Vai al contenuto principale
Data Engineering

Apache Iceberg vs Delta Lake: funzionalità, differenze e casi d’uso

Scegli il formato tabellare giusto per il tuo data lake. Questo articolo confronta Apache Iceberg e Delta Lake, illustrandone funzionalità, differenze e quando usare ciascuno.
Laiba Siddiqui's photo
Laiba Siddiqui
Aggiornato · 11 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Crea il tuo account gratuito

Pratica and corso your progress.

Continua Con Google
Continuando, accetti i nostri Termini di utilizzo, la nostra Informativa sulla privacy e che i tuoi dati siano conservati negli Stati Uniti.

L’elaborazione dei big data spesso implica lavorare con dati non strutturati, che possono essere difficili da gestire e analizzare. Cancellazioni accidentali o altri errori possono verificarsi in qualsiasi momento — rappresentando un serio rischio per l’integrità dei dati.

Apache Iceberg e Delta Lake sono formati di tabella open-source utilizzati principalmente per gestire data lake e lakehouse su larga scala. Entrambe le piattaforme offrono funzionalità come l’evoluzione dello schema, il time travel e le transazioni ACID per affrontare le sfide legate alla gestione di dataset massivi. Pur avendo vantaggi specifici, condividono un obiettivo comune: mantenere la coerenza dei dati tra i dataset.

In questo articolo spiegherò le funzionalità chiave, le somiglianze e le differenze architetturali tra Apache Iceberg e Delta Lake per aiutarti a scegliere lo strumento giusto per le tue esigenze. 
Che cos’è Apache Iceberg?

Logo di Apache Iceberg

Sviluppato da Netflix e successivamente donato all’Apache Software Foundation, Iceberg mira a risolvere le sfide della gestione dei data lake su larga scala. È un formato ad alte prestazioni per grandi tabelle analitiche che gestisce e interroga in modo efficiente dataset enormi. Le sue funzionalità colmano molte delle limitazioni degli approcci tradizionali di storage nei data lake.

Vediamo più nel dettaglio Apache Iceberg. 

Funzionalità di Apache Iceberg

Ecco alcune delle funzionalità più rilevanti di Apache Iceberg, molto utili per i data engineer quando lavorano con i dataset.

  • Evoluzione dello schema: Nei database tradizionali, cambiare la struttura dei dati (per esempio aggiungendo una nuova colonna) può essere complicato. Iceberg lo rende semplice. Ad esempio, se stai tracciando i dati dei clienti e vuoi aggiungere un campo loyalty_points, puoi farlo senza intaccare i dati esistenti o interrompere le query correnti. Questa flessibilità è particolarmente utile per progetti di lungo periodo che devono adattarsi nel tempo.
  • Partizionamento: Aiuta a organizzare i dati in blocchi più piccoli e gestibili. Le query risultano più veloci perché non devi scandagliare tutti i dati ogni volta. Per esempio, con un enorme dataset di registrazioni di vendita, Iceberg può organizzare automaticamente i dati per data, località o altri fattori rilevanti. 
  • Time travel: Questa funzionalità consente di accedere facilmente a versioni storiche dei dati. Se qualcuno cancella per errore informazioni importanti o se devi confrontare i dati attuali con uno stato passato, puoi tornare indietro a un momento specifico. Queste query point-in-time semplificano audit e processi di ripristino dei dati.
  • Integrità dei dati: La corruzione dei dati può avvenire per molte ragioni, come problemi di rete, di storage o bug software. Iceberg utilizza tecniche matematiche (checksum) per rilevare se anche un solo bit dei dati è cambiato in modo imprevisto. Questo garantisce che i dati che analizzi corrispondano esattamente a quelli originariamente archiviati.
  • Compattazione e ottimizzazione: Col tempo, i sistemi dati possono accumulare molti file di piccole dimensioni, rallentando l’elaborazione. Iceberg ripulisce periodicamente combinando i file piccoli e organizzando i dati in modo più efficiente.

Queste funzionalità rendono Iceberg particolarmente adatto all’analisi di dati su larga scala, soprattutto se gestisci dati che cambiano frequentemente o che devono essere accessibili in modi diversi nel lungo periodo.

Dai un’occhiata al post Apache Iceberg Explained per un approfondimento su questa tecnologia.
Che cos’è Delta Lake?

Logo di Delta Lake

Sviluppato da Databricks, Delta Lake si integra perfettamente con Spark, diventando una scelta popolare per le organizzazioni già investite nell’ecosistema Spark. È un livello di storage open-source che porta le transazioni ACID (Atomicità, Coerenza, Isolamento, Durabilità) in Apache Spark e nei carichi di lavoro big data. 

I lakehouse basati su Delta Lake semplificano data warehousing e machine learning per mantenere la qualità dei dati tramite metadati scalabili, versioning e applicazione dello schema.

Funzionalità di Delta Lake

Ecco le funzionalità chiave che rendono Delta Lake una buona soluzione per l’elaborazione dati moderna:

  • Transazioni ACID: I data lake tradizionali spesso faticano a mantenere la coerenza dei dati. Per superare questo problema, Delta Lake porta nei data lake le proprietà ACID tipiche dei database. Questo significa poter eseguire operazioni complesse sui dati senza preoccuparti di corruzioni o inconsistenze, anche se qualcosa va storto a metà processo.
  • Versioning dei dati e time travel: Con regolamenti come GDPR sempre più stringenti, tracciare i cambiamenti nel tempo è diventato prezioso. La funzione di time travel di Delta Lake permette di accedere e ripristinare versioni precedenti dei dati. È utile per la conformità e per eseguire esperimenti con versioni diverse dei tuoi dataset.
  • Batch e streaming unificati: Tradizionalmente, le organizzazioni avevano sistemi separati per l’elaborazione batch (grandi volumi in una volta) e lo stream processing (dati in tempo reale). Delta Lake colma questo divario così puoi usare lo stesso sistema per entrambi. Ciò semplifica l’architettura dati e ti permette di costruire pipeline più flessibili.
  • Gestione dei metadati scalabile: Con volumi che crescono fino alla scala dei petabyte, gestire i metadati (dati sui dati) diventa difficile. Di conseguenza, molti sistemi rallentano notevolmente quando gestiscono milioni di file. Delta Lake, invece, regge scale enormi senza degrado delle prestazioni, risultando adatto a data lake molto grandi.
  • Letture e scritture ottimizzate: Le prestazioni sono cruciali nei contesti big data. Delta Lake integra data skipping, caching e compattazione per velocizzare le operazioni di lettura e scrittura. Questo si traduce in query più rapide e uso più efficiente delle risorse computazionali, con risparmi nei contesti cloud.

Il corso Big Data Fundamentals with PySpark approfondisce l’elaborazione dati moderna con Spark. È un ottimo ripasso di questa potente tecnologia.

Apache Iceberg e Delta Lake: somiglianze

Dato che Apache Iceberg e Delta Lake gestiscono grandi volumi di dati, esaminiamone le somiglianze fondamentali. 

Transazioni ACID e coerenza dei dati

Entrambi gli strumenti garantiscono piena coerenza dei dati tramite transazioni ACID e versioning. Tuttavia, Iceberg adotta l’approccio merge-on-read, mentre Delta Lake utilizza la strategia merge-on-write. 

Di conseguenza, ognuno gestisce in modo diverso prestazioni e gestione dei dati. Iceberg può offrire pieno supporto all’evoluzione dello schema, mentre Delta Lake applica la conformità allo schema.

Supporto per il time travel

La funzionalità di time travel consente di interrogare versioni storiche dei dati. È preziosa per audit, debug e perfino per riprodurre esperimenti. Sia Iceberg che Delta Lake supportano il time travel, permettendoti di accedere a stati precedenti dei dati senza preoccupazioni.

Natura open-source

Apache Iceberg e Delta Lake sono tecnologie open-source. Ciò significa che chiunque può usarle gratuitamente e persino contribuire a migliorarle. Inoltre, essendo open-source, non sei vincolato al prodotto di una sola azienda — hai più libertà di cambiare o combinare strumenti secondo necessità. E poiché il codice è pubblico, puoi anche ottimizzarlo per le tue esigenze specifiche.
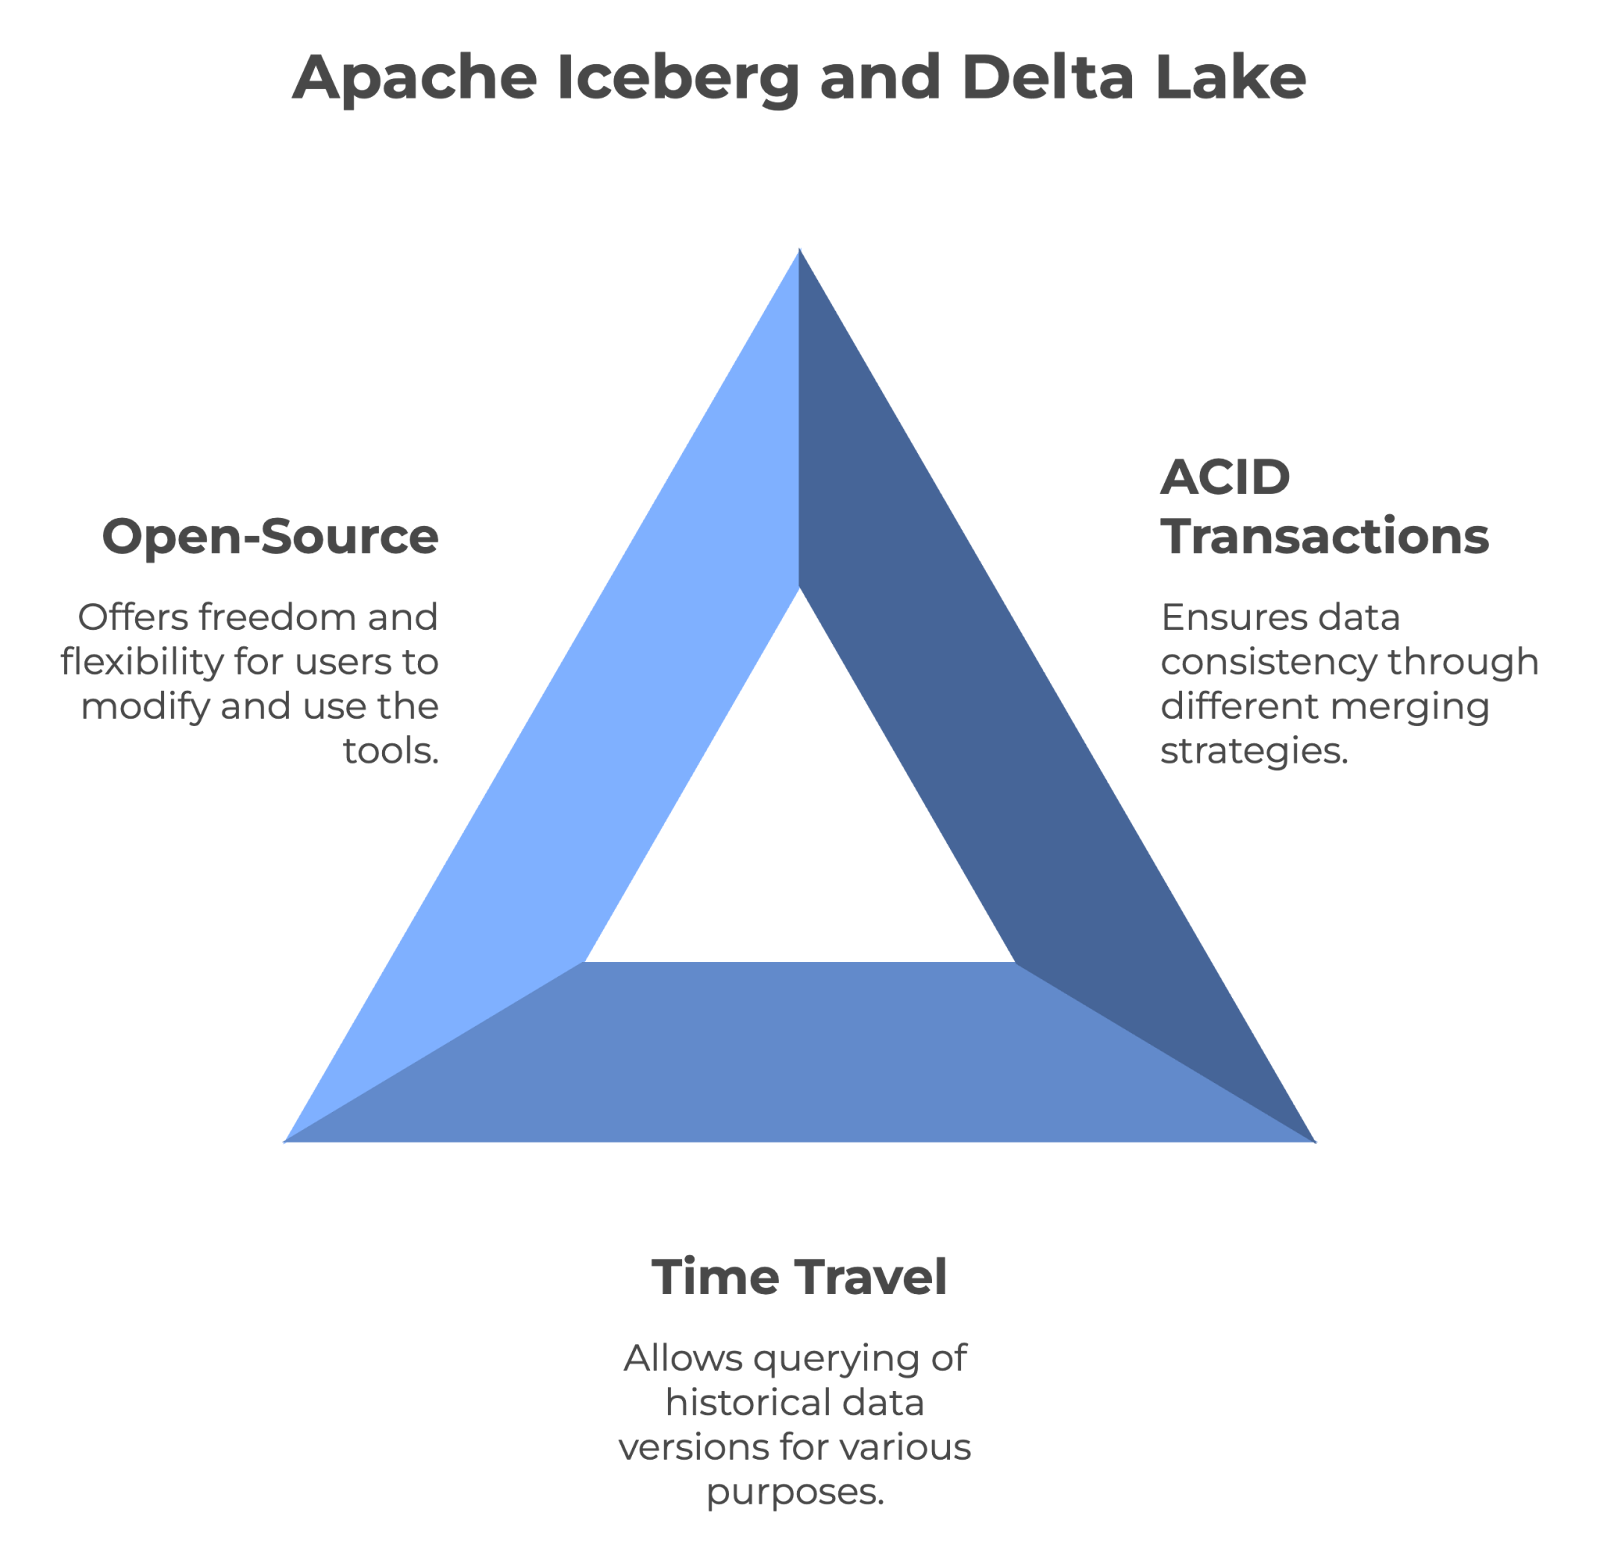
Somiglianze tra Apache Iceberg e Delta Lake

Le principali funzionalità condivise da Apache Iceberg e Delta Lake. Immagine dell’autore creata con napkin.ai.

Iceberg vs Delta Lake: differenze architetturali di base

Pur condividendo alcune somiglianze, Iceberg e Delta Lake differiscono nell’architettura. Vediamo come:

Modello di transazione

Iceberg e Delta Lake garantiscono l’affidabilità dei dati nei data lake, ma lo fanno tramite meccanismi diversi. Iceberg utilizza snapshot per transazioni atomiche, assicurando che le modifiche vengano completamente confermate o annullate. Delta Lake invece utilizza log delle transazioni per garantire che solo le modifiche validate vengano applicate alla tabella, offrendo affidabilità negli aggiornamenti dei dati.

Gestione dei metadati

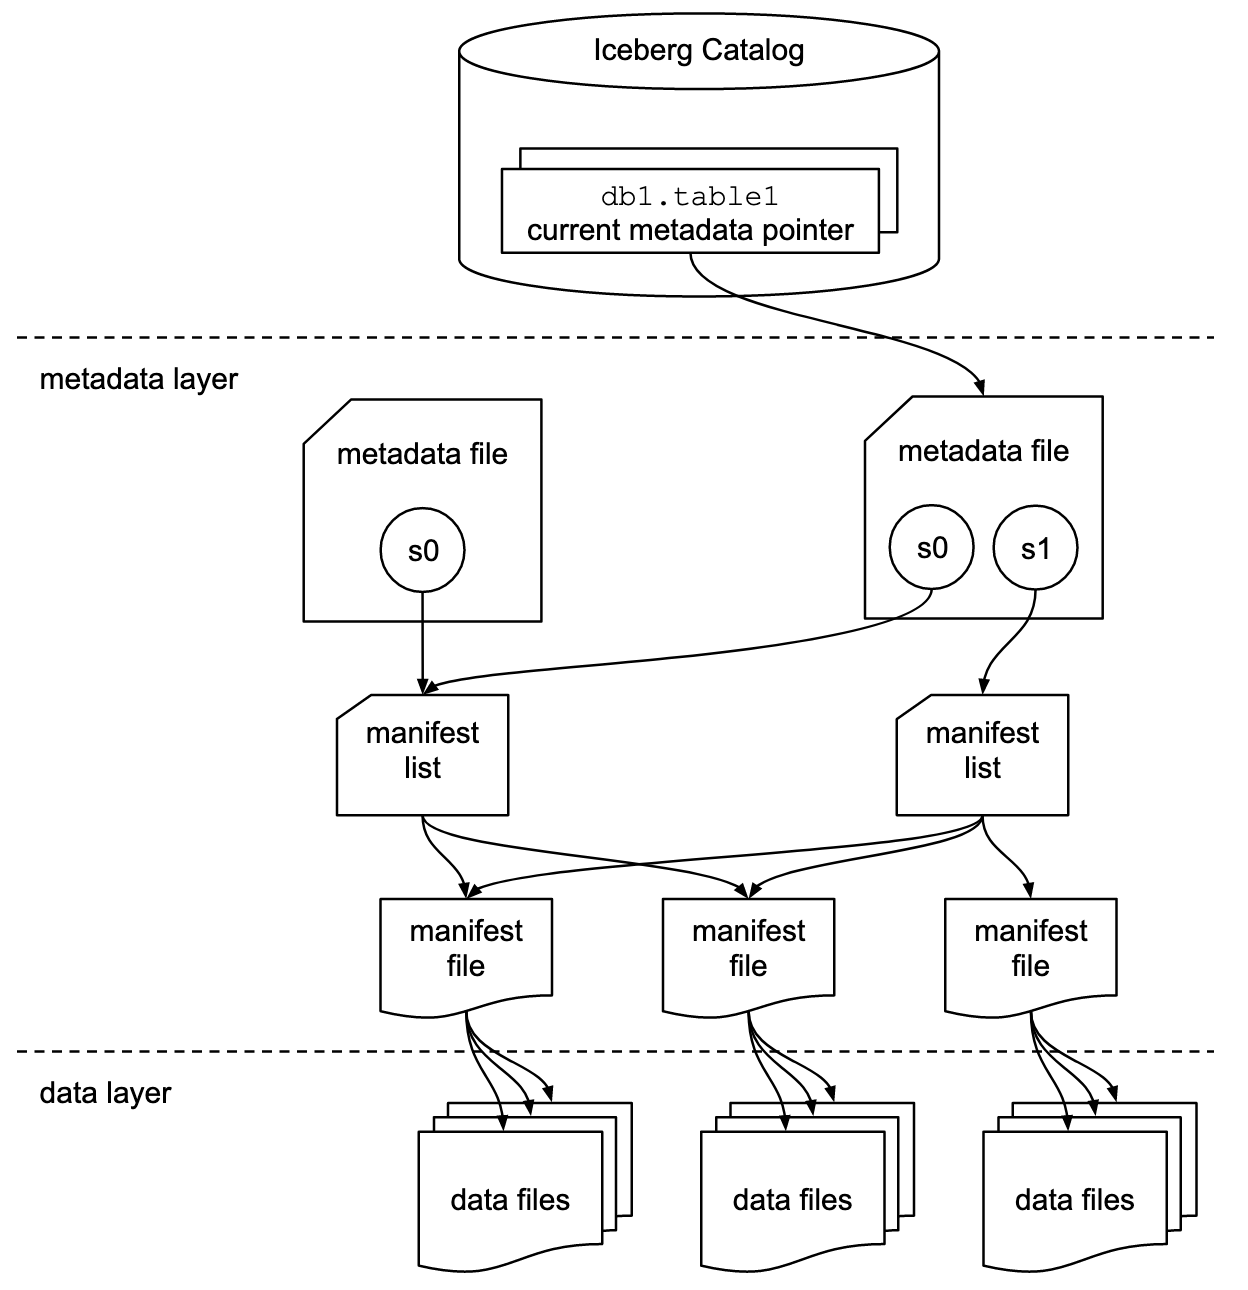
Apache Iceberg impiega una struttura dei metadati gerarchica, che include file di manifest, liste di manifest e file di metadati. Questo design snellisce l’elaborazione delle query eliminando operazioni costose come elencare e rinominare i file. 

Delta Lake, invece, adotta un approccio basato sulle transazioni per registrare ogni operazione in un log. Per aumentare l’efficienza delle query e semplificare la gestione dei log, consolida periodicamente questi log in file di checkpoint Parquet che catturano lo stato completo della tabella.

Compatibilità dei formati di file

Iceberg è flessibile rispetto ai formati di file e funziona nativamente con Parquet, ORC e Avro. Questo è utile se hai dati in formati diversi o se vuoi cambiare formato in futuro senza modificare l’intero sistema.

Delta Lake archivia principalmente i dati in formato Parquet perché è efficiente, soprattutto per le query analitiche. Concentrarsi su un solo formato consente le migliori prestazioni possibili per quel tipo di file.

Prestazioni e scalabilità

Iceberg e Delta Lake scalano i data lake ma con strategie diverse. Iceberg dà priorità a un’organizzazione avanzata dei dati con funzionalità come partizionamento e compattazione, mentre Delta Lake punta a prestazioni elevate tramite Delta Engine, auto compaction e capacità di indicizzazione.
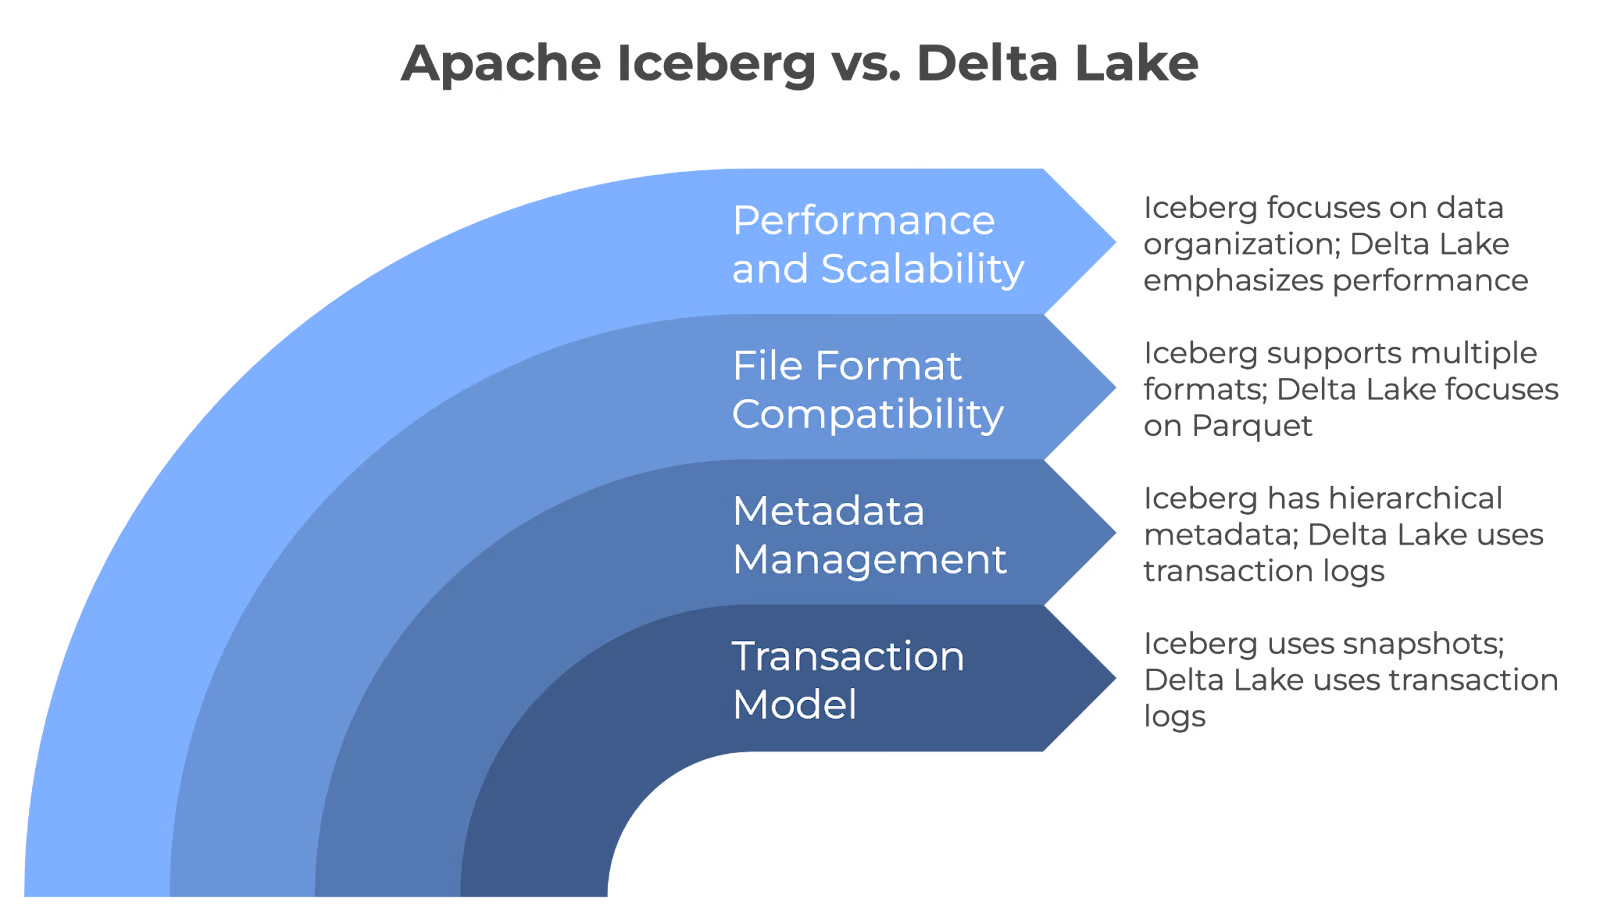
Differenze principali tra Apache Iceberg e Delta Lake

Differenze centrali tra Apache Iceberg e Delta Lake. Immagine dell’autore creata con napkin.ai.

Casi d’uso di Apache Iceberg

Grazie alle sue caratteristiche uniche, Apache Iceberg è rapidamente diventato una soluzione di riferimento per la gestione moderna dei data lake. Esaminiamone alcuni casi d’uso principali per capire i suoi punti di forza. 

Data lake cloud-native

Ecco perché Iceberg è una scelta popolare per le organizzazioni che costruiscono data lake operanti alla scala del cloud:

  • Forte evoluzione dello schema: Ti permette di aggiungere, rimuovere o modificare colonne senza impattare le query esistenti. Per esempio, se devi aggiungere un nuovo campo per tracciare le preferenze degli utenti, puoi farlo senza ricostruire l’intero dataset o aggiornare tutte le query.
  • Prestazioni: Tecniche avanzate come clustering dei dati e gestione dei metadati ottimizzano le prestazioni delle query. Eliminano rapidamente i file non necessari per ridurre i dati scansionati e migliorare la velocità delle query. 
  • Scalabilità: Gestisce miliardi di file e petabyte di dati. Inoltre, la sua partition evolution ti consente di cambiare il modo in cui i dati sono organizzati senza downtime o migrazioni costose.

Modelli di dati complessi

I team che trattano modelli di dati complessi trovano Iceberg particolarmente utile per i seguenti motivi:

  • Flessibilità dello schema: Supporta tipi di dato annidati (struct, list e map) per rappresentare relazioni complesse. Per esempio, una piattaforma e-commerce potrebbe archiviare i dettagli dell’ordine, inclusi oggetti annidati per articoli e dati del cliente, all’interno di un’unica tabella.
  • Query con time travel: Questo metodo mantiene snapshot dei dati per interrogarli così come erano in qualsiasi momento passato. È prezioso per ricostruire lo stato dei dati in un dato momento a fini di conformità o per rieseguire analisi su snapshot storici.

Integrazione con gli strumenti

Iceberg è compatibile con strumenti eterogenei, risultando una scelta versatile per l’ecosistema dati. Vediamo alcune integrazioni chiave: 

Iceberg funziona senza attriti con:

  • Apache Spark per l’elaborazione dati su larga scala e il machine learning.
  • Trino per query SQL distribuite e veloci su più sorgenti dati.
  • Apache Flink per lo stream processing in tempo reale e il calcolo batch.

I seguenti principali provider cloud offrono supporto nativo per Iceberg:

Iceberg fornisce anche librerie client per diversi linguaggi di programmazione, come:
  • SQL per scrivere query SQL standard su tabelle Iceberg.
  • Python tramite PySpark o librerie come pyiceberg per la manipolazione dei dati.
  • Java con la nativa API Java per operazioni a basso livello e integrazioni personalizzate.

Architettura tecnica di Apache Iceberg

Specifiche del formato tabellare Apache Iceberg. Fonte immagine: Iceberg documentation.

Casi d’uso di Delta Lake

Delta Lake può risolvere sfide comuni e rendere la gestione dei dati più semplice. Vediamo alcune situazioni in cui è davvero utile.

Carichi di lavoro batch e streaming unificati

Con Delta Lake non servono sistemi separati per tipi di dati diversi. Puoi avere un unico sistema che gestisce tutto. Puoi aggiungere nuovi dati alle tue tabelle in tempo reale, pronti subito per l’analisi. Questo significa che i tuoi dati sono sempre aggiornati. 

Puoi creare un unico flusso di lavoro che gestisce dati vecchi e nuovi, rendendo l’intero sistema meno complesso e più facile da amministrare. Questo approccio unificato semplifica le pipeline dati. 

Transazioni ACID per i data lake

Delta Lake porta una forte affidabilità nei data lake tramite le transazioni ACID. Per esempio: 

  • Gli ospedali possono mantenere cartelle cliniche accurate e aggiornate per fornire cure adeguate e rispettare le norme sulla privacy. 
  • Le banche possono assicurarsi che tutte le transazioni finanziarie siano registrate correttamente e non possano essere modificate per errore. 
  • I negozi retail possono mantenere conteggi d’inventario precisi anche con molti aggiornamenti simultanei, evitando problemi come vendere articoli non realmente disponibili. 

Delta Lake raggiunge questa affidabilità assicurando che tutte le modifiche vengano applicate completamente o per niente. Inoltre, garantisce che i dati passino sempre da uno stato valido a un altro e che operazioni diverse non interferiscano tra loro. 

Ecosistema Apache Spark

Delta Lake funziona anche in modo naturale con Apache Spark, un grande vantaggio per molte organizzazioni. Se già usi Spark, aggiungere Delta Lake sarà semplice e non richiederà grandi cambiamenti nell’infrastruttura esistente. Il tuo team può usare gli stessi strumenti e comandi SQL di Spark a cui è abituato. 

Di conseguenza, i tuoi job Spark gireranno più velocemente, soprattutto con grandi volumi di dati. Ci riesce organizzando meglio i dati e utilizzando tecniche intelligenti di indicizzazione. 

Apache Iceberg vs Delta Lake: un riepilogo

Ricapitoliamo le principali differenze tra Apache Iceberg e Delta Lake per aiutarti a coglierne rapidamente i punti di forza e le funzionalità chiave.

Funzionalità 

Apache Iceberg 

Delta Lake

Transazioni ACID

Sì

Sì

Time travel

Sì

Sì

Versioning dei dati 

Sì 

Sì 

Formato file

Parquet, ORC, Avro

Parquet

Evoluzione dello schema

Completa 

Parziale 

Integrazione con altri motori

Apache Spark, Trino, Flink

Principalmente Apache Spark

Compatibilità cloud

AWS, GCP, Azure

AWS, GCP

Motori di query

Spark, Trino, Flink

Spark

Linguaggi di programmazione

SQL, Python, Java

SQL, Python

Nota: la scelta migliore dipende dalle tue esigenze, dai requisiti di scalabilità e dalla strategia dati di lungo periodo.

Conclusione 

Quando scegli tra Apache Iceberg e Delta Lake, considera il tuo caso d’uso specifico e lo stack tecnologico esistente. La flessibilità di Iceberg con formati di file e motori di query lo rende ideale per ambienti cloud-native. Tuttavia, la stretta integrazione di Delta Lake con Apache Spark è un’ottima opzione per le organizzazioni fortemente investite nell’ecosistema Spark.

Puoi anche consultare alcune risorse DataCamp utili per rafforzare le tue conoscenze sui dati:

  1. Understanding Data Engineering, un corso per afferrare i concetti fondamentali
  2. Database Design e Data Warehousing, corsi per strutturare efficacemente dati su larga scala.
  3. Modern Data Architecture per conoscere best practice e trend attuali. 

Buono studio!

FAQ

Qual è la principale differenza tra le strategie Merge-on-Read e Merge-on-Write?

Merge-on-Read (usato da Iceberg) legge i dati dai file esistenti e applica le modifiche al momento della query. Merge-on-Write (usato da Delta Lake) unisce gli aggiornamenti ai dati di base durante il processo di scrittura per garantire letture più veloci a scapito di scritture più lente.

Apache Iceberg e Delta Lake possono gestire dati alla scala dei petabyte?

Sì, sia Apache Iceberg sia Delta Lake gestiscono in modo efficiente dataset alla scala dei petabyte. Offrono funzionalità avanzate come partizionamento, gestione dei metadati e compattazione per ottimizzare le prestazioni dei grandi data lake.

Come si comportano Apache Iceberg e Delta Lake nell’interrogare strutture di dati profondamente annidate?

Apache Iceberg è eccellente nell’interrogare strutture di dati profondamente annidate. Supporta formati tabellari come Parquet, ottimizzati per dati annidati. D’altro canto, anche Delta Lake supporta dati annidati, ma le prestazioni possono variare in base alla complessità della query e alla dimensione del dataset.

Apache Iceberg e Delta Lake possono funzionare insieme nella stessa architettura di data lake?

Sì, Apache Iceberg e Delta Lake possono coesistere nello stesso data lake. Ciascuno può essere utilizzato per casi d’uso diversi a seconda dei requisiti. Ad esempio, potresti usare Delta Lake per carichi di lavoro incentrati su Apache Spark e Iceberg per un’integrazione più flessibile con motori di query eterogenei.

Ci sono limitazioni nell’uso di Delta Lake con motori non Spark?

Delta Lake è strettamente integrato con Apache Spark e, sebbene possa funzionare con altri motori come Presto o Hive, queste integrazioni sono ancora in evoluzione. Le prestazioni potrebbero non essere ottimizzate come con Spark, limitandone l’efficacia al di fuori dell’ecosistema Spark.

Come gestiscono Iceberg e Delta Lake il problema dei file piccoli nei data lake?

Sia Apache Iceberg sia Delta Lake affrontano il problema dei file piccoli tramite compattazione. Iceberg combina periodicamente i file piccoli per ottimizzare le prestazioni delle query, mentre Delta Lake utilizza l’auto compaction per consolidare i file durante le operazioni di scrittura. Questo garantisce prestazioni migliori riducendo l’overhead causato da troppi file piccoli.

Perché Databricks ha acquisito Tabular (l’azienda dietro Iceberg)?

Databricks ha acquisito Tabular per rafforzare le proprie capacità con Apache Iceberg, originariamente creato dai fondatori di Tabular. L’acquisizione mira a migliorare compatibilità e interoperabilità tra Delta Lake e Iceberg, puntando in ultima analisi a un formato lakehouse unificato che combini i punti di forza di entrambi i progetti open-source.

Cosa comporta l’acquisizione di Tabular per gli utenti di Delta Lake e Iceberg?

L’acquisizione significa che Databricks lavorerà attivamente per avvicinare Delta Lake e Iceberg in termini di compatibilità. Gli utenti beneficeranno di un’integrazione migliorata, con Delta Lake UniForm che già funge da piattaforma per abilitare l’interoperabilità tra Delta Lake, Iceberg e Apache Hudi. Questo consente di lavorare su formati diversi senza essere vincolati a una singola soluzione.

Databricks continuerà a supportare sia Delta Lake sia Iceberg?

Sì, Databricks ha indicato il proprio impegno per entrambi i formati. Acquisendo Tabular e coinvolgendo i creatori originali di Apache Iceberg, Databricks punta a favorire la collaborazione tra le community di Iceberg e Delta Lake. L’obiettivo è sviluppare uno standard aperto unico per l’interoperabilità dei formati lakehouse, offrendo agli utenti più opzioni e flessibilità.


Laiba Siddiqui's photo
Author
Laiba Siddiqui
LinkedIn
Twitter

Sono una content strategist: mi piace semplificare argomenti complessi. Ho aiutato aziende come Splunk, Hackernoon e Tiiny Host a creare contenuti coinvolgenti e informativi per il loro pubblico.

Argomenti
Data Engineering

Approfondisci il data engineering con questi corsi!

Corso

Introduzione al Data Engineering

4 ore
130.4K
Scopri il mondo dell'ingegneria dei dati in questo breve corso, che parla di strumenti e argomenti come ETL e cloud computing.
Vedi i dettagliInizia Il Corso

Crea il tuo account gratuito

Pratica and corso your progress.

Continua Con Google
Continuando, accetti i nostri Termini di utilizzo, la nostra Informativa sulla privacy e che i tuoi dati siano conservati negli Stati Uniti.
Mostra altro
Correlato

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Mostra altro

