Kurs
Büyük veri işleme, çoğu zaman yapılandırılmamış verilerle çalışmayı içerir; bu da yönetimi ve analizi zorlaştırabilir. Her aşamada kazara silmeler veya başka hatalar meydana gelebilir — bu da veri bütünlüğü için büyük bir risk oluşturur.
Apache Iceberg ve Delta Lake, öncelikle büyük ölçekli veri göllerini ve lakehouse’ları yönetmek için kullanılan açık kaynak tablo formatlarıdır. Her iki platform da şema evrimi, zaman yolculuğu ve ACID işlemleri gibi özellikler sunarak devasa veri kümelerini yönetmenin zorluklarını ele alır. Her birinin kendine özgü avantajları olsa da, ortak amaçları veri kümeleri genelinde veri tutarlılığını sağlamaktır.
Bu makalede, ihtiyaçlarınıza uygun aracı seçmenize yardımcı olmak için Apache Iceberg ve Delta Lake’in temel özelliklerini, benzerliklerini ve mimari farklılıklarını açıklayacağım.
Apache Iceberg nedir?

Netflix tarafından geliştirilen ve daha sonra Apache Software Foundation’a bağışlanan Iceberg büyük ölçekli veri göllerini yönetme zorluklarını çözmeyi amaçlar. Büyük analitik tablolar için yüksek performanslı bir formattır ve devasa veri kümelerini verimli şekilde yönetir ve sorgular. Özellikleri, geleneksel veri gölü depolama yaklaşımlarının birçok kısıtını giderir.
Apache Iceberg’i biraz daha ayrıntılı inceleyelim.
Apache Iceberg’in özellikleri
İşte Apache Iceberg’in veri mühendislerinin veri kümeleriyle çalışırken çok işine yarayan en belirgin özelliklerinden bazıları.
- Şema evrimi: Geleneksel veritabanlarında verinizin yapısını değiştirmek (örneğin yeni bir sütun eklemek) büyük bir zahmet olabilir. Iceberg bunu kolaylaştırır. Örneğin, müşteri verilerini izliyor ve
loyalty_pointsalanını eklemek istiyorsanız, mevcut verileri etkilemeden veya halihazırdaki sorguları bozmadan bunu yapabilirsiniz. Bu esneklik, zaman içinde uyum sağlaması gereken uzun vadeli veri projeleri için özellikle faydalıdır. - Bölümleme (partitioning): Verinizi daha küçük ve yönetilebilir parçalara ayırmaya yardımcı olur. Bu da sorguları hızlandırır, çünkü her seferinde tüm verileri taramak zorunda kalmazsınız. Örneğin, elimde devasa bir satış kayıtları veri kümesi var. Iceberg bu veriyi tarih, konum veya başka ilgili faktörlere göre otomatik olarak düzenleyebilir.
- Zaman yolculuğu: Bu özellik, geçmiş veri sürümlerine kolayca erişmenizi sağlar. Biri yanlışlıkla önemli bilgileri silerse veya mevcut verileri geçmiş bir durumla karşılaştırmanız gerekirse, belirli bir ana geri gidebilirsiniz. Bu anlık sorgular, denetim ve veri kurtarma süreçlerini basitleştirir.
- Veri bütünlüğü: Ağ sorunları, depolama problemleri veya yazılım hataları gibi birçok nedenle veri bozulması meydana gelebilir. Iceberg, verinizde tek bir bit bile beklenmedik şekilde değişmişse bunu tespit etmek için matematiksel teknikler (checksum’lar) kullanır. Bu, analiz ettiğiniz verinin ilk kaydedilen verinin aynısı olmasını sağlar.
- Sıkıştırma ve optimizasyon: Zamanla veri sistemleri çok sayıda küçük dosyayla dolup taşabilir ve bu da işlemleri yavaşlatır. Iceberg, küçük dosyaları birleştirerek ve verileri daha verimli organize ederek bunu periyodik olarak temizler.
Bu özellikler, özellikle verileriniz sık değişiyorsa veya uzun dönem boyunca farklı şekillerde erişilmesi gerekiyorsa Iceberg’i büyük ölçekli veri analitiği için özellikle uygun kılar.
Bu heyecan verici teknolojiye derinlemesine bir bakış için Apache Iceberg Açıklaması blog yazısına göz atın.
Delta Lake nedir?

Databricks tarafından geliştirilen Delta Lake, Spark ile sorunsuz çalışır ve bu da onu Spark ekosistemine yatırım yapmış kuruluşlar için popüler bir tercih haline getirir. Apache Spark ve büyük veri iş yüklerine ACID (Atomicity, Consistency, Isolation, Durability) işlemlerini getiren açık kaynaklı bir depolama katmanıdır.
Delta Lake tabanlı lakehouse’lar, ölçeklenebilir meta veriler, sürümleme ve şema zorlamasıyla veri kalitesini korumak için veri ambarını ve makine öğrenimini bir araya getirir.
Delta Lake’in özellikleri
Delta Lake’i modern veri işleme için iyi bir çözüm haline getiren temel özellikler şunlardır:
- ACID işlemleri: Geleneksel veri gölleri, veri tutarlılığını korumakta sıkça zorlanır. Bunu aşmak için Delta Lake, veritabanlarıyla ilişkilendirilen ACID özelliklerini veri göllerine taşır. Bu sayede, süreç ortasında bir şeyler ters gitse bile veri bozulması veya tutarsızlıklar konusunda endişe etmeden veriniz üzerinde karmaşık işlemler gerçekleştirebilirsiniz.
- Veri sürümleme ve zaman yolculuğu: GDPR gibi veri düzenlemeleri daha katı hale geldikçe, zaman içindeki veri değişikliklerini izlemek paha biçilemez oldu. Delta Lake’in zaman yolculuğu özelliği, verinizin önceki sürümlerine erişmenize ve onları geri yüklemenize olanak tanır. Bu, uyumluluk için ve veri kümelerinizin farklı sürümleriyle deneyler yürütmek açısından faydalıdır.
- Birleşik yığın ve akış: Geleneksel olarak kuruluşlar, yığın işleme (verilerin büyük hacimlerini bir kerede işleme) ve akış işleme (gerçek zamanlı verilerle çalışma) için ayrı sistemlere ihtiyaç duyardı. Delta Lake bu uçurumu kapatır; her ikisi için de aynı sistemi kullanabilirsiniz. Bu, veri mimarinizi basitleştirir ve daha esnek veri hatları kurmanıza olanak tanır.
- Ölçeklenebilir meta veri yönetimi: Veri hacimleri petabayt ölçeğine çıktıkça, meta verileri (veriniz hakkındaki veriler) yönetmek zorlaşır. Sonuç olarak birçok sistem milyonlarca dosyayla uğraşırken ciddi şekilde yavaşlar. Oysa Delta Lake performans düşüşü olmadan devasa ölçekte çalışabilir; bu da onu çok büyük veri gölleri için uygun kılar.
- Okuma ve yazmalarda optimizasyon: Büyük veri senaryolarında performans kritiktir. Delta Lake, okuma ve yazma işlemlerini hızlandırmak için data skipping, önbellekleme ve sıkıştırma kullanır. Bu da daha hızlı sorgular ve bulut ortamlarında maliyet tasarrufu sağlayan daha verimli hesaplama kaynak kullanımı demektir.
PySpark ile Büyük Veri Temelleri dersi, Spark ile modern veri işlemeye derinlemesine dalar. Bu güçlü teknoloji için harika bir hatırlatmadır.
Apache Iceberg ve Delta Lake: Benzerlikler
Apache Iceberg ve Delta Lake her ikisi de büyük miktarda veriyi yönettiğinden, temel benzerliklerine bakalım.
ACID işlemleri ve veri tutarlılığı
Her iki araç da ACID işlemleri ve sürümleme yoluyla tam veri tutarlılığı sağlayabilir. Ancak Iceberg merge-on-read yaklaşımını kullanırken, Delta Lake merge-on-write stratejisini kullanır.
Sonuç olarak, her biri performansı ve veri yönetimini farklı şekilde ele alır. Iceberg tam şema evrimi desteği sunabilirken, Delta Lake şema uyumluluğunu zorlar.
Zaman yolculuğu desteği
Zaman yolculuğu işlevi, kullanıcıların verilerin tarihsel sürümlerini sorgulamasına olanak tanır. Bu, denetim, hata ayıklama ve hatta deneyleri yeniden üretmek için çok değerlidir. Hem Iceberg hem de Delta Lake zaman yolculuğunu destekler; bu da önceki veri durumlarına endişe etmeden erişebileceğiniz anlamına gelir.
Açık kaynak doğası
Apache Iceberg ve Delta Lake açık kaynak teknolojilerdir. Bu, herkesin onları ücretsiz kullanabileceği ve hatta geliştirilmesine katkıda bulunabileceği anlamına gelir. Ayrıca açık kaynak olmaları, tek bir şirketin ürününe bağlı kalmayacağınız anlamına gelir — ihtiyaç duyduğunuzda araçları değiştirme veya birleştirme özgürlüğünüz vardır. Kodları herkese açık olduğu için, özel ihtiyaçlarınıza göre optimize de edebilirsiniz.
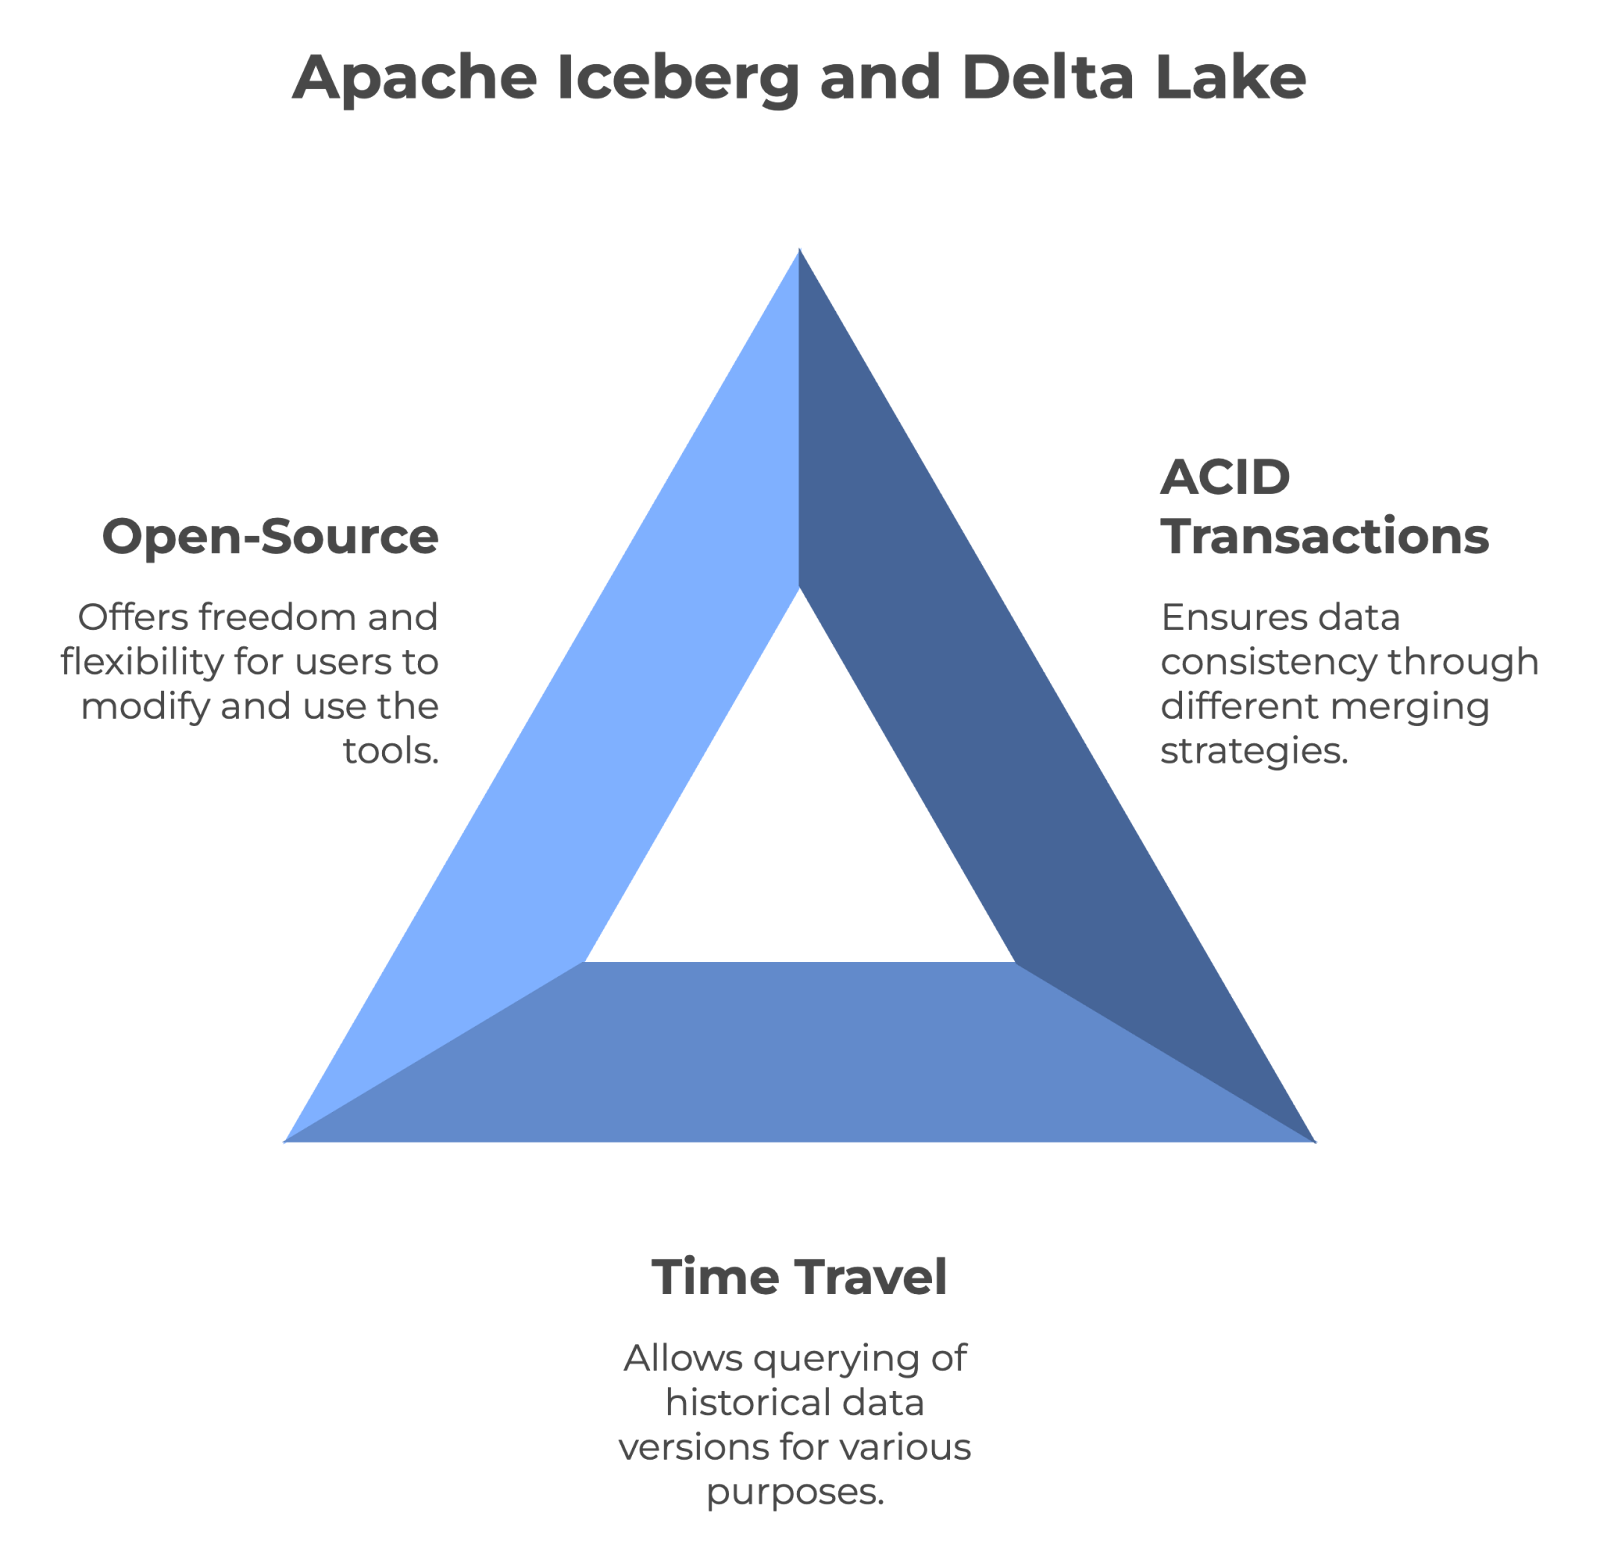
Apache Iceberg ve Delta Lake’in paylaştığı başlıca özellikler. Görsel: Yazar tarafından napkin.ai ile oluşturulmuştur.
Iceberg vs Delta Lake: Temel Mimari Farklar
Iceberg ve Delta Lake benzerlikler taşısa da mimarileri farklıdır. Nasıl olduğuna bakalım:
İşlem modeli
Iceberg ve Delta Lake, veri göllerinde veri güvenilirliğini sağlar ancak bunu farklı mekanizmalarla başarır. Iceberg, değişikliklerin ya tamamen işlendiğini ya da geri alındığını garanti etmek için atomik işlemler için anlık görüntüler (snapshot) kullanır. Buna karşılık Delta Lake, yalnızca doğrulanmış değişikliklerin tabloya işlendiğini sağlamak için işlem günlüklerini kullanır ve veri güncellemelerinde güvenilirlik sağlar.
Meta veri yönetimi
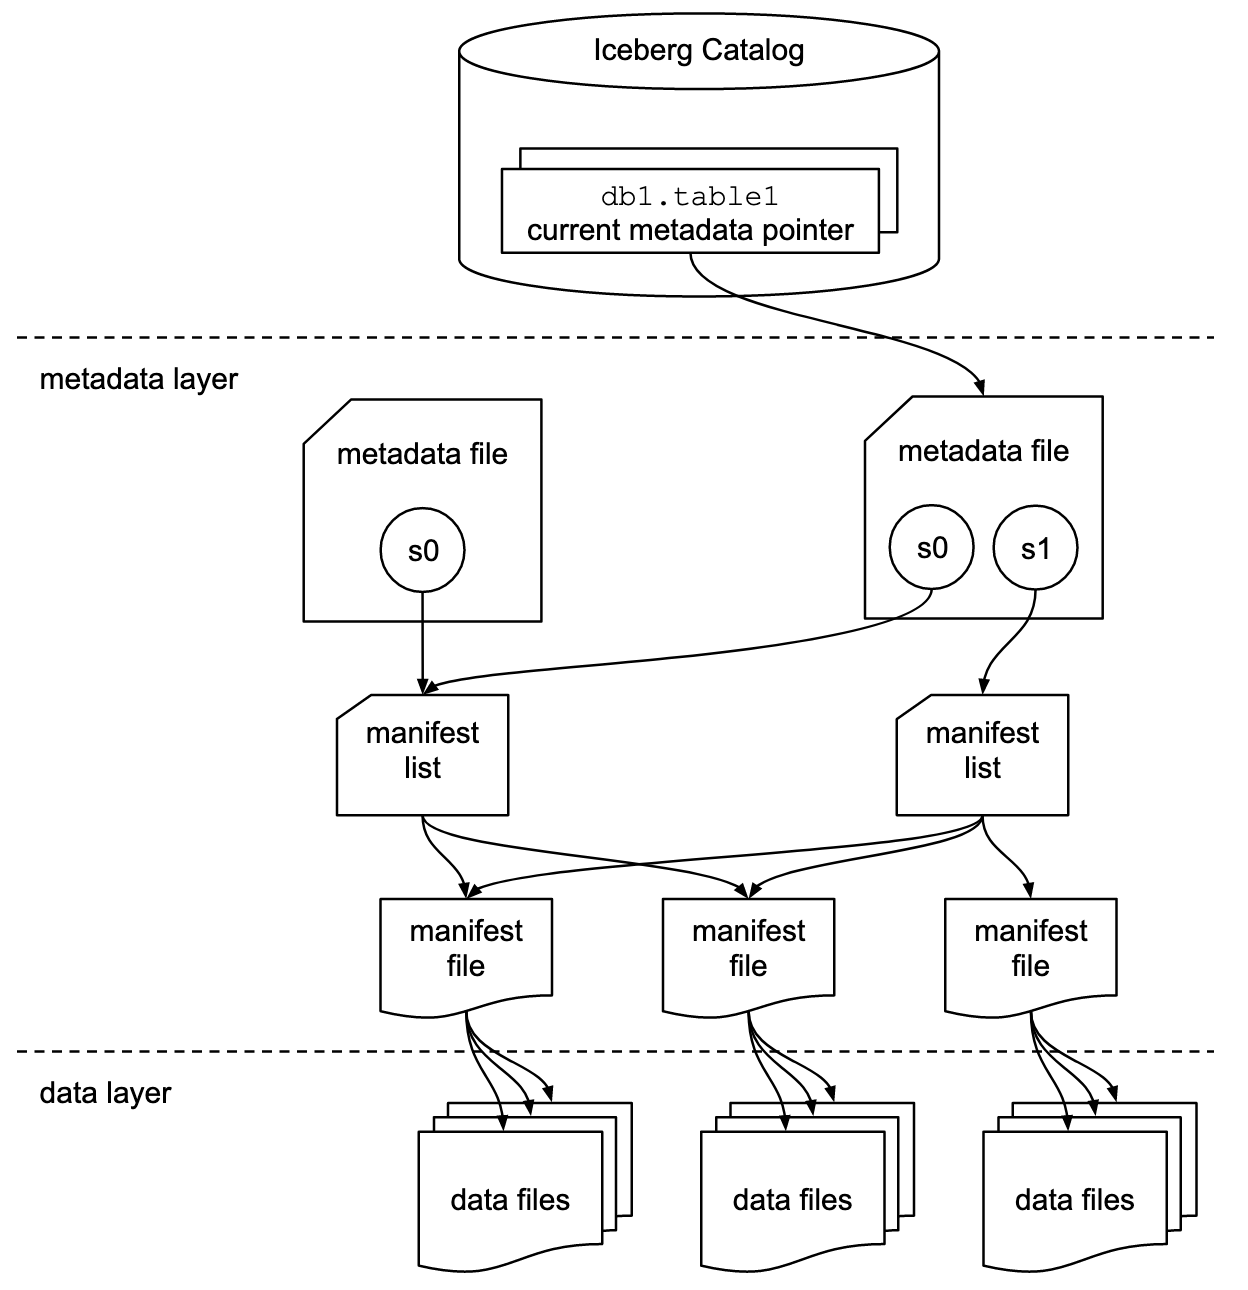
Apache Iceberg, manifest dosyaları, manifest listeleri ve meta veri dosyalarını içeren hiyerarşik bir meta veri yapısı kullanır. Bu tasarım, dosya listeleme ve yeniden adlandırma gibi maliyetli işlemleri ortadan kaldırarak sorgu işlemeyi hızlandırır.
Buna karşın Delta Lake, her işlemi bir günlükte kaydeden işlem tabanlı bir yaklaşım benimser. Sorgu verimliliğini artırmak ve günlük yönetimini basitleştirmek için bu günlükleri periyodik olarak, tablo durumunun tamamını yakalayan Parquet checkpoint dosyalarında birleştirir.
Dosya formatı uyumluluğu
Iceberg dosya formatları konusunda esnektir ve Parquet, ORC ve Avro dosyalarıyla yerel olarak çalışabilir. Bu, farklı formatlarda verileriniz varsa veya gelecekte tüm sistemi değiştirmeden formatlar arasında geçiş yapmak istiyorsanız faydalıdır.
Delta Lake verileri ağırlıklı olarak Parquet formatında depolar; çünkü Parquet özellikle analitik sorgular için verimlidir. En iyi performansı sağlamak için tek bir formata odaklanır.
Performans ve ölçeklenebilirlik
Iceberg ve Delta Lake, veri göllerini ölçeklendirir ancak farklı stratejiler uygular. Iceberg bölümleme ve sıkıştırma gibi özelliklerle gelişmiş veri organizasyonuna öncelik verirken, Delta Lake Delta Engine, otomatik sıkıştırma ve indeksleme yetenekleriyle yüksek performansı vurgular.
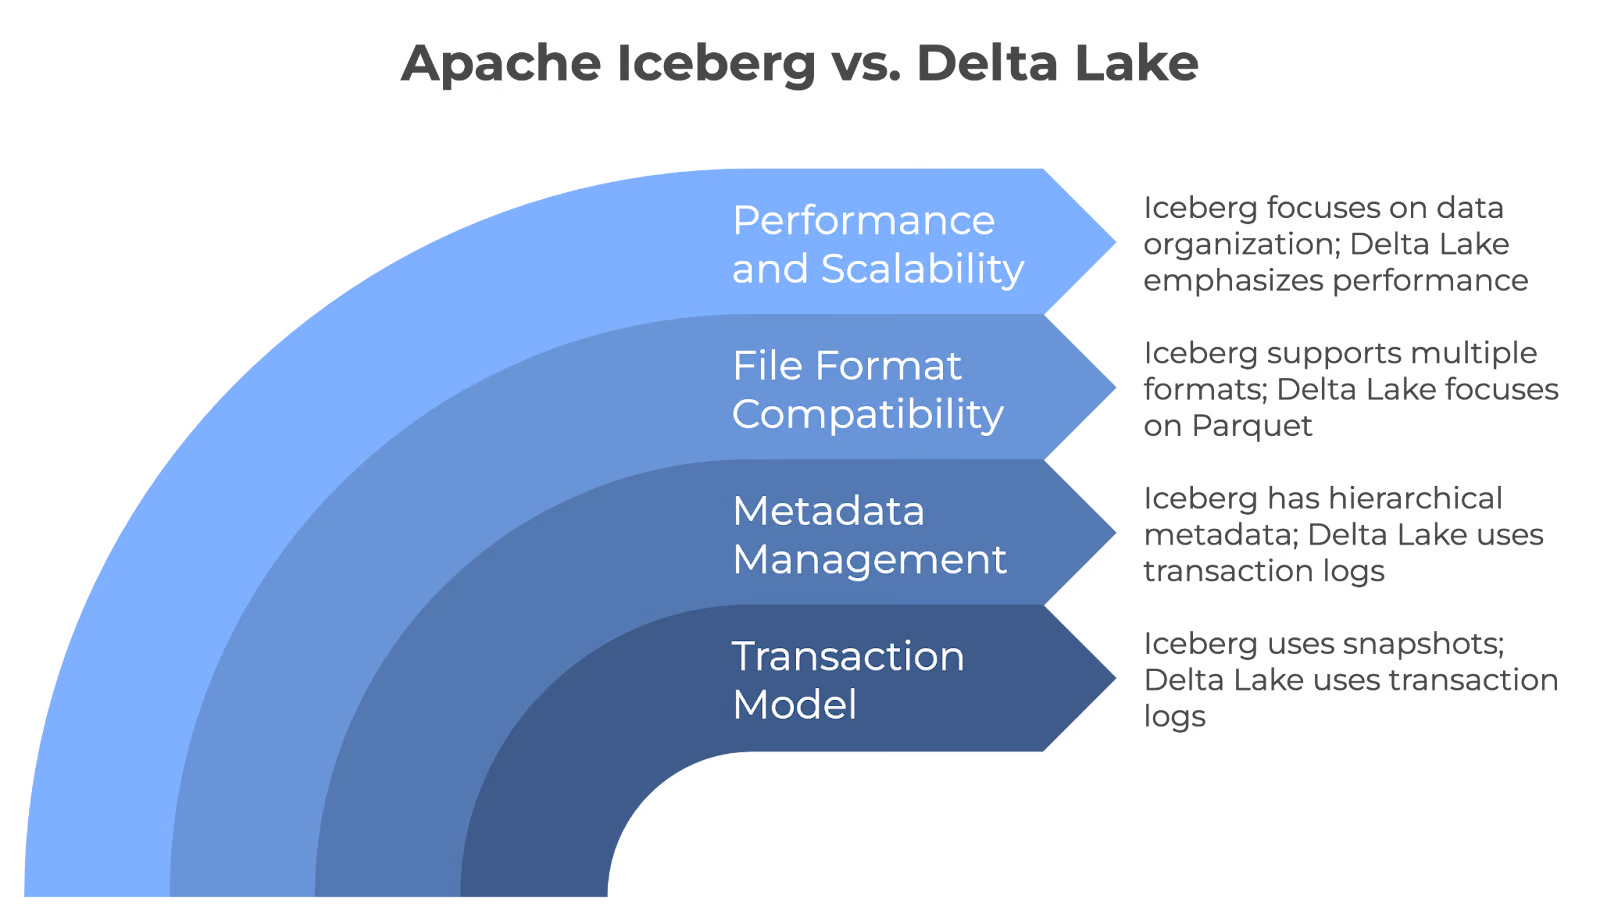
Apache Iceberg ve Delta Lake’in temel farkları. Görsel: Yazar tarafından napkin.ai ile oluşturulmuştur.
Apache Iceberg için Kullanım Alanları
Benzersiz özellikleri sayesinde Apache Iceberg, modern veri gölü yönetimi için hızla başvurulan bir çözüm haline geldi. Güçlü yönlerini anlamak için başlıca kullanım alanlarına bakalım.
Bulut-yerel veri gölleri
İşte Iceberg’in bulut ölçeğinde çalışan veri gölleri oluşturan kuruluşlar için popüler bir tercih olmasının nedenleri:
- Güçlü şema evrimi: Mevcut sorguları etkilemeden sütun eklemenize, kaldırmanıza veya değiştirmenize olanak tanır. Örneğin, kullanıcı tercihlerini izlemek için yeni bir alan eklemeniz gerekiyorsa, tüm veri kümesini yeniden inşa etmeden veya tüm sorgularınızı güncellemeden bunu yapabilirsiniz.
- Performans: Veri kümeleme ve meta veri yönetimi gibi gelişmiş teknikler sorgu performansını optimize eder. Gereksiz veri dosyalarını hızla budayarak taranan veri miktarını azaltır ve sorgu hızını artırır.
- Ölçeklenebilirlik: Milyarlarca dosya ve petabaytlarca veriyi yönetin. Ayrıca, bölüm evrimi (partition evolution) özelliği, kesinti veya maliyetli geçişler olmadan verinin nasıl organize edildiğini değiştirmenize olanak tanır.
Karmaşık veri modelleri
Karmaşık veri modelleriyle uğraşan ekipler, aşağıdaki nedenlerle Iceberg’i özellikle faydalı bulur:
- Şema esnekliği: Karmaşık ilişkileri temsil etmek için iç içe geçmiş veri türlerini (struct, list ve map) destekler. Örneğin bir e-ticaret platformu, tek bir tablo içinde kalemler ve müşteri verileri için iç içe yapılar dahil olmak üzere sipariş ayrıntılarını saklayabilir.
- Zaman yolculuğu sorguları: Bu yöntem, geçmişin herhangi bir anındaki gibi veri sorgulamak için verinizin anlık görüntülerini korur. Uyumluluk amaçları için verinizin belirli bir zamandaki durumunu yeniden oluşturmada veya geçmiş anlık görüntüler üzerinde analizleri yeniden çalıştırmada paha biçilmezdir.
Araçlarla entegrasyon
Iceberg, çeşitli araçlarla uyumludur ve veri ekosistemi için çok yönlü bir tercih haline gelir. Başlıca entegrasyonlarından bazılarına bakalım:
Iceberg aşağıdakilerle sorunsuz çalışır:
- Apache Spark büyük ölçekli veri işleme ve makine öğrenimi için.
- Trino çoklu veri kaynakları üzerinde hızlı, dağıtık SQL sorguları için.
- Apache Flink gerçek zamanlı akış işleme ve yığın hesaplama için.
Aşağıdaki büyük bulut sağlayıcıları Iceberg’i yerel olarak destekler:
- Amazon Web Services (AWS) şu hizmetlerle entegre olur: AWS Glue, Redshift, EMR ve Athena.
- Google Cloud Platform (GCP) BigQuery ve Dataproc ile çalışır.
- Microsoft Azure Azure Synapse Analytics ile uyumludur.
Iceberg ayrıca farklı programlama dilleri için istemci kitaplıkları sağlar. Örneğin:
- SQL, Iceberg tablolarına karşı standart SQL sorguları yazar.
- Python, veri manipülasyonu için PySpark veya pyiceberg gibi kütüphaneleri kullanır.
- Java , düşük seviyeli işlemler ve özel entegrasyonlar için yerel Java API’sinden yararlanır.

Apache Iceberg tablo formatı spesifikasyonu. Görsel kaynağı: Iceberg dokümantasyonu.
Delta Lake için Kullanım Alanları
Delta Lake, yaygın zorlukları çözebilir ve veri yönetimini kolaylaştırır. Gerçekten yardımcı olduğu bazı kilit durumlara bakalım.
Birleşik yığın ve akış iş yükleri
Delta Lake ile farklı veri türleri için ayrı sistemlere ihtiyacınız yoktur. Bunun yerine, her şeyi yöneten tek bir sistem kullanabilirsiniz. Verileri tablolarınıza gerçek zamanlı olarak ekleyebilir ve anında analize hazır hale getirebilirsiniz. Bu, verinizin her zaman güncel olması demektir.
Eski ve yeni verileri yöneten tek bir iş akışı oluşturabilir, böylece tüm sisteminizi daha az karmaşık ve yönetimi daha kolay hale getirebilirsiniz. Bu birleşik yaklaşım veri hatlarınızı basitleştirir.
Veri gölleri için ACID işlemleri
Delta Lake, ACID işlemleriyle veri göllerine güçlü veri güvenilirliği getirir. Örneğin:
- Hastaneler, doğru ve güncel hasta kayıtlarını koruyarak uygun bakım sağlar ve gizlilik kurallarına uyar.
- Bankalar, tüm finansal işlemlerin doğru şekilde kaydedilmesini ve kazara değiştirilememesini sağlar.
- Perakende mağazaları eşzamanlı birçok güncelleme olsa bile stok sayımlarını doğru tutabilir. Bu, gerçekte stokta olmayan ürünlerin satılması gibi sorunları önlemeye yardımcı olur.
Delta Lake bu güvenilirliği, tüm değişikliklerin ya tamamen uygulanmasını ya da hiç uygulanmamasını sağlayarak elde eder. Ayrıca, verilerin her zaman bir geçerli durumdan diğerine taşınmasını ve farklı işlemlerin birbirini etkilememesini garanti eder.
Apache Spark ekosistemi
Delta Lake ayrıca Apache Spark ile sorunsuz çalışır; bu da birçok kuruluş için büyük bir avantajdır. Hâlihazırda Spark kullanıyorsanız, Delta Lake’i eklemek kolay olur ve mevcut kurulumunuzda büyük değişiklikler gerektirmez. Ekibiniz, aşina olduğu aynı Spark araçlarını ve SQL komutlarını kullanmaya devam edebilir.
Sonuç olarak, özellikle büyük veri hacimleriyle uğraşırken Spark işlerinizin daha hızlı çalışmasını sağlar. Bunu, verileri daha verimli şekilde düzenleyerek ve akıllı indeksleme teknikleri kullanarak yapar.
Apache Iceberg vs Delta Lake: Özet
Apache Iceberg ve Delta Lake arasındaki temel farkları özetleyelim; böylece formatların güçlü yönlerini ve kilit özelliklerini hızlıca kavrayabilirsiniz.
|
Özellikler |
Apache Iceberg |
Delta Lake |
|
ACID işlem |
Evet |
Evet |
|
Zaman yolculuğu |
Evet |
Evet |
|
Veri sürümleme |
Evet |
Evet |
|
Dosya formatı |
Parquet, ORC, Avro |
Parquet |
|
Şema evrimi |
Tam |
Kısmi |
|
Diğer motorlarla entegrasyon |
Apache Spark, Trino, Flink |
Ağırlıklı olarak Apache Spark |
|
Bulut Uyumluluğu |
AWS, GCP, Azure |
AWS, GCP |
|
Sorgu Motorları |
Spark, Trino, Flink |
Spark |
|
Programlama Dili |
SQL, Python, Java |
SQL, Python |
Not: En iyi seçim, ihtiyaçlarınıza, ölçeklenebilirlik gereksinimlerinize ve uzun vadeli veri stratejinize bağlıdır.
Sonuç
Apache Iceberg ile Delta Lake arasında seçim yaparken, özel kullanım senaryonuzu ve mevcut teknoloji yığınınızı dikkate alın. Iceberg’in dosya formatları ve sorgu motorlarıyla sunduğu esneklik, onu bulut-yerel ortamlar için ideal kılar. Buna karşılık, Delta Lake’in Apache Spark ile sıkı entegrasyonu, Spark ekosistemine yoğun yatırım yapmış kuruluşlar için iyi bir seçenektir.
Mevcut veri bilginizi güçlendirmek için ilgili bazı DataCamp kaynaklarına da göz atabilirsiniz:
- Understanding Data Engineering dersi ile temel kavramları kavrayın
- Database Design ve Data Warehousing dersleri ile büyük ölçekli veriyi etkili şekilde yapılandırın.
- Modern Data Architecture dersi ile güncel en iyi uygulamaları ve trendleri öğrenin.
İyi öğrenmeler!
SSS
Merge-on-Read ve Merge-on-Write stratejileri arasındaki temel fark nedir?
Merge-on-Read (Iceberg tarafından kullanılır), mevcut dosyalardan verileri okur ve değişiklikleri sorgu sırasında uygular. Merge-on-Write (Delta Lake tarafından kullanılır) ise yazma sürecinde güncellemeleri temel veriye birleştirerek daha hızlı okuma sağlar; bunun bedeli daha yavaş yazma işlemleridir.
Apache Iceberg ve Delta Lake petabayt ölçeğindeki verileri işleyebilir mi?
Evet, hem Apache Iceberg hem de Delta Lake petabayt ölçeğindeki veri kümelerini verimli şekilde işler. Bölümleme, meta veri yönetimi ve sıkıştırma gibi gelişmiş özellikler sunarak büyük veri göllerinde performansı optimize ederler.
Apache Iceberg ve Delta Lake, derin iç içe geçmiş veri yapıları sorgulanırken nasıl performans gösterir?
Apache Iceberg, derin iç içe geçmiş veri yapılarında sorgulamada mükemmeldir. İç içe veriler için optimize edilmiş Parquet gibi tablo depolama formatlarını destekler. Öte yandan Delta Lake de iç içe verileri destekler ancak performansı sorgu karmaşıklığına ve veri kümesinin boyutuna bağlı olarak değişebilir.
Apache Iceberg ve Delta Lake aynı veri gölü mimarisinde birlikte çalışabilir mi?
Evet, Apache Iceberg ve Delta Lake aynı veri gölü içinde bir arada bulunabilir. Gereksinimlere bağlı olarak her biri farklı kullanım durumları için kullanılabilir. Örneğin Apache Spark merkezli iş yükleri için Delta Lake’i, çeşitli sorgu motorlarıyla daha esnek entegrasyon için ise Iceberg’i tercih edebilirsiniz.
Delta Lake’i Spark dışı motorlarla kullanırken sınırlamalar var mı?
Delta Lake, Apache Spark ile sıkı şekilde entegredir; Presto veya Hive gibi diğer motorlarla da çalışabilse de bu entegrasyonlar hâlâ olgunlaşmaktadır. Performans Spark kadar optimize olmayabilir; bu da Spark dışındaki ekosistemlerde etkinliğini sınırlayabilir.
Iceberg ve Delta Lake veri göllerindeki küçük dosya sorunlarını nasıl ele alır?
Hem Apache Iceberg hem de Delta Lake, küçük dosya sorununu sıkıştırma yoluyla ele alır. Iceberg, sorgu performansını optimize etmek için küçük dosyaları periyodik olarak birleştirir; Delta Lake ise yazma işlemleri sırasında dosyaları birleştiren otomatik sıkıştırma kullanır. Bu, çok sayıda küçük dosyanın neden olduğu ek yükü azaltarak daha iyi performans sağlar.
Databricks neden Iceberg’in arkasındaki şirket olan Tabular’ı satın aldı?
Databricks, Apache Iceberg’in kurucularının yer aldığı Tabular’ı satın alarak Iceberg ile ilgili yetkinliklerini güçlendirdi. Bu satın alma, Delta Lake ve Iceberg arasında uyumluluğu ve birlikte çalışabilirliği iyileştirmeyi amaçlar ve nihayetinde her iki açık kaynak projenin güçlü yönlerini birleştiren birleşik bir lakehouse formatına doğru ilerlemeyi hedefler.
Tabular’ın satın alınması Delta Lake ve Iceberg kullanıcıları için ne anlama geliyor?
Bu satın alma, Databricks’in Delta Lake ve Iceberg’i uyumluluk açısından birbirine yaklaştırmak için aktif olarak çalışacağı anlamına gelir. Kullanıcılar geliştirilmiş entegrasyondan faydalanacaktır; Delta Lake UniForm, Delta Lake, Iceberg ve Apache Hudi arasında birlikte çalışabilirliği etkinleştiren bir platform olarak hâlihazırda hizmet vermektedir. Bu sayede kullanıcılar, tek bir çözüme kilitlenmeden farklı formatlarda çalışabilir.
Databricks, hem Delta Lake’i hem de Iceberg’i desteklemeye devam edecek mi?
Evet, Databricks her iki formata da bağlılığını ifade etti. Tabular’ı satın alıp Apache Iceberg’in orijinal yaratıcılarını bünyesine katarak Databricks, Iceberg ve Delta Lake toplulukları arasında işbirliğini teşvik etmeyi hedefliyor. Amaç, lakehouse formatları arasında birlikte çalışabilirlik için tek ve açık bir standart geliştirmek; bu da kullanıcılara daha fazla seçenek ve esneklik sağlayacaktır.
Karmaşık konuları basitleştirmeyi seven bir içerik stratejistiyim. Splunk, Hackernoon ve Tiiny Host gibi şirketlerin hedef kitleleri için ilgi çekici ve bilgilendirici içerikler üretmelerine yardımcı oldum.


