Khóa học
Xử lý dữ liệu lớn thường liên quan đến dữ liệu phi cấu trúc, điều này có thể khó quản lý và phân tích. Xóa nhầm hoặc các lỗi khác có thể xảy ra ở bất kỳ thời điểm nào — gây rủi ro lớn cho tính toàn vẹn dữ liệu.
Apache Iceberg và Delta Lake là các định dạng bảng mã nguồn mở, chủ yếu dùng để quản lý data lake và lakehouse quy mô lớn. Cả hai nền tảng đều cung cấp các tính năng như tiến hóa lược đồ, du hành thời gian và giao dịch ACID nhằm giải quyết thách thức khi xử lý tập dữ liệu khổng lồ. Mỗi công nghệ có lợi thế riêng, nhưng đều hướng đến mục tiêu chung: duy trì tính nhất quán dữ liệu trên toàn bộ tập dữ liệu.
Trong bài viết này, tôi sẽ giải thích các tính năng chính, điểm tương đồng và khác biệt về kiến trúc giữa Apache Iceberg và Delta Lake để giúp bạn chọn công cụ phù hợp với nhu cầu.
Apache Iceberg là gì?

Được Netflix phát triển và sau đó đóng góp cho Apache Software Foundation, Iceberg nhằm giải quyết các thách thức trong quản lý data lake quy mô lớn. Đây là định dạng hiệu năng cao cho các bảng phân tích lớn, quản lý và truy vấn tập dữ liệu khổng lồ một cách hiệu quả. Các tính năng của Iceberg khắc phục nhiều hạn chế của cách lưu trữ data lake truyền thống.
Hãy cùng tìm hiểu chi tiết hơn về Apache Iceberg.
Tính năng của Apache Iceberg
Dưới đây là một số tính năng nổi bật nhất của Apache Iceberg, rất hữu ích cho kỹ sư dữ liệu khi làm việc với tập dữ liệu.
- Tiến hóa lược đồ (Schema evolution): Trong các cơ sở dữ liệu truyền thống, thay đổi cấu trúc dữ liệu (như thêm cột mới) có thể rất phiền toái. Iceberg giúp việc này trở nên dễ dàng. Ví dụ, nếu bạn đang theo dõi dữ liệu khách hàng và muốn thêm trường
loyalty_points, bạn có thể thực hiện mà không ảnh hưởng đến dữ liệu hiện có hoặc làm hỏng các truy vấn hiện tại. Tính linh hoạt này đặc biệt hữu ích cho các dự án dữ liệu dài hạn cần thích ứng theo thời gian. - Phân vùng (Partitioning): Giúp tổ chức dữ liệu thành các phần nhỏ, dễ quản lý hơn. Điều này làm truy vấn nhanh hơn vì bạn không phải tìm trong toàn bộ dữ liệu mỗi lần. Ví dụ, tôi có một tập dữ liệu hồ sơ bán hàng khổng lồ. Iceberg có thể tự động tổ chức dữ liệu này theo ngày, địa điểm hoặc bất kỳ yếu tố liên quan nào khác.
- Du hành thời gian (Time travel): Tính năng này cho phép bạn dễ dàng truy cập các phiên bản dữ liệu lịch sử. Nếu ai đó vô tình xóa thông tin quan trọng hoặc bạn cần so sánh dữ liệu hiện tại với trạng thái trước đây, bạn có thể quay lại một thời điểm cụ thể. Các truy vấn theo điểm thời gian này giúp đơn giản hóa việc kiểm toán và khôi phục dữ liệu.
- Tính toàn vẹn dữ liệu (Data integrity): Hỏng dữ liệu có thể xảy ra vì nhiều lý do như sự cố mạng, vấn đề lưu trữ hoặc lỗi phần mềm. Iceberg sử dụng các kỹ thuật toán học (checksum) để phát hiện ngay cả khi chỉ một bit dữ liệu bị thay đổi bất ngờ. Điều này đảm bảo dữ liệu bạn đang phân tích chính xác là dữ liệu đã được lưu trữ ban đầu.
- Nén gộp và tối ưu hóa (Compaction and optimization): Theo thời gian, hệ thống dữ liệu có thể bị lộn xộn với nhiều tệp nhỏ, làm chậm xử lý. Iceberg định kỳ dọn dẹp bằng cách gộp các tệp nhỏ và tổ chức dữ liệu hiệu quả hơn.
Những tính năng này khiến Iceberg đặc biệt phù hợp cho phân tích dữ liệu quy mô lớn, nhất là khi bạn xử lý dữ liệu thường xuyên thay đổi hoặc cần truy cập theo nhiều cách trong thời gian dài.
Xem bài viết Giải thích về Apache Iceberg để tìm hiểu sâu hơn về công nghệ thú vị này.
Delta Lake là gì?

Được Databricks phát triển, Delta Lake tích hợp mượt mà với Spark, trở thành lựa chọn phổ biến cho các tổ chức đã đầu tư vào hệ sinh thái Spark. Đây là một lớp lưu trữ mã nguồn mở đưa giao dịch ACID (Atomicity, Consistency, Isolation, Durability) vào Apache Spark và các tác vụ dữ liệu lớn.
Các lakehouse dựa trên Delta Lake hợp lý hóa kho dữ liệu và học máy để duy trì chất lượng dữ liệu thông qua metadata có thể mở rộng, quản lý phiên bản và thực thi lược đồ.
Tính năng của Delta Lake
Dưới đây là các tính năng then chốt khiến Delta Lake trở thành giải pháp tốt cho xử lý dữ liệu hiện đại:
- Giao dịch ACID: Các data lake truyền thống thường gặp khó khăn trong việc duy trì tính nhất quán. Để khắc phục, Delta Lake đưa các thuộc tính ACID vốn gắn với cơ sở dữ liệu vào data lake. Điều này có nghĩa bạn có thể thực hiện các thao tác phức tạp trên dữ liệu mà không lo hỏng hay không nhất quán, ngay cả khi có sự cố giữa chừng.
- Phiên bản dữ liệu và du hành thời gian: Khi các quy định dữ liệu như GDPR ngày càng nghiêm ngặt, theo dõi thay đổi dữ liệu theo thời gian trở nên vô giá. Tính năng du hành thời gian của Delta Lake cho phép bạn truy cập và khôi phục các phiên bản dữ liệu trước đây. Điều này hữu ích cho tuân thủ và chạy thử nghiệm với các phiên bản dữ liệu khác nhau.
- Hợp nhất batch và streaming: Truyền thống, các tổ chức cần hệ thống riêng cho xử lý theo lô (batch) và xử lý luồng (thời gian thực). Delta Lake thu hẹp khoảng cách này để bạn có thể dùng cùng một hệ thống cho cả hai. Điều này đơn giản hóa kiến trúc dữ liệu và cho phép xây dựng pipeline linh hoạt hơn.
- Xử lý metadata có khả năng mở rộng: Khi dữ liệu tăng đến quy mô petabyte, quản lý metadata (dữ liệu về dữ liệu) trở nên khó khăn. Nhiều hệ thống bị chậm đáng kể khi phải xử lý hàng triệu tệp. Tuy nhiên, Delta Lake có thể xử lý quy mô khổng lồ mà không suy giảm hiệu năng, phù hợp với data lake rất lớn.
- Tối ưu đọc và ghi: Hiệu năng là yếu tố sống còn trong bối cảnh dữ liệu lớn. Delta Lake tích hợp bỏ qua dữ liệu (data skipping), bộ nhớ đệm và nén gộp để tăng tốc thao tác đọc/ghi. Điều này mang lại truy vấn nhanh hơn và sử dụng tài nguyên tính toán hiệu quả hơn, giúp tiết kiệm chi phí trên đám mây.
Khóa học Những điều căn bản về Big Data với PySpark đi sâu vào xử lý dữ liệu hiện đại với Spark. Đây là phần ôn tập tuyệt vời về công nghệ mạnh mẽ này.
Apache Iceberg và Delta Lake: Điểm tương đồng
Vì Apache Iceberg và Delta Lake đều quản lý lượng dữ liệu lớn, hãy xem các điểm tương đồng cơ bản của chúng.
Giao dịch ACID và tính nhất quán dữ liệu
Cả hai công cụ đều có thể cung cấp tính nhất quán dữ liệu đầy đủ bằng giao dịch ACID và quản lý phiên bản. Tuy nhiên, Iceberg sử dụng cách tiếp cận merge-on-read, trong khi Delta Lake dùng chiến lược merge-on-write.
Do đó, mỗi công cụ xử lý hiệu năng và quản lý dữ liệu khác nhau. Iceberg có thể hỗ trợ tiến hóa lược đồ đầy đủ, còn Delta Lake thực thi tuân thủ lược đồ.
Hỗ trợ du hành thời gian
Chức năng du hành thời gian cho phép người dùng truy vấn các phiên bản dữ liệu trong quá khứ. Điều này vô cùng hữu ích cho kiểm toán, gỡ lỗi và thậm chí tái lập thí nghiệm. Cả Iceberg và Delta Lake đều hỗ trợ du hành thời gian, nghĩa là bạn có thể truy cập các trạng thái dữ liệu trước đó mà không phải lo lắng.
Tính mã nguồn mở
Apache Iceberg và Delta Lake là công nghệ mã nguồn mở. Điều này có nghĩa bất kỳ ai cũng có thể sử dụng miễn phí và thậm chí đóng góp cải tiến. Ngoài ra, là mã nguồn mở giúp bạn không bị ràng buộc vào sản phẩm của một công ty — bạn có nhiều tự do hơn để chuyển đổi hoặc kết hợp công cụ khi cần. Và vì mã nguồn công khai, bạn còn có thể tối ưu cho nhu cầu cụ thể của mình.
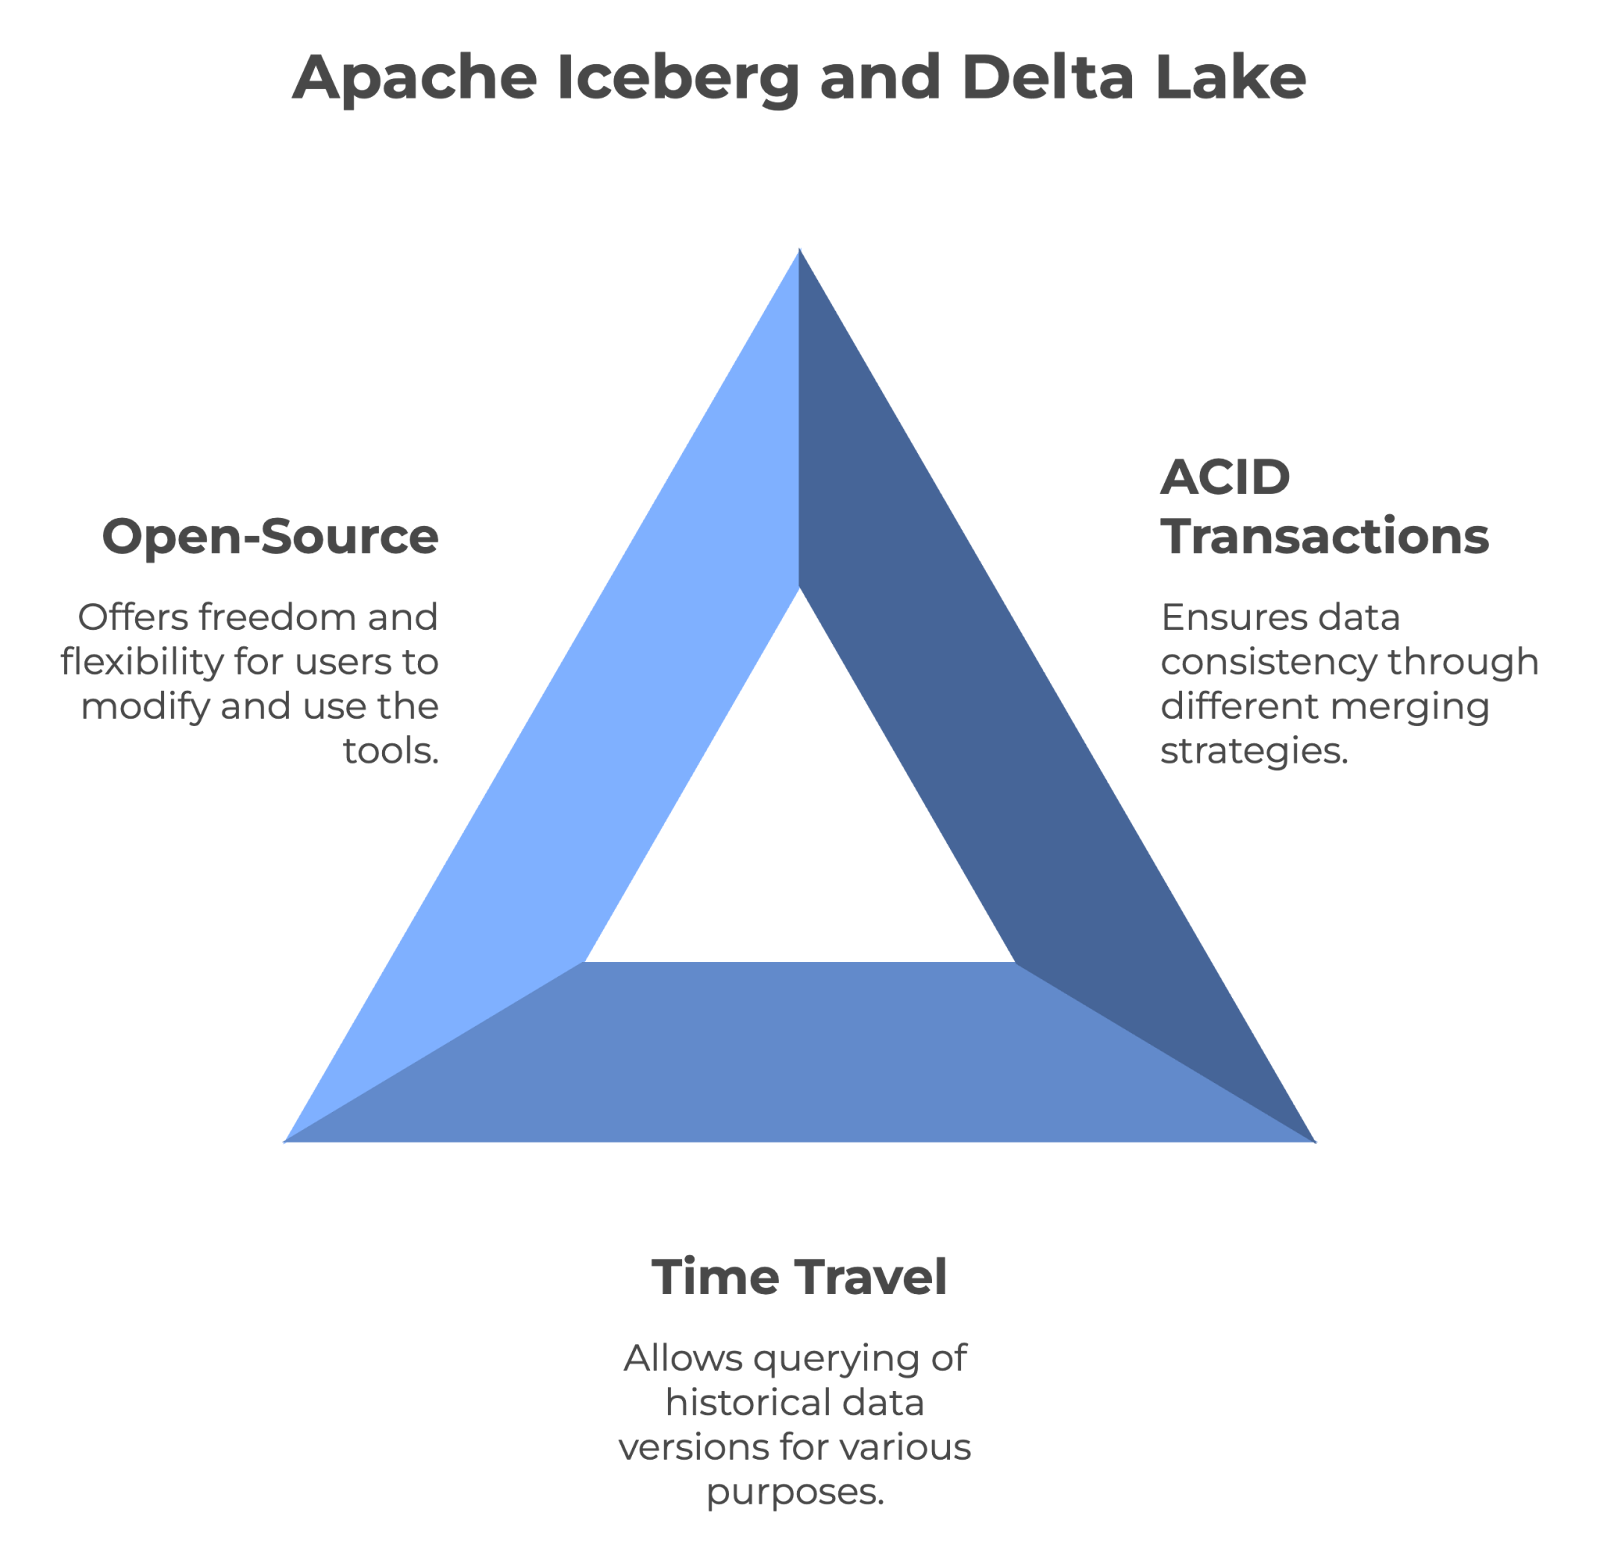
Các tính năng chính mà Apache Iceberg và Delta Lake cùng chia sẻ. Hình ảnh do Tác giả tạo bằng napkin.ai.
Iceberg vs Delta Lake: Khác biệt kiến trúc cốt lõi
Dù Iceberg và Delta Lake có nhiều điểm giống nhau, chúng khác nhau về kiến trúc. Hãy xem chi tiết:
Mô hình giao dịch
Iceberg và Delta Lake đảm bảo độ tin cậy dữ liệu trong data lake, nhưng đạt được điều này bằng các cơ chế khác nhau. Iceberg sử dụng snapshot cho các giao dịch nguyên tử để đảm bảo thay đổi được cam kết hoàn toàn hoặc bị hoàn tác. Còn Delta Lake dùng nhật ký giao dịch để đảm bảo chỉ những thay đổi đã được xác thực mới được ghi vào bảng, cung cấp độ tin cậy cho cập nhật dữ liệu.
Quản lý metadata
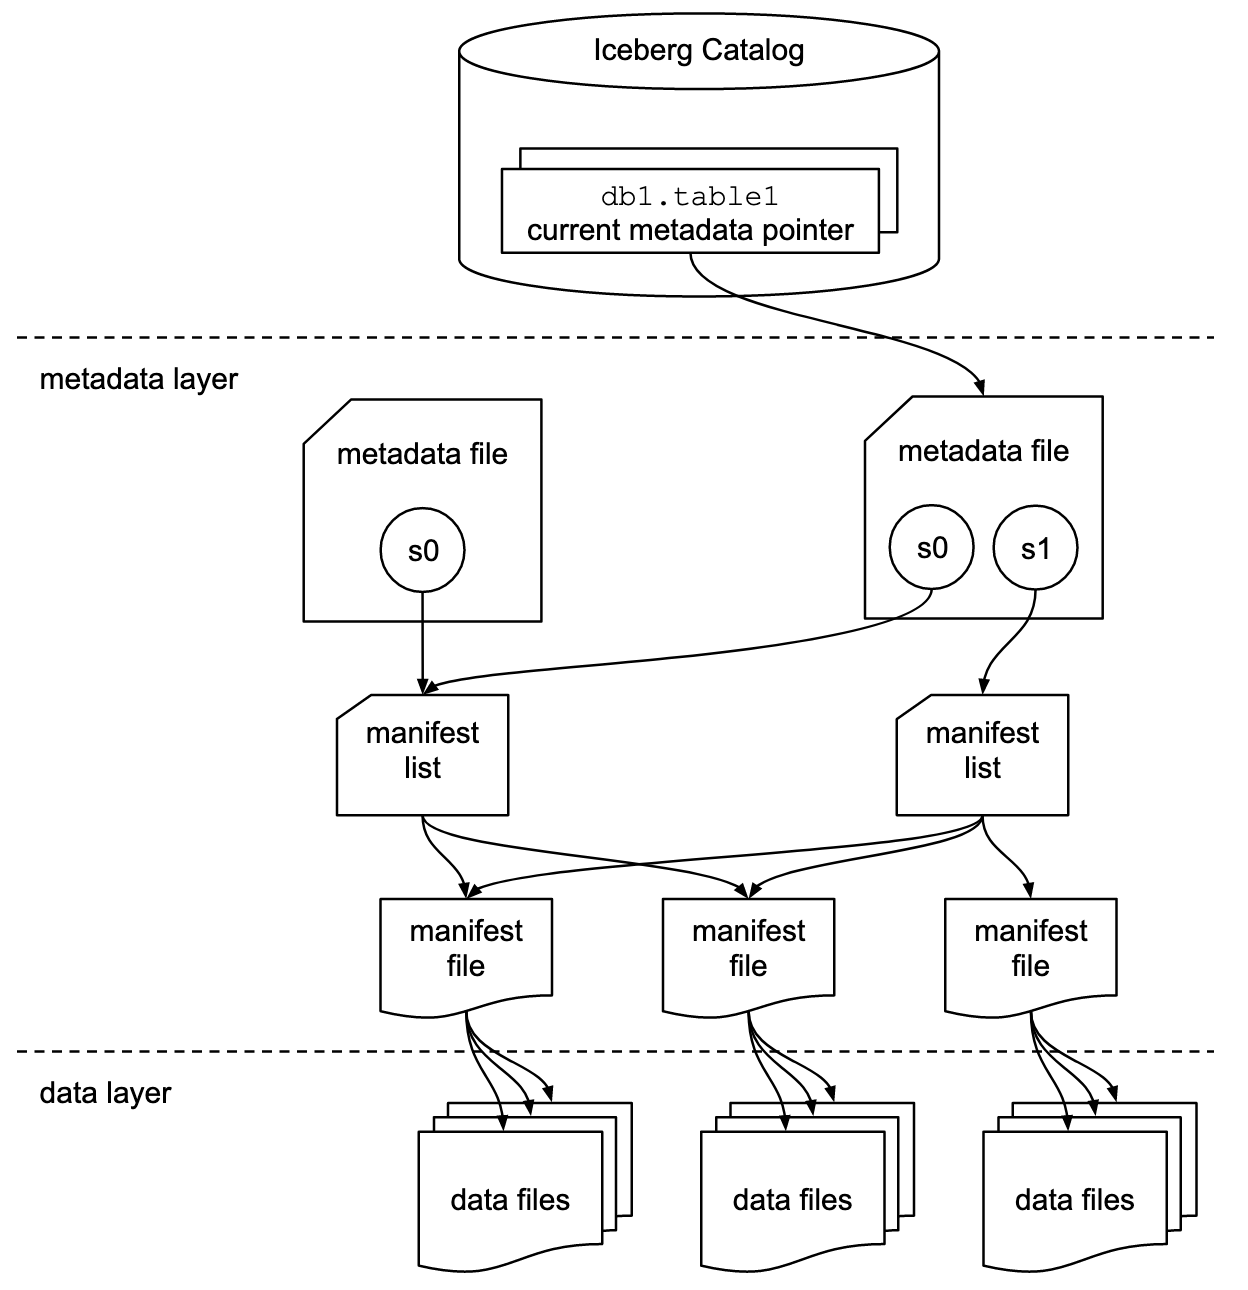
Apache Iceberg sử dụng cấu trúc metadata phân cấp, bao gồm tệp manifest, danh sách manifest và tệp metadata. Thiết kế này tối ưu xử lý truy vấn bằng cách loại bỏ các thao tác tốn kém như liệt kê và đổi tên tệp.
Trong khi đó, Delta Lake áp dụng cách tiếp cận dựa trên giao dịch để ghi lại mỗi giao dịch vào một log. Để tăng hiệu quả truy vấn và đơn giản hóa quản lý log, nó định kỳ hợp nhất các log này vào các tệp checkpoint Parquet ghi lại trạng thái đầy đủ của bảng.
Tương thích định dạng tệp
Iceberg linh hoạt với định dạng tệp và có thể làm việc trực tiếp với Parquet, ORC và Avro. Điều này hữu ích nếu bạn có dữ liệu ở các định dạng khác nhau hoặc muốn chuyển đổi định dạng trong tương lai mà không cần thay đổi toàn bộ hệ thống.
Delta Lake chủ yếu lưu dữ liệu ở định dạng Parquet vì Parquet hiệu quả, đặc biệt cho truy vấn phân tích. Nó tập trung vào một định dạng để mang lại hiệu năng tốt nhất cho loại tệp đó.
Hiệu năng và khả năng mở rộng
Iceberg và Delta Lake đều mở rộng data lake nhưng dùng chiến lược khác nhau. Iceberg ưu tiên tổ chức dữ liệu nâng cao với các tính năng như phân vùng và nén gộp, trong khi Delta Lake nhấn mạnh hiệu năng cao thông qua Delta Engine, tự động nén gộp và khả năng lập chỉ mục.
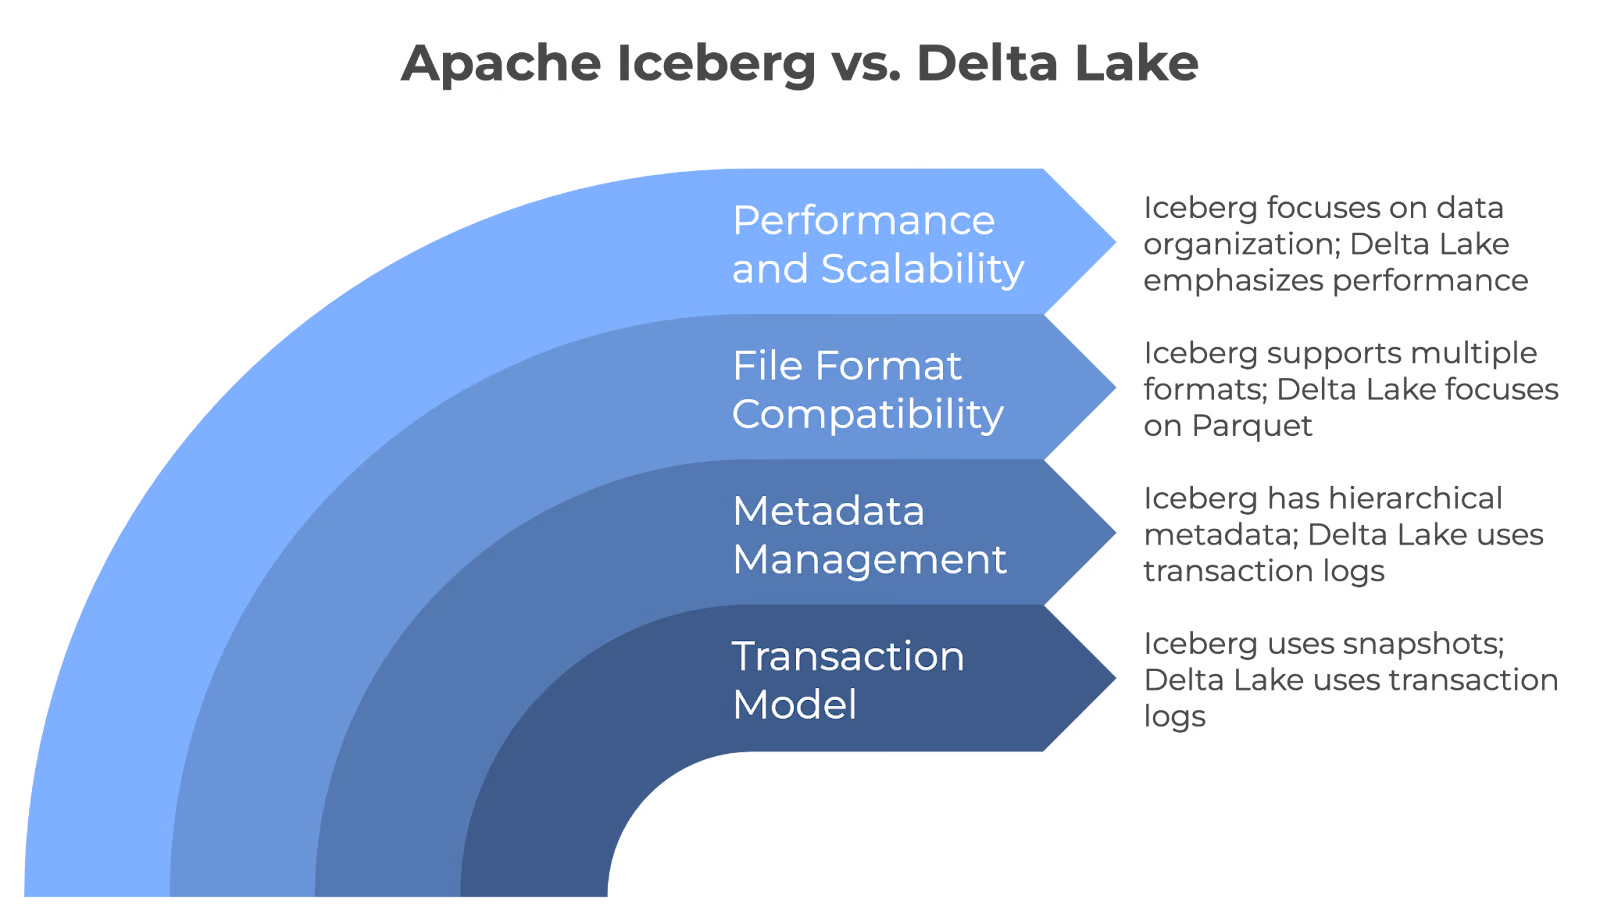
Những khác biệt cốt lõi giữa Apache Iceberg và Delta Lake. Hình ảnh do Tác giả tạo bằng napkin.ai.
Trường hợp sử dụng của Apache Iceberg
Nhờ các tính năng độc đáo, Apache Iceberg nhanh chóng trở thành giải pháp ưa chuộng cho quản lý data lake hiện đại. Hãy xem một số trường hợp sử dụng chính để hiểu rõ điểm mạnh của nó.
Data lake thuần đám mây
Đây là lý do Iceberg được ưa chuộng cho các tổ chức xây dựng data lake vận hành ở quy mô đám mây:
- Tiến hóa lược đồ mạnh mẽ: Cho phép thêm, bỏ hoặc sửa cột mà không ảnh hưởng đến truy vấn hiện có. Ví dụ, nếu bạn cần thêm trường mới để theo dõi sở thích người dùng, bạn có thể làm mà không phải dựng lại toàn bộ tập dữ liệu hoặc cập nhật mọi truy vấn.
- Hiệu năng: Các kỹ thuật nâng cao như gom cụm dữ liệu và quản lý metadata tối ưu hiệu năng truy vấn. Chúng nhanh chóng loại bỏ các tệp dữ liệu không cần thiết để giảm lượng dữ liệu quét và tăng tốc truy vấn.
- Khả năng mở rộng: Quản lý hàng tỷ tệp và petabyte dữ liệu. Ngoài ra, tính năng tiến hóa phân vùng cho phép bạn thay đổi cách tổ chức dữ liệu mà không cần downtime hoặc di chuyển tốn kém.
Mô hình dữ liệu phức tạp
Các đội ngũ làm việc với mô hình dữ liệu phức tạp thấy Iceberg đặc biệt hữu ích vì những điều sau:
- Linh hoạt lược đồ: Hỗ trợ kiểu dữ liệu lồng nhau (struct, list và map) để biểu diễn quan hệ phức tạp. Ví dụ, một nền tảng thương mại điện tử có thể lưu chi tiết đơn hàng, bao gồm cấu trúc lồng nhau cho mặt hàng và dữ liệu khách hàng, tất cả trong một bảng.
- Truy vấn du hành thời gian: Phương thức này duy trì snapshot dữ liệu để truy vấn dữ liệu như tồn tại ở bất kỳ thời điểm nào trong quá khứ. Điều này vô giá để tái dựng trạng thái dữ liệu cho mục đích tuân thủ hoặc chạy lại phân tích trên các snapshot lịch sử.
Tích hợp với công cụ
Iceberg tương thích với nhiều công cụ, khiến nó trở thành lựa chọn linh hoạt trong hệ sinh thái dữ liệu. Hãy cùng điểm qua một số tích hợp chính:
Iceberg hoạt động mượt mà với:
- Apache Spark cho xử lý dữ liệu quy mô lớn và học máy.
- Trino cho các truy vấn SQL phân tán nhanh trên nhiều nguồn dữ liệu.
- Apache Flink cho xử lý luồng thời gian thực và tính toán theo lô.
Các nhà cung cấp đám mây lớn sau đây hỗ trợ Iceberg ở mức độ bản địa:
- Amazon Web Services (AWS) tích hợp với AWS Glue, Redshift, EMR và Athena.
- Google Cloud Platform (GCP) làm việc với BigQuery và Dataproc.
- Microsoft Azure tương thích với Azure Synapse Analytics.
Iceberg cũng cung cấp thư viện khách cho nhiều ngôn ngữ lập trình, chẳng hạn như:
- SQL viết các truy vấn SQL chuẩn trên bảng Iceberg.
- Python dùng PySpark hoặc thư viện như pyiceberg để thao tác dữ liệu.
- Java tận dụng API Java gốc cho các thao tác mức thấp và tích hợp tùy chỉnh.

Đặc tả định dạng bảng Apache Iceberg. Nguồn ảnh: Tài liệu Iceberg.
Trường hợp sử dụng của Delta Lake
Delta Lake có thể giải quyết các thách thức phổ biến và giúp quản lý dữ liệu dễ dàng hơn. Hãy xem một số tình huống chính nơi nó thực sự phát huy tác dụng.
Hợp nhất khối lượng công việc batch và streaming
Với Delta Lake, bạn không cần hệ thống riêng cho các loại dữ liệu khác nhau. Thay vào đó, bạn có thể có một hệ thống xử lý tất cả. Bạn có thể thêm dữ liệu mới vào bảng theo thời gian thực và dữ liệu sẵn sàng để phân tích ngay lập tức. Điều này có nghĩa dữ liệu của bạn luôn cập nhật.
Bạn có thể xây dựng một quy trình làm việc duy nhất xử lý cả dữ liệu cũ và mới để giúp toàn bộ hệ thống bớt phức tạp và dễ quản lý hơn. Cách tiếp cận hợp nhất này sẽ đơn giản hóa pipeline dữ liệu của bạn.
Giao dịch ACID cho data lake
Delta Lake mang lại độ tin cậy dữ liệu mạnh mẽ cho data lake thông qua giao dịch ACID. Ví dụ:
- Bệnh viện có thể duy trì hồ sơ bệnh nhân chính xác và cập nhật để chăm sóc đúng và tuân thủ quy định về quyền riêng tư.
- Ngân hàng có thể đảm bảo mọi giao dịch tài chính được ghi nhận chính xác và không thể vô tình bị thay đổi.
- Cửa hàng bán lẻ có thể giữ số lượng tồn kho chính xác, ngay cả khi có nhiều cập nhật diễn ra đồng thời. Điều này giúp tránh các vấn đề như bán hàng hóa không còn trong kho.
Delta Lake đạt được độ tin cậy này bằng cách đảm bảo mọi thay đổi hoặc được áp dụng hoàn toàn hoặc không áp dụng. Ngoài ra, nó đảm bảo dữ liệu luôn chuyển từ trạng thái hợp lệ này sang trạng thái hợp lệ khác và các thao tác khác nhau không can thiệp lẫn nhau.
Hệ sinh thái Apache Spark
Delta Lake cũng hoạt động mượt mà với Apache Spark, là lợi thế lớn cho nhiều tổ chức. Nếu bạn đã dùng Spark, bổ sung Delta Lake sẽ đơn giản và không đòi hỏi thay đổi lớn trong thiết lập hiện tại. Đội ngũ của bạn có thể dùng các công cụ Spark và câu lệnh SQL quen thuộc.
Nhờ đó, các job Spark của bạn sẽ chạy nhanh hơn, đặc biệt khi xử lý lượng dữ liệu lớn. Delta Lake làm điều này bằng cách tổ chức dữ liệu hiệu quả hơn và sử dụng kỹ thuật lập chỉ mục thông minh.
Apache Iceberg vs Delta Lake: Tóm tắt
Hãy tóm tắt các khác biệt chính giữa Apache Iceberg và Delta Lake để bạn nhanh chóng nắm bắt điểm mạnh và tính năng cốt lõi của mỗi định dạng.
|
Tính năng |
Apache Iceberg |
Delta Lake |
|
Giao dịch ACID |
Có |
Có |
|
Du hành thời gian |
Có |
Có |
|
Quản lý phiên bản dữ liệu |
Có |
Có |
|
Định dạng tệp |
Parquet, ORC, Avro |
Parquet |
|
Tiến hóa lược đồ |
Đầy đủ |
Một phần |
|
Tích hợp với engine khác |
Apache Spark, Trino, Flink |
Chủ yếu Apache Spark |
|
Tương thích đám mây |
AWS, GCP, Azure |
AWS, GCP |
|
Công cụ truy vấn |
Spark, Trino, Flink |
Spark |
|
Ngôn ngữ lập trình |
SQL, Python, Java |
SQL, Python |
Lưu ý: Lựa chọn tốt nhất phụ thuộc vào nhu cầu, yêu cầu mở rộng và chiến lược dữ liệu dài hạn của bạn.
Kết luận
Khi lựa chọn giữa Apache Iceberg và Delta Lake, hãy cân nhắc trường hợp sử dụng cụ thể và hệ công nghệ hiện có. Tính linh hoạt của Iceberg với định dạng tệp và engine truy vấn khiến nó lý tưởng cho môi trường thuần đám mây. Trong khi đó, việc tích hợp chặt chẽ của Delta Lake với Apache Spark là lựa chọn phù hợp cho các tổ chức đầu tư mạnh vào hệ sinh thái Spark.
Bạn cũng có thể xem một số tài nguyên liên quan trên DataCamp để củng cố hiểu biết dữ liệu hiện có:
- Understanding Data Engineering khóa học để nắm bắt các khái niệm nền tảng
- Database Design và Data Warehousing các khóa học để cấu trúc dữ liệu quy mô lớn hiệu quả.
- Modern Data Architecture khóa học để tìm hiểu các thực tiễn và xu hướng hiện nay.
Chúc bạn học tốt!
FAQs
Sự khác biệt chính giữa chiến lược Merge-on-Read và Merge-on-Write là gì?
Merge-on-Read (dùng bởi Iceberg) đọc dữ liệu từ các tệp hiện có và áp dụng thay đổi vào lúc truy vấn. Merge-on-Write (dùng bởi Delta Lake) gộp các cập nhật vào dữ liệu gốc trong quá trình ghi để đảm bảo đọc nhanh hơn, đổi lại ghi chậm hơn.
Apache Iceberg và Delta Lake có xử lý được dữ liệu quy mô petabyte không?
Có, cả Apache Iceberg và Delta Lake đều xử lý hiệu quả các tập dữ liệu ở quy mô petabyte. Chúng cung cấp các tính năng nâng cao như phân vùng, quản lý metadata và nén gộp để tối ưu hiệu năng data lake lớn.
Apache Iceberg và Delta Lake hoạt động ra sao khi truy vấn cấu trúc dữ liệu lồng sâu?
Apache Iceberg rất xuất sắc trong truy vấn các cấu trúc dữ liệu lồng sâu. Nó hỗ trợ các định dạng lưu trữ dạng bảng như Parquet, vốn được tối ưu cho dữ liệu lồng nhau. Ở chiều ngược lại, Delta Lake cũng hỗ trợ dữ liệu lồng nhau, nhưng hiệu năng có thể khác nhau tùy độ phức tạp truy vấn và kích thước tập dữ liệu.
Apache Iceberg và Delta Lake có thể hoạt động cùng nhau trong cùng một kiến trúc data lake không?
Có, cả Apache Iceberg và Delta Lake đều có thể cùng tồn tại trong cùng một data lake. Mỗi công cụ có thể dùng cho trường hợp khác nhau tùy yêu cầu. Ví dụ, bạn có thể dùng Delta Lake cho khối lượng công việc xoay quanh Apache Spark và Iceberg cho tích hợp linh hoạt hơn với nhiều engine truy vấn.
Có hạn chế nào khi dùng Delta Lake với các engine không phải Spark không?
Delta Lake được tích hợp chặt chẽ với Apache Spark, và dù có thể hoạt động với các engine khác như Presto hoặc Hive, những tích hợp này vẫn đang phát triển. Hiệu năng có thể không được tối ưu như với Spark, điều này có thể hạn chế hiệu quả khi dùng ngoài hệ sinh thái Spark.
Iceberg và Delta Lake xử lý vấn đề tệp nhỏ trong data lake như thế nào?
Cả Apache Iceberg và Delta Lake đều giải quyết vấn đề tệp nhỏ thông qua nén gộp. Iceberg định kỳ gộp các tệp nhỏ để tối ưu hiệu năng truy vấn, trong khi Delta Lake dùng tự động nén gộp để hợp nhất tệp trong quá trình ghi. Điều này đảm bảo hiệu năng tốt hơn bằng cách giảm chi phí do quá nhiều tệp nhỏ gây ra.
Vì sao Databricks mua lại Tabular (công ty đứng sau Iceberg)?
Databricks đã mua lại Tabular để tăng cường năng lực với Apache Iceberg, vốn do những người sáng lập Tabular tạo ra. Thương vụ nhằm cải thiện khả năng tương thích và tương tác giữa Delta Lake và Iceberg, hướng đến một định dạng lakehouse thống nhất kết hợp thế mạnh của cả hai dự án mã nguồn mở.
Việc mua lại Tabular có ý nghĩa gì cho người dùng Delta Lake và Iceberg?
Thương vụ này đồng nghĩa Databricks sẽ tích cực thúc đẩy đưa Delta Lake và Iceberg xích lại gần nhau hơn về mặt tương thích. Người dùng sẽ hưởng lợi từ tích hợp được cải thiện, với Delta Lake UniForm đã đóng vai trò nền tảng cho khả năng tương tác giữa Delta Lake, Iceberg và Apache Hudi. Điều này cho phép người dùng làm việc trên nhiều định dạng mà không bị khóa vào một giải pháp duy nhất.
Databricks có tiếp tục hỗ trợ cả Delta Lake và Iceberg không?
Có, Databricks đã thể hiện cam kết với cả hai định dạng. Bằng việc mua lại Tabular và đưa những người tạo ra Apache Iceberg về cùng một nhà, Databricks muốn thúc đẩy hợp tác giữa cộng đồng Iceberg và Delta Lake. Mục tiêu là phát triển một tiêu chuẩn mở duy nhất cho khả năng tương tác định dạng lakehouse, mang lại cho người dùng nhiều lựa chọn và linh hoạt hơn.
Tôi là một chiến lược gia nội dung, yêu thích việc đơn giản hóa các chủ đề phức tạp. Tôi đã giúp các công ty như Splunk, Hackernoon và Tiiny Host tạo nội dung hấp dẫn và giàu thông tin cho khán giả của họ.
