
Apache Iceberg और Delta Lake: समानताएँ
क्योंकि Apache Iceberg और Delta Lake दोनों बड़े पैमाने पर डेटा का प्रबंधन करते हैं, आइए उनकी बुनियादी समानताओं की जाँच करें।
ACID ट्रांज़ैक्शन्स और डेटा स्थिरता
दोनों टूल्स ACID ट्रांज़ैक्शन्स और वर्ज़निंग का उपयोग करके पूर्ण डेटा स्थिरता प्रदान कर सकते हैं। हालाँकि, Iceberg मर्ज-ऑन-रीड दृष्टिकोण अपनाता है, जबकि Delta Lake मर्ज-ऑन-राइट रणनीति का उपयोग करता है।
नतीजतन, दोनों परफ़ॉर्मेंस और डेटा मैनेजमेंट को अलग-अलग तरीके से संभालते हैं। Iceberg पूर्ण स्कीमा इवोल्यूशन सपोर्ट प्रदान कर सकता है, जबकि Delta Lake स्कीमा अनुपालन लागू कराता है।
टाइम ट्रेवल का समर्थन
टाइम ट्रेवल फंक्शनैलिटी उपयोगकर्ताओं को डेटा के ऐतिहासिक वर्ज़न्स पर क्वेरी करने देती है। यह ऑडिटिंग, डिबगिंग और यहाँ तक कि प्रयोगों को पुन:उत्पादित करने के लिए अमूल्य साबित होती है। Iceberg और Delta Lake दोनों टाइम ट्रेवल सपोर्ट करते हैं, जिसका अर्थ है कि आप निश्चिंत होकर डेटा की पिछली अवस्थाओं तक पहुँच सकते हैं।
ओपन-सोर्स प्रकृति
Apache Iceberg और Delta Lake ओपन-सोर्स टेक्नोलॉजीज़ हैं। इसका मतलब है कि कोई भी इन्हें मुफ़्त में इस्तेमाल कर सकता है और इन्हें बेहतर बनाने में योगदान भी दे सकता है। साथ ही, ओपन-सोर्स होने का अर्थ है कि आप किसी एक कंपनी के प्रोडक्ट से बँधे नहीं हैं — जरूरत पड़ने पर आपके पास टूल्स बदलने या मिलाकर इस्तेमाल करने की अधिक स्वतंत्रता होती है। और क्योंकि इनका कोड सार्वजनिक है, आप इसे अपनी विशिष्ट ज़रूरतों के लिए ऑप्टिमाइज़ भी कर सकते हैं।
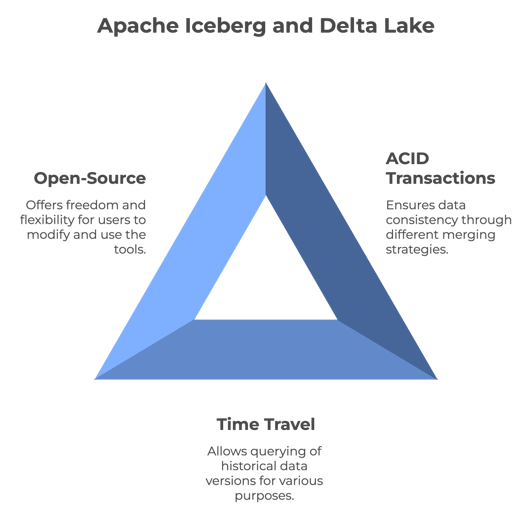
Apache Iceberg और Delta Lake द्वारा साझा किए गए मुख्य फीचर्स। इमेज: लेखक द्वारा napkin.ai से बनाई गई।
Iceberg बनाम Delta Lake: मुख्य आर्किटेक्चरल अंतर
यद्यपि Iceberg और Delta Lake में समानताएँ हैं, वे आर्किटेक्चर में भिन्न हैं। आइए देखें कैसे:
ट्रांज़ैक्शन मॉडल
Iceberg और Delta Lake डेटा लेक्स में डेटा विश्वसनीयता सुनिश्चित करते हैं, लेकिन वे इसे अलग-अलग तंत्रों के माध्यम से प्राप्त करते हैं। Iceberg एटॉमिक ट्रांज़ैक्शन्स के लिए स्नैपशॉट्स का उपयोग करता है ताकि बदलाव पूरी तरह कमिट हों या रोल बैक। लेकिन Delta Lake ट्रांज़ैक्शन लॉग्स का उपयोग करता है ताकि केवल वैलिडेटेड बदलाव ही टेबल में कमिट हों और डेटा अपडेट्स में विश्वसनीयता मिले।
मेटाडेटा प्रबंधन
Apache Iceberg एक पदानुक्रमित मेटाडेटा संरचना अपनाता है, जिसमें मैनिफ़ेस्ट फ़ाइलें, मैनिफ़ेस्ट लिस्ट्स और मेटाडेटा फ़ाइलें शामिल हैं। यह डिज़ाइन फ़ाइल लिस्टिंग और रीनेमिंग जैसी महंगी प्रक्रियाओं को समाप्त कर क्वेरी प्रोसेसिंग को सुव्यवस्थित करता है।
वहीं, Delta Lake प्रत्येक ट्रांज़ैक्शन को लॉग में रिकॉर्ड करने के लिए ट्रांज़ैक्शन-आधारित दृष्टिकोण अपनाता है। क्वेरी दक्षता बढ़ाने और लॉग प्रबंधन को सरल बनाने के लिए, यह समय-समय पर इन लॉग्स को Parquet चेकपॉइंट फ़ाइलों में समेकित करता है, जो पूरी टेबल स्टेट को कैप्चर करती हैं।
फ़ाइल फ़ॉर्मेट संगतता
Iceberg फ़ाइल फ़ॉर्मेट्स के साथ लचीला है और Parquet, ORC और Avro फ़ाइलों के साथ मूल रूप से काम कर सकता है। यह तब सहायक होता है जब आपके पास अलग-अलग फ़ॉर्मेट्स में डेटा हो या आप भविष्य में बिना पूरी प्रणाली बदले फ़ॉर्मेट बदलना चाहें।
Delta Lake मुख्य रूप से डेटा को Parquet फ़ॉर्मेट में स्टोर करता है क्योंकि Parquet विशेषकर विश्लेषणात्मक क्वेरीज़ के लिए कुशल है। यह सर्वश्रेष्ठ संभव परफ़ॉर्मेंस देने के लिए केवल एक फ़ॉर्मेट पर फ़ोकस करता है।
परफ़ॉर्मेंस और स्केलेबिलिटी
Iceberg और Delta Lake डेटा लेक्स को स्केल करते हैं, लेकिन अलग-अलग रणनीतियाँ अपनाते हैं। Iceberg उन्नत डेटा संगठन को प्राथमिकता देता है, जैसे पार्टिशनिंग और कम्पैक्शन, जबकि Delta Lake Delta Engine, ऑटो कम्पैक्शन और इंडेक्सिंग क्षमताओं के माध्यम से उच्च परफ़ॉर्मेंस पर ज़ोर देता है।
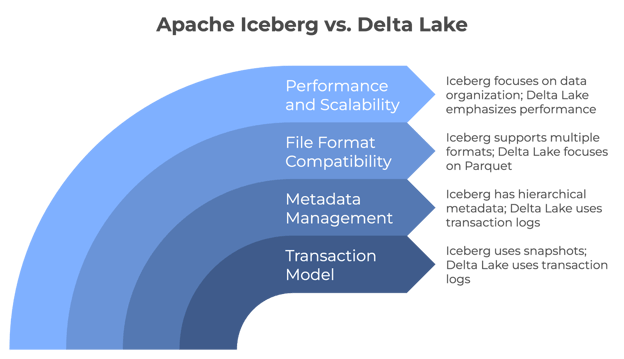
Apache Iceberg और Delta Lake के मुख्य अंतर। इमेज: लेखक द्वारा napkin.ai से बनाई गई।
Apache Iceberg के उपयोग के मामले
अपने विशिष्ट फीचर्स के कारण, Apache Iceberg आधुनिक डेटा लेक प्रबंधन के लिए तेज़ी से पसंदीदा समाधान बन गया है। इसकी प्रमुख उपयोग स्थितियों की जाँच करते हैं ताकि इसकी खूबियाँ समझ सकें।
क्लाउड-नेटिव डेटा लेक्स
यहाँ बताया गया है कि क्लाउड स्केल पर काम करने वाले डेटा लेक्स बनाने वाले संगठनों के लिए Iceberg एक लोकप्रिय विकल्प क्यों है:
- मजबूत स्कीमा इवोल्यूशन: यह आपको मौजूदा क्वेरीज़ को प्रभावित किए बिना कॉलम जोड़ने, हटाने या संशोधित करने देता है। उदाहरण के लिए, यदि आपको यूज़र प्रेफरेंसेज़ ट्रैक करने के लिए नया फ़ील्ड जोड़ना है, तो आप अपने पूरे डेटासेट को रिबिल्ड किए या सभी क्वेरीज़ को अपडेट किए बिना ऐसा कर सकते हैं।
- परफ़ॉर्मेंस: डेटा क्लस्टरिंग और मेटाडेटा मैनेजमेंट जैसी उन्नत तकनीकें क्वेरी परफ़ॉर्मेंस को ऑप्टिमाइज़ करती हैं। वे अनावश्यक डेटा फ़ाइलों को जल्दी प्रून कर स्कैन किए जाने वाले डेटा की मात्रा घटाती हैं और क्वेरी स्पीड बढ़ाती हैं।
- स्केलेबिलिटी: अरबों फ़ाइलों और पेटाबाइट्स डेटा का प्रबंधन करें। इसके अलावा, इसका पार्टिशन इवोल्यूशन फीचर आपको बिना डाउनटाइम या महंगी माइग्रेशन्स के डेटा के संगठन के तरीके को बदलने देता है।
जटिल डेटा मॉडल्स
जटिल डेटा मॉडल्स से निपटने वाली टीमें निम्न कारणों से Iceberg को विशेष रूप से उपयोगी पाती हैं:
- स्कीमा लचीलापन: नेस्टेड डेटा टाइप्स (structs, lists और maps) का समर्थन करता है ताकि जटिल संबंधों का निरूपण किया जा सके। उदाहरण के लिए, एक ई-कॉमर्स प्लेटफ़ॉर्म ऑर्डर विवरणों को संग्रहीत कर सकता है, जिसमें आइटम्स और कस्टमर डेटा के लिए नेस्टेड स्ट्रक्चर्स शामिल हैं, और यह सब एक ही टेबल में।
- टाइम-ट्रेवल क्वेरीज़: यह विधि आपके डेटा के स्नैपशॉट्स बनाए रखती है ताकि आप अतीत के किसी भी समय पर मौजूद डेटा पर क्वेरी कर सकें। यह अनुपालन उद्देश्यों के लिए किसी भी समय पर आपके डेटा की स्थिति को पुनर्निर्मित करने या ऐतिहासिक स्नैपशॉट्स पर विश्लेषण फिर से चलाने के लिए अमूल्य है।
टूल्स के साथ इंटीग्रेशन
Iceberg विभिन्न टूल्स के साथ संगत है, जिससे यह डेटा इकोसिस्टम के लिए एक बहुमुखी विकल्प बनता है। आइए इसके कुछ प्रमुख इंटीग्रेशन्स पर नज़र डालें:
Iceberg निम्न के साथ सहजता से काम करता है:
- Apache Spark बड़े पैमाने की डेटा प्रोसेसिंग और मशीन लर्निंग के लिए।
- Trino कई डेटा सोर्सेज़ पर तेज़, डिस्ट्रीब्यूटेड SQL क्वेरीज़ के लिए।
- Apache Flink रीयल-टाइम स्ट्रीम प्रोसेसिंग और बैच कंप्यूटेशन के लिए।
निम्न प्रमुख क्लाउड प्रदाता Iceberg के लिए नेटिव सपोर्ट प्रदान करते हैं:
- Amazon Web Services (AWS) इंटीग्रेट होता है AWS Glue, Redshift, EMR, और Athena के साथ।
- Google Cloud Platform (GCP) BigQuery और Dataproc के साथ काम करता है।
- Microsoft Azure Azure Synapse Analytics के साथ संगत है।
Iceberg विभिन्न प्रोग्रामिंग भाषाओं के लिए क्लाइंट लाइब्रेरीज़ भी प्रदान करता है, जैसे:
- SQL Iceberg टेबल्स पर मानक SQL क्वेरीज़ लिखता है।
- Python PySpark या pyiceberg जैसी लाइब्रेरीज़ का उपयोग कर डेटा मैनिपुलेशन करता है।
- Java लो-लेवल ऑपरेशन्स और कस्टम इंटीग्रेशन्स के लिए नेटिव Java API का लाभ उठाता है।
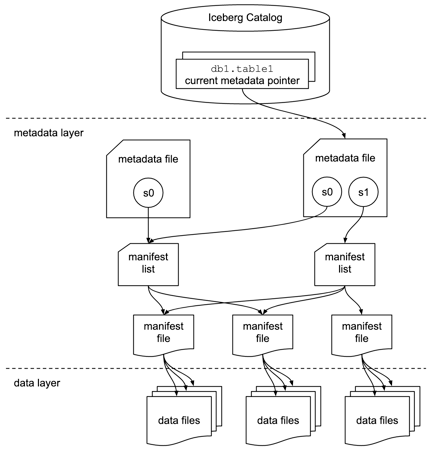
Apache Iceberg टेबल फ़ॉर्मेट स्पेसिफ़िकेशन। इमेज स्रोत: Iceberg documentation.
Delta Lake के उपयोग के मामले
Delta Lake सामान्य चुनौतियों का समाधान कर सकता है और डेटा प्रबंधन को आसान बना सकता है। आइए कुछ प्रमुख स्थितियों की जाँच करें जहाँ यह वास्तव में मदद करता है।
एकीकृत बैच और स्ट्रीमिंग वर्कलोड्स
Delta Lake के साथ, आपको अलग-अलग डेटा प्रकारों के लिए अलग सिस्टम्स की ज़रूरत नहीं है। इसके बजाय, आप एक ही सिस्टम रख सकते हैं जो सब कुछ संभालता है। आप अपने टेबल्स में रीयल-टाइम में नया डेटा जोड़ सकते हैं, और वह तुरंत विश्लेषण के लिए तैयार होता है। इसका मतलब है आपका डेटा हमेशा अप-टू-डेट रहता है।
आप एक ऐसा एकल वर्कफ़्लो बना सकते हैं जो पुराने और नए डेटा — दोनों को संभाले, जिससे आपका पूरा सिस्टम कम जटिल और मैनेज करने में आसान हो जाता है। यह एकीकृत दृष्टिकोण आपकी डेटा पाइपलाइंस को सरल बना देगा।
डेटा लेक्स के लिए ACID ट्रांज़ैक्शन्स
Delta Lake ACID ट्रांज़ैक्शन्स के माध्यम से डेटा लेक्स में मजबूत डेटा विश्वसनीयता लाता है। उदाहरण के लिए:
- हॉस्पिटल सटीक और अप-टू-डेट रोगी रिकॉर्ड्स बनाए रख सकते हैं ताकि उचित देखभाल प्रदान हो और गोपनीयता नियमों का पालन हो सके।
- बैंक यह सुनिश्चित कर सकते हैं कि सभी वित्तीय लेनदेन सटीक रूप से रिकॉर्ड हों और अनजाने में बदले न जा सकें।
- रिटेल स्टोर्स अपनी इन्वेंटरी काउंट्स को सटीक रख सकते हैं, भले ही कई अपडेट्स एक साथ हों। इससे ऐसे समस्याओं को रोकने में मदद मिलती है जैसे स्टॉक में न होने वाली वस्तुओं की बिक्री।
Delta Lake यह विश्वसनीयता इस तरह सुनिश्चित करता है कि सभी बदलाव या तो पूरी तरह लागू हों या बिल्कुल नहीं। इसके अलावा, यह सुनिश्चित करता है कि डेटा हमेशा एक वैध स्टेट से दूसरे वैध स्टेट में जाए और अलग-अलग ऑपरेशन्स एक-दूसरे में दखल न दें।
Apache Spark इकोसिस्टम
Delta Lake Apache Spark के साथ भी सहजता से काम करता है, जो कई संगठनों के लिए एक बड़ा लाभ है। यदि आप पहले से Spark का उपयोग कर रहे हैं, तो Delta Lake को जोड़ना सरल होगा और आपके मौजूदा सेटअप में बड़े बदलावों की आवश्यकता नहीं होगी। आपकी टीम वही Spark टूल्स और SQL कमांड्स इस्तेमाल कर सकती है जिनसे वे परिचित हैं।
नतीजतन, यह आपके Spark जॉब्स को तेज़ चलाएगा, खासकर जब बड़े पैमाने के डेटा से निपटना हो। यह डेटा को अधिक कुशलता से व्यवस्थित कर और स्मार्ट इंडेक्सिंग तकनीकों का उपयोग कर ऐसा करता है।
Apache Iceberg बनाम Delta Lake: संक्षेप
आइए Apache Iceberg और Delta Lake के मुख्य अंतर का सार लें ताकि आप उनके फ़ॉर्मेट की खूबियों और प्रमुख फीचर्स को जल्दी समझ सकें।
|
फीचर्स |
Apache Iceberg |
Delta Lake |
|
ACID ट्रांज़ैक्शन |
Yes |
Yes |
|
टाइम ट्रेवल |
Yes |
Yes |
|
डेटा वर्ज़निंग |
Yes |
Yes |
|
फ़ाइल फ़ॉर्मेट |
Parquet, ORC, Avro |
Parquet |
|
स्कीमा इवोल्यूशन |
Full |
Partial |
|
अन्य इंज़िन्स के साथ इंटीग्रेशन |
Apache Spark, Trino, Flink |
मुख्यतः Apache Spark |
|
क्लाउड संगतता |
AWS, GCP, Azure |
AWS, GCP |
|
क्वेरी इंज़िन्स |
Spark, Trino, Flink |
Spark |
|
प्रोग्रामिंग भाषा |
SQL, Python, Java |
SQL, Python |
नोट: सर्वोत्तम विकल्प आपकी ज़रूरतों, स्केलेबिलिटी आवश्यकताओं और दीर्घकालीन डेटा रणनीति पर निर्भर करता है।
निष्कर्ष
Apache Iceberg और Delta Lake के बीच चयन करते समय, अपने विशिष्ट उपयोग के मामले और मौजूदा टेक्नोलॉजी स्टैक पर विचार करें। फ़ाइल फ़ॉर्मेट्स और क्वेरी इंज़िन्स के साथ Iceberg का लचीलापन इसे क्लाउड-नेटिव वातावरण के लिए उपयुक्त बनाता है। हालाँकि, Apache Spark के साथ Delta Lake का सघन इंटीग्रेशन उन संगठनों के लिए अच्छा विकल्प है जो Spark इकोसिस्टम में गहराई से निवेशित हैं।
आप अपने मौजूदा डेटा समझ को मज़बूत करने के लिए कुछ संबंधित DataCamp संसाधन भी देख सकते हैं:
- Understanding Data Engineering कोर्स, बुनियादी अवधारणाएँ समझने के लिए
- Database Design और Data Warehousing कोर्स, बड़े पैमाने के डेटा को प्रभावी ढंग से संरचित करने के लिए।
- Modern Data Architecture कोर्स, मौजूदा सर्वोत्तम प्रथाओं और रुझानों के बारे में सीखने के लिए।
सीखते रहिए!
FAQs
मर्ज-ऑन-रीड और मर्ज-ऑन-राइट रणनीतियों में प्राथमिक अंतर क्या है?
मर्ज-ऑन-रीड (Iceberg द्वारा उपयोग) मौजूदा फ़ाइलों से डेटा पढ़ता है और क्वेरी के समय बदलाव लागू करता है। मर्ज-ऑन-राइट (Delta Lake द्वारा उपयोग) अपडेट्स को लिखने की प्रक्रिया के दौरान बेस डेटा में मर्ज करता है, जिससे रीड तेज़ होती है लेकिन राइट ऑपरेशन्स धीमे हो सकते हैं।
क्या Apache Iceberg और Delta Lake पेटाबाइट-स्केल डेटा संभाल सकते हैं?
हाँ, Apache Iceberg और Delta Lake दोनों पेटाबाइट-स्केल डेटासेट्स को कुशलतापूर्वक संभालते हैं। वे पार्टिशनिंग, मेटाडेटा मैनेजमेंट और कम्पैक्शन जैसी उन्नत सुविधाएँ प्रदान करते हैं ताकि बड़े डेटा लेक के परफ़ॉर्मेंस को ऑप्टिमाइज़ किया जा सके।
डीपली नेस्टेड डेटा स्ट्रक्चर्स पर क्वेरी करने में Apache Iceberg और Delta Lake कैसे प्रदर्शन करते हैं?
Apache Iceberg गहराई से नेस्टेड डेटा संरचनाओं पर क्वेरी करने में उत्कृष्ट है। यह Parquet जैसे टेब्युलर स्टोरेज फ़ॉर्मेट्स का समर्थन करता है, जो नेस्टेड डेटा के लिए ऑप्टिमाइज़्ड हैं। दूसरी ओर, Delta Lake भी नेस्टेड डेटा को सपोर्ट करता है, लेकिन इसका परफ़ॉर्मेंस क्वेरी की जटिलता और डेटासेट के आकार के आधार पर बदल सकता है।
क्या Apache Iceberg और Delta Lake एक ही डेटा लेक आर्किटेक्चर में साथ काम कर सकते हैं?
हाँ, Apache Iceberg और Delta Lake दोनों एक ही डेटा लेक में सह-अस्तित्व में रह सकते हैं। आवश्यकताओं के आधार पर प्रत्येक को अलग-अलग उपयोग मामलों के लिए इस्तेमाल किया जा सकता है। उदाहरण के लिए, आप Spark-केंद्रित वर्कलोड्स के लिए Delta Lake और विविध क्वेरी इंज़िन्स के साथ अधिक लचीले इंटीग्रेशन के लिए Iceberg का उपयोग कर सकते हैं।
नॉन-Spark इंज़िन्स के साथ Delta Lake का उपयोग करने में क्या सीमाएँ हैं?
Delta Lake Apache Spark के साथ कड़ी तरह से इंटीग्रेटेड है, और भले ही यह Presto या Hive जैसे अन्य इंज़िन्स के साथ काम कर सकता है, ये इंटीग्रेशन्स अभी विकसित हो रहे हैं। परफ़ॉर्मेंस Spark जितना ऑप्टिमाइज़्ड नहीं हो सकता, जो Spark इकोसिस्टम के बाहर इसकी प्रभावशीलता को सीमित कर सकता है।
डेटा लेक्स में छोटी फ़ाइलों की समस्या को Iceberg और Delta Lake कैसे संभालते हैं?
Apache Iceberg और Delta Lake दोनों कम्पैक्शन के माध्यम से छोटे फ़ाइलों की समस्या का समाधान करते हैं। Iceberg समय-समय पर छोटी फ़ाइलों को मिलाकर क्वेरी परफ़ॉर्मेंस को ऑप्टिमाइज़ करता है, जबकि Delta Lake राइट ऑपरेशन्स के दौरान फ़ाइलों को समेकित करने के लिए ऑटो कम्पैक्शन का उपयोग करता है। यह कई छोटी फ़ाइलों से उत्पन्न ओवरहेड को कम करके बेहतर परफ़ॉर्मेंस सुनिश्चित करता है।
Databricks ने Tabular (Iceberg के पीछे की कंपनी) का अधिग्रहण क्यों किया?
Databricks ने Apache Iceberg की क्षमताओं को मज़बूत करने के लिए Tabular का अधिग्रहण किया, जिसे मूल रूप से Tabular के संस्थापकों ने बनाया था। इस अधिग्रहण का उद्देश्य Delta Lake और Iceberg के बीच संगतता और इंटरऑपरेबिलिटी में सुधार करना है, और अंततः दोनों ओपन-सोर्स प्रोजेक्ट्स की ताकतों को मिलाकर एक एकीकृत लेकहाउस फ़ॉर्मेट की ओर काम करना है।
Tabular अधिग्रहण का Delta Lake और Iceberg उपयोगकर्ताओं के लिए क्या अर्थ है?
इस अधिग्रहण का मतलब है कि Databricks Delta Lake और Iceberg को संगतता के लिहाज़ से और करीब लाने के लिए सक्रिय रूप से काम करेगा। उपयोगकर्ताओं को बेहतर इंटीग्रेशन का लाभ मिलेगा, जिसमें Delta Lake UniForm पहले से ही Delta Lake, Iceberg और Apache Hudi के बीच इंटरऑपरेबिलिटी सक्षम करने के लिए एक प्लेटफ़ॉर्म के रूप में काम कर रहा है। यह उपयोगकर्ताओं को किसी एक समाधान में बँधे बिना अलग-अलग फ़ॉर्मेट्स में काम करने देता है।
क्या Databricks Delta Lake और Iceberg — दोनों का समर्थन जारी रखेगा?
हाँ, Databricks ने दोनों फ़ॉर्मेट्स के प्रति अपनी प्रतिबद्धता दर्शाई है। Tabular का अधिग्रहण कर और Apache Iceberg के मूल रचनाकारों को साथ लाकर, Databricks Iceberg और Delta Lake समुदायों के बीच सहयोग बढ़ाना चाहता है। उनका लक्ष्य लेकहाउस फ़ॉर्मेट इंटरऑपरेबिलिटी के लिए एक एकल, ओपन स्टैंडर्ड विकसित करना है, जो उपयोगकर्ताओं को अधिक विकल्प और लचीलापन प्रदान करेगा।

मैं एक कंटेंट स्ट्रैटेजिस्ट हूँ जिसे जटिल विषयों को सरल बनाना पसंद है। मैंने Splunk, Hackernoon, और Tiiny Host जैसी कंपनियों को अपने दर्शकों के लिए आकर्षक और सूचनात्मक सामग्री बनाने में मदद की है।
बिग डेटा प्रोसेसिंग में अक्सर असंरचित डेटा के साथ काम करना शामिल होता है, जिसे प्रबंधित और विश्लेषित करना चुनौतीपूर्ण हो सकता है। किसी भी समय अनजाने में डिलीशन या अन्य त्रुटियाँ हो सकती हैं — जो डेटा इंटीग्रिटी के लिए बड़ा जोखिम पैदा करती हैं।
Apache Iceberg और Delta Lake ओपन-सोर्स टेबल फ़ॉर्मेट हैं जिनका उपयोग मुख्य रूप से बड़े पैमाने के डेटा लेक्स और लेकहाउस प्रबंधन के लिए किया जाता है। दोनों प्लेटफ़ॉर्म स्कीमा इवोल्यूशन, टाइम ट्रेवल और ACID ट्रांज़ैक्शन्स जैसे फीचर्स प्रदान करते हैं, ताकि विशाल डेटासेट्स को संभालने की चुनौतियों का समाधान किया जा सके। प्रत्येक के अपने विशिष्ट लाभ हैं, फिर भी इनका साझा उद्देश्य समान है: डेटासेट्स में डेटा स्थिरता बनाए रखना।
इस लेख में, मैं Apache Iceberg और Delta Lake के प्रमुख फीचर्स, समानताएँ और आर्किटेक्चरल अंतर समझाऊँगा ताकि आप अपनी ज़रूरतों के लिए सही टूल चुन सकें।
Apache Iceberg क्या है?
Netflix द्वारा विकसित और बाद में Apache Software Foundation को दान किया गया, Iceberg बड़े पैमाने के डेटा लेक्स को प्रबंधित करने की चुनौतियों को हल करने का उद्देश्य रखता है। यह बड़े एनालिटिक टेबल्स के लिए एक हाई-परफ़ॉर्मेंस फ़ॉर्मेट है, जो विशाल डेटासेट्स का कुशल प्रबंधन और क्वेरीइंग करता है। इसके फीचर्स पारंपरिक डेटा लेक स्टोरेज तरीकों की कई सीमाओं को दूर करते हैं।
आइए Apache Iceberg को और विस्तार से समझते हैं।
Apache Iceberg के फीचर्स
यहाँ Apache Iceberg के कुछ प्रमुख फीचर्स दिए गए हैं, जो डेटासेट्स के साथ काम करते समय डेटा इंजीनियर्स के लिए बहुत सहायक होते हैं।
loyalty_pointsफ़ील्ड जोड़ना चाहते हैं, तो आप यह काम मौजूदा डेटा को प्रभावित किए बिना या चल रही क्वेरीज़ तोड़े बिना कर सकते हैं। यह लचीलापन विशेष रूप से दीर्घकालिक डेटा प्रोजेक्ट्स के लिए उपयोगी है जिन्हें समय के साथ अनुकूलित होना पड़ता है।ये फीचर्स Iceberg को बड़े पैमाने की डेटा एनालिटिक्स के लिए खास तौर पर उपयुक्त बनाते हैं, विशेषकर तब जब आप ऐसे डेटा से निपटते हैं जो अक्सर बदलता है या जिसे लंबे समय तक कई तरीकों से एक्सेस करना पड़ता है।
इस रोमांचक तकनीक पर गहराई से जानने के लिए Apache Iceberg Explained ब्लॉग पोस्ट देखें।
Delta Lake क्या है?
Databricks द्वारा विकसित, Delta Lake Spark के साथ सहजता से काम करता है, जिससे यह Spark इकोसिस्टम में पहले से निवेश करने वाले संगठनों के लिए लोकप्रिय विकल्प बनता है। यह एक ओपन-सोर्स स्टोरेज लेयर है जो Apache Spark और बिग डेटा वर्कलोड्स में ACID (Atomicity, Consistency, Isolation, Durability) ट्रांज़ैक्शन्स लाता है।
Delta Lake-आधारित डेटा लेकहाउस स्केलेबल मेटाडेटा, वर्ज़निंग और स्कीमा एन्फोर्समेंट के जरिए डेटा गुणवत्ता बनाए रखते हुए डेटा वेयरहाउसिंग और मशीन लर्निंग को सुगम बनाते हैं।
Delta Lake के फीचर्स
यहाँ वे प्रमुख फीचर्स हैं जो Delta Lake को आधुनिक डेटा प्रोसेसिंग के लिए एक अच्छा समाधान बनाते हैं:
कोर्स Big Data Fundamentals with PySpark Spark के साथ आधुनिक डेटा प्रोसेसिंग पर गहराई से जाता है। यह इस शक्तिशाली तकनीक पर एक बेहतरीन रिफ्रेशर है।