
Kursus
Pemrosesan Citra dengan Python
4 jam
56.9K
SAM2 adalah model fondasi yang dikembangkan oleh Meta untuk segmentasi visual berbasis prompt pada gambar dan video. Berbeda dengan pendahulunya, SAM, yang terutama berfokus pada gambar statis, SAM2 juga dirancang untuk menangani kompleksitas segmentasi video.
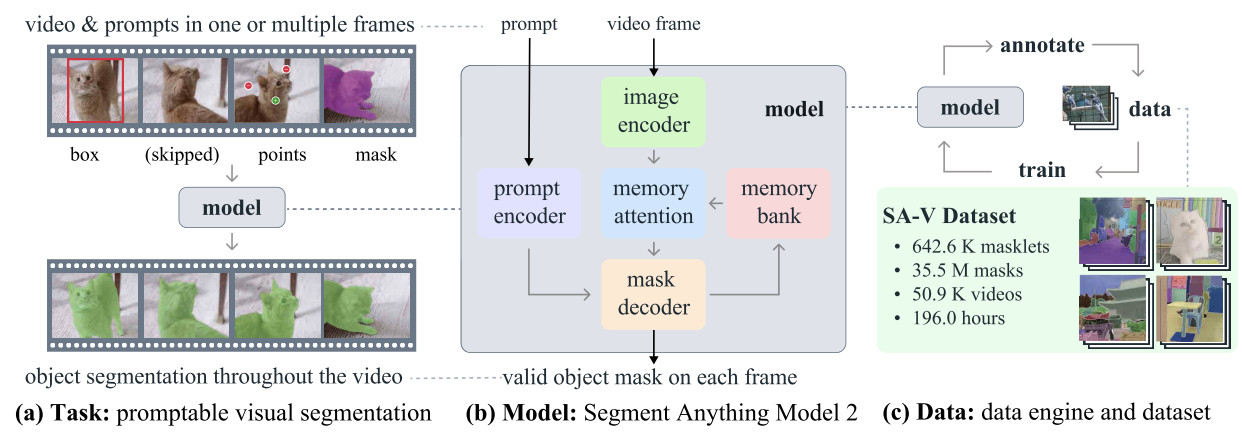
SAM2 - Tugas, Model, dan Data (Sumber: Ravi dkk., 2024)
Model ini menggunakan arsitektur transformer dengan memori streaming, yang memungkinkan pemrosesan video secara real time. Pelatihan SAM 2 melibatkan himpunan data yang sangat besar dan beragam dengan SA-V dataset yang baru, mencakup lebih dari 600.000 anotasi masklet dari 51.000 video.
Mesin data (data engine)-nya, yang memungkinkan pengumpulan data interaktif dan peningkatan model, memberi kemampuan pada model untuk men-segmentasi apa saja. Engine ini memungkinkan SAM 2 terus belajar dan beradaptasi, sehingga makin efektif menangani data baru dan menantang. Namun, untuk tugas khusus domain atau objek langka, fine-tuning sangat penting guna mencapai performa optimal.
Dalam konteks SAM 2, fine-tuning adalah proses melatih lebih lanjut model SAM 2 yang sudah dipra-latih pada dataset spesifik untuk meningkatkan performanya pada tugas atau domain tertentu. Walau SAM 2 merupakan alat yang kuat dan dilatih pada data yang luas serta beragam, sifatnya yang general-purpose mungkin tidak selalu menghasilkan hasil optimal untuk tugas khusus atau langka.
Sebagai contoh, jika Anda mengerjakan sebuah proyek pencitraan medis yang memerlukan identifikasi tipe tumor tertentu, performa model bisa saja kurang memadai karena pelatihannya yang bersifat umum.
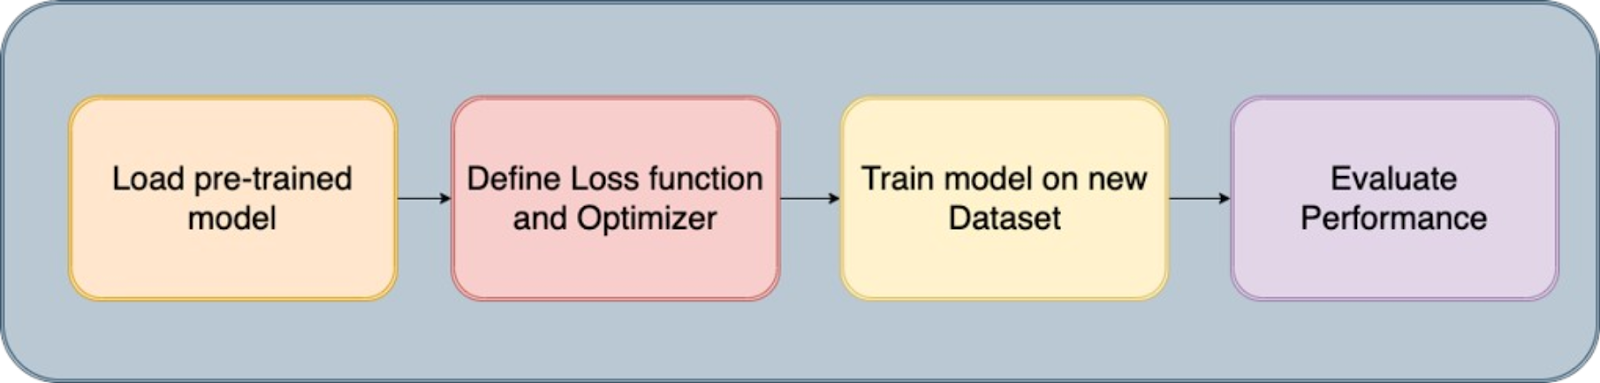
Proses fine-tuning
Fine-tuning SAM 2 mengatasi keterbatasan ini dengan memungkinkan Anda menyesuaikan model terhadap dataset Anda. Proses ini meningkatkan akurasi model dan membuatnya lebih efektif untuk kasus penggunaan Anda.
Berikut manfaat utama fine-tuning SAM 2:
Untuk memulai fine-tuning SAM 2, Anda perlu menyiapkan hal-hal berikut:
Perangkat lunak dan kebutuhan lain:
Kualitas dataset sangat penting untuk fine-tuning model SAM 2. Gambar atau video beranotasi berkualitas tinggi dengan mask segmentasi yang akurat sangat krusial untuk mencapai performa optimal. Anotasi yang presisi memungkinkan model mempelajari fitur yang benar, menghasilkan akurasi segmentasi yang lebih baik dan ketangguhan dalam aplikasi dunia nyata.
Langkah pertama adalah memperoleh dataset, yang menjadi tulang punggung proses pelatihan. Kami mendapatkan data dari Kaggle, platform tepercaya yang menyediakan beragam dataset. Menggunakan Kaggle API, kami mengunduh data dalam format yang diperlukan, memastikan gambar dan mask segmentasinya tersedia untuk pemrosesan lanjutan.
Setelah mengunduh dataset, kami melakukan langkah-langkah berikut:
Karena model SAM2 memerlukan masukan dalam format tertentu, kami mengonversi data sebagai berikut:
Gambar dan mask yang telah diproses kemudian diorganisasi ke dalam folder masing-masing untuk akses yang mudah selama proses fine-tuning. Selain itu, path ke gambar dan mask tersebut ditulis ke dalam berkas CSV (train.csv) untuk memudahkan pemuatan data saat pelatihan.
Langkah terakhir adalah memvalidasi dataset untuk memastikan akurasinya:
Di sini tersedia notebook ringkas untuk memandu Anda melalui kode pembuatan dataset. Anda bisa mengikuti jalur pembuatan data ini atau langsung menggunakan dataset mana pun yang tersedia online dengan format yang sama seperti disebutkan pada prasyarat.
Segment Anything Model 2 memiliki beberapa komponen, namun kunci untuk fine-tuning yang lebih cepat adalah hanya melatih komponen yang ringan, seperti mask decoder dan prompt encoder, alih-alih seluruh model. Langkah-langkah fine-tuning model ini adalah sebagai berikut:
Untuk memulai proses fine-tuning, kita perlu menginstal pustaka SAM-2, yang penting untuk Segment Anything Model (SAM2). Model ini dirancang untuk menangani berbagai tugas segmentasi secara efektif. Instalasi mencakup mengkloning repositori SAM-2 dari GitHub dan memasang dependensi yang diperlukan.
!git clone https://github.com/facebookresearch/segment-anything-2
%cd /content/segment-anything-2
!pip install -q -e .
Cuplikan kode ini memastikan pustaka SAM2 terpasang dengan benar dan siap digunakan dalam alur kerja fine-tuning kita.
Setelah pustaka SAM-2 terinstal, langkah berikutnya adalah memperoleh dataset yang akan kita gunakan untuk fine-tuning. Kita menggunakan dataset yang tersedia di Kaggle, khususnya dataset segmentasi CT dada yang berisi gambar dan mask paru-paru, jantung, dan trakea.
Dataset ini berisi:
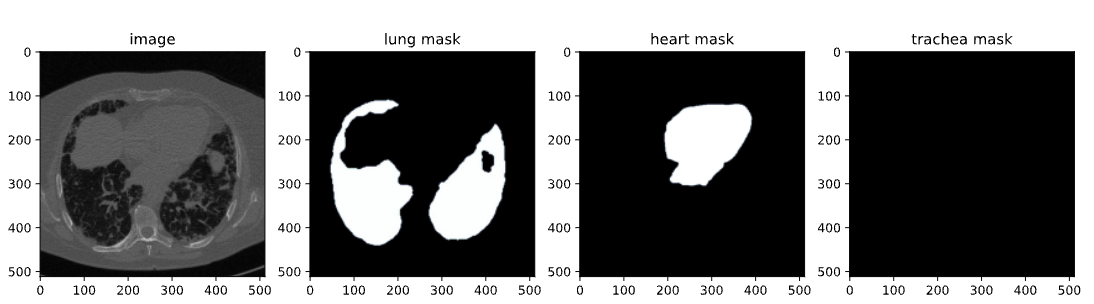
Gambar dari Dataset CT Scan
Pada blog ini, kita hanya akan menggunakan gambar dan mask paru-paru untuk segmentasi. Kaggle API memungkinkan kita mengunduh dataset langsung ke lingkungan kerja. Kita mulai dengan mengunggah berkas kaggle.json dari Kaggle untuk mengakses dataset dengan mudah.
Untuk mendapatkan kaggle.json, buka tab Settings di bawah profil pengguna Anda dan pilih Create New Token. Ini akan memicu unduhan Kaggle.json, berkas yang berisi kredensial API Anda.
# get dataset from Kaggle
from google.colab import files
files.upload()  # This will prompt you to upload the kaggle.json file

!mkdir -p ~/.kaggle
!mv kaggle.json ~/.kaggle/
!chmod 600 ~/.kaggle/kaggle.json
!kaggle datasets download -d polomarco/chest-ct-segmentation
Ekstrak data:
!unzip chest-ct-segmentation.zip -d chest-ct-segmentationSetelah dataset siap, mari mulai proses fine-tuning. Seperti disebutkan sebelumnya, kuncinya adalah melakukan fine-tuning hanya pada komponen SAM2 yang ringan, seperti mask decoder dan prompt encoder, bukan seluruh model. Pendekatan ini lebih efisien dan membutuhkan sumber daya lebih sedikit.
Untuk proses fine-tuning, kita perlu memulai dengan bobot model SAM2 pra-latih. Bobot ini, yang disebut "checkpoint," menjadi titik awal untuk pelatihan lanjutan. Checkpoint telah dilatih pada beragam gambar, dan dengan fine-tuning pada dataset spesifik kita, performa pada tugas target dapat ditingkatkan.
!wget -O sam2_hiera_tiny.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_tiny.pt"
!wget -O sam2_hiera_small.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_small.pt"
!wget -O sam2_hiera_base_plus.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_base_plus.pt"
!wget -O sam2_hiera_large.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_large.pt"
Pada langkah ini, kita mengunduh berbagai checkpoint SAM-2 yang sesuai dengan ukuran model berbeda (misalnya tiny, small, base_plus, large). Pilihan checkpoint dapat disesuaikan berdasarkan sumber daya komputasi yang tersedia dan tugas spesifik yang dikerjakan.
Dengan dataset yang telah diunduh, langkah berikutnya adalah menyiapkannya untuk pelatihan. Ini mencakup membagi dataset menjadi set pelatihan dan pengujian serta membuat struktur data yang dapat dimasukkan ke model SAM 2 selama fine-tuning.
%cd /content/segment-anything-2

import os
import pandas as pd
import cv2
import torch
import torch.nn.utils
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.colors as mcolors
from sklearn.model_selection import train_test_split
from sam2.build_sam import build_sam2
from sam2.sam2_image_predictor import SAM2ImagePredictor

# Path to the chest-ct-segmentation dataset folder
data_dir = "/content/segment-anything-2/chest-ct-segmentation"
images_dir = os.path.join(data_dir, "images/images")
masks_dir = os.path.join(data_dir, "masks/masks")

# Load the train.csv file
train_df = pd.read_csv(os.path.join(data_dir, "train.csv"))

# Split the data into two halves: one for training and one for testing
train_df, test_df = train_test_split(train_df, test_size=0.2, random_state=42)

# Prepare the training data list
train_data = []
for index, row in train_df.iterrows():
   image_name = row['ImageId']
   mask_name = row['MaskId']

   # Append image and corresponding mask paths
   train_data.append({
       "image": os.path.join(images_dir, image_name),
       "annotation": os.path.join(masks_dir, mask_name)
   })

# Prepare the testing data list (if needed for inference or evaluation later)
test_data = []
for index, row in test_df.iterrows():
   image_name = row['ImageId']
   mask_name = row['MaskId']

   # Append image and corresponding mask paths
   test_data.append({
       "image": os.path.join(images_dir, image_name),
       "annotation": os.path.join(masks_dir, mask_name)
   })
Kita membagi dataset menjadi set pelatihan (80%) dan set pengujian (20%) untuk memastikan kita dapat mengevaluasi performa model setelah pelatihan. Data pelatihan akan digunakan untuk fine-tuning model SAM 2, sementara data pengujian digunakan untuk inferensi dan evaluasi.
Setelah membagi dataset menjadi set pelatihan dan pengujian, langkah berikutnya mencakup pembuatan mask biner, pemilihan titik kunci di dalam mask tersebut, serta memvisualisasikan elemen-elemen ini untuk memastikan data diproses dengan benar.
1. Membaca dan mengubah ukuran gambar: Proses dimulai dengan memilih secara acak satu gambar dan mask yang sesuai dari dataset. Gambar dikonversi dari format BGR ke RGB, yang merupakan format warna standar bagi sebagian besar model deep learning. Anotasi terkait (mask) dibaca dalam mode skala abu-abu. Lalu, baik gambar maupun mask anotasi diubah ukurannya hingga dimensi maksimum 1024 piksel, dengan menjaga rasio aspek agar sesuai dengan kebutuhan input model dan mengurangi beban komputasi.
def read_batch(data, visualize_data=False):
   # Select a random entry
   ent = data[np.random.randint(len(data))]

   # Get full paths
   Img = cv2.imread(ent["image"])[..., ::-1]  # Convert BGR to RGB
   ann_map = cv2.imread(ent["annotation"], cv2.IMREAD_GRAYSCALE)  # Read annotation as grayscale

   if Img is None or ann_map is None:
       print(f"Error: Could not read image or mask from path {ent['image']} or {ent['annotation']}")
       return None, None, None, 0

   # Resize image and mask
   r = np.min([1024 / Img.shape[1], 1024 / Img.shape[0]])  # Scaling factor
   Img = cv2.resize(Img, (int(Img.shape[1] * r), int(Img.shape[0] * r)))
   ann_map = cv2.resize(ann_map, (int(ann_map.shape[1] * r), int(ann_map.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
2. Binerisasi mask segmentasi: Mask anotasi multi-kelas (yang mungkin memiliki beberapa kelas objek dengan nilai piksel berbeda) dikonversi menjadi mask biner. Mask ini menyorot semua area yang diminati pada gambar, menyederhanakan tugas segmentasi menjadi masalah klasifikasi biner: objek vs. latar belakang. Mask biner kemudian di-erosi menggunakan kernel 5x5.
Erosi sedikit mengurangi ukuran mask, yang membantu menghindari efek batas saat memilih titik. Ini memastikan titik yang dipilih berada di dalam interior objek, bukan di dekat tepinya yang mungkin bising atau ambigu.
Titik kunci dipilih dari dalam mask yang telah di-erosi. Titik-titik ini bertindak sebagai prompt selama proses fine-tuning, membimbing model ke area yang harus diperhatikan. Titik dipilih secara acak dari interior objek agar representatif dan tidak terpengaruh oleh batas yang bising.
   ### Continuation of read_batch() ###

   # Initialize a single binary mask
   binary_mask = np.zeros_like(ann_map, dtype=np.uint8)
   points = []

   # Get binary masks and combine them into a single mask
   inds = np.unique(ann_map)[1:]  # Skip the background (index 0)
   for ind in inds:
       mask = (ann_map == ind).astype(np.uint8)  # Create binary mask for each unique index
       binary_mask = np.maximum(binary_mask, mask)  # Combine with the existing binary mask

   # Erode the combined binary mask to avoid boundary points
   eroded_mask = cv2.erode(binary_mask, np.ones((5, 5), np.uint8), iterations=1)

   # Get all coordinates inside the eroded mask and choose a random point
   coords = np.argwhere(eroded_mask > 0)
   if len(coords) > 0:
       for _ in inds:  # Select as many points as there are unique labels
           yx = np.array(coords[np.random.randint(len(coords))])
           points.append([yx[1], yx[0]])

   points = np.array(points)
3. Visualisasi: Langkah ini krusial untuk memverifikasi bahwa langkah prapemrosesan data telah dijalankan dengan benar. Dengan memeriksa secara visual titik-titik pada mask yang dibinerisasi, Anda dapat memastikan model akan menerima masukan yang tepat saat pelatihan. Terakhir, mask biner diubah bentuk dan diformat dengan benar (dengan dimensi yang sesuai untuk input model), dan titik-titik juga diubah bentuk untuk digunakan lebih lanjut dalam proses pelatihan. Fungsi mengembalikan gambar yang diproses, mask biner, titik-titik yang dipilih, dan jumlah mask yang ditemukan.
    ### Continuation of read_batch() ###

    if visualize_data:
        # Plotting the images and points
        plt.figure(figsize=(15, 5))

        # Original Image
        plt.subplot(1, 3, 1)
        plt.title('Original Image')
        plt.imshow(img)
        plt.axis('off')

        # Segmentation Mask (binary_mask)
        plt.subplot(1, 3, 2)
        plt.title('Binarized Mask')
        plt.imshow(binary_mask, cmap='gray')
        plt.axis('off')

        # Mask with Points in Different Colors
        plt.subplot(1, 3, 3)
        plt.title('Binarized Mask with Points')
        plt.imshow(binary_mask, cmap='gray')

        # Plot points in different colors
        colors = list(mcolors.TABLEAU_COLORS.values())
        for i, point in enumerate(points):
            plt.scatter(point[0], point[1], c=colors[i % len(colors)], s=100, label=f'Point {i+1}')  # Corrected to plot y, x order

        # plt.legend()
        plt.axis('off')

        plt.tight_layout()
        plt.show()

    binary_mask = np.expand_dims(binary_mask, axis=-1)  # Now shape is (1024, 1024, 1)
    binary_mask = binary_mask.transpose((2, 0, 1))
    points = np.expand_dims(points, axis=1)

    # Return the image, binarized mask, points, and number of masks
    return img, binary_mask, points, len(inds)

# Visualize the data
Img1, masks1, points1, num_masks = read_batch(train_data, visualize_data=True)
Kode di atas mengembalikan gambar berikut yang memuat gambar asli dari dataset beserta mask yang dibinerisasi dan mask biner dengan titik-titiknya.
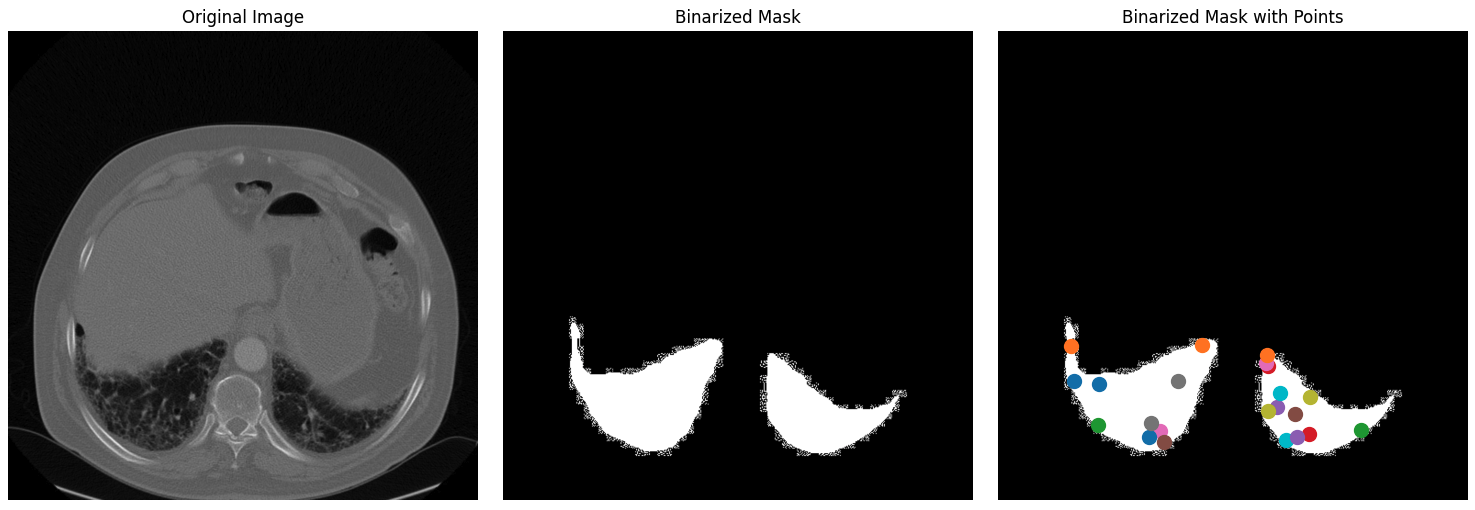
Gambar asli, mask biner, dan mask biner dengan titik untuk dataset.
Fine-tuning model SAM2 melibatkan beberapa langkah, termasuk memuat model, menyiapkan optimizer dan scheduler, serta memperbarui bobot model secara iteratif berdasarkan data pelatihan.
Muat checkpoint model:
sam2_checkpoint = "sam2_hiera_small.pt"  # @param ["sam2_hiera_tiny.pt", "sam2_hiera_small.pt", "sam2_hiera_base_plus.pt", "sam2_hiera_large.pt"]
model_cfg = "sam2_hiera_s.yaml" # @param ["sam2_hiera_t.yaml", "sam2_hiera_s.yaml", "sam2_hiera_b+.yaml", "sam2_hiera_l.yaml"]

sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
predictor = SAM2ImagePredictor(sam2_model)
Kita mulai dengan membangun model SAM2 menggunakan checkpoint pra-latih. Model kemudian dibungkus dalam kelas predictor, yang menyederhanakan proses set image, encoding prompt, dan decoding mask.
Kami mengonfigurasi beberapa hiperparameter agar model belajar secara efektif, seperti learning rate, weight decay, dan langkah akumulasi gradien. Hiperparameter ini mengontrol proses pembelajaran, termasuk seberapa cepat model memperbarui bobotnya dan bagaimana ia menghindari overfitting. Silakan bereksperimen dengan nilai-nilai ini.
# Train mask decoder.
predictor.model.sam_mask_decoder.train(True)

# Train prompt encoder.
predictor.model.sam_prompt_encoder.train(True)

# Configure optimizer.
optimizer=torch.optim.AdamW(params=predictor.model.parameters(),lr=0.0001,weight_decay=1e-4) #1e-5, weight_decay = 4e-5

# Mix precision.
scaler = torch.cuda.amp.GradScaler()

# No. of steps to train the model.
NO_OF_STEPS = 3000 # @param

# Fine-tuned model name.
FINE_TUNED_MODEL_NAME = "fine_tuned_sam2"
Optimizer bertanggung jawab memperbarui bobot model, sedangkan scheduler menyesuaikan learning rate selama pelatihan untuk meningkatkan konvergensi. Dengan menyetel parameter-parameter ini, kita dapat mencapai akurasi segmentasi yang lebih baik.
Proses fine-tuning yang sebenarnya bersifat iteratif, di mana pada tiap langkah, satu batch gambar dan mask (hanya paru-paru) dilewatkan melalui model, lalu loss dihitung dan digunakan untuk memperbarui bobot model.
# Initialize scheduler
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=500, gamma=0.2) # 500 , 250, gamma = 0.1
accumulation_steps = 4  # Number of steps to accumulate gradients before updating

for step in range(1, NO_OF_STEPS + 1):
   with torch.cuda.amp.autocast():
       image, mask, input_point, num_masks = read_batch(train_data, visualize_data=False)
       if image is None or mask is None or num_masks == 0:
           continue

       input_label = np.ones((num_masks, 1))
       if not isinstance(input_point, np.ndarray) or not isinstance(input_label, np.ndarray):
           continue

       if input_point.size == 0 or input_label.size == 0:
           continue

       predictor.set_image(image)
       mask_input, unnorm_coords, labels, unnorm_box = predictor._prep_prompts(input_point, input_label, box=None, mask_logits=None, normalize_coords=True)
       if unnorm_coords is None or labels is None or unnorm_coords.shape[0] == 0 or labels.shape[0] == 0:
           continue

       sparse_embeddings, dense_embeddings = predictor.model.sam_prompt_encoder(
           points=(unnorm_coords, labels), boxes=None, masks=None,
       )

       batched_mode = unnorm_coords.shape[0] > 1
       high_res_features = [feat_level[-1].unsqueeze(0) for feat_level in predictor._features["high_res_feats"]]
       low_res_masks, prd_scores, _, _ = predictor.model.sam_mask_decoder(
           image_embeddings=predictor._features["image_embed"][-1].unsqueeze(0),
           image_pe=predictor.model.sam_prompt_encoder.get_dense_pe(),
           sparse_prompt_embeddings=sparse_embeddings,
           dense_prompt_embeddings=dense_embeddings,
           multimask_output=True,
           repeat_image=batched_mode,
           high_res_features=high_res_features,
       )
       prd_masks = predictor._transforms.postprocess_masks(low_res_masks, predictor._orig_hw[-1])

       gt_mask = torch.tensor(mask.astype(np.float32)).cuda()
       prd_mask = torch.sigmoid(prd_masks[:, 0])
       seg_loss = (-gt_mask * torch.log(prd_mask + 0.000001) - (1 - gt_mask) * torch.log((1 - prd_mask) + 0.00001)).mean()

       inter = (gt_mask * (prd_mask > 0.5)).sum(1).sum(1)
       iou = inter / (gt_mask.sum(1).sum(1) + (prd_mask > 0.5).sum(1).sum(1) - inter)
       score_loss = torch.abs(prd_scores[:, 0] - iou).mean()
       loss = seg_loss + score_loss * 0.05

       # Apply gradient accumulation
       loss = loss / accumulation_steps
       scaler.scale(loss).backward()

       # Clip gradients
       torch.nn.utils.clip_grad_norm_(predictor.model.parameters(), max_norm=1.0)

       if step % accumulation_steps == 0:
           scaler.step(optimizer)
           scaler.update()
           predictor.model.zero_grad()

       # Update scheduler
       scheduler.step()

       if step % 500 == 0:
           FINE_TUNED_MODEL = FINE_TUNED_MODEL_NAME + "_" + str(step) + ".torch"
           torch.save(predictor.model.state_dict(), FINE_TUNED_MODEL)

       if step == 1:
           mean_iou = 0

       mean_iou = mean_iou * 0.99 + 0.01 * np.mean(iou.cpu().detach().numpy())

       if step % 100 == 0:
           print("Step " + str(step) + ":\t", "Accuracy (IoU) = ", mean_iou)
Pada setiap iterasi, model memproses satu batch gambar, menghitung mask segmentasi, dan membandingkannya dengan ground truth untuk menghitung loss. Loss ini kemudian digunakan untuk menyesuaikan bobot model, sehingga performa model meningkat secara bertahap. Setelah pelatihan sekitar 3000 epoch, kita memperoleh akurasi (IoU - Intersection over Union) sekitar 72%.
Model kemudian dapat digunakan untuk inferensi, yaitu memprediksi mask segmentasi pada gambar baru yang belum pernah dilihat. Mulailah dengan fungsi pembantu read_images dan get_points untuk mendapatkan gambar inferensi dan mask-nya beserta titik-titik kunci.
def read_image(image_path, mask_path):  # read and resize image and mask
   img = cv2.imread(image_path)[..., ::-1]  # Convert BGR to RGB
   mask = cv2.imread(mask_path, 0)
   r = np.min([1024 / img.shape[1], 1024 / img.shape[0]])
   img = cv2.resize(img, (int(img.shape[1] * r), int(img.shape[0] * r)))
   mask = cv2.resize(mask, (int(mask.shape[1] * r), int(mask.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
   return img, mask

def get_points(mask, num_points):  # Sample points inside the input mask
   points = []
   coords = np.argwhere(mask > 0)
   for i in range(num_points):
       yx = np.array(coords[np.random.randint(len(coords))])
       points.append([[yx[1], yx[0]]])
   return np.array(points)
Lalu muat gambar contoh untuk inferensi, beserta bobot hasil fine-tuning yang baru, dan lakukan inferensi dengan menyetel torch.no_grad().
# Randomly select a test image from the test_data
selected_entry = random.choice(test_data)
image_path = selected_entry['image']
mask_path = selected_entry['annotation']

# Load the selected image and mask
image, mask = read_image(image_path, mask_path)

# Generate random points for the input
num_samples = 30  # Number of points per segment to sample
input_points = get_points(mask, num_samples)

# Load the fine-tuned model
FINE_TUNED_MODEL_WEIGHTS = "fine_tuned_sam2_1000.torch"
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")

# Build net and load weights
predictor = SAM2ImagePredictor(sam2_model)
predictor.model.load_state_dict(torch.load(FINE_TUNED_MODEL_WEIGHTS))

# Perform inference and predict masks
with torch.no_grad():
   predictor.set_image(image)
   masks, scores, logits = predictor.predict(
       point_coords=input_points,
       point_labels=np.ones([input_points.shape[0], 1])
   )

# Process the predicted masks and sort by scores
np_masks = np.array(masks[:, 0])
np_scores = scores[:, 0]
sorted_masks = np_masks[np.argsort(np_scores)][::-1]

# Initialize segmentation map and occupancy mask
seg_map = np.zeros_like(sorted_masks[0], dtype=np.uint8)
occupancy_mask = np.zeros_like(sorted_masks[0], dtype=bool)

# Combine masks to create the final segmentation map
for i in range(sorted_masks.shape[0]):
   mask = sorted_masks[i]
   if (mask * occupancy_mask).sum() / mask.sum() > 0.15:
       continue

   mask_bool = mask.astype(bool)
   mask_bool[occupancy_mask] = False  # Set overlapping areas to False in the mask
   seg_map[mask_bool] = i + 1  # Use boolean mask to index seg_map
   occupancy_mask[mask_bool] = True  # Update occupancy_mask

# Visualization: Show the original image, mask, and final segmentation side by side
plt.figure(figsize=(18, 6))

plt.subplot(1, 3, 1)
plt.title('Test Image')
plt.imshow(image)
plt.axis('off')

plt.subplot(1, 3, 2)
plt.title('Original Mask')
plt.imshow(mask, cmap='gray')
plt.axis('off')

plt.subplot(1, 3, 3)
plt.title('Final Segmentation')
plt.imshow(seg_map, cmap='jet')
plt.axis('off')

plt.tight_layout()
plt.show()
Pada langkah ini, kita menggunakan model yang telah di-fine-tune untuk menghasilkan mask segmentasi pada gambar uji. Mask yang diprediksi kemudian divisualisasikan berdampingan dengan gambar asli dan mask ground truth untuk mengevaluasi performa model.
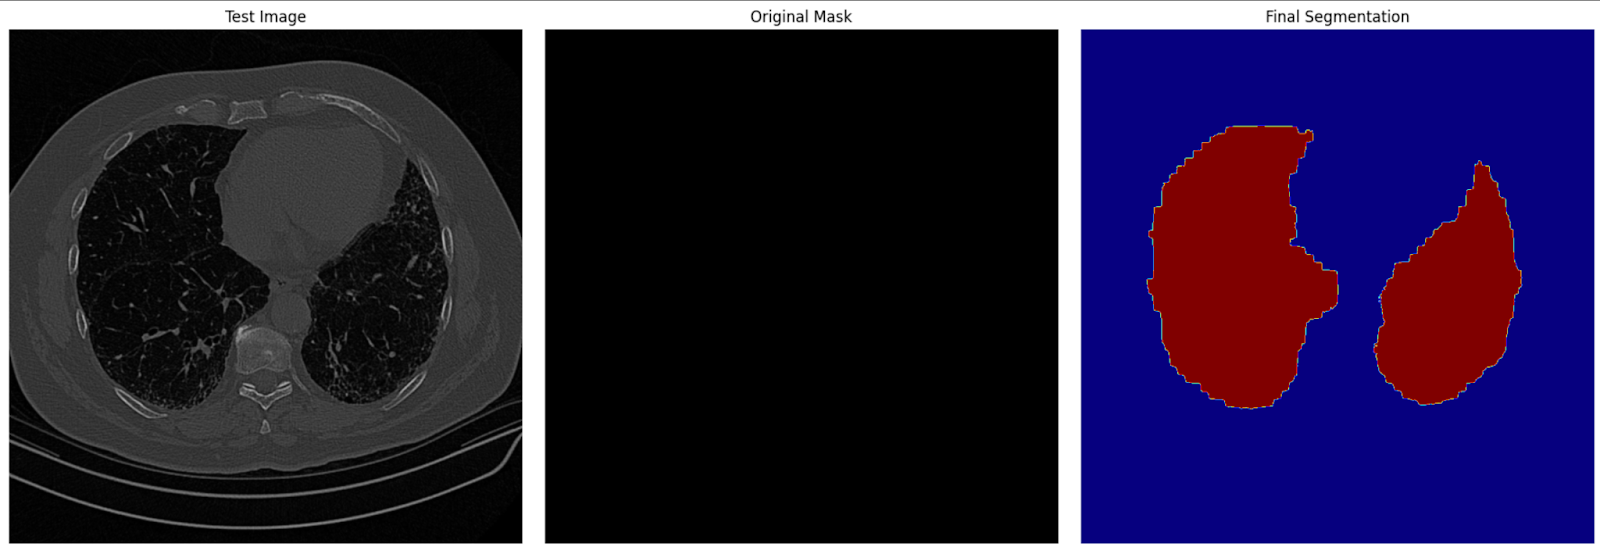
Citra segmentasi akhir pada data uji
Fine-tuning SAM2 menawarkan cara praktis untuk meningkatkan kemampuannya pada tugas-tugas spesifik. Baik Anda mengerjakan pencitraan medis, kendaraan otonom, maupun penyuntingan video, fine-tuning memungkinkan Anda memanfaatkan SAM2 untuk kebutuhan unik Anda. Dengan mengikuti panduan ini, Anda dapat menyesuaikan SAM2 untuk proyek Anda dan meraih hasil segmentasi tingkat terdepan.
Untuk kasus lanjutan, pertimbangkan melakukan fine-tuning pada komponen SAM2 lainnya, seperti image encoder. Meski memerlukan sumber daya lebih besar, opsi ini menawarkan fleksibilitas dan peningkatan performa yang lebih tinggi.
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




