
{count, plural, one {Kursus} other {Kursus}}
Retrieval Augmented Generation (RAG) dengan LangChain
{hours} jam
21K
Seiring kecerdasan buatan terus berkembang, salah satu tantangan utama adalah bagaimana mengintegrasikan pengetahuan secara efektif ke dalam Large Language Models (LLM), mengingat keterbatasan pengetahuan yang dimilikinya. Untuk mengatasi keterbatasan ini, para peneliti dan praktisi mengeksplorasi berbagai pendekatan integrasi pengetahuan.
Dua pendekatan terpenting saat ini adalah retrieval-augmented generation, atau RAG, dan cache-augmented generation, atau CAG. Saya telah bekerja dengan kedua pendekatan tersebut, dan meskipun sering disajikan sebagai pesaing, menurut saya keduanya lebih seperti alat berbeda untuk pekerjaan berbeda—bahkan terkadang lebih baik jika digunakan bersama.
Dalam artikel ini, saya akan mengulas perbandingan RAG dan CAG, mengeksplorasi arti masing-masing konsep, cara kerjanya, dan di mana keduanya paling cocok dalam aplikasi dunia nyata. Pada akhirnya, Anda akan melihat bagaimana pendekatan ini berbeda, di mana keduanya saling tumpang tindih, dan bagaimana memilih di antara keduanya, atau bahkan mengombinasikannya, saat merancang sistem AI.
Jika Anda ingin melampaui konsep dan mulai membangun sistem ini sendiri, saya sarankan mengikuti kursus praktik kami, Retrieval Augmented Generation (RAG) with LangChain.
Retrieval-augmented generation adalah teknik yang memungkinkan model AI melampaui data pelatihan yang statis dan memasukkan informasi eksternal secara dinamis. Alih-alih hanya mengandalkan apa yang dikodekan ke dalam model saat pelatihan,
RAG menghubungkan model ke basis data eksternal dan mekanisme pengambilan (retrieval), sehingga dapat mengambil dokumen atau pengetahuan relevan saat kueri diajukan.
Gagasan ini semakin populer ketika organisasi menyadari bahwa data pelatihan statis cepat usang. Saya melihat sendiri bagaimana informasi berubah setiap hari di banyak industri, dan model tanpa lapisan retrieval eksternal tidak bisa mengikutinya.
RAG dikembangkan untuk menutup kesenjangan ini dan membawa pengetahuan yang segar, spesifik domain, atau dinamis langsung ke proses generasi.
Alur kerja RAG dimulai dengan kueri pengguna. Kueri terlebih dahulu dikodekan menjadi representasi vektor, yang kemudian digunakan untuk mencari ke basis data vektor (sistem retrieval) yang berisi dokumen, rekaman, atau sumber pengetahuan lainnya. Tahap retrieval ini memastikan model mengidentifikasi informasi eksternal yang paling relevan sebelum melanjutkan.
Strategi chunking yang efisien sangat penting pada tahap ini: dokumen dipecah menjadi unit makna yang lebih kecil, biasanya antara 100 hingga 1.000 token, sehingga sistem retrieval dapat menampilkan konteks paling relevan tanpa membebani model generasi.
Algoritme retrieval, yang sering didasarkan pada pencarian approximate nearest neighbor, memastikan potongan (chunk) relevan diambil dengan cepat bahkan dari basis pengetahuan skala besar.
Setelah dokumen relevan diambil, dokumen tersebut diteruskan ke tahap generasi, di mana model bahasa mengintegrasikan informasi ini ke dalam responnya. Proses ini memungkinkan sistem menghasilkan jawaban yang tidak hanya lebih koheren, tetapi juga berlandaskan pengetahuan eksternal yang mutakhir.
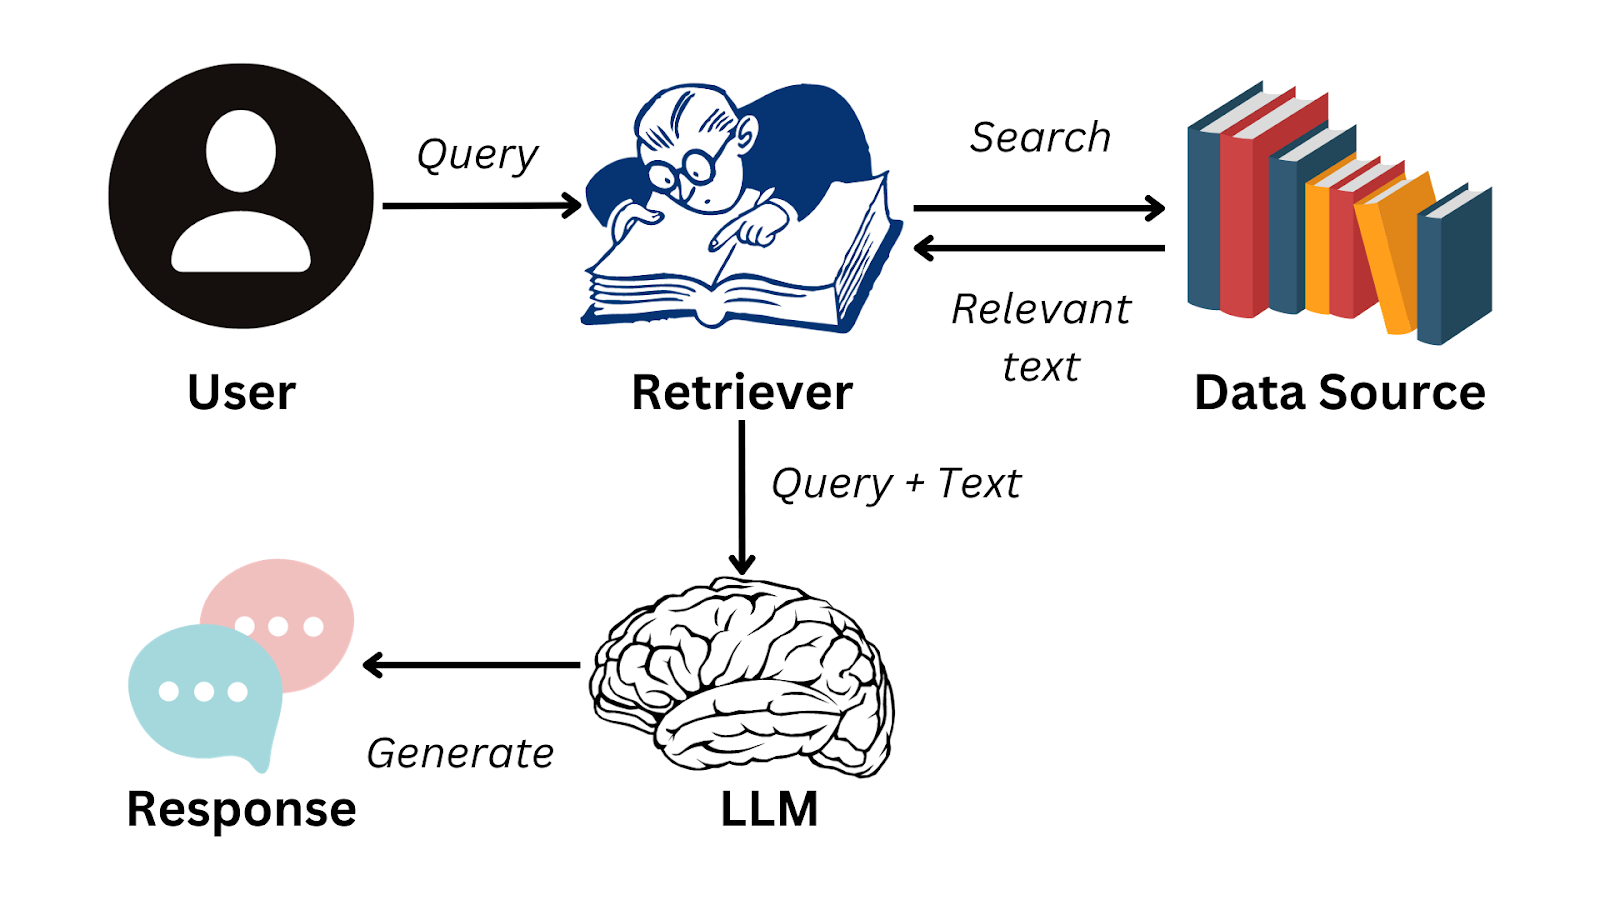
Alur kerja RAG
Sumber pengetahuan eksternal bisa mencakup basis data proprietari, makalah ilmiah, arsip hukum, atau bahkan API real-time. Mesin retrieval adalah jembatan yang memungkinkan model bahasa menggabungkan kemampuan generatifnya dengan data faktual. Anggap saja seperti memberi AI Anda kartu perpustakaan alih-alih berharap ia menghafal semua buku.
Struktur dasar ini dapat disempurnakan dengan menerapkan teknik RAG tingkat lanjut atau menggunakan Corrective RAG (CRAG), versi yang ditingkatkan dari RAG yang dioptimalkan untuk akurasi.
Sekarang setelah kita melihat bagaimana RAG disusun dan dioperasikan, akan lebih mudah mengevaluasi apa yang membuat metode ini sangat kuat dalam skenario dunia nyata.
Hal yang paling saya sukai dari RAG adalah kemampuannya menghadapi perubahan. Departemen hukum Anda memperbarui kebijakan pukul 15.00? Sistem RAG Anda mengetahuinya pada pukul 15.01—tanpa perlu pelatihan ulang.
Berdasarkan pengalaman saya, RAG unggul dalam tiga area utama:
Pembaruan real-time: Lapisan retrieval terhubung ke pengetahuan eksternal, memberikan jawaban berdasarkan data terbaru. Ini membuat RAG sangat berharga di bidang yang cepat berubah seperti kedokteran, keuangan, atau teknologi.
Lebih sedikit halusinasi: LLM sering menghasilkan teks yang terdengar masuk akal tetapi salah secara faktual. Dengan membumikan jawaban pada dokumen yang diambil, RAG memastikan keluaran memiliki landasan faktual, sehingga meningkatkan keandalan.
Integrasi data yang fleksibel: Pengetahuan eksternal dapat berasal dari berbagai sumber, seperti basis data terstruktur, API semi-terstruktur, atau repositori teks tak terstruktur. Organisasi dapat menyesuaikan pipeline retrieval sesuai kebutuhan spesifik mereka.
Meskipun RAG menawarkan keunggulan yang menarik, sama pentingnya untuk memahami tantangan dan keterbatasan yang menyertainya.
Di sinilah jadi rumit, dan ini yang selalu saya sampaikan kepada klien sejak awal. RAG memiliki beberapa trade-off nyata:
Kompleksitas sistem: Anda perlu mengorkestrasi sistem retrieval, basis data vektor, dan model generasi. Kompleksitas ini menciptakan titik kegagalan tambahan dan meningkatkan beban pemeliharaan.
Masalah latensi: Proses retrieval menambah beban komputasi pada setiap kueri. Mencari di basis pengetahuan besar dan mengambil dokumen relevan membutuhkan waktu, yang dapat mengganggu pengalaman pengguna pada aplikasi real-time.
Ketergantungan pada kualitas retrieval: Respon Anda hanya sebaik mekanisme retrieval Anda. Retrieval yang buruk berarti konteks tidak relevan masuk ke model bahasa, yang dapat menurunkan kualitas jawaban.
Namun, ada beberapa teknik kunci untuk meningkatkan performa RAG dan mengatasi masalah ini secara efektif.
Setelah menjelajahi pendekatan berfokus pada retrieval, sekarang saya beralih ke cache-augmented generation, yang mengambil jalur berbeda untuk meningkatkan kinerja model.
CAG adalah pendatang baru, dan jujur, saya butuh waktu untuk menghargai keanggunannya. Alih-alih terus-menerus mengambil informasi seperti RAG, CAG memuat terlebih dahulu apa yang Anda butuhkan dan menyimpannya siap pakai.
Berbeda dengan pendekatan retrieval dinamis pada RAG, CAG berfokus pada pra-pemuatan dan pemeliharaan informasi relevan di konteks yang diperluas atau memori cache model. Gambar berikut membandingkan kedua pendekatan:
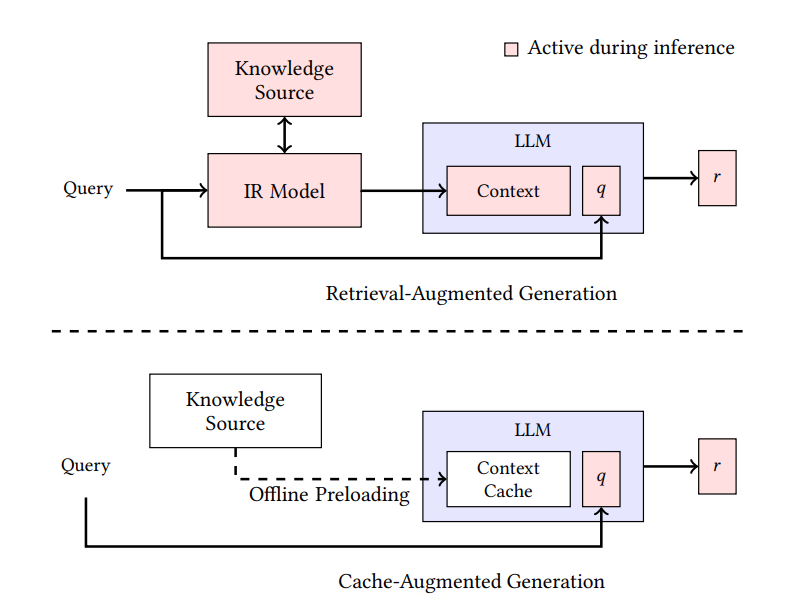
Perbandingan arsitektur RAG dan CAG
CAG semakin menonjol seiring berkembangnya model bahasa yang mendukung jendela konteks semakin besar, terkadang hingga jutaan token. Ini seperti perbedaan antara mencari setiap jawaban di buku referensi versus memiliki catatan ringkas yang sudah Anda siapkan.
CAG mengandalkan dua mekanisme caching yang saling melengkapi.
Pertama, knowledge caching terjadi ketika dokumen atau materi referensi yang relevan dimuat sebelumnya ke dalam jendela konteks yang diperluas pada model. Setelah disimpan, model dapat menggunakan kembali informasi ini di berbagai kueri tanpa perlu mengambilnya secara eksternal, seperti yang dilakukan sistem RAG.
Kedua, key-value (KV) caching berfokus pada efisiensi dengan menyimpan state atensi (matriks key dan value) yang dihasilkan saat model memproses token. Ketika kueri serupa atau berulang datang, model dapat menggunakan ulang state yang di-cache ini alih-alih menghitungnya dari nol.
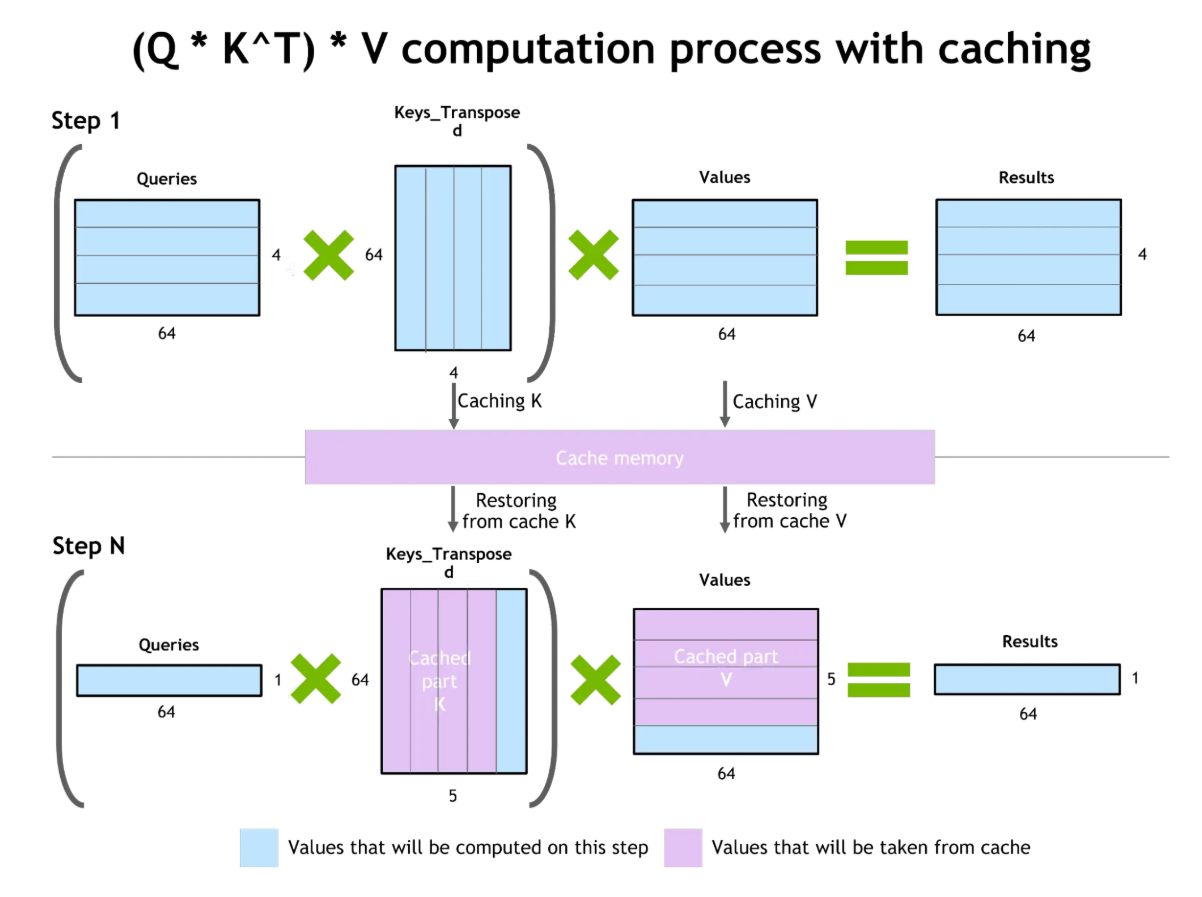
Mekanisme ini mengurangi latensi dan memungkinkan model mempertahankan konteks jangka lebih panjang di seluruh percakapan. Alur kerja ini memperluas memori efektif sistem, memungkinkannya menangani riwayat dialog yang lebih panjang atau kueri berulang tanpa harus memulai dari awal setiap kali.
Gagasan utamanya adalah caching memperluas batas praktis dari apa yang bisa diingat model. Dengan menyimpan informasi dan merujuknya dengan cepat, CAG menciptakan pengalaman kontinuitas di sepanjang percakapan yang lebih panjang.
Dengan alur kerja ini, kita mulai melihat mengapa CAG semakin menarik untuk aplikasi tertentu, terutama ketika kecepatan dan efisiensi menjadi prioritas utama
Kekuatan utama CAG terletak pada efisiensinya. Karena model menggunakan kembali perhitungan yang di-cache, waktu respons meningkat secara signifikan, mengurangi latensi, terutama dalam skenario di mana kueri bersifat repetitif atau kebutuhan pengetahuan tetap stabil. Di sinilah CAG benar-benar unggul:
Kecepatan dan efisiensi: Penggunaan ulang perhitungan yang di-cache sangat meningkatkan waktu respons, terutama untuk kueri berulang atau kebutuhan pengetahuan yang stabil.
Konsistensi lintas sesi: Dengan menyimpan konteks sebelumnya, CAG menghindari pergeseran jawaban dan memastikan koherensi. Ini ideal untuk agen percakapan, otomasi alur kerja, atau chatbot dukungan pelanggan yang sering menerima kueri berulang.
Kompleksitas sistem lebih rendah: Karena model tidak perlu sering melakukan pencarian eksternal, keseluruhan sistem lebih sederhana dibandingkan RAG.
Terlepas dari keunggulannya, tidak ada teknik tanpa trade-off, dan CAG memperkenalkan serangkaian tantangannya sendiri yang harus dipertimbangkan dengan cermat oleh organisasi.
Informasi usang: Data yang di-cache menjadi kedaluwarsa seiring waktu, sehingga sistem mungkin tidak mencerminkan pembaruan terbaru atau perubahan dinamis pada basis pengetahuan.
Kebutuhan memori besar: Memelihara cache besar memerlukan sumber daya komputasi yang substansial. Organisasi harus menyeimbangkan ukuran cache dengan memori dan kemampuan pemrosesan yang tersedia.
Manajemen cache yang kompleks: Memastikan informasi yang di-cache tetap akurat dan tersinkronisasi di seluruh deployment terdistribusi memerlukan mekanisme koordinasi canggih—dan kompleksitas ini meningkat seiring skala sistem.
Setelah menelaah RAG dan CAG secara terpisah, langkah berikutnya adalah membandingkannya secara langsung dan menyoroti perbedaan krusial yang membentuk adopsinya dalam praktik.
Jadi, mana yang sebaiknya Anda gunakan? Pertanyaan ini sering saya terima, dan jawaban jujur saya: tergantung pada apa yang Anda bangun. Setelah bekerja dengan kedua pendekatan di berbagai proyek, saya melihat beberapa pola jalas. Izinkan saya merangkum apa yang saya pelajari dari implementasi nyata.
|
Fitur |
RAG (Retrieval-Augmented Generation) |
CAG (Cache-Augmented Generation) |
|
Mekanisme Inti |
Just-in-Time: Mengambil data relevan dari basis data eksternal saat kueri berlangsung. |
Pra-Muat: Memuat data relevan ke konteks atau cache model sebelum kueri. |
|
Latensi & Kecepatan |
Lebih lambat: Memerlukan waktu untuk mencari, mengambil, dan memproses dokumen sebelum menghasilkan jawaban. |
Paling cepat: Mengakses informasi seketika dari memori, menghilangkan overhead retrieval. |
|
Kebaruan Pengetahuan |
Real-Time: Dapat mengakses data yang diperbarui beberapa detik lalu (misalnya berita terkini, undang-undang baru). |
Snapshot: Pengetahuan hanya seterkini pembaruan cache terakhir; berisiko menjadi "usang". |
|
Use Case Terbaik |
Dataset dinamis dan masif (misalnya, Yurisprudensi, Riset Medis, Berita). |
Dataset stabil dan repetitif (misalnya, Aturan Kepatuhan, FAQ, Prosedur Operasi Standar). |
|
Skalabilitas |
Horizontal: Skala dengan baik bersama basis data yang luas; dibatasi oleh kecepatan pencarian. |
Terikat Memori: Dibatasi oleh ukuran jendela konteks model dan RAM yang tersedia. |
|
Kompleksitas |
Tinggi: Memerlukan pengelolaan basis data vektor, pipeline embedding, dan logika retrieval. |
Moderat: Memerlukan pengelolaan siklus hidup cache, optimasi konteks, dan efisiensi memori. |
|
Penanganan Halusinasi |
Membumikan jawaban pada dokumen yang diambil (sitasi). |
Membumikan jawaban pada konteks yang konsisten dan pra-muat. |
RAG dan CAG mengambil pendekatan yang secara fundamental berbeda terhadap akses pengetahuan. RAG mengikuti model just-in-time: mengkodekan kueri pengguna, mencari basis data vektor, mengambil dokumen relevan, lalu meneruskannya ke tahap generasi. Desain ini memastikan akses ke informasi terbaru, tetapi langkah retrieval tambahan menimbulkan latensi.
Secara arsitektural, sistem RAG bergantung pada pipeline multi-tahap yang menggabungkan chunking dokumen, pencarian vektor, dan koordinasi retrieval. Chunking dokumen harus mempertahankan makna semantik sambil tetap efisien untuk retrieval, dan pencarian vektor sering mengandalkan algoritme approximate nearest neighbor untuk menangani koleksi skala besar tanpa biaya tinggi.
Sebaliknya, CAG beroperasi melalui pra-pemuatan. Alih-alih mencari keluar untuk pengetahuan baru, ia mengandalkan jendela konteks yang diperluas dan memori cache untuk menggunakan kembali informasi yang sebelumnya disimpan. Pendekatan spasial ini mengurangi latensi karena model mengambil dari memori, bukan dari basis data eksternal.
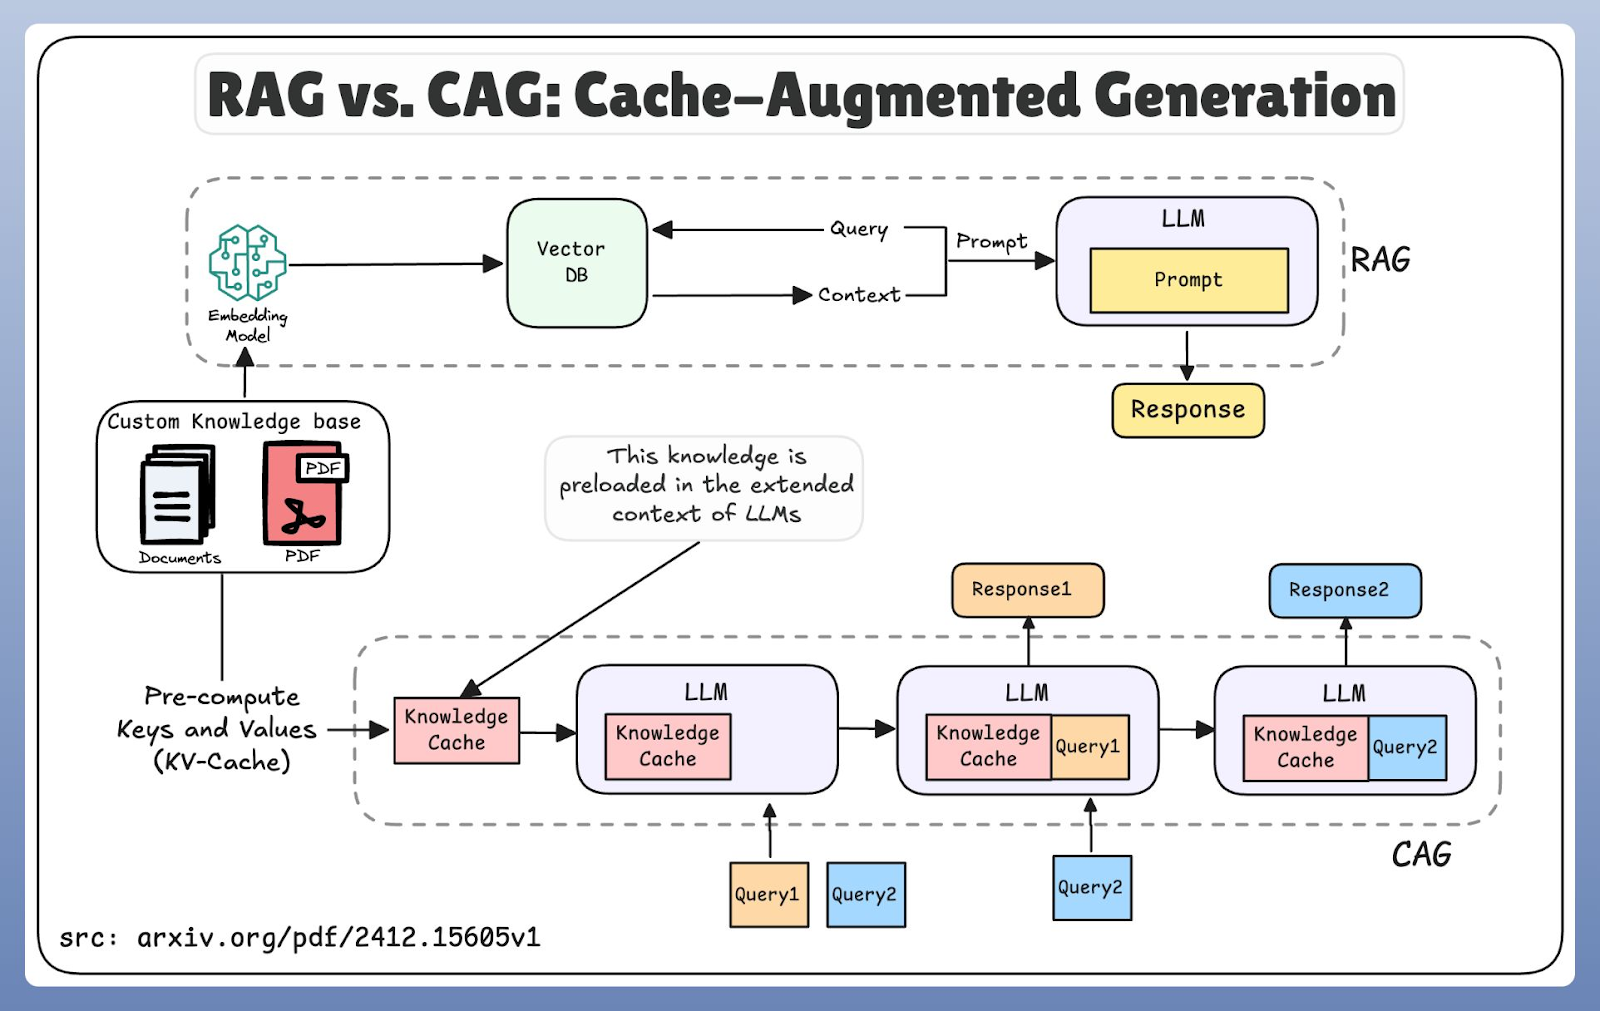
Perbandingan alur kerja RAG dan CAG
Namun, trade-off-nya adalah kebaruan: informasi yang di-cache bisa tertinggal dari pembaruan dunia nyata. Karena itu, sistem CAG berfokus pada manajemen cache yang cerdas, menggunakan strategi penggantian cache, alokasi memori, dan optimasi jendela konteks.
Saya telah melihat sistem produksi di mana trade-off ini menentukan berhasil atau tidaknya implementasi, dan efektivitas strategi ini secara langsung menentukan kinerja dan skalabilitas sistem.
Di luar arsitektur teknis, ada dimensi praktis yang layak dibahas: bagaimana setiap sistem menangani perubahan.
Berikut pengamatan saya tentang kemampuan beradaptasi:
Fleksibilitas RAG: Mekanisme retrieval dinamis memungkinkan sistem ini mengakses informasi baru segera setelah diindeks. Saya menyaksikan sistem memperbarui basis pengetahuan secara real-time, sempurna untuk domain yang berkembang cepat.
Rigiditas CAG: Informasi yang di-cache sebelumnya berarti lebih konsisten tetapi kurang adaptif. Meskipun ini memberikan kecepatan dan perilaku yang dapat diprediksi, pendekatan ini kesulitan menghadapi kueri tak terduga yang tidak diantisipasi saat persiapan cache.
Menurut pengalaman saya, perbedaan ini paling penting ketika domain Anda tidak dapat diprediksi atau terus berkembang.
Sekarang mari bahas akurasi dan bagaimana tiap pendekatan menangani kecenderungan AI mengada-ada.
Kedua teknik menangani halusinasi secara berbeda berdasarkan arsitektur dasarnya. Sistem RAG mengurangi halusinasi dengan membumikan respons pada informasi faktual yang diambil, memberikan validasi eksternal untuk konten yang dihasilkan.
Sistem CAG mengurangi halusinasi melalui akses konsisten ke informasi yang telah diverifikasi dan di-cache. Namun, jika informasi yang di-cache tidak akurat atau menjadi usang, kesalahan ini dapat bertahan di banyak interaksi.
Aspek paling krusial muncul saat Anda memikirkan deployment produksi dalam skala besar. Berikut beberapa trade-off performa yang pernah saya temui:
Sistem RAG: Latensi lebih tinggi karena overhead retrieval, tetapi Anda dapat melakukan penskalaan horizontal dengan menambah kapasitas retrieval dan mendistribusikan basis data vektor. Dalam praktiknya, ini bekerja baik setelah Anda berinvestasi pada infrastrukturnya.
Sistem CAG: Waktu respons unggul tetapi skalabilitasnya dibatasi memori. Bottleneck biasanya terjadi ketika overhead manajemen cache tumbuh lebih cepat daripada anggaran memori Anda.
Pertanyaan skalabilitas jarang sederhana. Ini sangat bergantung pada pola kueri dan sumber daya yang tersedia.
Baiklah, cukup teori. Mari praktis. Setelah menerapkan kedua pendekatan di berbagai proyek, berikut kerangka saya untuk memutuskan mana yang digunakan.
Begini biasanya saya membimbing tim melalui keputusan ini. Organisasi harus menilai volatilitas informasi, kebutuhan latensi, kebutuhan konsistensi, dan ketersediaan sumber daya saat memilih antara RAG dan CAG. Volatilitas informasi yang tinggi mendukung RAG, sementara domain pengetahuan yang stabil mendapat manfaat dari efisiensi CAG.
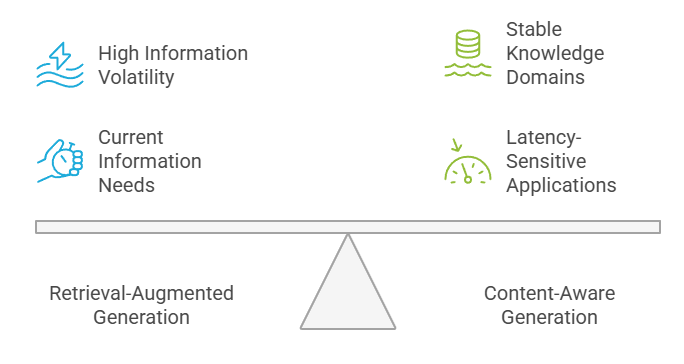
Kerangka Keputusan: RAG vs. CAG
Aplikasi yang sensitif terhadap latensi biasanya berkinerja lebih baik dengan sistem CAG, sedangkan aplikasi yang memerlukan informasi paling mutakhir sebaiknya memanfaatkan kemampuan RAG. Keputusan ini sering kali melibatkan penyeimbangan kebutuhan yang bersaing berdasarkan prioritas bisnis.
Pilih RAG ketika Anda membutuhkan:
Informasi dinamis dan sering diperbarui: Aplikasi riset, dukungan pelanggan untuk produk yang terus berkembang, atau platform analisis berita di mana kekinian lebih penting daripada kecepatan.
Basis pengetahuan besar dan beragam: Platform riset hukum, sistem informasi medis, dan aplikasi intelijen kompetitif. Menurut pengalaman saya, jika data Anda berubah harian atau mingguan, RAG biasanya pilihan tepat.
Ketika biaya menyajikan data usang lebih tinggi daripada biaya tambahan latensi.
Biasanya saya mengatakan kepada klien: jika Anda khawatir AI memberikan jawaban usang, mulailah dengan RAG. Kecepatan bisa dioptimalkan kemudian. Jika memilih RAG, jangan lupa untuk memilih kerangka kerja yang tepat.
Pilih CAG ketika Anda memiliki:
Kebutuhan pengetahuan yang stabil: Chatbot layanan pelanggan yang menangani pertanyaan rutin, platform edukasi dengan kurikulum mapan, atau otomasi alur kerja di mana pengetahuan inti tidak banyak berubah.
Volume kueri tinggi dengan pola repetitif: Jika Anda menjawab 100 pertanyaan yang sama ribuan kali per hari, keunggulan kecepatan CAG akan sangat terasa.
Aplikasi kritis terhadap latensi: Sistem rekomendasi real-time, pengalaman gim interaktif, atau di mana milidetik berpengaruh pada pengalaman pengguna.
Menurut saya, CAG ideal ketika Anda dapat memprediksi 90% kueri Anda, dan basis pengetahuan Anda relatif stabil.
Mari saya tunjukkan bagaimana ini diterapkan dalam praktik. Saya telah bekerja (dan mempelajari) implementasi di berbagai industri, dan muncul beberapa pola yang jelas. Berikut yang benar-benar berhasil di produksi.
Mari mulai analisis industri dengan kesehatan, di mana kebutuhan akan akses informasi yang akurat dan tepat waktu sangat tinggi.
Dalam aplikasi kesehatan, sistem RAG mendukung pengambilan keputusan klinis dengan mengambil riset medis terbaru, protokol perawatan, dan informasi interaksi obat. Tenaga medis mendapat manfaat dari akses ke pedoman klinis terkini dan temuan studi terbaru yang mungkin tidak termasuk dalam data pelatihan model.
Sistem CAG berguna pada skenario kesehatan yang memerlukan akses cepat ke protokol baku, ringkasan riwayat pasien, dan prosedur diagnostik standar di mana konsistensi dan kecepatan menjadi yang utama.
Menurut saya, kesehatan adalah bidang yang paling jelas untuk pendekatan hibrida: CAG untuk protokol standar, RAG untuk hal-hal yang berubah.
Keuangan adalah kasus menarik lainnya. Di sini, kebutuhannya sangat berbeda dari di bidang kesehatan.
Lembaga keuangan menggunakan sistem RAG untuk analisis pasar, pemantauan kepatuhan regulasi, dan riset investasi, di mana akses ke data pasar real-time dan perubahan regulasi terbaru sangat krusial. Sistem ini dapat terintegrasi dengan basis data keuangan dan umpan berita untuk memberi wawasan pasar terkini.
Di sisi lain, sistem CAG unggul dalam aplikasi keuangan yang memerlukan respons cepat terhadap pertanyaan rutin, seperti perhitungan keuangan standar, definisi produk, dan prosedur kepatuhan yang telah ditetapkan.
Yang saya perhatikan di keuangan, keputusan sering bergantung pada risiko regulasi. Jika kesalahan bisa berujung denda jutaan karena kepatuhan, tim cenderung memilih RAG.
Pendidikan juga menjadi lahan subur bagi RAG dan CAG.
Platform pembelajaran personal sering mendapat manfaat dari RAG, karena siswa memerlukan akses ke konten yang beragam dan terus diperbarui, termasuk artikel riset baru, materi kursus, atau bahkan peristiwa terkini sebagai contoh pembelajaran. Dengan RAG, tutor AI dapat menyediakan referensi akurat atau bacaan tambahan yang tidak menjadi bagian dari set pelatihan awalnya.
Sebaliknya, CAG berkinerja baik dalam situasi di mana repetisi dan konsistensi adalah kunci. Misalnya, ketika platform menyajikan kuis rutin, penjelasan konsep standar, atau sesi latihan terstruktur, caching memastikan penyampaian umpan balik yang lebih cepat dan konsisten.
Dengan cara ini, sistem pendidikan sering mengombinasikan kedua teknik, memadukan wawasan segar dengan penguatan pengetahuan inti yang andal.
Beralih ke dunia perangkat lunak, developer semakin mengadopsi kedua metode untuk meningkatkan produktivitas.
RAG mendukung developer dengan mengambil dokumentasi, spesifikasi API, atau langkah pemecahan masalah dari sumber eksternal. Karena library atau framework perangkat lunak dapat berubah cepat, lapisan retrieval RAG unggul dalam memastikan jawaban tetap mutakhir.
Sementara itu, CAG berperan pada tugas yang sangat bergantung pada interaksi berulang, seperti pelengkapan kode otomatis, bantuan debugging, atau menanggapi pertanyaan pengembang yang berulang. Dengan melakukan caching pada pola yang pernah terlihat, CAG mengurangi latensi dan mempercepat alur kerja pengembangan.
Bersama-sama, pendekatan ini memungkinkan engineer bergerak lebih cepat sambil mengandalkan panduan yang akurat dan kontekstual.
Sektor hukum menghadirkan studi kasus menarik lainnya tentang bagaimana pendekatan ini menangani tantangan spesifik domain dengan pola akses informasi yang berbeda.
Profesional hukum memanfaatkan sistem RAG untuk riset yurisprudensi dan telaah kontrak, di mana akses ke dokumen kontrak terbaru dan preseden hukum sangat penting. Ini memungkinkan mereka memastikan nasihat hukum mencerminkan putusan pengadilan dan perubahan regulasi terkini segera setelah diterbitkan.
Sebaliknya, CAG adalah pilihan unggul untuk pemantauan kepatuhan internal dan penegakan kebijakan otomatis, terutama ketika aturannya tetap dan kuerinya berulang. Alih-alih mengambil "Pedoman Anti-Suap" atau "GDPR Pasal 15" yang sama ribuan kali sehari, sistem CAG memuat kerangka regulasi statis ini langsung ke konteks model.
Karena "kebenaran" inti (hukum) jarang berubah dari hari ke hari, melakukan caching pengetahuan ini menghilangkan hambatan retrieval untuk 90% kueri berupa pemeriksaan kepatuhan standar.
Di ritel dan e-commerce, kecepatan dan relevansi secara langsung membentuk pengalaman pelanggan.
RAG sering digunakan untuk mendukung pencarian produk lanjutan, mengintegrasikan data inventaris langsung, dan memberikan rekomendasi dinamis. Misalnya, jika pelanggan menanyakan apakah produk tersedia, sistem bertenaga RAG dapat memeriksa basis data real-time untuk memberikan jawaban terkini.
Di sisi lain, CAG memastikan respons cepat terhadap pertanyaan pelanggan umum, seperti kebijakan pengiriman, aturan pengembalian, atau status pesanan. Dengan menggunakan ulang interaksi yang di-cache, sistem memberikan jawaban instan dan mengurangi beban server.
Jika digunakan bersama, RAG dan CAG menciptakan pengalaman mulus yang menawarkan akurasi sekaligus efisiensi.
Sampai titik ini, kita memperlakukan RAG dan CAG sebagai teknik terpisah. Namun dalam praktik, banyak organisasi mulai mengadopsi pendekatan hibrida yang mengintegrasikan keduanya. Kombinasi ini memungkinkan mereka menyeimbangkan kebaruan dan adaptabilitas RAG dengan kecepatan dan efisiensi CAG.
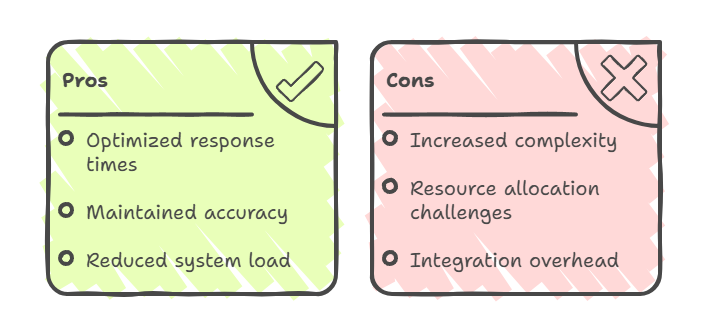
Pendekatan Hibrida: Kelebihan dan Kekurangan
Sistem hibrida mewakili evolusi berikutnya dalam integrasi pengetahuan, menggabungkan kemampuan retrieval dinamis RAG dengan manfaat efisiensi CAG.
Dalam model hibrida ini, CAG biasanya digunakan untuk informasi yang sering diakses dan stabil, sementara RAG diterapkan untuk kueri yang memerlukan data real-time atau pengetahuan khusus. Hasilnya adalah “yang terbaik dari keduanya”: waktu respons teroptimasi untuk kueri umum, akurasi terjaga untuk konten dinamis, dan beban sistem keseluruhan berkurang melalui perutean cerdas.
Namun, pendekatan hibrida meningkatkan kompleksitas arsitektur. Pendekatan ini memerlukan orkestrasi canggih antara sistem caching dan retrieval, serta penyeimbangan cermat dalam alokasi sumber daya.
Overhead integrasi mencakup pengelolaan jalur pengetahuan ganda, pemeliharaan sinkronisasi antara data yang di-cache dan yang diambil, serta implementasi logika perutean cerdas untuk menentukan metode mana yang digunakan untuk setiap kueri.
Jika Anda ingin menggunakan solusi hibrida, Anda benar-benar perlu memahami apa yang Anda lakukan.
Menurut pengalaman saya, adopsi arsitektur hibrida yang paling luas saat ini ditemukan dalam ekosistem layanan pelanggan. Saya sering melihat platform di mana CAG menangani FAQ statis ber-volume tinggi untuk pengambilan instan, sementara RAG diterapkan secara selektif untuk mengambil detail akun langsung atau riwayat transaksi.
Contoh klasik lainnya dapat ditemukan pada aplikasi riset, di mana CAG mempertahankan pengetahuan dasar yang di-cache sementara RAG mengambil publikasi terbaru atau data dinamis untuk kueri baru. Demikian pula, pada platform e-commerce, CAG menangani deskripsi produk atau kebijakan yang di-cache, sementara RAG mengintegrasikan level inventaris dan pembaruan harga real-time.
Tidak ada jawaban universal yang benar di sini, dan siapa pun yang mengatakan sebaliknya mungkin sedang menjual sesuatu. Pilihan antara RAG dan CAG, atau keputusan untuk mengombinasikannya, pada akhirnya bergantung pada kebutuhan, keterbatasan, dan tujuan spesifik Anda.
RAG unggul ketika Anda membutuhkan akses ke informasi yang dinamis dan mutakhir serta dapat mentolerir sedikit latensi demi akurasi dan kebaruan. CAG bersinar pada skenario di mana kecepatan dan konsistensi paling penting, dan kebutuhan pengetahuan Anda relatif stabil.
Ke depan, kita mungkin akan melihat pendekatan hibrida yang lebih canggih yang merutekan kueri secara cerdas antara informasi yang di-cache dan yang diambil, mengoptimalkan baik kinerja maupun akurasi.
Untuk menguasai keterampilan lengkap yang diperlukan untuk merancang dan menerapkan sistem RAG, CAG, atau hibrida, pertimbangkan untuk mendaftar ke jalur karier AI Engineer kami yang komprehensif.
Kursus Generative AI
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



