Naarmate kunstmatige intelligentie zich blijft ontwikkelen, is een van de centrale uitdagingen hoe je kennis effectief integreert in Large Language Models (LLM’s), gezien hun beperkte kennis. Om deze beperkingen te overwinnen, hebben onderzoekers en practitioners verschillende benaderingen voor kennisintegratie verkend.
Twee van de belangrijkste benaderingen vandaag zijn retrieval-augmented generation (RAG) en cache-augmented generation (CAG). Ik heb met beide gewerkt, en hoewel ze vaak als concurrenten worden neergezet, zie ik ze meer als verschillende tools voor verschillende taken—soms zelfs beter in combinatie.
In dit artikel neem ik je mee in een vergelijking van RAG en CAG: wat ze betekenen, hoe ze werken en waar ze het beste passen in echte toepassingen. Aan het einde zie je hoe deze benaderingen verschillen, waar ze overlappen en hoe je ertussen kunt kiezen—of ze zelfs kunt combineren—bij het ontwerpen van AI-systemen.
Als je verder wilt gaan dan de concepten en zelf met deze systemen aan de slag wilt, raad ik onze praktijkgerichte cursus Retrieval Augmented Generation (RAG) met LangChain aan.
Wat is Retrieval-Augmented Generation (RAG)?
Retrieval-augmented generation is een techniek waarmee AI-modellen verder kunnen reiken dan hun vaste trainingsdata en dynamisch externe informatie kunnen integreren. In plaats van alleen te vertrouwen op wat tijdens de training in het model is gecodeerd,
verbindt RAG het model met externe databases en retrievalmechanismen, zodat het bij een query relevante documenten of kennis kan ophalen.
Dit idee won aan populariteit toen organisaties inzagen dat statische trainingsdata snel verouderen. Ik zie in veel sectoren hoe informatie dagelijks verandert, en een model zonder externe retrievallaag kan dat niet bijbenen.
RAG is ontwikkeld om dit gat te dichten en actuele, domeinspecifieke of dynamische kennis direct in het generatieproces te brengen.
Hoe werkt RAG?
De RAG-workflow begint met een gebruikersquery. De query wordt eerst gecodeerd naar een vectorrepresentatie, die vervolgens wordt gebruikt om een vectordatabank (retrievalsysteem) te doorzoeken met documenten, records of andere kennisbronnen. Deze retrievalfase zorgt ervoor dat het model de meest relevante externe informatie identificeert voordat het verder gaat.
Efficiënte chunkingstrategieën zijn in deze fase cruciaal: documenten worden opgeknipt in kleinere betekenisvolle eenheden, doorgaans 100 tot 1.000 tokens, zodat het retrievalsysteem de meest relevante context kan tonen zonder het generatiemodel te overladen.
Retrievalalgoritmen, vaak gebaseerd op approximate nearest neighbor-zoektechnieken, zorgen ervoor dat relevante chunks snel worden opgehaald, zelfs uit grootschalige kennisbases.
Zodra relevante documenten zijn opgehaald, gaan ze door naar de generatiefase, waar het taalmodel deze informatie integreert in zijn antwoord. Zo kan het systeem antwoorden produceren die niet alleen coherenter zijn, maar ook verankerd in externe, actuele kennis.
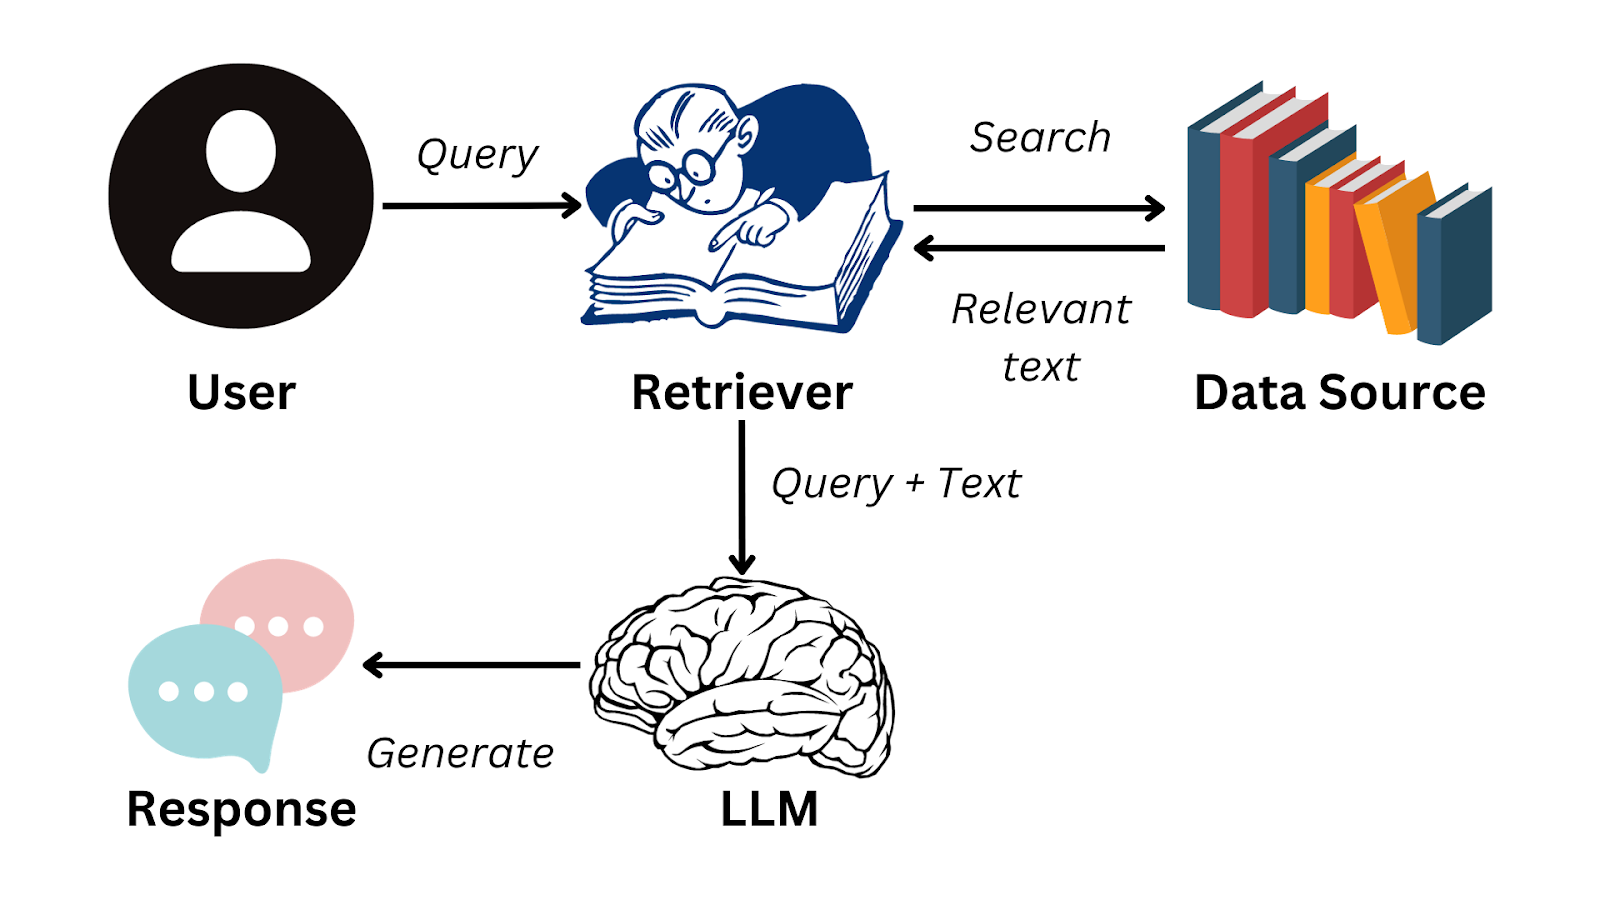
RAG-workflow
De externe kennisbronnen kunnen bestaan uit propriëtaire databases, wetenschappelijke artikelen, juridische archieven of zelfs realtime API’s. De retrievalengine is de brug die het taalmodel in staat stelt zijn generatieve vermogen te combineren met feitelijke data. Zie het als je AI een bibliotheekpasje geven in plaats van te hopen dat het elk boek uit het hoofd kent.
Deze basisstructuur kan verfijnd worden door advanced geavanceerde RAG-technieken toe te passen of Corrective RAG (CRAG) te gebruiken, een verbeterde versie van RAG die geoptimaliseerd is voor nauwkeurigheid.
Nu we hebben bekeken hoe RAG is opgebouwd en werkt, is het eenvoudiger te beoordelen wat deze methode in praktijksituaties zo krachtig maakt.
Sterke punten van RAG
Wat ik het mooist vind aan RAG is hoe het met verandering omgaat. Werkt je juridische afdeling een beleid bij om 15:00? Je RAG-systeem weet het om 15:01—zonder hertraining.
Uit mijn ervaring blinkt RAG uit op drie hoofdpunten:
-
Realtime updates: De retrievallaag verbindt met externe kennis en levert antwoorden op basis van de nieuwste data. Dit maakt RAG bijzonder waardevol in snel veranderende domeinen zoals geneeskunde, financiën of technologie.
-
Minder hallucinaties: LLM’s genereren vaak tekst die aannemelijk klinkt maar feitelijk onjuist is. Door antwoorden te verankeren in opgehaalde documenten zorgt RAG voor een feitelijke basis, wat de betrouwbaarheid verhoogt.
-
Flexibele dataintegratie: Externe kennis kan uit meerdere bronnen komen, zoals gestructureerde databases, semi-gestructureerde API’s of ongestructureerde tekstbestanden. Organisaties kunnen retrievalpipelines afstemmen op hun specifieke behoeften.
Hoewel RAG sterke voordelen biedt, is het net zo belangrijk om de uitdagingen en beperkingen te begrijpen die bij deze aanpak horen.
Beperkingen van RAG
Hier wordt het lastig, en hiervoor waarschuw ik mijn klanten altijd vooraf. RAG kent echte trade-offs:
-
Systeemcomplexiteit: Je moet het retrievalsysteem, de vectordatabank en het generatiemodel orkestreren. Die complexiteit creëert extra faalpunten en verhoogt het onderhoud.
-
Latencyproblemen: Het retrievalproces voegt rekenoverhead toe aan elke query. Zoeken in grote kennisbases en relevante documenten ophalen kost tijd, wat de gebruikerservaring in realtime toepassingen kan schaden.
-
Afhankelijkheid van retrievalkwaliteit: Je antwoorden zijn maar zo goed als je retrievalmechanisme. Slechte retrieval betekent dat irrelevante context naar het taalmodel gaat, wat de kwaliteit kan verslechteren.
Er zijn echter verschillende belangrijke technieken om de RAG-prestaties te verbeteren en deze problemen effectief aan te pakken.
Na de retrievalgerichte aanpak te hebben verkend, stap ik nu over op cache-augmented generation, dat een heel andere route neemt om modelprestaties te verbeteren.
Wat is Cache-Augmented Generation (CAG)?
CAG is de nieuwkomer, en eerlijk: het duurde even voordat ik de elegantie ervan echt waardeerde. In plaats van constant informatie op te halen zoals RAG, laadt CAG vooraf wat je nodig hebt en houdt het paraat.
In tegenstelling tot RAG’s dynamische retrievalbenadering richt CAG zich op het vooraf laden en onderhouden van relevante informatie in de uitgebreide context of cachegeheugen van het model. De volgende graphic vergelijkt beide benaderingen:
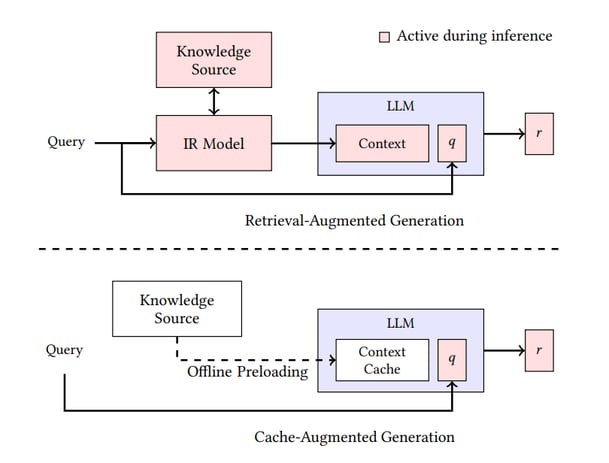
RAG- en CAG-architecturen vergeleken
CAG won aan belang met de komst van taalmodellen met steeds grotere contextvensters, soms oplopend tot miljoenen tokens. Het is het verschil tussen elk antwoord opzoeken in een naslagwerk of een spiekbriefje hebben dat je al hebt voorbereid.
Hoe werkt CAG?
CAG steunt op twee complementaire cachingmechanismen.
Ten eerste vindt kenniscaching plaats wanneer relevante documenten of referentiemateriaal vooraf in het uitgebreide contextvenster van het model worden geladen. Eenmaal opgeslagen kan het model deze informatie hergebruiken over meerdere queries, zonder deze extern op te halen zoals RAG-systemen doen.
Ten tweede richt key-value (KV) caching zich op efficiëntie door de attention states (key- en valuematrices) op te slaan die ontstaan wanneer het model tokens verwerkt. Bij een vergelijkbare of herhaalde query kan het model deze cached states hergebruiken in plaats van ze opnieuw te berekenen.
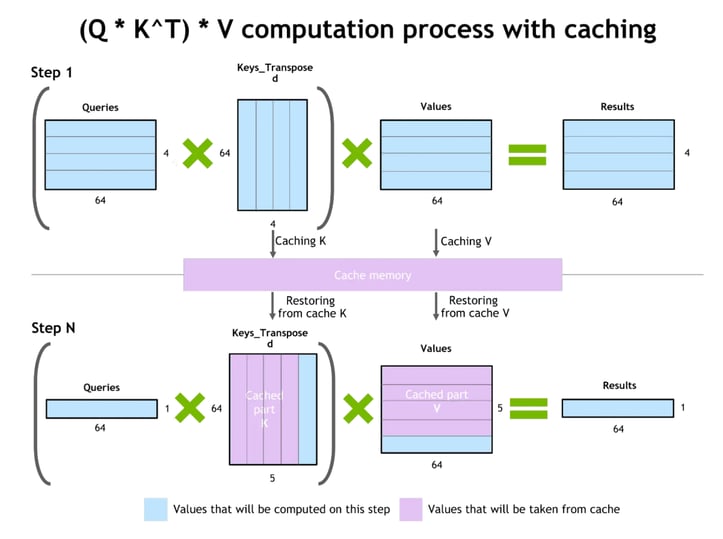
Key-Value Caching
Dit mechanisme verlaagt de latency en stelt het model in staat om langere-termijncontext in gesprekken te behouden. De workflow vergroot het effectieve geheugen van het systeem, zodat het langere dialooggeschiedenissen of herhalende queries aankan zonder telkens opnieuw te beginnen.
De kern is dat caching de praktische grenzen van wat een model kan onthouden, oprekt. Door informatie te bewaren en snel te raadplegen, creëert CAG een gevoel van continuïteit over langere gesprekken.
Met deze workflow in gedachten zie je waarom CAG steeds aantrekkelijker wordt voor bepaalde toepassingen, zeker wanneer snelheid en efficiëntie topprioriteit zijn
Sterke punten van CAG
De belangrijkste kracht van CAG zit in de efficiëntie. Omdat het model cached berekeningen hergebruikt, verbeteren de responstijden aanzienlijk en daalt de latency, vooral wanneer queries zich herhalen of de kennis stabiel blijft. Hier blinkt CAG echt uit:
-
Snelheid en efficiëntie: Het hergebruiken van cached berekeningen verbetert de responstijden drastisch, vooral bij repetitieve queries of stabiele kennisbehoeften.
-
Consistentie over sessies heen: Door eerdere context op te slaan voorkomt CAG afglijdende antwoorden en waarborgt het coherentie. Ideaal voor conversatie-agents, workflow-automatisering of klantenservicechatbots met veel herhaalde vragen.
-
Lagere systeemcomplexiteit: Omdat het model minder vaak externe lookups hoeft te doen, is het totale systeem eenvoudiger dan bij RAG.
Beperkingen van CAG
Ondanks deze voordelen is geen enkele techniek zonder trade-offs, en CAG introduceert zijn eigen set uitdagingen waar organisaties goed over moeten nadenken.
-
Verouderde informatie: Cached data veroudert na verloop van tijd, waardoor systemen recente updates of dynamische wijzigingen mogelijk niet weerspiegelen.
-
Zware geheugeneisen: Het onderhouden van grote caches vereist aanzienlijke rekenresources. Organisaties moeten de cachegrootte zorgvuldig balanceren met beschikbaar geheugen en rekenkracht.
-
Complex cachebeheer: Zorgen dat gecachte informatie accuraat en gesynchroniseerd blijft in gedistribueerde omgevingen vereist geavanceerde coördinatiemechanismen—en die complexiteit groeit naarmate het systeem schaalt.
Nu we zowel RAG als CAG afzonderlijk hebben bekeken, is de volgende stap ze direct te vergelijken en de cruciale verschillen te benadrukken die hun toepassing in de praktijk bepalen.
RAG vs CAG: belangrijkste verschillen
Welke moet je nu echt gebruiken? Die vraag krijg ik voortdurend, en mijn eerlijke antwoord is: het hangt af van wat je bouwt. Na met beide benaderingen te hebben gewerkt in verschillende projecten, zie ik duidelijke patronen. Dit is wat ik heb geleerd van echte implementaties.
|
Kenmerk
|
RAG (Retrieval-Augmented Generation)
|
CAG (Cache-Augmented Generation)
|
|
Kernmechanisme
|
Just-in-time: Haalt relevante data op uit een externe database tijdens de query.
|
Vooraf geladen: Laadt relevante data in de context of cache van het model vóór de query.
|
|
Latency & snelheid
|
Langzamer: Kost tijd om documenten te zoeken, op te halen en te verwerken vóór het antwoord.
|
Allersnelst: Benadert informatie direct uit het geheugen, zonder retrieval-overhead.
|
|
Actualiteit van kennis
|
Realtime: Kan data raadplegen die seconden geleden is bijgewerkt (bijv. breaking news, nieuwe wetten).
|
Momentopname: Kennis is zo actueel als de laatste cache-update; risico op "veroudering".
|
|
Beste use-case
|
Dynamische, enorme datasets (bijv. jurisprudentie, medisch onderzoek, nieuws).
|
Stabiele, repetitieve datasets (bijv. complianceregels, FAQ’s, standaardprocedures).
|
|
Schaalbaarheid
|
Horizontaal: Schaalt goed met enorme databases; beperkt door zoektijd.
|
Geheugen-gebonden: Beperkt door de contextvenstergrootte van het model en beschikbare RAM.
|
|
Complexiteit
|
Hoog: Vereist beheer van vectordatabanken, embeddingpipelines en retrievallogica.
|
Gemiddeld: Vereist beheer van cachelevenscyclus, contextoptimalisatie en geheugenefficiëntie.
|
|
Omgaan met hallucinaties
|
Verankert antwoorden in opgehaalde documenten (citaten).
|
Verankert antwoorden in consistente, vooraf geladen context.
|
Vergelijking van architectuur en workflow
RAG en CAG kiezen fundamenteel verschillende routes naar kennis. RAG volgt een just-in-time model: het encodeert de query van de gebruiker, doorzoekt een vectordatabank, haalt relevante documenten op en geeft die door aan de generatiefase. Dit zorgt voor toegang tot de meest recente informatie, maar de extra retrievalstap introduceert latency.
Architectonisch leunen RAG-systemen op meertraps-pipelines die documentchunking, vectorzoektocht en retrievalcoördinatie combineren. Documentchunking moet semantische betekenis behouden en tegelijk efficiënt zijn voor retrieval, en vectorzoektocht gebruikt vaak approximate nearest neighbor-algoritmen om grote collecties te verwerken zonder hoge kosten.
CAG werkt daarentegen via vooraf laden. In plaats van naar buiten te reiken voor nieuwe kennis, vertrouwt het op uitgebreide contextvensters en cachegeheugen om eerder opgeslagen informatie te hergebruiken. Deze ruimtelijke aanpak vermindert de latency omdat het model uit geheugen haalt in plaats van uit een externe database.
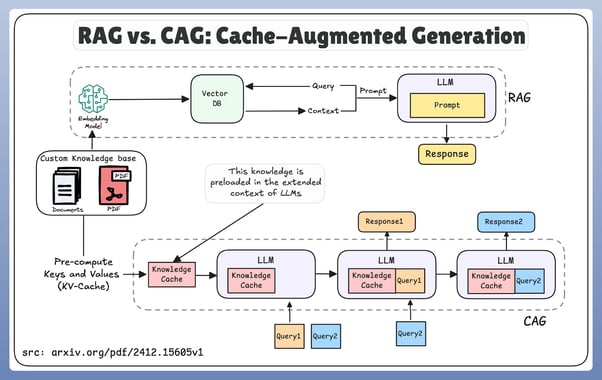
Vergelijking van RAG- en CAG-workflows
De keerzijde is echter actualiteit: gecachte informatie kan achterlopen op echte updates. Daarom richten CAG-systemen zich op slim cachebeheer, met strategieën voor cachevervanging, geheugentoewijzing en optimalisatie van het contextvenster.
Ik heb productiesystemen gezien waar deze trade-off de implementatie maakte of brak; de effectiviteit van deze strategieën bepaalt direct zowel de prestaties als de schaalbaarheid van het systeem.
Los van de technische architectuur is er ook een praktische dimensie: hoe elk systeem met verandering omgaat.
Flexibiliteit vs. rigiditeit
Dit is wat ik heb gezien rond aanpasbaarheid:
-
Flexibiliteit van RAG: Het dynamische retrievalmechanisme laat systemen nieuwe informatie meteen na indexering benaderen. Ik heb systemen hun kennisbasis realtime zien updaten—perfect voor snel evoluerende domeinen.
-
Rigiditeit van CAG: Vooraf gecachte informatie betekent meer consistentie maar minder flexibiliteit. Dat levert snelheid en voorspelbaar gedrag op, maar het worstelt met onverwachte queries die niet in de cachevoorbereiding zaten.
Naar mijn ervaring telt dit verschil het meest wanneer je domein onvoorspelbaar is of constant verandert.
Omgaan met hallucinaties
Laten we het nu hebben over nauwkeurigheid en hoe elke aanpak omgaat met de neiging van AI om dingen te verzinnen.
Beide technieken pakken hallucinaties anders aan, gebaseerd op hun architectuur. RAG-systemen beperken hallucinaties door antwoorden te verankeren in opgehaalde feitelijke informatie, wat externe validatie biedt voor de gegenereerde content.
CAG-systemen verminderen hallucinaties via consistente toegang tot geverifieerde, gecachte informatie. Maar als de cache onjuistheden bevat of verouderd raakt, kunnen die fouten zich over meerdere interacties voortzetten.
Prestaties en schaalbaarheid
Het wordt pas echt spannend bij productie op schaal. Dit zijn enkele prestatietrade-offs die ik ben tegengekomen:
-
RAG-systemen: Hogere latency door retrieval-overhead, maar horizontaal schaalbaar door extra retrievalcapaciteit toe te voegen en vectordatabanken te distribueren. In de praktijk werkt dit goed als je in de infrastructuur investeert.
-
CAG-systemen: Betere responstijden, maar schaalbaarheid wordt beperkt door geheugen. De bottleneck ontstaat vaak wanneer de overhead van cachebeheer sneller groeit dan je geheugenbudget toelaat.
De schaalbaarheidsvraag is zelden eenvoudig. Het hangt sterk af van je querypatronen en beschikbare resources.
Wanneer gebruik je RAG vs CAG?
Genoeg theorie. Laten we praktisch worden. Na implementaties met beide benaderingen hanteer ik deze leidraad om te beslissen welke je gebruikt.
Besliskader
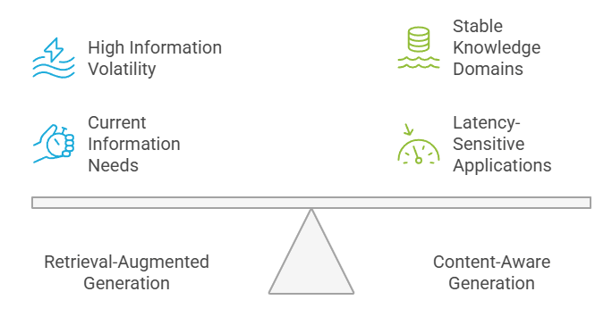
Zo begeleid ik teams meestal. Beoordeel de volatiliteit van je informatie, latency-eisen, behoefte aan consistentie en beschikbare resources bij de keuze tussen RAG en CAG. Hoge informatievolatiliteit pleit voor RAG, terwijl stabiele kennisdomeinen profiteren van de efficiëntie van CAG.
Besliskader: RAG vs. CAG
Latency-gevoelige toepassingen presteren meestal beter met CAG-systemen, terwijl applicaties die de meest actuele informatie vereisen juist RAG gebruiken. De keuze draait vaak om het balanceren van deze concurrerende eisen op basis van zakelijke prioriteiten.
Gebruik RAG wanneer...
Kies RAG wanneer je nodig hebt:
-
Dynamische, vaak geüpdatete informatie: Onderzoekstoepassingen, klantenondersteuning voor evoluerende producten of nieuwsanalyses waar actueel zijn belangrijker is dan snelheid.
-
Grote, diverse kennisbases: Platforms voor juridisch onderzoek, medische informatiesystemen en concurrentie-intelligentie. Als je data dagelijks of wekelijks verandert, is RAG doorgaans de juiste keuze.
-
Bescherming tegen verouderde informatie: Wanneer de kosten van verouderde data hoger zijn dan de kosten van extra latency.
Ik zeg klanten meestal: als je bang bent dat je AI verouderde antwoorden geeft, begin dan met RAG. Snelheid kun je later altijd optimaliseren. Als je voor RAG gaat, vergeet dan niet om het juiste framework te kiezen.
Gebruik CAG wanneer...
Kies CAG wanneer je hebt:
-
Stabiele kennisbehoeften: Klantenservicechatbots voor routinematige vragen, educatieve platforms met vaste curricula of workflow-automatisering waarbij de kernkennis weinig verandert.
-
Hoge queryvolumes met repetitieve patronen: Als je dezelfde 100 vragen duizenden keren per dag beantwoordt, stapelt CAG’s snelheidsvoordeel snel op.
-
Latency-kritische applicaties: Realtime aanbevelingssystemen, interactieve game-ervaringen of overal waar milliseconden tellen voor de gebruikerservaring.
Mijn ervaring: CAG is ideaal wanneer je 90% van je queries kunt voorspellen en je kennisbasis relatief stabiel is.
Toepassingen en use-cases van RAG en CAG in de praktijk
Zo werkt het in de praktijk. Ik heb implementaties gezien (en bestudeerd) in verschillende sectoren en er tekenen zich duidelijke patronen af. Dit werkt daadwerkelijk in productie.
Zorg
We beginnen met de zorg, waar de inzet voor accurate en tijdige informatie bijzonder hoog is.
In zorgtoepassingen ondersteunen RAG-systemen klinische besluitvorming door het nieuwste medisch onderzoek, behandelprotocollen en informatie over geneesmiddelinteracties op te halen. Zorgprofessionals profiteren van toegang tot actuele richtlijnen en recente bevindingen die mogelijk niet in de trainingsdata van het model zitten.
CAG is waardevol in zorgscenario’s waar snelle toegang tot vaste protocollen, samenvattingen van patiëntgeschiedenis en gestandaardiseerde diagnoseprocedures cruciaal is voor consistentie en snelheid.
Naar mijn mening zie je in de zorg de duidelijkste casus voor hybride aanpakken: CAG voor standaardprotocollen, RAG voor alles wat verandert.
Financiën
Financiën is een ander interessant geval, met totaal andere eisen dan in de zorg.
Financiële instellingen gebruiken RAG voor marktanalyse, monitoring van regelgeving en beleggingsonderzoek, waar toegang tot realtime marktdata en recente regelwijzigingen cruciaal is. Deze systemen kunnen integreren met financiële databases en nieuwsfeeds om actuele marktinzichten te bieden.
CAG blinkt juist uit in financiële toepassingen die snelle antwoorden op routinematige vragen vereisen, zoals standaard financiële berekeningen, productdefinities en vaste complianceprocedures.
Wat mij in de financiële sector opvalt, is dat de keuze vaak neerkomt op regelgevingsrisico. Als fouten miljoenen aan boetes kunnen kosten, kiezen teams eerder voor RAG.
Onderwijs
Ook het onderwijs is vruchtbare grond voor zowel RAG als CAG.
Gepersonaliseerde leerplatforms profiteren vaak van RAG, omdat studenten diverse en constant geüpdatete content nodig hebben, waaronder nieuwe onderzoeksartikelen, cursusmateriaal of zelfs actualiteiten als lesvoorbeelden. Met RAG kan een AI-tutor nauwkeurige referenties of aanvullende literatuur bieden die niet in de oorspronkelijke trainingsset zat.
CAG presteert daarentegen goed in situaties waar herhaling en consistentie key zijn. Bijvoorbeeld bij regelmatige quizzen, uitleg van standaardconcepten of gestructureerde oefensessies zorgt caching voor snellere en consistentere feedback.
Zo combineren onderwijssystemen vaak beide technieken: frisse inzichten met betrouwbare herhaling van kernkennis.
Software-engineering
In de softwarewereld omarmen ontwikkelaars beide methoden steeds vaker om de productiviteit te verhogen.
RAG ondersteunt ontwikkelaars door documentatie, API-specificaties of stappen voor probleemoplossing uit externe bronnen op te halen. Omdat softwarebibliotheken of -frameworks snel veranderen, blinkt de retrievallaag van RAG uit in actualiteit.
CAG speelt intussen een rol bij taken met veel herhaling, zoals code-autocompletion, debug-assistentie of antwoorden op terugkerende ontwikkelaarsvragen. Door eerder geziene patronen te cachen, verlaagt CAG de latency en versnelt het de ontwikkelworkflow.
Samen stellen deze benaderingen engineers in staat sneller te werken met accurate, contextbewuste ondersteuning.
Juridisch en compliance
De juridische sector is een ander interessant voorbeeld van hoe deze benaderingen domeinspecifieke uitdagingen aanpakken met verschillende toegangspatronen tot informatie.
Juridische professionals gebruiken RAG voor jurisprudentieonderzoek en contractreview, waar toegang tot de meest recente contractdocumenten en juridische precedenten essentieel is. Zo kunnen ze zeker weten dat hun adviezen de nieuwste rechtspraak en regelgeving reflecteren zodra die verschijnt.
CAG is daarentegen superieur voor interne compliancebewaking en geautomatiseerde handhaving van beleid, vooral wanneer de regels vastliggen en de queries repetitief zijn. In plaats van duizenden keren per dag dezelfde "Anti-corruptierichtlijnen" of "AVG artikel 15" op te halen, laadt een CAG-systeem deze statische kaders vooraf in de context van het model.
Omdat de kern van de "waarheid" (de wet) niet dagelijks verandert, elimineert het cachen van deze kennis de retrievalbottleneck voor 90% van de standaard compliancechecks.
Retail
In retail en e-commerce bepalen snelheid en relevantie direct de klantervaring.
RAG wordt vaak ingezet voor geavanceerd productzoeken, integratie van live voorraaddata en dynamische aanbevelingen. Vraagt een klant of een product op voorraad is, dan kan een RAG-systeem realtime databases raadplegen voor een actueel antwoord.
CAG zorgt daarentegen voor snelle antwoorden op veelgestelde vragen, zoals verzendbeleid, retourregels of orderstatus. Door gecachte interacties te hergebruiken, levert het systeem directe antwoorden en verlaagt het de serverbelasting.
Samen bieden RAG en CAG een naadloze ervaring die zowel accuraat als efficiënt is.
Hybride aanpakken en systeemintegratie
Tot nu toe hebben we RAG en CAG als afzonderlijke technieken behandeld. In de praktijk adopteren veel organisaties echter hybride aanpakken die beide methoden integreren. Zo kunnen ze de actualiteit en flexibiliteit van RAG balanceren met de snelheid en efficiëntie van CAG.
Hybride aanpakken: voor- en nadelen
Voordelen van hybride modellen
Hybride systemen zijn de volgende stap in kennisintegratie: ze combineren de dynamische retrieval van RAG met de efficiëntievoordelen van CAG.
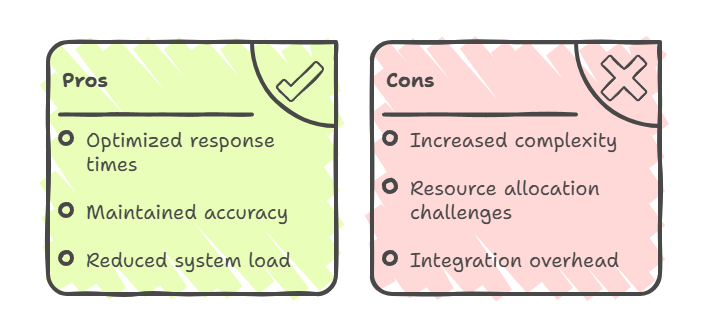
In deze modellen gebruik je CAG meestal voor vaak geraadpleegde, stabiele informatie, terwijl RAG wordt ingezet voor queries die realtime data of gespecialiseerde kennis vereisen. Dit resulteert in “het beste van twee werelden”: geoptimaliseerde responstijden voor veelvoorkomende vragen, behouden nauwkeurigheid voor dynamische content en een lagere systeembelasting via slimme routering.
Uitdagingen van hybride modellen
Hybride aanpakken brengen echter meer architecturale complexiteit mee. Ze vereisen geavanceerde orkestratie tussen caching- en retrievalsystemen en vragen om zorgvuldige balans in resourceallocatie.
De integratieoverhead omvat het beheren van dubbele kennispaden, het synchroniseren van gecachte en opgehaalde data en het implementeren van intelligente routeringslogica die per query bepaalt welke methode wordt gebruikt.
Als je voor een hybride oplossing gaat, moet je echt weten wat je doet.
Voorbeelden van hybride use-cases
De meest wijdverspreide adoptie van hybride architecturen zie ik momenteel in klantservicesystemen. Vaak zie ik platforms waar CAG de statische FAQ’s met hoog volume direct afhandelt, terwijl RAG selectief wordt ingezet voor live accountgegevens of transactiehistorie.
Een ander klassiek voorbeeld is te vinden in onderzoekstoepassingen, waar CAG gecachte basiskennis bewaart terwijl RAG de nieuwste publicaties of dynamische data ophaalt voor nieuwe vragen. Evenzo handelt CAG in e-commerceplatforms gecachte productbeschrijvingen of beleidsregels af, terwijl RAG realtime voorraadniveaus en prijsupdates integreert.
Conclusie
Er is geen universeel juist antwoord, en wie dat beweert, verkoopt je waarschijnlijk iets. De keuze tussen RAG en CAG, of de beslissing om ze te combineren, hangt uiteindelijk af van jouw specifieke eisen, beperkingen en doelen.
RAG blinkt uit wanneer je toegang tot dynamische, actuele informatie nodig hebt en enige latency accepteert in ruil voor nauwkeurigheid en actualiteit. CAG schittert in scenario’s waar snelheid en consistentie het belangrijkst zijn en je kennisbehoeften relatief stabiel blijven.
In de toekomst zullen we waarschijnlijk meer geavanceerde hybride aanpakken zien die queries intelligent routeren tussen gecachte en opgehaalde informatie, geoptimaliseerd voor zowel performance als nauwkeurigheid.
Wil je de volledige skillset beheersen om RAG-, CAG- of hybride systemen te ontwerpen en te deployen, overweeg dan onze uitgebreide AI Engineer-carrièreroute.


Naarmate kunstmatige intelligentie zich blijft ontwikkelen, is een van de centrale uitdagingen hoe je kennis effectief integreert in Large Language Models (LLM’s), gezien hun beperkte kennis. Om deze beperkingen te overwinnen, hebben onderzoekers en practitioners verschillende benaderingen voor kennisintegratie verkend.
Twee van de belangrijkste benaderingen vandaag zijn retrieval-augmented generation (RAG) en cache-augmented generation (CAG). Ik heb met beide gewerkt, en hoewel ze vaak als concurrenten worden neergezet, zie ik ze meer als verschillende tools voor verschillende taken—soms zelfs beter in combinatie.
In dit artikel neem ik je mee in een vergelijking van RAG en CAG: wat ze betekenen, hoe ze werken en waar ze het beste passen in echte toepassingen. Aan het einde zie je hoe deze benaderingen verschillen, waar ze overlappen en hoe je ertussen kunt kiezen—of ze zelfs kunt combineren—bij het ontwerpen van AI-systemen.
Als je verder wilt gaan dan de concepten en zelf met deze systemen aan de slag wilt, raad ik onze praktijkgerichte cursus Retrieval Augmented Generation (RAG) met LangChain aan.
Wat is Retrieval-Augmented Generation (RAG)?
Retrieval-augmented generation is een techniek waarmee AI-modellen verder kunnen reiken dan hun vaste trainingsdata en dynamisch externe informatie kunnen integreren. In plaats van alleen te vertrouwen op wat tijdens de training in het model is gecodeerd,
verbindt RAG het model met externe databases en retrievalmechanismen, zodat het bij een query relevante documenten of kennis kan ophalen.
Dit idee won aan populariteit toen organisaties inzagen dat statische trainingsdata snel verouderen. Ik zie in veel sectoren hoe informatie dagelijks verandert, en een model zonder externe retrievallaag kan dat niet bijbenen.
RAG is ontwikkeld om dit gat te dichten en actuele, domeinspecifieke of dynamische kennis direct in het generatieproces te brengen.
Hoe werkt RAG?
De RAG-workflow begint met een gebruikersquery. De query wordt eerst gecodeerd naar een vectorrepresentatie, die vervolgens wordt gebruikt om een vectordatabank (retrievalsysteem) te doorzoeken met documenten, records of andere kennisbronnen. Deze retrievalfase zorgt ervoor dat het model de meest relevante externe informatie identificeert voordat het verder gaat.
Efficiënte chunkingstrategieën zijn in deze fase cruciaal: documenten worden opgeknipt in kleinere betekenisvolle eenheden, doorgaans 100 tot 1.000 tokens, zodat het retrievalsysteem de meest relevante context kan tonen zonder het generatiemodel te overladen.
Retrievalalgoritmen, vaak gebaseerd op approximate nearest neighbor-zoektechnieken, zorgen ervoor dat relevante chunks snel worden opgehaald, zelfs uit grootschalige kennisbases.
Zodra relevante documenten zijn opgehaald, gaan ze door naar de generatiefase, waar het taalmodel deze informatie integreert in zijn antwoord. Zo kan het systeem antwoorden produceren die niet alleen coherenter zijn, maar ook verankerd in externe, actuele kennis.
RAG-workflow
De externe kennisbronnen kunnen bestaan uit propriëtaire databases, wetenschappelijke artikelen, juridische archieven of zelfs realtime API’s. De retrievalengine is de brug die het taalmodel in staat stelt zijn generatieve vermogen te combineren met feitelijke data. Zie het als je AI een bibliotheekpasje geven in plaats van te hopen dat het elk boek uit het hoofd kent.
Deze basisstructuur kan verfijnd worden door advanced geavanceerde RAG-technieken toe te passen of Corrective RAG (CRAG) te gebruiken, een verbeterde versie van RAG die geoptimaliseerd is voor nauwkeurigheid.
Nu we hebben bekeken hoe RAG is opgebouwd en werkt, is het eenvoudiger te beoordelen wat deze methode in praktijksituaties zo krachtig maakt.
Sterke punten van RAG
Wat ik het mooist vind aan RAG is hoe het met verandering omgaat. Werkt je juridische afdeling een beleid bij om 15:00? Je RAG-systeem weet het om 15:01—zonder hertraining.
Uit mijn ervaring blinkt RAG uit op drie hoofdpunten:
Realtime updates: De retrievallaag verbindt met externe kennis en levert antwoorden op basis van de nieuwste data. Dit maakt RAG bijzonder waardevol in snel veranderende domeinen zoals geneeskunde, financiën of technologie.
Minder hallucinaties: LLM’s genereren vaak tekst die aannemelijk klinkt maar feitelijk onjuist is. Door antwoorden te verankeren in opgehaalde documenten zorgt RAG voor een feitelijke basis, wat de betrouwbaarheid verhoogt.
Flexibele dataintegratie: Externe kennis kan uit meerdere bronnen komen, zoals gestructureerde databases, semi-gestructureerde API’s of ongestructureerde tekstbestanden. Organisaties kunnen retrievalpipelines afstemmen op hun specifieke behoeften.
Hoewel RAG sterke voordelen biedt, is het net zo belangrijk om de uitdagingen en beperkingen te begrijpen die bij deze aanpak horen.
Beperkingen van RAG
Hier wordt het lastig, en hiervoor waarschuw ik mijn klanten altijd vooraf. RAG kent echte trade-offs:
Systeemcomplexiteit: Je moet het retrievalsysteem, de vectordatabank en het generatiemodel orkestreren. Die complexiteit creëert extra faalpunten en verhoogt het onderhoud.
Latencyproblemen: Het retrievalproces voegt rekenoverhead toe aan elke query. Zoeken in grote kennisbases en relevante documenten ophalen kost tijd, wat de gebruikerservaring in realtime toepassingen kan schaden.
Afhankelijkheid van retrievalkwaliteit: Je antwoorden zijn maar zo goed als je retrievalmechanisme. Slechte retrieval betekent dat irrelevante context naar het taalmodel gaat, wat de kwaliteit kan verslechteren.
Er zijn echter verschillende belangrijke technieken om de RAG-prestaties te verbeteren en deze problemen effectief aan te pakken.
Na de retrievalgerichte aanpak te hebben verkend, stap ik nu over op cache-augmented generation, dat een heel andere route neemt om modelprestaties te verbeteren.
Wat is Cache-Augmented Generation (CAG)?
CAG is de nieuwkomer, en eerlijk: het duurde even voordat ik de elegantie ervan echt waardeerde. In plaats van constant informatie op te halen zoals RAG, laadt CAG vooraf wat je nodig hebt en houdt het paraat.
In tegenstelling tot RAG’s dynamische retrievalbenadering richt CAG zich op het vooraf laden en onderhouden van relevante informatie in de uitgebreide context of cachegeheugen van het model. De volgende graphic vergelijkt beide benaderingen:
RAG- en CAG-architecturen vergeleken
CAG won aan belang met de komst van taalmodellen met steeds grotere contextvensters, soms oplopend tot miljoenen tokens. Het is het verschil tussen elk antwoord opzoeken in een naslagwerk of een spiekbriefje hebben dat je al hebt voorbereid.
Hoe werkt CAG?
CAG steunt op twee complementaire cachingmechanismen.
Ten eerste vindt kenniscaching plaats wanneer relevante documenten of referentiemateriaal vooraf in het uitgebreide contextvenster van het model worden geladen. Eenmaal opgeslagen kan het model deze informatie hergebruiken over meerdere queries, zonder deze extern op te halen zoals RAG-systemen doen.
Ten tweede richt key-value (KV) caching zich op efficiëntie door de attention states (key- en valuematrices) op te slaan die ontstaan wanneer het model tokens verwerkt. Bij een vergelijkbare of herhaalde query kan het model deze cached states hergebruiken in plaats van ze opnieuw te berekenen.
Key-Value Caching
Dit mechanisme verlaagt de latency en stelt het model in staat om langere-termijncontext in gesprekken te behouden. De workflow vergroot het effectieve geheugen van het systeem, zodat het langere dialooggeschiedenissen of herhalende queries aankan zonder telkens opnieuw te beginnen.
De kern is dat caching de praktische grenzen van wat een model kan onthouden, oprekt. Door informatie te bewaren en snel te raadplegen, creëert CAG een gevoel van continuïteit over langere gesprekken.
Met deze workflow in gedachten zie je waarom CAG steeds aantrekkelijker wordt voor bepaalde toepassingen, zeker wanneer snelheid en efficiëntie topprioriteit zijn
Sterke punten van CAG
De belangrijkste kracht van CAG zit in de efficiëntie. Omdat het model cached berekeningen hergebruikt, verbeteren de responstijden aanzienlijk en daalt de latency, vooral wanneer queries zich herhalen of de kennis stabiel blijft. Hier blinkt CAG echt uit:
Snelheid en efficiëntie: Het hergebruiken van cached berekeningen verbetert de responstijden drastisch, vooral bij repetitieve queries of stabiele kennisbehoeften.
Consistentie over sessies heen: Door eerdere context op te slaan voorkomt CAG afglijdende antwoorden en waarborgt het coherentie. Ideaal voor conversatie-agents, workflow-automatisering of klantenservicechatbots met veel herhaalde vragen.
Lagere systeemcomplexiteit: Omdat het model minder vaak externe lookups hoeft te doen, is het totale systeem eenvoudiger dan bij RAG.
Beperkingen van CAG
Ondanks deze voordelen is geen enkele techniek zonder trade-offs, en CAG introduceert zijn eigen set uitdagingen waar organisaties goed over moeten nadenken.
Verouderde informatie: Cached data veroudert na verloop van tijd, waardoor systemen recente updates of dynamische wijzigingen mogelijk niet weerspiegelen.
Zware geheugeneisen: Het onderhouden van grote caches vereist aanzienlijke rekenresources. Organisaties moeten de cachegrootte zorgvuldig balanceren met beschikbaar geheugen en rekenkracht.
Complex cachebeheer: Zorgen dat gecachte informatie accuraat en gesynchroniseerd blijft in gedistribueerde omgevingen vereist geavanceerde coördinatiemechanismen—en die complexiteit groeit naarmate het systeem schaalt.
Nu we zowel RAG als CAG afzonderlijk hebben bekeken, is de volgende stap ze direct te vergelijken en de cruciale verschillen te benadrukken die hun toepassing in de praktijk bepalen.
RAG vs CAG: belangrijkste verschillen
Welke moet je nu echt gebruiken? Die vraag krijg ik voortdurend, en mijn eerlijke antwoord is: het hangt af van wat je bouwt. Na met beide benaderingen te hebben gewerkt in verschillende projecten, zie ik duidelijke patronen. Dit is wat ik heb geleerd van echte implementaties.
Kenmerk
RAG (Retrieval-Augmented Generation)
CAG (Cache-Augmented Generation)
Kernmechanisme
Just-in-time: Haalt relevante data op uit een externe database tijdens de query.
Vooraf geladen: Laadt relevante data in de context of cache van het model vóór de query.
Latency & snelheid
Langzamer: Kost tijd om documenten te zoeken, op te halen en te verwerken vóór het antwoord.
Allersnelst: Benadert informatie direct uit het geheugen, zonder retrieval-overhead.
Actualiteit van kennis
Realtime: Kan data raadplegen die seconden geleden is bijgewerkt (bijv. breaking news, nieuwe wetten).
Momentopname: Kennis is zo actueel als de laatste cache-update; risico op "veroudering".
Beste use-case
Dynamische, enorme datasets (bijv. jurisprudentie, medisch onderzoek, nieuws).
Stabiele, repetitieve datasets (bijv. complianceregels, FAQ’s, standaardprocedures).
Schaalbaarheid
Horizontaal: Schaalt goed met enorme databases; beperkt door zoektijd.
Geheugen-gebonden: Beperkt door de contextvenstergrootte van het model en beschikbare RAM.
Complexiteit
Hoog: Vereist beheer van vectordatabanken, embeddingpipelines en retrievallogica.
Gemiddeld: Vereist beheer van cachelevenscyclus, contextoptimalisatie en geheugenefficiëntie.
Omgaan met hallucinaties
Verankert antwoorden in opgehaalde documenten (citaten).
Verankert antwoorden in consistente, vooraf geladen context.
Vergelijking van architectuur en workflow
RAG en CAG kiezen fundamenteel verschillende routes naar kennis. RAG volgt een just-in-time model: het encodeert de query van de gebruiker, doorzoekt een vectordatabank, haalt relevante documenten op en geeft die door aan de generatiefase. Dit zorgt voor toegang tot de meest recente informatie, maar de extra retrievalstap introduceert latency.
Architectonisch leunen RAG-systemen op meertraps-pipelines die documentchunking, vectorzoektocht en retrievalcoördinatie combineren. Documentchunking moet semantische betekenis behouden en tegelijk efficiënt zijn voor retrieval, en vectorzoektocht gebruikt vaak approximate nearest neighbor-algoritmen om grote collecties te verwerken zonder hoge kosten.
CAG werkt daarentegen via vooraf laden. In plaats van naar buiten te reiken voor nieuwe kennis, vertrouwt het op uitgebreide contextvensters en cachegeheugen om eerder opgeslagen informatie te hergebruiken. Deze ruimtelijke aanpak vermindert de latency omdat het model uit geheugen haalt in plaats van uit een externe database.
Vergelijking van RAG- en CAG-workflows
De keerzijde is echter actualiteit: gecachte informatie kan achterlopen op echte updates. Daarom richten CAG-systemen zich op slim cachebeheer, met strategieën voor cachevervanging, geheugentoewijzing en optimalisatie van het contextvenster.
Ik heb productiesystemen gezien waar deze trade-off de implementatie maakte of brak; de effectiviteit van deze strategieën bepaalt direct zowel de prestaties als de schaalbaarheid van het systeem.
Los van de technische architectuur is er ook een praktische dimensie: hoe elk systeem met verandering omgaat.
Flexibiliteit vs. rigiditeit
Dit is wat ik heb gezien rond aanpasbaarheid:
Flexibiliteit van RAG: Het dynamische retrievalmechanisme laat systemen nieuwe informatie meteen na indexering benaderen. Ik heb systemen hun kennisbasis realtime zien updaten—perfect voor snel evoluerende domeinen.
Rigiditeit van CAG: Vooraf gecachte informatie betekent meer consistentie maar minder flexibiliteit. Dat levert snelheid en voorspelbaar gedrag op, maar het worstelt met onverwachte queries die niet in de cachevoorbereiding zaten.
Naar mijn ervaring telt dit verschil het meest wanneer je domein onvoorspelbaar is of constant verandert.
Omgaan met hallucinaties
Laten we het nu hebben over nauwkeurigheid en hoe elke aanpak omgaat met de neiging van AI om dingen te verzinnen.
Beide technieken pakken hallucinaties anders aan, gebaseerd op hun architectuur. RAG-systemen beperken hallucinaties door antwoorden te verankeren in opgehaalde feitelijke informatie, wat externe validatie biedt voor de gegenereerde content.
CAG-systemen verminderen hallucinaties via consistente toegang tot geverifieerde, gecachte informatie. Maar als de cache onjuistheden bevat of verouderd raakt, kunnen die fouten zich over meerdere interacties voortzetten.
Prestaties en schaalbaarheid
Het wordt pas echt spannend bij productie op schaal. Dit zijn enkele prestatietrade-offs die ik ben tegengekomen:
RAG-systemen: Hogere latency door retrieval-overhead, maar horizontaal schaalbaar door extra retrievalcapaciteit toe te voegen en vectordatabanken te distribueren. In de praktijk werkt dit goed als je in de infrastructuur investeert.
CAG-systemen: Betere responstijden, maar schaalbaarheid wordt beperkt door geheugen. De bottleneck ontstaat vaak wanneer de overhead van cachebeheer sneller groeit dan je geheugenbudget toelaat.
De schaalbaarheidsvraag is zelden eenvoudig. Het hangt sterk af van je querypatronen en beschikbare resources.
Wanneer gebruik je RAG vs CAG?
Genoeg theorie. Laten we praktisch worden. Na implementaties met beide benaderingen hanteer ik deze leidraad om te beslissen welke je gebruikt.
Besliskader
Zo begeleid ik teams meestal. Beoordeel de volatiliteit van je informatie, latency-eisen, behoefte aan consistentie en beschikbare resources bij de keuze tussen RAG en CAG. Hoge informatievolatiliteit pleit voor RAG, terwijl stabiele kennisdomeinen profiteren van de efficiëntie van CAG.
Besliskader: RAG vs. CAG
Latency-gevoelige toepassingen presteren meestal beter met CAG-systemen, terwijl applicaties die de meest actuele informatie vereisen juist RAG gebruiken. De keuze draait vaak om het balanceren van deze concurrerende eisen op basis van zakelijke prioriteiten.
Gebruik RAG wanneer...
Kies RAG wanneer je nodig hebt:
Dynamische, vaak geüpdatete informatie: Onderzoekstoepassingen, klantenondersteuning voor evoluerende producten of nieuwsanalyses waar actueel zijn belangrijker is dan snelheid.
Grote, diverse kennisbases: Platforms voor juridisch onderzoek, medische informatiesystemen en concurrentie-intelligentie. Als je data dagelijks of wekelijks verandert, is RAG doorgaans de juiste keuze.
Bescherming tegen verouderde informatie: Wanneer de kosten van verouderde data hoger zijn dan de kosten van extra latency.
Ik zeg klanten meestal: als je bang bent dat je AI verouderde antwoorden geeft, begin dan met RAG. Snelheid kun je later altijd optimaliseren. Als je voor RAG gaat, vergeet dan niet om het juiste framework te kiezen.
Gebruik CAG wanneer...
Kies CAG wanneer je hebt:
Stabiele kennisbehoeften: Klantenservicechatbots voor routinematige vragen, educatieve platforms met vaste curricula of workflow-automatisering waarbij de kernkennis weinig verandert.
Hoge queryvolumes met repetitieve patronen: Als je dezelfde 100 vragen duizenden keren per dag beantwoordt, stapelt CAG’s snelheidsvoordeel snel op.
Latency-kritische applicaties: Realtime aanbevelingssystemen, interactieve game-ervaringen of overal waar milliseconden tellen voor de gebruikerservaring.
Mijn ervaring: CAG is ideaal wanneer je 90% van je queries kunt voorspellen en je kennisbasis relatief stabiel is.
Toepassingen en use-cases van RAG en CAG in de praktijk
Zo werkt het in de praktijk. Ik heb implementaties gezien (en bestudeerd) in verschillende sectoren en er tekenen zich duidelijke patronen af. Dit werkt daadwerkelijk in productie.
Zorg
We beginnen met de zorg, waar de inzet voor accurate en tijdige informatie bijzonder hoog is.
In zorgtoepassingen ondersteunen RAG-systemen klinische besluitvorming door het nieuwste medisch onderzoek, behandelprotocollen en informatie over geneesmiddelinteracties op te halen. Zorgprofessionals profiteren van toegang tot actuele richtlijnen en recente bevindingen die mogelijk niet in de trainingsdata van het model zitten.
CAG is waardevol in zorgscenario’s waar snelle toegang tot vaste protocollen, samenvattingen van patiëntgeschiedenis en gestandaardiseerde diagnoseprocedures cruciaal is voor consistentie en snelheid.
Naar mijn mening zie je in de zorg de duidelijkste casus voor hybride aanpakken: CAG voor standaardprotocollen, RAG voor alles wat verandert.
Financiën
Financiën is een ander interessant geval, met totaal andere eisen dan in de zorg.
Financiële instellingen gebruiken RAG voor marktanalyse, monitoring van regelgeving en beleggingsonderzoek, waar toegang tot realtime marktdata en recente regelwijzigingen cruciaal is. Deze systemen kunnen integreren met financiële databases en nieuwsfeeds om actuele marktinzichten te bieden.
CAG blinkt juist uit in financiële toepassingen die snelle antwoorden op routinematige vragen vereisen, zoals standaard financiële berekeningen, productdefinities en vaste complianceprocedures.
Wat mij in de financiële sector opvalt, is dat de keuze vaak neerkomt op regelgevingsrisico. Als fouten miljoenen aan boetes kunnen kosten, kiezen teams eerder voor RAG.
Onderwijs
Ook het onderwijs is vruchtbare grond voor zowel RAG als CAG.
Gepersonaliseerde leerplatforms profiteren vaak van RAG, omdat studenten diverse en constant geüpdatete content nodig hebben, waaronder nieuwe onderzoeksartikelen, cursusmateriaal of zelfs actualiteiten als lesvoorbeelden. Met RAG kan een AI-tutor nauwkeurige referenties of aanvullende literatuur bieden die niet in de oorspronkelijke trainingsset zat.
CAG presteert daarentegen goed in situaties waar herhaling en consistentie key zijn. Bijvoorbeeld bij regelmatige quizzen, uitleg van standaardconcepten of gestructureerde oefensessies zorgt caching voor snellere en consistentere feedback.
Zo combineren onderwijssystemen vaak beide technieken: frisse inzichten met betrouwbare herhaling van kernkennis.
Software-engineering
In de softwarewereld omarmen ontwikkelaars beide methoden steeds vaker om de productiviteit te verhogen.
RAG ondersteunt ontwikkelaars door documentatie, API-specificaties of stappen voor probleemoplossing uit externe bronnen op te halen. Omdat softwarebibliotheken of -frameworks snel veranderen, blinkt de retrievallaag van RAG uit in actualiteit.
CAG speelt intussen een rol bij taken met veel herhaling, zoals code-autocompletion, debug-assistentie of antwoorden op terugkerende ontwikkelaarsvragen. Door eerder geziene patronen te cachen, verlaagt CAG de latency en versnelt het de ontwikkelworkflow.
Samen stellen deze benaderingen engineers in staat sneller te werken met accurate, contextbewuste ondersteuning.
Juridisch en compliance
De juridische sector is een ander interessant voorbeeld van hoe deze benaderingen domeinspecifieke uitdagingen aanpakken met verschillende toegangspatronen tot informatie.
Juridische professionals gebruiken RAG voor jurisprudentieonderzoek en contractreview, waar toegang tot de meest recente contractdocumenten en juridische precedenten essentieel is. Zo kunnen ze zeker weten dat hun adviezen de nieuwste rechtspraak en regelgeving reflecteren zodra die verschijnt.
CAG is daarentegen superieur voor interne compliancebewaking en geautomatiseerde handhaving van beleid, vooral wanneer de regels vastliggen en de queries repetitief zijn. In plaats van duizenden keren per dag dezelfde "Anti-corruptierichtlijnen" of "AVG artikel 15" op te halen, laadt een CAG-systeem deze statische kaders vooraf in de context van het model.
Omdat de kern van de "waarheid" (de wet) niet dagelijks verandert, elimineert het cachen van deze kennis de retrievalbottleneck voor 90% van de standaard compliancechecks.
Retail
In retail en e-commerce bepalen snelheid en relevantie direct de klantervaring.
RAG wordt vaak ingezet voor geavanceerd productzoeken, integratie van live voorraaddata en dynamische aanbevelingen. Vraagt een klant of een product op voorraad is, dan kan een RAG-systeem realtime databases raadplegen voor een actueel antwoord.
CAG zorgt daarentegen voor snelle antwoorden op veelgestelde vragen, zoals verzendbeleid, retourregels of orderstatus. Door gecachte interacties te hergebruiken, levert het systeem directe antwoorden en verlaagt het de serverbelasting.
Samen bieden RAG en CAG een naadloze ervaring die zowel accuraat als efficiënt is.
Hybride aanpakken en systeemintegratie
Tot nu toe hebben we RAG en CAG als afzonderlijke technieken behandeld. In de praktijk adopteren veel organisaties echter hybride aanpakken die beide methoden integreren. Zo kunnen ze de actualiteit en flexibiliteit van RAG balanceren met de snelheid en efficiëntie van CAG.
Hybride aanpakken: voor- en nadelen
Voordelen van hybride modellen
Hybride systemen zijn de volgende stap in kennisintegratie: ze combineren de dynamische retrieval van RAG met de efficiëntievoordelen van CAG.
In deze modellen gebruik je CAG meestal voor vaak geraadpleegde, stabiele informatie, terwijl RAG wordt ingezet voor queries die realtime data of gespecialiseerde kennis vereisen. Dit resulteert in “het beste van twee werelden”: geoptimaliseerde responstijden voor veelvoorkomende vragen, behouden nauwkeurigheid voor dynamische content en een lagere systeembelasting via slimme routering.
Uitdagingen van hybride modellen
Hybride aanpakken brengen echter meer architecturale complexiteit mee. Ze vereisen geavanceerde orkestratie tussen caching- en retrievalsystemen en vragen om zorgvuldige balans in resourceallocatie.
De integratieoverhead omvat het beheren van dubbele kennispaden, het synchroniseren van gecachte en opgehaalde data en het implementeren van intelligente routeringslogica die per query bepaalt welke methode wordt gebruikt.
Als je voor een hybride oplossing gaat, moet je echt weten wat je doet.
Voorbeelden van hybride use-cases
De meest wijdverspreide adoptie van hybride architecturen zie ik momenteel in klantservicesystemen. Vaak zie ik platforms waar CAG de statische FAQ’s met hoog volume direct afhandelt, terwijl RAG selectief wordt ingezet voor live accountgegevens of transactiehistorie.
Een ander klassiek voorbeeld is te vinden in onderzoekstoepassingen, waar CAG gecachte basiskennis bewaart terwijl RAG de nieuwste publicaties of dynamische data ophaalt voor nieuwe vragen. Evenzo handelt CAG in e-commerceplatforms gecachte productbeschrijvingen of beleidsregels af, terwijl RAG realtime voorraadniveaus en prijsupdates integreert.
Conclusie
Er is geen universeel juist antwoord, en wie dat beweert, verkoopt je waarschijnlijk iets. De keuze tussen RAG en CAG, of de beslissing om ze te combineren, hangt uiteindelijk af van jouw specifieke eisen, beperkingen en doelen.
RAG blinkt uit wanneer je toegang tot dynamische, actuele informatie nodig hebt en enige latency accepteert in ruil voor nauwkeurigheid en actualiteit. CAG schittert in scenario’s waar snelheid en consistentie het belangrijkst zijn en je kennisbehoeften relatief stabiel blijven.
In de toekomst zullen we waarschijnlijk meer geavanceerde hybride aanpakken zien die queries intelligent routeren tussen gecachte en opgehaalde informatie, geoptimaliseerd voor zowel performance als nauwkeurigheid.
Wil je de volledige skillset beheersen om RAG-, CAG- of hybride systemen te ontwerpen en te deployen, overweeg dan onze uitgebreide AI Engineer-carrièreroute.