Con l’evoluzione dell’intelligenza artificiale, una delle sfide centrali è capire come integrare efficacemente la conoscenza nei Large Language Models (LLM), considerata la loro conoscenza limitata. Per superare questi limiti, ricercatori e professionisti hanno esplorato diversi approcci all’integrazione della conoscenza.
Due degli approcci più importanti oggi sono la retrieval-augmented generation, o RAG, e la cache-augmented generation, o CAG. Ho lavorato con entrambi e, anche se spesso vengono presentati come concorrenti, li considero strumenti diversi per lavori diversi—a volte persino migliori se usati insieme.
In questo articolo ti guiderò in un confronto tra RAG e CAG, esplorando cosa significano, come funzionano e dove si collocano al meglio nelle applicazioni reali. Alla fine, vedrai come questi approcci differiscono, dove si sovrappongono e come scegliere tra loro, o persino combinarli, quando progetti sistemi di AI.
Se vuoi andare oltre i concetti e iniziare a costruire tu stesso questi sistemi, ti consiglio il nostro corso pratico Retrieval Augmented Generation (RAG) with LangChain.
Che cos’è la Retrieval-Augmented Generation (RAG)?
La retrieval-augmented generation è una tecnica che permette ai modelli di AI di andare oltre i loro dati di training fissi e incorporare informazioni esterne in modo dinamico. Invece di fare affidamento esclusivamente su quanto è stato codificato nel modello durante l’addestramento,
RAG collega il modello a database esterni e meccanismi di recupero, consentendogli di reperire documenti o conoscenze pertinenti al momento della query.
Questa idea è cresciuta in popolarità quando le organizzazioni si sono rese conto che i dati di training statici diventano rapidamente obsoleti. Ho visto come, in molti settori, le informazioni cambiano ogni giorno e un modello senza un livello di retrieval esterno non riesce a stare al passo.
RAG è stata sviluppata per colmare questo divario e portare conoscenza aggiornata, specifica del dominio o dinamica direttamente nel processo di generazione.
Come funziona RAG?
Il flusso di lavoro di RAG inizia con una query dell’utente. La query viene prima codificata in una rappresentazione vettoriale, poi utilizzata per cercare in un database vettoriale (sistema di retrieval) contenente documenti, record o altre fonti di conoscenza. Questa fase di retrieval garantisce che il modello identifichi le informazioni esterne più pertinenti prima di procedere.
In questa fase sono fondamentali strategie di chunking efficienti: i documenti vengono suddivisi in unità di significato più piccole, in genere da 100 a 1.000 token, in modo che il sistema di retrieval possa far emergere il contesto più rilevante senza sovraccaricare il modello di generazione.
Algoritmi di retrieval, spesso basati sulla ricerca del vicino approssimato, garantiscono che i chunk rilevanti vengano recuperati rapidamente anche da knowledge base di grandi dimensioni.
Una volta recuperati i documenti pertinenti, questi vengono passati alla fase di generazione, dove il modello linguistico integra tali informazioni nella sua risposta. Il processo consente al sistema di produrre risposte non solo più coerenti, ma anche ancorate a conoscenze esterne e aggiornate.
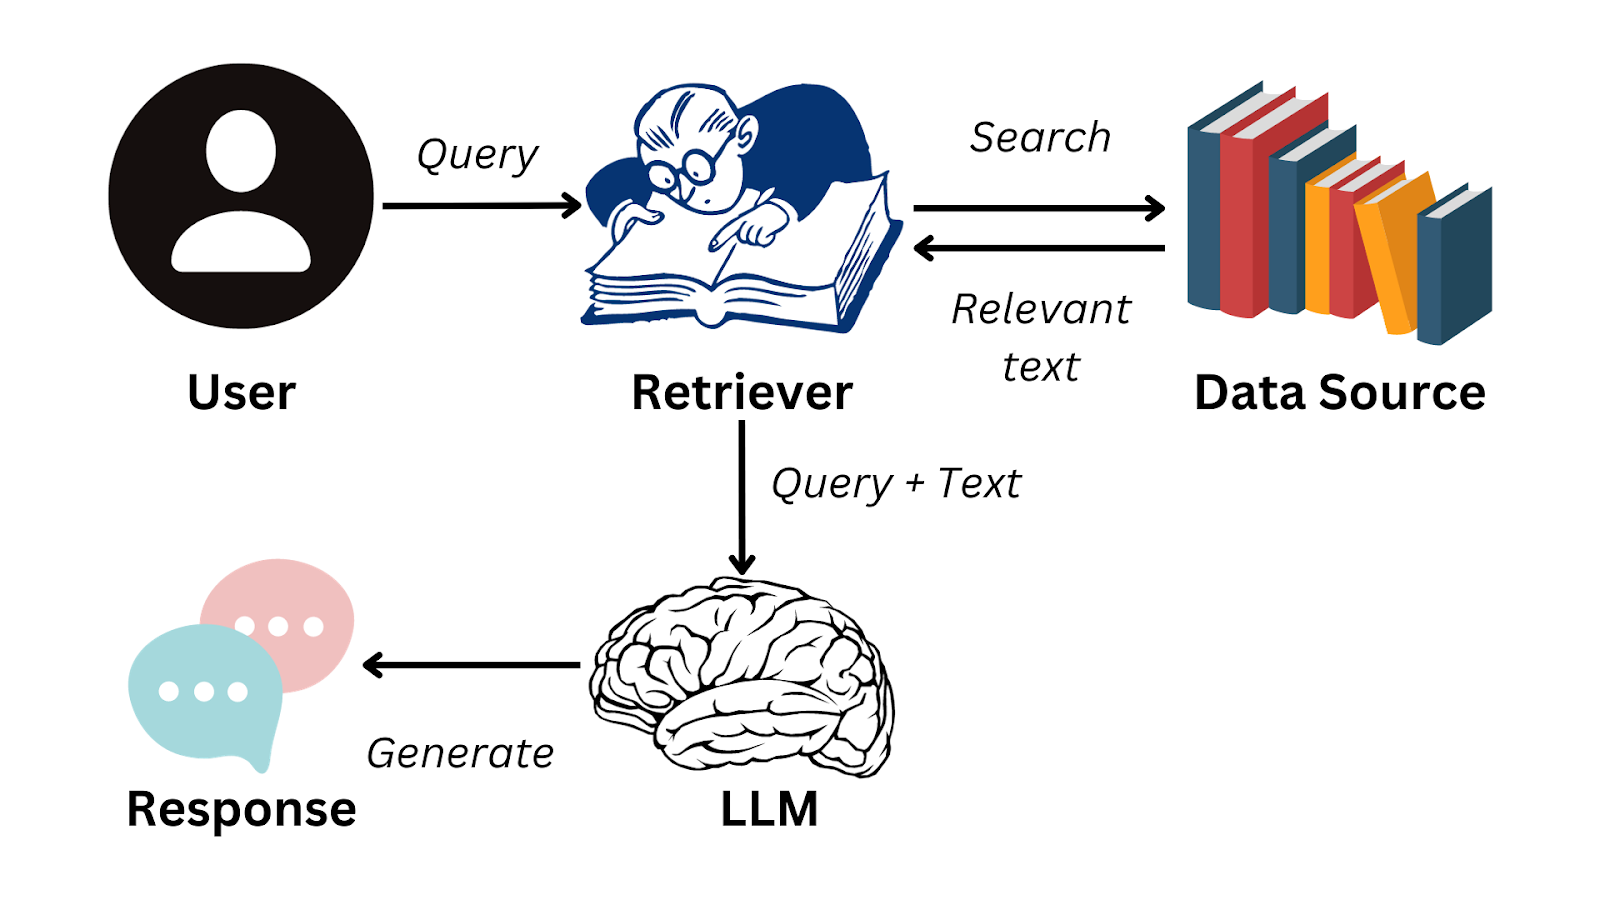
Flusso di lavoro RAG
Le fonti di conoscenza esterne possono includere database proprietari, articoli scientifici, archivi legali o persino API in tempo reale. Il motore di retrieval è il ponte che permette al modello linguistico di combinare la sua capacità generativa con dati fattuali. È come dare alla tua AI una tessera della biblioteca, invece di sperare che abbia memorizzato ogni libro.
Questa struttura di base può essere perfezionata applicando tecniche RAG avanzate o utilizzando il Corrective RAG (CRAG), una versione migliorata di RAG ottimizzata per l’accuratezza.
Ora che abbiamo visto come è strutturata e come opera RAG, diventa più semplice valutare cosa rende questo metodo particolarmente potente in scenari reali.
Punti di forza di RAG
Quello che amo di più di RAG è come gestisce il cambiamento. Il tuo reparto legale aggiorna una policy alle 15:00? Il tuo sistema RAG la conosce alle 15:01—senza bisogno di riaddestramento.
Per esperienza, RAG eccelle in tre aree principali:
-
Aggiornamenti in tempo reale: Il livello di retrieval si collega a conoscenza esterna, fornendo risposte basate sui dati più recenti. Questo rende RAG particolarmente preziosa in campi in rapida evoluzione come medicina, finanza o tecnologia.
-
Meno allucinazioni: Gli LLM spesso generano testo plausibile ma fattualmente errato. Ancorando le risposte a documenti recuperati, RAG fornisce un appiglio fattuale, aumentando l’affidabilità.
-
Integrazione dati flessibile: La conoscenza esterna può provenire da più fonti, come database strutturati, API semi-strutturate o archivi di testo non strutturati. Le organizzazioni possono adattare le pipeline di retrieval alle proprie esigenze.
Sebbene RAG offra vantaggi interessanti, è altrettanto importante comprendere le sfide e i vincoli che questo approccio comporta.
Limiti di RAG
Qui le cose si complicano, ed è ciò di cui avverto subito i miei clienti. RAG comporta compromessi reali:
-
Complessità del sistema: Devi orchestrare sistema di retrieval, database vettoriale e modello di generazione. Questa complessità crea ulteriori punti di failure e aumenta i costi di manutenzione.
-
Problemi di latenza: Il processo di retrieval aggiunge overhead computazionale a ogni query. Cercare in knowledge base di grandi dimensioni e recuperare documenti pertinenti richiede tempo, con impatto negativo sull’esperienza utente nelle applicazioni real-time.
-
Dipendenza dalla qualità del retrieval: Le risposte sono valide quanto il meccanismo di retrieval. Un retrieval scarso alimenta al modello contesto irrilevante, potenzialmente degradando la qualità della risposta.
Esistono comunque diverse tecniche chiave per migliorare le prestazioni di RAG e affrontare efficacemente questi problemi.
Dopo aver esplorato l’approccio incentrato sul retrieval, passiamo ora alla cache-augmented generation, che segue una strada molto diversa per migliorare le prestazioni del modello.
Che cos’è la Cache-Augmented Generation (CAG)?
CAG è l’ultima arrivata e, onestamente, mi ci è voluto un po’ per apprezzarne l’eleganza. Invece di andare a prendere continuamente informazioni come fa RAG, CAG pre-carica ciò che ti serve e lo tiene pronto.
A differenza dell’approccio dinamico di RAG, CAG punta a pre-caricare e mantenere informazioni rilevanti nel contesto esteso del modello o nella memoria cache. Il grafico seguente confronta i due approcci:
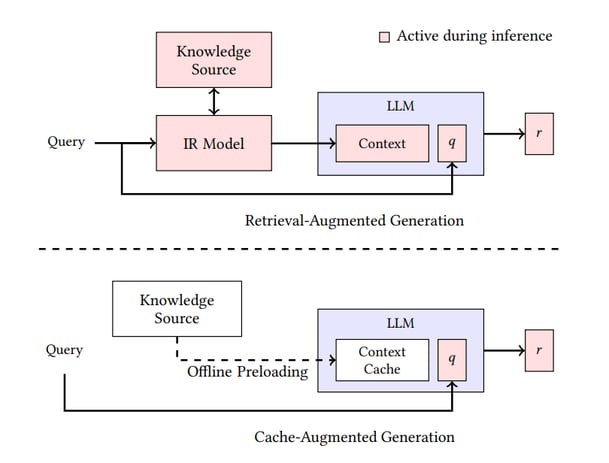
Confronto tra architetture RAG e CAG
CAG ha guadagnato rilevanza con lo sviluppo di modelli linguistici che supportano finestre di contesto sempre più ampie, talvolta fino a milioni di token. È la differenza tra cercare ogni risposta su un libro di riferimento e avere già pronta una cheat sheet.
Come funziona CAG?
CAG si basa su due meccanismi di caching complementari.
Per prima cosa, la knowledge caching si verifica quando documenti o materiali di riferimento rilevanti vengono pre-caricati nella finestra di contesto estesa del modello. Una volta archiviati, il modello può riutilizzare queste informazioni su più query senza doverle recuperare esternamente, come fanno i sistemi RAG.
In secondo luogo, la key-value (KV) caching punta all’efficienza memorizzando gli stati di attenzione (matrici key e value) generati mentre il modello elabora i token. Quando arriva una query simile o ripetuta, il modello può riutilizzare questi stati in cache invece di ricalcolarli da zero.
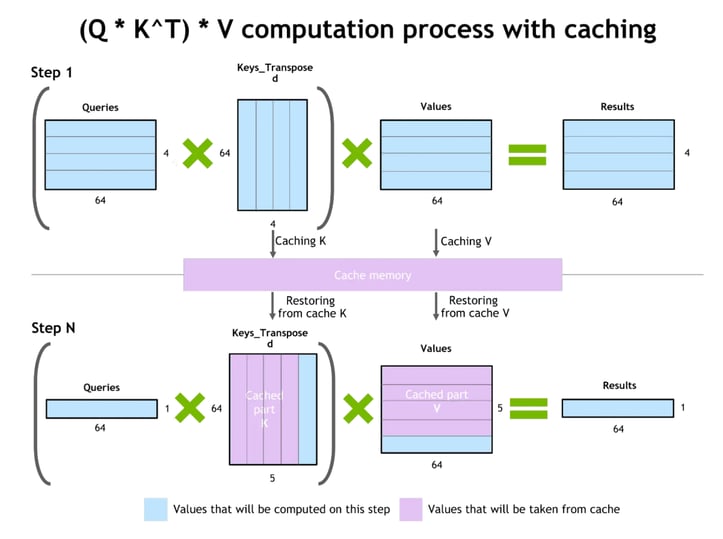
Key-Value Caching
Questo meccanismo riduce la latenza e consente al modello di mantenere un contesto di più lungo termine nelle conversazioni. Il flusso di lavoro amplia la memoria effettiva del sistema, permettendogli di gestire storie dialogiche più estese o query ripetitive senza dover ripartire ogni volta da zero.
L’idea alla base è che il caching estende i limiti pratici di ciò che un modello può ricordare. Persistendo le informazioni e richiamandole rapidamente, CAG crea un’esperienza di continuità nelle conversazioni più lunghe.
Con questo flusso di lavoro in mente, è facile capire perché CAG stia diventando sempre più attraente per certe applicazioni, soprattutto quando velocità ed efficienza sono priorità assolute
Punti di forza di CAG
Il principale punto di forza di CAG è l’efficienza. Poiché il modello riutilizza calcoli in cache, i tempi di risposta migliorano sensibilmente, riducendo la latenza, in particolare in scenari con query ripetitive o requisiti di conoscenza stabili. Ecco dove CAG brilla davvero:
-
Velocità ed efficienza: Il riutilizzo dei calcoli in cache migliora drasticamente i tempi di risposta, soprattutto per query ripetitive o con conoscenza stabile.
-
Coerenza tra sessioni: Memorizzando il contesto precedente, CAG evita derive nelle risposte e garantisce coerenza. È ideale per agenti conversazionali, automazione di workflow o chatbot di supporto dove le query ricorrenti sono comuni.
-
Minore complessità di sistema: Poiché il modello non deve effettuare lookup esterni così spesso, il sistema complessivo è più semplice rispetto a RAG.
Limiti di CAG
Nonostante questi vantaggi, nessuna tecnica è priva di compromessi, e CAG introduce un proprio set di sfide che le organizzazioni devono considerare con attenzione.
-
Informazioni obsolete: I dati in cache diventano obsoleti col tempo, quindi questi sistemi potrebbero non riflettere aggiornamenti recenti o cambiamenti dinamici nelle knowledge base.
-
Forti requisiti di memoria: Mantenere cache di grandi dimensioni richiede notevoli risorse computazionali. Le organizzazioni devono bilanciare attentamente la dimensione della cache con memoria disponibile e capacità di elaborazione.
-
Gestione della cache complessa: Garantire che le informazioni in cache restino accurate e sincronizzate in distribuzioni distribuite richiede meccanismi di coordinamento sofisticati—e questa complessità cresce con la scala del sistema.
Dopo aver esaminato RAG e CAG singolarmente, il passo successivo è confrontarle direttamente e mettere in evidenza le differenze critiche che ne influenzano l’adozione nella pratica.
RAG vs CAG: differenze chiave
Quindi, quale dovresti usare davvero? Mi fanno questa domanda continuamente e la mia risposta onesta è: dipende da cosa stai costruendo. Dopo aver lavorato con entrambi gli approcci in progetti diversi, ho notato alcuni schemi ricorrenti. Ecco, in sintesi, cosa ho imparato da implementazioni reali.
|
Caratteristica
|
RAG (Retrieval-Augmented Generation)
|
CAG (Cache-Augmented Generation)
|
|
Meccanismo di base
|
Just-in-Time: recupera i dati pertinenti da un database esterno durante la query.
|
Pre-caricato: carica i dati rilevanti nel contesto o nella cache del modello prima della query.
|
|
Latenza e velocità
|
Più lenta: richiede tempo per cercare, recuperare ed elaborare i documenti prima di generare una risposta.
|
Più veloce: accede istantaneamente alle informazioni dalla memoria, eliminando l’overhead del retrieval.
|
|
Freschezza della conoscenza
|
In tempo reale: può accedere a dati aggiornati pochi secondi prima (ad es. ultime notizie, nuove leggi).
|
Istantanea: la conoscenza è aggiornata solo all’ultimo refresh della cache; rischio di diventare "obsoleta".
|
|
Miglior caso d’uso
|
Dataset dinamici e massivi (ad es. giurisprudenza, ricerca medica, notizie).
|
Dataset stabili e ripetitivi (ad es. regole di compliance, FAQ, procedure operative standard).
|
|
Scalabilità
|
Orizzontale: scala bene con database vasti; limitata solo dalla velocità di ricerca.
|
Vincolata dalla memoria: limitata dalla dimensione della finestra di contesto del modello e dalla RAM disponibile.
|
|
Complessità
|
Alta: richiede la gestione di database vettoriali, pipeline di embedding e logica di retrieval.
|
Moderata: richiede la gestione del ciclo di vita della cache, l’ottimizzazione del contesto e l’efficienza della memoria.
|
|
Gestione delle allucinazioni
|
Ancoraggio delle risposte a documenti recuperati (citazioni).
|
Ancoraggio delle risposte a un contesto coerente, pre-caricato.
|
Confronto di architettura e flusso di lavoro
RAG e CAG adottano approcci fondamentalmente diversi all’accesso alla conoscenza. RAG segue un modello just-in-time: codifica la query dell’utente, cerca in un database vettoriale, recupera i documenti pertinenti e poi li passa alla fase di generazione. Questo design assicura l’accesso alle informazioni più recenti, ma il passaggio aggiuntivo di retrieval introduce latenza.
Dal punto di vista architetturale, i sistemi RAG si basano su pipeline multistadio che combinano chunking dei documenti, ricerca vettoriale e coordinamento del retrieval. Il chunking deve preservare il significato semantico restando efficiente per il retrieval, e la ricerca vettoriale spesso dipende da algoritmi di nearest neighbor approssimati per gestire raccolte su larga scala senza costi elevati.
CAG, al contrario, opera tramite pre-caricamento. Invece di cercare all’esterno nuova conoscenza, fa affidamento su finestre di contesto estese e memoria cache per riutilizzare informazioni archiviate in precedenza. Questo approccio spaziale riduce la latenza perché il modello recupera dalla memoria anziché da un database esterno.
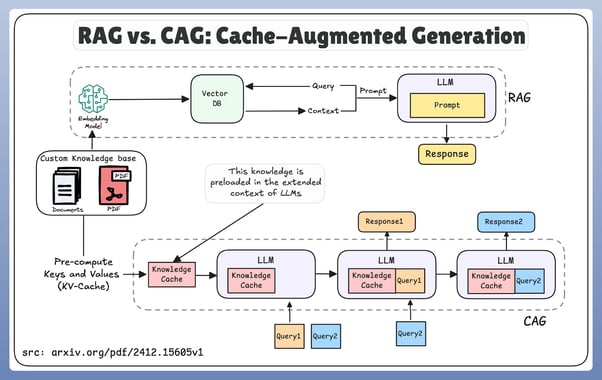
Confronto del flusso di lavoro tra RAG e CAG
Il compromesso, però, è la freschezza: le informazioni in cache possono rimanere indietro rispetto agli aggiornamenti del mondo reale. Per questo, i sistemi CAG si concentrano su una gestione intelligente della cache, usando strategie di sostituzione, allocazione della memoria e ottimizzazione della finestra di contesto.
Ho visto sistemi in produzione in cui questo compromesso determinava il successo o il fallimento dell’implementazione, e l’efficacia di queste strategie incide direttamente su prestazioni e scalabilità del sistema.
Oltre all’architettura tecnica, c’è una dimensione pratica da discutere: come ciascun sistema gestisce il cambiamento.
Flessibilità vs rigidità
Ecco cosa ho osservato sull’adattabilità:
-
Flessibilità di RAG: il meccanismo di retrieval dinamico consente a questi sistemi di accedere a nuove informazioni subito dopo l’indicizzazione. Ho visto sistemi aggiornare la propria knowledge base in tempo reale, perfetti per domini in rapida evoluzione.
-
Rigidità di CAG: le informazioni pre-cachate significano più coerenza ma meno adattabilità. Pur offrendo velocità e comportamento prevedibile, fatica con query impreviste non considerate durante la preparazione della cache.
Per quello che ho visto, questa differenza conta soprattutto quando il tuo dominio è imprevedibile o in costante evoluzione.
Gestione delle allucinazioni
Parliamo ora di accuratezza e di come ciascun approccio affronta la tendenza dell’AI a inventare.
Le due tecniche affrontano le allucinazioni in modo diverso, in base alle rispettive architetture. I sistemi RAG mitigano le allucinazioni ancorando le risposte a informazioni fattuali recuperate, fornendo una validazione esterna ai contenuti generati.
I sistemi CAG riducono le allucinazioni grazie all’accesso coerente a informazioni verificate e in cache. Tuttavia, se le informazioni in cache contengono inesattezze o diventano obsolete, questi errori possono persistere in più interazioni.
Prestazioni e scalabilità
Il banco di prova è il deployment in produzione su larga scala. Ecco alcuni compromessi prestazionali che ho riscontrato:
-
Sistemi RAG: maggiore latenza a causa dell’overhead di retrieval, ma scalabilità orizzontale possibile aggiungendo capacità di retrieval e distribuendo i database vettoriali. In pratica, funziona bene una volta investito nell’infrastruttura.
-
Sistemi CAG: tempi di risposta superiori ma scalabilità vincolata dalla memoria. Il collo di bottiglia arriva quando l’overhead di gestione della cache cresce più rapidamente del budget di memoria.
La questione della scalabilità è raramente semplice. Dipende molto dai pattern di query e dalle risorse disponibili.
Quando usare RAG vs CAG?
Basta teoria. Passiamo alla pratica. Dopo aver implementato entrambi gli approcci in vari progetti, ecco il mio framework per decidere quale usare.
Framework decisionale
Ecco come di solito guido i team in questa decisione. Le organizzazioni dovrebbero valutare volatilità dell’informazione, requisiti di latenza, esigenze di coerenza e risorse disponibili quando scelgono tra RAG e CAG. Elevata volatilità dell’informazione favorisce RAG, mentre domini di conoscenza stabili beneficiano dell’efficienza di CAG.
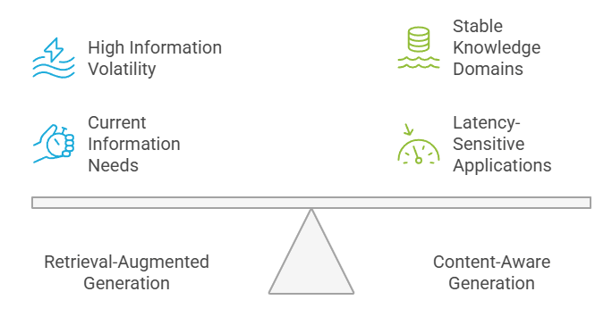
Framework decisionale: RAG vs CAG
Le applicazioni sensibili alla latenza in genere rendono meglio con sistemi CAG, mentre quelle che richiedono informazioni aggiornate dovrebbero sfruttare le capacità di RAG. La decisione spesso implica bilanciare questi requisiti in competizione in base alle priorità di business.
Usa RAG quando...
Scegli RAG quando ti serve:
-
Informazione dinamica e frequentemente aggiornata: applicazioni di ricerca, supporto clienti per prodotti in evoluzione o piattaforme di analisi delle notizie, dove contare è più importante che essere veloci.
-
Knowledge base ampie e diversificate: piattaforme di ricerca legale, sistemi di informazione medica e applicazioni di competitive intelligence. Per esperienza, se i tuoi dati cambiano ogni giorno o ogni settimana, RAG è di solito la scelta giusta.
-
Protezione contro informazioni obsolete: quando il costo di fornire dati stantii è più alto del costo della latenza aggiuntiva.
Di solito dico ai clienti: se temi che la tua AI dia risposte superate, parti da RAG. Potrai sempre ottimizzare la velocità dopo. Se opti per RAG, ricordati di scegliere il framework giusto.
Usa CAG quando...
Scegli CAG quando hai:
-
Requisiti di conoscenza stabili: chatbot di assistenza clienti per richieste di routine, piattaforme educative con curricula consolidati o automazione di workflow in cui la conoscenza di base cambia poco.
-
Volumi elevati di query con pattern ripetitivi: se rispondi alle stesse 100 domande migliaia di volte al giorno, il vantaggio di velocità di CAG si accumula rapidamente.
-
Applicazioni critiche per la latenza: sistemi di raccomandazione in tempo reale, esperienze di gioco interattive o ovunque i millisecondi contino per l’esperienza utente.
Per quello che ho visto, CAG è ideale quando puoi prevedere il 90% delle query e la tua knowledge base è relativamente stabile.
Applicazioni reali e casi d’uso di RAG e CAG
Vediamo come tutto questo si traduce nella pratica. Ho lavorato (e studiato) implementazioni in vari settori, e sono emersi pattern chiari. Ecco cosa funziona davvero in produzione.
Sanità
Partiamo dall’analisi di settore con la sanità, dove l’accesso a informazioni accurate e tempestive è particolarmente critico.
Nelle applicazioni sanitarie, i sistemi RAG supportano il decision-making clinico recuperando le ricerche mediche più recenti, i protocolli di trattamento e le informazioni sulle interazioni farmacologiche. I professionisti hanno così accesso a linee guida cliniche aggiornate e a studi recenti che potrebbero non essere inclusi nei dati di training del modello.
I sistemi CAG si rivelano preziosi negli scenari sanitari che richiedono accesso rapido a protocolli consolidati, riepiloghi della storia del paziente e procedure diagnostiche standardizzate, dove coerenza e velocità sono fondamentali.
A mio avviso, la sanità è dove si vede più chiaramente il caso per approcci ibridi: CAG per i protocolli standard, RAG per tutto ciò che cambia.
Finanza
La finanza è un altro caso interessante. Qui i requisiti sono completamente diversi rispetto alla sanità.
Le istituzioni finanziarie usano sistemi RAG per analisi di mercato, monitoraggio della conformità normativa e ricerca sugli investimenti, dove l’accesso a dati di mercato in tempo reale e a cambi normativi recenti è cruciale. Questi sistemi possono integrarsi con database finanziari e feed di notizie per fornire insight aggiornati.
CAG, invece, eccelle nelle applicazioni finanziarie che richiedono risposte rapide a richieste di routine, come calcoli standard, definizioni di prodotti e procedure di compliance consolidate.
In finanza, ho notato che la decisione spesso si riduce al rischio normativo. Se sbagliare può costare milioni in multe di conformità, i team tendono a preferire RAG.
Istruzione
L’istruzione offre un terreno fertile per entrambi, RAG e CAG.
Le piattaforme di apprendimento personalizzato spesso beneficiano di RAG, poiché gli studenti richiedono accesso a contenuti diversificati e in costante aggiornamento, inclusi nuovi articoli di ricerca, materiali di corso o persino eventi attuali usati come esempi didattici. Con RAG, un tutor AI può fornire riferimenti accurati o letture di approfondimento che non facevano parte del training originale.
CAG, per contro, rende al meglio in situazioni in cui ripetizione e coerenza sono fondamentali. Ad esempio, quando una piattaforma eroga quiz regolari, spiegazioni di concetti standard o sessioni di pratica strutturate, il caching assicura feedback più rapidi e coerenti.
In questo modo, i sistemi educativi spesso combinano entrambe le tecniche, unendo nuove intuizioni a un rinforzo affidabile della conoscenza di base.
Ingegneria del software
Passando al mondo del software, gli sviluppatori adottano sempre più entrambi i metodi per migliorare la produttività.
RAG supporta gli sviluppatori recuperando documentazione, specifiche API o passaggi di troubleshooting da fonti esterne. Poiché librerie o framework cambiano rapidamente, il livello di retrieval di RAG brilla nell’assicurare che le risposte restino aggiornate.
CAG, invece, è utile in attività che si basano molto su interazioni ripetute, come completamento del codice, assistenza al debugging o risposte a domande ricorrenti degli sviluppatori. Caching di pattern già visti riduce la latenza e accelera il flusso di lavoro di sviluppo.
Insieme, questi approcci permettono agli ingegneri di muoversi più velocemente contando su indicazioni accurate e consapevoli del contesto.
Legale e compliance
Il settore legale è un altro caso interessante su come questi approcci affrontano sfide specifiche di dominio con diversi pattern di accesso all’informazione.
I professionisti legali utilizzano sistemi RAG per ricerche di giurisprudenza e revisione di contratti, dove l’accesso ai documenti contrattuali più recenti e ai precedenti legali è essenziale. Ciò consente di assicurare che i pareri riflettano le decisioni dei tribunali e i cambi normativi più recenti non appena pubblicati.
CAG, invece, è la scelta migliore per il monitoraggio interno della conformità e l’applicazione automatizzata delle policy, soprattutto quando le regole sono fisse e le query ripetitive. Invece di recuperare le stesse "Linee guida anti-corruzione" o "Articolo 15 del GDPR" migliaia di volte al giorno, un sistema CAG pre-carica questi framework regolatori statici direttamente nel contesto del modello.
Poiché la "verità" di base (la legge) raramente cambia di giorno in giorno, mettere in cache questa conoscenza elimina il collo di bottiglia del retrieval per il 90% delle query che sono controlli standard di compliance.
Retail
Nel retail e nell’e-commerce, velocità e pertinenza plasmano direttamente l’esperienza del cliente.
RAG viene spesso utilizzata per potenziare la ricerca avanzata dei prodotti, integrare dati di inventario live e fornire raccomandazioni dinamiche. Ad esempio, se un cliente chiede se un prodotto è disponibile, un sistema abilitato RAG può interrogare database in tempo reale per dare una risposta aggiornata.
CAG, invece, garantisce risposte rapide a domande comuni dei clienti, come politiche di spedizione, regole di reso o aggiornamenti sullo stato dell’ordine. Riutilizzando interazioni in cache, il sistema fornisce risposte istantanee e riduce il carico sui server.
Usati insieme, RAG e CAG creano un’esperienza fluida che offre sia accuratezza sia efficienza.
Approcci ibridi e integrazione di sistema
Finora abbiamo trattato RAG e CAG come tecniche separate. Nella pratica, però, molte organizzazioni stanno iniziando ad adottare approcci ibridi che integrano entrambi i metodi. Questa combinazione consente di bilanciare la freschezza e l’adattabilità di RAG con la velocità e l’efficienza di CAG.
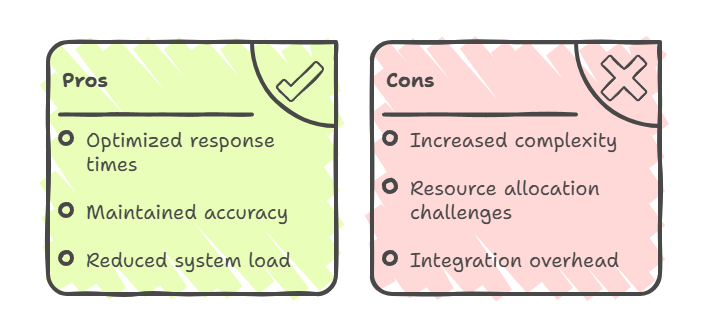
Approcci ibridi: pro e contro
Vantaggi dei modelli ibridi
I sistemi ibridi rappresentano la prossima evoluzione dell’integrazione della conoscenza, combinando le capacità di retrieval dinamico di RAG con i benefici di efficienza di CAG.
In questi modelli, CAG viene tipicamente usata per informazioni stabili e frequentemente consultate, mentre RAG è impiegata per query che richiedono dati in tempo reale o conoscenza specializzata. Il risultato è “il meglio di entrambi i mondi”: tempi di risposta ottimizzati per le query comuni, accuratezza mantenuta per contenuti dinamici e carico di sistema ridotto grazie a un routing intelligente.
Sfide dei modelli ibridi
Tuttavia, gli approcci ibridi introducono maggiore complessità architetturale. Richiedono un’orchestrazione sofisticata tra sistemi di caching e retrieval e un attento bilanciamento nell’allocazione delle risorse.
L’overhead di integrazione include la gestione di due percorsi di conoscenza, il mantenimento della sincronizzazione tra dati in cache e recuperati e l’implementazione di logiche di instradamento intelligenti che stabiliscono quale metodo usare per ciascuna query.
Se vuoi adottare una soluzione ibrida, devi davvero sapere quello che stai facendo.
Esempi di casi d’uso ibridi
Per esperienza, l’adozione più diffusa di architetture ibride si trova oggi negli ecosistemi di customer service. Vedo spesso piattaforme in cui CAG gestisce le FAQ statiche ad alto volume per un recupero istantaneo, mentre RAG viene usata selettivamente per recuperare dati live dell’account o storico delle transazioni.
Un altro esempio classico è nelle applicazioni di ricerca, dove CAG mantiene conoscenza di base in cache mentre RAG recupera le ultime pubblicazioni o dati dinamici per nuove query. Allo stesso modo, nelle piattaforme e-commerce, CAG gestisce descrizioni dei prodotti o policy in cache, mentre RAG integra livelli di inventario e aggiornamenti di prezzo in tempo reale.
Conclusione
Non esiste una risposta giusta universale, e chi dice il contrario probabilmente sta vendendo qualcosa. La scelta tra RAG e CAG, o la decisione di combinarle, dipende in ultima analisi da requisiti, vincoli e obiettivi specifici.
RAG eccelle quando hai bisogno di accedere a informazioni dinamiche e aggiornate e puoi tollerare un po’ di latenza in cambio di accuratezza e freschezza. CAG brilla negli scenari in cui contano soprattutto velocità e coerenza, e i requisiti di conoscenza restano relativamente stabili.
In futuro, è probabile che vedremo emergere approcci ibridi più sofisticati, capaci di instradare intelligentemente le query tra informazioni in cache e recuperate, ottimizzando sia le prestazioni sia l’accuratezza.
Per padroneggiare l’intero set di competenze necessario a progettare e distribuire sistemi RAG, CAG o ibridi, considera l’iscrizione al nostro percorso professionale AI Engineer.






Con l’evoluzione dell’intelligenza artificiale, una delle sfide centrali è capire come integrare efficacemente la conoscenza nei Large Language Models (LLM), considerata la loro conoscenza limitata. Per superare questi limiti, ricercatori e professionisti hanno esplorato diversi approcci all’integrazione della conoscenza.
Due degli approcci più importanti oggi sono la retrieval-augmented generation, o RAG, e la cache-augmented generation, o CAG. Ho lavorato con entrambi e, anche se spesso vengono presentati come concorrenti, li considero strumenti diversi per lavori diversi—a volte persino migliori se usati insieme.
In questo articolo ti guiderò in un confronto tra RAG e CAG, esplorando cosa significano, come funzionano e dove si collocano al meglio nelle applicazioni reali. Alla fine, vedrai come questi approcci differiscono, dove si sovrappongono e come scegliere tra loro, o persino combinarli, quando progetti sistemi di AI.
Se vuoi andare oltre i concetti e iniziare a costruire tu stesso questi sistemi, ti consiglio il nostro corso pratico Retrieval Augmented Generation (RAG) with LangChain.
Che cos’è la Retrieval-Augmented Generation (RAG)?
La retrieval-augmented generation è una tecnica che permette ai modelli di AI di andare oltre i loro dati di training fissi e incorporare informazioni esterne in modo dinamico. Invece di fare affidamento esclusivamente su quanto è stato codificato nel modello durante l’addestramento,
RAG collega il modello a database esterni e meccanismi di recupero, consentendogli di reperire documenti o conoscenze pertinenti al momento della query.
Questa idea è cresciuta in popolarità quando le organizzazioni si sono rese conto che i dati di training statici diventano rapidamente obsoleti. Ho visto come, in molti settori, le informazioni cambiano ogni giorno e un modello senza un livello di retrieval esterno non riesce a stare al passo.
RAG è stata sviluppata per colmare questo divario e portare conoscenza aggiornata, specifica del dominio o dinamica direttamente nel processo di generazione.
Come funziona RAG?
Il flusso di lavoro di RAG inizia con una query dell’utente. La query viene prima codificata in una rappresentazione vettoriale, poi utilizzata per cercare in un database vettoriale (sistema di retrieval) contenente documenti, record o altre fonti di conoscenza. Questa fase di retrieval garantisce che il modello identifichi le informazioni esterne più pertinenti prima di procedere.
In questa fase sono fondamentali strategie di chunking efficienti: i documenti vengono suddivisi in unità di significato più piccole, in genere da 100 a 1.000 token, in modo che il sistema di retrieval possa far emergere il contesto più rilevante senza sovraccaricare il modello di generazione.
Algoritmi di retrieval, spesso basati sulla ricerca del vicino approssimato, garantiscono che i chunk rilevanti vengano recuperati rapidamente anche da knowledge base di grandi dimensioni.
Una volta recuperati i documenti pertinenti, questi vengono passati alla fase di generazione, dove il modello linguistico integra tali informazioni nella sua risposta. Il processo consente al sistema di produrre risposte non solo più coerenti, ma anche ancorate a conoscenze esterne e aggiornate.
Flusso di lavoro RAG
Le fonti di conoscenza esterne possono includere database proprietari, articoli scientifici, archivi legali o persino API in tempo reale. Il motore di retrieval è il ponte che permette al modello linguistico di combinare la sua capacità generativa con dati fattuali. È come dare alla tua AI una tessera della biblioteca, invece di sperare che abbia memorizzato ogni libro.
Questa struttura di base può essere perfezionata applicando tecniche RAG avanzate o utilizzando il Corrective RAG (CRAG), una versione migliorata di RAG ottimizzata per l’accuratezza.
Ora che abbiamo visto come è strutturata e come opera RAG, diventa più semplice valutare cosa rende questo metodo particolarmente potente in scenari reali.
Punti di forza di RAG
Quello che amo di più di RAG è come gestisce il cambiamento. Il tuo reparto legale aggiorna una policy alle 15:00? Il tuo sistema RAG la conosce alle 15:01—senza bisogno di riaddestramento.
Per esperienza, RAG eccelle in tre aree principali:
Aggiornamenti in tempo reale: Il livello di retrieval si collega a conoscenza esterna, fornendo risposte basate sui dati più recenti. Questo rende RAG particolarmente preziosa in campi in rapida evoluzione come medicina, finanza o tecnologia.
Meno allucinazioni: Gli LLM spesso generano testo plausibile ma fattualmente errato. Ancorando le risposte a documenti recuperati, RAG fornisce un appiglio fattuale, aumentando l’affidabilità.
Integrazione dati flessibile: La conoscenza esterna può provenire da più fonti, come database strutturati, API semi-strutturate o archivi di testo non strutturati. Le organizzazioni possono adattare le pipeline di retrieval alle proprie esigenze.
Sebbene RAG offra vantaggi interessanti, è altrettanto importante comprendere le sfide e i vincoli che questo approccio comporta.
Limiti di RAG
Qui le cose si complicano, ed è ciò di cui avverto subito i miei clienti. RAG comporta compromessi reali:
Complessità del sistema: Devi orchestrare sistema di retrieval, database vettoriale e modello di generazione. Questa complessità crea ulteriori punti di failure e aumenta i costi di manutenzione.
Problemi di latenza: Il processo di retrieval aggiunge overhead computazionale a ogni query. Cercare in knowledge base di grandi dimensioni e recuperare documenti pertinenti richiede tempo, con impatto negativo sull’esperienza utente nelle applicazioni real-time.
Dipendenza dalla qualità del retrieval: Le risposte sono valide quanto il meccanismo di retrieval. Un retrieval scarso alimenta al modello contesto irrilevante, potenzialmente degradando la qualità della risposta.
Esistono comunque diverse tecniche chiave per migliorare le prestazioni di RAG e affrontare efficacemente questi problemi.
Dopo aver esplorato l’approccio incentrato sul retrieval, passiamo ora alla cache-augmented generation, che segue una strada molto diversa per migliorare le prestazioni del modello.
Che cos’è la Cache-Augmented Generation (CAG)?
CAG è l’ultima arrivata e, onestamente, mi ci è voluto un po’ per apprezzarne l’eleganza. Invece di andare a prendere continuamente informazioni come fa RAG, CAG pre-carica ciò che ti serve e lo tiene pronto.
A differenza dell’approccio dinamico di RAG, CAG punta a pre-caricare e mantenere informazioni rilevanti nel contesto esteso del modello o nella memoria cache. Il grafico seguente confronta i due approcci:
Confronto tra architetture RAG e CAG
CAG ha guadagnato rilevanza con lo sviluppo di modelli linguistici che supportano finestre di contesto sempre più ampie, talvolta fino a milioni di token. È la differenza tra cercare ogni risposta su un libro di riferimento e avere già pronta una cheat sheet.
Come funziona CAG?
CAG si basa su due meccanismi di caching complementari.
Per prima cosa, la knowledge caching si verifica quando documenti o materiali di riferimento rilevanti vengono pre-caricati nella finestra di contesto estesa del modello. Una volta archiviati, il modello può riutilizzare queste informazioni su più query senza doverle recuperare esternamente, come fanno i sistemi RAG.
In secondo luogo, la key-value (KV) caching punta all’efficienza memorizzando gli stati di attenzione (matrici key e value) generati mentre il modello elabora i token. Quando arriva una query simile o ripetuta, il modello può riutilizzare questi stati in cache invece di ricalcolarli da zero.
Key-Value Caching
Questo meccanismo riduce la latenza e consente al modello di mantenere un contesto di più lungo termine nelle conversazioni. Il flusso di lavoro amplia la memoria effettiva del sistema, permettendogli di gestire storie dialogiche più estese o query ripetitive senza dover ripartire ogni volta da zero.
L’idea alla base è che il caching estende i limiti pratici di ciò che un modello può ricordare. Persistendo le informazioni e richiamandole rapidamente, CAG crea un’esperienza di continuità nelle conversazioni più lunghe.
Con questo flusso di lavoro in mente, è facile capire perché CAG stia diventando sempre più attraente per certe applicazioni, soprattutto quando velocità ed efficienza sono priorità assolute
Punti di forza di CAG
Il principale punto di forza di CAG è l’efficienza. Poiché il modello riutilizza calcoli in cache, i tempi di risposta migliorano sensibilmente, riducendo la latenza, in particolare in scenari con query ripetitive o requisiti di conoscenza stabili. Ecco dove CAG brilla davvero:
Velocità ed efficienza: Il riutilizzo dei calcoli in cache migliora drasticamente i tempi di risposta, soprattutto per query ripetitive o con conoscenza stabile.
Coerenza tra sessioni: Memorizzando il contesto precedente, CAG evita derive nelle risposte e garantisce coerenza. È ideale per agenti conversazionali, automazione di workflow o chatbot di supporto dove le query ricorrenti sono comuni.
Minore complessità di sistema: Poiché il modello non deve effettuare lookup esterni così spesso, il sistema complessivo è più semplice rispetto a RAG.
Limiti di CAG
Nonostante questi vantaggi, nessuna tecnica è priva di compromessi, e CAG introduce un proprio set di sfide che le organizzazioni devono considerare con attenzione.
Informazioni obsolete: I dati in cache diventano obsoleti col tempo, quindi questi sistemi potrebbero non riflettere aggiornamenti recenti o cambiamenti dinamici nelle knowledge base.
Forti requisiti di memoria: Mantenere cache di grandi dimensioni richiede notevoli risorse computazionali. Le organizzazioni devono bilanciare attentamente la dimensione della cache con memoria disponibile e capacità di elaborazione.
Gestione della cache complessa: Garantire che le informazioni in cache restino accurate e sincronizzate in distribuzioni distribuite richiede meccanismi di coordinamento sofisticati—e questa complessità cresce con la scala del sistema.
Dopo aver esaminato RAG e CAG singolarmente, il passo successivo è confrontarle direttamente e mettere in evidenza le differenze critiche che ne influenzano l’adozione nella pratica.
RAG vs CAG: differenze chiave
Quindi, quale dovresti usare davvero? Mi fanno questa domanda continuamente e la mia risposta onesta è: dipende da cosa stai costruendo. Dopo aver lavorato con entrambi gli approcci in progetti diversi, ho notato alcuni schemi ricorrenti. Ecco, in sintesi, cosa ho imparato da implementazioni reali.
Caratteristica
RAG (Retrieval-Augmented Generation)
CAG (Cache-Augmented Generation)
Meccanismo di base
Just-in-Time: recupera i dati pertinenti da un database esterno durante la query.
Pre-caricato: carica i dati rilevanti nel contesto o nella cache del modello prima della query.
Latenza e velocità
Più lenta: richiede tempo per cercare, recuperare ed elaborare i documenti prima di generare una risposta.
Più veloce: accede istantaneamente alle informazioni dalla memoria, eliminando l’overhead del retrieval.
Freschezza della conoscenza
In tempo reale: può accedere a dati aggiornati pochi secondi prima (ad es. ultime notizie, nuove leggi).
Istantanea: la conoscenza è aggiornata solo all’ultimo refresh della cache; rischio di diventare "obsoleta".
Miglior caso d’uso
Dataset dinamici e massivi (ad es. giurisprudenza, ricerca medica, notizie).
Dataset stabili e ripetitivi (ad es. regole di compliance, FAQ, procedure operative standard).
Scalabilità
Orizzontale: scala bene con database vasti; limitata solo dalla velocità di ricerca.
Vincolata dalla memoria: limitata dalla dimensione della finestra di contesto del modello e dalla RAM disponibile.
Complessità
Alta: richiede la gestione di database vettoriali, pipeline di embedding e logica di retrieval.
Moderata: richiede la gestione del ciclo di vita della cache, l’ottimizzazione del contesto e l’efficienza della memoria.
Gestione delle allucinazioni
Ancoraggio delle risposte a documenti recuperati (citazioni).
Ancoraggio delle risposte a un contesto coerente, pre-caricato.
Confronto di architettura e flusso di lavoro
RAG e CAG adottano approcci fondamentalmente diversi all’accesso alla conoscenza. RAG segue un modello just-in-time: codifica la query dell’utente, cerca in un database vettoriale, recupera i documenti pertinenti e poi li passa alla fase di generazione. Questo design assicura l’accesso alle informazioni più recenti, ma il passaggio aggiuntivo di retrieval introduce latenza.
Dal punto di vista architetturale, i sistemi RAG si basano su pipeline multistadio che combinano chunking dei documenti, ricerca vettoriale e coordinamento del retrieval. Il chunking deve preservare il significato semantico restando efficiente per il retrieval, e la ricerca vettoriale spesso dipende da algoritmi di nearest neighbor approssimati per gestire raccolte su larga scala senza costi elevati.
CAG, al contrario, opera tramite pre-caricamento. Invece di cercare all’esterno nuova conoscenza, fa affidamento su finestre di contesto estese e memoria cache per riutilizzare informazioni archiviate in precedenza. Questo approccio spaziale riduce la latenza perché il modello recupera dalla memoria anziché da un database esterno.
Confronto del flusso di lavoro tra RAG e CAG
Il compromesso, però, è la freschezza: le informazioni in cache possono rimanere indietro rispetto agli aggiornamenti del mondo reale. Per questo, i sistemi CAG si concentrano su una gestione intelligente della cache, usando strategie di sostituzione, allocazione della memoria e ottimizzazione della finestra di contesto.
Ho visto sistemi in produzione in cui questo compromesso determinava il successo o il fallimento dell’implementazione, e l’efficacia di queste strategie incide direttamente su prestazioni e scalabilità del sistema.
Oltre all’architettura tecnica, c’è una dimensione pratica da discutere: come ciascun sistema gestisce il cambiamento.
Flessibilità vs rigidità
Ecco cosa ho osservato sull’adattabilità:
Flessibilità di RAG: il meccanismo di retrieval dinamico consente a questi sistemi di accedere a nuove informazioni subito dopo l’indicizzazione. Ho visto sistemi aggiornare la propria knowledge base in tempo reale, perfetti per domini in rapida evoluzione.
Rigidità di CAG: le informazioni pre-cachate significano più coerenza ma meno adattabilità. Pur offrendo velocità e comportamento prevedibile, fatica con query impreviste non considerate durante la preparazione della cache.
Per quello che ho visto, questa differenza conta soprattutto quando il tuo dominio è imprevedibile o in costante evoluzione.
Gestione delle allucinazioni
Parliamo ora di accuratezza e di come ciascun approccio affronta la tendenza dell’AI a inventare.
Le due tecniche affrontano le allucinazioni in modo diverso, in base alle rispettive architetture. I sistemi RAG mitigano le allucinazioni ancorando le risposte a informazioni fattuali recuperate, fornendo una validazione esterna ai contenuti generati.
I sistemi CAG riducono le allucinazioni grazie all’accesso coerente a informazioni verificate e in cache. Tuttavia, se le informazioni in cache contengono inesattezze o diventano obsolete, questi errori possono persistere in più interazioni.
Prestazioni e scalabilità
Il banco di prova è il deployment in produzione su larga scala. Ecco alcuni compromessi prestazionali che ho riscontrato:
Sistemi RAG: maggiore latenza a causa dell’overhead di retrieval, ma scalabilità orizzontale possibile aggiungendo capacità di retrieval e distribuendo i database vettoriali. In pratica, funziona bene una volta investito nell’infrastruttura.
Sistemi CAG: tempi di risposta superiori ma scalabilità vincolata dalla memoria. Il collo di bottiglia arriva quando l’overhead di gestione della cache cresce più rapidamente del budget di memoria.
La questione della scalabilità è raramente semplice. Dipende molto dai pattern di query e dalle risorse disponibili.
Quando usare RAG vs CAG?
Basta teoria. Passiamo alla pratica. Dopo aver implementato entrambi gli approcci in vari progetti, ecco il mio framework per decidere quale usare.
Framework decisionale
Ecco come di solito guido i team in questa decisione. Le organizzazioni dovrebbero valutare volatilità dell’informazione, requisiti di latenza, esigenze di coerenza e risorse disponibili quando scelgono tra RAG e CAG. Elevata volatilità dell’informazione favorisce RAG, mentre domini di conoscenza stabili beneficiano dell’efficienza di CAG.
Framework decisionale: RAG vs CAG
Le applicazioni sensibili alla latenza in genere rendono meglio con sistemi CAG, mentre quelle che richiedono informazioni aggiornate dovrebbero sfruttare le capacità di RAG. La decisione spesso implica bilanciare questi requisiti in competizione in base alle priorità di business.
Usa RAG quando...
Scegli RAG quando ti serve:
Informazione dinamica e frequentemente aggiornata: applicazioni di ricerca, supporto clienti per prodotti in evoluzione o piattaforme di analisi delle notizie, dove contare è più importante che essere veloci.
Knowledge base ampie e diversificate: piattaforme di ricerca legale, sistemi di informazione medica e applicazioni di competitive intelligence. Per esperienza, se i tuoi dati cambiano ogni giorno o ogni settimana, RAG è di solito la scelta giusta.
Protezione contro informazioni obsolete: quando il costo di fornire dati stantii è più alto del costo della latenza aggiuntiva.
Di solito dico ai clienti: se temi che la tua AI dia risposte superate, parti da RAG. Potrai sempre ottimizzare la velocità dopo. Se opti per RAG, ricordati di scegliere il framework giusto.
Usa CAG quando...
Scegli CAG quando hai:
Requisiti di conoscenza stabili: chatbot di assistenza clienti per richieste di routine, piattaforme educative con curricula consolidati o automazione di workflow in cui la conoscenza di base cambia poco.
Volumi elevati di query con pattern ripetitivi: se rispondi alle stesse 100 domande migliaia di volte al giorno, il vantaggio di velocità di CAG si accumula rapidamente.
Applicazioni critiche per la latenza: sistemi di raccomandazione in tempo reale, esperienze di gioco interattive o ovunque i millisecondi contino per l’esperienza utente.
Per quello che ho visto, CAG è ideale quando puoi prevedere il 90% delle query e la tua knowledge base è relativamente stabile.
Applicazioni reali e casi d’uso di RAG e CAG
Vediamo come tutto questo si traduce nella pratica. Ho lavorato (e studiato) implementazioni in vari settori, e sono emersi pattern chiari. Ecco cosa funziona davvero in produzione.
Sanità
Partiamo dall’analisi di settore con la sanità, dove l’accesso a informazioni accurate e tempestive è particolarmente critico.
Nelle applicazioni sanitarie, i sistemi RAG supportano il decision-making clinico recuperando le ricerche mediche più recenti, i protocolli di trattamento e le informazioni sulle interazioni farmacologiche. I professionisti hanno così accesso a linee guida cliniche aggiornate e a studi recenti che potrebbero non essere inclusi nei dati di training del modello.
I sistemi CAG si rivelano preziosi negli scenari sanitari che richiedono accesso rapido a protocolli consolidati, riepiloghi della storia del paziente e procedure diagnostiche standardizzate, dove coerenza e velocità sono fondamentali.
A mio avviso, la sanità è dove si vede più chiaramente il caso per approcci ibridi: CAG per i protocolli standard, RAG per tutto ciò che cambia.
Finanza
La finanza è un altro caso interessante. Qui i requisiti sono completamente diversi rispetto alla sanità.
Le istituzioni finanziarie usano sistemi RAG per analisi di mercato, monitoraggio della conformità normativa e ricerca sugli investimenti, dove l’accesso a dati di mercato in tempo reale e a cambi normativi recenti è cruciale. Questi sistemi possono integrarsi con database finanziari e feed di notizie per fornire insight aggiornati.
CAG, invece, eccelle nelle applicazioni finanziarie che richiedono risposte rapide a richieste di routine, come calcoli standard, definizioni di prodotti e procedure di compliance consolidate.
In finanza, ho notato che la decisione spesso si riduce al rischio normativo. Se sbagliare può costare milioni in multe di conformità, i team tendono a preferire RAG.
Istruzione
L’istruzione offre un terreno fertile per entrambi, RAG e CAG.
Le piattaforme di apprendimento personalizzato spesso beneficiano di RAG, poiché gli studenti richiedono accesso a contenuti diversificati e in costante aggiornamento, inclusi nuovi articoli di ricerca, materiali di corso o persino eventi attuali usati come esempi didattici. Con RAG, un tutor AI può fornire riferimenti accurati o letture di approfondimento che non facevano parte del training originale.
CAG, per contro, rende al meglio in situazioni in cui ripetizione e coerenza sono fondamentali. Ad esempio, quando una piattaforma eroga quiz regolari, spiegazioni di concetti standard o sessioni di pratica strutturate, il caching assicura feedback più rapidi e coerenti.
In questo modo, i sistemi educativi spesso combinano entrambe le tecniche, unendo nuove intuizioni a un rinforzo affidabile della conoscenza di base.
Ingegneria del software
Passando al mondo del software, gli sviluppatori adottano sempre più entrambi i metodi per migliorare la produttività.
RAG supporta gli sviluppatori recuperando documentazione, specifiche API o passaggi di troubleshooting da fonti esterne. Poiché librerie o framework cambiano rapidamente, il livello di retrieval di RAG brilla nell’assicurare che le risposte restino aggiornate.
CAG, invece, è utile in attività che si basano molto su interazioni ripetute, come completamento del codice, assistenza al debugging o risposte a domande ricorrenti degli sviluppatori. Caching di pattern già visti riduce la latenza e accelera il flusso di lavoro di sviluppo.
Insieme, questi approcci permettono agli ingegneri di muoversi più velocemente contando su indicazioni accurate e consapevoli del contesto.
Legale e compliance
Il settore legale è un altro caso interessante su come questi approcci affrontano sfide specifiche di dominio con diversi pattern di accesso all’informazione.
I professionisti legali utilizzano sistemi RAG per ricerche di giurisprudenza e revisione di contratti, dove l’accesso ai documenti contrattuali più recenti e ai precedenti legali è essenziale. Ciò consente di assicurare che i pareri riflettano le decisioni dei tribunali e i cambi normativi più recenti non appena pubblicati.
CAG, invece, è la scelta migliore per il monitoraggio interno della conformità e l’applicazione automatizzata delle policy, soprattutto quando le regole sono fisse e le query ripetitive. Invece di recuperare le stesse "Linee guida anti-corruzione" o "Articolo 15 del GDPR" migliaia di volte al giorno, un sistema CAG pre-carica questi framework regolatori statici direttamente nel contesto del modello.
Poiché la "verità" di base (la legge) raramente cambia di giorno in giorno, mettere in cache questa conoscenza elimina il collo di bottiglia del retrieval per il 90% delle query che sono controlli standard di compliance.
Retail
Nel retail e nell’e-commerce, velocità e pertinenza plasmano direttamente l’esperienza del cliente.
RAG viene spesso utilizzata per potenziare la ricerca avanzata dei prodotti, integrare dati di inventario live e fornire raccomandazioni dinamiche. Ad esempio, se un cliente chiede se un prodotto è disponibile, un sistema abilitato RAG può interrogare database in tempo reale per dare una risposta aggiornata.
CAG, invece, garantisce risposte rapide a domande comuni dei clienti, come politiche di spedizione, regole di reso o aggiornamenti sullo stato dell’ordine. Riutilizzando interazioni in cache, il sistema fornisce risposte istantanee e riduce il carico sui server.
Usati insieme, RAG e CAG creano un’esperienza fluida che offre sia accuratezza sia efficienza.
Approcci ibridi e integrazione di sistema
Finora abbiamo trattato RAG e CAG come tecniche separate. Nella pratica, però, molte organizzazioni stanno iniziando ad adottare approcci ibridi che integrano entrambi i metodi. Questa combinazione consente di bilanciare la freschezza e l’adattabilità di RAG con la velocità e l’efficienza di CAG.
Approcci ibridi: pro e contro
Vantaggi dei modelli ibridi
I sistemi ibridi rappresentano la prossima evoluzione dell’integrazione della conoscenza, combinando le capacità di retrieval dinamico di RAG con i benefici di efficienza di CAG.
In questi modelli, CAG viene tipicamente usata per informazioni stabili e frequentemente consultate, mentre RAG è impiegata per query che richiedono dati in tempo reale o conoscenza specializzata. Il risultato è “il meglio di entrambi i mondi”: tempi di risposta ottimizzati per le query comuni, accuratezza mantenuta per contenuti dinamici e carico di sistema ridotto grazie a un routing intelligente.
Sfide dei modelli ibridi
Tuttavia, gli approcci ibridi introducono maggiore complessità architetturale. Richiedono un’orchestrazione sofisticata tra sistemi di caching e retrieval e un attento bilanciamento nell’allocazione delle risorse.
L’overhead di integrazione include la gestione di due percorsi di conoscenza, il mantenimento della sincronizzazione tra dati in cache e recuperati e l’implementazione di logiche di instradamento intelligenti che stabiliscono quale metodo usare per ciascuna query.
Se vuoi adottare una soluzione ibrida, devi davvero sapere quello che stai facendo.
Esempi di casi d’uso ibridi
Per esperienza, l’adozione più diffusa di architetture ibride si trova oggi negli ecosistemi di customer service. Vedo spesso piattaforme in cui CAG gestisce le FAQ statiche ad alto volume per un recupero istantaneo, mentre RAG viene usata selettivamente per recuperare dati live dell’account o storico delle transazioni.
Un altro esempio classico è nelle applicazioni di ricerca, dove CAG mantiene conoscenza di base in cache mentre RAG recupera le ultime pubblicazioni o dati dinamici per nuove query. Allo stesso modo, nelle piattaforme e-commerce, CAG gestisce descrizioni dei prodotti o policy in cache, mentre RAG integra livelli di inventario e aggiornamenti di prezzo in tempo reale.
Conclusione
Non esiste una risposta giusta universale, e chi dice il contrario probabilmente sta vendendo qualcosa. La scelta tra RAG e CAG, o la decisione di combinarle, dipende in ultima analisi da requisiti, vincoli e obiettivi specifici.
RAG eccelle quando hai bisogno di accedere a informazioni dinamiche e aggiornate e puoi tollerare un po’ di latenza in cambio di accuratezza e freschezza. CAG brilla negli scenari in cui contano soprattutto velocità e coerenza, e i requisiti di conoscenza restano relativamente stabili.
In futuro, è probabile che vedremo emergere approcci ibridi più sofisticati, capaci di instradare intelligentemente le query tra informazioni in cache e recuperate, ottimizzando sia le prestazioni sia l’accuratezza.
Per padroneggiare l’intero set di competenze necessario a progettare e distribuire sistemi RAG, CAG o ibridi, considera l’iscrizione al nostro percorso professionale AI Engineer.