

Kurs
LangChain ile Retrieval Augmented Generation (RAG)
3 sa
21.3K
Alıştırma and program your progress.
Google Ile Devam EdinYapay zekâ gelişmeye devam ederken, Büyük Dil Modellerine (LLM) bilgiyi etkin şekilde entegre etmenin, modellerin sınırlı bilgisi dikkate alındığında, en temel zorluklardan biri olduğunu görüyoruz. Bu sınırlamaları aşmak için, araştırmacılar ve uygulayıcılar bilgi entegrasyonuna yönelik farklı yaklaşımlar keşfettiler.
Günümüzde en önemli iki yaklaşım, retrieval-augmented generation (RAG) ve cache-augmented generation (CAG). Bu iki yaklaşımla da çalıştım ve çoğu zaman rakip gibi sunulsalar da, pratikte farklı işler için farklı araçlar olduklarını—hatta bazen birlikte kullanıldıklarında daha iyi sonuç verdiklerini—gördüm.
Bu yazıda, RAG ve CAG’yi karşılaştırarak her bir kavramın ne anlama geldiğini, nasıl çalıştığını ve gerçek dünyadaki uygulamalarda nerelerde en iyi şekilde konumlandığını ele alacağım. Sonunda, bu yaklaşımların nasıl farklılaştığını, nerelerde örtüştüğünü ve yapay zekâ sistemleri tasarlarken aralarından nasıl seçim yapabileceğinizi—hatta nasıl birleştirebileceğinizi—göreceksiniz.
Kavramların ötesine geçip bu sistemleri kendiniz kurmaya başlamak isterseniz, uygulamalı kursumuz Retrieval Augmented Generation (RAG) with LangChain’i öneririm.
Retrieval-augmented generation, AI modellerinin sabit eğitim verilerinin ötesine geçip haricî bilgileri dinamik olarak dahil etmesini sağlayan bir tekniktir. Modelin yalnızca eğitim sırasında kodlananlara dayanması yerine,
RAG, modeli haricî veritabanlarına ve getirme (retrieval) mekanizmalarına bağlayarak, sorgu anında ilgili belgeleri veya bilgileri getirmesine imkân tanır.
Bu fikir, kuruluşlar statik eğitim verilerinin hızla güncelliğini yitirdiğini fark ettikçe popülerlik kazandı. Birçok sektörde bilgilerin her gün değiştiğini gördüm ve haricî bir getirme katmanı olmayan bir model bu değişime ayak uyduramaz.
RAG, bu boşluğu kapatmak ve güncel, alana özgü veya dinamik bilgiyi doğrudan üretim sürecine taşımak için geliştirildi.
RAG iş akışı bir kullanıcı sorgusuyla başlar. Sorgu önce bir vektör temsiline dönüştürülür ve ardından belgeler, kayıtlar veya diğer bilgi kaynaklarını içeren bir vektör veritabanında (getirme sistemi) arama yapmak için kullanılır. Bu getirme aşaması, modele ilerlemeden önce en ilgili haricî bilgiyi tespit ettirir.
Bu aşamada verimli parçalama stratejileri kritik öneme sahiptir: belgeler, genellikle 100 ila 1.000 token aralığında, daha küçük anlam birimlerine bölünür; böylece getirme sistemi, üretim modelini boğmadan en ilgili bağlamı yüzeye çıkarabilir.
Getirme algoritmaları, sıklıkla yaklaşık en yakın komşu aramasına dayanarak, büyük ölçekli bilgi tabanlarından dahi ilgili parçaların hızlıca getirilmesini sağlar.
İlgili belgeler getirildikten sonra üretim aşamasına aktarılır ve dil modeli bu bilgiyi yanıtına entegre eder. Bu süreç, yalnızca daha tutarlı değil, aynı zamanda haricî ve güncel bilgiye dayalı yanıtlar üretilmesini sağlar.
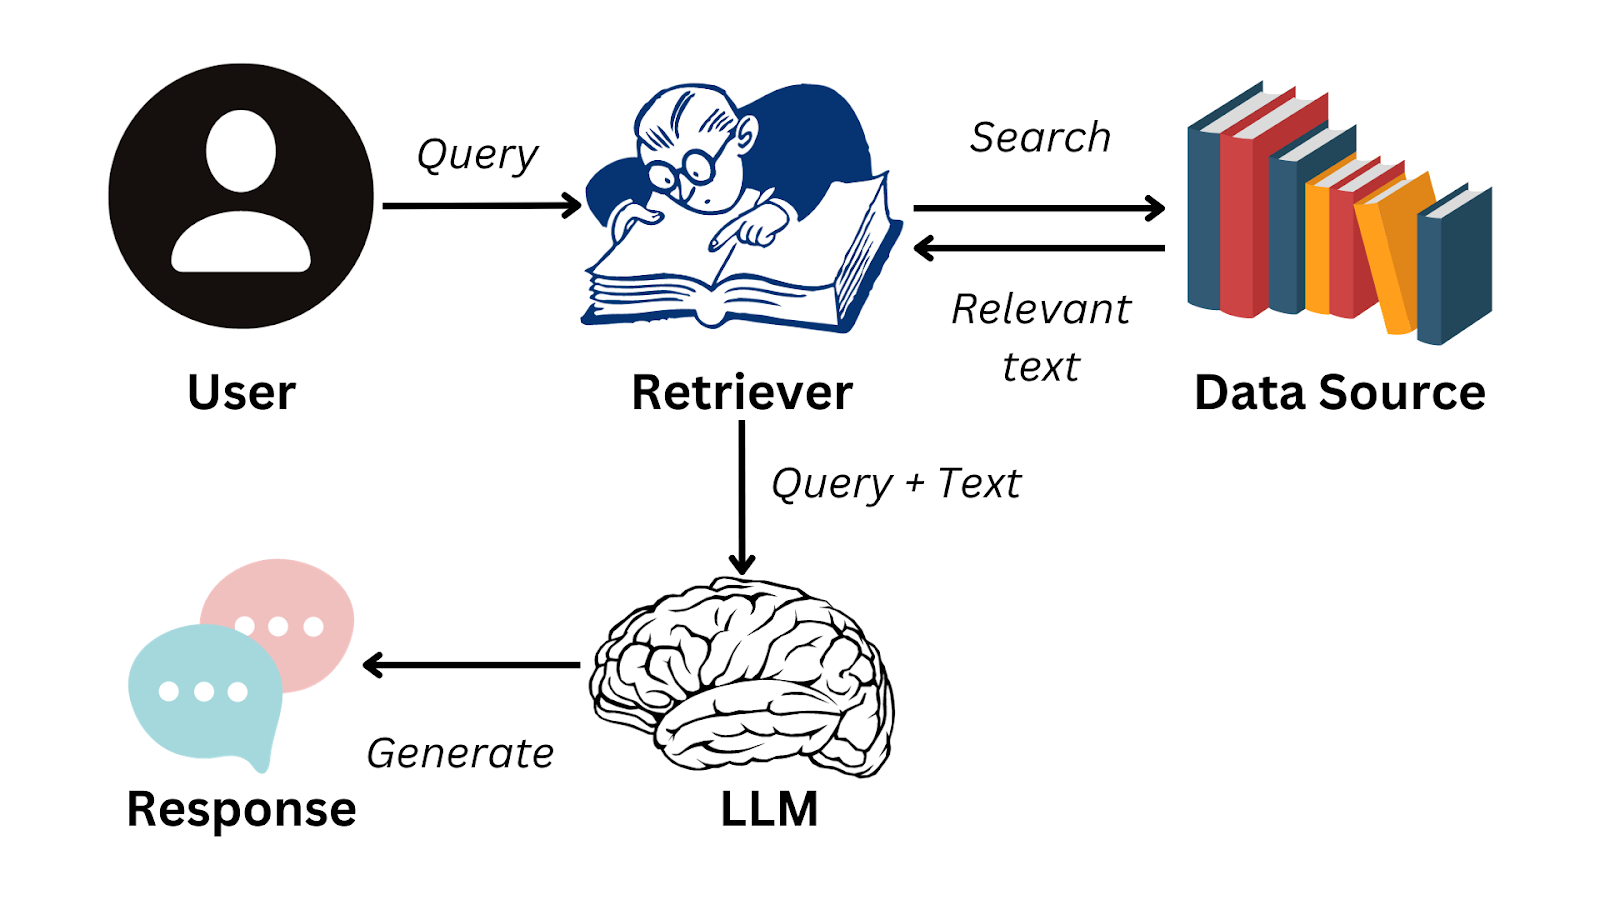
RAG iş akışı
Haricî bilgi kaynakları; kurumsal veritabanları, bilimsel makaleler, hukuk arşivleri veya gerçek zamanlı API’leri içerebilir. Getirme motoru, dil modelinin üretim kabiliyetini olgusal verilerle birleştirmesini sağlayan köprüdür. Bunu, yapay zekânıza her kitabı ezberlemesini ummak yerine bir kütüphane kartı vermek gibi düşünebilirsiniz.
Bu temel yapı, uygulanacak ileri RAG teknikleri veya doğruluğa yönelik optimize edilmiş, RAG’in geliştirilmiş bir sürümü olan Corrective RAG (CRAG) kullanılarak iyileştirilebilir.
RAG’in nasıl yapılandığını ve çalıştığını incelediğimize göre, bu yöntemi gerçek dünyada özellikle güçlü kılan unsurları değerlendirmek kolaylaşır.
RAG’de en sevdiğim şey, değişimi nasıl yönettiği. Hukuk biriminiz saat 15.00’te bir politikayı güncelledi mi? RAG sisteminiz bunu 15.01’de biliyor—yeniden eğitim gerekmez.
Deneyimlerime göre, RAG üç ana alanda öne çıkar:
Gerçek zamanlı güncellemeler: Getirme katmanı haricî bilgiye bağlanarak en güncel verilere dayalı yanıtlar sunar. Bu, tıpkı tıp, finans veya teknoloji gibi hızla değişen alanlarda RAG’yi özellikle değerli kılar.
Daha az halüsinasyon: LLM’ler kulağa makul gelen ama gerçekte yanlış olan metinler üretebilir. Yanıtları getirilen belgelere dayandırarak, RAG çıktının olgusal bir dayanağa sahip olmasını sağlar ve güvenilirliği artırır.
Esnek veri entegrasyonu: Haricî bilgi; yapılandırılmış veritabanları, yarı yapılandırılmış API’ler veya yapılandırılmamış metin depoları gibi birden çok kaynaktan gelebilir. Kuruluşlar, getirme hatlarını kendi ihtiyaçlarına göre uyarlayabilir.
RAG etkileyici avantajlar sunsa da, bu yaklaşımla birlikte gelen zorlukları ve kısıtları da anlamak aynı derecede önemlidir.
Zorlayıcı kısım işte burada başlıyor ve müşterilerimi en baştan bunun konusunda uyarırım. RAG gerçek ödünler içerir:
Sistem karmaşıklığı: Getirme sistemi, vektör veritabanı ve üretim modelini orkestre etmeniz gerekir. Bu karmaşıklık ek arıza noktaları yaratır ve bakım yükünü artırır.
Gecikme sorunları: Getirme süreci her sorguya hesaplama yükü ekler. Büyük bilgi tabanlarında arama yapmak ve ilgili belgeleri getirmek zaman alır; bu da gerçek zamanlı uygulamalarda kullanıcı deneyimini olumsuz etkileyebilir.
Getirme kalitesine bağımlılık: Yanıtlarınız getirme mekanizmanız kadar iyidir. Zayıf getirme, dil modeline ilgisiz bağlam verilmesine neden olabilir ve yanıt kalitesini düşürebilir.
Bununla birlikte, RAG performansını artırmak için temel teknikler mevcuttur ve bu sorunlarla etkili şekilde başa çıkılabilir.
Getirme odaklı yaklaşımı inceledikten sonra, şimdi model performansını artırmak için oldukça farklı bir yol izleyen cache-augmented generation’a geçiyorum.
CAG bu alanın yeni oyuncusu ve açıkçası, zarafetini takdir etmem biraz zaman aldı. RAG gibi sürekli bilgi çekmek yerine, CAG ihtiyaç duyduğunuzu önceden yükler ve hazır tutar.
RAG’nin dinamik getirme yaklaşımından farklı olarak CAG, modelin genişletilmiş bağlamına veya önbellek belleğine ilgili bilgileri önceden yüklemeye ve sürdürmeye odaklanır. Aşağıdaki görsel iki yaklaşımı karşılaştırır:
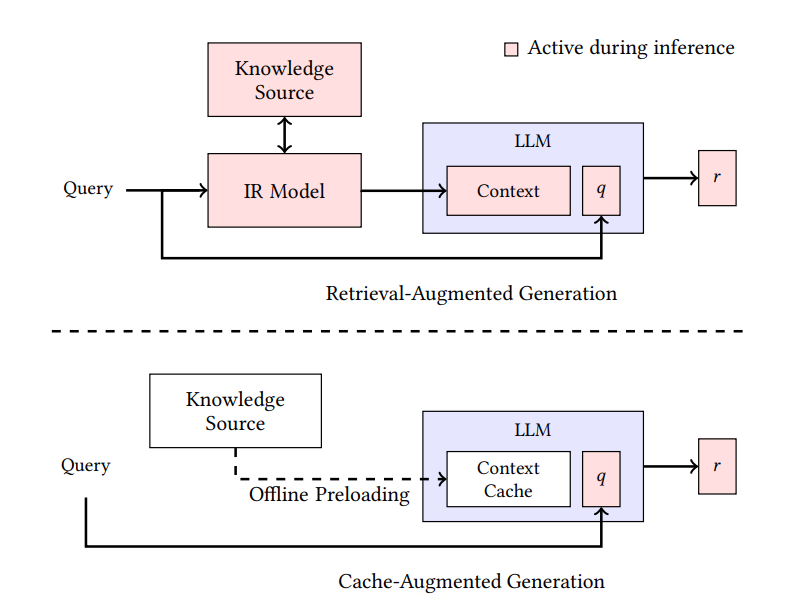
RAG ve CAG mimarilerinin karşılaştırılması
CAG, milyonlarca tokena kadar uzanan giderek daha büyük bağlam pencerelerini destekleyen dil modellerinin gelişimiyle birlikte öne çıktı. Bu, cevapları sürekli bir başvuru kitabından aramak ile önceden hazırlanmış bir kopya kâğıdına sahip olmak arasındaki farka benzer.
CAG, iki tamamlayıcı önbellekleme mekanizmasına dayanır.
İlk olarak, bilgi önbellekleme, ilgili belgeler veya referans materyallerin modelin genişletilmiş bağlam penceresine önceden yüklenmesiyle gerçekleşir. Bir kez saklandığında, model bu bilgiyi RAG sistemlerinde olduğu gibi haricî olarak çekmeye gerek kalmadan, birden fazla sorguda yeniden kullanabilir.
İkincisi, anahtar-değer (KV) önbellekleme, model tokenları işlerken üretilen dikkat durumlarının (anahtar ve değer matrisleri) saklanmasına odaklanır. Benzer veya tekrarlanan bir sorgu geldiğinde, model bu önbelleğe alınmış durumları sıfırdan yeniden hesaplamak yerine yeniden kullanabilir.
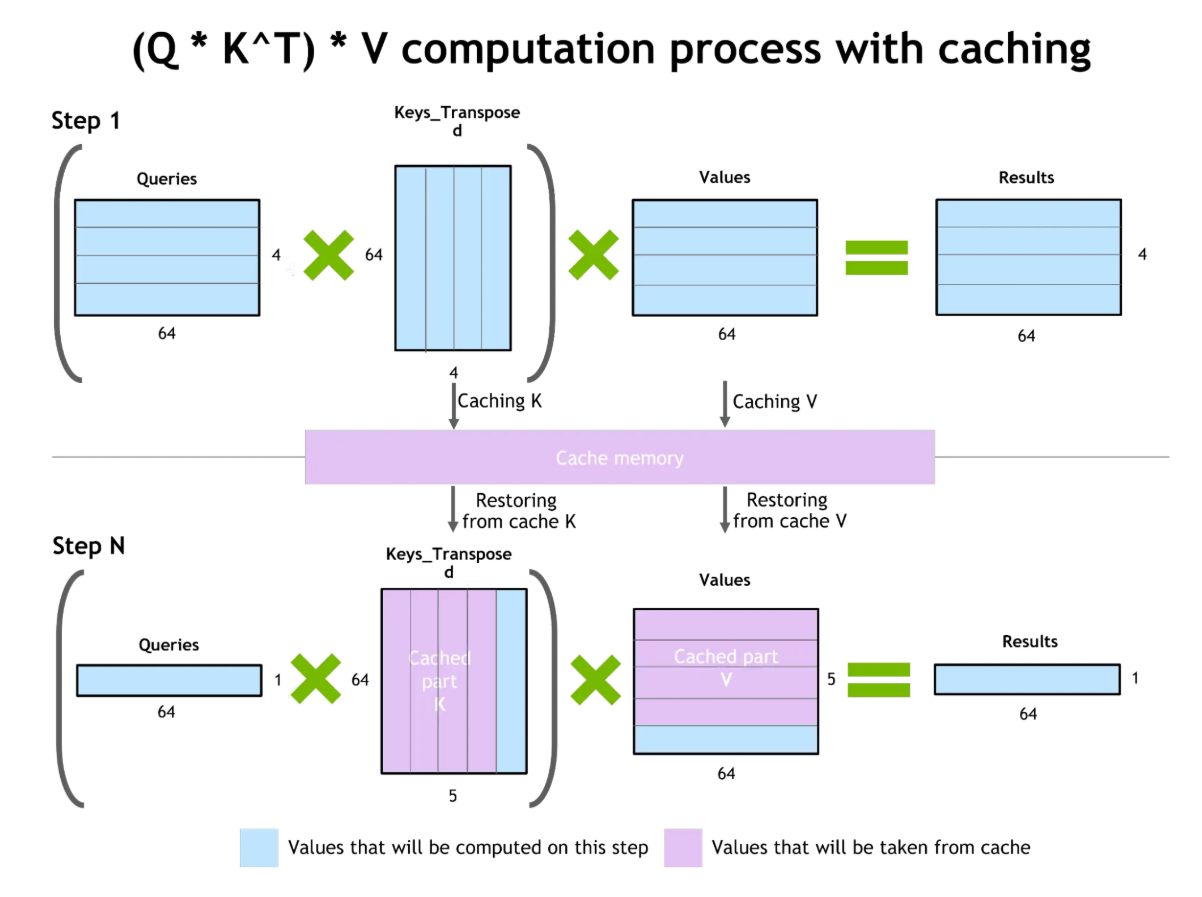
Bu mekanizma, gecikmeyi azaltır ve modelin konuşmalar boyunca daha uzun vadeli bağlamı korumasına olanak tanır. İş akışı, sistemin etkin belleğini genişleterek, daha kapsamlı diyalog geçmişlerini veya tekrar eden sorguları her seferinde başa dönmeden ele almasını mümkün kılar.
Temel fikir, önbelleklemenin bir modelin hatırlayabileceği pratik sınırları genişletmesidir. Bilgiyi kalıcı hale getirip hızlıca referanslayarak, CAG daha uzun konuşmalar boyunca süreklilik hissi yaratır.
Bu iş akışını akılda tutarak, özellikle hız ve verimliliğin öncelikli olduğu belirli uygulamalar için CAG’nin neden giderek daha cazip hale geldiğini görebiliriz
CAG’nin başlıca gücü verimliliğidir. Model önbelleğe alınmış hesaplamaları yeniden kullandığı için yanıt süreleri önemli ölçüde iyileşir; özellikle sorguların tekrarlı olduğu veya bilgi gereksinimlerinin sabit kaldığı durumlarda gecikme azalır. CAG’nin gerçekten parladığı noktalar şunlardır:
Hız ve verimlilik: Önbelleğe alınmış hesaplamaların yeniden kullanımı, özellikle tekrarlanan sorgular veya istikrarlı bilgi gereksinimlerinde, yanıt sürelerini dramatik biçimde iyileştirir.
Oturumlar arasında tutarlılık: Önceki bağlamı saklayarak, CAG yanıtların sapmasını önler ve tutarlılığı sağlar. Bu da tekrarlayan sorguların yaygın olduğu sohbet botları, iş akışı otomasyonu veya müşteri destek asistanları için idealdir.
Daha düşük sistem karmaşıklığı: Model haricî aramaları daha seyrek gerçekleştirdiği için, genel sistem RAG’ye kıyasla daha basittir.
Bu avantajlara rağmen hiçbir teknik ödünsüz değildir ve CAG, kuruluşların dikkatle değerlendirmesi gereken kendine özgü bir dizi zorluk getirir.
Bayat bilgi: Önbelleğe alınan veri zamanla güncelliğini yitirir; bu nedenle bu sistemler yakın tarihli güncellemeleri veya bilgi tabanlarındaki dinamik değişimleri yansıtmayabilir.
Ağır bellek gereksinimleri: Büyük önbelleklerin sürdürülmesi ciddi hesaplama kaynakları gerektirir. Kuruluşlar, önbellek boyutunu mevcut bellek ve işlem kapasitesiyle dikkatle dengelemelidir.
Karmaşık önbellek yönetimi: Önbelleğe alınmış bilginin dağıtık konuşlandırmalar boyunca doğru ve senkronize kalmasını sağlamak sofistike koordinasyon mekanizmaları gerektirir—ve sistem ölçeklendikçe bu karmaşıklık artar.
RAG ve CAG’yi ayrı ayrı incelediğimize göre, bir sonraki adım bunları doğrudan karşılaştırıp pratikte benimsenmelerini şekillendiren kritik farkları vurgulamaktır.
Peki gerçekte hangisini kullanmalısınız? Bu soruyu sürekli duyuyorum ve dürüst yanıtım şu: ne inşa ettiğinize bağlı. Her iki yaklaşımla da farklı projelerde çalıştıktan sonra bazı net kalıplar fark ettim. Gerçek uygulamalardan öğrendiklerimi özetleyeyim.
|
Özellik |
RAG (Retrieval-Augmented Generation) |
CAG (Cache-Augmented Generation) |
|
Temel Mekanizma |
İhtiyaç Anında: Sorgu sırasında haricî bir veritabanından ilgili verileri çeker. |
Önceden Yükleme: Sorgudan önce ilgili verileri modelin bağlamına veya önbelleğine yükler. |
|
Gecikme ve Hız |
Daha Yavaş: Yanıt üretmeden önce belgeleri aramak, getirmek ve işlemek için zaman gerekir. |
En Hızlı: Bilgiye bellekte anında erişir, getirme yükünü ortadan kaldırır. |
|
Bilgi Tazeliği |
Gerçek Zamanlı: Saniyeler önce güncellenmiş verilere erişebilir (ör. son dakika haberleri, yeni yasalar). |
Anlık Görüntü: Bilgi son önbellek güncellemesi kadar tazedir; “bayat” kalma riski vardır. |
|
En İyi Kullanım Alanı |
Dinamik, devasa veri kümeleri (ör. İçtihat Hukuku, Tıbbi Araştırma, Haberler). |
Sabit, tekrarlayan veri kümeleri (ör. Uyum Kuralları, SSS, Standart İşletim Prosedürleri). |
|
Ölçeklenebilirlik |
Yatay: Geniş veritabanlarıyla iyi ölçeklenir; yalnızca arama hızıyla sınırlıdır. |
Bellek Sınırlı: Modelin bağlam penceresi boyutu ve mevcut RAM ile sınırlıdır. |
|
Karmaşıklık |
Yüksek: Vektör veritabanlarını, gömme (embedding) hatlarını ve getirme mantığını yönetmeyi gerektirir. |
Orta: Önbellek yaşam döngüsü, bağlam optimizasyonu ve bellek verimliliğinin yönetilmesini gerektirir. |
|
Halüsinasyonlarla Başa Çıkma |
Yanıtları getirilen belgelere (atıflara) dayandırır. |
Yanıtları tutarlı, önceden yüklenmiş bağlama dayandırır. |
RAG ve CAG bilgiye erişimde temelde farklı yaklaşımlar benimser. RAG, ihtiyaca göre (just-in-time) bir model izler: kullanıcının sorgusunu kodlar, bir vektör veritabanında arama yapar, ilgili belgeleri getirir ve ardından bunları üretim aşamasına iletir. Bu tasarım en güncel bilgilere erişimi sağlarken, ek getirme adımı gecikme yaratır.
Mimari olarak RAG sistemleri, belge parçalama, vektör araması ve getirme koordinasyonunu birleştiren çok aşamalı hatlara dayanır. Belge parçalamanın, anlamsal bütünlüğü korurken getirme için verimli kalması gerekir; vektör arama ise genellikle yüksek maliyete yol açmadan büyük koleksiyonları ele almak için yaklaşık en yakın komşu algoritmalarına dayanır.
Buna karşılık CAG, önceden yükleme üzerinden çalışır. Yeni bilgiye dışarıdan uzanmak yerine, daha önce depolanmış bilgiyi yeniden kullanmak için genişletilmiş bağlam pencerelerine ve önbellek belleğine dayanır. Bu mekânsal yaklaşım, modelin haricî bir veritabanı yerine bellekten yararlanması sayesinde gecikmeyi azaltır.
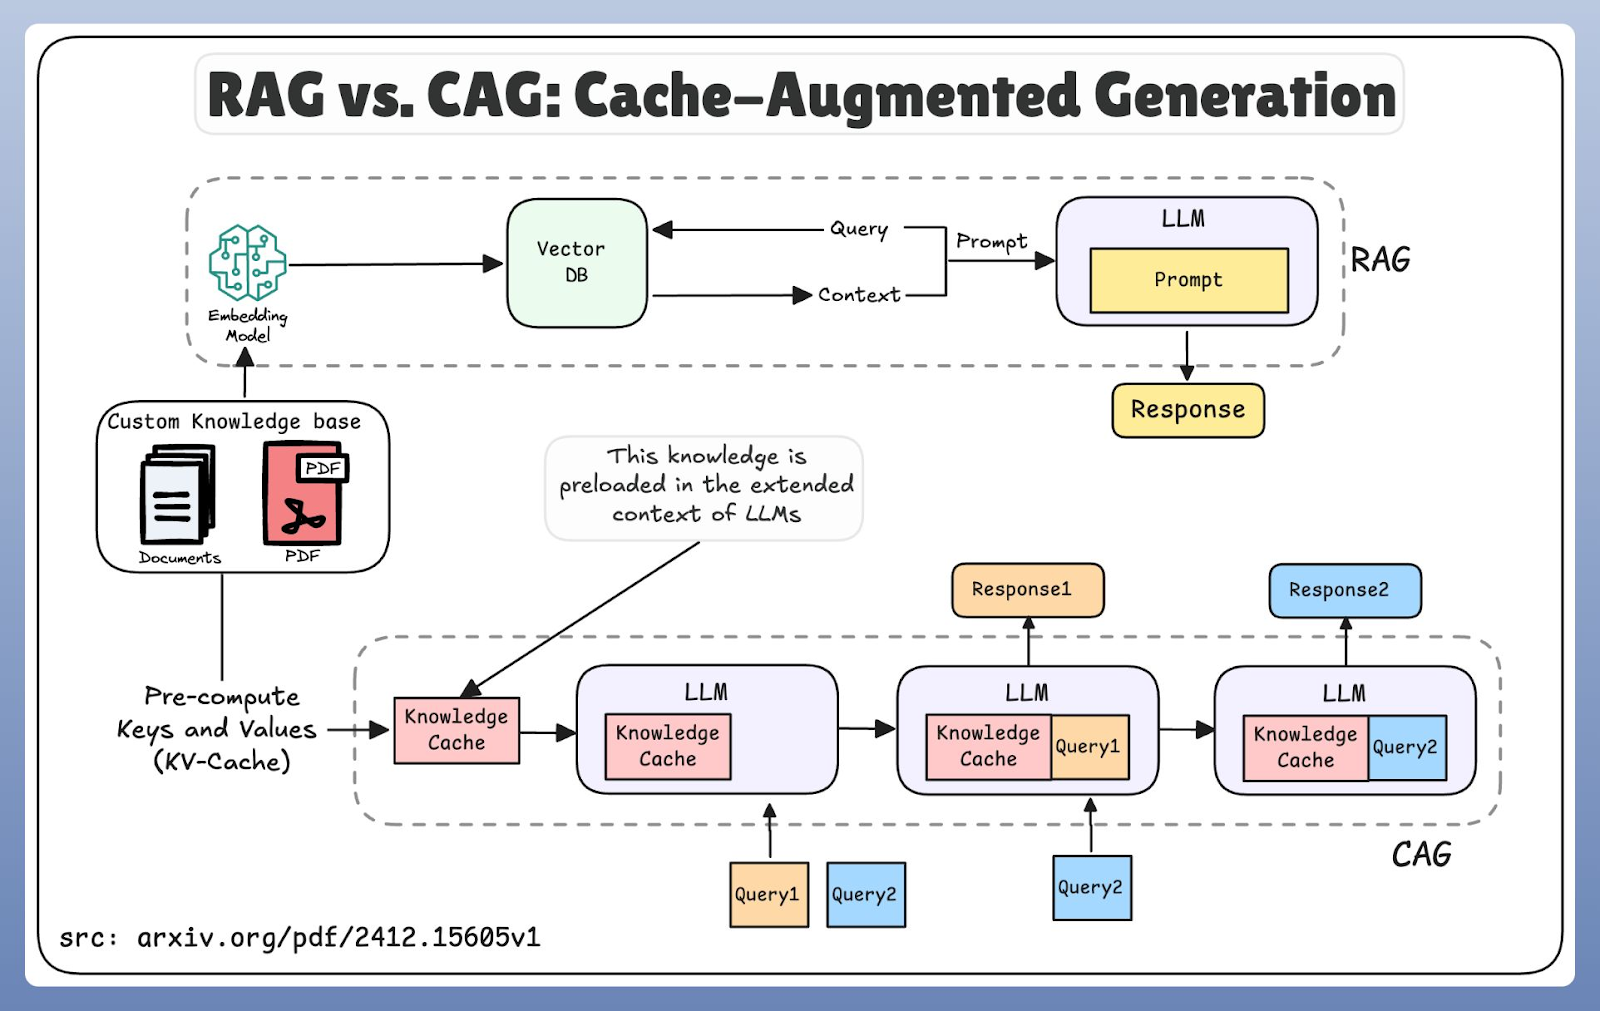
RAG ve CAG iş akışı karşılaştırması
Ancak ödün, tazeliktedir: önbelleğe alınan bilgiler gerçek dünya güncellemelerinin gerisinde kalabilir. Bu nedenle CAG sistemleri, önbellek değiştirme, bellek tahsisi ve bağlam penceresi optimizasyonuna yönelik stratejilerle akıllı önbellek yönetimine odaklanır.
Bu ödünün üretim sistemlerinde uygulamayı başarıya ulaştırabildiğini de başarısızlığa uğratabildiğini de gördüm; bu stratejilerin etkinliği sistemin performansını ve ölçeklenebilirliğini doğrudan belirler.
Teknik mimarinin ötesinde, her bir sistemin değişimi nasıl ele aldığına dair tartışmaya değer pratik bir boyut da var.
Uyarlanabilirlikle ilgili gözlemlerim şunlar:
RAG’nin esnekliği: Dinamik getirme mekanizması, bu sistemlerin dizinlendiği anda yeni bilgilere erişmesini sağlar. Bilgi tabanını gerçek zamanlı güncelleyen sistemler gördüm; hızla evrilen alanlar için mükemmel.
CAG’nin katılığı: Önceden önbelleğe alınmış bilgi daha fazla tutarlılık ama daha az uyarlanabilirlik demektir. Bu hız ve öngörülebilir davranış sağlarken, önbellek hazırlığı sırasında öngörülmeyen beklenmedik sorgularda zorlanır.
Gördüğüm kadarıyla, bu fark alanınız öngörülemez veya sürekli gelişiyorsa en çok önem kazanır.
Şimdi doğruluk ve her yaklaşımın yapay zekânın uydurma eğilimiyle nasıl başa çıktığına bakalım.
Her iki teknik de altta yatan mimarilerine bağlı olarak halüsinasyonları farklı şekilde ele alır. RAG sistemleri, yanıtları getirilen olgusal bilgilere dayandırarak, üretilen içerik için haricî doğrulama sağlar ve halüsinasyonları azaltır.
CAG sistemleri, doğrulanmış ve önbelleğe alınmış bilgiye tutarlı erişim yoluyla halüsinasyonları azaltır. Ancak önbelleğe alınmış bilgi hatalar içeriyorsa veya güncelliğini yitirirse, bu hatalar birden fazla etkileşim boyunca kalıcı olabilir.
Ölçekli üretim konuşlandırmasını düşündüğünüzde işin rengi değişir. Karşılaştığım performans ödünleri şunlar:
RAG sistemleri: Getirme yükü nedeniyle daha yüksek gecikme; ancak getirme kapasitesi ekleyip vektör veritabanlarını dağıtarak yatayda ölçekleyebilirsiniz. Pratikte, altyapıya yatırım yaptığınızda bunun iyi çalıştığını gördüm.
CAG sistemleri: Üstün yanıt süreleri ancak bellekle sınırlı ölçeklenebilirlik. Darboğaz genellikle önbellek yönetimi yükü bellek bütçenizin izin verdiğinden daha hızlı büyüdüğünde ortaya çıkar.
Ölçeklenebilirlik sorusu nadiren basittir. Yoğun biçimde sorgu kalıplarınıza ve mevcut kaynaklarınıza bağlıdır.
Peki, teori yeter. Pratiğe geçelim. Her iki yaklaşımı farklı projelerde uyguladıktan sonra, hangisini kullanacağıma böyle karar veriyorum.
Ekipleri bu kararda genellikle şöyle yönlendiriyorum. Kuruluşlar, RAG ile CAG arasında seçim yaparken bilgi oynaklığını, gecikme gereksinimlerini, tutarlılık ihtiyaçlarını ve kaynak mevcudiyetini değerlendirmelidir. Bilgi oynaklığının yüksek olduğu durumlar RAG’yi, bilgi alanlarının istikrarlı olduğu durumlar ise CAG’nin verimliliğini tercih eder.
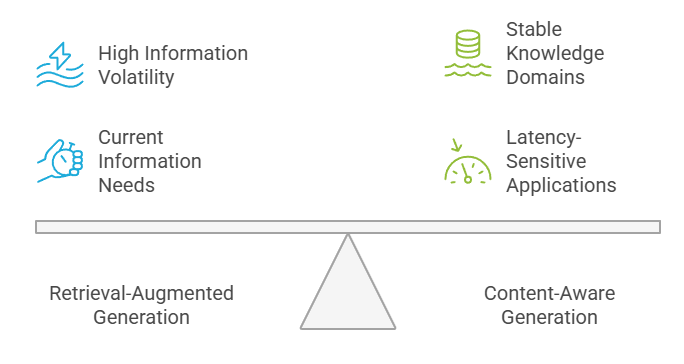
Karar Çerçevesi: RAG vs. CAG
Gecikmeye duyarlı uygulamalar genellikle CAG sistemleriyle daha iyi performans gösterirken, en güncel bilgiye ihtiyaç duyan uygulamalar RAG yeteneklerini kullanmalıdır. Karar çoğu zaman, iş önceliklerine göre bu rekabet halindeki gereksinimlerin dengelenmesini içerir.
RAG’yi şu durumlarda tercih edin:
Dinamik, sık güncellenen bilgi: Araştırma uygulamaları, gelişen ürünler için müşteri desteği veya hızdan ziyade güncelliğin önemli olduğu haber analiz platformları.
Büyük ve çeşitli bilgi tabanları: Hukuk araştırma platformları, tıbbi bilgi sistemleri ve rekabet istihbaratı uygulamaları. Deneyimlerime göre, veriniz günlük ya da haftalık değişiyorsa, genellikle doğru tercih RAG’dir.
Güncel olmayan bilgiden korunma: Bayat veri sunmanın maliyeti, ek gecikme maliyetinden yüksek olduğunda.
Müşterilere genelde şunu söylerim: Yapay zekânızın eski yanıtlar vermesinden endişe ediyorsanız, RAG ile başlayın. Hızı sonradan da optimize edebilirsiniz. RAG’yi tercih ederseniz doğru çerçeveyi seçmeyi unutmayın.
CAG’yi şu durumda tercih edin:
Sabit bilgi gereksinimleri: Rutin sorguları ele alan müşteri hizmetleri botları, yerleşik müfredata sahip eğitim platformları veya temel bilginin çok değişmediği iş akışı otomasyonları.
Tekrarlayıcı desenlere sahip yüksek sorgu hacimleri: Aynı 100 soruyu günde binlerce kez yanıtlıyorsanız, CAG’nin hız avantajı hızla katlanır.
Gecikmeye kritik duyarlılık: Gerçek zamanlı öneri sistemleri, etkileşimli oyun deneyimleri veya milisaniyelerin kullanıcı deneyimi için önemli olduğu her yer.
Gözlemlerime göre, sorgularınızın %90’ını öngörebiliyorsanız ve bilgi tabanınız nispeten sabitse, CAG idealdir.
Bunun pratikte nasıl işlediğini göstereyim. Farklı sektörlerdeki uygulamalarla çalıştım (ve inceledim) ve bazı net kalıplar ortaya çıktı. Üretimde gerçekten işe yarayanlar şunlar.
Analize sağlık sektöründen başlayalım; burada doğru ve zamanında bilgiye erişimin önemi özellikle yüksektir.
Sağlık uygulamalarında RAG sistemleri, en güncel tıbbi araştırmaları, tedavi protokollerini ve ilaç etkileşim bilgilerini getirerek klinik karar desteği sağlar. Sağlık profesyonelleri, modelin eğitim verilerinde yer almayabilecek güncel klinik kılavuzlara ve yeni çalışma bulgularına erişmekten fayda görür.
CAG sistemleri ise hız ve tutarlılığın hayati olduğu, yerleşik protokollere, hasta geçmişi özetlerine ve standart tanısal prosedürlere hızlı erişim gerektiren sağlık senaryolarında değerlidir.
Bana göre, sağlıkta hibrit yaklaşımlar için en net gerekçeyi görürsünüz: sabit protokoller için CAG, değişen her şey için RAG.
Finans da ilginç bir örnek. Buradaki gereksinimler sağlıktan tamamen farklıdır.
Finansal kurumlar; piyasa analizi, düzenleyici uyum izlemesi ve yatırım araştırması için RAG sistemlerini kullanır; burada gerçek zamanlı piyasa verilerine ve yakın tarihli düzenleyici değişikliklere erişim kritiktir. Bu sistemler, güncel piyasa içgörüleri sağlamak için finansal veritabanları ve haber akışlarıyla entegre olabilir.
Öte yandan CAG, standart finansal hesaplamalar, ürün tanımları ve yerleşik uyum prosedürleri gibi rutin sorgulara hızlı yanıt gerektiren finansal uygulamalarda öne çıkar.
Finansta sıklıkla kararın düzenleyici riske göre şekillendiğini gözlemledim. Yanlış olmanın, uyum cezalarında milyonlara mal olabileceği durumlarda ekipler RAG’ye yöneliyor.
Eğitim, hem RAG hem CAG için bir diğer verimli alan sunar.
Kişiselleştirilmiş öğrenme platformları çoğu zaman RAG’den fayda sağlar; çünkü öğrenciler yeni araştırma makaleleri, ders materyalleri veya öğrenme örnekleri olarak kullanılan güncel olaylar dâhil çeşitli ve sürekli güncellenen içeriğe ihtiyaç duyar. RAG ile bir AI eğitmen, orijinal eğitim setinin parçası olmayan doğru referanslar veya tamamlayıcı okumalar sunabilir.
Buna karşılık CAG, tekrar ve tutarlılığın kilit olduğu durumlarda iyi performans gösterir. Örneğin, bir platform düzenli kısa sınavlar, standart kavramların açıklamaları veya yapılandırılmış pratik oturumları sunuyorsa, önbellekleme geri bildirimlerin daha hızlı ve daha tutarlı verilmesini sağlar.
Bu şekilde eğitim sistemleri, taze içgörüleri temel bilginin güvenilir pekiştirmesiyle birleştirerek her iki tekniği de birlikte kullanır.
Yazılım dünyasına geçtiğimizde, geliştiricilerin üretkenliği artırmak için her iki yöntemi de giderek daha fazla benimsediğini görüyoruz.
RAG, geliştiricileri dokümantasyon, API özellikleri veya sorun giderme adımlarını haricî kaynaklardan getirerek destekler. Yazılım kütüphaneleri veya çerçeveleri hızla değişebildiğinden, RAG’in getirme katmanı yanıtların güncel kalmasını sağlamada öne çıkar.
CAG ise, kod tamamlama, hata ayıklama desteği veya tekrar eden geliştirici sorgularına yanıt verme gibi yoğun biçimde tekrarlanan etkileşimlere dayanan görevlerde rol oynar. Daha önce görülen desenleri önbelleğe alarak, CAG gecikmeyi azaltır ve geliştirme iş akışını hızlandırır.
Birlikte ele alındığında, bu yaklaşımlar mühendislerin hem daha hızlı hareket etmesini hem de doğru ve bağlama duyarlı rehberliğe güvenmesini sağlar.
Hukuk sektörü, bu yaklaşımların alanlara özgü zorlukları farklı bilgi erişim kalıplarıyla nasıl ele aldıklarına dair bir diğer ilgi çekici örnek sunar.
Hukuk profesyonelleri; en güncel sözleşme belgelerine ve hukuk içtihatlarına erişimin esas olduğu içtihat araştırması ve sözleşme incelemeleri için RAG sistemlerini kullanır. Bu sayede, yayınlanır yayınlanmaz en yeni mahkeme kararlarını ve düzenleyici değişiklikleri yansıtan hukuki danışmanlık sağlayabilirler.
Buna karşılık CAG, özellikle kuralların sabit ve sorguların tekrarlı olduğu iç uyum izleme ve otomatik politika uygulama için üstün bir tercihtir. Aynı “Rüşvetle Mücadele Kılavuzları”nı veya “GDPR Madde 15”i günde binlerce kez getirmek yerine, CAG sistemi bu statik düzenleyici çerçeveleri doğrudan modelin bağlamına önceden yükler.
Çekirdek “hakikat”in (hukukun) gün be gün nadiren değişmesi nedeniyle, bu bilginin önbelleğe alınması, standart uyum kontrolleri olan sorguların %90’ında getirme darboğazını ortadan kaldırır.
Perakende ve e-ticarette hız ve alaka düzeyi doğrudan müşteri deneyimini şekillendirir.
RAG sıklıkla gelişmiş ürün aramasını güçlendirmek, canlı stok verilerini entegre etmek ve dinamik öneriler sağlamak için kullanılır. Örneğin bir müşteri bir ürünün stokta olup olmadığını sorarsa, RAG destekli bir sistem gerçek zamanlı veritabanlarını kontrol ederek güncel yanıt verebilir.
CAG ise, kargo politikaları, iade kuralları veya sipariş durumu güncellemeleri gibi yaygın müşteri sorularına hızlı yanıt sağlar. Önbelleğe alınmış etkileşimleri yeniden kullanarak anında yanıt verir ve sunucu yükünü azaltır.
Birlikte kullanıldıklarında, RAG ve CAG hem doğruluk hem verimlilik sunan kesintisiz bir deneyim yaratır.
Buraya kadar RAG ve CAG’yi ayrı teknikler olarak ele aldık. Ancak pratikte pek çok kuruluş her iki yöntemi de entegre eden hibrit yaklaşımları benimsiyor. Bu kombinasyon, RAG’nin tazelik ve uyarlanabilirliği ile CAG’nin hız ve verimliliği arasında denge kurmalarını sağlıyor.
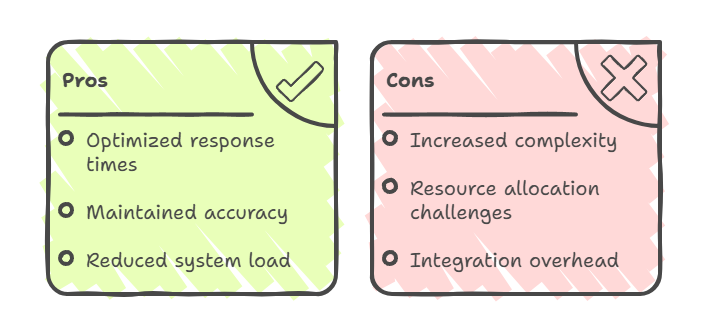
Hibrit Yaklaşımlar: Artılar ve Eksiler
Hibrit sistemler, bilgi entegrasyonunda bir sonraki evrimi temsil eder; RAG’nin dinamik getirme kabiliyetlerini CAG’nin verimlilik avantajlarıyla birleştirir.
Bu hibrit modellerde CAG genellikle sık erişilen, sabit bilgiler için; RAG ise gerçek zamanlı veri veya uzmanlık bilgisi gerektiren sorgular için kullanılır. Sonuç “iki dünyanın en iyisi”dir: yaygın sorgular için optimize edilmiş yanıt süreleri, dinamik içerik için korunan doğruluk ve akıllı yönlendirme yoluyla azalan toplam sistem yükü.
Bununla birlikte hibrit yaklaşımlar mimari karmaşıklığı artırır. Önbellekleme ve getirme sistemleri arasında sofistike bir orkestrasyon ve kaynak tahsisinde dikkatli bir denge gerektirirler.
Entegrasyon yükü; çift bilgi yolunun yönetilmesini, önbelleğe alınmış ve getirilen veriler arasında senkronizasyonun korunmasını ve her sorgu için hangi yöntemin kullanılacağına karar veren akıllı yönlendirme mantığının uygulanmasını içerir.
Hibrit bir çözüme gitmek istiyorsanız, gerçekten ne yaptığınızı biliyor olmanız gerekir.
Deneyimlerime göre, hibrit mimarilerin en yaygın benimsenmesi şu anda müşteri hizmetleri ekosistemlerinde görülüyor. CAG’nin yüksek hacimli, statik SSS’leri anında yanıtlamak için kullanıldığını; RAG’nin ise seçici biçimde canlı hesap ayrıntıları veya işlem geçmişini getirmek için devreye alındığını sıkça görüyorum.
Bir diğer klasik örnek araştırma uygulamalarında bulunabilir; burada CAG temel bilgiyi önbellekte tutarken, RAG yeni sorgular için en son yayınları veya dinamik verileri getirir. Benzer şekilde e-ticaret platformlarında CAG ürün açıklamalarını veya politikaları önbellekten sunarken, RAG gerçek zamanlı stok seviyeleri ve fiyat güncellemelerini entegre eder.
Açık konuşalım, burada herkese uyan tek bir doğru yok ve aksini söyleyen biri muhtemelen bir şey satmaya çalışıyordur. RAG ile CAG arasında seçim yapmak ya da bunları birleştirme kararı, nihayetinde özgül gereksinimlerinize, kısıtlarınıza ve hedeflerinize bağlıdır.
RAG, dinamik ve güncel bilgilere erişmeniz gerektiğinde, doğruluk ve tazelik karşılığında bir miktar gecikmeyi tolere edebildiğiniz senaryolarda öne çıkar. CAG ise hız ve tutarlılığın en çok önem taşıdığı ve bilgi gereksinimlerinizin nispeten sabit kaldığı durumlarda parlar.
Gelecekte, sorguları önbelleğe alınmış ve getirilen bilgi arasında akıllıca yönlendirerek hem performansı hem doğruluğu optimize eden daha sofistike hibrit yaklaşımlar göreceğiz.
RAG, CAG veya hibrit sistemleri tasarlayıp devreye almak için gereken tam yetkinliği kazanmak adına, kapsamlı Yapay Zekâ Mühendisi kariyer yolumuza kaydolmayı değerlendirin.
Üretken Yapay Zekâ Kursları
Kurs
Program
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



