Cours
Traitement d’images en Python
4 h
56.8K
Apprenez à travailler avec des LLM en Python directement dans votre navigateur
Au cœur des vision language models se trouve l’intégration de la vision par ordinateur et du traitement du langage naturel.
La vision par ordinateur vise à permettre aux machines d’interpréter et d’analyser des données visuelles, comme des images et des vidéos, en reconnaissant objets, motifs et autres éléments visuels.
Le traitement du langage naturel, lui, s’attache à comprendre et générer le langage humain, pour que les machines puissent appréhender, analyser et produire du texte.
Les VLM comblent l’écart entre ces deux domaines en créant des modèles capables de traiter et de comprendre simultanément des entrées visuelles et textuelles. Cela s’appuie sur des architectures de deep learning avancées, en particulier les transformeurs, qui ont largement contribué au succès des grands modèles de langage comme GPT-4o, Llama, Gemini et Gemma.
Ces architectures à base de transformeurs ont été adaptées pour gérer des entrées multimodales, permettant aux VLM de capter les relations complexes entre données visuelles et linguistiques.
Le modèle transformeur, initialement introduit pour des tâches de NLP, est devenu l’épine dorsale de nombreux systèmes d’IA avancés grâce à sa capacité à gérer les dépendances longues et à capturer le contexte dans les données.
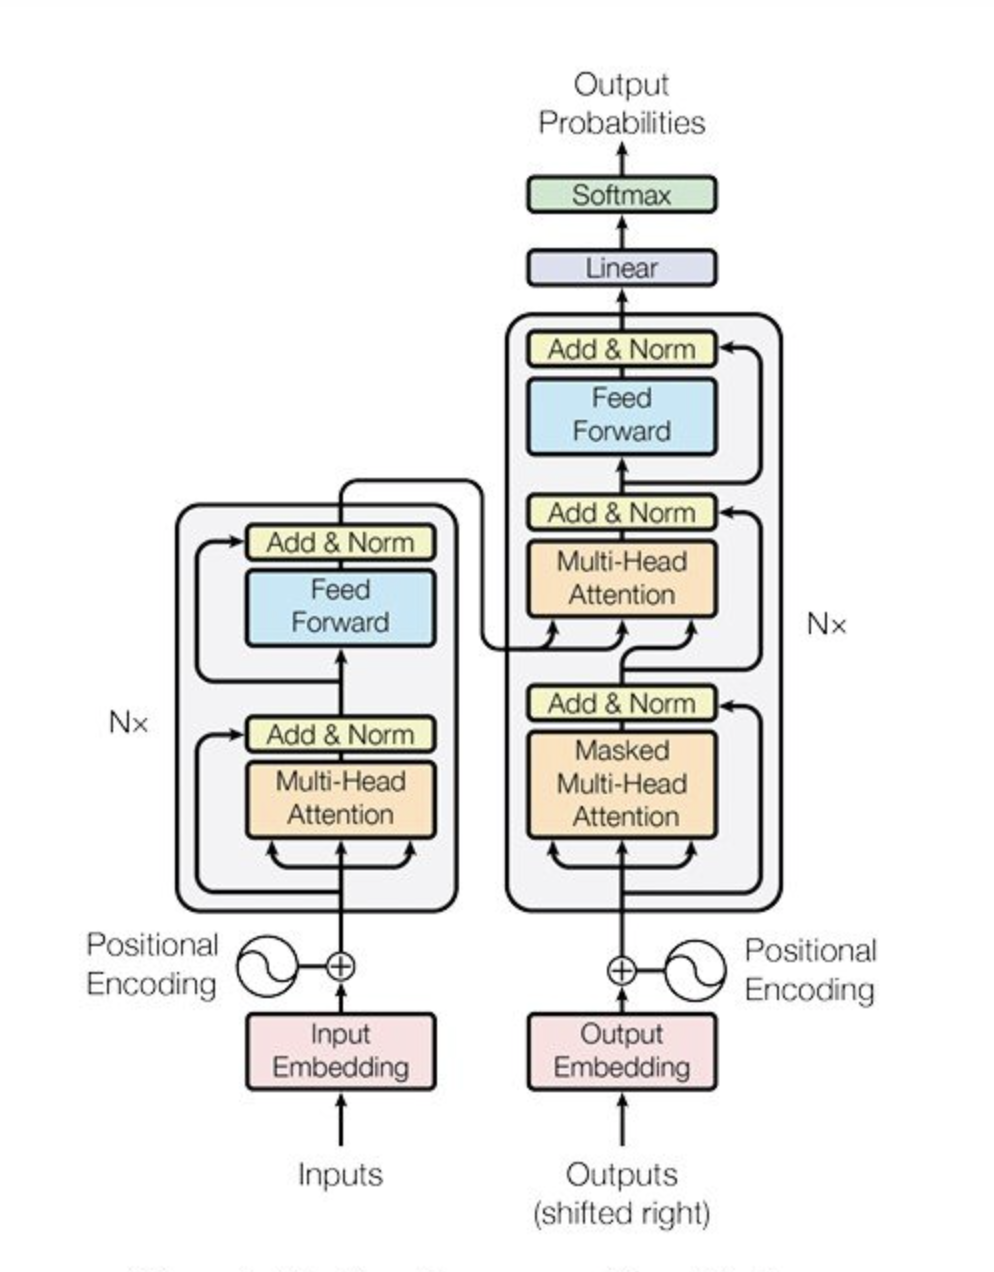
Source : Vaswani et al., 2017
Dans le cadre des VLM, les transformeurs ont été adaptés pour traiter simultanément images et texte, assurant une intégration fluide des deux modalités.
Une architecture VLM typique comprend deux composants principaux : un encodeur d’images et un décodeur de texte :
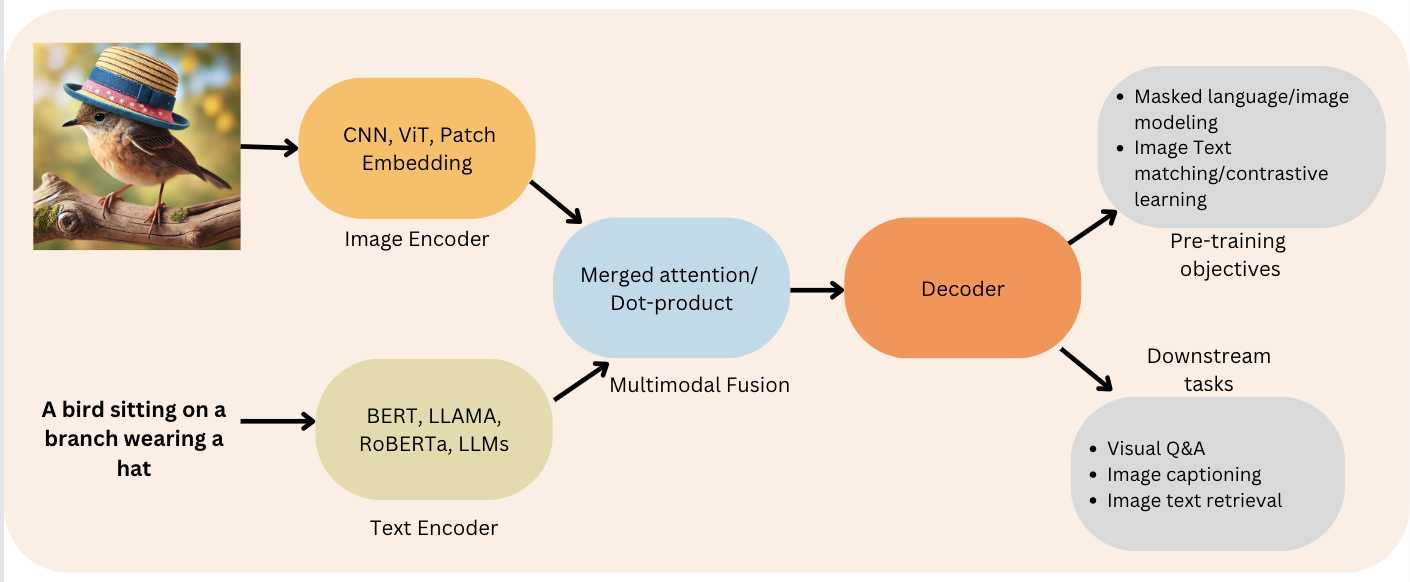
Figure 2 : fonction encodeur‑décodeur (Source : Viso.ai)
En combinant ces deux blocs, les VLM réalisent des prouesses : décrire finement des images, répondre à des questions sur ce qu’elles contiennent, voire générer de nouvelles images à partir d’une description textuelle. Le déroulé type comprend les étapes suivantes :
La plupart des VLM utilisent un Vision Transformer (ViT) comme encodeur d’images, préentraîné sur des jeux de données massifs afin de bien capter les caractéristiques visuelles nécessaires aux tâches multimodales.
Le décodeur de texte s’appuie sur un modèle de langage, affiné pour gérer les subtilités de la génération de texte dans un contexte visuel. Cette combinaison de traitements visuels et linguistiques avancés rend les VLM très polyvalents et puissants.
L’un des principaux défis est la nécessité de jeux de données vastes et diversifiés associant informations visuelles et textuelles. Ils sont essentiels pour entraîner les modèles à comprendre et générer du contenu multimodal.
L’entraînement d’un VLM consiste à fournir des paires image‑texte, afin que le modèle apprenne les relations fines entre éléments visuels et expressions linguistiques.
Pour traiter ces données, les VLM recourent souvent à des couches d’embrayage (embeddings) transformant les entrées visuelles et textuelles dans un espace de grande dimension, propice à la comparaison et à la combinaison.
Ce passage par des embeddings permet au modèle de relier les deux modalités et de générer des sorties cohérentes et pertinentes en contexte.
L’écosystème des vision language models (VLM) est foisonnant, avec de nombreux modèles open source disponibles sur le Hugging Face Hub. Ces modèles diffèrent par leur taille, leurs capacités et leurs licences, offrant un large choix selon les besoins. Voici un aperçu de quelques VLM open source majeurs, avec leurs caractéristiques clés :
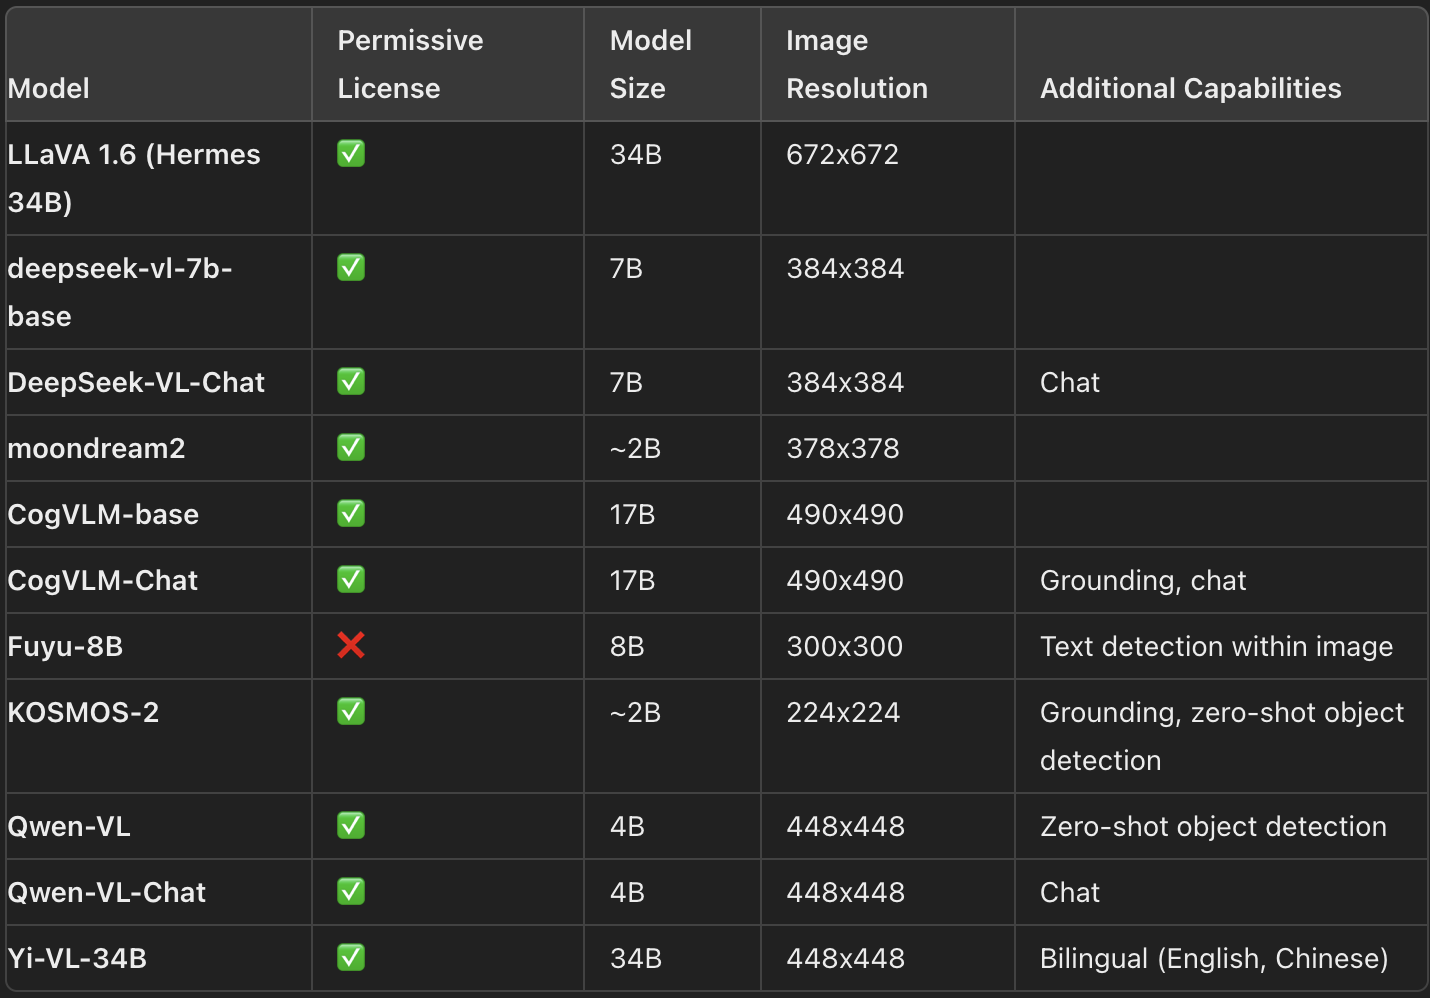
Derniers VLM et leurs fonctionnalités clés (Source : HuggingFace)
Choisir le VLM le plus adapté à votre cas d’usage peut s’avérer complexe, au vu du nombre d’options. Plusieurs outils et ressources peuvent vous aider :
Si Vision Arena et l’Open VLM Leaderboard apportent des insights précieux, ils restent limités aux modèles soumis et nécessitent des mises à jour régulières pour intégrer les nouveautés.
Plusieurs benchmarks sont couramment utilisés pour évaluer les performances des VLM :
Le préentraînement des VLM consiste à unifier les représentations d’images et de texte pour les injecter dans un décodeur textuel en vue de la génération. La structure type comprend un encodeur d’images, un projecteur d’embeddings pour aligner images et texte, et un décodeur de texte. Les stratégies de préentraînement varient toutefois selon les modèles.
Dans bien des cas, le préentraînement n’est pas indispensable si vous pouvez affiner des modèles existants pour votre cas d’usage. Des outils comme Transformers et SFTTrainer simplifient l’affinage pour des tâches spécifiques, même avec des ressources limitées.
Voici une implémentation HuggingFace pour utiliser le VLM open source LlavaNext gratuitement sur Colab ou en local avec la bibliothèque Transformers de HuggingFace.
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf",
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True
)
model.to(device)Les capacités des vision language models vont bien au‑delà de la simple légende d’images. Ils ouvrent la voie à de nombreux usages tirant parti de leur aptitude à relier information visuelle et textuelle. Passons en revue les applications les plus marquantes dans différents secteurs.
Le Visual Question Answering (VQA) consiste à répondre à des questions sur le contenu d’une image.
Cette application requiert de comprendre à la fois les éléments visuels de l’image et le contexte linguistique de la question. Par exemple, face à une photo d’un centre‑ville animé, un VLM peut répondre : « Quelle est la couleur du plus haut bâtiment ? » ou « Combien de personnes sont visibles ? »
Le VQA a de nombreuses applications concrètes, notamment dans les secteurs où la donnée visuelle est critique. En santé, par exemple, il peut analyser des images médicales et apporter des réponses utiles au diagnostic et à la planification des soins. En retail, il enrichit l’expérience d’achat en permettant d’interagir avec les visuels produits de manière naturelle et intuitive.
L’une des capacités les plus enthousiasmantes est la génération d’images à partir d’une description textuelle. Par exemple : « Un coucher de soleil serein sur une chaîne de montagnes avec une rivière traversant la vallée ». Le VLM peut produire une image correspondante.
Ce procédé a un fort potentiel en création, design et publicité. Designers et annonceurs peuvent générer rapidement des pistes visuelles alignées sur des messages marketing précis.
La recherche d’images consiste à retrouver des visuels pertinents à partir d’une requête textuelle. Les VLM excellent sur cette tâche grâce à leur compréhension conjointe du contenu des images et du contexte de la requête.
Cette capacité rend les moteurs de recherche plus puissants et précis, pour trouver plus facilement l’image exacte recherchée.
Les applications vont de l’e‑commerce à l’analyse d’imagerie médicale. En e‑commerce, la recherche d’images aide à retrouver des produits selon des critères visuels et textuels. En santé, elle facilite l’accès à des images pertinentes pour la recherche ou le diagnostic.
Au‑delà des images, les VLM peuvent aussi analyser et générer des légendes pour des vidéos. La compréhension de vidéos consiste à analyser leur contenu visuel et à générer un texte descriptif reflétant l’essentiel des scènes.
Les usages incluent la recherche vidéo, le résumé automatique et la modération de contenu. En recherche, un VLM peut retrouver des séquences à partir de requêtes textuelles. En résumé, il peut condenser de longues vidéos pour en faciliter la compréhension rapide. En modération, il aide à détecter des contenus inappropriés, pour des plateformes plus sûres et agréables.
Passons maintenant aux défis associés aux VLM, ainsi qu’aux enjeux éthiques.
L’entraînement et le déploiement de VLM nécessitent d’importantes ressources de calcul, en particulier pour les grands modèles comme PaliGemma. Cela peut constituer un frein pour les organisations ne disposant pas d’infrastructures de calcul haute performance.
Pour y remédier, la recherche explore des pistes d’optimisation : compression de modèles, architectures plus efficientes, et recours à des accélérateurs matériels (GPU, TPU).
Le développement des VLM soulève des préoccupations éthiques, notamment quant aux biais potentiels dans les sorties du modèle. Entraînés sur des données image‑texte à grande échelle et issues du monde réel, les VLM peuvent refléter des biais socioculturels présents dans les données. Ceux‑ci peuvent conduire à des contenus préjudiciables ou offensants.
Pour limiter ces risques, différentes techniques d’atténuation sont mises en œuvre : jeux de données équilibrés, algorithmes sensibles à l’équité, évaluations rigoureuses des sorties pour repérer et corriger les biais.
Par ailleurs, des organisations comme Google appliquent des filtres de sûreté des contenus afin de garantir des données d’entraînement propres et dépourvues de contenus nuisibles pour des modèles comme PaliGemma.
Un autre enjeu clé tient à la protection des données et à la sécurité. Les VLM exigent souvent de grands volumes de données, potentiellement sensibles. Leur traitement sécurisé et conforme aux réglementations est crucial pour préserver la confiance des utilisateurs et des parties prenantes.
Pour répondre à ces enjeux, des approches comme l’apprentissage fédéré sont explorées : les modèles sont entraînés sur des données décentralisées, sans transfert d’informations sensibles vers un serveur central.
En complément, des mesures de responsabilité des données, comme le filtrage d’informations personnelles et sensibles dans les jeux d’entraînement, sont mises en place pour protéger la vie privée.
Les vision language models marquent une avancée majeure en IA, avec le potentiel d’enrichir de nombreuses applications grâce à leur capacité à traiter des données visuelles et textuelles.
À mesure que la recherche progresse, on peut s’attendre à des VLM toujours plus sophistiqués, capables de tâches complexes et générateurs d’insights précieux.
L’intégration de la compréhension visuelle et textuelle ouvre de nouvelles perspectives d’innovation, faisant des VLM un champ prometteur pour la recherche et le développement.
Formez-vous à l’IA avec ces cours !
Cours
Cours
Cours