
VLM Nedir?
Görsel dil modellerinin temelinde bilgisayarlı görü ile doğal dil işlemenin entegrasyonu yer alır.
Bilgisayarlı görü; nesneleri, desenleri ve diğer görsel öğeleri tanıyarak görüntüler ve videolar gibi görsel verileri yorumlayıp analiz etmeyi makineler için mümkün kılmaya odaklanır.
Öte yandan doğal dil işleme; makinelerin metni kavramasını, analiz etmesini ve üretmesini sağlayarak insan dilini anlama ve üretmeyle ilgilenir.
VLM'ler, görsel ve metinsel girdileri aynı anda işleyip anlayabilen modeller oluşturarak bu iki alan arasındaki boşluğu kapatır. Bu, özellikle büyük dil modellerinin başarısında kritik rol oynayan derin öğrenme mimarileri, özellikle de GPT-4o, Llama, Gemini ve Gemma gibi modellerin başarısında kilit olan dönüştürücü modellere dayalı gelişmiş mimariler sayesinde mümkün olur.
Bu dönüştürücü tabanlı mimariler, çok modlu girdileri işleyecek şekilde uyarlanmıştır; bu da VLM'lerin görsel ve dilsel veriler arasındaki karmaşık ilişkileri yakalamasını sağlar.
VLM'ler Nasıl Çalışır?
Başlangıçta NLP görevleri için tanıtılan dönüştürücü model, uzun menzilli bağımlılıkları ele alma ve verideki bağlamsal ilişkileri yakalama yeteneği sayesinde birçok gelişmiş yapay zeka sisteminin bel kemiği haline gelmiştir.
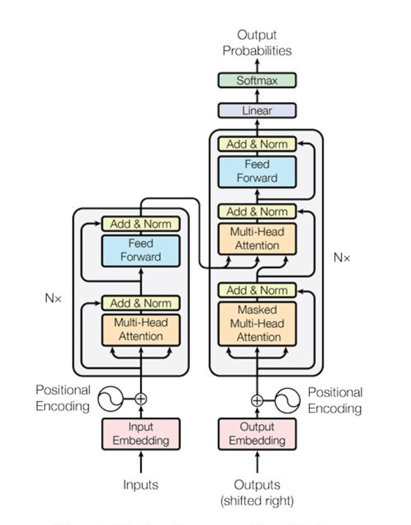
Kaynak: Vaswani ve ark., 2017
VLM bağlamında dönüştürücüler, hem görüntüleri hem de metni işleyecek şekilde uyarlanmış ve bu iki modalitenin sorunsuz entegrasyonuna olanak tanımıştır.
Tipik bir VLM mimarisi iki ana bileşenden oluşur: bir görüntü kodlayıcı ve bir metin kod çözücü:
- Görüntü kodlayıcı: Görsel verileri işler, özellikleri (nesneler, renkler, dokular vb.) çıkarır ve modeli anlayabileceği bir formata dönüştürür.
- Metin kod çözücü: Metinsel verileri işler ve kodlanmış görsel özelliklere dayanarak çıktı üretir.
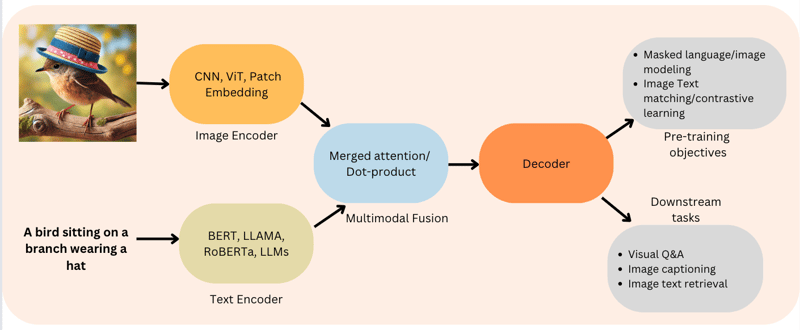
Şekil 2: Kodlayıcı-Kod Çözücü işlevi (Kaynak: Viso.ai)
Bu iki parçayı birleştirerek VLM'ler, görüntüleri ayrıntılı biçimde tanımlamak, gördükleriyle ilgili soruları yanıtlamak ve hatta metinsel açıklamalara dayalı yeni görüntüler üretmek gibi etkileyici işler yapabilir! VLM'lerin izlediği süreç şu adımlardan oluşur:
- Görüntü analizi: Görüntü kodlayıcı, görüntüyü inceler ve temel görsel özelliklerini temsil eden bir kod oluşturur.
- Bilginin birleştirilmesi: Metin kod çözücü bu kodu alır, varsa metin girdisiyle (ör. bir soru) birleştirir ve hepsini birlikte işler.
- Çıktı üretimi: Metin kod çözücü daha sonra bu birleşik anlayışı kullanarak, görüntüyü betimleyen bir altyazı ya da soruya verilen bir yanıt gibi bir çıktı üretir.
VLM'lerin çoğu, görüntü kodlayıcı olarak Vision Transformer (ViT) kullanır; bu yapı, çok büyük ölçekli görüntü veri kümeleri üzerinde önceden eğitilmiştir ve çok modlu görevler için gerekli görsel özellikleri etkili bir şekilde yakalayabilir.
Metin kod çözücü, görsel veri bağlamında dil üretiminin inceliklerini ele alacak şekilde ince ayar uygulanmış bir dil modeline dayanır. Gelişmiş görsel ve dilsel işleme yeteneklerinin bu kombinasyonu, VLM'leri son derece çok yönlü ve güçlü kılar.
VLM geliştirmedeki en önemli zorluklardan biri, hem görsel hem de metinsel bilgi içeren büyük ve çeşitli veri kümelerine duyulan ihtiyaçtır. Bu veri kümeleri, modellerin çok modlu içeriği anlaması ve üretmesi için eğitilmesinde kritik öneme sahiptir.
Bir VLM'i eğitme süreci, modele görüntüler ve bunların karşılık gelen metinsel açıklamaları çiftleri verilmesini içerir; böylece model, görsel öğeler ile dilsel ifadeler arasındaki karmaşık ilişkileri öğrenir.
Bu veriyi işlemek için VLM'ler sıklıkla, hem görsel hem de metinsel girdileri karşılaştırılabilecek ve birleştirilebilecekleri yüksek boyutlu bir uzaya dönüştüren gömme (embedding) katmanları kullanır.
Bu gömme süreci, modelin iki modalite arasındaki bağlantıları anlamasını ve tutarlı, bağlamsal olarak uygun çıktılar üretmesini sağlar.
Açık Kaynak Görsel Dil Modellerine Genel Bakış
Görsel dil modelleri (VLM'ler) alanı geniştir ve Hugging Face Hub üzerinde çok sayıda açık kaynak model mevcuttur. Bu modeller boyut, yetenek ve lisans açısından farklılık gösterir; böylece farklı uygulamalara yönelik bir dizi seçenek sunar. Aşağıda, başlıca açık kaynak VLM'lerden bazılarının temel özelliklerini öne çıkaran bir genel bakış yer almaktadır:
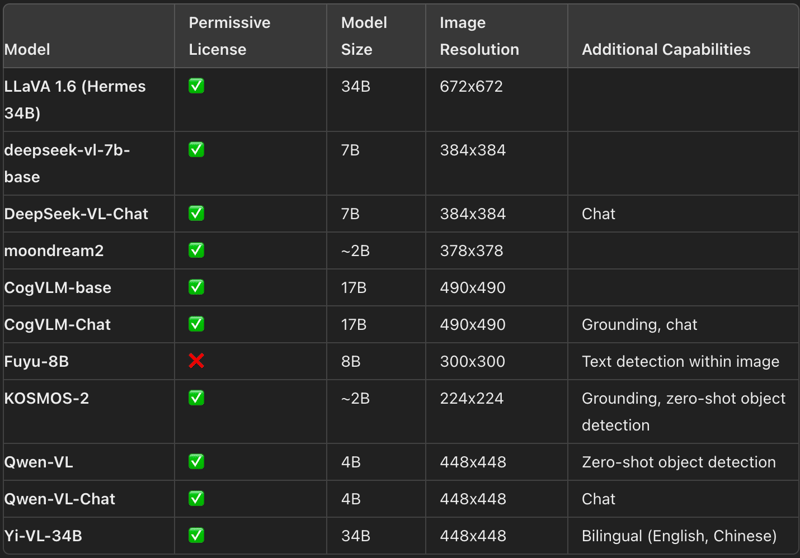
En yeni VLM'ler ve temel özellikleri (Kaynak: HuggingFace)
Mevcut seçeneklerin çeşitliliği göz önüne alındığında, belirli kullanım senaryonuz için en uygun VLM'i seçmek zor olabilir. Bu seçim sürecine yardımcı olabilecek çeşitli araçlar ve kaynaklar mevcuttur:
- Vision Arena: Model çıktılarının anonim oylanmasına dayalı dinamik bir liderlik tablosu. Kullanıcılar bir görüntü ve bir istem girer; iki farklı modelden çıkanlar anonim olarak örneklenir ve kullanıcılar tercih ettikleri çıktıyı seçer. Böylece liderlik tablosu tamamen insan tercihlerine göre oluşturulup modellerin tarafsız bir sıralamasını sağlar.
- Open VLM Leaderboard: Bu liderlik tablosu, çeşitli metrikler ve ortalama puanlara göre farklı VLM'leri sıralar; modelleri boyut, lisans ve farklı metriklerdeki performansa göre filtreleme olanağı sunar.
- VLMEvalKit: Open VLM Leaderboard'u besleyen ve VLM'ler üzerinde kıyaslamalar çalıştırmak için tasarlanmış bir araç takımıdır. Bir diğer değerlendirme paketi olan LMMS-Eval, Hub üzerinde barındırılan veri kümelerini kullanarak Hugging Face modellerini değerlendirmek için komut satırı arayüzü sunar.
Hem Vision Arena hem de Open VLM Leaderboard değerli içgörüler sunsa da, gönderilmiş modellerle sınırlıdır ve yeni modelleri dahil etmek için düzenli güncellemeler gerektirir.
VLM'leri Değerlendirmeye Yönelik Kıyaslamalar
VLM'lerin performansını değerlendirmek için yaygın olarak kullanılan birkaç kıyaslama vardır:
- MMMU: Massive Multi-discipline Multimodal Understanding and Reasoning, sanat ve mühendislik gibi disiplinlerde üniversite düzeyinde bilgi gerektiren 11,5 bin çok modlu meydan okumayı kapsayan kapsamlı bir değerlendirme aracıdır.
- MMBench: OCR ve nesne konumlandırma dahil 20 farklı beceride 3.000 tek şıklı sorudan oluşur. Burada seçeneklerin karıştırıldığı ve modelin doğru cevabı tutarlı şekilde seçmesi gereken CircularEval stratejisi kullanılır.
- Alan Odaklı Kıyaslamalar: MathVista (görsel matematiksel akıl yürütme), AI2D (diyagram anlama), ScienceQA (bilimsel soru yanıtlama) ve OCRBench (belge anlama) gibi diğer kıyaslamalar daha uzmanlaşmış değerlendirmeler sağlar.
Teknik Ayrıntılar: VLM'lerin Ön Eğitimi
VLM'leri ön eğitmek, görüntü ve metin temsillerini birleştirip üretim için bir metin kod çözücüye beslemeyi içerir. Yapı genellikle bir görüntü kodlayıcı, görüntü ve metin temsillerini hizalamak için bir gömme dönüştürücü (projector) ve bir metin kod çözücü içerir. Ancak farklı modeller, farklı ön eğitim stratejileri kullanır.
Pek çok durumda, mevcut modelleri belirli kullanım senaryonuza göre ince ayar yapabiliyorsanız bir VLM'i baştan ön eğitmek bile gerekli değildir. Transformers ve SFTTrainer gibi araçlar, modelleri belirli görevlere uyarlama sürecini sadeleştirir ve sınırlı kaynağa sahip olanlar için bile erişilebilir kılar.
Açık kaynak VLM'leri uygulamak
Aşağıda, HuggingFace'in Transformers kütüphanesiyle, açık kaynak VLM LlavaNext modelini Colab ya da yerel makinenizde ücretsiz kullanmak için bir HuggingFace uygulaması yer almaktadır.
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
"llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
"llava-hf/llava-v1.6-mistral-7b-hf",
torch_dtype=torch.float16,
low_cpu_mem_usage=True
)
model.to(device)VLM'lerin Uygulamaları
Görsel dil modellerinin yetenekleri, görsel altyazı üretiminin çok ötesine uzanır. VLM'ler, görsel ve metinsel bilgi arasındaki boşluğu kapatma becerilerini kullanan birçok uygulamaya kapı aralamıştır. Farklı sektörlerde VLM'lerin en etkili uygulamalarından bazılarını inceleyelim.
Görsel soru yanıtlama
Görsel soru yanıtlama (VQA), bir görüntünün içeriği hakkında sorulan soruları yanıtlamayı içeren bir görevdir.
Bu uygulama, modelin hem görüntüdeki görsel öğeleri hem de sorunun dilsel bağlamını anlamasını gerektirir. Örneğin, hareketli bir şehir manzarası görüntüsü verildiğinde, bir VLM "En yüksek binanın rengi nedir?" veya "Görüntüde kaç kişi görünüyor?" gibi soruları yanıtlayabilir.
VQA'nın özellikle görsel verilerin kritik rol oynadığı sektörlerde çok sayıda pratik uygulaması vardır. Örneğin sağlık hizmetlerinde, tıbbi görüntüleri analiz etmek ve tanı ile tedavi planlamasına yardımcı olacak sorulara yanıtlar üretmek için VQA kullanılabilir. Perakendede ise, müşterilerin ürün görselleriyle daha doğal ve sezgisel biçimde etkileşim kurmasını sağlayarak alışveriş deneyimini iyileştirebilir.
Metinden görsele üretim
VLM'lerin en heyecan verici yeteneklerinden biri metinden görsele üretimdir. Bu görev, metinsel bir açıklamaya dayalı olarak bir sahnenin veya nesnenin görsel bir temsilini üretmeyi içerir. Örneğin, bir VLM "Vadi boyunca akan bir nehirle dağ sıraları üzerinde dingin bir gün batımı" gibi bir istemi alıp buna karşılık gelen bir görüntü üretebilir.
Metinden görsele üretim, tasarım ve reklamcılık gibi yaratıcı alanlarda büyük potansiyele sahiptir. Tasarımcılar ve reklamcılar, bu teknolojiyi metinsel istemlere dayalı olarak görsel fikirleri hızla oluşturmak için kullanabilir. Metinden görsele üretim, belirli pazarlama mesajlarıyla uyumlu görsel içerik oluşturma sürecini kolaylaştırabilir.
Görüntü getirme (image retrieval)
Görüntü getirme, metinsel bir sorguya dayalı olarak ilgili görüntülerin bulunması sürecidir. VLM'ler, hem görüntülerin görsel içeriğini hem de sorgunun dilsel bağlamını anlama yetenekleri sayesinde bu görevde üstün performans gösterir.
Bu yetenek, arama motorlarını daha güçlü ve daha isabetli hale getirir; kullanıcıların, aradıkları görüntüleri çok daha kolay şekilde bulmalarına olanak tanır.
Görüntü getirme, e-ticaretten tıbbi görüntü analizine kadar çeşitli alanlarda uygulama bulur. E-ticarette, görsel ve metinsel açıklamalara dayalı olarak müşterilerin tercihlerine uyan ürünleri bulmalarına yardımcı olabilir. Sağlık hizmetlerinde ise, araştırma veya tanı amaçları için ilgili tıbbi görüntüleri bulmada sağlık profesyonellerine yardımcı olabilir.
Video anlama
Yukarıdaki örnekler görüntülere odaklansa da, VLM'ler videoları anlamak ve onlar için altyazılar üretmek üzere de genişletilebilir. Video anlama, bir videonun görsel içeriğini analiz etmeyi ve betimlenen sahnelerin özünü yakalayan açıklayıcı metinler üretmeyi içerir.
Video anlama; video arama, özetleme ve içerik denetimi gibi uygulamalarda kullanılabilir. Video aramada, VLM'ler kullanıcıların metinsel sorgulara dayalı belli video kliplerini bulmasına yardımcı olabilir. Özetleme görevlerinde, uzun videoların özlü özetlerini üreterek kullanıcıların içeriği hızlıca kavramasını sağlayabilir. İçerik denetiminde ise, uygunsuz veya zararlı içerikleri tespit etmeye yardımcı olarak platformların güvenli ve kullanıcı dostu kalmasına katkıda bulunabilir.
Zorluklar ve dikkat edilmesi gerekenler
Şimdi de VLM'lerle ilişkili zorlukları ve etik yönleri ele alalım.
Hesaplama gereksinimleri
VLM'leri eğitmek ve dağıtmak, özellikle PaliGemma gibi büyük modeller için önemli hesaplama kaynakları gerektirir. Bu durum, yüksek performanslı bilişim altyapısına sınırlı erişimi olan kuruluşlar için engel teşkil edebilir.
Bu zorluğun üstesinden gelmek için araştırmacılar; model sıkıştırma tekniklerinin kullanılması, model mimarisinin optimize edilmesi ve GPU ile TPU gibi donanım hızlandırıcılarının kullanılması gibi VLM'leri daha verimli hale getirme yollarını araştırmaktadır.
Etik hususlar ve önyargıların azaltılması
VLM'lerin geliştirilmesi, özellikle model çıktılarında önyargı potansiyeli etrafında çeşitli etik endişeler doğurur. Gerçek dünyadan, büyük ölçekli görüntü-metin verisiyle eğitilen VLM'ler, eğitim materyaline gömülü sosyo-kültürel önyargıları yansıtabilir. Bu önyargılar model çıktılarında kendini göstererek zararlı veya saldırgan içeriklere yol açabilir.
Bu endişeleri gidermek için araştırmacılar; dengeli eğitim veri kümeleri kullanmak, adalet odaklı öğrenme algoritmalarını entegre etmek ve potansiyel önyargıları belirleyip ele almak için model çıktılarının titiz değerlendirmelerini yürütmek gibi çeşitli önyargı azaltma tekniklerini uygulamaktadır.
Ayrıca Google gibi kuruluşlar, PaliGemma gibi modeller için kullanılan eğitim verisinin temiz ve zararlı içerikten arındırılmış olmasını sağlamak amacıyla içerik güvenliği filtreleri uygulamaktadır.
Gizlilik ve veri güvenliği
VLM'lerin geliştirilmesinde bir diğer önemli husus gizlilik ve veri güvenliğidir. VLM'ler sıklıkla, potansiyel olarak hassas bilgiler de dahil olmak üzere büyük miktarda veriye erişim gerektirir. Bu verilerin güvenli bir şekilde ve gizlilik düzenlemelerine uygun olarak işlenmesini sağlamak, kullanıcıların ve paydaşların güvenini korumak açısından kritiktir.
Gizlilik endişelerini gidermek için araştırmacılar, hassas bilgilerin merkezi bir sunucuya aktarılmasına gerek kalmadan modellerin merkezsiz veriler üzerinde eğitilmesini sağlayan federatif öğrenme gibi teknikleri araştırmaktadır.
Ayrıca Google gibi kuruluşlar, eğitim veri kümelerinden kişisel bilgi ve hassas verileri filtrelemek gibi veri sorumluluğu önlemleri uygulayarak bireylerin mahremiyetini korumaktadır.
Sonuç
Görsel dil modelleri, hem görsel hem de metinsel verileri işleme yetenekleri sayesinde çeşitli uygulamaları geliştirme potansiyeli sunarak yapay zekada önemli bir ilerlemeyi temsil eder.
Bu alandaki araştırmalar ilerledikçe, karmaşık görevleri gerçekleştirebilen ve değerli içgörüler sağlayabilen daha sofistike VLM'lerin geliştirildiğine tanık olabiliriz.
Görsel ve metinsel anlamanın entegrasyonu, yenilik için yeni olanaklar açar ve VLM'leri umut vadeden bir araştırma ve geliştirme alanı haline getirir.

GenAI ve veri bilimi üzerine bilgi paylaşarak 20 milyon görüntüleme elde etmiş Kıdemli GenAI Mühendisi ve İçerik Üreticisi.



Doğal dil işleme (NLP) ve bilgisayarlı görü (CV) son yıllarda önemli ölçüde ilerledi ve makinelerin hem metni hem de görselleri anlamasını sağladı. Bu alanların entegrasyonu, hem görsel hem de metinsel verileri işleyip anlayabilen görsel dil modellerinin (VLM) geliştirilmesine yol açtı.
VLM'ler, görsel altyazı üretimi, görsel soru yanıtlama ve metinden görsele üretim gibi hem görüntüleri hem de metni içeren görevleri yerine getirebilen yeni bir yapay zeka modeli sınıfını temsil eder. Bu görevler daha önce ayrı, uzmanlaşmış sistemler gerektiriyordu; VLM'ler ise birleşik bir yaklaşım sunar. Gelin, görsel dil modelleri hakkında daha fazla bilgi edinelim.