कोर्स
Python में इमेज प्रोसेसिंग
4 घंटा
56.9K
विज़न लैंग्वेज मॉडलों के केंद्र में कंप्यूटर विज़न और नेचुरल लैंग्वेज प्रोसेसिंग का एकीकरण होता है।
कंप्यूटर विज़न का उद्देश्य मशीनों को इमेज और वीडियो जैसे दृश्य डेटा की व्याख्या और विश्लेषण करने में सक्षम बनाना है, जिसमें ऑब्जेक्ट्स, पैटर्न और अन्य दृश्य तत्वों की पहचान शामिल है।
दूसरी ओर, नेचुरल लैंग्वेज प्रोसेसिंग मानव भाषा को समझने और उत्पन्न करने से संबंधित है, जिससे मशीनें टेक्स्ट को समझ, विश्लेषित और तैयार कर सकती हैं।
VLMs इन दो क्षेत्रों के बीच की खाई को पाटते हैं, ऐसे मॉडल बनाकर जो एक साथ दृश्य और पाठ्य इनपुट्स को प्रोसेस और समझ सकें। यह उन्नत डीप लर्निंग आर्किटेक्चर, खासकर ट्रांसफॉर्मर मॉडलों के माध्यम से हासिल किया जाता है, जो GPT-4o, Llama, Gemini और Gemma जैसे बड़े भाषा मॉडलों की सफलता में सहायक रहे हैं।
इन ट्रांसफॉर्मर-आधारित आर्किटेक्चर को मल्टीमॉडल इनपुट को संभालने के लिए अनुकूलित किया गया है, जिससे VLMs दृश्य और भाषायी डेटा के बीच जटिल संबंधों को कैप्चर कर सकें।
ट्रांसफॉर्मर मॉडल, जिसे मूल रूप से NLP कार्यों के लिए प्रस्तुत किया गया था, डेटा में लंबी-अवधि की निर्भरताओं और प्रसंगगत संबंधों को संभालने की क्षमता के कारण कई उन्नत एआई सिस्टम्स की रीढ़ बन गया है।
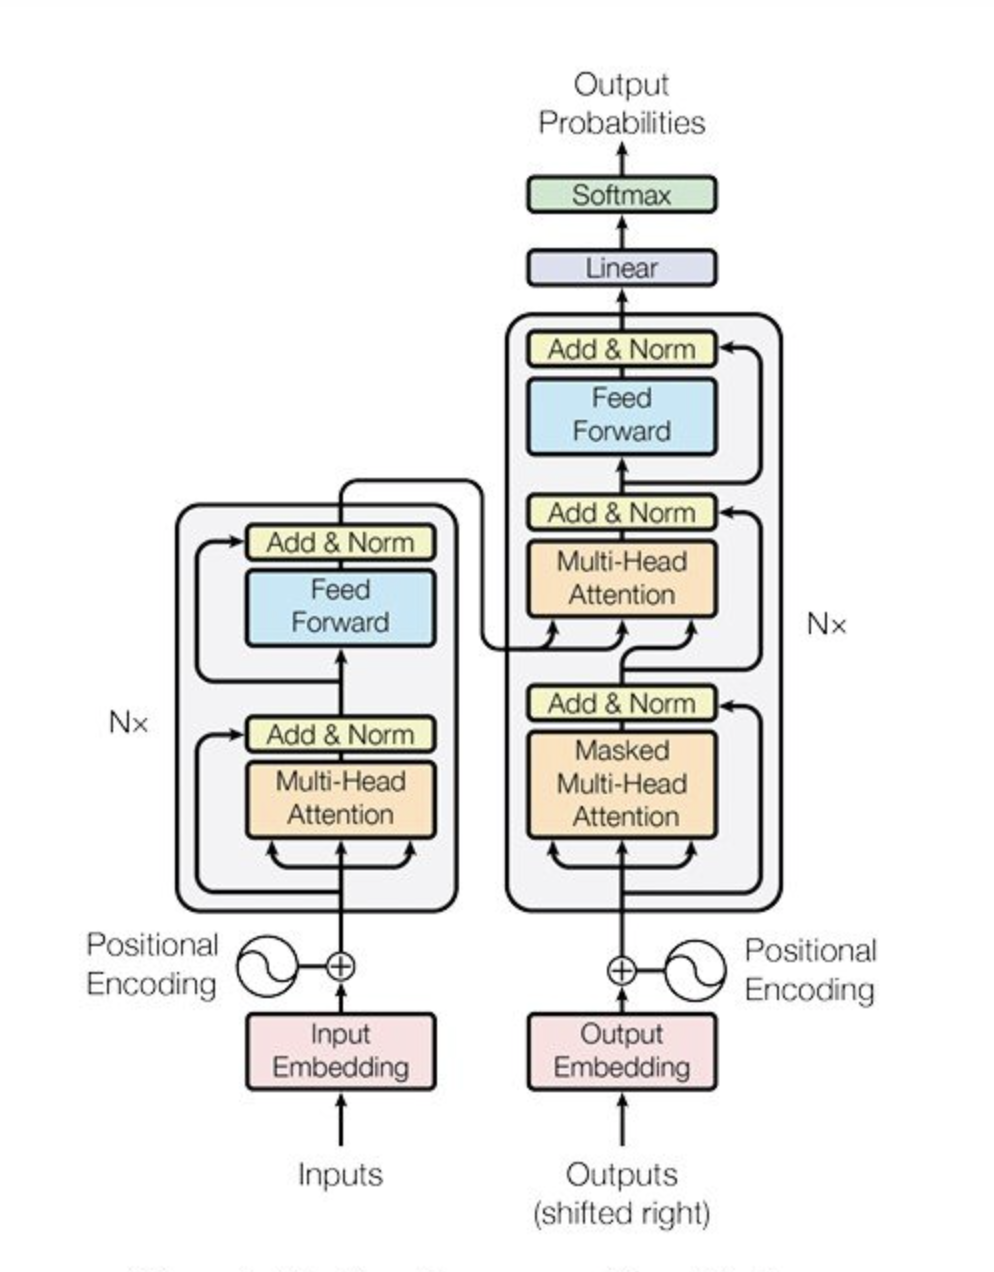
स्रोत: Vaswani et al., 2017
VLMs के संदर्भ में, ट्रांसफॉर्मर को इमेज और टेक्स्ट दोनों को प्रोसेस करने के लिए अनुकूलित किया गया है, जिससे इन दोनों मॉडेलिटीज़ का सहज एकीकरण संभव हो सके।
एक सामान्य VLM आर्किटेक्चर में दो मुख्य घटक होते हैं: एक इमेज एन्कोडर और एक टेक्स्ट डिकोडर:
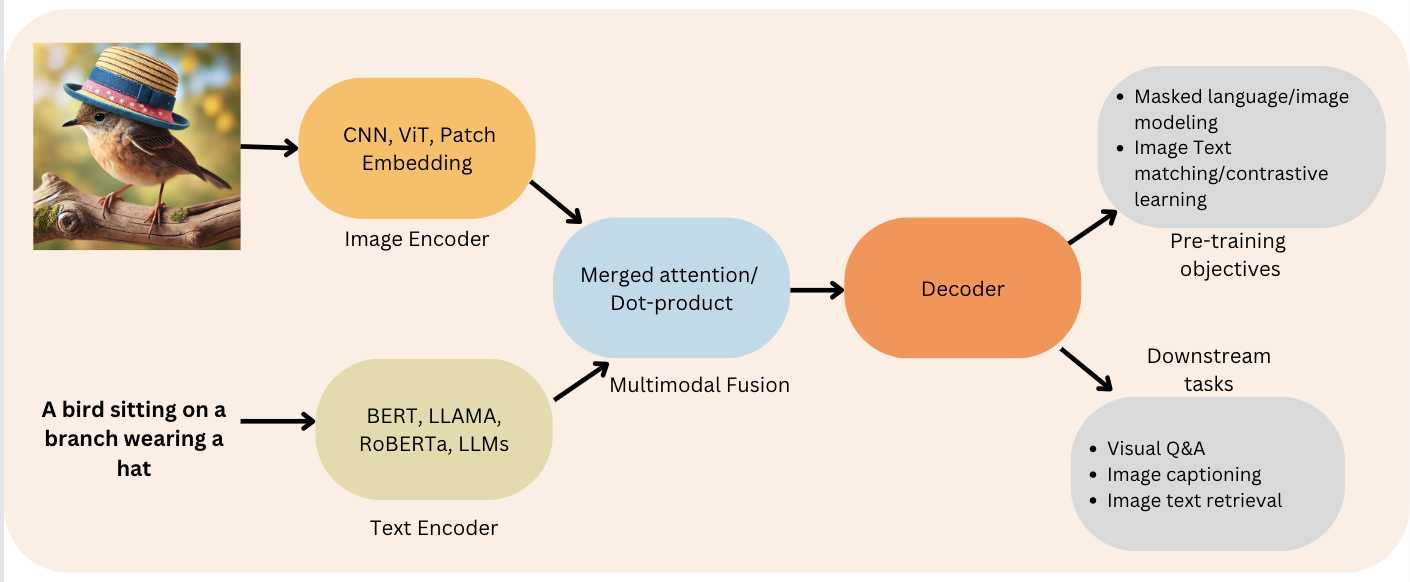
चित्र 2: एन्कोडर-डिकोडर फंक्शन (स्रोत: Viso.ai)
इन दोनों हिस्सों को मिलाकर, VLMs अद्भुत काम कर सकते हैं—जैसे इमेज का विस्तार से वर्णन करना, जो वे देखते हैं उस पर प्रश्नों के उत्तर देना, और टेक्स्ट विवरणों के आधार पर नई इमेज तक जनरेट करना! VLMs निम्नलिखित चरणों का पालन करते हैं:
अधिकांश VLMs अपने इमेज एन्कोडर के रूप में विज़न ट्रांसफॉर्मर (ViT) का उपयोग करते हैं, जिसे बड़े पैमाने के इमेज डेटासेट्स पर प्री-ट्रेन किया जाता है ताकि वह मल्टीमॉडल कार्यों के लिए आवश्यक दृश्य फीचर्स को प्रभावी ढंग से कैप्चर कर सके।
टेक्स्ट डिकोडर एक भाषा मॉडल पर आधारित होता है, जिसे दृश्य डेटा के संदर्भ में भाषा जनरेशन की जटिलताओं को संभालने के लिए फाइन-ट्यून किया गया है। उन्नत दृश्य और भाषायी प्रोसेसिंग क्षमताओं का यह संयोजन VLM को अत्यधिक बहुमुखी और शक्तिशाली बनाता है।
VLMs के विकास में सबसे बड़ी चुनौतियों में से एक ऐसी बड़ी और विविध डेटासेट्स की आवश्यकता है जिनमें दृश्य और पाठ्य दोनों जानकारी हो। ये डेटासेट्स मॉडलों को मल्टीमॉडल सामग्री को समझने और उत्पन्न करने के लिए प्रशिक्षित करने में आवश्यक होते हैं।
VLM को प्रशिक्षित करने की प्रक्रिया में मॉडल को इमेज और उनकी संबंधित पाठ्य विवरणों के जोड़े खिलाए जाते हैं, जिससे मॉडल दृश्य तत्वों और भाषाई अभिव्यक्तियों के बीच जटिल संबंधों को सीख सके।
इस डेटा को संभालने के लिए, VLMs अक्सर एंबेडिंग लेयर्स का उपयोग करते हैं जो दृश्य और पाठ्य दोनों इनपुट्स को उच्च-आयामी स्पेस में ट्रांसफॉर्म करती हैं, जहां उनकी तुलना और संयोजन किया जा सके।
यह एंबेडिंग प्रक्रिया मॉडल को दोनों मॉडेलिटीज़ के बीच संबंध समझने और सुसंगत व प्रसंगानुकूल आउटपुट जनरेट करने में सक्षम बनाती है।
विज़न लैंग्वेज मॉडलों (VLMs) का परिदृश्य व्यापक है, और Hugging Face Hub पर कई ओपन-सोर्स मॉडल उपलब्ध हैं। ये मॉडल आकार, क्षमताओं और लाइसेंसिंग में भिन्न हैं, और उपयोगकर्ताओं को अलग-अलग अनुप्रयोगों के अनुरूप विकल्प प्रदान करते हैं। नीचे कुछ प्रमुख ओपन-सोर्स VLMs का अवलोकन दिया गया है, जिनकी मुख्य विशेषताओं को रेखांकित किया गया है:
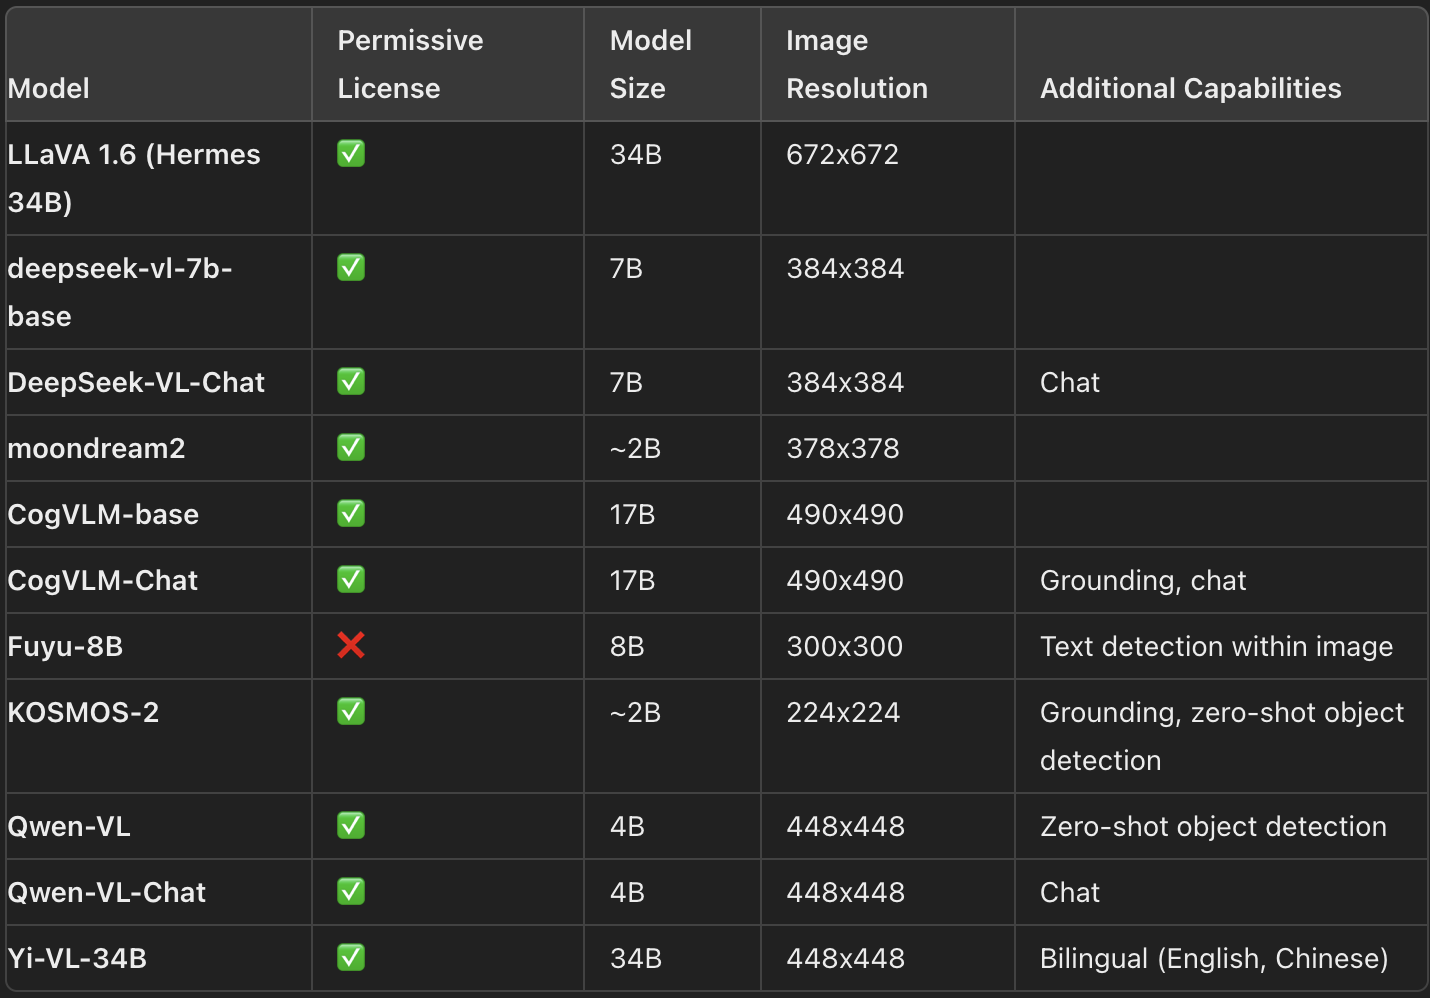
नवीनतम VLMs और उनकी प्रमुख विशेषताएँ (स्रोत: HuggingFace)
उपलब्ध विकल्पों की विविधता को देखते हुए, अपने विशिष्ट उपयोग-केस के लिए सबसे उपयुक्त VLM चुनना चुनौतीपूर्ण हो सकता है। इस चयन प्रक्रिया में कई टूल्स और संसाधन मदद कर सकते हैं:
जहाँ Vision Arena और Open VLM Leaderboard दोनों मूल्यवान अंतर्दृष्टि प्रदान करते हैं, वहीं वे केवल सबमिट किए गए मॉडलों तक सीमित हैं और नए मॉडलों को शामिल करने के लिए नियमित अपडेट की आवश्यकता होती है।
कई बेंचमार्क आमतौर पर VLMs के प्रदर्शन का मूल्यांकन करने के लिए उपयोग किए जाते हैं:
VLMs का प्रीट्रेनिंग इमेज और टेक्स्ट प्रतिनिधित्वों को एकीकृत करके उन्हें जनरेशन के लिए टेक्स्ट डिकोडर में फीड करना शामिल करता है। संरचना में आमतौर पर एक इमेज एन्कोडर, इमेज और टेक्स्ट प्रतिनिधित्वों को संरेखित करने के लिए एक एंबेडिंग प्रोजेक्टर और एक टेक्स्ट डिकोडर शामिल होता है। हालांकि, अलग-अलग मॉडल अलग-अलग प्रीट्रेनिंग रणनीतियाँ अपनाते हैं।
कई मामलों में, यदि आप मौजूदा मॉडलों को अपने विशिष्ट उपयोग-केस के लिए फाइन-ट्यून कर सकते हैं, तो VLM का प्रीट्रेनिंग करना आवश्यक भी नहीं होता। Transformers और SFTTrainer जैसे टूल्स विशिष्ट कार्यों के लिए मॉडलों को फाइन-ट्यून करने की प्रक्रिया को सरल बनाते हैं, जिससे सीमित संसाधनों वाले लोगों के लिए भी यह सुलभ हो जाता है।
यहाँ HuggingFace का एक इम्प्लीमेंटेशन है, जिससे आप HuggingFace की Transformers लाइब्रेरी के साथ अपने Colab या लोकल मशीन पर ओपन-सोर्स VLM LlavaNext मॉडल को निःशुल्क इस्तेमाल कर सकते हैं।
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf",
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True
)
model.to(device)विज़न लैंग्वेज मॉडलों की क्षमताएँ इमेज कैप्शनिंग से कहीं आगे तक जाती हैं। VLMs ने ऐसे कई अनुप्रयोगों के द्वार खोले हैं जो दृश्य और पाठ्य जानकारी के बीच की खाई को पाटने की उनकी क्षमता का उपयोग करते हैं। आइए विभिन्न उद्योगों में VLMs के कुछ सबसे प्रभावशाली अनुप्रयोगों का अन्वेषण करें।
विज़ुअल क्वेश्चन आंसरिंग (VQA) एक ऐसा कार्य है जिसमें किसी इमेज की सामग्री के बारे में प्रश्नों के उत्तर देना शामिल होता है।
इस अनुप्रयोग में मॉडल को इमेज के दृश्य तत्वों और प्रश्न के भाषायी संदर्भ—दोनों को समझना होता है। उदाहरण के लिए, किसी चहल-पहल वाले सिटीस्केप की इमेज दी जाए तो VLM ऐसे प्रश्नों का उत्तर दे सकता है: "सबसे ऊँची इमारत का रंग क्या है?" या "इमेज में कितने लोग दिखाई दे रहे हैं?"
VQA के कई व्यावहारिक अनुप्रयोग हैं, खासकर ऐसे उद्योगों में जहाँ दृश्य डेटा महत्वपूर्ण भूमिका निभाता है। उदाहरण के लिए स्वास्थ्य सेवा में VQA का उपयोग चिकित्सा इमेज का विश्लेषण करने और निदान व उपचार योजना में सहायक प्रश्नों के उत्तर देने के लिए किया जा सकता है। रिटेल में VQA ग्राहकों को उत्पाद इमेज के साथ अधिक स्वाभाविक और सहज तरीके से इंटरैक्ट करने की सुविधा देकर शॉपिंग अनुभव को बेहतर बना सकता है।
VLMs की सबसे रोमांचक क्षमताओं में से एक है टेक्स्ट-टू-इमेज जनरेशन। इस कार्य में किसी दृश्य या वस्तु का टेक्स्ट विवरण लेकर उसका दृश्य प्रतिनिधित्व जनरेट करना शामिल है। उदाहरण के लिए, कोई VLM "एक शांत सूर्यास्त, पहाड़ी श्रृंखला के ऊपर, घाटी से बहती नदी के साथ" जैसे प्रॉम्प्ट को लेकर उसके अनुरूप इमेज बना सकता है।
टेक्स्ट-टू-इमेज जनरेशन में डिजाइन और विज्ञापन जैसे रचनात्मक क्षेत्रों में अपार संभावनाएँ हैं। डिजाइनर और विज्ञापनदाता टेक्स्ट प्रॉम्प्ट्स के आधार पर तेजी से विज़ुअल आइडियाज़ जनरेट करने के लिए इस तकनीक का उपयोग कर सकते हैं। यह विशिष्ट मार्केटिंग संदेशों के अनुरूप विज़ुअल कंटेंट बनाने की प्रक्रिया को सुगम बना सकता है।
इमेज रिट्रीवल किसी पाठ्य क्वेरी के आधार पर प्रासंगिक इमेज ढूँढने की प्रक्रिया है। VLMs इस कार्य में इसलिए उत्कृष्ट हैं क्योंकि वे इमेज की दृश्य सामग्री और क्वेरी के भाषायी संदर्भ—दोनों को समझ सकते हैं।
यह क्षमता सर्च इंजनों को और शक्तिशाली और सटीक बनाती है, जिससे उपयोगकर्ता अपनी मनचाही इमेज को अधिक आसानी से पा सकें।
इमेज रिट्रीवल के अनुप्रयोग ई-कॉमर्स से लेकर चिकित्सा इमेज विश्लेषण तक फैले हैं। ई-कॉमर्स में, इमेज रिट्रीवल ग्राहकों को दृश्य और पाठ्य विवरणों के आधार पर उनके पसंद के उत्पाद खोजने में मदद कर सकता है। स्वास्थ्य सेवा में, यह शोध या निदान हेतु प्रासंगिक चिकित्सा इमेज खोजने में पेशेवरों की सहायता कर सकता है।
हालाँकि ऊपर दिए गए उदाहरण इमेज पर केंद्रित हैं, VLMs को वीडियो को समझने और उनके लिए कैप्शन जनरेट करने तक बढ़ाया जा सकता है। वीडियो समझ में किसी वीडियो की दृश्य सामग्री का विश्लेषण करना और ऐसे वर्णनात्मक टेक्स्ट बनाना शामिल है जो दर्शाए गए दृश्यों का सार पकड़ सके।
वीडियो समझ के अनुप्रयोगों में वीडियो सर्च, संक्षेपण और कंटेंट मॉडरेशन शामिल हैं। वीडियो सर्च में, VLMs उपयोगकर्ताओं को पाठ्य क्वेरी के आधार पर विशिष्ट क्लिप खोजने में मदद कर सकते हैं। संक्षेपण कार्यों में, VLMs लंबे वीडियो का संक्षिप्त सार बना सकते हैं, जिससे उपयोगकर्ता सामग्री को जल्दी समझ सकें। कंटेंट मॉडरेशन में, VLMs अनुचित या हानिकारक वीडियो सामग्री की पहचान में मदद कर सकते हैं, ताकि प्लेटफॉर्म सुरक्षित और उपयोगकर्ता-मित्र बने रहें।
अब VLMs से जुड़ी चुनौतियों और नैतिक पहलुओं पर विचार करें।
VLMs को प्रशिक्षित करना और तैनात करना महत्वपूर्ण कम्प्यूटेशनल संसाधनों की मांग करता है, खासकर PaliGemma जैसे बड़े मॉडलों के लिए। यह उच्च-प्रदर्शन कम्प्यूटिंग इन्फ्रास्ट्रक्चर तक सीमित पहुँच वाली संस्थाओं के लिए बाधा बन सकता है।
इस चुनौती का समाधान करने के लिए, शोधकर्ता VLMs को अधिक कुशल बनाने के तरीके तलाश रहे हैं, जैसे मॉडल कम्प्रेशन तकनीकों का उपयोग, मॉडल आर्किटेक्चर का अनुकूलन, और GPUs व TPUs जैसे हार्डवेयर एक्सेलेरेटर का लाभ उठाना।
VLMs का विकास कई नैतिक चिंताएँ उठाता है, खासकर मॉडल के आउटपुट में संभावित पक्षपात को लेकर। बड़े पैमाने के, वास्तविक दुनिया के इमेज-टेक्स्ट डेटा पर प्रशिक्षित VLMs प्रशिक्षण सामग्री में निहित सामाजिक-सांस्कृतिक पक्षपात को परावर्तित कर सकते हैं। ये पक्षपात मॉडल के आउटपुट्स में प्रकट हो सकते हैं, जिससे हानिकारक या आपत्तिजनक सामग्री उत्पन्न हो सकती है।
इन चिंताओं का समाधान करने के लिए, शोधकर्ता विभिन्न पक्षपात-शमन तकनीकों को लागू कर रहे हैं, जैसे संतुलित प्रशिक्षण डेटासेट्स का उपयोग, फेयरनेस-एवेयर लर्निंग एल्गोरिद्म शामिल करना, और मॉडल आउटपुट का कड़े मूल्यांकन के माध्यम से संभावित पक्षपातों की पहचान व निवारण करना।
इसके अतिरिक्त, Google जैसी संस्थाएँ कंटेंट सेफ्टी फ़िल्टर्स लागू कर रही हैं ताकि PaliGemma जैसे मॉडलों के लिए उपयोग किए जाने वाले प्रशिक्षण डेटा को साफ और हानिकारक सामग्री से मुक्त रखा जा सके।
VLMs के विकास में एक अन्य महत्वपूर्ण विचार गोपनीयता और डेटा सुरक्षा है। VLMs को अक्सर बड़े पैमाने के डेटा तक पहुँच की आवश्यकता होती है, जिसमें संवेदनशील जानकारी भी शामिल हो सकती है। यह सुनिश्चित करना कि इस डेटा को सुरक्षित रूप से और गोपनीयता विनियमों के अनुरूप संभाला जाए, उपयोगकर्ताओं और हितधारकों का विश्वास बनाए रखने के लिए अत्यंत महत्वपूर्ण है।
गोपनीयता संबंधी चिंताओं को दूर करने के लिए, शोधकर्ता फेडरेटेड लर्निंग जैसी तकनीकों का अन्वेषण कर रहे हैं, जो मॉडलों को विकेन्द्रीकृत डेटा पर प्रशिक्षित करने की अनुमति देती हैं, बिना संवेदनशील जानकारी को किसी केंद्रीय सर्वर पर ट्रांसफर किए।
इसके अतिरिक्त, Google जैसी संस्थाएँ प्रशिक्षण डेटासेट्स से व्यक्तिगत जानकारी और संवेदनशील डेटा को फ़िल्टर करने जैसे डेटा दायित्व उपाय लागू कर रही हैं, ताकि व्यक्तियों की गोपनीयता की रक्षा की जा सके।
विज़न लैंग्वेज मॉडल कृत्रिम बुद्धिमत्ता में एक महत्वपूर्ण कदम का प्रतिनिधित्व करते हैं, जो दृश्य और पाठ्य दोनों डेटा को प्रोसेस करने की क्षमता के माध्यम से विभिन्न अनुप्रयोगों को सुदृढ़ करने की संभावनाएँ प्रदान करते हैं।
जैसे-जैसे इस क्षेत्र में शोध आगे बढ़ेगा, हम और अधिक परिष्कृत VLMs की अपेक्षा कर सकते हैं जो जटिल कार्यों को अंजाम देने और मूल्यवान अंतर्दृष्टि प्रदान करने में सक्षम हों।
दृश्य और पाठ्य समझ के एकीकरण से नवाचार के नए रास्ते खुलते हैं, जिससे VLMs अनुसंधान और विकास का एक आशाजनक क्षेत्र बन जाते हैं।
इन कोर्सेज के साथ एआई सीखें!
कोर्स
कोर्स
कोर्स