Kurs
Bildverarbeitung mit Python
4 Std.
56.8K
Lerne, wie du mit LLMs in Python direkt in deinem Browser arbeiten kannst
Im Kern von Vision-Language-Modellen steht die Verbindung von Computer Vision und Natural Language Processing.
Computer Vision zielt darauf ab, Maschinen das Interpretieren und Analysieren visueller Daten wie Bilder und Videos zu ermöglichen, indem Objekte, Muster und andere visuelle Elemente erkannt werden.
Natural Language Processing befasst sich hingegen mit dem Verstehen und Generieren menschlicher Sprache, sodass Maschinen Text erfassen, analysieren und erzeugen können.
VLMs schlagen die Brücke zwischen beiden Feldern, indem sie Modelle bereitstellen, die visuelle und textuelle Eingaben gleichzeitig verarbeiten und verstehen. Möglich wird das durch fortgeschrittene Deep-Learning-Architekturen, insbesondere Transformer-Modelle, die maßgeblich zum Erfolg großer Sprachmodelle wie GPT-4o, Llama, Gemini und Gemma beigetragen haben.
Diese Transformer-basierten Architekturen wurden so angepasst, dass sie multimodale Eingaben verarbeiten und die komplexen Beziehungen zwischen visuellen und sprachlichen Daten erfassen können.
Das ursprünglich für NLP eingeführte Transformer-Modell ist dank seiner Fähigkeit, lange Abhängigkeiten und Kontextbeziehungen in Daten zu erfassen, zum Rückgrat vieler moderner KI-Systeme geworden.
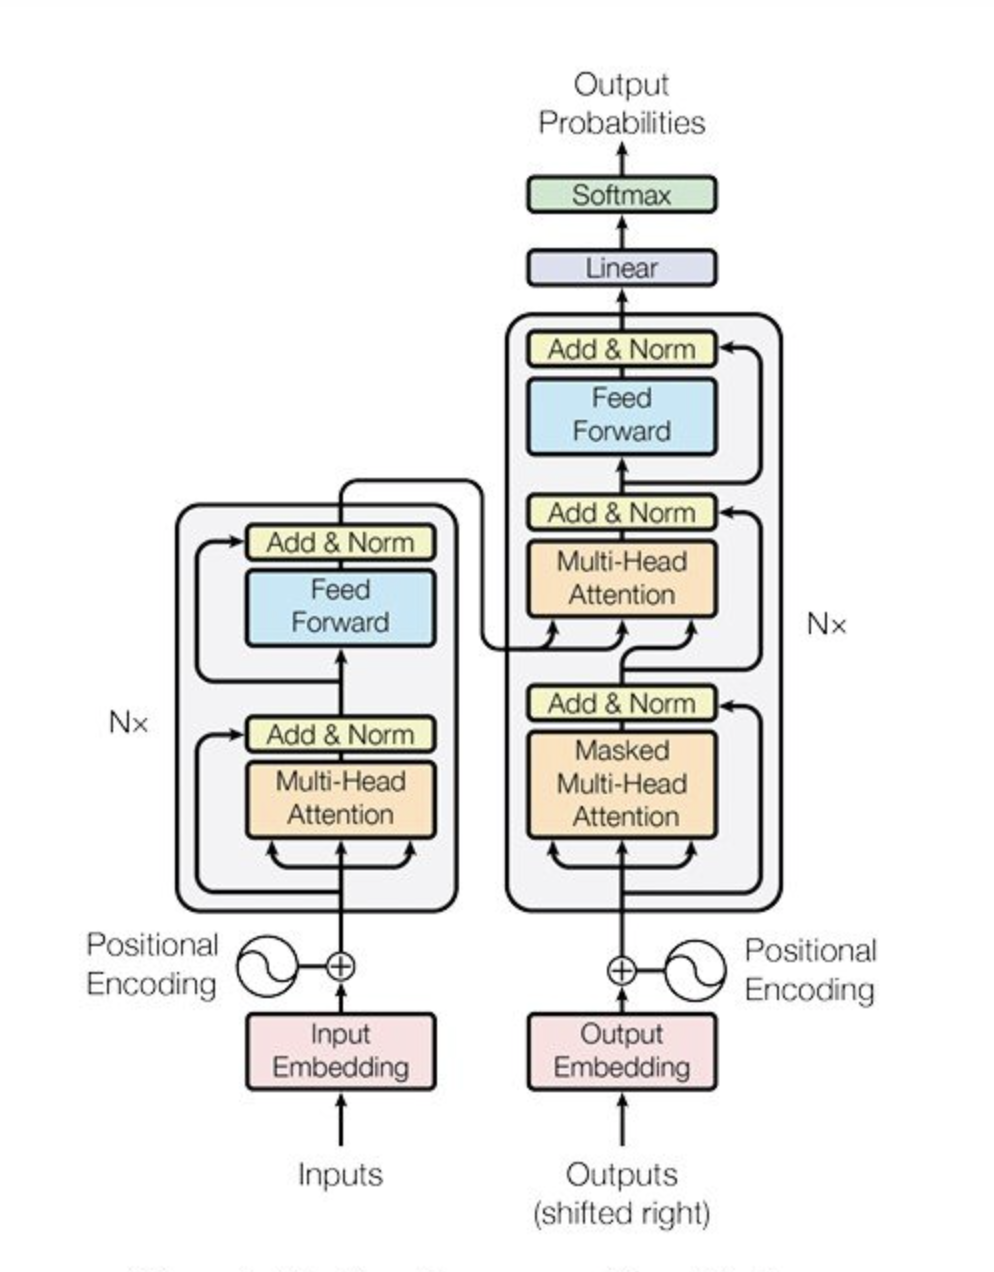
Quelle: Vaswani et al., 2017
Im Kontext von VLMs wurden Transformer so erweitert, dass sie Bilder und Text verarbeiten können – für eine nahtlose Integration beider Modalitäten.
Eine typische VLM-Architektur besteht aus zwei Hauptkomponenten: einem Bildencoder und einem Textdecoder:
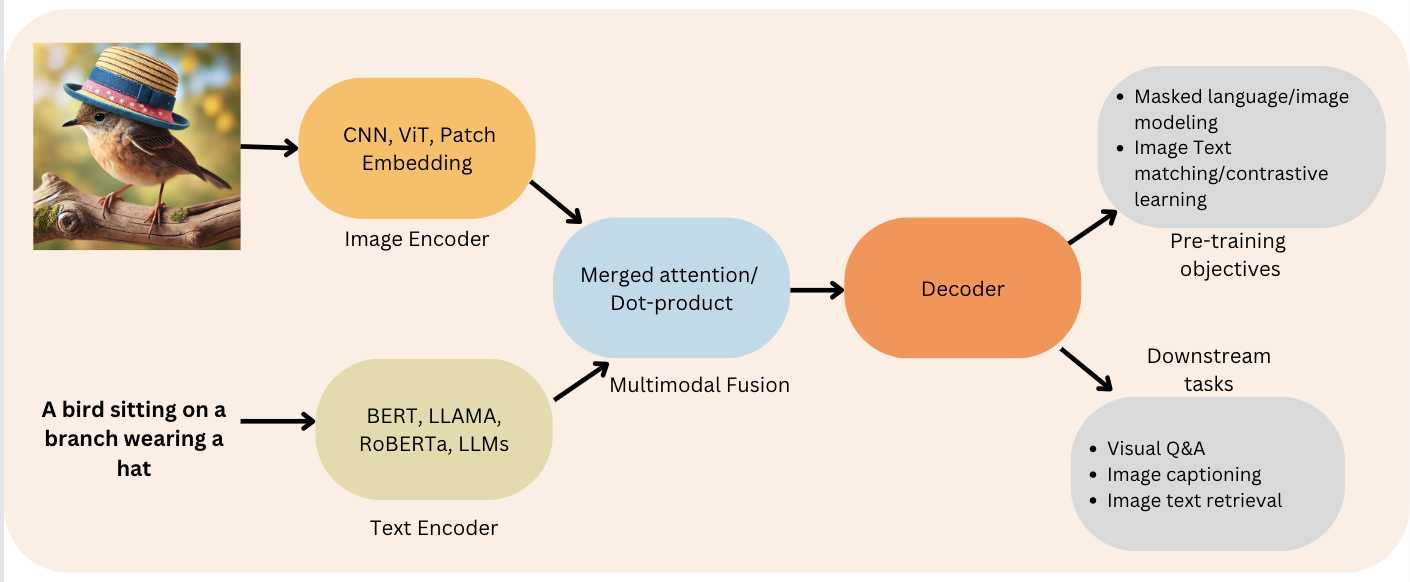
Abbildung 2: Encoder-Decoder-Funktion (Quelle: Viso.ai)
Durch das Zusammenspiel beider Teile können VLMs Beeindruckendes leisten: Sie beschreiben Bilder detailliert, beantworten Fragen zu Bildinhalten und generieren sogar neue Bilder aus Textbeschreibungen. Der typische Ablauf sieht so aus:
Die meisten VLMs nutzen einen Vision Transformer (ViT) als Bildencoder, der auf großen Bilddatensätzen vortrainiert wurde, um visuelle Merkmale für multimodale Aufgaben zuverlässig zu erfassen.
Der Textdecoder basiert auf dem Sprachmodell, das für die Feinabstimmung auf Sprachgenerierung im Kontext visueller Daten optimiert wurde. Die Kombination aus fortgeschrittener visueller und sprachlicher Verarbeitung macht VLMs extrem vielseitig und leistungsstark.
Eine der größten Herausforderungen bei der Entwicklung von VLMs ist der Bedarf an großen, vielfältigen Datensätzen, die sowohl visuelle als auch textuelle Informationen enthalten. Sie sind zentral, um die Modelle auf multimodale Inhalte zu trainieren.
Beim Training werden dem Modell Bild-Text-Paare zugeführt, damit es die feinen Zusammenhänge zwischen visuellen Elementen und sprachlichen Ausdrücken lernt.
Zur Verarbeitung dieser Daten nutzen VLMs häufig Embedding-Schichten, die visuelle und textuelle Eingaben in einen hochdimensionalen Raum abbilden, in dem sie verglichen und kombiniert werden können.
So versteht das Modell die Verbindungen zwischen beiden Modalitäten und erzeugt kohärente, kontextrelevante Ausgaben.
Das Feld der Vision-Language-Modelle (VLMs) ist breit gefächert – auf dem Hugging Face Hub sind zahlreiche Open-Source-Modelle verfügbar. Sie unterscheiden sich in Größe, Fähigkeiten und Lizenzen – und bieten für viele Anwendungsfälle passende Optionen. Im Folgenden findest du einen Überblick über einige der bekanntesten Open-Source-VLMs mit ihren wichtigsten Eigenschaften:
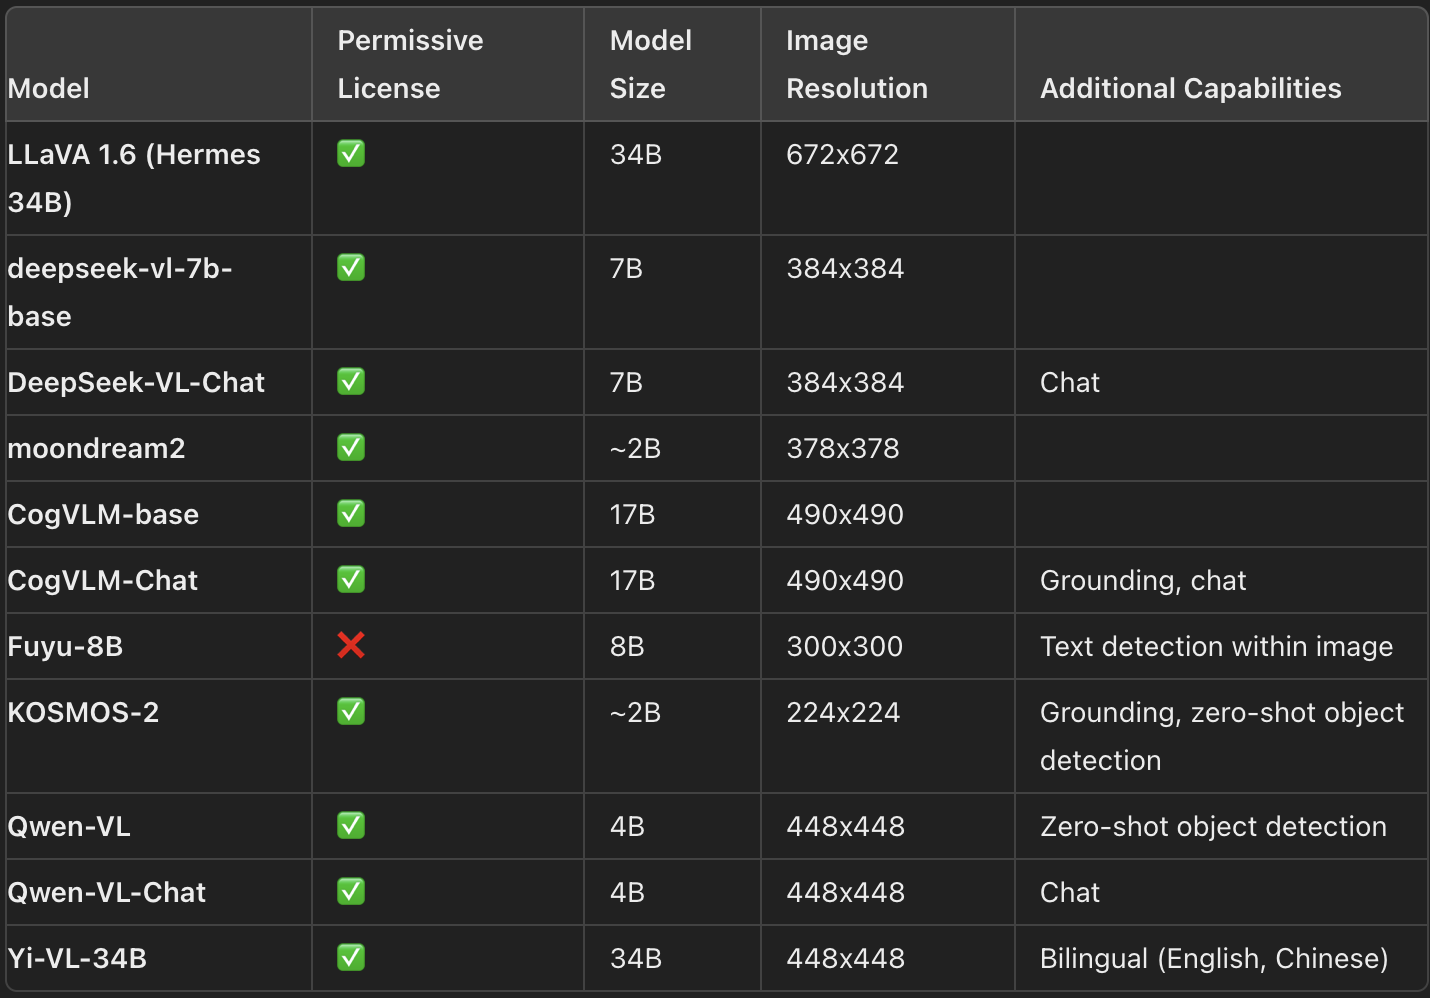
Aktuelle VLMs und ihre wichtigsten Merkmale (Quelle: HuggingFace)
Angesichts der Vielzahl an Optionen ist die Auswahl des passenden VLMs nicht trivial. Diese Tools und Ressourcen helfen bei der Entscheidung:
Sowohl Vision Arena als auch das Open VLM Leaderboard liefern wertvolle Einblicke, decken jedoch nur eingereichte Modelle ab und müssen regelmäßig um neue Modelle ergänzt werden.
Zur Leistungsbewertung von VLMs werden häufig diese Benchmarks eingesetzt:
Beim Pretraining von VLMs werden Bild- und Textrepräsentationen vereinheitlicht, um sie zur Generierung in einen Textdecoder einzuspeisen. Typisch sind Bildencoder, ein Embedding-Projektor zur Angleichung von Bild- und Textrepräsentationen sowie ein Textdecoder. Unterschiedliche Modelle verfolgen dabei verschiedene Pretraining-Strategien.
Oft ist Pretraining gar nicht nötig, wenn du bestehende Modelle auf deinen Anwendungsfall feinabstimmen kannst. Tools wie Transformers und SFTTrainer vereinfachen das Fine-Tuning auf spezifische Aufgaben – auch mit begrenzten Ressourcen.
Hier ist eine HuggingFace-Implementierung, um das Open-Source-VLM LlavaNext kostenlos auf Colab oder lokal mit der Transformers-Bibliothek von HuggingFace zu nutzen.
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf",
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True
)
model.to(device)Die Möglichkeiten von Vision-Language-Modellen gehen weit über Bildbeschriftung hinaus. VLMs eröffnen zahlreiche Anwendungen, die ihre Stärke nutzen, visuelle und textuelle Informationen zu verbinden. Hier sind einige der wirkungsvollsten Einsatzfelder in verschiedenen Branchen.
Visual Question Answering (VQA) beantwortet Fragen zum Inhalt eines Bildes.
Dafür muss das Modell sowohl die visuellen Elemente im Bild als auch den sprachlichen Kontext der Frage verstehen. Bei einem Bild einer geschäftigen Skyline kann ein VLM zum Beispiel Fragen wie „Welche Farbe hat das höchste Gebäude?“ oder „Wie viele Menschen sind zu sehen?“ beantworten.
VQA hat viele praktische Anwendungen – besonders dort, wo visuelle Daten eine zentrale Rolle spielen. Im Gesundheitswesen kann VQA beispielsweise medizinische Bilder analysieren und Antworten liefern, die bei Diagnose und Therapieplanung unterstützen. Im Einzelhandel verbessert VQA das Shopping-Erlebnis, indem Kundinnen und Kunden natürlicher mit Produktbildern interagieren.
Eine der spannendsten Fähigkeiten von VLMs ist die Text-zu-Bild-Generierung. Dabei wird auf Basis einer Textbeschreibung eine visuelle Darstellung einer Szene oder eines Objekts erzeugt. Ein Prompt wie „Ein ruhiger Sonnenuntergang über einem Gebirgszug mit einem Fluss im Tal“ führt zu einem passenden Bild.
Für Kreativbereiche wie Design und Werbung ist das äußerst vielversprechend. Teams können schnell visuelle Ideen aus Textvorgaben entwickeln. So lässt sich die Produktion passgenauer visueller Inhalte deutlich beschleunigen.
Beim Image Retrieval werden passende Bilder zu einer Textanfrage gefunden. VLMs überzeugen hier, weil sie sowohl den visuellen Bildinhalt als auch den sprachlichen Kontext der Suche verstehen.
Das macht Suchmaschinen leistungsfähiger und präziser – Nutzer finden schneller genau die Bilder, die sie suchen.
Einsatzfelder reichen von E-Commerce bis zur medizinischen Bildanalyse. Im Handel hilft die Bildsuche, Produkte passend zu visuellen und textlichen Beschreibungen zu finden. In der Medizin unterstützt sie Fachpersonal bei der Recherche oder Diagnostik.
VLMs lassen sich auch auf Videos erweitern, um Inhalte zu verstehen und Bildunterschriften zu generieren. Dabei wird der visuelle Videoinhalt analysiert und in prägnantem Text beschrieben.
Anwendungen sind Videosuche, Zusammenfassungen und Inhaltsmoderation. Bei der Suche helfen VLMs, gezielt Clips zu finden. Für Summaries erzeugen sie knappe Zusammenfassungen langer Videos. In der Moderation identifizieren sie unangemessene oder schädliche Inhalte und tragen so zu einer sicheren Umgebung bei.
Zum Schluss betrachten wir die Herausforderungen rund um VLMs sowie die ethischen Fragen.
Training und Einsatz von VLMs erfordern beträchtliche Rechenressourcen, insbesondere bei großen Modellen wie PaliGemma. Für Organisationen ohne Hochleistungsinfrastruktur kann das eine Hürde sein.
Forschende arbeiten an effizienteren VLMs – etwa durch Modellkompression, Architektur-Optimierung und den Einsatz von Hardware-Beschleunigern wie GPUs und TPUs.
Die Entwicklung von VLMs wirft ethische Fragen auf – vor allem hinsichtlich potenzieller Verzerrungen in den Ausgaben. Auf großen, realweltlichen Bild-Text-Daten trainierte VLMs können soziokulturelle Biases aus den Trainingsdaten widerspiegeln – mit potenziell schädlichen oder anstößigen Ergebnissen.
Zur Minderung kommen u. a. ausgewogene Trainingsdatensätze, Fairness-orientierte Lernverfahren und strenge Output-Evaluierungen zum Einsatz, um Verzerrungen zu identifizieren und zu adressieren.
Zusätzlich setzen Organisationen wie Google Content-Safety-Filter ein, um Trainingsdaten für Modelle wie PaliGemma von schädlichen Inhalten zu bereinigen.
Ein weiterer zentraler Aspekt ist Privatsphäre und Datensicherheit. VLMs benötigen oft große Datenmengen – teils mit sensiblen Informationen. Eine sichere, DSGVO-konforme Verarbeitung ist entscheidend, um Vertrauen zu erhalten.
Zur Wahrung der Privatsphäre werden Ansätze wie föderiertes Lernen erprobt, bei dem Modelle dezentral trainieren, ohne sensible Daten zentral zu übertragen.
Zudem implementieren Organisationen wie Google Maßnahmen der Datenverantwortung – etwa das Filtern personenbezogener und sensibler Informationen aus Trainingsdatensätzen.
Vision-Language-Modelle sind ein großer Schritt für die Künstliche Intelligenz und erweitern Anwendungen, indem sie visuelle und textuelle Daten gemeinsam verarbeiten.
Mit dem Fortschritt der Forschung entstehen immer ausgereiftere VLMs, die komplexe Aufgaben meistern und neue Einsichten liefern.
Das Zusammenspiel aus visueller und sprachlicher Intelligenz eröffnet neue Innovationsräume – VLMs bleiben ein vielversprechendes Feld für Forschung und Entwicklung.
Lerne KI mit diesen Kursen!
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
DataCamp Team
5 Min.





