
Kursus
Retrieval Augmented Generation (RAG) dengan LangChain
3 jam
21.3K
DeepSeek-R1 sangat cocok untuk sistem berbasis RAG karena kinerjanya yang dioptimalkan, kemampuan pencarian vektor tingkat lanjut, dan fleksibilitas di berbagai lingkungan, dari setup lokal hingga deployment berskala. Berikut beberapa alasan mengapa ini efektif:
Proyek demo kami berfokus pada pembuatan chatbot RAG menggunakan DeepSeek-R1 dan Gradio.
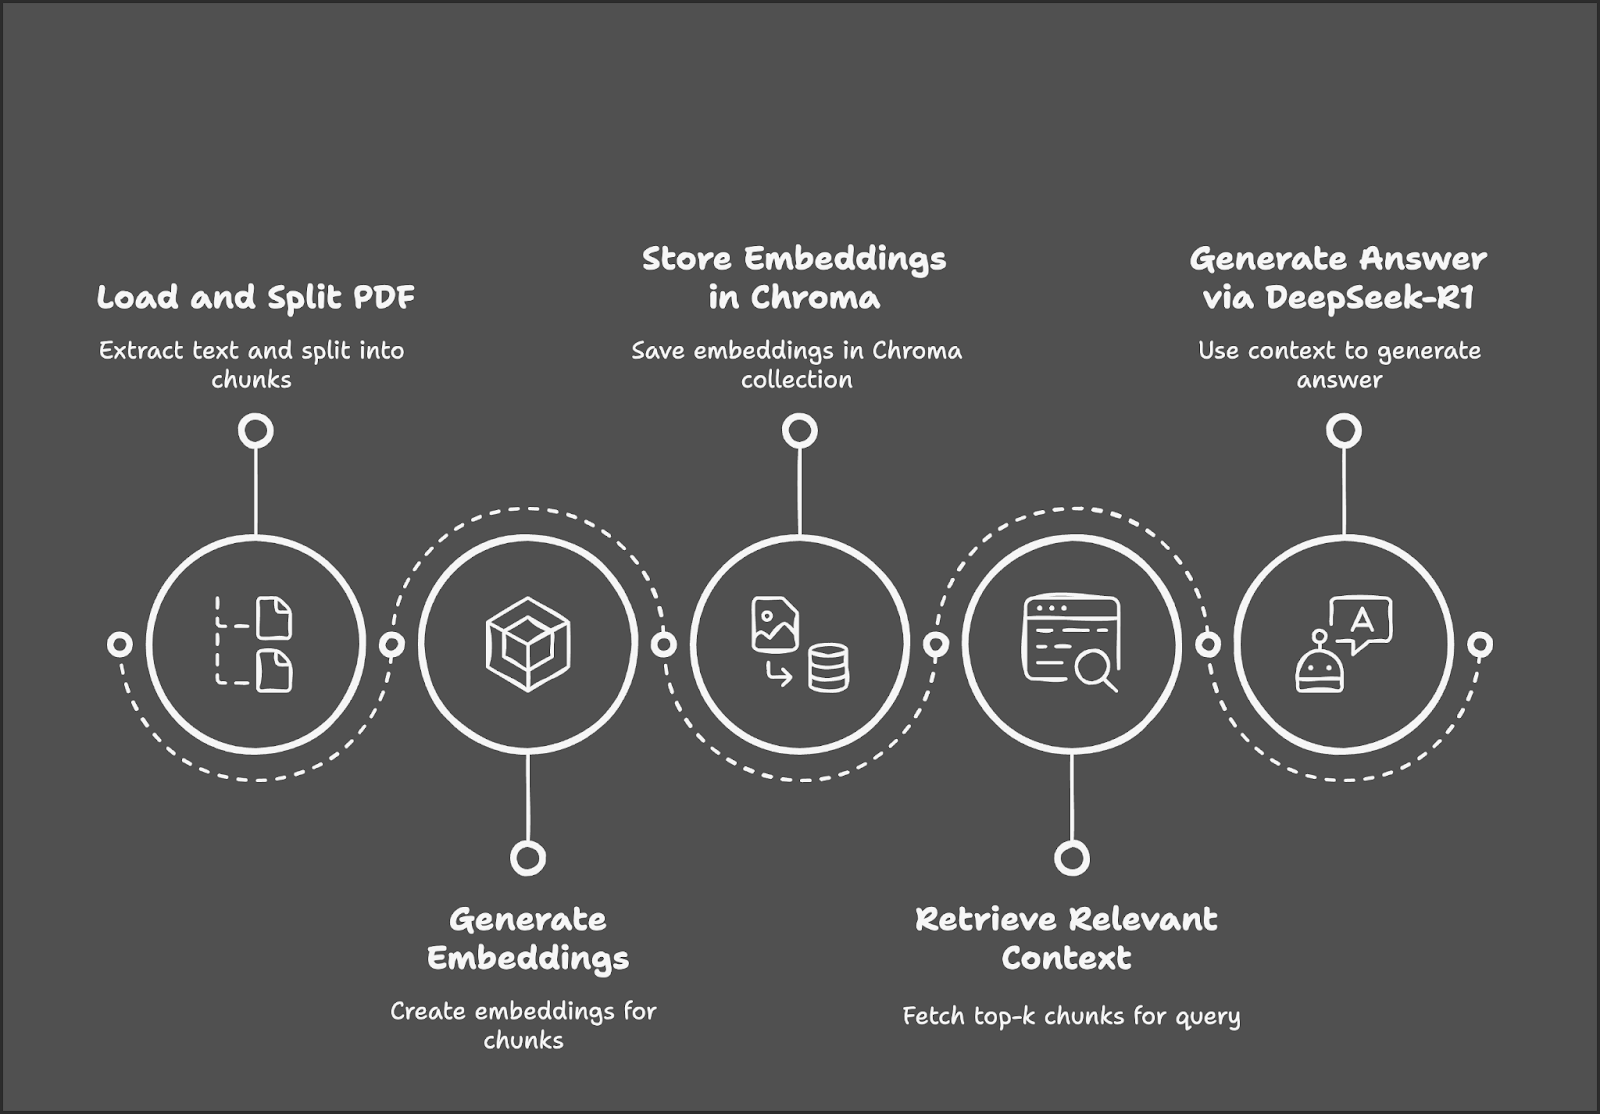
Proses dimulai dengan memuat dan membagi PDF menjadi potongan teks, lalu menghasilkan embedding untuk potongan tersebut. Embedding ini disimpan di database Chroma untuk pengambilan yang efisien. Saat pengguna mengirimkan kueri, sistem mengambil potongan teks yang paling relevan dan menggunakan DeepSeek-R1 untuk menghasilkan jawaban berdasarkan konteks yang diambil.
Sebelum memulai, pastikan kita telah memasang alat dan pustaka berikut:
Jalankan perintah berikut untuk memasang dependensi yang diperlukan:
!pip install langchain chromadb gradio ollama pymypdf
!pip install -U langchain-community
Setelah dependensi di atas terpasang, jalankan perintah impor berikut:
import ollama
import re
import gradio as gr
from concurrent.futures import ThreadPoolExecutor
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import PyMuPDFLoader
from langchain_community.embeddings import OllamaEmbeddings
from chromadb.config import Settings
from chromadb import Client
from langchain.vectorstores import ChromaKita akan menggunakan PyMuPDFLoader dari LangChain untuk mengekstrak teks dari versi PDF buku Foundations of LLMs karya Tong Xiao dan Jingbo Zhu—ini adalah buku yang sarat matematika, sehingga chatbot kita seharusnya mampu menjelaskan matematika di balik LLM dengan baik. Anda dapat menemukan bukunya di arXiv.
# Load the document using PyMuPDFLoader
loader = PyMuPDFLoader("/path/to/Foundations_of_llms.pdf")

documents = loader.load()
Setelah dokumen dimuat, kita dapat mulai membaginya menjadi potongan-potongan untuk diproses lebih lanjut.
Kita akan membagi teks yang diekstrak menjadi potongan kecil yang saling tumpang tindih agar pengambilan konteks lebih baik. Anda dapat mengubah ukuran chunk dan overlap sesuai kebutuhan sistem dalam fungsi RecursiveCharacterTextSpilitter().
# Split the document into smaller chunks
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)

chunks = text_splitter.split_documents(documents)
Sekarang kita memiliki potongan teks yang siap diubah menjadi embedding.
Kita akan menggunakan Ollama Embeddings berbasis DeepSeek-R1 untuk menghasilkan embedding dokumen. Bergantung pada ukuran dokumen, pembuatan embedding bisa memakan waktu, sehingga lebih baik diparalelkan agar lebih cepat.
Catatan: model="deepseek-r1" secara bawaan menggunakan model 7B parameter. Anda dapat mengubahnya sesuai kebutuhan ke 8B, 14B, 32B, 70B, atau 671B. Ganti X pada nama model berikut dengan ukuran model: model="deepseek-r1:X"
# Initialize Ollama embeddings using DeepSeek-R1
embedding_function = OllamaEmbeddings(model="deepseek-r1")
# Parallelize embedding generation
def generate_embedding(chunk):
    return embedding_function.embed_query(chunk.page_content)
with ThreadPoolExecutor() as executor:
    embeddings = list(executor.map(generate_embedding, chunks))
Fungsi di atas menginisialisasi DeepSeek-R1 melalui Ollama untuk menghasilkan embedding semantik berdimensi tinggi, yang nantinya digunakan untuk retrieval dokumen berbasis kemiripan.
Fungsi generate_embedding() mengambil teks potongan dokumen dan menghasilkan embedding-nya. Terakhir, ThreadPoolExecutor() menerapkan generate_embedding() ke setiap potongan secara bersamaan, mengumpulkan embedding ke dalam daftar agar pemrosesan lebih cepat dibandingkan eksekusi berurutan.
Kita akan menyimpan embedding dan potongan teks terkait di basis data vektor berkinerja tinggi, Chroma.
# Initialize Chroma client and create/reset the collection
client = Client(Settings())
client.delete_collection(name="foundations_of_llms")  # Delete existing collection (if any)
collection = client.create_collection(name="foundations_of_llms")
# Add documents and embeddings to Chroma
for idx, chunk in enumerate(chunks):
    collection.add(
        documents=[chunk.page_content],
        metadatas=[{'id': idx}],
        embeddings=[embeddings[idx]],
        ids=[str(idx)]  # Ensure IDs are strings
    )
Kita mulai dengan mengikuti langkah-langkah berikut untuk menyimpan embedding:
Client(Settings()) menginisialisasi klien Chroma untuk mengelola vector store. client.delete_collection() untuk menghindari error. Terakhir, gunakan client.create_collection() untuk membuat koleksi baru guna menyimpan potongan dokumen dan embedding-nya.collection.add() menyimpan:chunk.page_content){'id': idx}) untuk mereferensikan potonganPengaturan ini memastikan setiap potongan dokumen terindeks dengan benar untuk retrieval berbasis vektor yang efisien.
Kita akan menginisialisasi Chroma retriever, memastikan ia menggunakan embedding DeepSeek-R1 yang sama untuk kueri.
# Initialize retriever using Ollama embeddings for queries
retriever = Chroma(collection_name="foundations_of_llms", client=client, embedding_function=embedding_function).as_retriever()
Chroma retriever terhubung ke koleksi "foundations_of_llms" dan menggunakan embedding DeepSeek-R1 melalui Ollama untuk me-embed kueri pengguna. Ia mengambil potongan dokumen yang paling relevan berdasarkan kemiripan vektor untuk respons yang sadar konteks.
Selanjutnya, kita akan mengambil potongan teks yang paling relevan dan memformatnya agar DeepSeek-R1 dapat menghasilkan jawaban.
def retrieve_context(question):
    # Retrieve relevant documents
    results = retriever.invoke(question)
    # Combine the retrieved content
    context = "\n\n".join([doc.page_content for doc in results])
    return context
Fungsi retrieve_context me-embed kueri pengguna menggunakan DeepSeek-R1 dan mengambil potongan dokumen paling relevan melalui Chroma retriever. Lalu menggabungkan konten potongan yang diambil menjadi satu string konteks untuk diproses lebih lanjut.
Sekarang kita memiliki pertanyaan dan konteks yang diambil. Selanjutnya, kirimkan ke DeepSeek-R1 melalui Ollama untuk mendapatkan jawaban akhir.
def query_deepseek(question, context):
    # Format the input prompt
    formatted_prompt = f"Question: {question}\n\nContext: {context}"
    # Query DeepSeek-R1 using Ollama
    response = embedding_function.chat(
        model="deepseek-r1",
        messages=[{'role': 'user', 'content': formatted_prompt}]
    )
    # Clean and return the response
    response_content = response['message']['content']
    final_answer = re.sub(r'<think>.*?</think>', '', response_content, flags=re.DOTALL).strip()
    return final_answer
Untuk memperoleh jawaban akhir, kita mulai dengan menggabungkan pertanyaan pengguna dan konteks yang diambil ke dalam prompt terstruktur. Lalu kirimkan prompt ini ke model DeepSeek-R1 melalui Ollama untuk menerima respons. Agar keluaran akhir rapi, kita menghapus tag yang tidak perlu dan mengembalikan jawaban akhir.
Kita sudah memiliki pipeline RAG. Sekarang, kita akan menggunakan Gradio untuk membuat antarmuka interaktif agar pengguna dapat mengajukan pertanyaan terkait basis pengetahuannya (dalam kasus ini Foundations of LLMs).
def ask_question(question):
    # Retrieve context and generate an answer using RAG
    context = retrieve_context(question)
    answer = query_deepseek(question, context)
    return answer
# Set up the Gradio interface
interface = gr.Interface(
    fn=ask_question,
    inputs="text",
    outputs="text",
    title="RAG Chatbot: Foundations of LLMs",
    description="Ask any question about the Foundations of LLMs book. Powered by DeepSeek-R1."
)
interface.launch()
Fungsi ask_question() mengambil konteks yang relevan menggunakan Chroma retriever dan menghasilkan jawaban akhir melalui DeepSeek-R1. Antarmuka Gradio, yang dibuat dengan gr.Interface(), memungkinkan pengguna bertanya secara interaktif dan menerima jawaban yang akurat serta berbasis konteks.
Selamat! Anda kini memiliki chatbot yang berjalan secara lokal dan siap membahas apa pun terkait LLM.
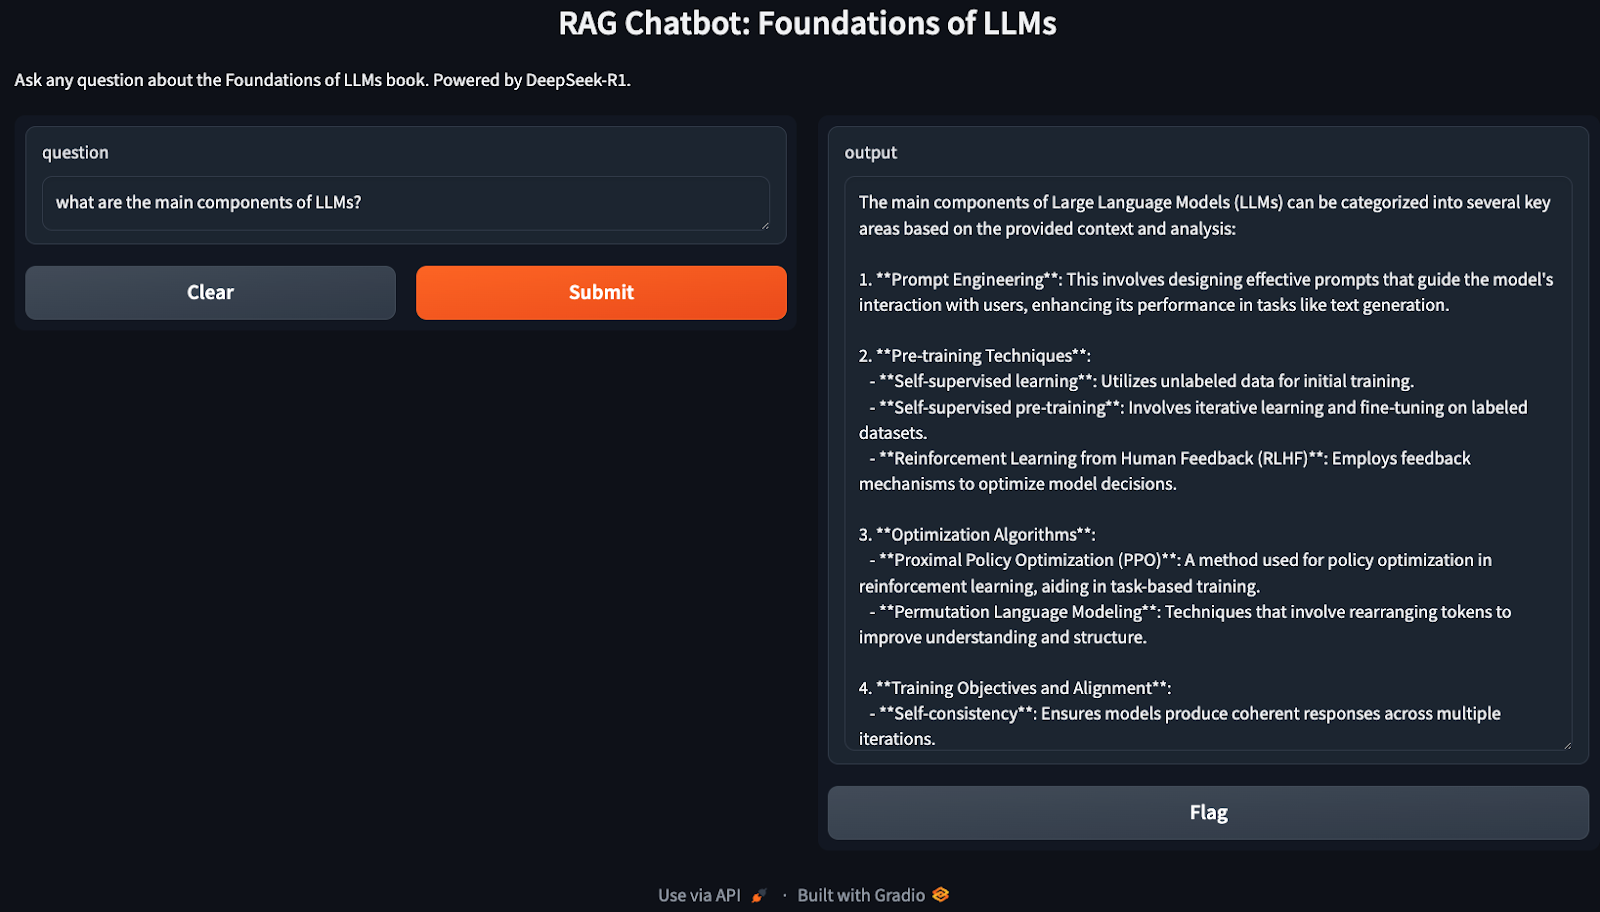
Demo di atas mencakup implementasi RAG yang sangat dasar, yang dapat dioptimalkan lebih lanjut untuk efisiensi. Berikut beberapa hal yang bisa dicoba:
chunk_size dan chunk_overlap untuk menyeimbangkan kinerja dan kualitas retrieval.Dalam tutorial ini, kita membangun chatbot lokal berbasis RAG menggunakan DeepSeek-R1 dan Chroma untuk retrieval, yang memastikan jawaban akurat dan kaya konteks terhadap pertanyaan berdasarkan basis pengetahuan besar.
Untuk mempelajari lebih lanjut tentang DeepSeek, saya merekomendasikan blog berikut:
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt



