
Cursus
Retrieval Augmented Generation (RAG) met LangChain
3 uur
21.3K
DeepSeek-R1 is een ideale match voor RAG-systemen dankzij de geoptimaliseerde prestaties, geavanceerde vectorzoekmogelijkheden en flexibiliteit in verschillende omgevingen, van lokaal tot schaalbare deployments. Dit zijn enkele redenen waarom het effectief is:
Ons demoproject richt zich op het bouwen van een RAG-chatbot met DeepSeek-R1 en Gradio.
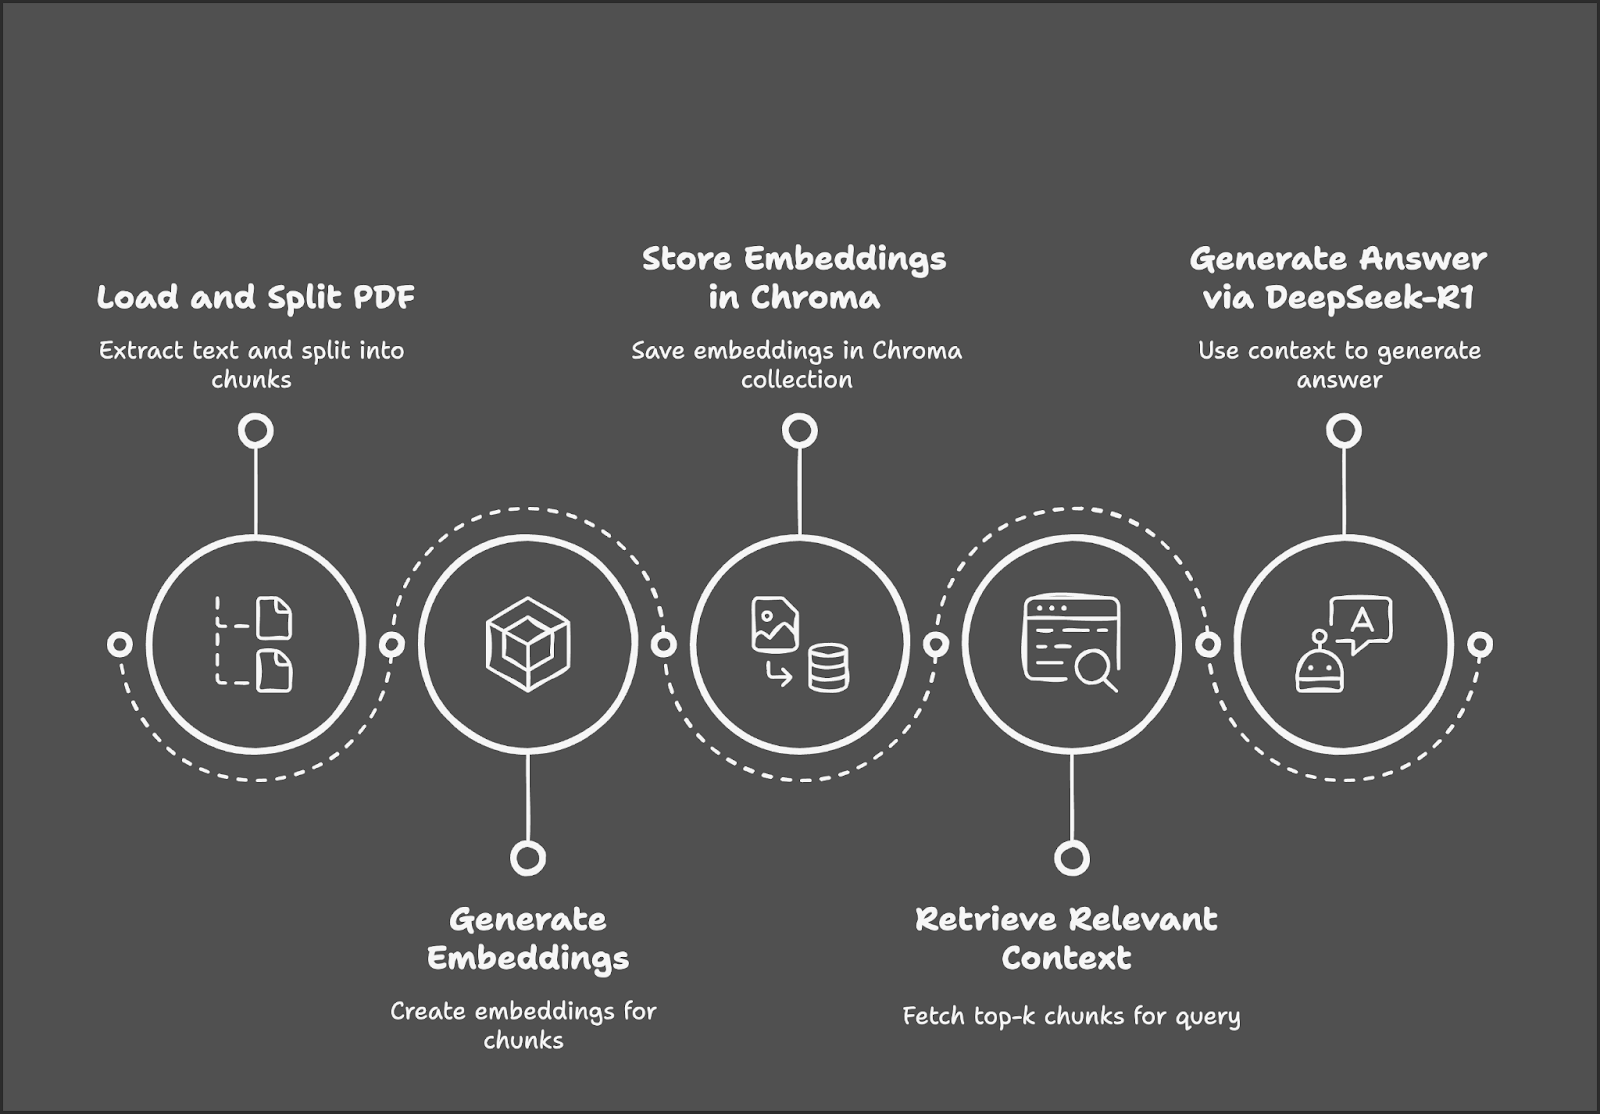
Het proces begint met het laden en opdelen van een PDF in tekstfragmenten, gevolgd door het genereren van embeddings voor die fragmenten. Deze embeddings worden opgeslagen in een Chroma-database voor efficiënt ophalen. Wanneer een gebruiker een vraag stelt, haalt het systeem de meest relevante tekstfragmenten op en gebruikt DeepSeek-R1 om een antwoord te genereren op basis van de opgehaalde context.
Voordat we beginnen, controleren we of de volgende tools en libraries zijn geïnstalleerd:
Voer de volgende commando’s uit om de benodigde dependencies te installeren:
!pip install langchain chromadb gradio ollama pymypdf
!pip install -U langchain-community
Zodra bovenstaande dependencies zijn geïnstalleerd, voer je de volgende importcommando’s uit:
import ollama
import re
import gradio as gr
from concurrent.futures import ThreadPoolExecutor
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import PyMuPDFLoader
from langchain_community.embeddings import OllamaEmbeddings
from chromadb.config import Settings
from chromadb import Client
from langchain.vectorstores import ChromaWe gebruiken LangChains PyMuPDFLoader om tekst te extraheren uit de PDF-versie van het boek Foundations of LLMs van Tong Xiao en Jingbo Zhu—dit is een wiskunde-intensief boek, dus onze chatbot moet de wiskunde achter LLM’s goed kunnen uitleggen. Je vindt het boek op arXiv.
# Load the document using PyMuPDFLoader
loader = PyMuPDFLoader("/path/to/Foundations_of_llms.pdf")

documents = loader.load()
Zodra het document is geladen, kunnen we de tekst in fragmenten verdelen voor verdere verwerking.
We splitsen de geëxtraheerde tekst in kleinere, overlappende fragmenten voor betere contextophaling. Je kunt de grootte van het fragment en de overlap variëren naar wens binnen de functie RecursiveCharacterTextSpilitter().
# Split the document into smaller chunks
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)

chunks = text_splitter.split_documents(documents)
Nu hebben we de tekstfragmenten die klaar zijn om omgezet te worden in embeddings.
We gebruiken Ollama Embeddings op basis van DeepSeek-R1 om de documentembeddings te genereren. Afhankelijk van de grootte van het document kan het genereren van embeddings tijd kosten, dus het is aan te raden dit te paralleliseren voor snellere verwerking.
Let op: model="deepseek-r1" gebruikt standaard het 7B-parametermodel. Je kunt dit aanpassen naar 8B, 14B, 32B, 70B of 671B. Vervang X in de volgende modelnaam door de modelgrootte: model="deepseek-r1:X"
# Initialize Ollama embeddings using DeepSeek-R1
embedding_function = OllamaEmbeddings(model="deepseek-r1")
# Parallelize embedding generation
def generate_embedding(chunk):
    return embedding_function.embed_query(chunk.page_content)
with ThreadPoolExecutor() as executor:
    embeddings = list(executor.map(generate_embedding, chunks))
Bovenstaande functie initialiseert DeepSeek-R1 via Ollama om hoog-dimensionale semantische embeddings te genereren, die later gebruikt worden voor op gelijkenis gebaseerde documentophaal.
De functie generate_embedding() neemt de tekst van een documentfragment en genereert de embedding. Tot slot past ThreadPoolExecutor() generate_embedding() gelijktijdig toe op elk fragment, waarbij embeddings in een lijst worden verzameld voor snellere verwerking dan sequentiële uitvoering.
We slaan de embeddings en bijbehorende tekstfragmenten op in een high-performance vectordatabase, Chroma.
# Initialize Chroma client and create/reset the collection
client = Client(Settings())
client.delete_collection(name="foundations_of_llms")  # Delete existing collection (if any)
collection = client.create_collection(name="foundations_of_llms")
# Add documents and embeddings to Chroma
for idx, chunk in enumerate(chunks):
    collection.add(
        documents=[chunk.page_content],
        metadatas=[{'id': idx}],
        embeddings=[embeddings[idx]],
        ids=[str(idx)]  # Ensure IDs are strings
    )
We volgen deze stappen om embeddings op te slaan:
Client(Settings()) initialiseert je de Chroma-client om de vectorstore te beheren. client.delete_collection() om fouten te voorkomen. Maak vervolgens met client.create_collection() een nieuwe collectie om de documentfragmenten en hun embeddings op te slaan.collection.add() het volgende op:chunk.page_content){'id': idx}) om naar het fragment te verwijzenDeze setup zorgt ervoor dat elk documentfragment correct wordt geïndexeerd voor efficiënt, vectorgebaseerd ophalen.
We initialiseren de Chroma-retriever en zorgen dat deze dezelfde DeepSeek-R1-embeddings voor queries gebruikt.
# Initialize retriever using Ollama embeddings for queries
retriever = Chroma(collection_name="foundations_of_llms", client=client, embedding_function=embedding_function).as_retriever()
De Chroma-retriever verbindt met de collectie "foundations_of_llms" en gebruikt DeepSeek-R1-embeddings via Ollama om gebruikersvragen te embedden. Op basis van vectorgelijkenis haalt hij de meest relevante documentfragmenten op voor contextbewuste antwoorden.
Vervolgens halen we de meest relevante tekstfragmenten op en formatteren we ze voor DeepSeek-R1 om antwoorden te genereren.
def retrieve_context(question):
    # Retrieve relevant documents
    results = retriever.invoke(question)
    # Combine the retrieved content
    context = "\n\n".join([doc.page_content for doc in results])
    return context
De functie retrieve_context embedt de gebruikersvraag met DeepSeek-R1 en haalt via de Chroma-retriever de meest relevante documentfragmenten op. Vervolgens wordt de inhoud van de opgehaalde fragmenten samengevoegd tot één contextstring voor verdere verwerking.
We hebben nu de vraag en de opgehaalde context. Stuur dit vervolgens naar DeepSeek-R1 via Ollama voor ons definitieve antwoord.
def query_deepseek(question, context):
    # Format the input prompt
    formatted_prompt = f"Question: {question}\n\nContext: {context}"
    # Query DeepSeek-R1 using Ollama
    response = embedding_function.chat(
        model="deepseek-r1",
        messages=[{'role': 'user', 'content': formatted_prompt}]
    )
    # Clean and return the response
    response_content = response['message']['content']
    final_answer = re.sub(r'<think>.*?</think>', '', response_content, flags=re.DOTALL).strip()
    return final_answer
Om het definitieve antwoord te krijgen, combineren we eerst de gebruikersvraag en de opgehaalde context in een gestructureerde prompt. Vervolgens sturen we deze prompt naar het DeepSeek-R1-model via Ollama om een reactie te ontvangen. Om de uitvoer netjes te maken, verwijderen we overbodige tags en geven we het eindantwoord terug.
De RAG-pijplijn staat. Nu gebruiken we Gradio om een interactieve interface te maken waarmee gebruikers vragen kunnen stellen over de kennisbank (in dit geval Foundations of LLMs).
def ask_question(question):
    # Retrieve context and generate an answer using RAG
    context = retrieve_context(question)
    answer = query_deepseek(question, context)
    return answer
# Set up the Gradio interface
interface = gr.Interface(
    fn=ask_question,
    inputs="text",
    outputs="text",
    title="RAG Chatbot: Foundations of LLMs",
    description="Ask any question about the Foundations of LLMs book. Powered by DeepSeek-R1."
)
interface.launch()
De functie ask_question() haalt relevante context op via de Chroma-retriever en genereert het eindantwoord met DeepSeek-R1. De Gradio-interface, gebouwd met gr.Interface(), maakt het mogelijk om interactief vragen te stellen en contextueel nauwkeurige, onderbouwde antwoorden te ontvangen.
Gefeliciteerd! Je hebt nu een lokaal draaiende chatbot die alles over LLM’s kan bespreken.
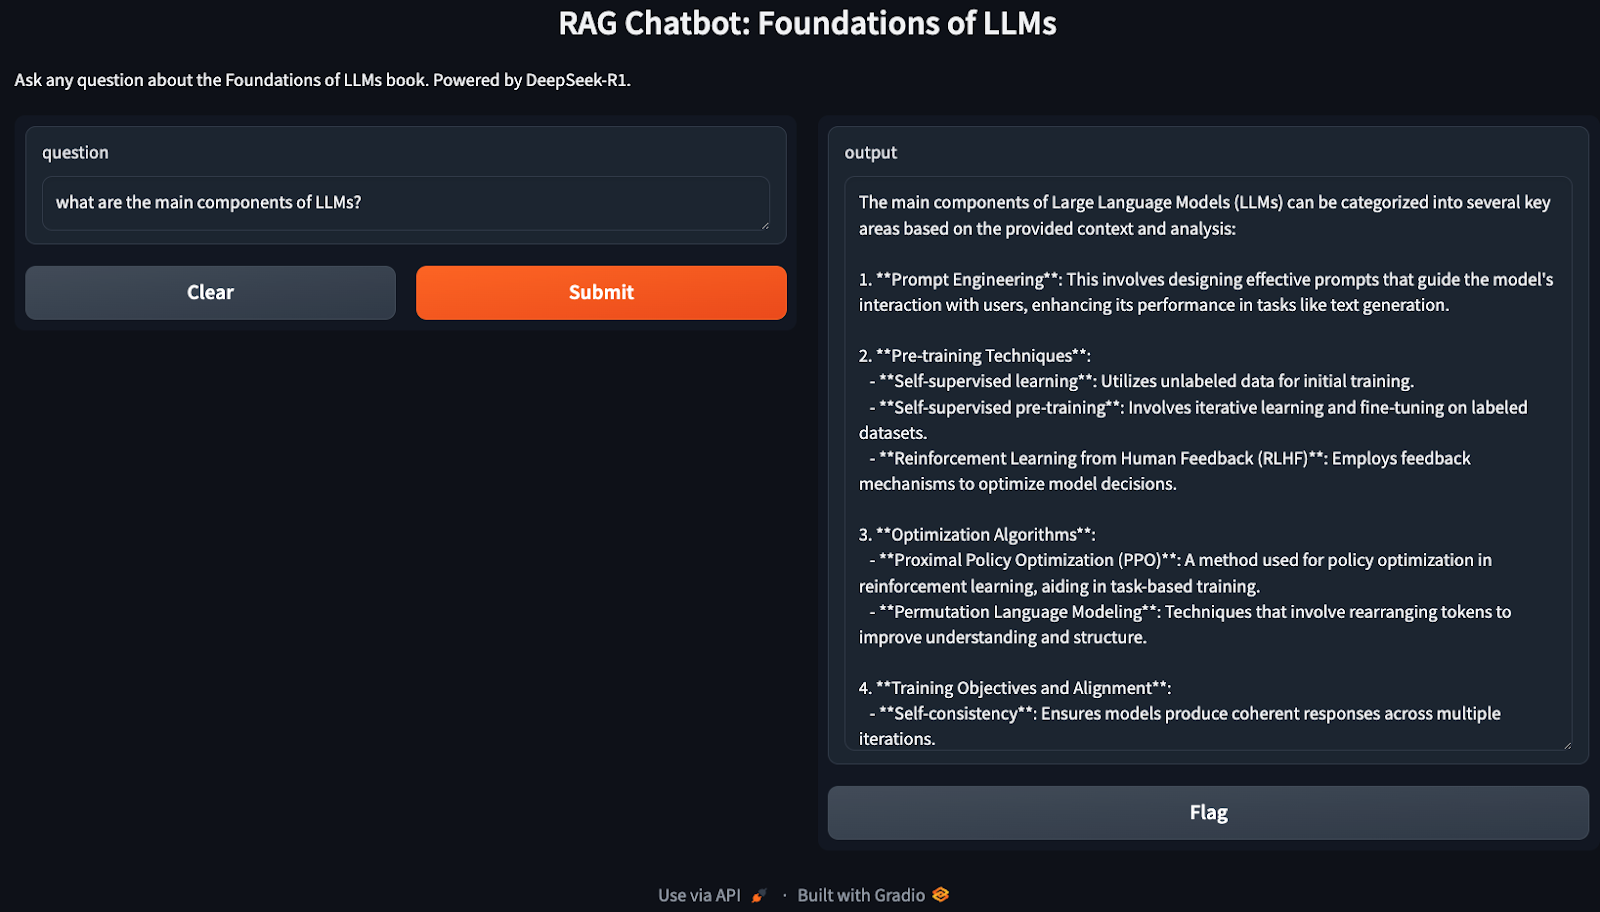
Bovenstaande demo dekt een heel basale RAG-implementatie, die je verder kunt optimaliseren voor efficiëntie. Probeer bijvoorbeeld het volgende:
chunk_size en chunk_overlap aan om performance en ophaalkwaliteit in balans te brengen.In deze tutorial bouwden we een lokale RAG-chatbot met DeepSeek-R1 en Chroma voor retrieval, wat zorgt voor nauwkeurige, contextueel rijke antwoorden op vragen op basis van een grote kennisbank.
Wil je meer leren over DeepSeek? Dan raad ik deze blogs aan:
Leer AI met deze cursussen!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

