

RAG के साथ DeepSeek-R1 क्यों उपयोग करें?
DeepSeek-R1 अनुकूलित प्रदर्शन, उन्नत वेक्टर सर्च क्षमताओं, और लोकल सेटअप से लेकर स्केलेबल डेप्लॉयमेंट तक विभिन्न परिवेशों में लचीलापन होने के कारण RAG-आधारित सिस्टम्स के लिए आदर्श है। इसके प्रभावी होने के कुछ कारण:
- हाई-परफॉर्मेंस रीट्रीवल: DeepSeek-R1 बड़े डॉक्यूमेंट संग्रह को कम विलंबता के साथ संभालता है।
- सूक्ष्म-स्तरीय प्रासंगिकता रैंकिंग: यह सैमांटिक समानता की गणना करके अंशों की सटीक रीट्रीवल सुनिश्चित करता है।
- लागत और गोपनीयता लाभ: आप DeepSeek-R1 को लोकल चलाकर API शुल्क से बच सकते हैं और संवेदनशील डेटा सुरक्षित रख सकते हैं।
- आसान एकीकरण: यह Chroma जैसे वेक्टर डेटाबेस के साथ आसानी से इंटीग्रेट हो जाता है।
- ऑफ़लाइन क्षमताएँ: DeepSeek-R1 के साथ आप ऐसे रीट्रीवल सिस्टम बना सकते हैं जो मॉडल डाउनलोड होने के बाद बिना इंटरनेट के भी काम करें।
अवलोकन: DeepSeek-R1 के साथ RAG चैटबॉट बनाना
हमारा डेमो प्रोजेक्ट DeepSeek-R1 और Gradio का उपयोग करके RAG चैटबॉट बनाने पर केंद्रित है।
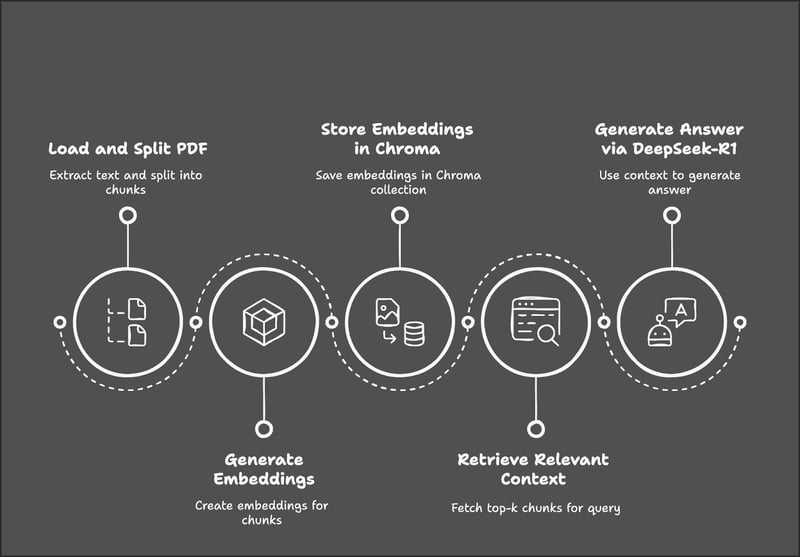
प्रक्रिया PDF को लोड कर उसे टेक्स्ट अंशों में विभाजित करने से शुरू होती है, फिर उन अंशों के लिए एंबेडिंग्स जेनरेट की जाती हैं। ये एंबेडिंग्स कुशल रीट्रीवल के लिए Chroma डेटाबेस में संग्रहीत की जाती हैं। जब उपयोगकर्ता क्वेरी सबमिट करता है, तो सिस्टम सबसे प्रासंगिक टेक्स्ट अंशों को पुनर्प्राप्त करता है और प्राप्त संदर्भ के आधार पर DeepSeek-R1 से उत्तर उत्पन्न करता है।
चरण 1: आवश्यकताएँ
शुरू करने से पहले, सुनिश्चित करें कि हमारे पास निम्नलिखित टूल और लाइब्रेरी इंस्टॉल हैं:
- Python 3.8+
- Langchain
- Chromadb
- Gradio
आवश्यक डिपेंडेंसी इंस्टॉल करने के लिए निम्नलिखित कमांड चलाएँ:
!pip install langchain chromadb gradio ollama pymypdf
!pip install -U langchain-communityऊपर दी गई डिपेंडेंसी इंस्टॉल होने के बाद, निम्न इम्पोर्ट कमांड्स चलाएँ:
import ollama
import re
import gradio as gr
from concurrent.futures import ThreadPoolExecutor
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import PyMuPDFLoader
from langchain_community.embeddings import OllamaEmbeddings
from chromadb.config import Settings
from chromadb import Client
from langchain.vectorstores import Chromaचरण 2: PyMuPDFLoader का उपयोग करके PDF लोड करें
हम LangChain के PyMuPDFLoader का उपयोग करके Tong Xiao और Jingbo Zhu द्वारा लिखित Foundations of LLMs किताब के PDF संस्करण से टेक्स्ट निकालेंगे—यह गणित-प्रधान किताब है, जिसका अर्थ है कि हमारा चैटबॉट LLMs के पीछे के गणित को अच्छी तरह समझा सके। आप यह किताब arXiv पर पा सकते हैं।
# Load the document using PyMuPDFLoader
loader = PyMuPDFLoader("/path/to/Foundations_of_llms.pdf")
documents = loader.load()डॉक्यूमेंट लोड होने के बाद, हम आगे की प्रोसेसिंग के लिए टेक्स्ट को अंशों में बाँटना शुरू कर सकते हैं।
चरण 3: डॉक्यूमेंट को छोटे अंशों में बाँटें
बेहतर संदर्भ रीट्रीवल के लिए हम निकाले गए टेक्स्ट को छोटे, ओवरलैपिंग अंशों में बाँटेंगे। आप अपने सिस्टम के अनुसार RecursiveCharacterTextSpilitter() फंक्शन में chunk size और chunk overlap का आकार बदल सकते हैं।
# Split the document into smaller chunks
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
chunks = text_splitter.split_documents(documents)अब हमारे पास निकाले गए टेक्स्ट के अंश हैं, जिन्हें एंबेडिंग्स में बदला जाना है।
चरण 4: DeepSeek-R1 का उपयोग करके एंबेडिंग्स जेनरेट करें
हम डॉक्यूमेंट एंबेडिंग्स बनाने के लिए DeepSeek-R1 आधारित Ollama Embeddings का उपयोग करेंगे। डॉक्यूमेंट के आकार के अनुसार एंबेडिंग जेनरेशन में समय लग सकता है, इसलिए तेज़ प्रोसेसिंग के लिए इसे पैरेलल करना बेहतर है।
ध्यान दें: model="deepseek-r1" डिफ़ॉल्ट रूप से 7B पैरामीटर मॉडल मानता है। आप आवश्यकता अनुसार इसे 8B, 14B, 32B, 70B, या 671B में बदल सकते हैं। निम्न मॉडल नाम में X को मॉडल साइज से बदलें: model="deepseek-r1:X"
# Initialize Ollama embeddings using DeepSeek-R1
embedding_function = OllamaEmbeddings(model="deepseek-r1")
# Parallelize embedding generation
def generate_embedding(chunk):
return embedding_function.embed_query(chunk.page_content)
with ThreadPoolExecutor() as executor:
embeddings = list(executor.map(generate_embedding, chunks))उपरोक्त फंक्शन Ollama के माध्यम से DeepSeek-R1 को इनिशियलाइज़ कर उच्च-आयामी सैमांटिक एंबेडिंग्स जेनरेट करता है, जिनका उपयोग आगे समानता-आधारित डॉक्यूमेंट रीट्रीवल में होगा।
फंक्शन generate_embedding() डॉक्यूमेंट अंश के टेक्स्ट को लेता है और उसकी एंबेडिंग बनाता है। अंततः, ThreadPoolExecutor() प्रत्येक अंश पर एक साथ generate_embedding() लागू करता है, जिससे क्रमिक निष्पादन की तुलना में तेज़ प्रोसेसिंग होती है।
चरण 5: एंबेडिंग्स को Chroma वेक्टर स्टोर में संग्रहीत करें
हम एंबेडिंग्स और संबंधित टेक्स्ट अंशों को हाई-परफॉर्मेंस वेक्टर डेटाबेस Chroma में संग्रहीत करेंगे।
# Initialize Chroma client and create/reset the collection
client = Client(Settings())
client.delete_collection(name="foundations_of_llms") # Delete existing collection (if any)
collection = client.create_collection(name="foundations_of_llms")
# Add documents and embeddings to Chroma
for idx, chunk in enumerate(chunks):
collection.add(
documents=[chunk.page_content],
metadatas=[{'id': idx}],
embeddings=[embeddings[idx]],
ids=[str(idx)] # Ensure IDs are strings
)एंबेडिंग्स स्टोर करने के लिए हम इन चरणों का पालन करते हैं:
1. Chroma क्लाइंट इनिशियलाइज़ करें और कलेक्शन रीसेट करें:
Client(Settings())वेक्टर स्टोर प्रबंधन के लिए Chroma क्लाइंट इनिशियलाइज़ करता है।- त्रुटियों से बचने के लिए
client.delete_collection()का उपयोग कर अपने कलेक्शन नाम जैसा कोई मौजूदा कलेक्शन हटा दें। अंत में, डॉक्यूमेंट अंश और उनकी एंबेडिंग्स स्टोर करने के लिएclient.create_collection()से नया कलेक्शन बनाएँ।
2. डॉक्यूमेंट अंशों पर इटरेट करें:
- प्रत्येक डॉक्यूमेंट अंश और उसकी संबंधित एंबेडिंग पर उसकी यूनिक स्ट्रिंग ID का उपयोग करते हुए इटरेट करें।
3. Chroma में अंश और एंबेडिंग्स जोड़ें:
- प्रत्येक अंश के लिए,
collection.add()स्टोर करता है: - डॉक्यूमेंट कंटेंट (
chunk.page_content) - मेटाडेटा (
{'id': idx}) अंश को संदर्भित करने के लिए - उसका संबंधित एंबेडिंग वेक्टर रीट्रीवल के लिए
- एंट्री की पहचान हेतु एक यूनिक ID स्ट्रिंग
यह सेटअप सुनिश्चित करता है कि प्रत्येक डॉक्यूमेंट अंश को कुशल वेक्टर-आधारित रीट्रीवल के लिए सही तरीके से इंडेक्स किया गया है।
चरण 6: रिट्रीवर इनिशियलाइज़ करें
हम Chroma रिट्रीवर इनिशियलाइज़ करेंगे, यह सुनिश्चित करते हुए कि यह क्वेरी के लिए वही DeepSeek-R1 एंबेडिंग्स का उपयोग करे।
# Initialize retriever using Ollama embeddings for queries
retriever = Chroma(collection_name="foundations_of_llms", client=client, embedding_function=embedding_function).as_retriever()Chroma रिट्रीवर "foundations_of_llms" कलेक्शन से जुड़ता है और Ollama के माध्यम से DeepSeek-R1 एंबेडिंग्स का उपयोग कर उपयोगकर्ता क्वेरीज़ को एंबेड करता है। यह वेक्टर समानता के आधार पर सबसे प्रासंगिक डॉक्यूमेंट अंशों को पुनर्प्राप्त करता है ताकि संदर्भ-सचेत उत्तर दिए जा सकें।
चरण 7: RAG पाइपलाइन परिभाषित करें
अगला कदम, सबसे प्रासंगिक टेक्स्ट अंशों को रीट्रीव करना और DeepSeek-R1 के लिए उन्हें उत्तर जनरेट करने हेतु फॉर्मेट करना है।
def retrieve_context(question):
# Retrieve relevant documents
results = retriever.invoke(question)
# Combine the retrieved content
context = "\n\n".join([doc.page_content for doc in results])
return contextफंक्शन retrieve_context DeepSeek-R1 का उपयोग करके उपयोगकर्ता क्वेरी को एंबेड करता है और Chroma रिट्रीवर के ज़रिए शीर्ष प्रासंगिक डॉक्यूमेंट अंशों को लाता है। फिर यह प्राप्त अंशों की सामग्री को जोड़कर एक एकल संदर्भ स्ट्रिंग बनाता है।
चरण 8: संदर्भित उत्तरों के लिए DeepSeek-R1 से क्वेरी करें
अब हमारे पास प्रश्न और प्राप्त संदर्भ है। अगला कदम, इसे अंतिम उत्तर के लिए Ollama के माध्यम से DeepSeek-R1 को भेजना है।
def query_deepseek(question, context):
# Format the input prompt
formatted_prompt = f"Question: {question}\n\nContext: {context}"
# Query DeepSeek-R1 using Ollama
response = embedding_function.chat(
model="deepseek-r1",
messages=[{'role': 'user', 'content': formatted_prompt}]
)
# Clean and return the response
response_content = response['message']['content']
final_answer = re.sub(r'<think>.*?</think>', '', response_content, flags=re.DOTALL).strip()
return final_answerअंतिम उत्तर प्राप्त करने के लिए, हम उपयोगकर्ता प्रश्न और प्राप्त संदर्भ को एक संरचित प्रॉम्प्ट में संयोजित करते हैं। फिर इस प्रॉम्प्ट को Ollama के माध्यम से DeepSeek-R1 मॉडल को भेजते हैं और प्रतिक्रिया प्राप्त करते हैं। अंतिम आउटपुट को प्रस्तुत करने योग्य बनाने के लिए, हम अनावश्यक टैग हटाकर अंतिम उत्तर लौटाते हैं।
चरण 9: Gradio इंटरफेस बनाएँ
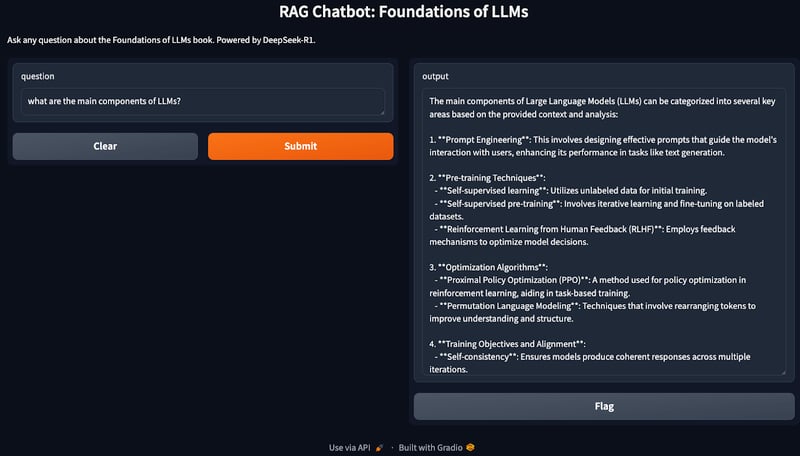
हमारी RAG पाइपलाइन तैयार है। अब, हम Gradio का उपयोग करके एक इंटरैक्टिव इंटरफेस बनाएँगे ताकि उपयोगकर्ता इसके नॉलेज बेस (यहाँ Foundations of LLMs) से जुड़े प्रश्न पूछ सकें।
def ask_question(question):
# Retrieve context and generate an answer using RAG
context = retrieve_context(question)
answer = query_deepseek(question, context)
return answer
# Set up the Gradio interface
interface = gr.Interface(
fn=ask_question,
inputs="text",
outputs="text",
title="RAG Chatbot: Foundations of LLMs",
description="Ask any question about the Foundations of LLMs book. Powered by DeepSeek-R1."
)
interface.launch()फंक्शन ask_question() Chroma रिट्रीवर का उपयोग करके प्रासंगिक संदर्भ लाता है और DeepSeek-R1 के माध्यम से अंतिम उत्तर जेनरेट करता है। gr.Interface() से निर्मित Gradio इंटरफेस उपयोगकर्ताओं को इंटरैक्टिव तरीके से प्रश्न पूछने और संदर्भ-संगत, विश्वसनीय उत्तर प्राप्त करने में सक्षम बनाता है।
बधाई! अब आपके पास एक लोकल रूप से चलने वाला चैटबॉट है जो LLMs से संबंधित किसी भी विषय पर चर्चा के लिए तैयार है।
अनुकूलन
ऊपर दिया गया डेमो RAG का एक बहुत बुनियादी इम्प्लीमेंटेशन कवर करता है, जिसे दक्षता के लिए और अनुकूलित किया जा सकता है। आज़माने के लिए कुछ सुझाव:
- चंक साइज़ समायोजन: प्रदर्शन और रीट्रीवल गुणवत्ता के बीच संतुलन के लिए
chunk_sizeऔरchunk_overlapपैरामीटर समायोजित करें। - छोटे मॉडल संस्करण: यदि DeepSeek-R1 संसाधन-गहन है, तो आप Ollama के माध्यम से अलग संस्करण (deepseek-r1:7b या deepseek-r1:8b या deepseek-r1:14b) उपयोग कर सकते हैं।
- Faiss के साथ स्केल करें: बड़े डॉक्यूमेंट्स के लिए तेज़ रीट्रीवल हेतु Faiss इंटीग्रेट करने पर विचार करें।
- बैच प्रोसेसिंग: यदि एंबेडिंग जेनरेशन धीमा है, तो दक्षता बढ़ाने के लिए अंशों को बैच में प्रोसेस करें।
निष्कर्ष
इस ट्यूटोरियल में, हमने DeepSeek-R1 और Chroma का उपयोग करके एक लोकल RAG-आधारित चैटबॉट बनाया, जो बड़े नॉलेज बेस पर आधारित प्रश्नों के सटीक और संदर्भ-समृद्ध उत्तर सुनिश्चित करता है।
DeepSeek के बारे में और जानने के लिए, मैं ये ब्लॉग सुझाता/सुझाती हूँ:

मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।
रीट्रीवल-ऑगमेंटेड जेनरेशन (RAG) बाहरी स्रोतों से ज्ञान को पुनर्प्राप्त कर उसे एकीकृत करके सटीक, तथ्य-आधारित और संदर्भ-संगत उत्तर उत्पन्न करने वाले AI अनुप्रयोग बनाने की एक शक्तिशाली विधि के रूप में उभरा है।
इस ट्यूटोरियल में, मैं चरण-दर-चरण समझाऊंगा कि DeepSeek-R1 और LLMs की नींव पर आधारित एक किताब को नॉलेज बेस बनाकर RAG-आधारित चैटबॉट कैसे बनाया जाए। ट्यूटोरियल के अंत तक, आप एक लोकल RAG एप्लिकेशन बना सकेंगे जो किताब से जुड़े प्रश्नों के उत्तर दे और Gradio इंटरफेस के माध्यम से उपयोगकर्ताओं के साथ संवाद कर सके।