
Kurs
LangChain ile Retrieval Augmented Generation (RAG)
3 sa
20.8K
DeepSeek-R1, optimize edilmiş performansı, gelişmiş vektör arama yetenekleri ve yerel kurulumlardan ölçeklenebilir dağıtımlara kadar farklı ortamlarda sunduğu esneklik sayesinde RAG tabanlı sistemler için ideal bir seçenektir. İşte etkili olmasının bazı nedenleri:
Demo projemiz, DeepSeek-R1 ve Gradio kullanarak bir RAG sohbet botu oluşturmayı hedefliyor.
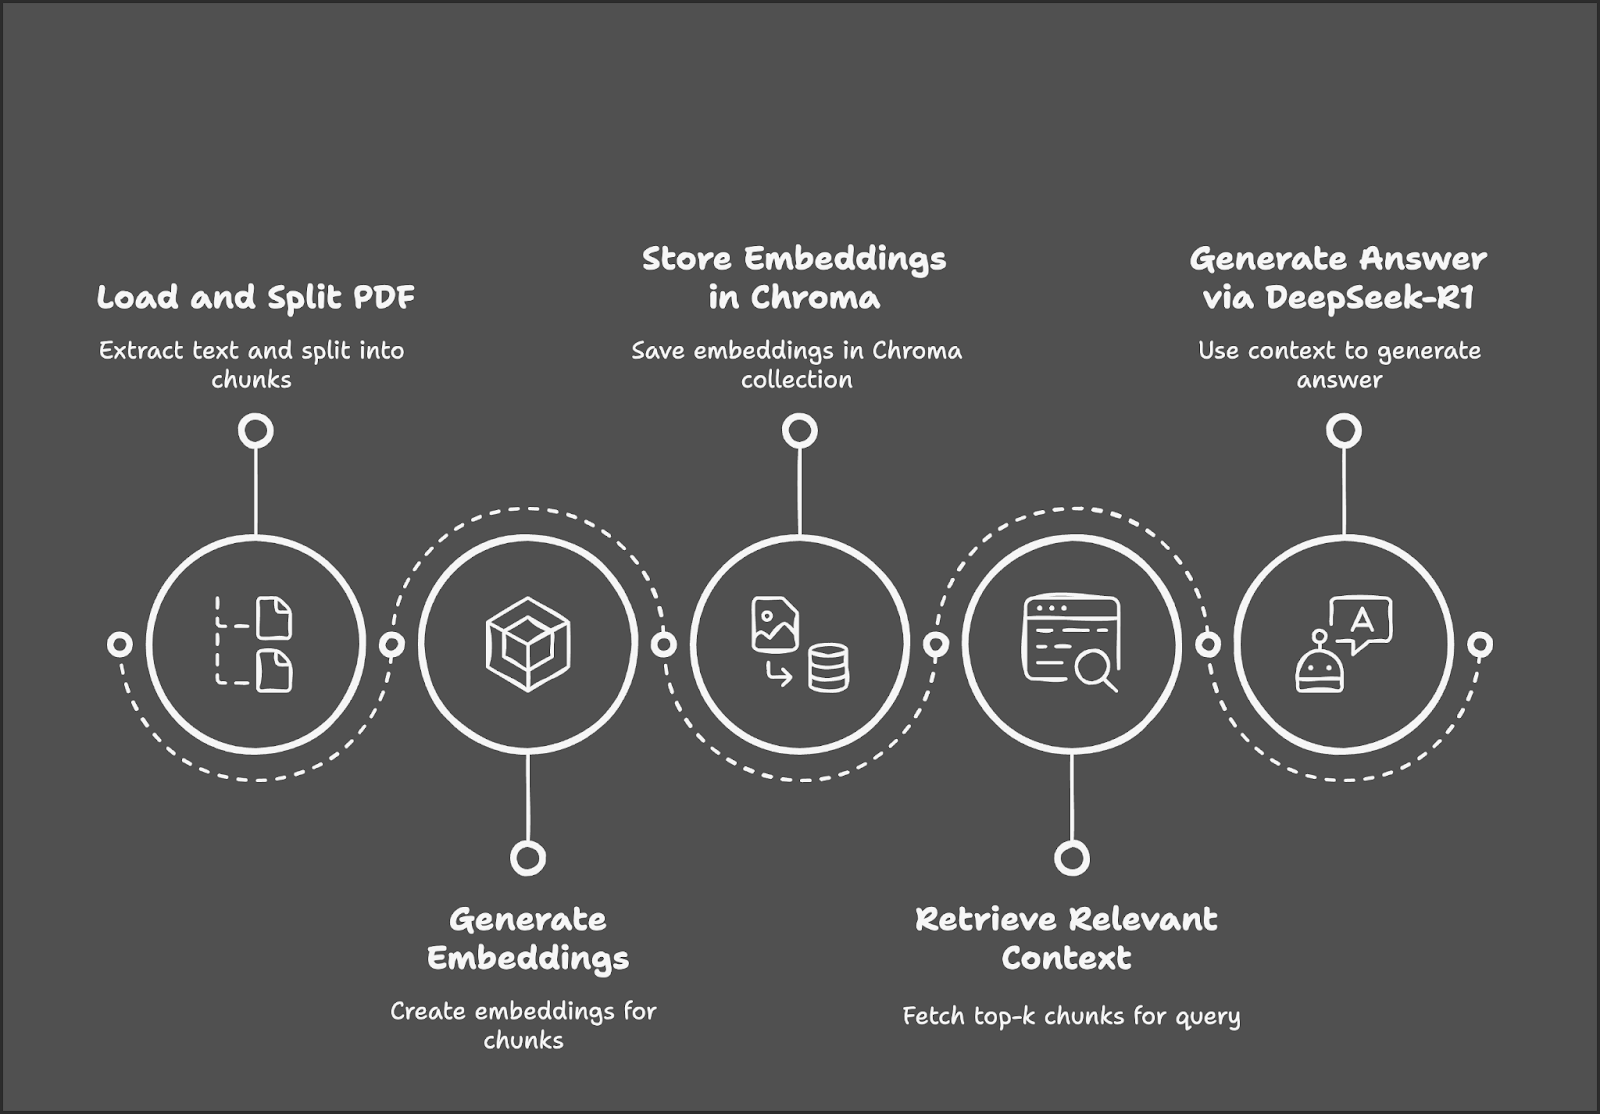
Süreç, bir PDF’yi yükleyip metin parçalarına ayırmakla başlar; ardından bu parçalar için gömme (embedding) vektörleri üretilir. Bu gömmeler, verimli getirme için bir Chroma veritabanında saklanır. Bir kullanıcı sorgu gönderdiğinde, sistem en alakalı metin parçalarını getirir ve DeepSeek-R1’ı kullanarak getirilen bağlama dayalı bir yanıt üretir.
Başlamadan önce aşağıdaki araç ve kütüphanelerin yüklü olduğundan emin olalım:
Gerekli bağımlılıkları kurmak için aşağıdaki komutları çalıştırın:
!pip install langchain chromadb gradio ollama pymypdf
!pip install -U langchain-community
Yukarıdaki bağımlılıklar kurulduktan sonra şu içe aktarma komutlarını çalıştırın:
import ollama
import re
import gradio as gr
from concurrent.futures import ThreadPoolExecutor
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import PyMuPDFLoader
from langchain_community.embeddings import OllamaEmbeddings
from chromadb.config import Settings
from chromadb import Client
from langchain.vectorstores import ChromaKitabın PDF sürümünden metin çıkarmak için LangChain’in PyMuPDFLoader aracını kullanacağız: Tong Xiao ve Jingbo Zhu’nun Foundations of LLMs kitabı — yoğun matematik içeren bu kitap, sohbet botumuzun LLM’lerin arkasındaki matematiği iyi açıklayabilmesi gerektiği anlamına gelir. Kitabı arXiv’de bulabilirsiniz.
# Load the document using PyMuPDFLoader
loader = PyMuPDFLoader("/path/to/Foundations_of_llms.pdf")

documents = loader.load()
Belge yüklendikten sonra metni daha ileri işlem için parçalara ayırmaya başlayabiliriz.
Daha iyi bağlam getirimi için çıkarılan metni daha küçük, üst üste binen parçalara ayıracağız. Sistem gereksinimlerinize göre RecursiveCharacterTextSpilitter() işlevi içinde parça boyutunu ve parça örtüşmesini değiştirebilirsiniz.
# Split the document into smaller chunks
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)

chunks = text_splitter.split_documents(documents)
Artık, gömmelere dönüştürmeye hazır çıkarılmış metin parçalarına sahibiz.
Belge gömmelerini üretmek için DeepSeek-R1 tabanlı Ollama Embeddings’i kullanacağız. Belgenin boyutuna bağlı olarak gömme üretimi zaman alabilir; bu yüzden daha hızlı işlem için paralelleştirmek tercih edilir.
Not: Varsayılan olarak model="deepseek-r1", 7B parametreli modeli dikkate alır. Gerekirse 8B, 14B, 32B, 70B veya 671B olarak değiştirebilirsiniz. Aşağıdaki model adında X’i model boyutuyla değiştirin: model="deepseek-r1:X"
# Initialize Ollama embeddings using DeepSeek-R1
embedding_function = OllamaEmbeddings(model="deepseek-r1")
# Parallelize embedding generation
def generate_embedding(chunk):
    return embedding_function.embed_query(chunk.page_content)
with ThreadPoolExecutor() as executor:
    embeddings = list(executor.map(generate_embedding, chunks))
Yukarıdaki işlev, Ollama aracılığıyla DeepSeek-R1’ı başlatarak yüksek boyutlu anlamsal gömmeler üretir; bu gömmeler daha sonra benzerliğe dayalı belge getirme için kullanılacaktır.
generate_embedding() işlevi, bir belge parçasının metnini alır ve onun gömmesini üretir. Son olarak, ThreadPoolExecutor(), generate_embedding() işlevini her parçaya eşzamanlı olarak uygular ve sıralı yürütmeye kıyasla daha hızlı işleme için gömmeleri bir listede toplar.
Gömme vektörlerini ve karşılık gelen metin parçalarını yüksek performanslı vektör veritabanı Chroma’da saklayacağız.
# Initialize Chroma client and create/reset the collection
client = Client(Settings())
client.delete_collection(name="foundations_of_llms")  # Delete existing collection (if any)
collection = client.create_collection(name="foundations_of_llms")
# Add documents and embeddings to Chroma
for idx, chunk in enumerate(chunks):
    collection.add(
        documents=[chunk.page_content],
        metadatas=[{'id': idx}],
        embeddings=[embeddings[idx]],
        ids=[str(idx)]  # Ensure IDs are strings
    )
Gömme vektörlerini saklamak için şu adımları izliyoruz:
Client(Settings()), vektör mağazasını yönetmek için Chroma istemcisini başlatır. client.delete_collection() ile koleksiyon adınıza benzer mevcut koleksiyonları silin. Son olarak, belge parçalarını ve gömmelerini saklamak için client.create_collection() kullanarak yeni bir koleksiyon oluşturun.collection.add() şunları saklar:chunk.page_content){'id': idx}) parçasına referans vermek içinBu kurulum, her belge parçasının verimli vektör tabanlı getirme için doğru şekilde indekslenmesini sağlar.
Chroma getiricisini başlatacağız ve sorgular için aynı DeepSeek-R1 gömmelerinin kullanılmasını sağlayacağız.
# Initialize retriever using Ollama embeddings for queries
retriever = Chroma(collection_name="foundations_of_llms", client=client, embedding_function=embedding_function).as_retriever()
Chroma getiricisi, "foundations_of_llms" koleksiyonuna bağlanır ve kullanıcı sorgularını gömmek için Ollama aracılığıyla DeepSeek-R1 gömmelerini kullanır. Bağlama duyarlı yanıtlar için vektör benzerliğine dayalı olarak en alakalı belge parçalarını getirir.
Sonraki adımda, en alakalı metin parçalarını getirip DeepSeek-R1’ın yanıt üretmesi için biçimlendireceğiz.
def retrieve_context(question):
    # Retrieve relevant documents
    results = retriever.invoke(question)
    # Combine the retrieved content
    context = "\n\n".join([doc.page_content for doc in results])
    return context
retrieve_context işlevi, kullanıcı sorgusunu DeepSeek-R1 ile gömerek Chroma getiricisi üzerinden en alakalı belge parçalarını getirir. Ardından, getirilen parçaların içeriğini bir bağlam dizesinde birleştirir.
Artık soru ve getirilen bağlama sahibiz. Şimdi bunu Ollama üzerinden DeepSeek-R1’a göndererek nihai yanıtı alalım.
def query_deepseek(question, context):
    # Format the input prompt
    formatted_prompt = f"Question: {question}\n\nContext: {context}"
    # Query DeepSeek-R1 using Ollama
    response = embedding_function.chat(
        model="deepseek-r1",
        messages=[{'role': 'user', 'content': formatted_prompt}]
    )
    # Clean and return the response
    response_content = response['message']['content']
    final_answer = re.sub(r'<think>.*?</think>', '', response_content, flags=re.DOTALL).strip()
    return final_answer
Nihai yanıtı almak için kullanıcı sorusu ve getirilen bağlamı yapılandırılmış bir istemde birleştirerek başlıyoruz. Ardından bu istemi Ollama üzerinden DeepSeek-R1 modeline gönderip yanıt alıyoruz. Çıkışın sunuma uygun olması için gereksiz etiketleri kaldırıp son yanıtı döndürüyoruz.
RAG hattımız hazır. Şimdi, kullanıcıların bilgi tabanına (bu örnekte Foundations of LLMs) ilişkin sorular sorabilmesi için Gradio ile etkileşimli bir arayüz oluşturacağız.
def ask_question(question):
    # Retrieve context and generate an answer using RAG
    context = retrieve_context(question)
    answer = query_deepseek(question, context)
    return answer
# Set up the Gradio interface
interface = gr.Interface(
    fn=ask_question,
    inputs="text",
    outputs="text",
    title="RAG Chatbot: Foundations of LLMs",
    description="Ask any question about the Foundations of LLMs book. Powered by DeepSeek-R1."
)
interface.launch()
ask_question() işlevi, Chroma getiricisini kullanarak ilgili bağlamı getirir ve son yanıtı DeepSeek-R1 üzerinden üretir. gr.Interface() ile oluşturulan Gradio arayüzü, kullanıcıların etkileşimli şekilde soru sormasını ve bağlama uygun, temellendirilmiş yanıtlar almasını sağlar.
Tebrikler! Artık LLM’lerle ilgili her şeyi tartışmaya hazır, yerelde çalışan bir sohbet botunuz var.
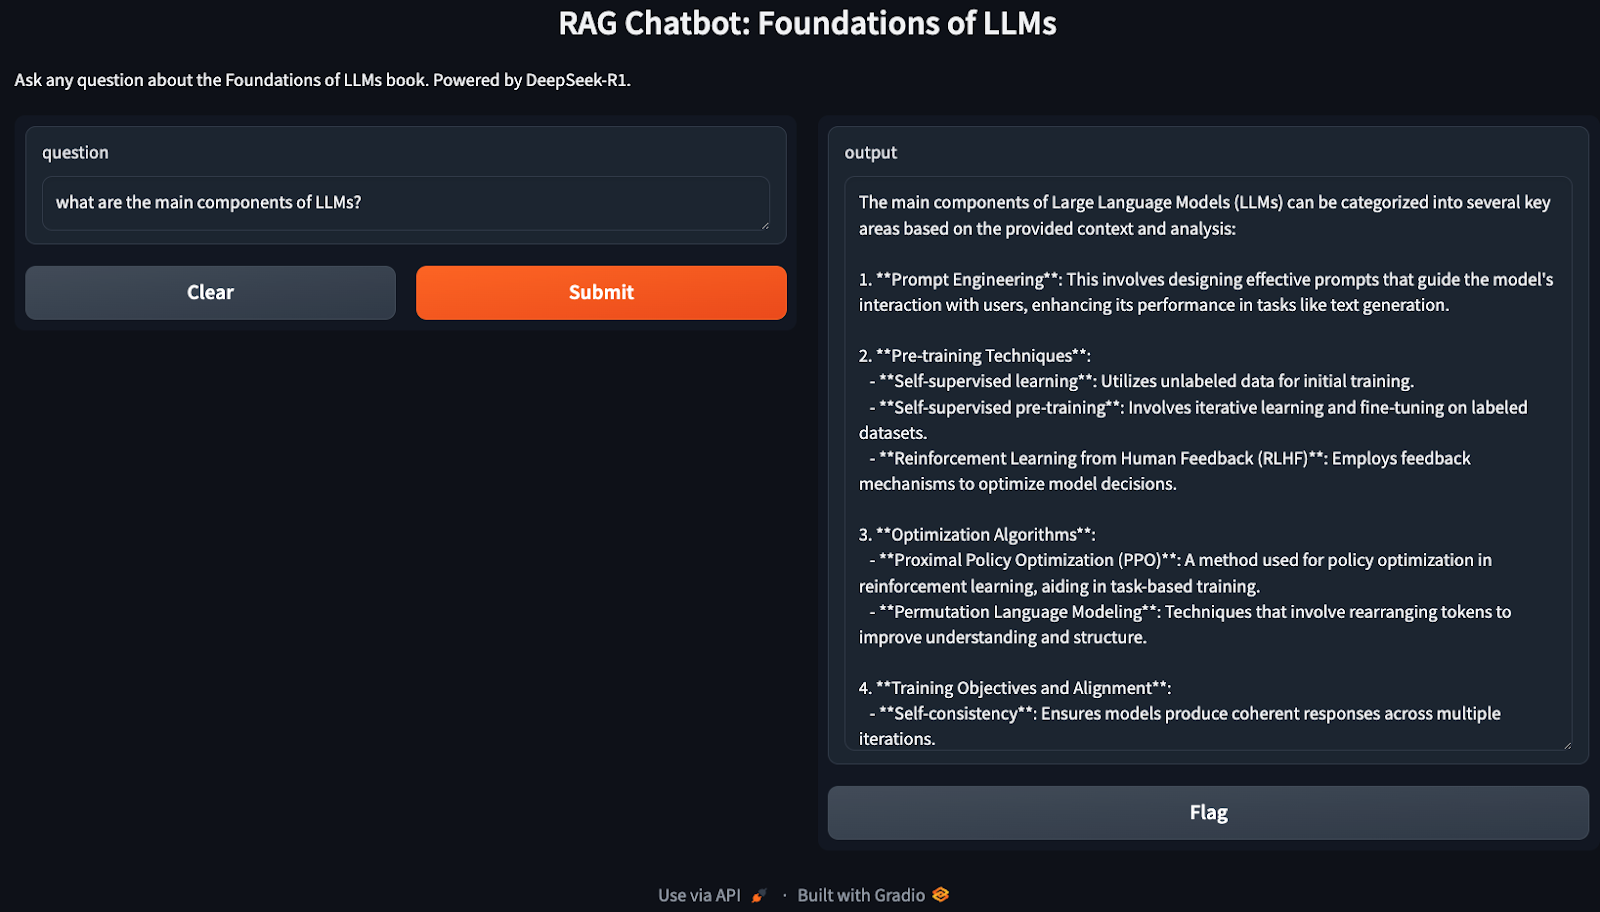
Yukarıdaki demo, daha fazla verimlilik için optimize edilebilecek oldukça temel bir RAG uygulamasını kapsıyor. Deneyebileceğiniz birkaç şey:
chunk_size ve chunk_overlap parametrelerini ayarlayın.Bu eğitimde, DeepSeek-R1 ve Chroma’yı getirme için kullanarak, geniş bir bilgi tabanına dayalı olarak doğru ve bağlamsal açıdan zengin yanıtlar sağlayan yerel bir RAG tabanlı sohbet botu oluşturduk.
DeepSeek hakkında daha fazla bilgi edinmek için şu blogları öneririm:
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



