
Khóa học
Retrieval Augmented Generation (RAG) với LangChain
3 giờ
21.3K
DeepSeek-R1 là lựa chọn lý tưởng cho hệ thống RAG nhờ hiệu năng tối ưu, năng lực tìm kiếm vector nâng cao và tính linh hoạt trên nhiều môi trường, từ cài đặt cục bộ đến triển khai mở rộng. Dưới đây là một vài lý do khiến nó hiệu quả:
Dự án demo của chúng tôi tập trung vào xây dựng chatbot RAG bằng DeepSeek-R1 và Gradio.
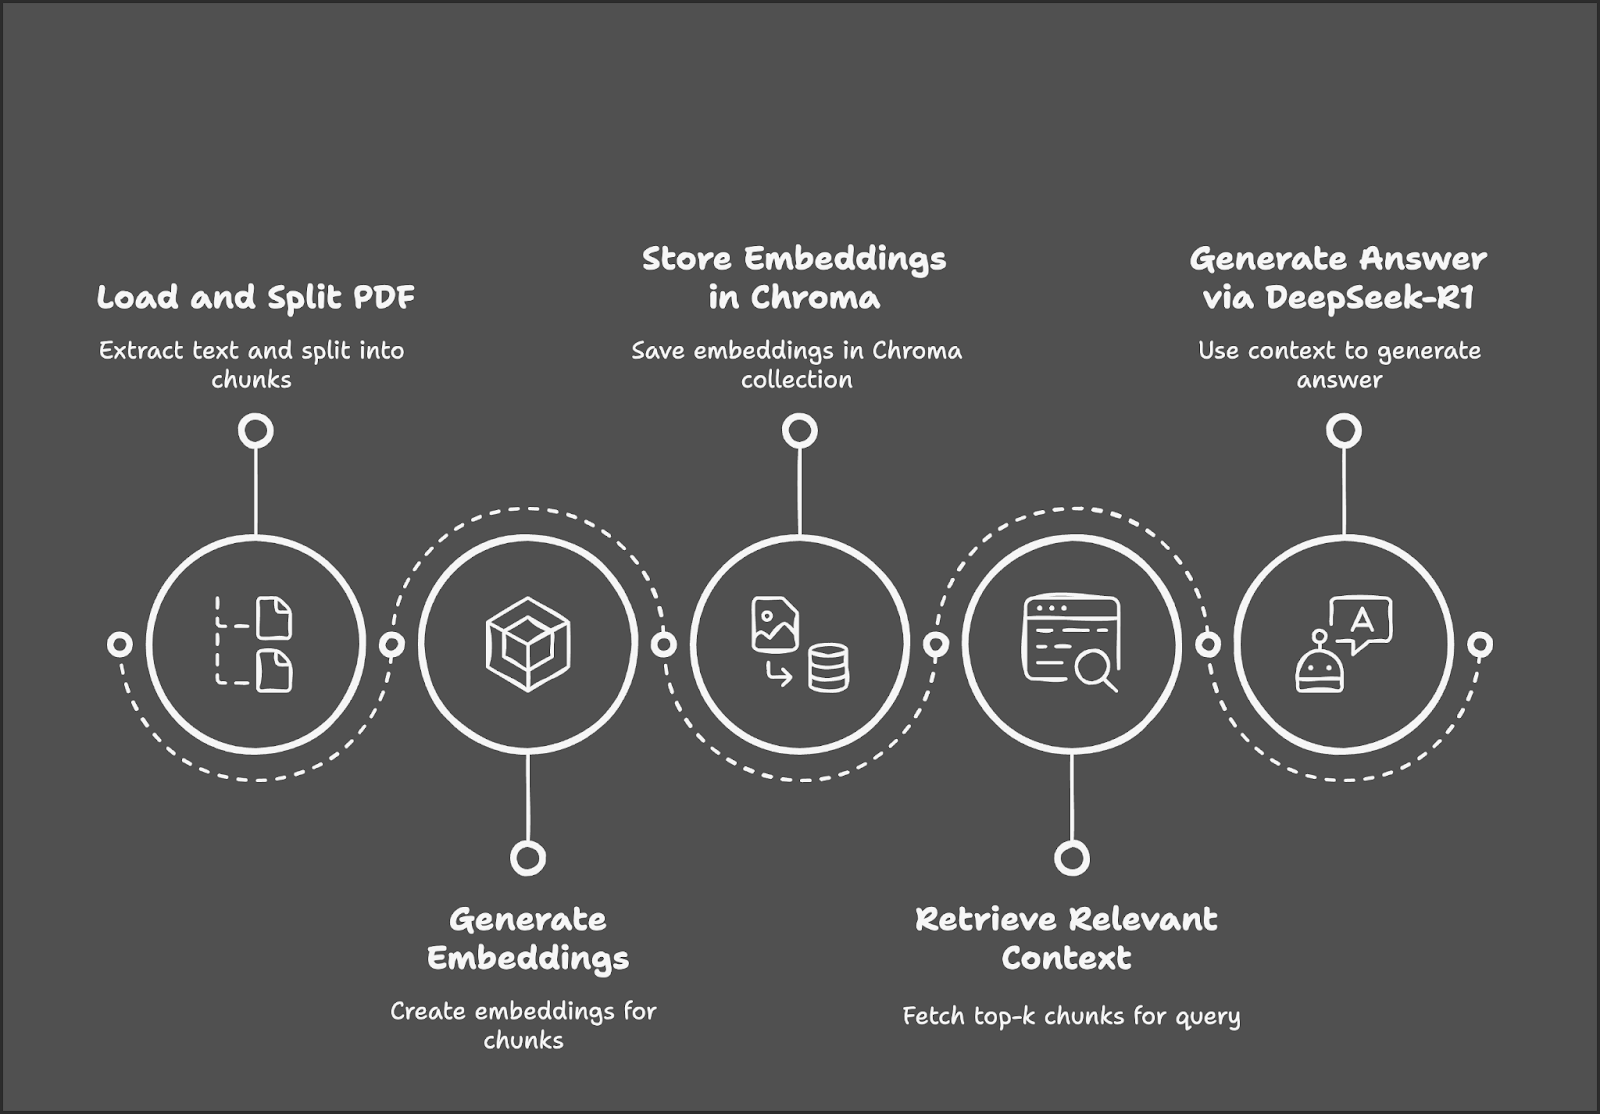
Quy trình bắt đầu bằng việc tải và chia một tệp PDF thành các đoạn văn bản nhỏ, sau đó tạo embedding cho các đoạn này. Những embedding này được lưu trong cơ sở dữ liệu Chroma để truy xuất hiệu quả. Khi người dùng gửi truy vấn, hệ thống sẽ truy xuất các đoạn văn bản liên quan nhất và dùng DeepSeek-R1 để tạo câu trả lời dựa trên ngữ cảnh đã truy xuất.
Trước khi bắt đầu, hãy đảm bảo rằng chúng ta đã cài đặt các công cụ và thư viện sau:
Chạy các lệnh sau để cài đặt các phụ thuộc cần thiết:
!pip install langchain chromadb gradio ollama pymypdf
!pip install -U langchain-community
Sau khi cài đặt xong các phụ thuộc trên, hãy chạy các lệnh import sau:
import ollama
import re
import gradio as gr
from concurrent.futures import ThreadPoolExecutor
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import PyMuPDFLoader
from langchain_community.embeddings import OllamaEmbeddings
from chromadb.config import Settings
from chromadb import Client
from langchain.vectorstores import ChromaChúng ta sẽ dùng PyMuPDFLoader của LangChain để trích xuất văn bản từ phiên bản PDF của cuốn Foundations of LLMs của Tong Xiao và Jingbo Zhu—đây là cuốn sách nặng về toán, nghĩa là chatbot của chúng ta nên có khả năng giải thích tốt phần toán học đằng sau LLM. Bạn có thể tìm cuốn sách trên arXiv.
# Load the document using PyMuPDFLoader
loader = PyMuPDFLoader("/path/to/Foundations_of_llms.pdf")

documents = loader.load()
Sau khi tài liệu được tải, chúng ta có thể bắt đầu chia văn bản thành các đoạn để xử lý tiếp.
Chúng ta sẽ chia văn bản đã trích xuất thành các đoạn nhỏ có chồng lấn để truy xuất ngữ cảnh tốt hơn. Bạn có thể thay đổi kích thước đoạn và mức chồng lấn tùy theo hệ thống trong hàm RecursiveCharacterTextSpilitter().
# Split the document into smaller chunks
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)

chunks = text_splitter.split_documents(documents)
Giờ đây, chúng ta đã có các đoạn văn bản sẵn sàng để chuyển thành embedding.
Chúng ta sẽ sử dụng Ollama Embeddings dựa trên DeepSeek-R1 để tạo embedding cho tài liệu. Tùy vào kích thước tài liệu, việc tạo embedding có thể mất thời gian, nên ưu tiên xử lý song song để nhanh hơn.
Lưu ý: model="deepseek-r1" mặc định dùng mô hình 7B tham số. Bạn có thể đổi sang 8B, 14B, 32B, 70B hoặc 671B. Thay X trong tên mô hình sau bằng kích thước mô hình: model="deepseek-r1:X"
# Initialize Ollama embeddings using DeepSeek-R1
embedding_function = OllamaEmbeddings(model="deepseek-r1")
# Parallelize embedding generation
def generate_embedding(chunk):
    return embedding_function.embed_query(chunk.page_content)
with ThreadPoolExecutor() as executor:
    embeddings = list(executor.map(generate_embedding, chunks))
Hàm trên khởi tạo DeepSeek-R1 qua Ollama để tạo embedding ngữ nghĩa chiều cao, sau này sẽ dùng cho truy xuất tài liệu dựa trên độ tương đồng.
Hàm generate_embedding() nhận văn bản của một đoạn và tạo embedding cho nó. Cuối cùng, ThreadPoolExecutor() áp dụng generate_embedding() cho từng đoạn đồng thời, thu thập embedding vào một danh sách để xử lý nhanh hơn so với tuần tự.
Chúng ta sẽ lưu embedding và các đoạn văn bản tương ứng vào cơ sở dữ liệu vector hiệu năng cao, Chroma.
# Initialize Chroma client and create/reset the collection
client = Client(Settings())
client.delete_collection(name="foundations_of_llms")  # Delete existing collection (if any)
collection = client.create_collection(name="foundations_of_llms")
# Add documents and embeddings to Chroma
for idx, chunk in enumerate(chunks):
    collection.add(
        documents=[chunk.page_content],
        metadatas=[{'id': idx}],
        embeddings=[embeddings[idx]],
        ids=[str(idx)]  # Ensure IDs are strings
    )
Chúng ta bắt đầu bằng các bước sau để lưu embedding:
Client(Settings()) khởi tạo client Chroma để quản lý vector store. client.delete_collection() để tránh lỗi. Cuối cùng, dùng client.create_collection() để tạo bộ sưu tập mới lưu các đoạn tài liệu và embedding của chúng.collection.add() lưu:chunk.page_content){'id': idx}) để tham chiếu đoạnThiết lập này đảm bảo mỗi đoạn tài liệu được lập chỉ mục chính xác để truy xuất theo vector hiệu quả.
Chúng ta sẽ khởi tạo retriever của Chroma, đảm bảo nó dùng cùng embedding DeepSeek-R1 cho các truy vấn.
# Initialize retriever using Ollama embeddings for queries
retriever = Chroma(collection_name="foundations_of_llms", client=client, embedding_function=embedding_function).as_retriever()
Retriever của Chroma kết nối tới bộ sưu tập "foundations_of_llms" và dùng embedding DeepSeek-R1 qua Ollama để nhúng truy vấn của người dùng. Nó truy xuất các đoạn tài liệu liên quan nhất dựa trên độ tương đồng vector để tạo phản hồi theo ngữ cảnh.
Tiếp theo, chúng ta sẽ truy xuất các đoạn văn bản phù hợp nhất và định dạng chúng để DeepSeek-R1 tạo câu trả lời.
def retrieve_context(question):
    # Retrieve relevant documents
    results = retriever.invoke(question)
    # Combine the retrieved content
    context = "\n\n".join([doc.page_content for doc in results])
    return context
Hàm retrieve_context nhúng truy vấn của người dùng bằng DeepSeek-R1 và truy xuất các đoạn tài liệu liên quan nhất qua retriever của Chroma. Sau đó, nó ghép nội dung các đoạn đã truy xuất thành một chuỗi ngữ cảnh để xử lý tiếp.
Giờ chúng ta đã có câu hỏi và ngữ cảnh đã truy xuất. Tiếp theo, gửi chúng tới DeepSeek-R1 qua Ollama để nhận câu trả lời cuối cùng.
def query_deepseek(question, context):
    # Format the input prompt
    formatted_prompt = f"Question: {question}\n\nContext: {context}"
    # Query DeepSeek-R1 using Ollama
    response = embedding_function.chat(
        model="deepseek-r1",
        messages=[{'role': 'user', 'content': formatted_prompt}]
    )
    # Clean and return the response
    response_content = response['message']['content']
    final_answer = re.sub(r'<think>.*?</think>', '', response_content, flags=re.DOTALL).strip()
    return final_answer
Để có câu trả lời cuối cùng, chúng ta bắt đầu bằng cách kết hợp câu hỏi của người dùng và ngữ cảnh đã truy xuất thành một prompt có cấu trúc. Sau đó gửi prompt này tới mô hình DeepSeek-R1 qua Ollama để nhận phản hồi. Để đầu ra gọn gàng, ta loại bỏ các thẻ không cần thiết và trả về câu trả lời cuối.
Chúng ta đã có pipeline RAG. Giờ sẽ dùng Gradio để tạo giao diện tương tác cho người dùng đặt câu hỏi liên quan tới cơ sở tri thức của nó (trong trường hợp này là Foundations of LLMs).
def ask_question(question):
    # Retrieve context and generate an answer using RAG
    context = retrieve_context(question)
    answer = query_deepseek(question, context)
    return answer
# Set up the Gradio interface
interface = gr.Interface(
    fn=ask_question,
    inputs="text",
    outputs="text",
    title="RAG Chatbot: Foundations of LLMs",
    description="Ask any question about the Foundations of LLMs book. Powered by DeepSeek-R1."
)
interface.launch()
Hàm ask_question() truy xuất ngữ cảnh liên quan bằng retriever của Chroma và tạo câu trả lời cuối qua DeepSeek-R1. Giao diện Gradio, được xây dựng với gr.Interface(), cho phép người dùng đặt câu hỏi tương tác và nhận câu trả lời chính xác, có căn cứ theo ngữ cảnh.
Chúc mừng! Bạn đã có một chatbot chạy cục bộ, sẵn sàng thảo luận mọi điều liên quan đến LLM.
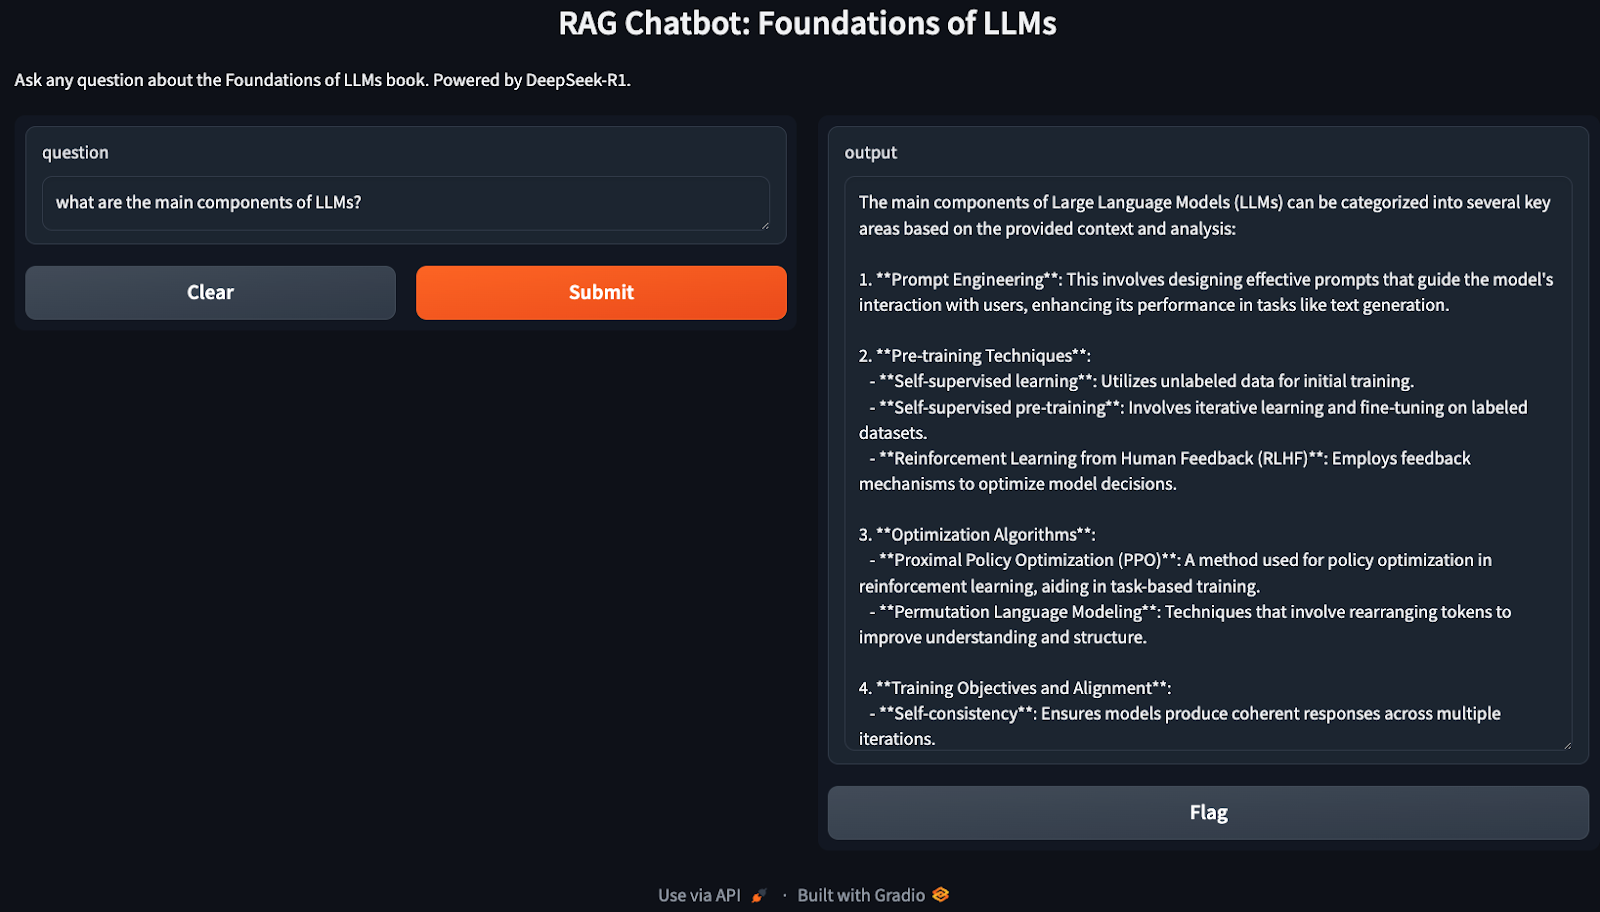
Bản demo trên bao quát một triển khai RAG rất cơ bản, có thể tối ưu thêm để hiệu quả hơn. Dưới đây là vài điều để thử:
chunk_size và chunk_overlap để cân bằng giữa hiệu năng và chất lượng truy xuất.Trong hướng dẫn này, chúng ta đã xây dựng một chatbot cục bộ dựa trên RAG bằng DeepSeek-R1 và Chroma cho phần truy xuất, đảm bảo các câu trả lời chính xác, phong phú về ngữ cảnh dựa trên một cơ sở tri thức lớn.
Để tìm hiểu thêm về DeepSeek, tôi khuyến nghị các bài viết sau:
Học AI với những khóa học này!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
