
Kurs
PyTorch ile Transformer Modelleri
2 sa
9.2K
Büyük Dil Modelleri (LLM) çıkarımı başlı başına bir sanat haline geliyor.
Şirketler giderek daha fazla, modelleri daha hızlı sunabilen, daha az donanım kullanan ve çıkarım maliyetlerini düşüren LLM çıkarımı ve MLOps mühendisleri arıyor.
İster modelleri yerelde çalıştırıyor, ister bir çıkarım sunucusu dağıtıyor, ister açık kaynak LLM’lerle deney yapıyor olun, çıkarımın nasıl çalıştığını anlamak büyük fark yaratabilir.
Verimli LLM çıkarımının arkasında, kuantizasyon, KV-önbellek optimizasyonu, sürekli toplu işleme, optimize edilmiş dikkat çekirdekleri, öngörüsel çözümleme ve donanım farkındalıklı ayarlamayı içeren tüm bir teknikler yığını bulunur.
Birçok modern çıkarım çerçevesi bunların bir kısmını otomatik olarak etkinleştirir; bu da, perde arkasında neler olduğunu tam anlamadan bile onlardan faydalanıyor olabileceğiniz anlamına gelir.
Bu rehberde, LLM çıkarımının temellerini, en önemli performans metriklerini, popüler sunum çerçevelerini ve modelleri daha hızlı, daha bellek verimli ve daha düşük maliyetle çalıştırmaya yönelik pratik teknikleri ele alacağım.
Temelden başlayacağız: çıkarım nedir, nasıl çalışır, performans nasıl ölçülür ve neden model mimarisi önemlidir.
LLM çıkarımı, bir dil modeline her komut gönderip yanıt beklediğinizde gerçekleşen süreçtir. Model girdiyi katmanları boyunca işler ve çıktıyı token token üretir.
Bu, eğitimden farklıdır. Eğitim sırasında model verilerden öğrenir ve ağırlıklarını günceller. Çıkarım sırasında ise bu ağırlıklar sabittir ve eğitilmiş model yalnızca tahmin üretmek için kullanılır.
Üretimde LLM hesaplama maliyetinin ezici çoğunluğu çıkarımda oluşur.
Bir model bir kez eğitilebilir, ancak milyonlarca isteği işler. Bu da çıkarım verimliliğini, uygulamalı yapay zekâda şu anda en belirleyici mühendislik problemlerinden biri yapar.
Çıkarımın teknik düzeyde nasıl çalıştığını anlamak önemlidir çünkü darboğazlar bariz değildir.
Daha hızlı donanım her zaman daha hızlı yanıt anlamına gelmez. Daha büyük modeller her zaman daha yavaş değildir. Modelin mimarisi, girişin uzunluğu, toplu iş boyutu ve sunum altyapısı, optimizasyona başlamadan önce anlaşılmaya değer biçimde birbiriyle etkileşir.
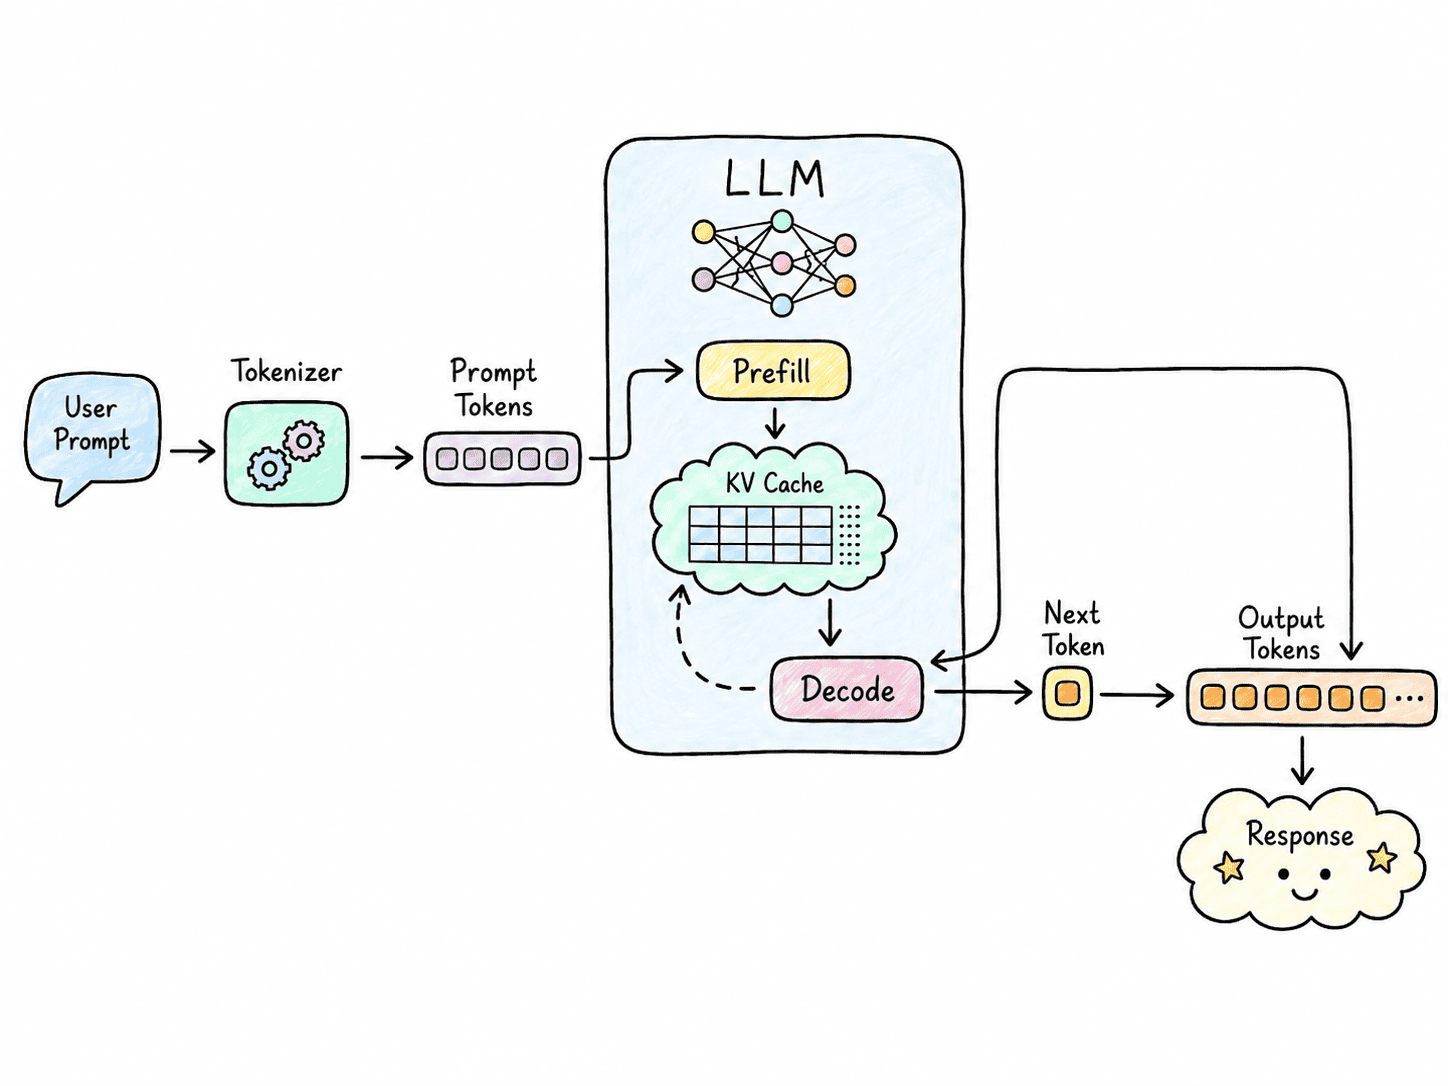
Çoğu kod çözücü tabanlı LLM için çıkarım iki ana aşamadan oluşur: ön doldurma (prefill) ve çözümleme (decode).
Daha küçük toplu iş boyutlarında çözümleme, çoğu zaman salt GPU hesaplamasından ziyade bellek bant genişliği ile sınırlıdır; çünkü model ağırlıkları ve önbelleğe alınmış dikkat durumları bellektan sürekli okunmak zorundadır.
Bu ayrım önemlidir; çünkü ön doldurma performansını iyileştiren bir optimizasyon, çözümleme performansını mutlaka iyileştirmeyebilir.
Bir çıkarım sunucusunun hızlı, verimli veya uygun maliyetli olup olmadığını söyleyen tek bir metrik yoktur. Bu metrikler, darboğazları belirlemeye, sunum kurulumlarını karşılaştırmaya ve bir optimizasyonun performansı gerçekten iyileştirip iyileştirmediğini anlamaya yardımcı olur.
En önemli metriklerden bazıları şunlardır:
Önbellek isabet oranı, üretimde özellikle önemli olabilir. Ajans benzeri sistemler sıklıkla büyük sistem komutlarını, araç tanımlarını, konuşma öneklerini veya belgeleri yeniden kullanır.
Bu girdinin %95’i veya daha fazlası önbellekten sunulabiliyorsa, tekrarlanan ön doldurma hesaplaması büyük ölçüde azaltılabilir; bu da gecikmeyi iyileştirir ve bu istekleri sunmanın etkin maliyetini düşürür.
Bu metrikler birbirine yakından bağlıdır.
Daha büyük toplu işler ve daha yüksek eşzamanlılık, işlem hacmini ve GPU kullanımını artırabilir; ancak tekil kullanıcılar için gecikmeyi yükseltebilir.
Benzer şekilde, düşük hassasiyete inmek bellek kullanımını ve donanım gereksinimlerini azaltabilir; ancak donanım o biçim için optimize edilmiş çekirdeklere sahip değilse üretim hızını iyileştirmeyebilir.
Bu nedenle amaç tek bir metriği maksimize etmek değil, iş yükünüz için gecikme, işlem hacmi, kullanım ve maliyet arasında doğru dengeyi bulmaktır.
Çıkarım performansı, büyük ölçüde modelin kendi mimarisi tarafından belirlenir.
Bir yoğun dönüştürücü (dense transformer) her token için esasen tüm parametrelerini kullanır. Buna karşılık bir Uzman Karışımı (MoE) model, çok sayıda uzmana sahip olmakla birlikte her token için yalnızca küçük bir alt kümesini etkinleştirir.
Bu, token başına gereken hesaplamayı azaltabilir; ancak uzman yönlendirme, yük dengeleme, GPU iletişimi ve uzman yerleşimi gibi zorlukları da beraberinde getirir.
Dikkat (attention) mimarisi de bellek kullanımı ve çıkarım hızını büyük ölçüde etkiler.
Geleneksel Çok Başlı Dikkat (MHA) her dikkat başlığı için ayrı anahtar ve değer temsilleri saklar; bu da KV önbelleğini büyük hale getirebilir.
Çoklu Sorgu Dikkati (MQA), birden çok sorgu başlığının aynı anahtar ve değerleri paylaşmasına izin vererek bu bellek gereksinimini azaltır.
Gruplandırılmış Sorgu Dikkati (GQA) ikisinin arasında yer alır; sorgu başlık grupları anahtar-değer temsillerini paylaşır. Daha yeni mimariler, bu temsilleri daha da sıkıştıran Çok Başlı Örtük Dikkat (MLA) gibi teknikler kullanabilir.
Bu nedenle, benzer parametre sayılarına sahip iki model çıkarım sırasında çok farklı davranabilir.
Mimarileri, hesaplama gereksinimlerini, KV-önbellek boyutunu, bellek kullanımını ve üretim hızını önemli ölçüde etkileyebilir.
Sırada, yerel kurulumlardan büyük ölçekli üretim sistemlerine kadar LLM’leri çalıştırmak için en yaygın kullanılan çerçevelere bakacağız.
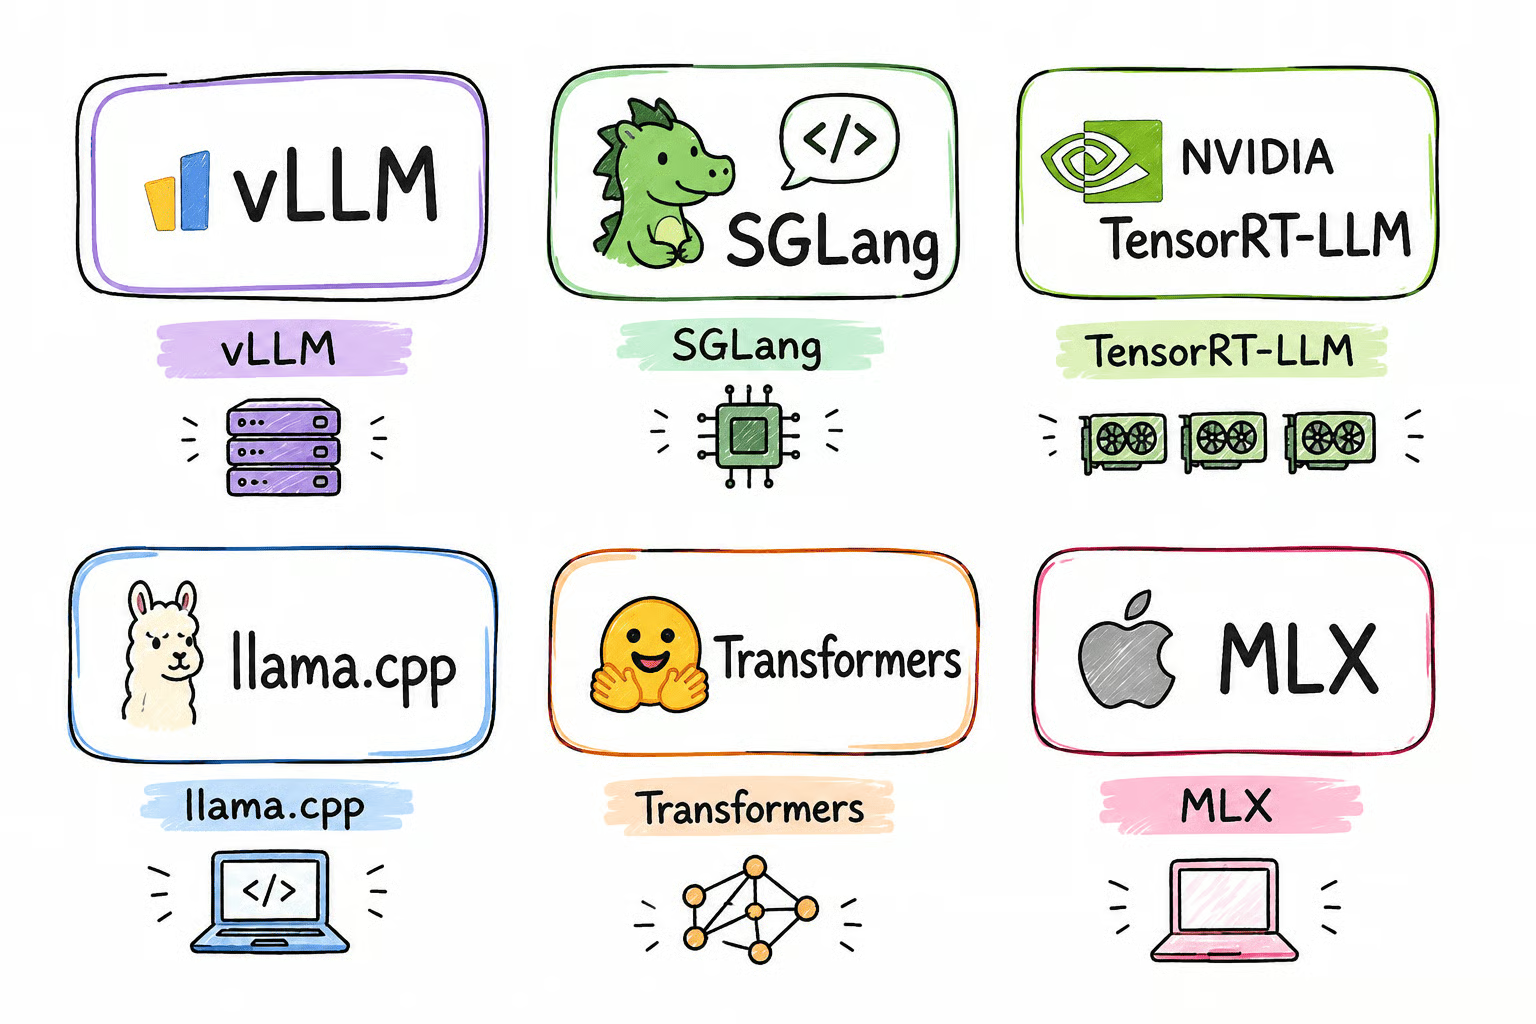
vLLM en yaygın kullanılan genel amaçlı çıkarım motorlarından biridir. Sürekli toplu işleme, PagedAttention, parçalı ön doldurma, önek önbellekleme, kuantizasyon, öngörüsel çözümleme, optimize edilmiş dikkat çekirdekleri ve dağıtık çıkarımı destekler.
SGLang, yüksek performanslı üretime ve verimli istek zamanlamasına odaklanır. Ajanlar, akıl yürütme modelleri, tekrarlanan bağlam, yapısal çıktılar ve diğer karmaşık üretim iş yükleri için özellikle kullanışlıdır.
TensorRT-LLM, NVIDIA’nın optimize edilmiş çıkarım yığınıdır. NVIDIA GPU özelliklerinden, özel CUDA çekirdeklerinden, düşük hassasiyetli biçimlerden, dağıtık yürütmeden, KV önbelleklemeden ve gelişmiş toplu işlemden yararlanır.
llama.cpp özellikle yerel ve kaynak kısıtlı çıkarım için kullanışlıdır. GGUF kuantizasyonu, CPU-GPU hibrit çıkarımı ve bellek eşlemeli model dosyalarını destekler; böylece ağırlıkların GPU belleği, sistem RAM’i ve gerektiğinde disk destekli bellek arasında dağıtılmasını sağlar.
Bu, kullanılabilir VRAM’den çok daha büyük modellerin çalıştırılmasını mümkün kılar; ancak diske aşırı bağımlılık performansı önemli ölçüde düşürebilir.
MLX, Apple Silicon için tasarlanmış bir çıkarım ve makine öğrenimi çerçevesidir. Mac’lerin birleşik bellek mimarisinden yararlanır ve M serisi cihazlarda LLM’leri yerelde çalıştırmak ve deney yapmak için kullanışlı bir seçenektir.
Kuantizasyondan öngörüsel çözümlemeye kadar bu bölüm, çıkarımı daha hızlı, daha ucuz ve daha bellek verimli hale getiren teknikleri kapsar.
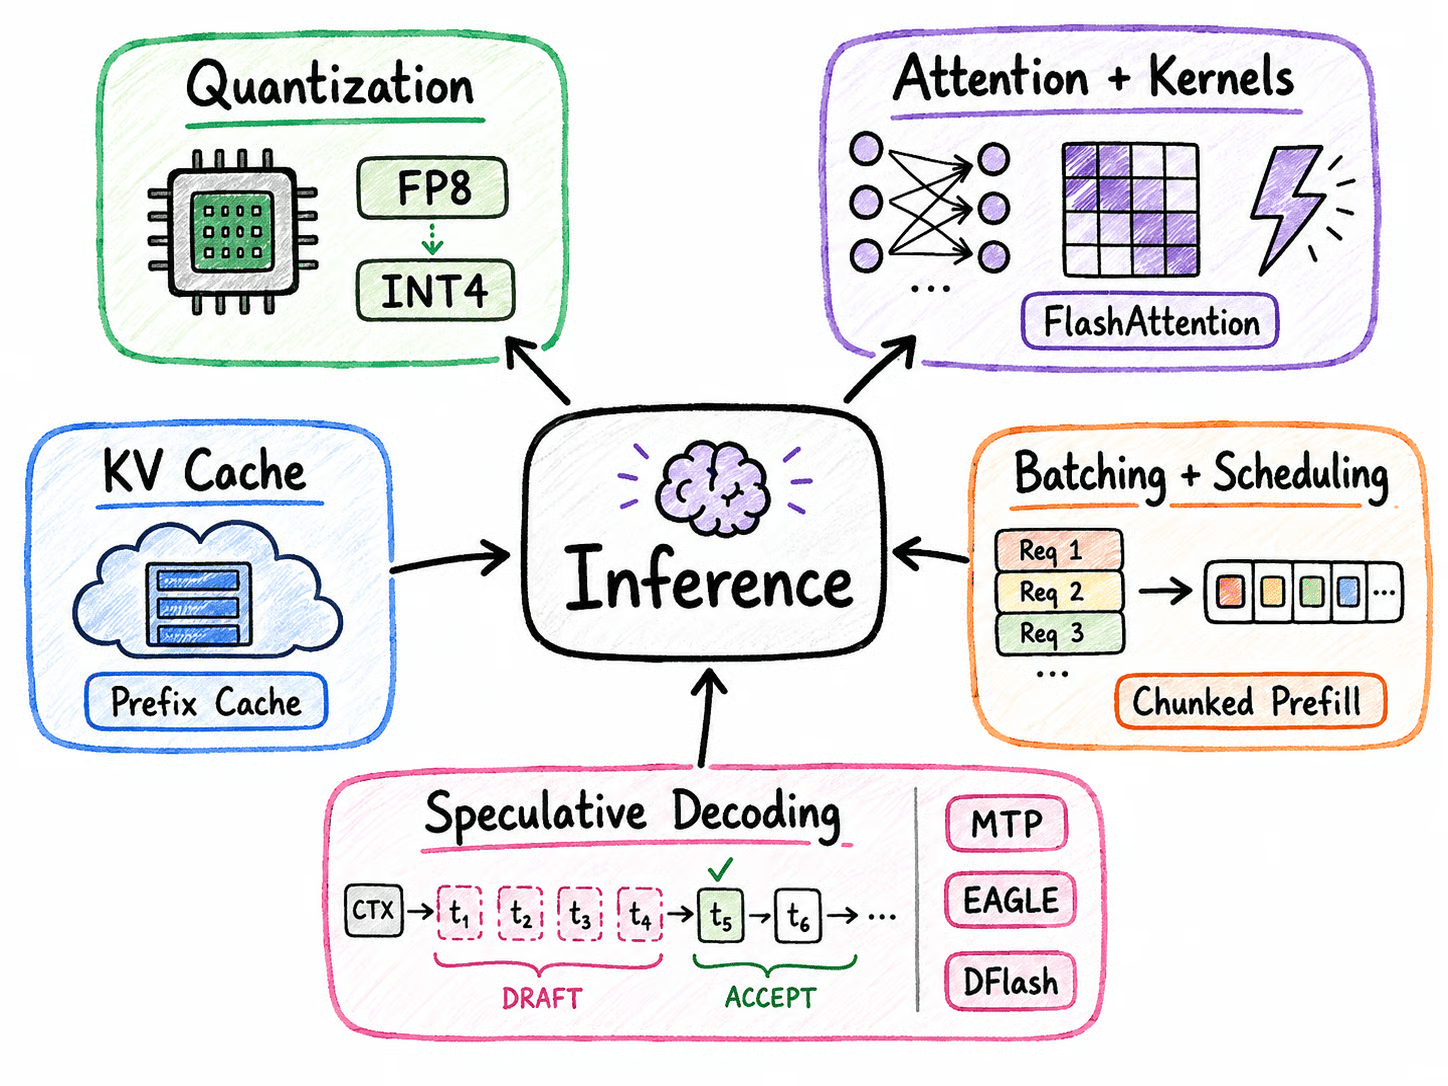
En yaygın çıkarım optimizasyonlarından biri kuantizasyondur.
Modeller sıklıkla BF16 veya FP16 hassasiyetinde eğitilir.
Kuantizasyon, ağırlıkları, aktivasyonları veya önbellekleri daha küçük sayısal biçimlerle temsil eder.
Yaygın biçimler ve yaklaşımlar şunlardır:
Hassasiyeti düşürmek bellek tüketimini azaltır ve bellek bant genişliği gereksinimlerini de düşürebilir.
Ancak daha küçük olmak otomatik olarak daha hızlı olmak anlamına gelmez. Performans, hedef donanımın o hassasiyet için verimli çekirdekler sunup sunmadığına büyük ölçüde bağlıdır.
KV önbelleği de kuantize edilebilir; bu da uzun bağlam ve yüksek eşzamanlılık sunumları için giderek daha değerli hale gelir.
Dikkat, bir dönüştürücü içindeki en önemli işlemlerden biridir. Modelin bir sonraki token’ı üretirken bağlamdaki hangi token’ların en ilgili olduğunu belirlemesini sağlar.
Ancak, bağlam penceresi büyüdükçe dikkat hesaplaması maliyetli hale gelebilir.
İşte bu noktada optimize edilmiş çekirdekler önem kazanır. Çekirdek, bir GPU gibi donanım üzerinde belirli bir matematiksel işlemi son derece optimize biçimde gerçekleştiren kod parçasıdır. Modelin çalışma şeklini değiştirmek yerine, optimize çekirdekler aynı hesaplamaları daha hızlı ve daha bellek verimli yapar.
Buna iyi bir örnek FlashAttention’dır. Geleneksel dikkat, GPU belleği ile hesaplama birimleri arasında büyük ara sonuçları taşımaya önemli zaman harcayabilir.
FlashAttention, dikkati daha küçük bloklar halinde işleyerek ve hesaplamayı GPU’ya daha yakın tutarak bu yükü azaltır.
Modern çıkarım motorları şunlar dahil olmak üzere benzer birçok optimizasyon kullanır:
Önemli nokta, bu tekniklerin genellikle modeli veya çıktı kalitesini değiştirmemesidir. Hesaplamaların nasıl yürütüldüğünü optimize ederler; böylece çıkarım motorları token’ları daha hızlı üretir ve mevcut donanımı daha verimli kullanır.
Üretim sırasında dönüştürücüler, önceki token’ların anahtar ve değerlerini KV önbelleğinde saklar.
Bu önbellek olmadan model, her yeni token ürettiğinde önceki token’ları yeniden hesaplamak zorunda kalırdı.
Dezavantajı bellek tüketimidir. Uzun bağlamlar ve çok sayıda eşzamanlı kullanıcı, KV önbelleğinin GPU belleğinin büyük bir bölümünü kaplamasına neden olabilir.
Bu sorunu ele alan çeşitli teknikler vardır.
PagedAttention, büyük bitişik tahsisler gerektirmek yerine KV önbellek belleğini yönetilebilir bloklara böler.
Önek önbellekleme, aynı öneke sahip isteklerin daha önce hesaplanmış KV durumlarını yeniden kullanmasına izin verir. Bu, paylaşılan sistem komutları, ajanlar ve tekrarlanan belge bağlamları için özellikle faydalıdır.
Diğer yaklaşımlar şunları içerir:
Büyük ölçekli çıkarım sistemlerinde KV-önbellek yönetimi, model ağırlığı optimizasyonu kadar önemli olabilir.
Bir çıkarım sunucusu aynı anda çok sayıda istek aldığında, GPU meşgul kalsın diye bunları birlikte işlemeye çalışır. Buna toplu işleme (batching) denir.
Sorun şu ki LLM istekleri nadiren aynı anda biter.
Bir kullanıcı 50 token üretirken diğeri 2.000 üretebilir.
Geleneksel toplu işlemde, daha kısa istekler, partideki en uzun isteğin bitmesini beklemek zorunda kalabilir.
Sürekli toplu işleme, tamamlanan istekleri çıkarıp yerlerine hemen yenilerini koyarak bunu çözer. Bu, kapasitenin atıl kalması yerine GPU’nun çalışmaya devam etmesini sağlar.
Bir başka yararlı teknik, parçalı ön doldurma (chunked prefill)dır. Sunucu, çok büyük bir komutu tek seferde işlemek yerine onu daha küçük parçalara böler; böylece token üretmekte olan diğer istekleri engellemez.
Trafik arttıkça çıkarım bir zamanlama problemine dönüşür. Sunucu hangi istekleri işleyeceğine, nasıl gruplayacağına ve GPU belleği, dizi uzunluğu, işlem hacmi ve gecikme arasında nasıl denge kuracağına karar vermelidir.
Geleneksel otoregresif çözümleme, token’ları tek tek üretir; bu da üretimi doğası gereği sıralı kılar.
Öngörüsel çözümleme bu darboğazı, birkaç aday token’ı ucuza üretip ardından tam hedef modelin bunları paralel olarak doğrulamasına izin vererek kırmaya çalışır.
Birden fazla aday kabul edilirse, hedef modelin çıktı dağılımını değiştirmeden, üretim bir anda birden fazla token ilerleyebilir.
Bu fikri izleyen çeşitli yaklaşımlar vardır:
Temel fikir basittir:
Birkaç olası gelecekteki token’ı ucuza üretin ve ardından onları daha büyük modelle verimli şekilde doğrulayın.
Öngörüsel çözümleme, sonraki token’lar görece öngörülebilir olduğunda ve kabul oranı yüksekken en iyi sonucu verir.
Bu da onu, hatta daha küçük bir modelin bile sırada ne geldiğini sıklıkla tahmin edebildiği kodlama ve diğer sıralı görevler için özellikle kullanışlı kılar.
Karmaşık akıl yürütme veya yüksek derecede öngörülemez üretimlerde, daha az taslak token kabul edilebilir; bu da performans kazanımını azaltır.
Modeller ve iş yükleri büyüdükçe, bellek büyük bir kısıt haline gelir. Burada, taşıma (offloading), çoklu GPU çıkarımı, ayrıştırılmış sunum ve uzun bağlam optimizasyonunu inceleyeceğiz.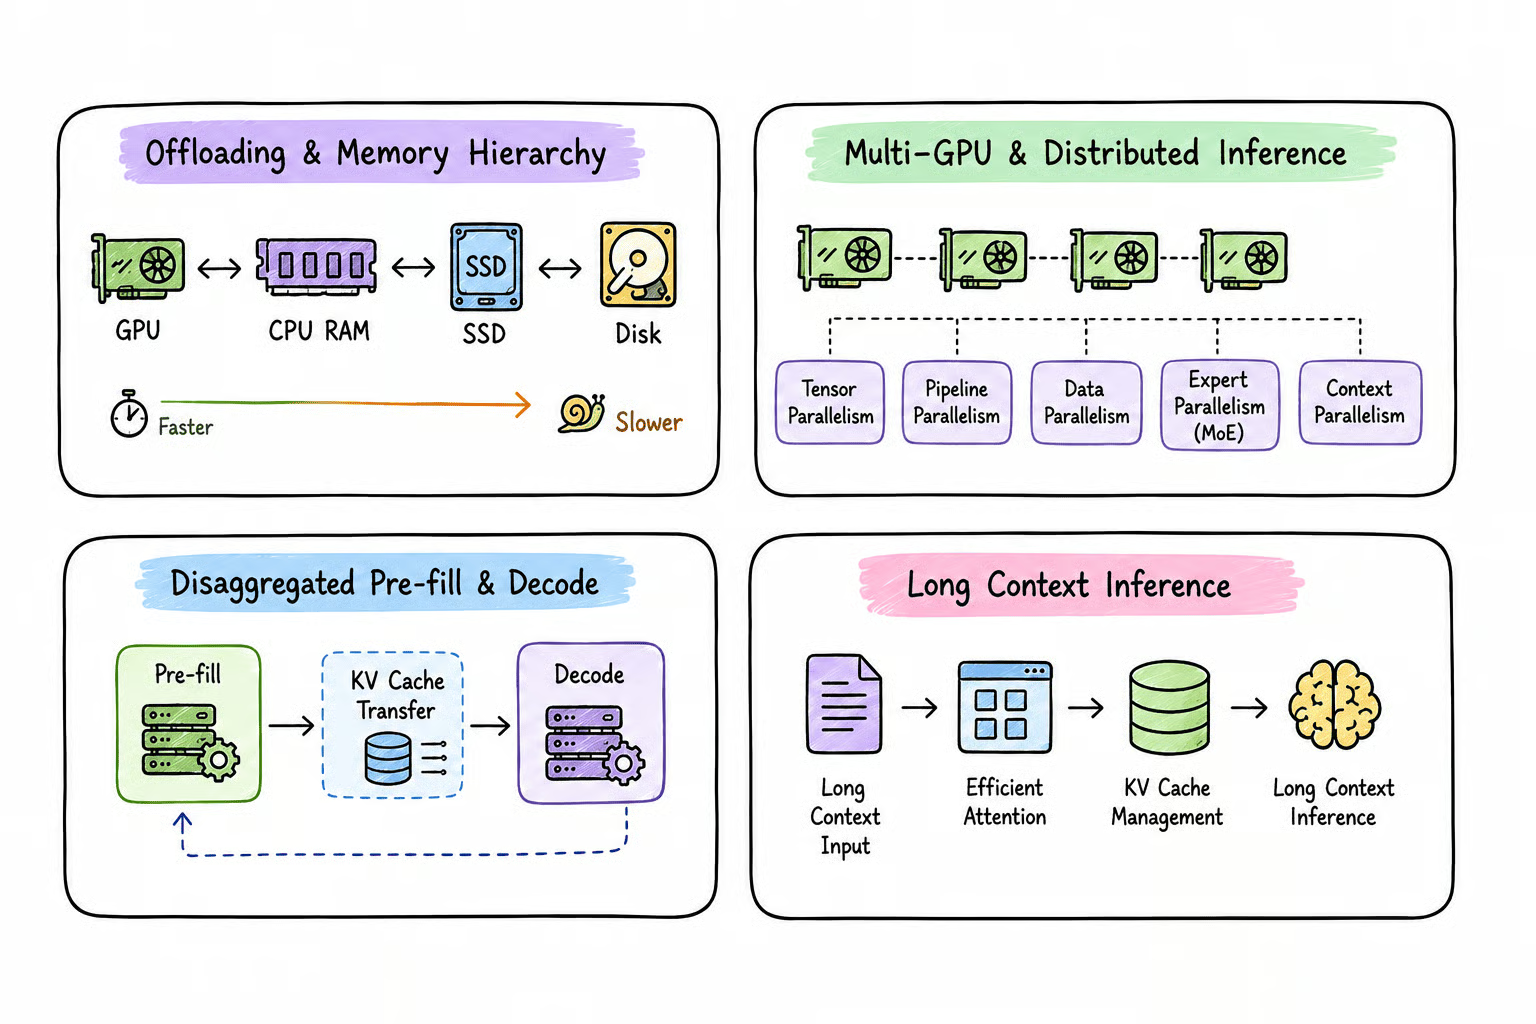
Bazen amaç en yüksek hız değildir. Amaç, yalnızca elinizdeki donanımda bir modeli çalıştırmaktır.
Çıkarım sistemleri farklı bellek seviyelerini kullanabilir:
GPU HBM → CPU RAM → NVMe depolama
GPU belleği en hızlı fakat aynı zamanda en sınırlı olandır.
CPU belleği daha düşük hızda daha fazla kapasite sunar; NVMe depolama ise çok daha fazla alan sağlar ancak çok daha yavaştır.
Bir model veya KV önbelleği tamamen VRAM’e sığmıyorsa, çıkarım motorları şu teknikleri kullanarak iş yükünün bir kısmını başka yerlere taşıyabilir:
Bu, kullanılabilir bellek miktarını artırır; ancak genellikle performans maliyetiyle gelir; çünkü veriler daha yavaş bellek katmanları arasında, çoğu zaman PCIe üzerinden taşınmalıdır.
Temel ödünleşim basittir: Veri GPU belleğinden ne kadar uzağa taşınırsa o kadar kapasite kazanırsınız; ancak çıkarım genellikle o kadar yavaşlar.
Çok büyük modeller sıklıkla birden fazla hızlandırıcı gerektirir.
Yaygın stratejiler şunlardır:
Çıkarım birden fazla GPU’ya yayıldığında iletişim önemli bir darboğaz haline gelir.
Bu nedenle NVLink, NVSwitch ve yüksek hızlı ağ gibi teknolojiler performansı önemli ölçüde etkileyebilir.
Ön doldurma ve çözümleme, çıkarım sırasında çok farklı davranır. Ön doldurma genellikle hesaplama açısından yoğundur, çünkü birçok komut token’ını paralel işler; çözümleme ise sıklıkla bellek bant genişliği açısından yoğundur ve token’ları birer birer üretir.
Daha büyük sunum sistemleri, her iki aşamayı da aynı GPU’lar için yarıştırmak yerine bunları ayırabilir:
Komut → Ön Doldurma İşçisi → KV Önbellek Transferi → Çözümleme İşçisi → Yanıt
Ön doldurma işçileri komutu işler ve KV önbelleğini oluşturur; ardından bu önbellek, yanıtı üreten özel çözümleme işçilerine aktarılır. Bu, her aşamanın farklı donanım, toplu işleme ve paralellik stratejileri kullanmasına olanak tanır.
Başlıca avantajı, ön doldurma ve çözümlemenin bağımsız olarak optimize edilip ölçeklenebilmesidir; bu da özellikle uzun komutlar ve yoğun iş yüklerinde, ilk token’a kadar süreyi (TTFT) ve tokenlar arası gecikmeyi (ITL) kontrol etmeye yardımcı olur.
Uzun bağlam pencereleri farklı bir çıkarım zorlukları seti oluşturur. Girdi büyüdükçe, ön doldurma daha fazla hesaplama gerektirir; KV önbellek ise büyür; GPU belleğini tüketir ve çözümlemeyi daha maliyetli hale getirir.
Birkaç teknik yardımcı olabilir:
Önemli nokta şu ki, bir milyon tokenlık bağlam penceresini desteklemek, bir milyon token sunmanın hızlı, ucuz veya pratik olduğu anlamına gelmez.
Daha uzun bağlamlar, bellek kullanımını, ilk token’a kadar süreyi ve genel çıkarım maliyetini artırır.
Her model çıkarım zamanında aynı davranmaz; bu nedenle MoE modelleri, yapısal üretim ve akıl yürütme iş yüklerinin kendine özgü zorluklarını inceleyeceğiz.
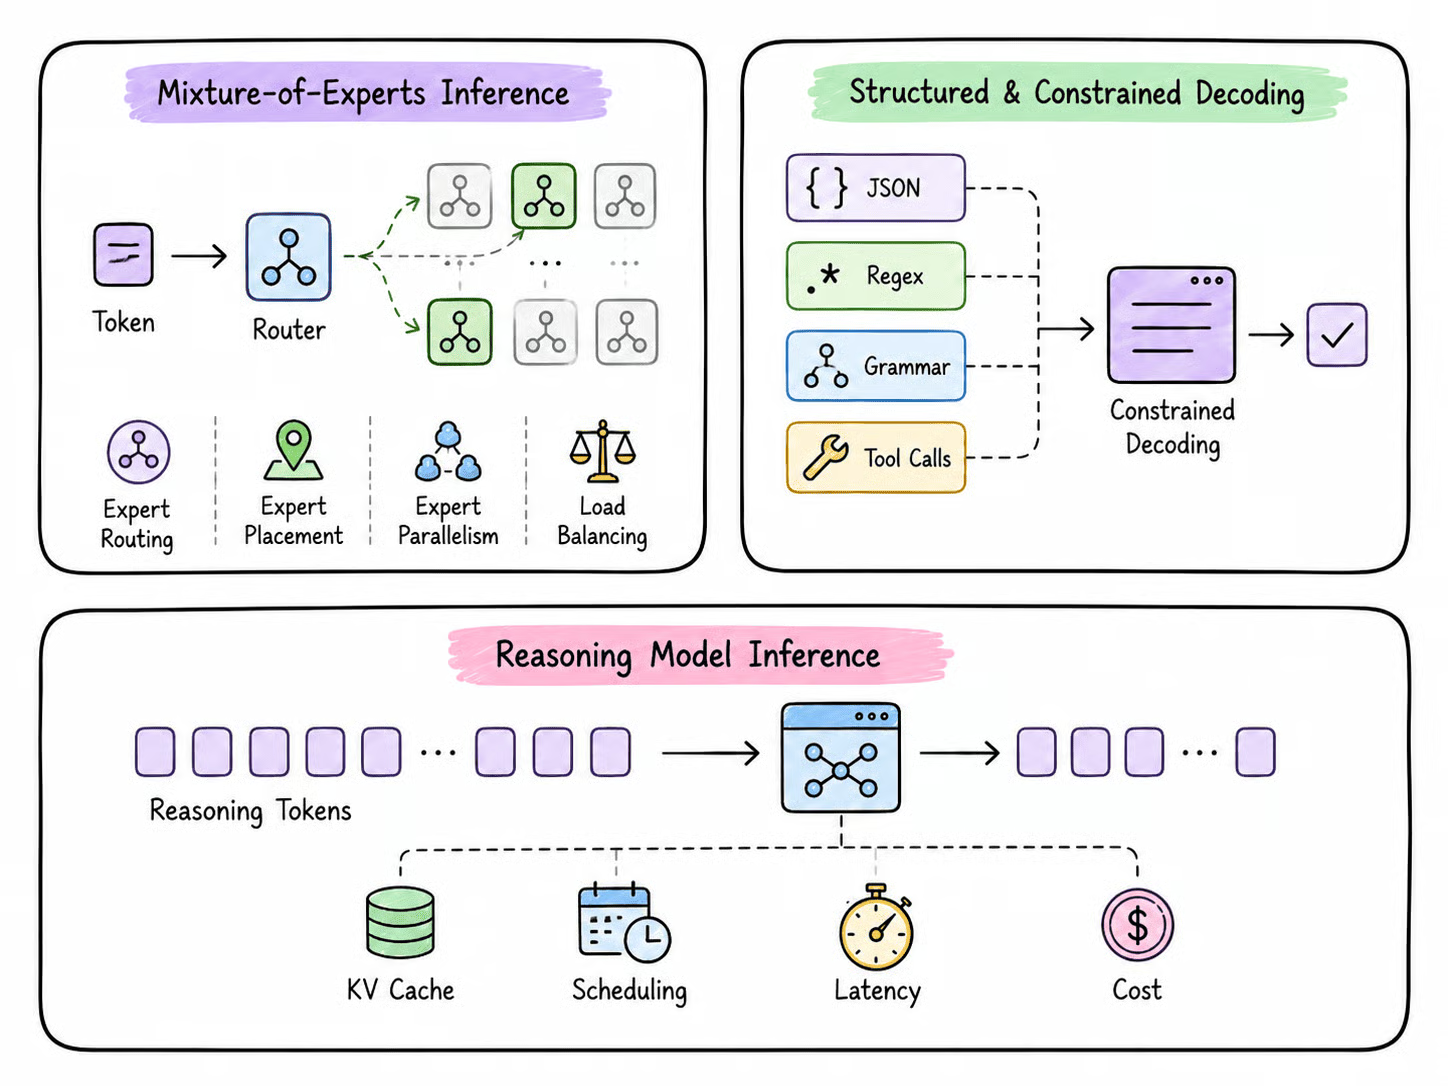
Uzman Karışımı (MoE) modelleri, yoğun modellerden farklı davranır. Her token için tüm parametreleri kullanmak yerine bir yönlendirici, her token’ı işlemek üzere yalnızca az sayıda uzman seçer.
Bu, hesaplamayı azaltır; ancak tam uzman kümesinin yine de sunum donanımı genelinde bir yerlere yerleştirilmesi gerekir.
Verimli MoE çıkarımı şu unsurlara bağlıdır:
Büyük ölçekte iletişim büyük bir darboğaz olabilir; bu nedenle DeepEP gibi teknolojiler, token’ları uzmanlar arasında taşımak için özel yüksek işlem hacimli ve düşük gecikmeli çekirdekler sunar.
Temel ayrım şudur: Toplam parametreler, depolanması gereken model kapasitesini belirlerken; etkin parametreler, her token için gerçekleştirilen hesaplama miktarı hakkında daha iyi bir fikir verir.
Modern LLM uygulamaları, sınırsız metinden daha öngörülebilir çıktılara ihtiyaç duyar. Örneğin ajanlar, geçerli JSON, araç argümanları, SQL veya önceden tanımlı bir şemayı izleyen yanıtlar üretmek zorunda olabilir.
Kısıtlı çözümleme, modelin her adımda üretmesine izin verilen token’ları kontrol ederek nihai çıktının gerekli bir yapıyı takip etmesini sağlar. vLLM gibi modern çıkarım motorları şu kısıtları destekler:
Bu yaklaşım, sınırsız metin üretip sonrasında düzeltmeye çalışmaktan genellikle daha güvenilirdir. Ancak kısıtlı çözümleme, yapıyı garanti eder; içindeki bilginin doğruluğunu ise mutlaka garanti etmez.
Akıl yürütme modelleri, nihai yanıtı üretmeden önce binlerce ara akıl yürütme token’ı oluşturabildikleri için çok farklı bir çıkarım iş yükü yaratır.
Uzun bağlam iş yüklerinde maliyetin çoğu büyük bir girdiyi işlemekten kaynaklanabilirken, akıl yürütme iş yükleri tüm üretim boyunca pahalı kalabilir; çünkü çözümleme aşaması bizzat çok uzundur.
Uzun akıl yürütme izleri şunları etkiler:
Bir diğer zorluk da akıl yürütme uzunluğunun sıklıkla öngörmesinin zor olmasıdır.
Bir istek hızlıca bitebilirken başka bir istek binlerce token üretmeye devam edebilir. Bu durum, çok sayıda kullanıcıya aynı anda hizmet verilirken toplu işleme, zamanlama ve KV-önbellek tahsisini zorlaştırır.
Sonuç olarak, birkaç yüz token üreten bir sohbet botuna hizmet vermekle 10.000 token üretebilen bir akıl yürütme modeline hizmet vermek, çok farklı çıkarım, bellek ve zamanlama stratejileri gerektirebilir.
Yazılım optimizasyonu, LLM çıkarımının yalnızca bir parçasıdır. Altındaki donanımın da hız, bellek kapasitesi, ölçeklenebilirlik ve maliyet üzerinde en az o kadar etkisi olabilir.
Önemli donanım özellikleri şunlardır:
Donanım performansını anlamak için yararlı bir kavram aritmetik yoğunluktur; bu, gerçekleştirilen hesaplama miktarını, taşınması gereken veri miktarına göre açıklar. Aritmetik yoğunluğu yüksek iş yükleri genellikle hesaplama sınırlıdır; aritmetik yoğunluğu düşük olanlar ise çoğunlukla bellek bant genişliğiyle sınırlıdır.
Ön doldurma sırasında birçok komut token’ı paralel işlenebilir; bu da donanımın hesaplama kaynaklarını daha iyi kullanmasını sağlar. Çözümleme sırasında ise token’lar sıralı üretilir ve sistem model ağırlıkları ile KV-önbellek verilerine tekrar tekrar erişir. Bu da üretim hızı için bellek bant genişliğini özellikle önemli kılar.
Bu yüzden bellek kapasitesi ile bellek bant genişliği iki farklı şeydir. Örneğin hem NVIDIA DGX Spark hem de bir Apple M4 Max sistemi 128 GB’a kadar birleşik bellek sağlayabilir. Ancak DGX Spark 273 GB/sn bellek bant genişliği sunarken, M4 Max 546 GB/sn’ye ulaşır. Dolayısıyla her iki sistem de aynı büyük modeli belleğe sığdırabilse bile çıkarım performansları çok farklı davranabilir.
Aynı ilke, GPU’lar ve yerel yapay zekâ makineleri karşılaştırılırken de geçerlidir: modeli sığdırmak kapasite problemini çözer; hız problemini mutlaka değil.
LLM çıkarımı için hesaplama performansı, bellek kapasitesi, bellek bant genişliği ve ara bağlantı hızı birlikte değerlendirilmelidir.
Bu kadar çok çıkarım tekniği varken, öncelikle sisteminizi gerçekten sınırlayan şeyin ne olduğunu belirlemek kritik önem taşır.
VRAM’e sığmayan bir model, yüksek gecikme veya düşük işlem hacmiyle boğuşan bir sunucudan çok farklı bir optimizasyona ihtiyaç duyar.
|
Sorun / Senaryo |
Düşünülecek Teknikler |
|
Model VRAM’e sığmıyor |
Kuantizasyon, CPU’ya taşıma, tensör/boru hattı paralelliği |
|
Yüksek TTFT / yavaş ön doldurma |
Önek önbellekleme, parçalı ön doldurma ayarı, optimize dikkat |
|
Yavaş token üretimi |
Öngörüsel çözümleme, optimize çekirdekler, daha düşük hassasiyet |
|
Düşük işlem hacmi / yüksek eşzamanlılık |
Sürekli toplu işleme, istek zamanlaması, veri paralelliği |
|
KV-önbellek bellek baskısı |
KV-önbellek kuantizasyonu, sayfalama, taşıma, azaltılmış bağlam/eşzamanlılık |
|
Uzun bağlam iş yükleri |
Parçalı ön doldurma, bağlam paralelliği, KV-önbellek optimizasyonu |
|
Büyük MoE modeller |
Uzman paralelliği, uzman yerleşimi, yük dengeleme, optimize MoE çekirdekleri |
|
Tekrarlanan veya paylaşılan komutlar |
Önek önbellekleme, önek farkındalıklı yönlendirme |
|
Yerel / sınırlı donanım |
Kuantizasyon, llama.cpp/GGUF, Apple Silicon’da MLX |
|
Büyük ölçekli üretim sunumu |
vLLM, SGLang, TensorRT-LLM, dağıtık çıkarım, ön doldurma/çözümleme ayrıştırması |
Önemli nokta şu ki, tek bir en iyi optimizasyon yoktur.
Önce TTFT, token üretim hızı, işlem hacmi, GPU kullanım oranı ve bellek kullanımı gibi metrikleri ölçün. Ardından gerçek darboğazı hedefleyen tekniği uygulayın ve yeniden kıyaslayın.
Örneğin, kuantizasyon bellek sınırlı olduğunda yardımcı olabilir; sürekli toplu işleme işlem hacmini iyileştirebilir; önek önbellekleme tekrarlanan ön doldurma işini azaltabilir ve öngörüsel çözümleme, gelecekteki token’lar öngörülebilir olduğunda üretim hızını artırabilir.
Amaç yalnızca saniye başına token’ı maksimize etmek değil; gecikme, işlem hacmi, bellek kullanımı, model kalitesi, donanım ve maliyet arasında en iyi dengeyi bulmaktır.
Bir LLM’i yerelde çalıştırmak ve llama.cpp’den yanıt almak harika bir başlangıçtır; ancak bu, verimli bir çıkarım sistemi kurduğunuz anlamına gelmez.
Kişisel projeler, denemeler ve daha küçük iş yükleri için basit bir yerel kurulum yeterli olabilir.
Ancak çok sayıda kullanıcıya hizmet vermeye, uzun bağlamları yönetmeye veya karmaşık kodlama ve ajans benzeri sistemler kurmaya başladığınızda, gereksinimler hızla değişir.
Aynı anda birçok isteği işleyebilen, iyi üretim hızını koruyan, belleği verimli yöneten ve iş yükleri daha talepkâr hale geldikçe bile duyarlı kalan bir çıkarım yığınına ihtiyacınız vardır.
İşte bu noktada, sürekli toplu işleme, önek önbellekleme, KV-önbellek yönetimi, kuantizasyon, öngörüsel çözümleme, optimize çekirdekler, paralellik ve istek zamanlaması gibi kavramlar önem kazanmaya başlar.
Ayrıca performansı yalnızca saniye başına token ile değerlendirmek yerine TTFT, işlem hacmi, gecikme, eşzamanlılık, GPU kullanım oranı ve token başına maliyet gibi metrikleri de anlamanız gerekir.
Her model veya iş yükü için işe yarayan evrensel bir yapılandırma da yoktur. Kodlama için iyi çalışan bir teknik, akıl yürütme için aynı faydayı sağlamayabilir.
İşlem hacmini artıran bir optimizasyon gecikmeyi artırabilir. Kuantizasyon bellek gereksinimlerini önemli ölçüde azaltabilir; ancak daha agresif kuantizasyon model kalitesini de düşürebilir.
Nihayetinde iyi LLM çıkarım mühendisliği, denge ile ilgilidir. Amaç, elinizdeki donanımı en iyi şekilde kullanırken hız, bellek, işlem hacmi, gecikme, model kalitesi ve maliyet arasında denge kurmaktır.
Bu yüzden çıkarımı öğrenmek önemlidir. Varsayılan ayarlara tamamen güvenmek veya yalnızca daha fazla GPU eklemek yerine, darboğazın nerede olduğunu anlayabilir, doğru optimizasyonu seçebilir ve iş yükünüz için gerçekten tasarlanmış bir sunum sistemi kurabilirsiniz.
LLM çıkarımı hakkında daha fazla bilgi edinmek için LLM Çıkarımını Anlamak konulu webinarımıza göz atmanızı öneririm.
Öne Çıkan DataCamp Kursları
Kurs
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



