
Corso
Modelli Transformer con PyTorch
2 ore
9.2K
L'inferenza dei Large Language Model (LLM) sta diventando un'arte a sé.
Sempre più aziende cercano ingegneri di inferenza LLM e MLOps in grado di servire i modelli più velocemente, usare meno hardware e ridurre i costi di inferenza.
Che tu stia eseguendo i modelli in locale, distribuendo un server di inferenza o sperimentando con LLM open-source, capire come funziona l'inferenza può fare una grande differenza.
Dietro un'inferenza LLM efficiente c'è un intero stack di tecniche, tra cui quantizzazione, ottimizzazione della KV-cache, batching continuo, kernel di attention ottimizzati, speculative decoding e tuning consapevole dell'hardware.
Molti framework di inferenza moderni abilitano alcune di queste tecniche automaticamente, il che significa che potresti già beneficiarne senza capire appieno cosa succede sotto il cofano.
In questa guida esplorerò le basi dell'inferenza LLM, le metriche di performance più importanti, i framework di serving più diffusi e le tecniche pratiche per rendere i modelli più veloci, più efficienti in memoria e più economici da eseguire.
Partiamo dalle basi: cos'è l'inferenza, come funziona, come si misura la performance e perché l'architettura del modello conta.
L'inferenza LLM è ciò che accade ogni volta che invii un prompt a un modello linguistico e aspetti una risposta. Il modello elabora l'input attraverso i suoi layer e poi genera l'output token per token.
Questo è diverso dall'addestramento. Durante l'addestramento, il modello impara dai dati e aggiorna i suoi pesi. Durante l'inferenza, quei pesi sono fissi e il modello addestrato viene semplicemente usato per generare previsioni.
In produzione, l'inferenza rappresenta la stragrande maggioranza del costo computazionale degli LLM.
Un modello può essere addestrato una volta, ma gestisce milioni di richieste. Ciò rende l'efficienza dell'inferenza uno dei problemi ingegneristici più rilevanti nell'AI applicata in questo momento.
Capire come funziona l'inferenza a livello tecnico è importante perché i colli di bottiglia non sono ovvi.
Hardware più veloce non significa sempre risposte più rapide. Modelli più grandi non sono sempre più lenti. L'architettura del modello, la lunghezza dell'input, la dimensione del batch e l'infrastruttura di serving interagiscono in modi che vale la pena comprendere prima di iniziare a ottimizzare.
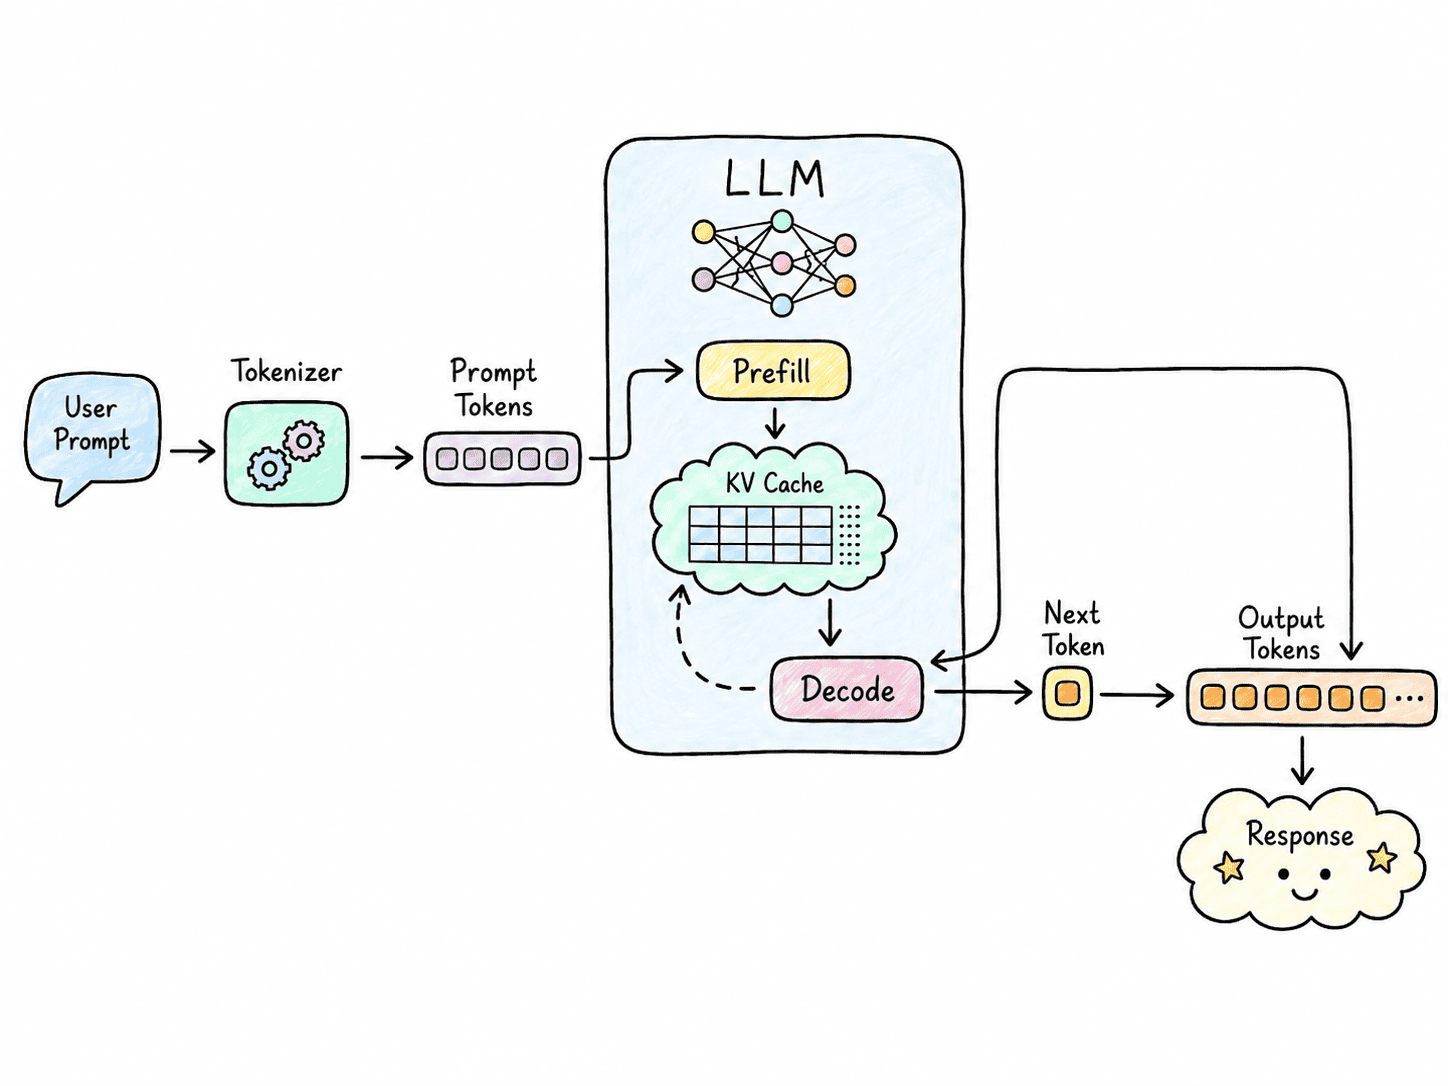
Per la maggior parte degli LLM basati su decoder, l'inferenza consiste in due fasi principali: prefill e decode.
Con batch più piccoli, il decoding è spesso limitato più dalla larghezza di banda della memoria che dalla potenza di calcolo grezza della GPU, perché i pesi del modello e gli stati di attention in cache devono essere continuamente letti dalla memoria.
Questa distinzione è importante perché un'ottimizzazione che migliora le prestazioni del prefill potrebbe non migliorare necessariamente quelle del decoding.
Non esiste una singola metrica che ci dica se un server di inferenza è veloce, efficiente o conveniente. Queste metriche aiutano a individuare i colli di bottiglia, confrontare i setup di serving e determinare se un'ottimizzazione sta davvero migliorando le prestazioni.
Alcune delle metriche più importanti includono:
La cache hit rate può essere particolarmente importante in produzione. I sistemi agentici spesso riutilizzano grandi system prompt, definizioni di tool, prefissi di conversazione o documenti.
Se il 95% o più di quell'input può essere servito dalla cache, il calcolo di prefill ripetuto può essere notevolmente ridotto, migliorando la latenza e abbassando il costo effettivo di serving di quelle richieste.
Queste metriche sono strettamente collegate.
Batch più grandi e maggiore concorrenza possono migliorare throughput e utilizzo della GPU, ma possono aumentare la latenza per i singoli utenti.
Allo stesso modo, ridurre la precisione può diminuire l'uso di memoria e i requisiti hardware, ma potrebbe non migliorare la velocità di generazione se l'hardware non ha kernel ottimizzati per quel formato.
L'obiettivo quindi non è massimizzare una singola metrica, ma trovare il giusto equilibrio tra latenza, throughput, utilizzo e costo per il tuo carico di lavoro.
Le prestazioni di inferenza sono fortemente influenzate dall'architettura del modello stesso.
Un transformer denso utilizza sostanzialmente tutti i suoi parametri per ogni token. Un modello Mixture-of-Experts (MoE), invece, contiene molti expert ma ne attiva solo un piccolo sottoinsieme per ciascun token.
Questo può ridurre la quantità di calcolo richiesta per token, ma introduce anche sfide come il routing degli expert, il bilanciamento del carico, la comunicazione tra GPU e il posizionamento degli expert.
L'architettura di attention ha inoltre un effetto rilevante sull'uso della memoria e sulla velocità di inferenza.
La Multi-Head Attention (MHA) tradizionale memorizza rappresentazioni di chiavi e valori separate per ogni head di attention, il che può rendere la KV cache grande.
La Multi-Query Attention (MQA) riduce questo requisito di memoria consentendo a più head di query di condividere le stesse chiavi e gli stessi valori.
La Grouped-Query Attention (GQA) si colloca tra le due, con gruppi di head di query che condividono rappresentazioni chiave-valore. Le architetture più recenti possono usare tecniche come la Multi-head Latent Attention (MLA), che comprime ulteriormente queste rappresentazioni.
Ecco perché due modelli con conteggi di parametri simili possono comportarsi in modo molto diverso durante l'inferenza.
La loro architettura può influire in modo significativo su requisiti di calcolo, dimensione della KV-cache, uso della memoria e velocità di generazione.
Poi vedremo i framework più utilizzati per eseguire gli LLM, dai setup locali ai sistemi di produzione su larga scala.
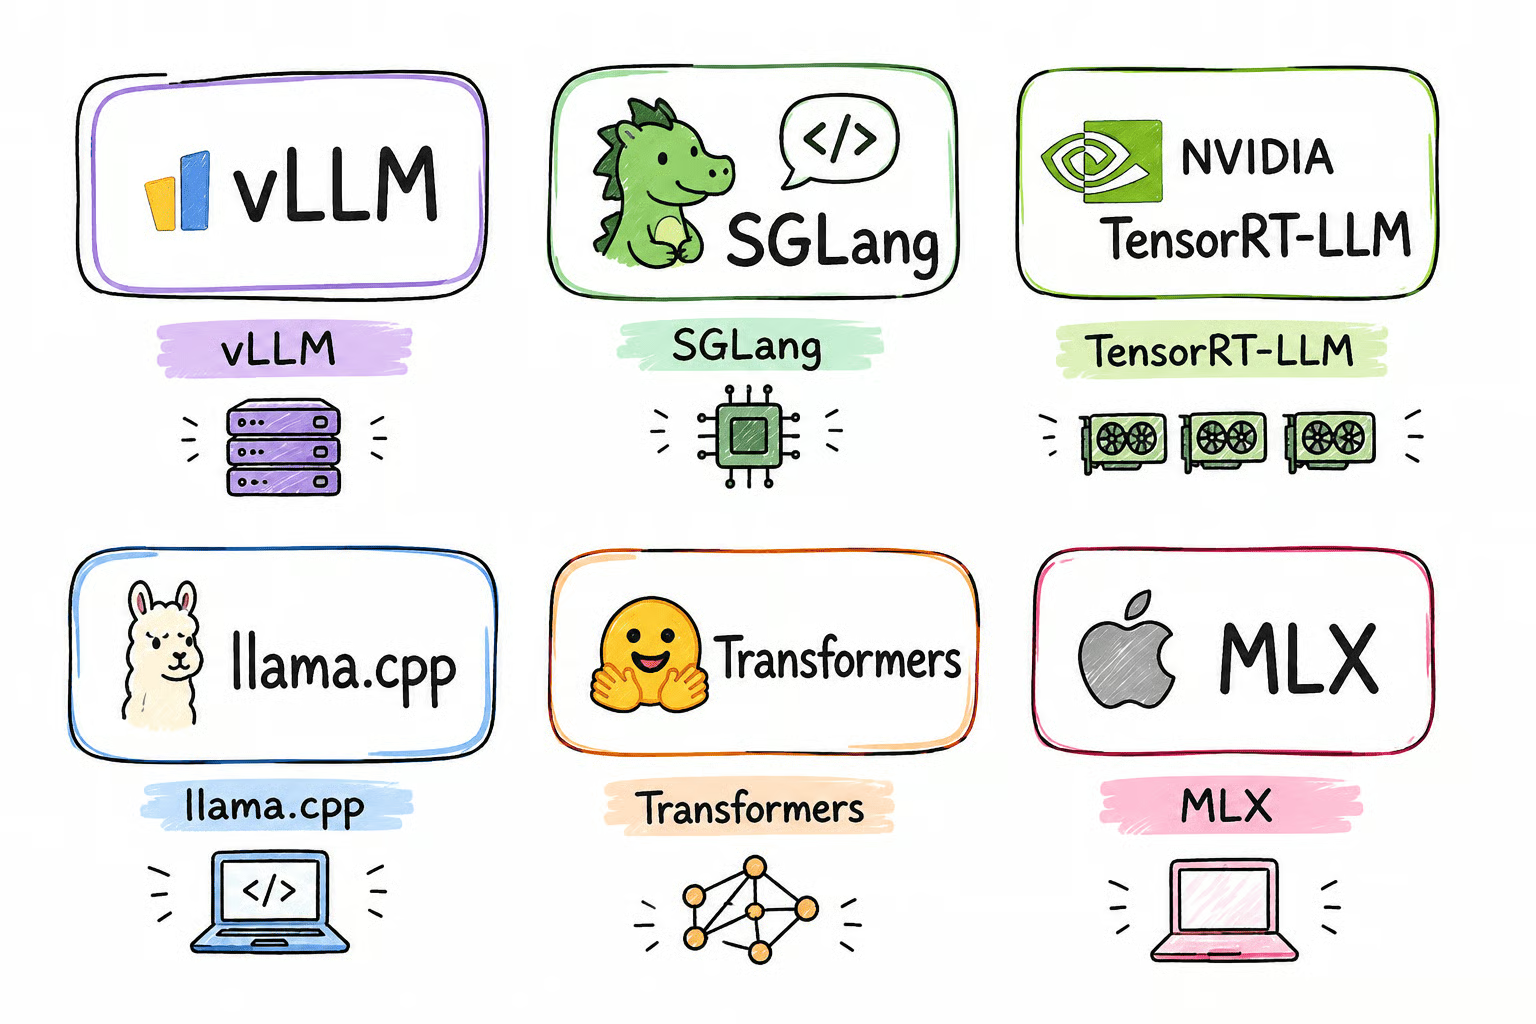
vLLM è uno dei motori di inferenza generici più diffusi. Supporta batching continuo, PagedAttention, prefill a chunk, cache dei prefissi, quantizzazione, speculative decoding, kernel di attention ottimizzati e inferenza distribuita.
SGLang è focalizzato sulla generazione ad alte prestazioni e su uno scheduling efficiente delle richieste. È particolarmente utile per agent, modelli di reasoning, contesti ripetuti, output strutturati e altri carichi di generazione complessi.
TensorRT-LLM è lo stack di inferenza ottimizzato di NVIDIA. Sfrutta le funzionalità delle GPU NVIDIA, kernel CUDA specializzati, formati a bassa precisione, esecuzione distribuita, caching KV e batching avanzato.
llama.cpp è particolarmente utile per l'inferenza locale e con risorse limitate. Supporta la quantizzazione GGUF, l'inferenza ibrida CPU-GPU e file di modello memory-mapped, consentendo di distribuire i pesi tra memoria GPU, RAM di sistema e, se necessario, memoria su disco.
Questo rende possibile eseguire modelli molto più grandi della VRAM disponibile, sebbene fare forte affidamento sul disco possa ridurre significativamente le prestazioni.
MLX è un framework di inferenza e machine learning progettato per Apple Silicon. Sfrutta l'architettura di memoria unificata dei Mac, rendendolo un'opzione utile per eseguire e sperimentare LLM in locale su dispositivi della serie M.
Dalla quantizzazione allo speculative decoding, questa parte copre le tecniche che rendono l'inferenza più veloce, economica ed efficiente in memoria.
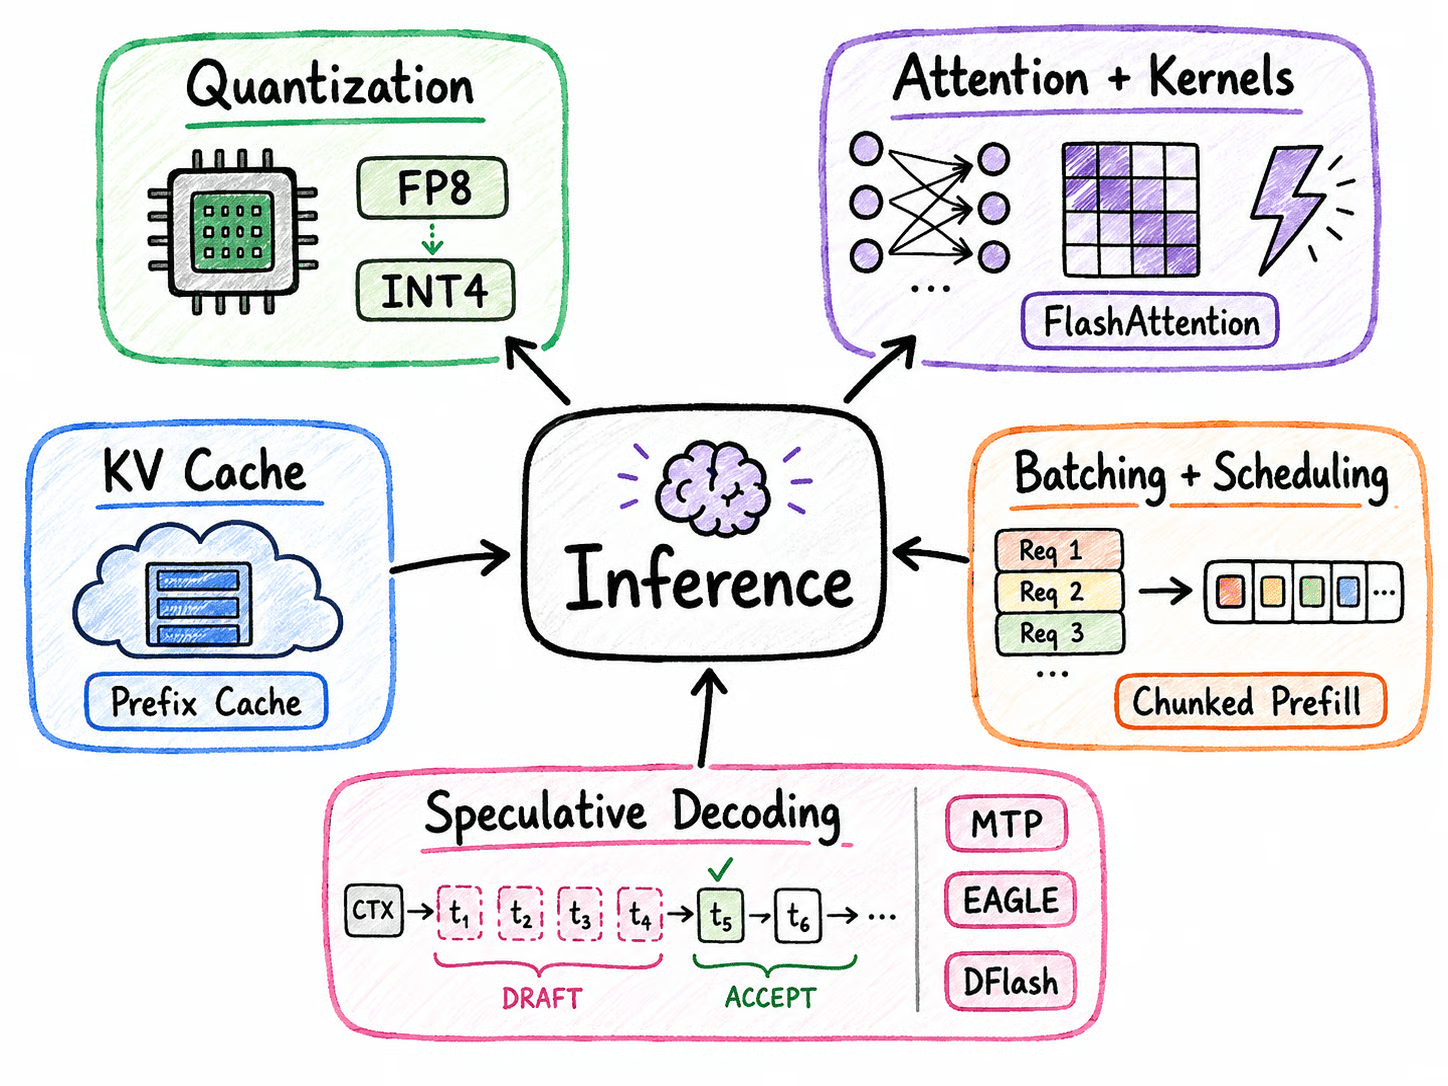
Una delle ottimizzazioni di inferenza più comuni è la quantizzazione.
I modelli sono spesso addestrati usando la precisione BF16 o FP16.
La quantizzazione rappresenta pesi, attivazioni o cache usando formati numerici più piccoli.
Formati e approcci comuni includono:
Ridurre la precisione abbassa il consumo di memoria e può ridurre i requisiti di larghezza di banda della memoria.
Tuttavia, più piccolo non significa automaticamente più veloce. Le prestazioni dipendono fortemente dal fatto che l'hardware di destinazione fornisca kernel efficienti per quella precisione.
Anche la KV cache può essere quantizzata, cosa che diventa sempre più preziosa per il serving con contesti lunghi e alta concorrenza.
L'attenzione è una delle operazioni più importanti all'interno di un transformer. Permette al modello di determinare quali token nel contesto sono più rilevanti quando genera il token successivo.
Tuttavia, l'attenzione può diventare costosa dal punto di vista computazionale, soprattutto quando la finestra di contesto cresce.
Qui entrano in gioco i kernel ottimizzati. Un kernel è un pezzo di codice altamente ottimizzato che esegue una specifica operazione matematica su hardware come una GPU. Invece di cambiare il funzionamento del modello, i kernel ottimizzati fanno sì che quegli stessi calcoli vengano eseguiti più velocemente e usino la memoria in modo più efficiente.
Un buon esempio è FlashAttention. L'attenzione tradizionale può impiegare una quota significativa del tempo a spostare grandi risultati intermedi tra la memoria della GPU e le unità di calcolo.
FlashAttention riduce questa overhead elaborando l'attenzione in blocchi più piccoli e mantenendo più calcolo vicino alla GPU.
I motori di inferenza moderni usano diverse ottimizzazioni simili, tra cui:
L'idea importante è che queste tecniche in genere non cambiano il modello o la qualità del suo output. Ottimizzano come i calcoli vengono eseguiti, aiutando i motori di inferenza a generare token più velocemente e a usare in modo più efficiente l'hardware disponibile.
Durante la generazione, i transformer memorizzano chiavi e valori dei token precedenti nella KV cache.
Senza questa cache, il modello dovrebbe ricalcolare i token precedenti ogni volta che ne genera un altro.
Lo svantaggio è il consumo di memoria. Contesti lunghi e molti utenti simultanei possono far sì che la KV cache occupi una grande porzione della memoria GPU.
Diverse tecniche affrontano questo problema.
PagedAttention divide la memoria della KV-cache in blocchi gestibili invece di richiedere grandi allocazioni contigue.
La cache dei prefissi consente alle richieste con prefissi identici di riutilizzare stati KV precedentemente calcolati. È particolarmente utile per system prompt condivisi, agent e contesti documentali ripetuti.
Altri approcci includono:
Per sistemi di inferenza su larga scala, la gestione della KV-cache può essere importante quanto l'ottimizzazione dei pesi del modello.
Quando un server di inferenza riceve molte richieste contemporaneamente, prova a elaborarle insieme così che la GPU resti occupata. Questo è noto come batching.
Il problema è che le richieste LLM raramente finiscono nello stesso momento.
Un utente potrebbe generare 50 token mentre un altro 2.000.
Con il batching tradizionale, le richieste più brevi possono finire per aspettare che la richiesta più lunga nel batch termini.
Il batching continuo risolve questo problema rimuovendo le richieste completate e sostituendole immediatamente con nuove. Questo mantiene la GPU al lavoro invece di lasciare capacità inutilizzata.
Un'altra tecnica utile è il prefill a chunk. Invece di elaborare un prompt molto grande tutto in una volta, il server lo suddivide in chunk più piccoli così da non bloccare altre richieste che stanno già generando token.
Man mano che il traffico cresce, l'inferenza diventa un problema di scheduling. Il server deve decidere quali richieste processare, come raggrupparle e come bilanciare memoria GPU, lunghezza delle sequenze, throughput e latenza.
Il decoding autoregressivo tradizionale genera i token uno alla volta, rendendo la generazione intrinsecamente sequenziale.
Lo speculative decoding prova a rompere questo collo di bottiglia generando diverse proposte di token a basso costo e poi lasciando che il modello target completo le verifichi in parallelo.
Se diverse proposte vengono accettate, la generazione può avanzare di più token alla volta senza cambiare la distribuzione d'uscita del modello target.
Diverse varianti seguono questa idea:
L'idea di base è semplice:
Generare in modo economico diversi token futuri probabili, quindi verificarli in modo efficiente con il modello più grande.
Lo speculative decoding funziona al meglio quando i prossimi token sono relativamente prevedibili e il tasso di accettazione è alto.
Questo lo rende particolarmente utile per coding e altri compiti sequenziali, dove anche un modello più piccolo può spesso prevedere cosa viene dopo.
Per il reasoning complesso o la generazione altamente imprevedibile, potrebbero essere accettati meno token draft, riducendo il beneficio in termini di performance.
Con la crescita dei modelli e dei carichi di lavoro, la memoria diventa un vincolo importante. Qui esploreremo offloading, inferenza multi-GPU, serving disaggregato e ottimizzazione per contesti lunghi.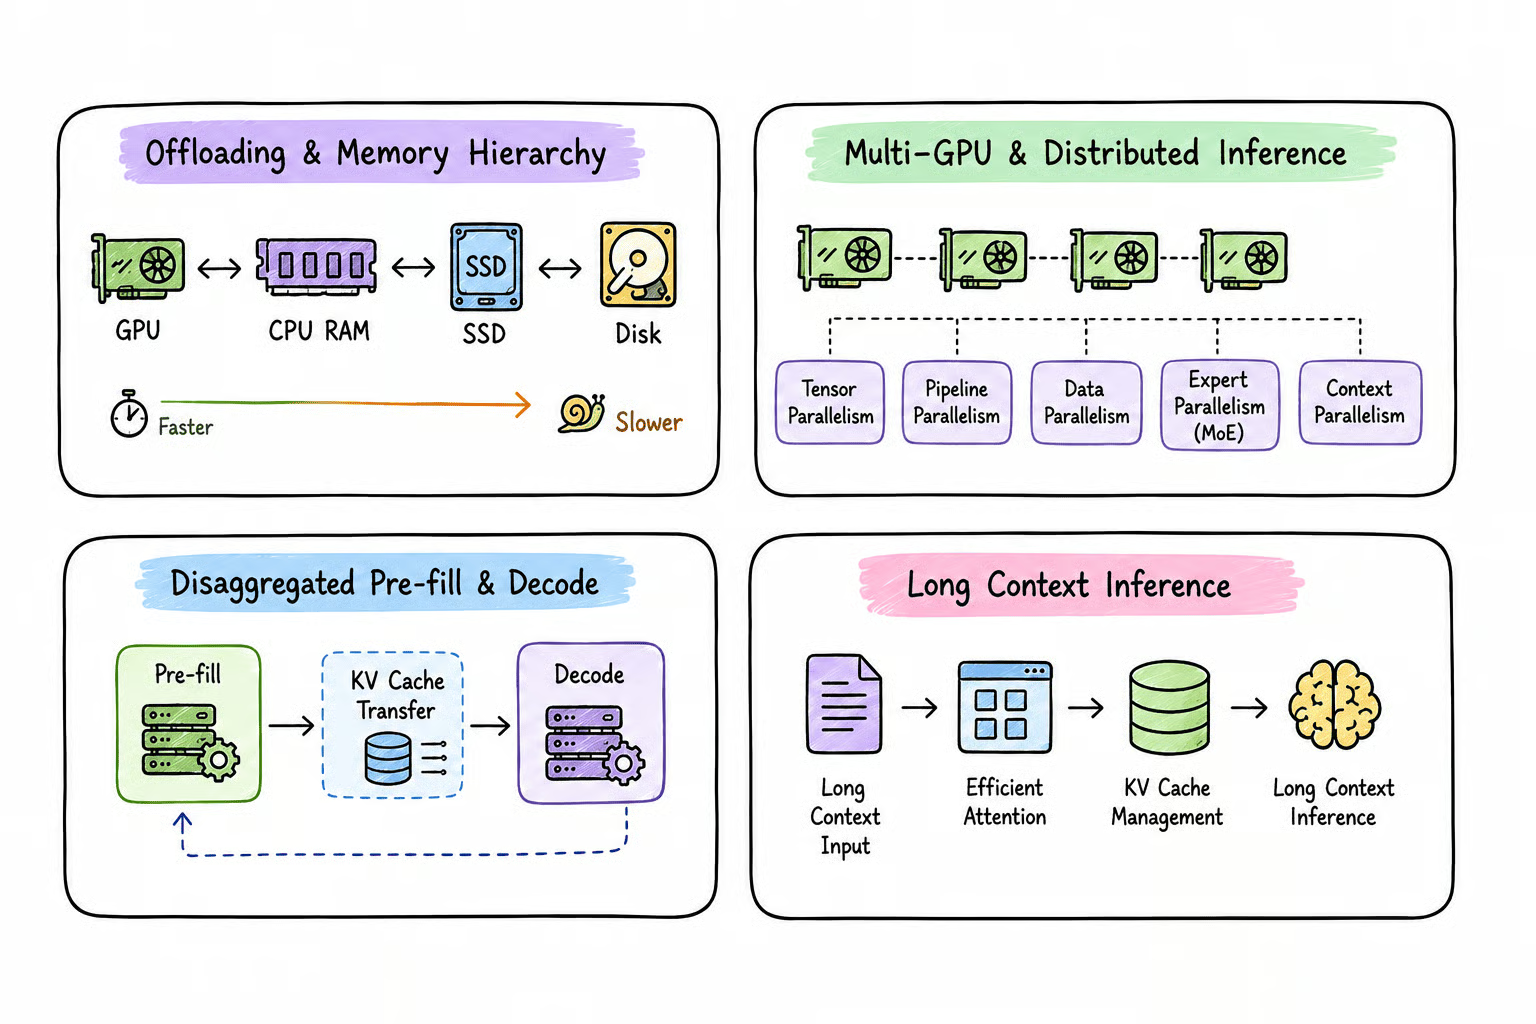
A volte l'obiettivo non è la massima velocità, ma semplicemente far girare un modello sull'hardware che hai.
I sistemi di inferenza possono usare diversi livelli di memoria:
GPU HBM → RAM CPU → Storage NVMe
La memoria GPU è la più veloce ma anche la più limitata.
La memoria CPU offre più capacità a velocità inferiore, mentre lo storage NVMe fornisce ancora più spazio ma è molto più lento.
Se un modello o la sua KV cache non entrano interamente in VRAM, i motori di inferenza possono spostare parte del carico altrove usando tecniche come:
Questo aumenta la quantità di memoria disponibile, ma di solito comporta un costo in termini di prestazioni perché i dati devono muoversi tra livelli di memoria più lenti, spesso attraverso PCIe.
Il compromesso di base è semplice: più i dati si allontanano dalla memoria GPU, più capacità guadagni, ma più l'inferenza tende a diventare lenta.
I modelli molto grandi richiedono spesso più acceleratori.
Strategie comuni includono:
Quando l'inferenza si estende su più GPU, la comunicazione diventa un collo di bottiglia importante.
Tecnologie come NVLink, NVSwitch e il networking ad alta velocità possono quindi avere un effetto sostanziale sulle prestazioni.
Prefill e decode si comportano in modo molto diverso durante l'inferenza. Il prefill è di solito intensivo in calcolo, poiché elabora molti token del prompt in parallelo, mentre il decode è spesso intensivo in larghezza di banda di memoria, generando i token uno alla volta.
Invece di far competere entrambe le fasi per le stesse GPU, i sistemi di serving più grandi possono separarle:
Prompt → Prefill Worker → Trasferimento KV Cache → Decode Worker → Risposta
I worker di prefill elaborano il prompt e costruiscono la KV cache, che viene poi trasferita a worker dedicati al decode che generano la risposta. Ciò consente a ciascuna fase di usare hardware, batching e strategie di parallelismo differenti.
Il vantaggio principale è che prefill e decode possono essere ottimizzati e scalati in modo indipendente, aiutando a controllare il time to first token (TTFT) e l'inter-token latency (ITL), soprattutto per prompt lunghi e carichi di lavoro ad alto traffico.
Finestre di contesto lunghe creano un insieme diverso di sfide di inferenza. All'aumentare dell'input, il prefill richiede più calcolo, mentre la KV cache cresce, consumando memoria GPU e rendendo il decoding più costoso.
Diverse tecniche possono aiutare:
Il punto importante è che supportare una context window da un milione di token context window non significa che servire un milione di token sia veloce, economico o pratico.
Contesti più lunghi aumentano l'uso di memoria, il time to first token e il costo complessivo dell'inferenza.
Non tutti i modelli si comportano allo stesso modo in fase di inferenza, quindi esamineremo le sfide specifiche dei modelli MoE, della generazione strutturata e dei carichi di lavoro di reasoning.
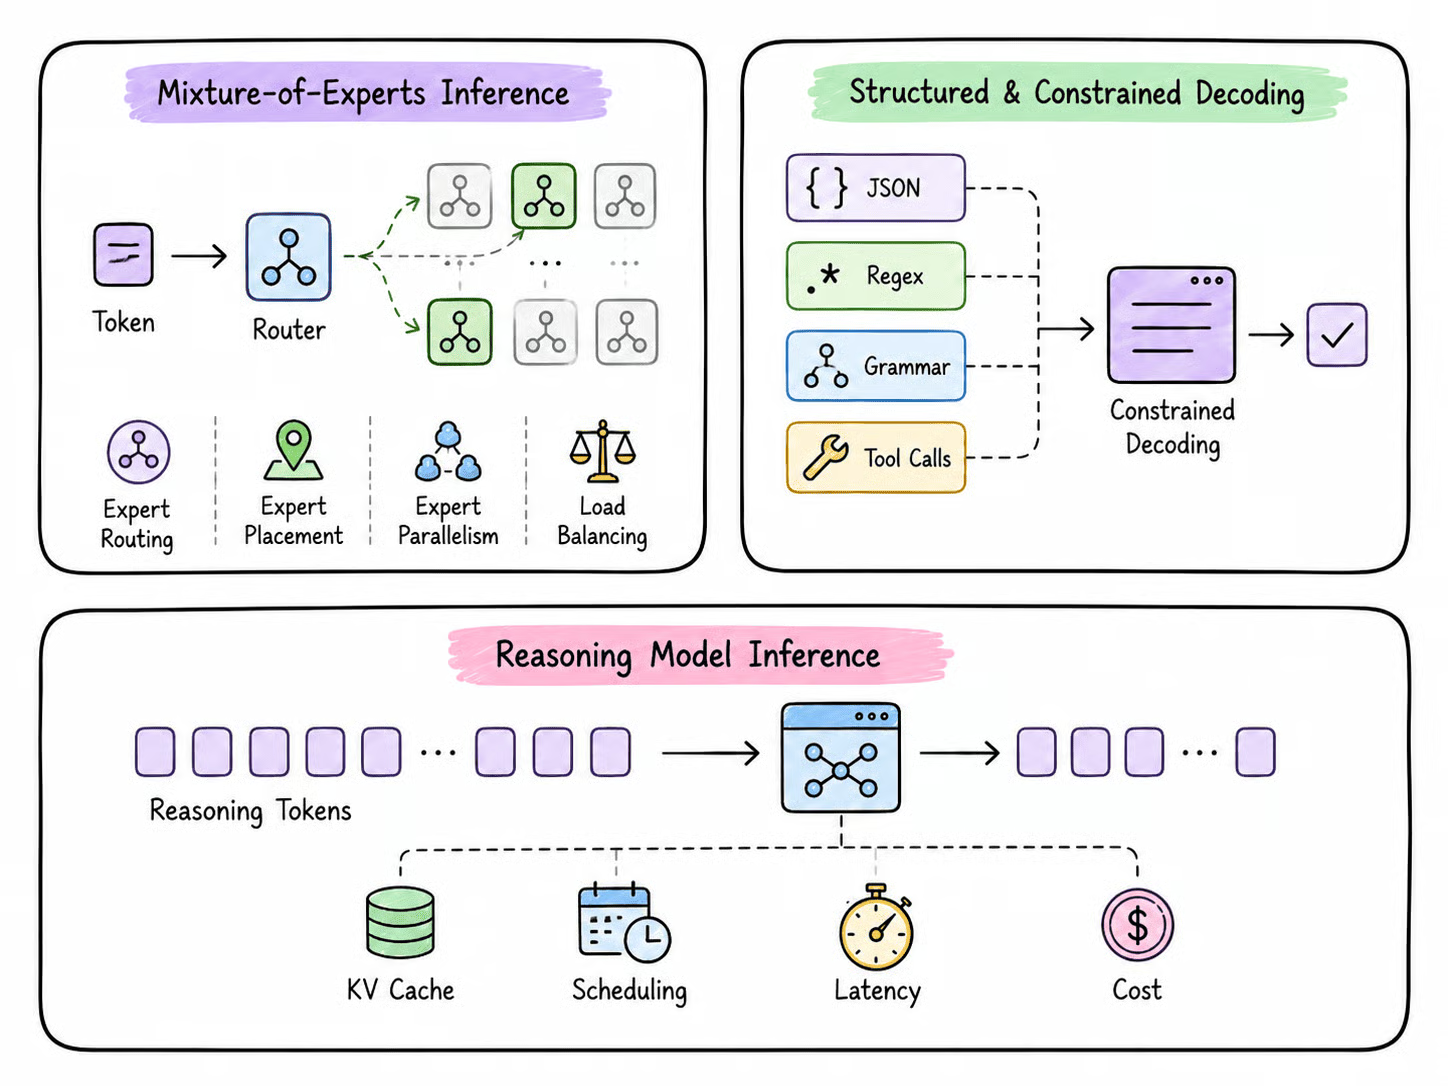
I modelli Mixture-of-Experts (MoE) si comportano in modo diverso dai modelli densi. Invece di usare ogni parametro per ogni token, un router seleziona solo un piccolo numero di expert per processare ciascun token.
Questo riduce il calcolo, ma l'intero set di expert deve comunque essere memorizzato da qualche parte nell'hardware di serving.
Un'inferenza MoE efficiente dipende quindi da:
Su larga scala, la comunicazione può diventare un grande collo di bottiglia, motivo per cui tecnologie come DeepEP forniscono kernel specializzati ad alto throughput e bassa latenza per spostare i token tra gli expert.
La distinzione chiave è che i parametri totali determinano quanta capacità di modello deve essere memorizzata, mentre i parametri attivi danno un'idea migliore di quanta computazione viene eseguita per ciascun token.
Le applicazioni LLM moderne spesso hanno bisogno di qualcosa di più prevedibile del testo libero. Gli agent, per esempio, possono dover generare JSON, argomenti di tool, SQL o risposte che seguano uno schema predefinito validi.
Il decoding vincolato controlla quali token il modello è autorizzato a generare a ogni passo, così che l'output finale segua una struttura richiesta. I motori di inferenza moderni come vLLM supportano vincoli, tra cui:
Questo è di solito più affidabile che generare testo libero e provare a ripararlo dopo. Tuttavia, il decoding vincolato garantisce la struttura, non necessariamente la correttezza delle informazioni al suo interno.
I modelli di reasoning creano un carico di inferenza molto diverso perché possono generare migliaia di token intermedi di ragionamento prima di produrre la risposta finale.
A differenza dei carichi con contesto lungo, dove la maggior parte del costo può derivare dall'elaborazione di un grande input, i carichi di reasoning possono rimanere costosi per tutta la generazione perché la fase di decode stessa diventa molto lunga.
Tracce di reasoning lunghe influiscono su:
Un'altra sfida è che la lunghezza del reasoning è spesso difficile da prevedere.
Una richiesta può finire rapidamente, mentre un'altra continua a generare migliaia di token. Questo rende batching, scheduling e allocazione della KV-cache più difficili quando si servono molti utenti contemporaneamente.
Di conseguenza, servire un chatbot che genera poche centinaia di token e un modello di reasoning che può generarne 10.000 può richiedere strategie di inferenza, memoria e scheduling molto diverse.
L'ottimizzazione software è solo una parte dell'inferenza LLM. L'hardware sottostante può avere un impatto altrettanto forte su velocità, capacità di memoria, scalabilità e costo.
Caratteristiche hardware importanti includono:
Un concetto utile per comprendere le prestazioni hardware è l'intensità aritmetica, che descrive quanta computazione viene eseguita rispetto a quanta data movement è necessario. Carichi con alta intensità aritmetica tendono a essere compute-bound, mentre carichi con bassa intensità aritmetica sono spesso limitati dalla larghezza di banda della memoria.
Durante il prefill, molti token del prompt possono essere elaborati in parallelo, consentendo all'hardware di sfruttare meglio le risorse di calcolo. Durante il decode, invece, i token vengono generati in sequenza e il sistema accede ripetutamente ai pesi del modello e ai dati della KV-cache. Questo rende la larghezza di banda della memoria particolarmente importante per la velocità di generazione.
Ecco perché capacità di memoria e larghezza di banda di memoria sono due cose diverse. Ad esempio, sia NVIDIA DGX Spark sia un sistema Apple M4 Max possono fornire fino a 128 GB di memoria unificata. Tuttavia, DGX Spark offre 273 GB/s di larghezza di banda della memoria, mentre M4 Max arriva fino a 546 GB/s. Quindi, anche se entrambi i sistemi possono far entrare lo stesso modello grande in memoria, le loro prestazioni di inferenza possono comportarsi in modo molto diverso.
Lo stesso principio vale quando si confrontano GPU e macchine AI locali: far entrare il modello risolve il problema della capacità, non necessariamente quello della velocità.
Per l'inferenza LLM, prestazioni di calcolo, capacità di memoria, larghezza di banda della memoria e velocità di interconnessione devono essere considerate insieme.
Con così tante tecniche di inferenza disponibili, la chiave è identificare prima di tutto cosa sta effettivamente limitando il tuo sistema.
Un modello che non entra in VRAM richiede un'ottimizzazione molto diversa rispetto a un server che fatica con alta latenza o basso throughput.
|
Problema / Scenario |
Tecniche da considerare |
|
Il modello non entra in VRAM |
Quantizzazione, offloading su CPU, parallelismo di tensore/pipeline |
|
TTFT alto / prefill lento |
Cache dei prefissi, tuning del prefill a chunk, attention ottimizzata |
|
Generazione di token lenta |
Speculative decoding, kernel ottimizzati, precisione più bassa |
|
Basso throughput / alta concorrenza |
Batching continuo, scheduling delle richieste, parallelismo dei dati |
|
Pressione sulla memoria della KV-cache |
Quantizzazione della KV-cache, paging, offloading, riduzione di contesto/concorrenza |
|
Carichi con contesto lungo |
Prefill a chunk, parallelismo del contesto, ottimizzazione della KV-cache |
|
Grandi modelli MoE |
Parallelismo degli expert, posizionamento degli expert, bilanciamento del carico, kernel MoE ottimizzati |
|
Prompt ripetuti o condivisi |
Cache dei prefissi, routing consapevole del prefisso |
|
Hardware locale / limitato |
Quantizzazione, llama.cpp/GGUF, MLX su Apple Silicon |
|
Serving di produzione su larga scala |
vLLM, SGLang, TensorRT-LLM, inferenza distribuita, disaggregazione prefill/decode |
Il punto importante è che non esiste un'unica ottimizzazione migliore.
Inizia misurando metriche come TTFT, velocità di generazione dei token, throughput, utilizzo GPU e uso della memoria. Quindi applica la tecnica che mira al collo di bottiglia reale e riesegui il benchmark.
Per esempio, la quantizzazione può aiutare quando la memoria è limitata, il batching continuo può migliorare il throughput, la cache dei prefissi può ridurre il lavoro di prefill ripetuto e lo speculative decoding può migliorare la velocità di generazione quando i token futuri sono prevedibili.
L'obiettivo non è semplicemente massimizzare i token al secondo, ma trovare il miglior equilibrio tra latenza, throughput, uso di memoria, qualità del modello, hardware e costo.
Eseguire un LLM in locale e ottenere una risposta con llama.cpp è un ottimo punto di partenza, ma non significa automaticamente che tu abbia costruito un sistema di inferenza efficiente.
Per progetti personali, sperimentazione e carichi più piccoli, un setup locale semplice può essere tutto ciò di cui hai bisogno.
Ma quando inizi a servire molti utenti, gestire contesti lunghi o costruire sistemi complessi di coding e agent, i requisiti cambiano rapidamente.
Hai bisogno di uno stack di inferenza in grado di processare molte richieste contemporaneamente, mantenere una buona velocità di generazione, gestire la memoria in modo efficiente e restare reattivo anche quando i carichi diventano più impegnativi.
È qui che concetti come batching continuo, cache dei prefissi, gestione della KV-cache, quantizzazione, speculative decoding, kernel ottimizzati, parallelismo e scheduling delle richieste iniziano a contare.
Devi anche comprendere metriche come TTFT, throughput, latenza, concorrenza, utilizzo GPU e costo per token invece di giudicare le prestazioni solo dai token al secondo.
Non esiste nemmeno una configurazione universale che funzioni per ogni modello o carico di lavoro. Una tecnica che funziona bene per il coding potrebbe non offrire lo stesso beneficio per il reasoning.
Un'ottimizzazione che migliora il throughput può aumentare la latenza. La quantizzazione può ridurre significativamente i requisiti di memoria, ma una quantizzazione più aggressiva può anche ridurre la qualità del modello.
In definitiva, una buona ingegneria dell'inferenza LLM riguarda l'equilibrio. L'obiettivo è sfruttare al meglio l'hardware che hai già, bilanciando velocità, memoria, throughput, latenza, qualità del modello e costo.
Ecco perché imparare l'inferenza è importante. Invece di affidarti interamente alle impostazioni predefinite o semplicemente aggiungere più GPU, puoi capire dove si trova il collo di bottiglia, scegliere l'ottimizzazione giusta e costruire un sistema di serving davvero adatto al tuo carico di lavoro.
Per approfondire l'inferenza LLM, ti consiglio di dare un'occhiata al nostro webinar su Understanding LLM Inference.
I migliori corsi DataCamp
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



