
कोर्स
PyTorch के साथ Transformer Models
2 घंटा
9.2K
बड़े भाषा मॉडल (LLM) की इन्फ़ेरेंस अब अपने आप में एक कला बनती जा रही है।
कंपनियाँ तेजी से ऐसे LLM इन्फ़ेरेंस और MLOps इंजीनियर तलाश रही हैं जो मॉडल को तेज़ी से सर्व कर सकें, कम हार्डवेयर का उपयोग करें, और इन्फ़ेरेंस लागत घटाएँ।
चाहे आप लोकली मॉडल चला रहे हों, इन्फ़ेरेंस सर्वर डिप्लॉय कर रहे हों, या ओपन-सोर्स LLMs के साथ प्रयोग कर रहे हों—इन्फ़ेरेंस कैसे काम करता है, यह समझना बड़ा फ़र्क ला सकता है।
कुशल LLM इन्फ़ेरेंस के पीछे पूरी तकनीकी स्टैक होती है, जिसमें क्वांटाइज़ेशन, KV-cache ऑप्टिमाइज़ेशन, कंटीन्युअस बैचिंग, ऑप्टिमाइज़्ड अटेंशन कर्नेल, स्पेकुलेटिव डिकोडिंग, और हार्डवेयर-अवेयर ट्यूनिंग शामिल हैं।
कई आधुनिक इन्फ़ेरेंस फ़्रेमवर्क इनमें से कुछ को स्वतः सक्षम कर देते हैं, यानी आप इनका लाभ पहले से उठा रहे हो सकते हैं, भले ही आपको अंदरूनी प्रक्रिया पूरी तरह समझ न आई हो।
इस गाइड में, मैं LLM इन्फ़ेरेंस की मूल बातें, सबसे महत्वपूर्ण परफ़ॉर्मेंस मीट्रिक्स, लोकप्रिय सर्विंग फ़्रेमवर्क, और मॉडल को तेज़, अधिक मेमोरी-कुशल, और चलाने में सस्ता बनाने की व्यावहारिक तकनीकों पर चर्चा करूँगा।
हम बुनियादी बातों से शुरू करेंगे: इन्फ़ेरेंस क्या है, यह कैसे काम करता है, परफ़ॉर्मेंस कैसे मापते हैं, और मॉडल आर्किटेक्चर क्यों मायने रखता है।
LLM इन्फ़ेरेंस हर बार होता है जब आप किसी भाषा मॉडल को प्रॉम्प्ट भेजते हैं और उत्तर की प्रतीक्षा करते हैं। मॉडल इनपुट को अपनी परतों से गुज़ारता है और फिर आउटपुट को टोकन-दर-टोकन जनरेट करता है।
यह प्रशिक्षण से अलग है। प्रशिक्षण के दौरान, मॉडल डेटा से सीखता है और अपने वज़न अपडेट करता है। इन्फ़ेरेंस के दौरान, वे वज़न स्थिर होते हैं और प्रशिक्षित मॉडल केवल भविष्यवाणी के लिए उपयोग होता है।
उत्पादन में LLM कंप्यूट लागत का बड़ा हिस्सा इन्फ़ेरेंस पर ही आता है।
एक मॉडल शायद एक बार प्रशिक्षित होता है, लेकिन वह लाखों अनुरोध संभालता है। इसी कारण इन्फ़ेरेंस दक्षता आज एप्प्लाइड AI में सबसे महत्वपूर्ण इंजीनियरिंग समस्याओं में से एक है।
तकनीकी स्तर पर इन्फ़ेरेंस कैसे काम करता है, यह समझना आवश्यक है क्योंकि बाधाएँ अक्सर स्पष्ट नहीं होतीं।
तेज़ हार्डवेयर हमेशा तेज़ प्रतिक्रिया नहीं देता। बड़े मॉडल हमेशा धीमे नहीं होते। मॉडल का आर्किटेक्चर, इनपुट की लंबाई, बैच साइज़, और सर्विंग इन्फ्रास्ट्रक्चर—ये सब ऐसे तरीक़ों से परस्पर क्रिया करते हैं जिन्हें ऑप्टिमाइज़ेशन शुरू करने से पहले समझना फायदेमंद है।
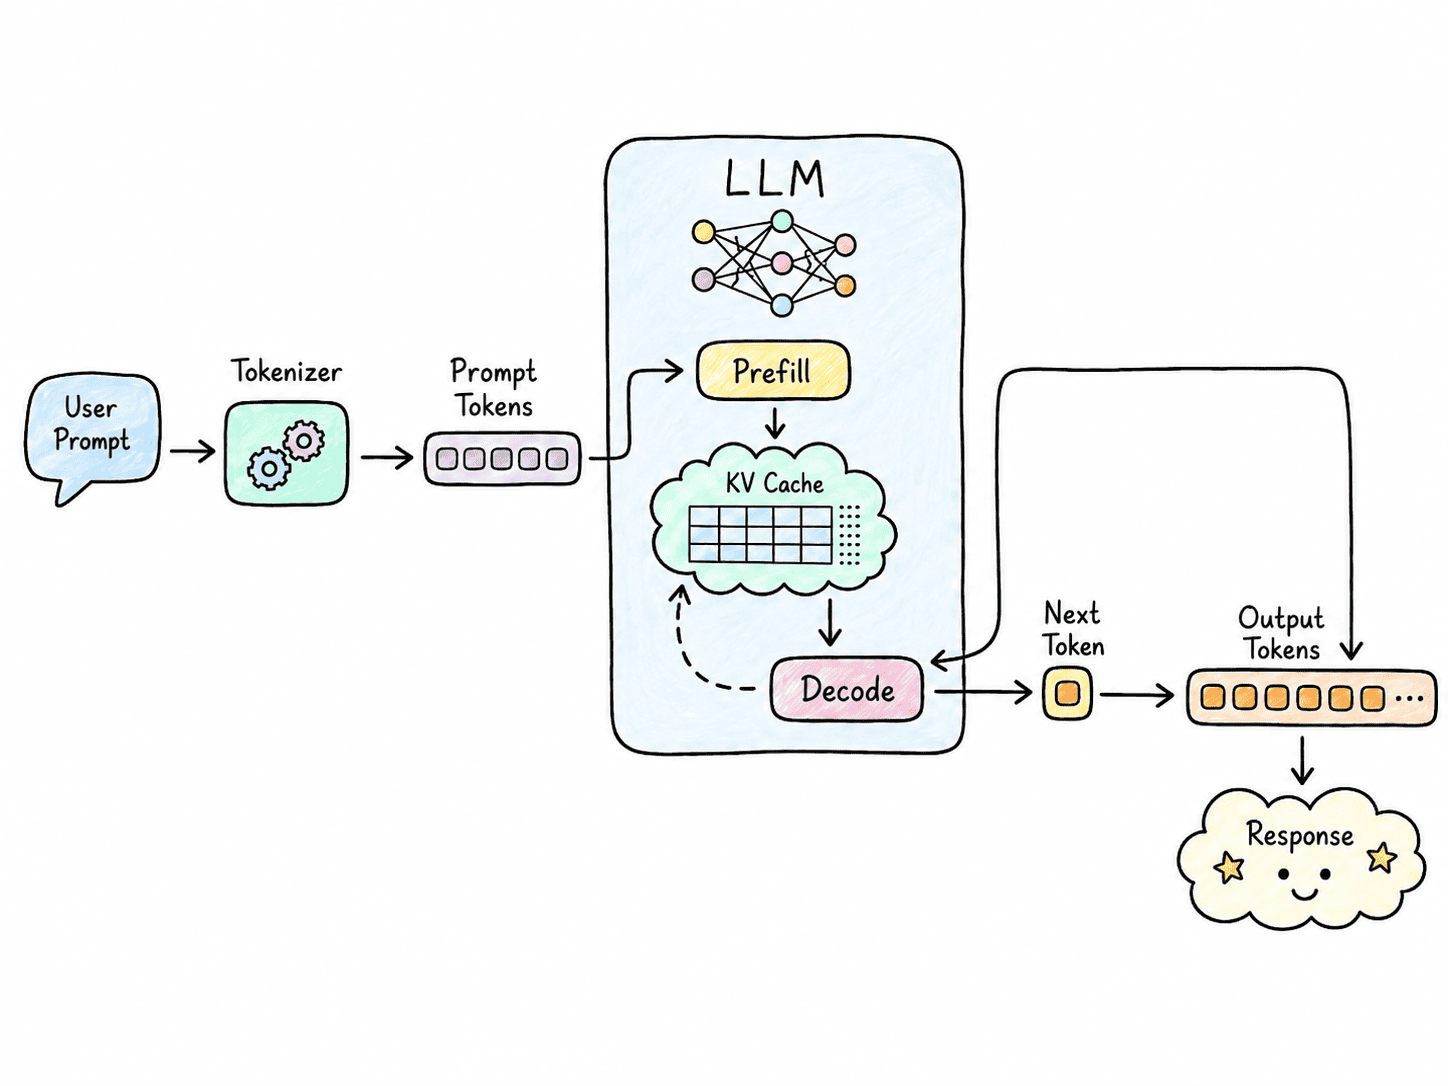
अधिकांश डिकोडर-आधारित LLMs में, इन्फ़ेरेंस दो मुख्य चरणों में होता है: प्रिफ़िल और डिकोड।
छोटे बैच साइज़ पर, डिकोडिंग अक्सर मेमोरी बैंडविड्थ से अधिक सीमित होती है न कि कच्ची GPU कंप्यूट से, क्योंकि मॉडल वज़न और कैश्ड अटेंशन स्टेट्स को लगातार मेमोरी से पढ़ना पड़ता है।
यह अंतर इसलिए महत्वपूर्ण है क्योंकि जो ऑप्टिमाइज़ेशन प्रिफ़िल परफ़ॉर्मेंस सुधारता है, वह ज़रूरी नहीं कि डिकोडिंग परफ़ॉर्मेंस भी सुधारे।
कोई एकल मीट्रिक नहीं है जो बता दे कि कोई इन्फ़ेरेंस सर्वर तेज़, कुशल, या किफायती है। ये मीट्रिक बॉटलनेक्स पहचानने, सर्विंग सेटअप की तुलना करने, और यह तय करने में मदद करते हैं कि कोई ऑप्टिमाइज़ेशन वास्तव में परफ़ॉर्मेंस सुधार रहा है या नहीं।
सबसे महत्वपूर्ण मीट्रिक में शामिल हैं:
उत्पादन में कैश हिट रेट विशेष रूप से महत्वपूर्ण हो सकता है। एजेण्टिक सिस्टम अक्सर बड़े सिस्टम प्रॉम्प्ट, टूल परिभाषाएँ, वार्ता प्रीफ़िक्स, या दस्तावेज़ों का पुन: उपयोग करते हैं।
यदि उस इनपुट का 95% या अधिक कैश से सर्व हो सके, तो दोहराए जाने वाले प्रिफ़िल कंप्यूटेशन को काफ़ी कम किया जा सकता है, जिससे लेटेंसी सुधरती है और उन अनुरोधों को सर्व करने की प्रभावी लागत घटती है।
ये मीट्रिक आपस में गहराई से जुड़े हैं।
बड़े बैच और अधिक कन्करेंसी थ्रूपुट और GPU उपयोग सुधार सकते हैं, लेकिन व्यक्तिगत उपयोगकर्ताओं के लिए लेटेंसी बढ़ा सकते हैं।
इसी तरह, प्रिसीजन घटाने से मेमोरी उपयोग और हार्डवेयर आवश्यकताएँ कम हो सकती हैं, लेकिन यदि हार्डवेयर में उस फ़ॉर्मैट के लिए ऑप्टिमाइज़्ड कर्नेल नहीं हैं, तो जेनरेशन गति में सुधार नहीं भी हो सकता।
इसलिए लक्ष्य किसी एक मीट्रिक को अधिकतम करना नहीं, बल्कि अपने वर्कलोड के लिए लेटेंसी, थ्रूपुट, उपयोग, और लागत के बीच सही संतुलन खोजना है।
इन्फ़ेरेंस परफ़ॉर्मेंस पर मॉडल के आर्किटेक्चर का बड़ा असर होता है।
एक डेंस ट्रांसफ़ॉर्मर मूलतः हर टोकन के लिए अपने लगभग सभी पैरामीटर का उपयोग करता है। इसके विपरीत, Mixture-of-Experts (MoE) मॉडल में कई विशेषज्ञ होते हैं, लेकिन हर टोकन के लिए केवल एक छोटा उपसमूह सक्रिय होता है।
इससे प्रति टोकन आवश्यक गणना घट सकती है, लेकिन साथ ही विशेषज्ञ रूटिंग, लोड बैलेंसिंग, GPU कम्युनिकेशन, और विशेषज्ञ प्लेसमेंट जैसी चुनौतियाँ आ जाती हैं।
अटेंशन आर्किटेक्चर भी मेमोरी उपयोग और इन्फ़ेरेंस गति पर बड़ा प्रभाव डालता है।
पारंपरिक मल्टी-हेड अटेंशन (MHA) हर अटेंशन हेड के लिए अलग की और वैल्यू अभ्यावेदन स्टोर करता है, जिससे KV कैश बड़ा हो सकता है।
मल्टी-क्वेरी अटेंशन (MQA) इस मेमोरी आवश्यकता को कम करता है, क्योंकि कई क्वेरी हेड एक ही की और वैल्यू साझा कर सकते हैं।
ग्रुप्ड-क्वेरी अटेंशन (GQA) दोनों के बीच आता है, जहाँ क्वेरी हेड्स के समूह की-वैल्यू अभ्यावेदन साझा करते हैं। नए आर्किटेक्चर मल्टी-हेड लैटेंट अटेंशन (MLA) जैसी तकनीकों का उपयोग कर सकते हैं, जो इन अभ्यावेदनों को और भी संपीड़ित करते हैं।
इसीलिए समान पैरामीटर काउंट वाले दो मॉडल इन्फ़ेरेंस के दौरान बहुत अलग तरह से व्यवहार कर सकते हैं।
उनका आर्किटेक्चर कम्प्यूट आवश्यकताओं, KV-cache आकार, मेमोरी उपयोग, और जेनरेशन गति पर महत्वपूर्ण प्रभाव डाल सकता है।
अब हम LLMs चलाने के सबसे व्यापक रूप से उपयोग होने वाले फ़्रेमवर्क पर नज़र डालेंगे—लोकल सेटअप से लेकर बड़े पैमाने की प्रोडक्शन प्रणालियों तक।
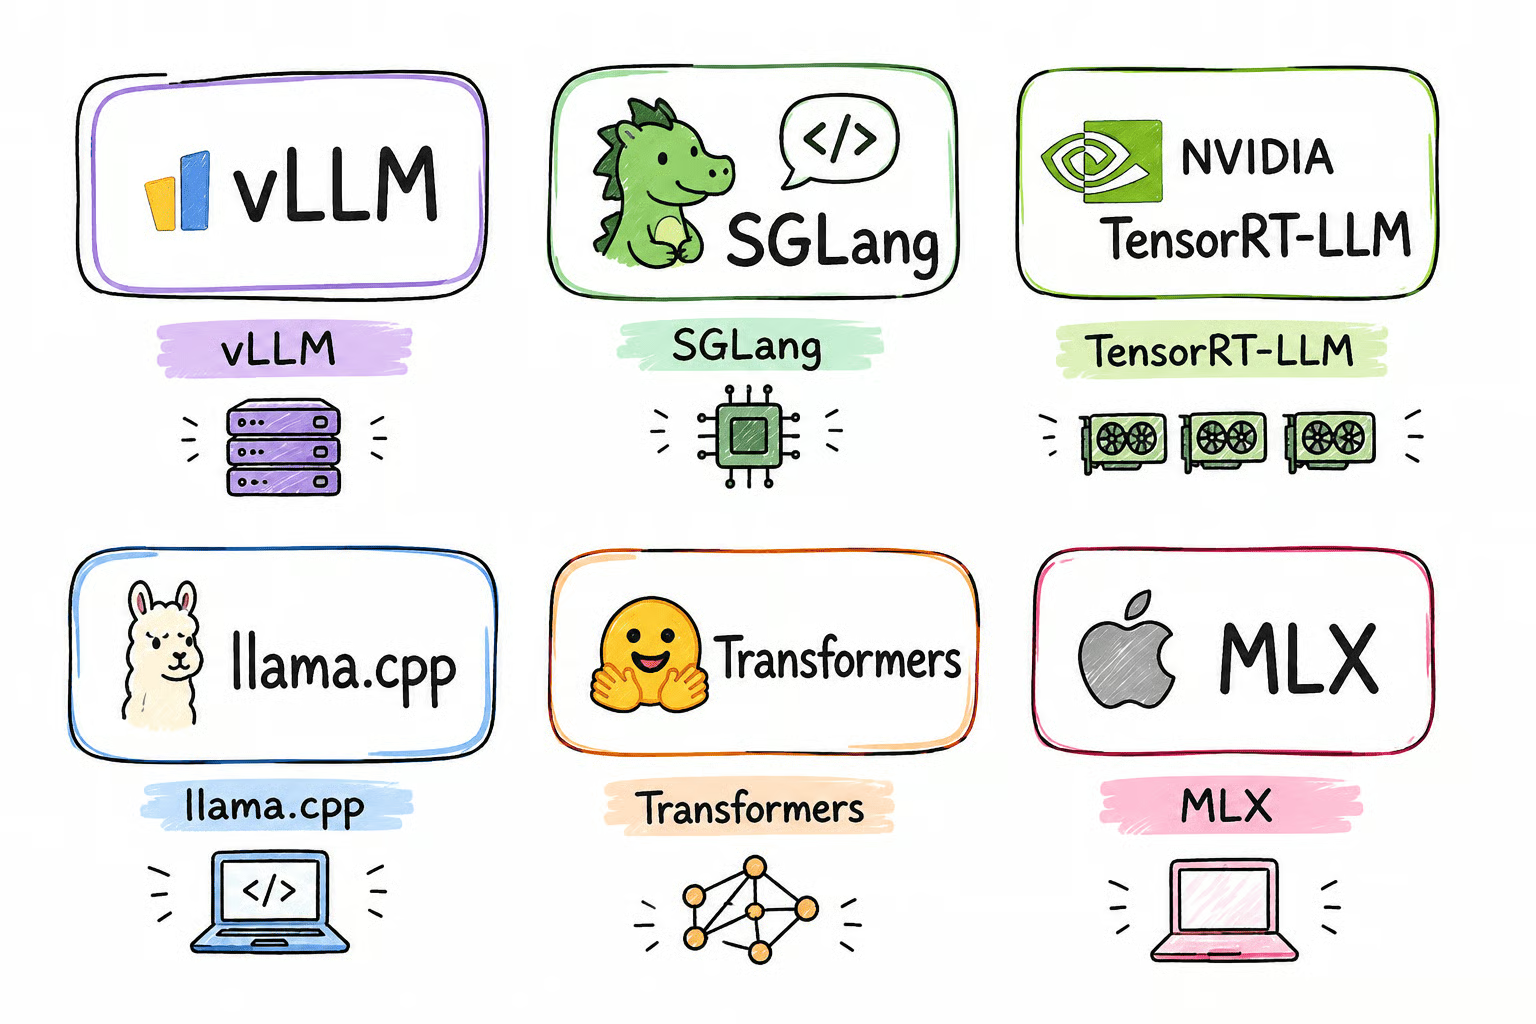
vLLM सबसे व्यापक रूप से उपयोग किए जाने वाले जनरल-पर्पज़ इन्फ़ेरेंस इंजन में से एक है। यह कंटीन्युअस बैचिंग, PagedAttention, चंकेड प्रिफ़िल, प्रीफ़िक्स कैशिंग, क्वांटाइज़ेशन, स्पेकुलेटिव डिकोडिंग, ऑप्टिमाइज़्ड अटेंशन कर्नेल, और डिस्ट्रीब्यूटेड इन्फ़ेरेंस को सपोर्ट करता है।
SGLang उच्च-प्रदर्शन जेनरेशन और कुशल अनुरोध शेड्यूलिंग पर केंद्रित है। यह एजेंट्स, रीजनिंग मॉडल, दोहराए जाने वाले संदर्भ, संरचित आउटपुट, और अन्य जटिल जेनरेशन वर्कलोड के लिए विशेष रूप से उपयोगी है।
TensorRT-LLM NVIDIA का ऑप्टिमाइज़्ड इन्फ़ेरेंस स्टैक है। यह NVIDIA GPU फीचर्स, विशेष CUDA कर्नेल, लो-प्रिसीजन फ़ॉर्मैट, डिस्ट्रीब्यूटेड एग्ज़िक्यूशन, KV कैशिंग, और उन्नत बैचिंग का लाभ उठाता है।
llama.cpp लोकल और संसाधन-सीमित इन्फ़ेरेंस के लिए विशेष रूप से उपयोगी है। यह GGUF क्वांटाइज़ेशन, CPU-GPU हाइब्रिड इन्फ़ेरेंस, और मेमोरी-मैप्ड मॉडल फ़ाइलों को सपोर्ट करता है, जिससे वज़न GPU मेमोरी, सिस्टम RAM, और आवश्यक होने पर डिस्क-बैक्ड मेमोरी में बाँटे जा सकते हैं।
इससे उपलब्ध VRAM से कहीं बड़े मॉडल चलाना संभव हो जाता है, हालाँकि डिस्क पर अत्यधिक निर्भरता परफ़ॉर्मेंस को काफ़ी घटा सकती है।
MLX Apple Silicon के लिए बनाया गया एक इन्फ़ेरेंस और मशीन लर्निंग फ़्रेमवर्क है। यह Mac के यूनिफ़ाइड मेमोरी आर्किटेक्चर का लाभ उठाता है, जिससे M-सीरीज़ डिवाइस पर लोकली LLMs चलाने और उन पर प्रयोग करने के लिए यह एक उपयोगी विकल्प बनता है।
क्वांटाइज़ेशन से लेकर स्पेकुलेटिव डिकोडिंग तक—यह भाग उन तकनीकों को कवर करता है जो इन्फ़ेरेंस को तेज़, सस्ता, और अधिक मेमोरी-कुशल बनाती हैं।
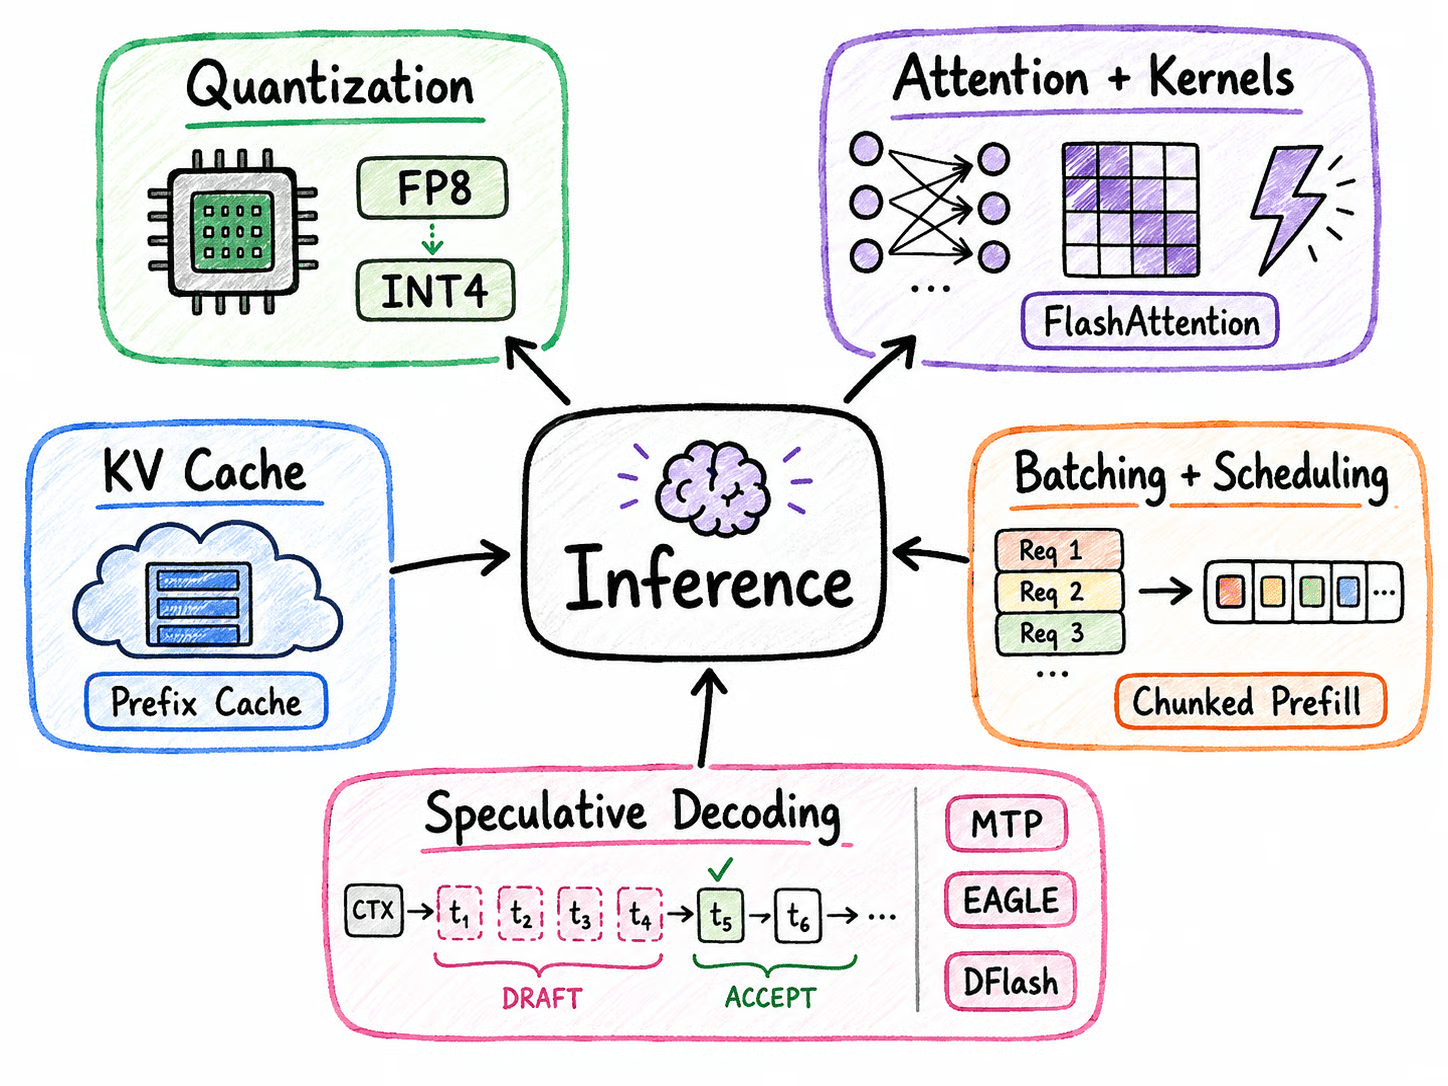
सबसे आम इन्फ़ेरेंस ऑप्टिमाइज़ेशन में से एक है क्वांटाइज़ेशन।
मॉडल अक्सर BF16 या FP16 प्रिसीजन का उपयोग करके प्रशिक्षित किए जाते हैं।
क्वांटाइज़ेशन वज़न, ऐक्टिवेशन, या कैश को छोटे संख्यात्मक फ़ॉर्मैट में निरूपित करता है।
आम फ़ॉर्मैट और तरीक़े शामिल हैं:
प्रिसीजन घटाने से मेमोरी खपत कम होती है और मेमोरी बैंडविड्थ आवश्यकताएँ भी कम हो सकती हैं।
हालाँकि, छोटा होना स्वतः तेज़ होना नहीं है। परफ़ॉर्मेंस काफ़ी हद तक इस पर निर्भर करता है कि लक्षित हार्डवेयर उस प्रिसीजन के लिए कुशल कर्नेल प्रदान करता है या नहीं।
KV कैश को भी क्वांटाइज़ किया जा सकता है, जो लंबे संदर्भ और उच्च कन्करेंसी सर्विंग के लिए और अधिक मूल्यवान होता जाता है।
अटेंशन ट्रांसफ़ॉर्मर के अंदर सबसे महत्वपूर्ण ऑपरेशनों में से एक है। यह मॉडल को यह तय करने देता है कि अगला टोकन जनरेट करते समय संदर्भ में कौन से टोकन सबसे प्रासंगिक हैं।
लेकिन, संदर्भ विंडो बढ़ने के साथ अटेंशन कम्प्यूटेशनली महंगा हो सकता है।
यहीं ऑप्टिमाइज़्ड कर्नेल महत्वपूर्ण हो जाते हैं। कर्नेल बेहद ऑप्टिमाइज़्ड कोड होता है जो GPU जैसे हार्डवेयर पर किसी विशेष गणितीय ऑपरेशन को अंजाम देता है। मॉडल कैसे काम करता है, यह बदले बिना, ऑप्टिमाइज़्ड कर्नेल उन्हीं गणनाओं को तेज़ और अधिक मेमोरी-कुशल बना देते हैं।
एक अच्छा उदाहरण है FlashAttention। पारंपरिक अटेंशन GPU मेमोरी और कंप्यूट यूनिट्स के बीच बड़े इंटरमीडिएट रिज़ल्ट्स को इधर-उधर करने में काफ़ी समय लगा सकता है।
FlashAttention इस ओवरहेड को अटेंशन को छोटे ब्लॉक्स में प्रोसेस करके और अधिक गणना GPU के क़रीब रखकर घटाता है।
आधुनिक इन्फ़ेरेंस इंजन कई समान ऑप्टिमाइज़ेशन का उपयोग करते हैं, जिनमें शामिल हैं:
मुख्य विचार यह है कि ये तकनीकें आम तौर पर मॉडल या उसके आउटपुट की गुणवत्ता नहीं बदलतीं। ये गणनाओं के निष्पादन के तरीके को ऑप्टिमाइज़ करती हैं, जिससे इन्फ़ेरेंस इंजन टोकन तेज़ी से जनरेट करते हैं और उपलब्ध हार्डवेयर का अधिक कुशलतापूर्वक उपयोग करते हैं।
जेनरेशन के दौरान, ट्रांसफ़ॉर्मर पिछले टोकनों से की और वैल्यू को KV कैश में स्टोर करते हैं।
इस कैश के बिना, हर नया टोकन जनरेट करते समय मॉडल को पिछले टोकनों को फिर से कंप्यूट करना पड़ता।
नुकसान यह है कि मेमोरी खपत बढ़ती है। लंबे संदर्भ और एक साथ कई उपयोगकर्ता KV कैश को GPU मेमोरी का बड़ा हिस्सा घेरने पर मजबूर कर सकते हैं।
कई तकनीकें इस समस्या का समाधान करती हैं।
PagedAttention KV-cache मेमोरी को बड़े, सतत आवंटन की आवश्यकता के बजाय प्रबंधनीय ब्लॉक्स में बाँट देता है।
प्रीफ़िक्स कैशिंग समान प्रीफ़िक्स वाले अनुरोधों को पहले से कंप्यूट किए गए KV स्टेट्स का पुन: उपयोग करने देती है। यह साझा सिस्टम प्रॉम्प्ट, एजेंट्स, और दोहराए जाने वाले डॉक्यूमेंट संदर्भों के लिए विशेष रूप से उपयोगी है।
अन्य तरीक़ों में शामिल हैं:
बड़े पैमाने की इन्फ़ेरेंस प्रणालियों में, KV-cache प्रबंधन मॉडल वज़न ऑप्टिमाइज़ेशन जितना ही महत्वपूर्ण हो सकता है।
जब कोई इन्फ़ेरेंस सर्वर एक ही समय में कई अनुरोध प्राप्त करता है, तो वह उन्हें साथ में प्रोसेस करने की कोशिश करता है ताकि GPU व्यस्त रहे। इसे बैचिंग कहते हैं।
समस्या यह है कि LLM अनुरोध शायद ही कभी एक ही समय पर पूरे होते हैं।
एक उपयोगकर्ता 50 टोकन जनरेट कर सकता है जबकि दूसरा 2,000।
पारंपरिक बैचिंग में, छोटे अनुरोध बैच के सबसे लंबे अनुरोध के पूरा होने का इंतज़ार करते रह सकते हैं।
कंटीन्युअस बैचिंग इसे इस तरह सुलझाती है कि पूरे हो चुके अनुरोधों को हटा देती है और उनकी जगह तुरंत नए अनुरोध लगा देती है। इससे GPU काम करता रहता है और क्षमता बेकार नहीं जाती।
एक और उपयोगी तकनीक है चंकेड प्रिफ़िल। एक बहुत बड़े प्रॉम्प्ट को एक साथ प्रोसेस करने के बजाय, सर्वर उसे छोटे-छोटे हिस्सों में बाँट देता है, ताकि वे अन्य अनुरोधों को, जो पहले से टोकन जेनरेट कर रहे हैं, ब्लॉक न करें।
ट्रैफ़िक बढ़ने पर, इन्फ़ेरेंस एक शेड्यूलिंग समस्या बन जाता है। सर्वर को तय करना होता है कि किन अनुरोधों को प्रोसेस करना है, उन्हें कैसे समूहित करना है, और GPU मेमोरी, सीक्वेंस लंबाई, थ्रूपुट, और लेटेंसी के बीच संतुलन कैसे बनाना है।
पारंपरिक ऑटोरिग्रेसिव डिकोडिंग एक समय में एक टोकन जनरेट करती है, जिससे जेनरेशन स्वाभाविक रूप से क्रमिक हो जाती है।
स्पेकुलेटिव डिकोडिंग इस बाधा को तोड़ने की कोशिश करती है—कई संभावित टोकन सस्ते में जनरेट करके, और फिर पूर्ण लक्ष्य मॉडल से उन्हें समानांतर में सत्यापित कराकर।
यदि कई उम्मीदवार स्वीकृत हो जाते हैं, तो जेनरेशन लक्ष्य मॉडल के आउटपुट वितरण को बदले बिना एक साथ कई टोकन आगे बढ़ सकती है।
कई तरीक़े इसी विचार का पालन करते हैं:
मूल विचार सरल है:
कई संभावित भविष्य के टोकन सस्ते में जनरेट करें, फिर उन्हें बड़े मॉडल से कुशलता से सत्यापित कराएँ।
स्पेकुलेटिव डिकोडिंग तब सबसे बेहतर काम करती है जब अगले टोकन अपेक्षाकृत अनुमानित हों और स्वीकृति दर ऊँची हो।
यह इसे कोडिंग और अन्य क्रमिक कार्यों के लिए विशेष रूप से उपयोगी बनाती है—जहाँ छोटा मॉडल भी अक्सर आगे क्या आएगा, यह भाँप सकता है।
जटिल रीजनिंग या अत्यंत अप्रत्याशित जेनरेशन में, कम ड्राफ़्ट टोकन स्वीकार हो सकते हैं, जिससे परफ़ॉर्मेंस लाभ घट सकता है।
जैसे-जैसे मॉडल और वर्कलोड बढ़ते हैं, मेमोरी बड़ी बाधा बन जाती है। यहाँ, हम ऑफ़लोडिंग, मल्टी-GPU इन्फ़ेरेंस, डिसएग्रीगेटेड सर्विंग, और लॉन्ग-कॉन्टेक्स्ट ऑप्टिमाइज़ेशन की पड़ताल करेंगे।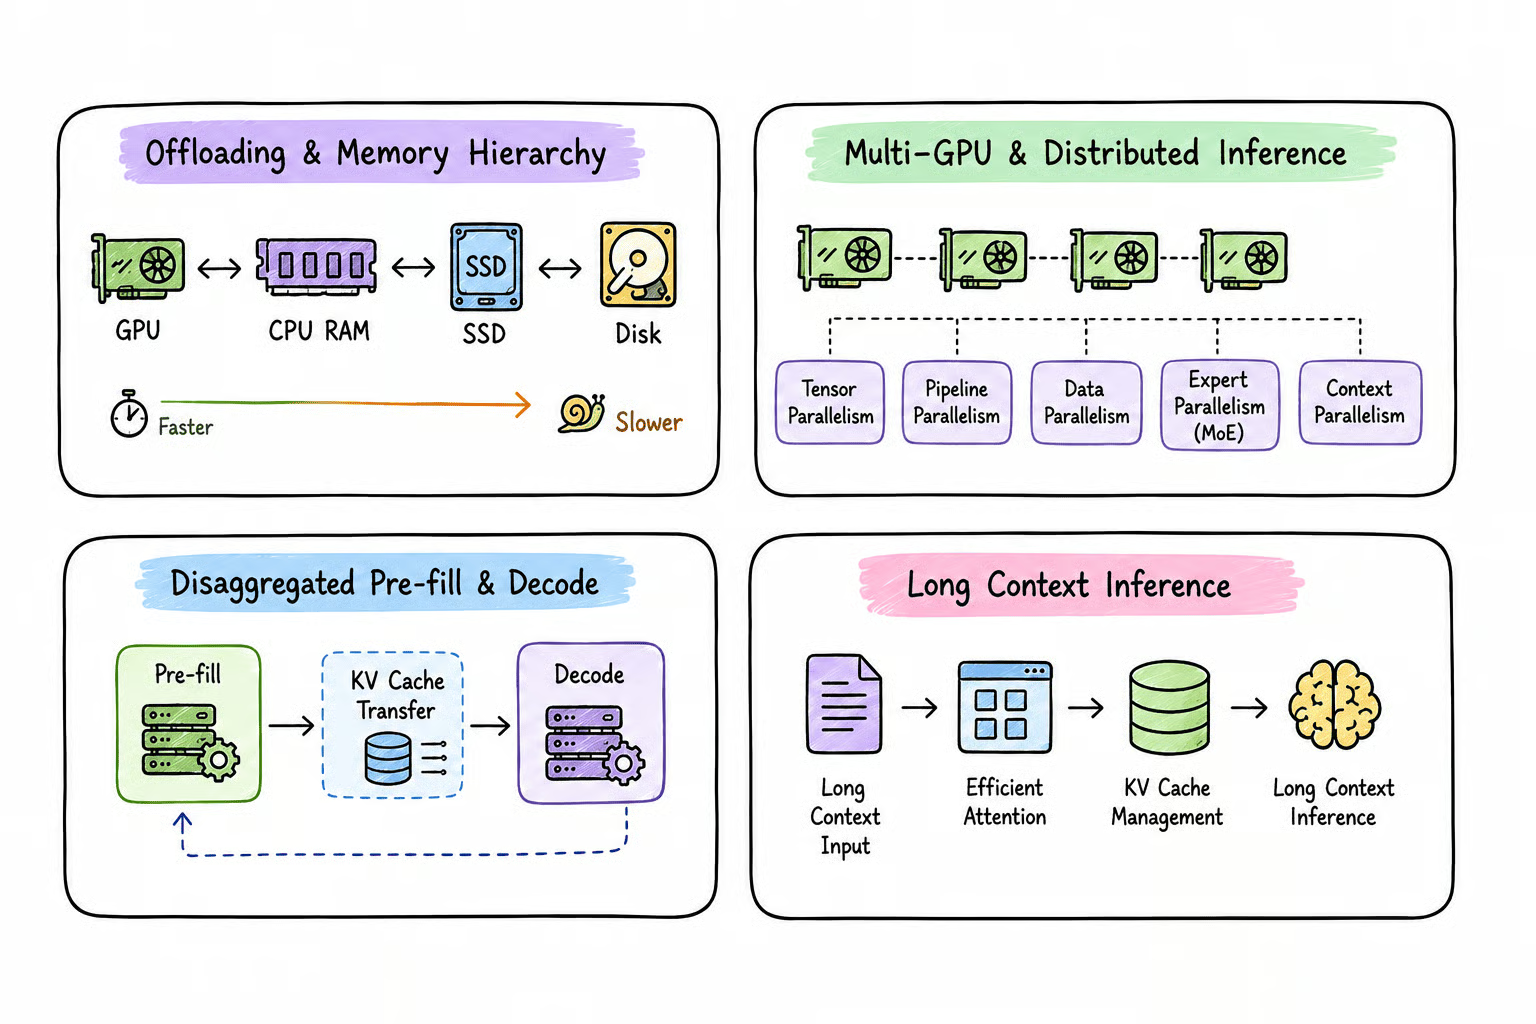
कभी-कभी लक्ष्य अधिकतम गति नहीं होता। लक्ष्य बस यह होता है कि आपके पास जो हार्डवेयर है, उस पर मॉडल चल जाए।
इन्फ़ेरेंस प्रणालियाँ अलग-अलग स्तर की मेमोरी का उपयोग कर सकती हैं:
GPU HBM → CPU RAM → NVMe storage
GPU मेमोरी सबसे तेज़ होती है, लेकिन इसकी क्षमता सबसे सीमित होती है।
CPU मेमोरी कम गति पर अधिक क्षमता देती है, जबकि NVMe स्टोरेज और भी अधिक स्थान देता है लेकिन काफी धीमा होता है।
यदि कोई मॉडल या उसका KV कैश पूरी तरह VRAM में फिट नहीं होता, तो इन्फरेंस इंजन निम्न तकनीकों का उपयोग कर वर्कलोड का हिस्सा अन्यत्र स्थानांतरित कर सकते हैं:
इससे उपलब्ध मेमोरी बढ़ती है, लेकिन आमतौर पर परफॉर्मेंस घटती है क्योंकि डेटा को धीमी मेमोरी परतों के बीच—अक्सर PCIe के पार—आना-जाना पड़ता है।
मूल सौदा सरल है: जितना डेटा GPU मेमोरी से दूर जाता है, उतनी क्षमता तो मिलती है, लेकिन इन्फरेंस आम तौर पर उतना ही धीमा होता जाता है।
बहुत बड़े मॉडलों के लिए अक्सर एक से अधिक एक्सेलेरेटर की आवश्यकता होती है।
आम रणनीतियाँ शामिल हैं:
जैसे ही इन्फरेंस कई GPUs तक फैलता है, संचार एक महत्वपूर्ण बाधा बन जाता है।
इसलिए NVLink, NVSwitch, और हाई-स्पीड नेटवर्किंग जैसी तकनीकों का प्रदर्शन पर बड़ा असर पड़ सकता है।
इन्फरेंस के दौरान प्रीफिल और डिकोड का व्यवहार काफी अलग होता है। प्रीफिल आम तौर पर कंप्यूट-इंटेंसिव होता है, क्योंकि यह कई प्रॉम्प्ट टोकन्स को समानांतर में संसाधित करता है, जबकि डिकोड अक्सर मेमोरी-बैंडविड्थ-इंटेंसिव होता है, जो एक बार में एक टोकन जेनरेट करता है।
दोनों चरणों को एक ही GPUs के लिए प्रतिस्पर्धा कराने के बजाय, बड़े सर्विंग सिस्टम इन्हें अलग कर सकते हैं:
Prompt → Prefill Worker → KV Cache Transfer → Decode Worker → Response
प्रीफिल वर्कर्स प्रॉम्प्ट को प्रोसेस करके KV कैश बनाते हैं, जिसे फिर समर्पित डिकोड वर्कर्स को ट्रांसफ़र किया जाता है जो प्रतिक्रिया जेनरेट करते हैं। इससे हर चरण को अलग हार्डवेयर, बैचिंग, और पैरेललिज़्म रणनीतियों का उपयोग करने की सुविधा मिलती है।
मुख्य लाभ यह है कि प्रीफिल और डिकोड को स्वतंत्र रूप से ऑप्टिमाइज़ और स्केल किया जा सकता है, जिससे समय-से-पहला-टोकन (TTFT) और इंटर-टोकन लेटेंसी (ITL) पर नियंत्रण में मदद मिलती है—खासकर लंबे प्रॉम्प्ट्स और उच्च-ट्रैफ़िक वर्कलोड्स के लिए।
लंबी कॉन्टेक्स्ट विंडो एक अलग तरह की इन्फरेंस चुनौतियाँ पैदा करती हैं। जैसे-जैसे इनपुट बढ़ता है, प्रीफिल में अधिक कंप्यूटेशन लगता है, जबकि KV कैश बड़ा होता जाता है, GPU मेमोरी का उपभोग करता है और डिकोडिंग को महँगा बनाता है।
कई तकनीकें मदद कर सकती हैं:
महत्वपूर्ण बात यह है कि एक मिलियन-टोकन कॉन्टेक्स्ट विंडो का समर्थन करना इसका मतलब नहीं कि एक मिलियन टोकन सर्व करना तेज़, सस्ता, या व्यावहारिक है.
लंबे कॉन्टेक्स्ट मेमोरी उपयोग, समय-से-पहला-टोकन, और कुल इन्फरेंस लागत बढ़ाते हैं।
हर मॉडल इन्फरेंस समय पर एक जैसा व्यवहार नहीं करता, इसलिए हम MoE मॉडलों, स्ट्रक्चर्ड जेनरेशन, और रीज़निंग वर्कलोड्स की विशिष्ट चुनौतियों की जाँच करेंगे।
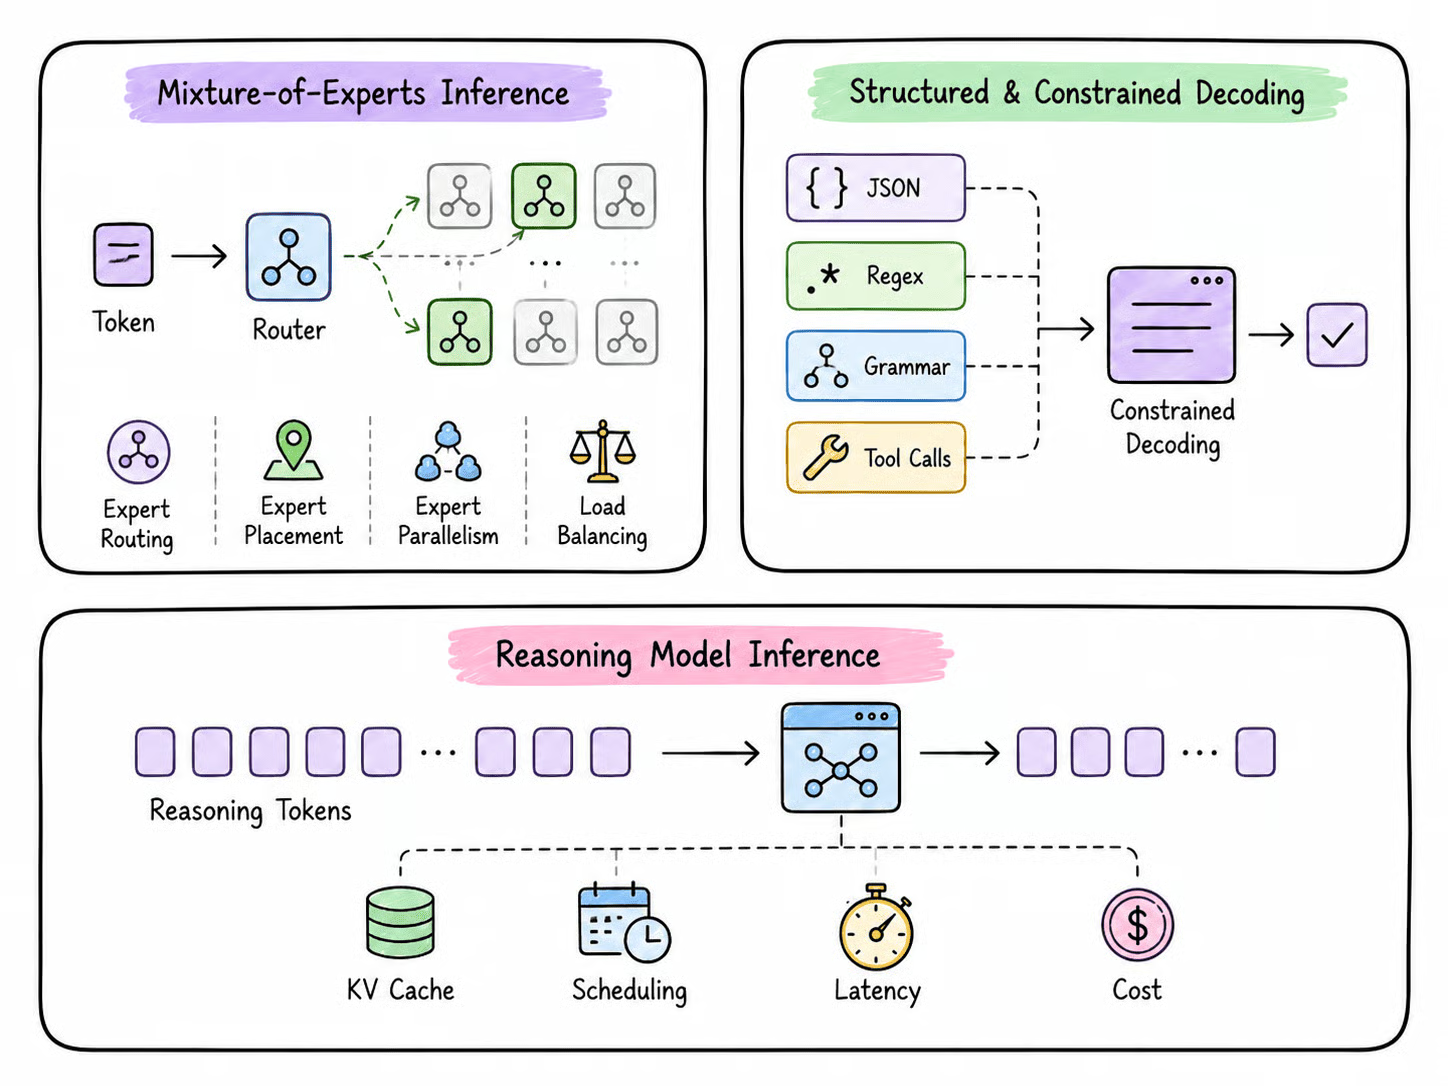
Mixture-of-Experts (MoE) मॉडल डेंस मॉडलों से अलग तरह से काम करते हैं। हर टोकन के लिए हर पैरामीटर का उपयोग करने के बजाय, एक राउटर कुछ ही एक्सपर्ट्स का चयन करता है जो प्रत्येक टोकन को प्रोसेस करें।
इससे कंप्यूटेशन कम होता है, लेकिन सभी एक्सपर्ट्स का पूरा सेट फिर भी कहीं न कहीं सर्विंग हार्डवेयर पर स्टोर रहना चाहिए।
कुशल MoE इन्फरेंस, इसलिए, इन पर निर्भर करता है:
स्केल पर, कम्युनिकेशन एक बड़ा बॉटलनेक बन सकता है, इसलिए DeepEP जैसी तकनीकें एक्सपर्ट्स के बीच टोकन्स को ले जाने के लिए विशेष उच्च-थ्रूपुट और कम-लेटेंसी कर्नेल्स प्रदान करती हैं।
मुख्य अंतर यह है कि कुल पैरामीटर्स यह तय करते हैं कि मॉडल की कितनी क्षमता स्टोर करनी होगी, जबकि सक्रिय पैरामीटर्स इस बात का बेहतर अंदाज़ा देते हैं कि प्रति टोकन कितना कंप्यूटेशन किया जाता है।
आधुनिक LLM अनुप्रयोगों को अक्सर बिना बंधनों वाले टेक्स्ट से अधिक पूर्वानुमेय आउटपुट चाहिए। उदाहरण के लिए, एजेंट्स को मान्य JSON, टूल आर्ग्यूमेंट्स, SQL, या पूर्व-निर्धारित स्कीमा के अनुरूप प्रतिक्रियाएँ जेनरेट करनी पड़ सकती हैं।
कंस्ट्रेन्ड डिकोडिंग यह नियंत्रित करती है कि हर चरण में मॉडल किन टोकन्स को जेनरेट करने की अनुमति है, ताकि अंतिम आउटपुट आवश्यक संरचना का पालन करे। vLLM जैसे आधुनिक इन्फरेंस इंजन निम्न बाधाओं का समर्थन करते हैं:
यह आमतौर पर बिना प्रतिबंध टेक्स्ट जेनरेट कर बाद में सुधार करने की तुलना में अधिक भरोसेमंद होता है। हालांकि, कंस्ट्रेन्ड डिकोडिंग संरचना की गारंटी देता है, जरूरी नहीं कि उसके भीतर की जानकारी की शुद्धता की।
रीज़निंग मॉडल बहुत अलग इन्फरेंस वर्कलोड बनाते हैं क्योंकि वे अंतिम उत्तर देने से पहले हज़ारों मध्यवर्ती रीज़निंग टोकन्स जेनरेट कर सकते हैं.
लॉन्ग-कॉन्टेक्स्ट वर्कलोड्स के विपरीत, जहाँ लागत का अधिकांश हिस्सा बड़े इनपुट को प्रोसेस करने से आ सकता है, रीज़निंग वर्कलोड्स जेनरेशन के दौरान भी महँगे रह सकते हैं क्योंकि डिकोड चरण स्वयं बहुत लंबा हो जाता है.
लंबे रीज़निंग ट्रेसेज़ का प्रभाव इन पर पड़ता है:
एक और चुनौती यह है कि रीज़निंग की लंबाई का अनुमान लगाना अक्सर कठिन होता है।
एक अनुरोध जल्दी समाप्त हो सकता है, जबकि दूसरा हज़ारों टोकन्स तक जेनरेट करता रह सकता है। इससे बैचिंग, शेड्यूलिंग, और KV-कैश अलोकेशन कठिन हो जाते हैं—खासकर जब एक साथ कई उपयोगकर्ताओं को सर्व करना हो।
नतीजतन, कुछ सौ टोकन्स जेनरेट करने वाले चैटबॉट और 10,000 टोकन्स जेनरेट कर सकने वाले रीज़निंग मॉडल को सर्व करने के लिए बहुत अलग इन्फरेंस, मेमोरी, और शेड्यूलिंग रणनीतियों की आवश्यकता हो सकती है।
सॉफ्टवेयर ऑप्टिमाइज़ेशन LLM इन्फरेंस का केवल एक हिस्सा है। इसके नीचे का हार्डवेयर भी गति, मेमोरी क्षमता, स्केलेबिलिटी, और लागत पर उतना ही प्रभाव डाल सकता है।
महत्वपूर्ण हार्डवेयर विशेषताएँ शामिल हैं:
हार्डवेयर प्रदर्शन को समझने के लिए एक उपयोगी अवधारणा है अरिथमेटिक इंटेंसिटी, जो यह बताती है कि जितना डेटा स्थानांतरित करना पड़ता है, उसके सापेक्ष कितना कंप्यूटेशन किया जाता है। उच्च अरिथमेटिक इंटेंसिटी वाले वर्कलोड प्रायः कंप्यूट-बाउंड होते हैं, जबकि निम्न अरिथमेटिक इंटेंसिटी वाले वर्कलोड अक्सर मेमोरी बैंडविड्थ से सीमित होते हैं।
प्रीफिल के दौरान कई प्रॉम्प्ट टोकन्स समानांतर में प्रोसेस हो सकते हैं, जिससे हार्डवेयर अपने कंप्यूट संसाधनों का बेहतर उपयोग कर पाता है। जबकि डिकोड के दौरान टोकन्स क्रमवार जेनरेट होते हैं, और सिस्टम बार-बार मॉडल वेट्स और KV-कैश डेटा तक पहुँचता है। इससे जेनरेशन स्पीड के लिए मेमोरी बैंडविड्थ विशेष रूप से महत्वपूर्ण हो जाती है।
इसीलिए मेमोरी क्षमता और मेमोरी बैंडविड्थ दो अलग चीजें हैं। उदाहरण के लिए, NVIDIA DGX Spark और एक Apple M4 Max सिस्टम—दोनों अधिकतम 128 GB यूनिफ़ाइड मेमोरी दे सकते हैं। हालांकि, DGX Spark 273 GB/s की मेमोरी बैंडविड्थ देता है, जबकि M4 Max अधिकतम 546 GB/s तक पहुँचता है। तो यद्यपि दोनों सिस्टम एक ही बड़े मॉडल को मेमोरी में फिट कर पाते हों, उनके इन्फरेंस प्रदर्शन का व्यवहार बहुत अलग हो सकता है।
यही सिद्धांत GPUs और लोकल AI मशीनों की तुलना पर भी लागू होता है: मॉडल को फिट कर लेना क्षमता की समस्या हल करता है, ज़रूरी नहीं कि गति की समस्या भी.
LLM इन्फरेंस के लिए कंप्यूट परफॉर्मेंस, मेमोरी क्षमता, मेमोरी बैंडविड्थ, और इंटरकनेक्ट स्पीड—सभी को साथ में देखना चाहिए।
इतनी सारी इन्फरेंस तकनीकों के बीच, कुंजी यह पहचानना है कि पहले आपके सिस्टम को वास्तविक रूप से क्या सीमित कर रहा है.
जो मॉडल VRAM में फिट नहीं होता, उसके लिए वह ऑप्टिमाइज़ेशन चाहिए जो उच्च लेटेंसी या कम थ्रूपुट से जूझ रहे सर्वर से बिल्कुल अलग है।
|
समस्या / परिदृश्य |
विचार करने योग्य तकनीकें |
|
मॉडल VRAM में फिट नहीं होता |
क्वांटाइज़ेशन, CPU ऑफ़लोडिंग, टेंसर/पाइपलाइन पैरेललिज़्म |
|
उच्च TTFT / धीमा प्रीफिल |
प्रिफिक्स कैशिंग, चंक्ड प्रीफिल ट्यूनिंग, ऑप्टिमाइज़्ड अटेंशन |
|
धीमी टोकन जेनरेशन |
स्पेक्युलेटिव डिकोडिंग, ऑप्टिमाइज़्ड कर्नेल्स, लोअर प्रिसीजन |
|
कम थ्रूपुट / उच्च कन्करेंसी |
कॉन्टीन्यूस बैचिंग, रिक्वेस्ट शेड्यूलिंग, डेटा पैरेललिज़्म |
|
KV-कैश मेमोरी दबाव |
KV-कैश क्वांटाइज़ेशन, पेजिंग, ऑफ़लोडिंग, घटाया कॉन्टेक्स्ट/कन्करेंसी |
|
लॉन्ग-कॉन्टेक्स्ट वर्कलोड्स |
चंक्ड प्रीफिल, कॉन्टेक्स्ट पैरेललिज़्म, KV-कैश ऑप्टिमाइज़ेशन |
|
बड़े MoE मॉडल |
एक्सपर्ट पैरेललिज़्म, एक्सपर्ट प्लेसमेंट, लोड बैलेंसिंग, ऑप्टिमाइज़्ड MoE कर्नेल्स |
|
दोहराए गए या साझा प्रॉम्प्ट्स |
प्रिफिक्स कैशिंग, प्रिफिक्स-अवेयर राउटिंग |
|
लोकल / सीमित हार्डवेयर |
क्वांटाइज़ेशन, llama.cpp/GGUF, Apple Silicon पर MLX |
|
बड़े पैमाने पर प्रोडक्शन सर्विंग |
vLLM, SGLang, TensorRT-LLM, डिस्ट्रीब्यूटेड इन्फरेंस, प्रीफिल/डिकोड डिसएग्रीगेशन |
महत्वपूर्ण बात यह है कि कोई एक सर्वश्रेष्ठ ऑप्टिमाइज़ेशन नहीं है.
TTFT, टोकन जेनरेशन स्पीड, थ्रूपुट, GPU उपयोग, और मेमोरी उपयोग जैसे मेट्रिक्स मापने से शुरू करें। फिर उस तकनीक को लागू करें जो वास्तविक बॉटलनेक को लक्षित करती है और दोबारा बेंचमार्क करें।
उदाहरण के लिए, जब मेमोरी सीमित हो तो क्वांटाइज़ेशन मदद कर सकता है; थ्रूपुट बढ़ाने के लिए कॉन्टीन्यूस बैचिंग; बार-बार होने वाले प्रीफिल कार्य को घटाने के लिए प्रिफिक्स कैशिंग; और जब भविष्य के टोकन्स अनुमानित हों तो जेनरेशन स्पीड बढ़ाने के लिए स्पेक्युलेटिव डिकोडिंग।
उद्देश्य केवल टोकन्स प्रति सेकंड को अधिकतम करना नहीं है, बल्कि लेटेंसी, थ्रूपुट, मेमोरी उपयोग, मॉडल गुणवत्ता, हार्डवेयर, और लागत के बीच सर्वोत्तम संतुलन खोजना है।
स्थानीय रूप से LLM चलाना और llama.cpp से प्रतिक्रिया पाना एक बेहतरीन शुरुआती कदम है, लेकिन इसका अर्थ यह नहीं कि आपने स्वतः ही एक कुशल इन्फरेंस सिस्टम बना लिया है।
व्यक्तिगत प्रोजेक्ट्स, प्रयोग, और छोटे वर्कलोड्स के लिए, एक साधारण लोकल सेटअप पर्याप्त हो सकता है।
लेकिन जैसे ही आप कई उपयोगकर्ताओं को सर्व करना शुरू करते हैं, लंबे कॉन्टेक्स्ट संभालते हैं, या जटिल कोडिंग और एजेण्टिक सिस्टम बनाते हैं, आवश्यकताएँ तेजी से बदलती हैं।
आपको ऐसा इन्फरेंस स्टैक चाहिए जो अनेक अनुरोधों को एक साथ प्रोसेस कर सके, अच्छी जेनरेशन स्पीड बनाए रखे, मेमोरी का कुशल प्रबंधन करे, और वर्कलोड्स के अधिक माँग वाले होने पर भी उत्तरदायी बना रहे।
यहीं पर कॉन्टीन्यूस बैचिंग, प्रिफिक्स कैशिंग, KV-कैश प्रबंधन, क्वांटाइज़ेशन, स्पेक्युलेटिव डिकोडिंग, ऑप्टिमाइज़्ड कर्नेल्स, पैरेललिज़्म, और रिक्वेस्ट शेड्यूलिंग जैसी अवधारणाएँ मायने रखने लगती हैं।
आपको TTFT, थ्रूपुट, लेटेंसी, कन्करेंसी, GPU उपयोग, और प्रति टोकन लागत जैसे मेट्रिक्स भी समझने चाहिए—सिर्फ टोकन्स प्रति सेकंड से प्रदर्शन का आकलन करने के बजाय।
हर मॉडल या वर्कलोड के लिए कोई सार्वभौमिक कॉन्फ़िगरेशन नहीं होता। जो तकनीक कोडिंग के लिए अच्छी काम करे, वही रीज़निंग के लिए वैसा लाभ न दे सके।
जो ऑप्टिमाइज़ेशन थ्रूपुट बढ़ाए, वह लेटेंसी बढ़ा सकता है। क्वांटाइज़ेशन मेमोरी आवश्यकताओं को काफी घटा सकता है, लेकिन अधिक आक्रामक क्वांटाइज़ेशन मॉडल गुणवत्ता भी घटा सकता है।
आखिरकार, अच्छा LLM इन्फरेंस इंजीनियरिंग संतुलन की बात है। उद्देश्य है आपके पास उपलब्ध हार्डवेयर का सर्वोत्तम उपयोग करना—गति, मेमोरी, थ्रूपुट, लेटेंसी, मॉडल गुणवत्ता, और लागत के बीच संतुलन बनाकर।
इसीलिए इन्फरेंस सीखना मायने रखता है। डिफ़ॉल्ट सेटिंग्स पर पूरी तरह निर्भर रहने या बस अधिक GPUs जोड़ने के बजाय, आप समझ सकते हैं कि बॉटलनेक कहाँ है, सही ऑप्टिमाइज़ेशन चुन सकते हैं, और अपने वर्कलोड के अनुरूप एक सर्विंग सिस्टम बना सकते हैं।
LLM इन्फरेंस के बारे में अधिक जानने के लिए, मैं हमारा Understanding LLM Inference पर वेबिनार देखने की सलाह देता हूँ।
टॉप DataCamp कोर्सेज़
कोर्स
लर्निंग पाथ
कोर्स