
Curso
Modelos Transformer com PyTorch
2 h
9.2K
A inferência de Large Language Models (LLMs) está virando uma arte própria.
As empresas buscam cada vez mais engenheiros de inferência de LLM e MLOps capazes de servir modelos mais rápido, usando menos hardware e reduzindo os custos de inferência.
Seja rodando modelos localmente, implantando um servidor de inferência ou experimentando LLMs open source, entender como a inferência funciona faz muita diferença.
Por trás da inferência eficiente de LLMs existe toda uma pilha de técnicas, incluindo quantização, otimização do KV-cache, continuous batching, kernels de atenção otimizados, speculative decoding e ajustes conscientes do hardware.
Muitos frameworks modernos de inferência habilitam parte disso automaticamente — o que significa que você talvez já esteja colhendo esses benefícios sem entender totalmente o que acontece nos bastidores.
Neste guia, vamos explorar os fundamentos da inferência de LLMs, as métricas de performance mais importantes, frameworks populares de serving e técnicas práticas para deixar os modelos mais rápidos, econômicos em memória e baratos de operar.
Vamos começar pelo básico: o que é inferência, como ela funciona, como medir performance e por que a arquitetura do modelo importa.
Inferência de LLM é o que acontece toda vez que você envia um prompt para um modelo de linguagem e espera a resposta. O modelo processa a entrada por suas camadas e gera a saída token por token.
Isso é diferente de treinamento. No treinamento, o modelo aprende com os dados e atualiza seus pesos. Na inferência, esses pesos ficam fixos, e o modelo treinado é usado apenas para gerar previsões.
É na inferência que ocorre a maior parte do custo computacional de LLMs em produção.
Um modelo pode ser treinado uma vez, mas atende a milhões de requisições. Por isso, eficiência na inferência é hoje um dos desafios de engenharia mais relevantes em IA aplicada.
Entender tecnicamente como a inferência funciona é importante porque os gargalos nem sempre são óbvios.
Hardware mais rápido nem sempre significa respostas mais rápidas. Modelos maiores nem sempre são mais lentos. A arquitetura do modelo, o tamanho da entrada, o batch size e a infraestrutura de serving interagem de formas que valem ser compreendidas antes de otimizar.
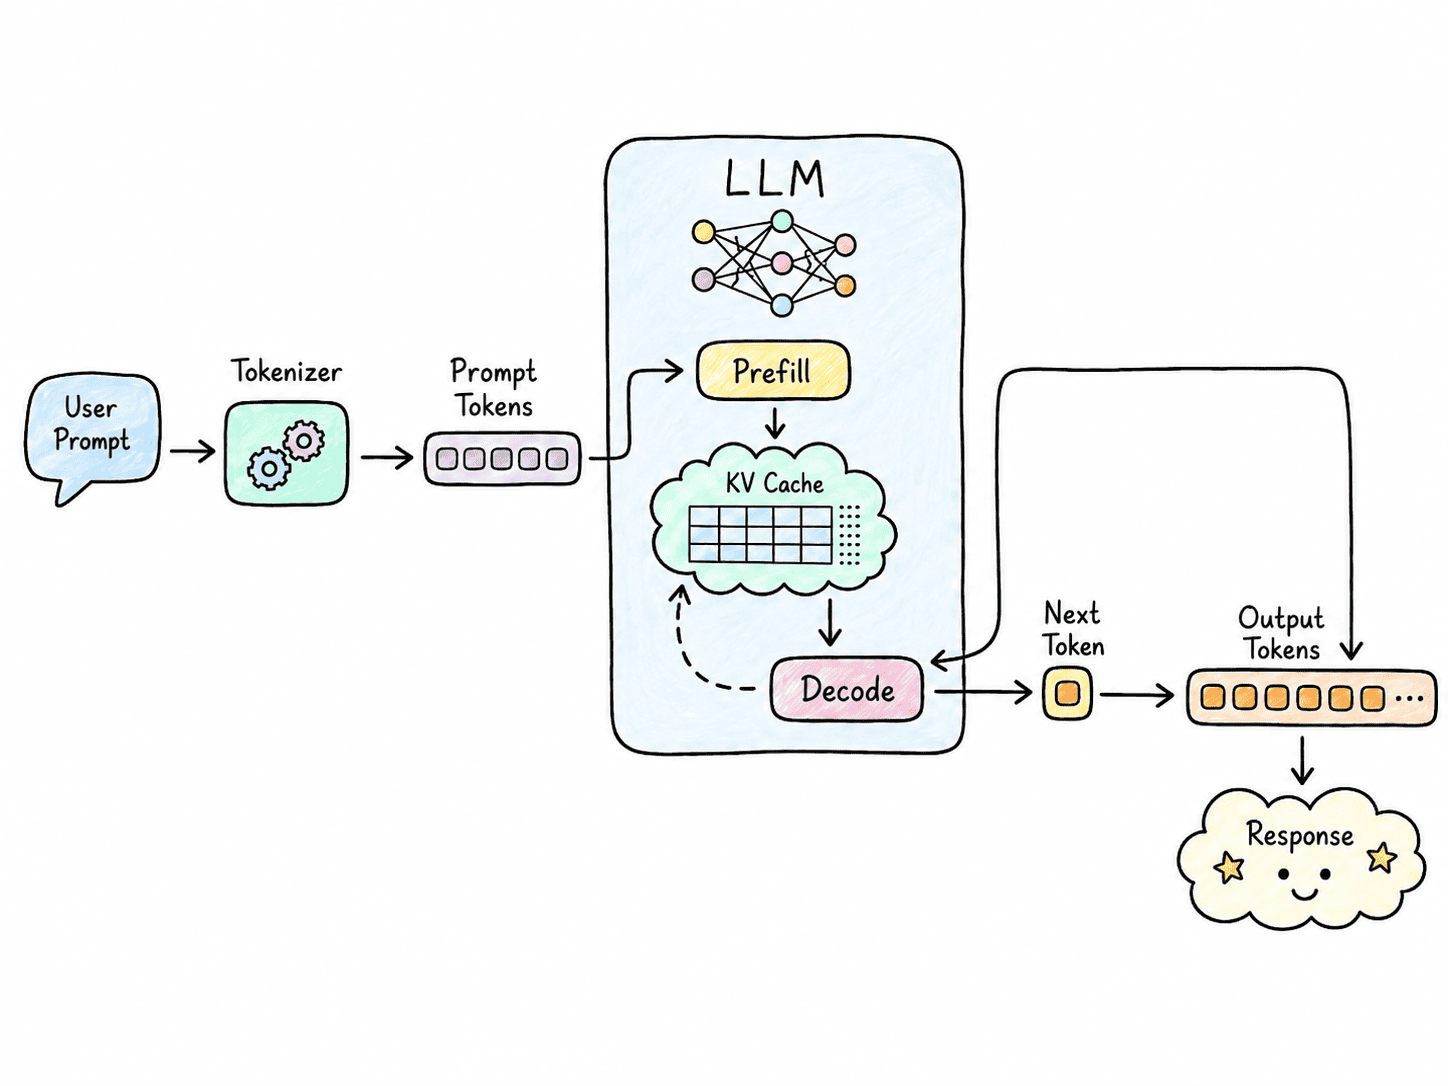
Na maior parte dos LLMs baseados em decoder, a inferência tem duas fases principais: prefill e decode.
Em batches menores, o decode costuma ser mais limitado pela largura de banda de memória do que pelo poder bruto da GPU, pois é preciso ler continuamente os pesos do modelo e os estados de atenção em cache.
Essa distinção importa porque uma otimização que melhora o prefill pode não melhorar o desempenho no decode.
Não existe uma única métrica que diga se um servidor de inferência é rápido, eficiente ou econômico. Essas métricas ajudam a identificar gargalos, comparar setups de serving e avaliar se uma otimização realmente melhora a performance.
Algumas das métricas mais importantes incluem:
A taxa de acerto do cache pode ser especialmente importante em produção. Sistemas de agentes costumam reutilizar prompts de sistema extensos, definições de ferramentas, prefixos de conversas ou documentos.
Se 95% ou mais dessa entrada puder vir do cache, o prefill repetido cai drasticamente, melhorando a latência e reduzindo o custo efetivo de servir essas requisições.
Essas métricas estão interligadas.
Batches maiores e maior concorrência podem melhorar o throughput e a utilização da GPU, mas podem elevar a latência para cada usuário.
Da mesma forma, reduzir a precisão diminui o uso de memória e os requisitos de hardware, mas pode não acelerar a geração se o hardware não tiver kernels otimizados para esse formato.
O objetivo, portanto, não é maximizar uma única métrica, e sim encontrar o equilíbrio certo entre latência, throughput, utilização e custo para sua carga de trabalho.
O desempenho na inferência é fortemente influenciado pela arquitetura do próprio modelo.
Um transformer denso usa essencialmente todos os seus parâmetros para cada token. Já um modelo de Mixture-of-Experts (MoE) contém vários experts, mas ativa apenas um subconjunto para cada token.
Isso pode reduzir a computação por token, mas traz desafios como roteamento de experts, balanceamento de carga, comunicação entre GPUs e alocação de experts.
A arquitetura de atenção também impacta fortemente o uso de memória e a velocidade de inferência.
A Multi-Head Attention (MHA) tradicional armazena representações separadas de chave e valor para cada head de atenção, o que pode tornar o KV-cache grande.
Multi-Query Attention (MQA) reduz essa necessidade de memória ao permitir que vários heads de query compartilhem as mesmas chaves e valores.
Grouped-Query Attention (GQA) fica no meio-termo, com grupos de heads de query compartilhando representações chave-valor. Arquiteturas mais novas podem usar técnicas como Multi-head Latent Attention (MLA), que comprime ainda mais essas representações.
Por isso, dois modelos com contagens de parâmetros semelhantes podem se comportar de forma bem diferente na inferência.
A arquitetura pode afetar significativamente os requisitos de computação, o tamanho do KV-cache, o uso de memória e a velocidade de geração.
Em seguida, vamos ver os frameworks mais usados para rodar LLMs, de setups locais a sistemas de produção em larga escala.
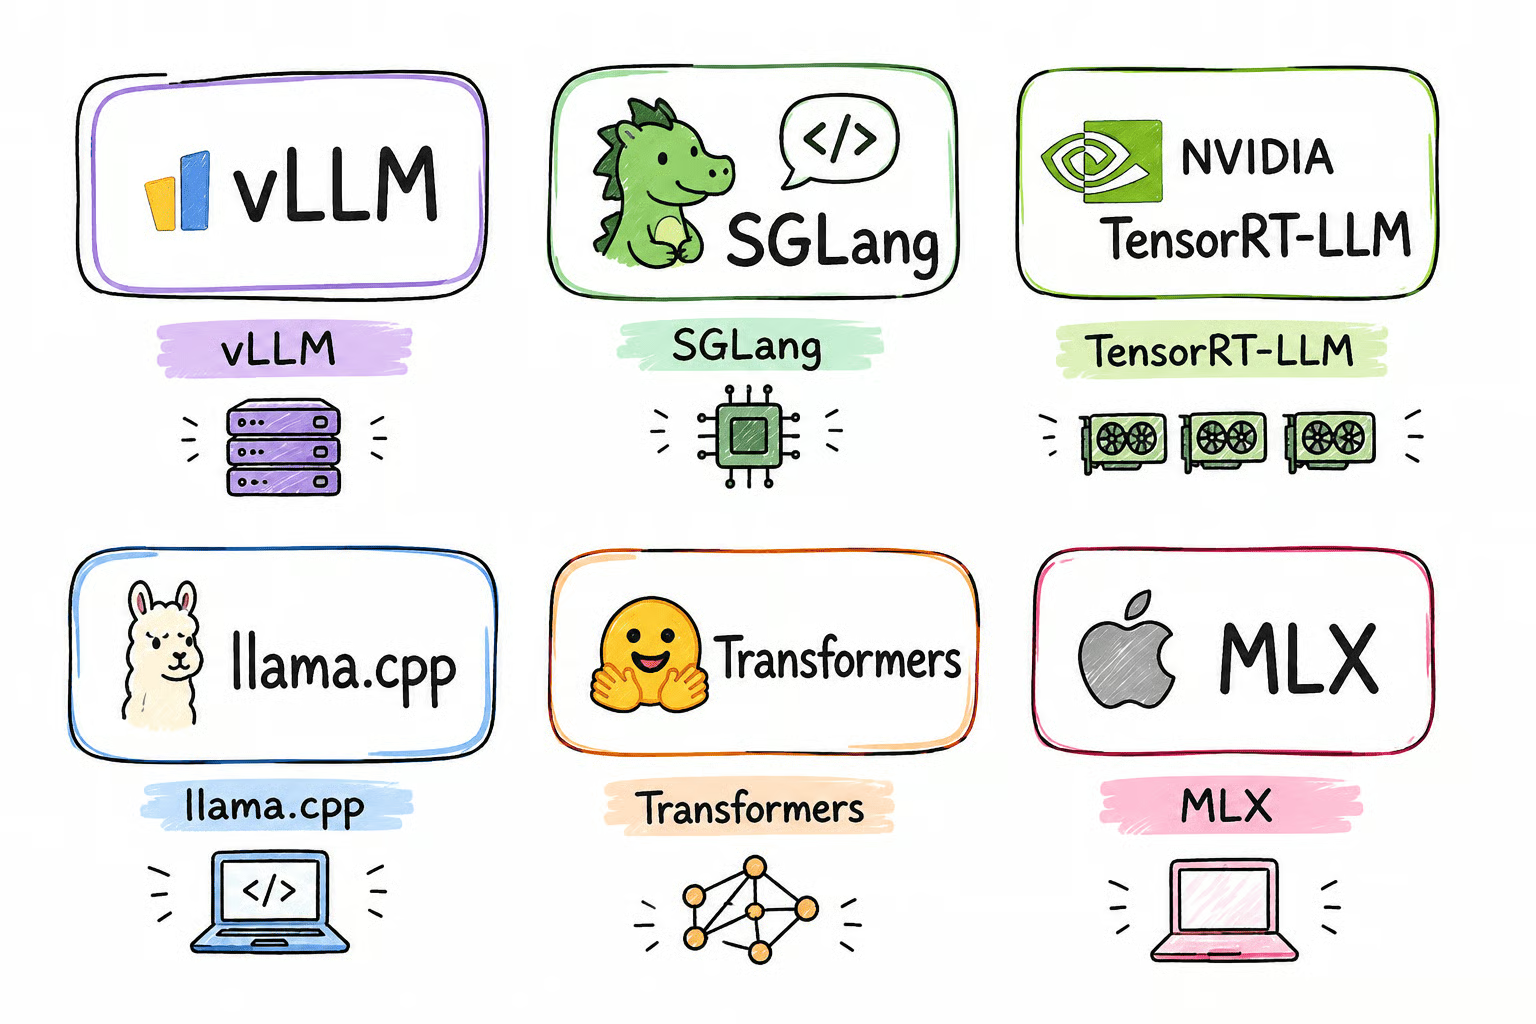
vLLM é um dos mecanismos de inferência de uso geral mais populares. Ele suporta continuous batching, PagedAttention, prefill em chunks, prefix caching, quantização, speculative decoding, kernels de atenção otimizados e inferência distribuída.
SGLang foca em geração de alta performance e no agendamento eficiente de requisições. É particularmente útil para agentes, modelos de raciocínio, contextos repetidos, saídas estruturadas e outras cargas de geração complexas.
TensorRT-LLM é a pilha de inferência otimizada da NVIDIA. Ela aproveita recursos das GPUs NVIDIA, kernels CUDA especializados, formatos de baixa precisão, execução distribuída, KV caching e batching avançado.
llama.cpp é especialmente útil para inferência local e com recursos limitados. Ele suporta quantização GGUF, inferência híbrida CPU-GPU e arquivos de modelo mapeados em memória, permitindo distribuir os pesos entre memória da GPU, RAM do sistema e, quando necessário, memória com paginação em disco.
Isso viabiliza rodar modelos bem maiores do que a VRAM disponível, embora depender muito do disco possa reduzir bastante a performance.
MLX é um framework de inferência e machine learning projetado para Apple Silicon. Ele aproveita a arquitetura de memória unificada dos Macs, sendo uma opção útil para rodar e experimentar LLMs localmente em dispositivos da linha M.
De quantização a speculative decoding, esta parte cobre as técnicas que tornam a inferência mais rápida, barata e eficiente em memória.
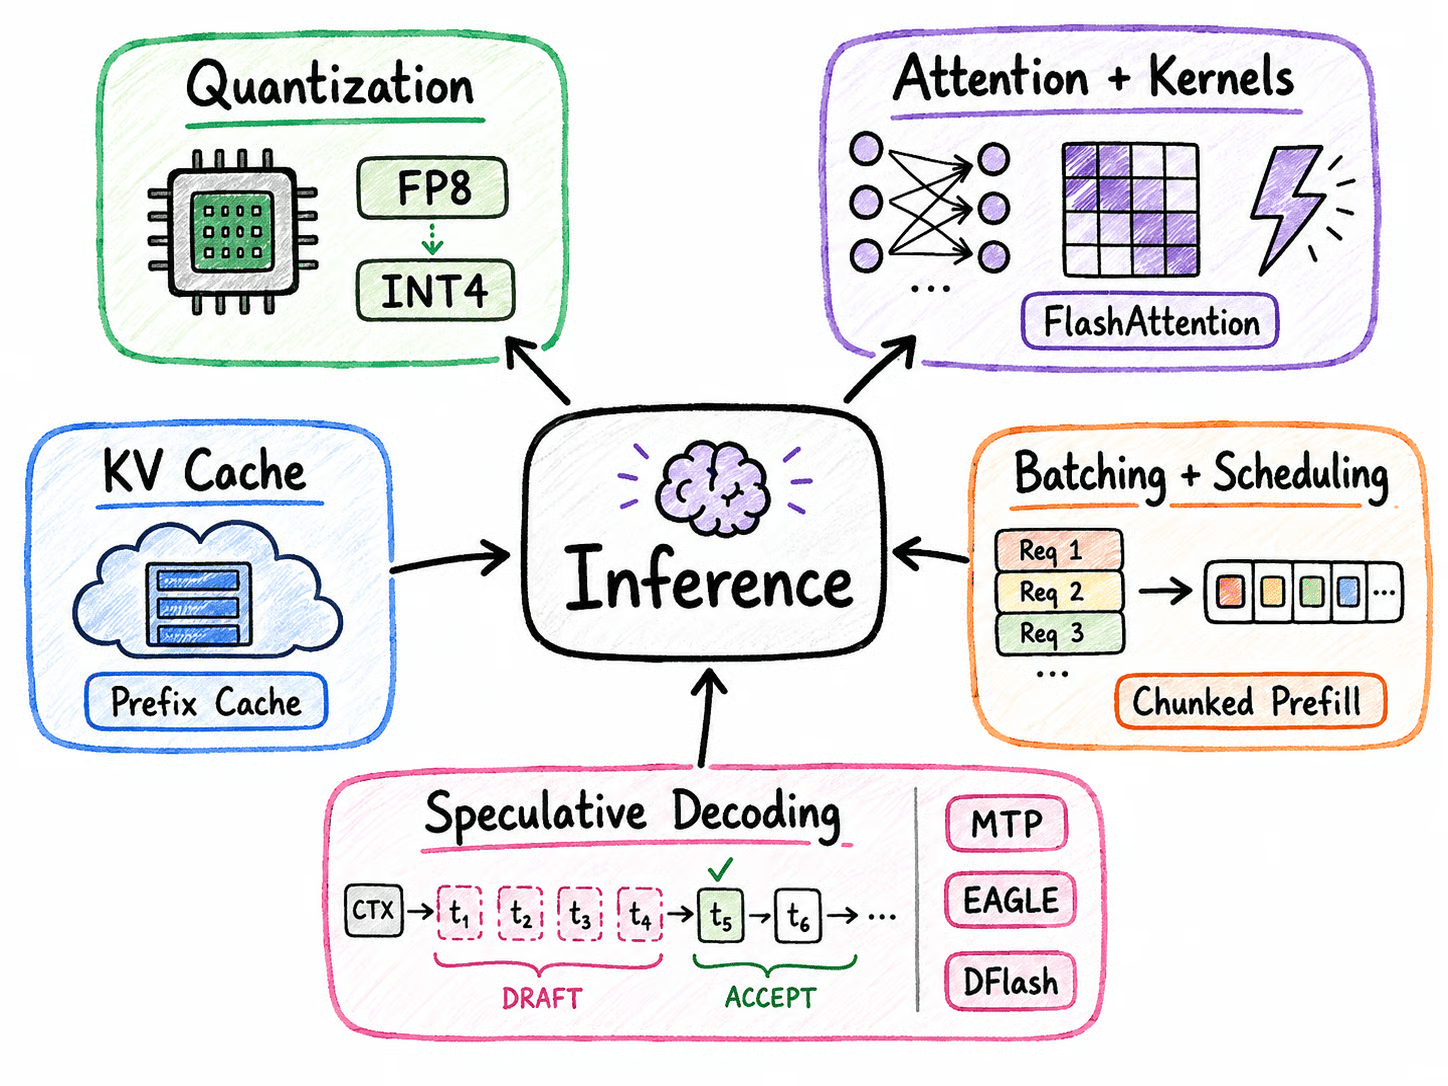
Uma das otimizações de inferência mais comuns é a quantização.
Modelos costumam ser treinados em precisão BF16 ou FP16.
A quantização representa pesos, ativações ou caches usando formatos numéricos menores.
Formatos e abordagens comuns incluem:
Reduzir a precisão diminui o consumo de memória e pode reduzir a demanda por largura de banda de memória.
No entanto, menor não significa automaticamente mais rápido. A performance depende muito de o hardware alvo oferecer kernels eficientes para aquela precisão.
O KV-cache também pode ser quantizado, o que se torna ainda mais valioso em janelas longas de contexto e em serving com alta concorrência.
Atenção é uma das operações mais importantes dentro de um transformer. Ela permite que o modelo determine quais tokens do contexto são mais relevantes ao gerar o próximo token.
Mas a atenção pode ficar cara computacionalmente, especialmente conforme a janela de contexto cresce.
É aí que entram os kernels otimizados. Um kernel é um trecho de código altamente otimizado que realiza uma operação matemática específica em hardware como a GPU. Em vez de mudar como o modelo funciona, kernels otimizados fazem as mesmas contas rodarem mais rápido e usarem memória de forma mais eficiente.
Um bom exemplo é o FlashAttention. A atenção tradicional pode gastar muito tempo movendo grandes resultados intermediários entre a memória da GPU e as unidades de computação.
O FlashAttention reduz esse overhead processando a atenção em blocos menores e mantendo mais computação próxima da GPU.
Mecanismos modernos de inferência usam várias otimizações semelhantes, incluindo:
O ponto-chave é que essas técnicas, em geral, não mudam o modelo nem a qualidade da saída. Elas otimizam como os cálculos são executados, ajudando os engines de inferência a gerar tokens mais rápido e a usar melhor o hardware disponível.
Durante a geração, transformers armazenam chaves e valores de tokens anteriores no KV-cache.
Sem esse cache, o modelo teria que recomputar tokens anteriores a cada novo token gerado.
O lado negativo é o consumo de memória. Contextos longos e muitos usuários simultâneos podem fazer o KV-cache ocupar uma grande parte da memória da GPU.
Diversas técnicas atacam esse problema.
PagedAttention divide a memória do KV-cache em blocos gerenciáveis, em vez de exigir alocações grandes e contíguas.
Prefix caching permite que requisições com prefixos idênticos reutilizem estados de KV previamente computados. Isso é especialmente útil para prompts de sistema compartilhados, agentes e contextos de documentos repetidos.
Outras abordagens incluem:
Para sistemas de inferência em larga escala, a gestão do KV-cache pode ser tão importante quanto otimizar os pesos do modelo.
Quando um servidor de inferência recebe muitas requisições ao mesmo tempo, ele tenta processá-las juntas para manter a GPU ocupada. Isso é o chamado batching.
O problema é que raramente as requisições de LLM terminam ao mesmo tempo.
Um usuário pode gerar 50 tokens enquanto outro gera 2.000.
Com o batching tradicional, requisições curtas podem acabar esperando a mais longa do batch terminar.
Continuous batching resolve isso removendo requisições concluídas e imediatamente substituindo-as por novas. Assim a GPU segue trabalhando, sem deixar capacidade ociosa.
Outra técnica útil é o prefill em chunks. Em vez de processar um prompt enorme de uma vez, o servidor o divide em partes menores, para não bloquear outras requisições que já estão gerando tokens.
Conforme o tráfego cresce, a inferência vira um problema de agendamento. O servidor precisa decidir quais requisições processar, como agrupá-las e como equilibrar memória de GPU, tamanho de sequência, throughput e latência.
A decodificação autorregressiva tradicional gera tokens um por vez, tornando a geração inerentemente sequencial.
Speculative decoding tenta quebrar esse gargalo gerando vários tokens candidatos de forma barata e fazendo o modelo alvo completo verificá-los em paralelo.
Se vários candidatos forem aceitos, a geração pode avançar múltiplos tokens de uma vez sem mudar a distribuição de saída do modelo alvo.
Várias abordagens seguem essa ideia:
A ideia é simples:
Gerar vários tokens futuros prováveis de forma barata e verificá-los de maneira eficiente com o modelo maior.
Speculative decoding funciona melhor quando os próximos tokens são relativamente previsíveis e a taxa de aceitação é alta.
Isso o torna especialmente útil para código e outras tarefas sequenciais, em que mesmo um modelo menor costuma prever o que vem a seguir.
Para raciocínio complexo ou geração altamente imprevisível, menos tokens de rascunho tendem a ser aceitos, reduzindo o ganho de performance.
À medida que modelos e workloads crescem, a memória vira um limitador importante. Aqui, vamos explorar offloading, inferência multi-GPU, serving desagregado e otimização para contextos longos.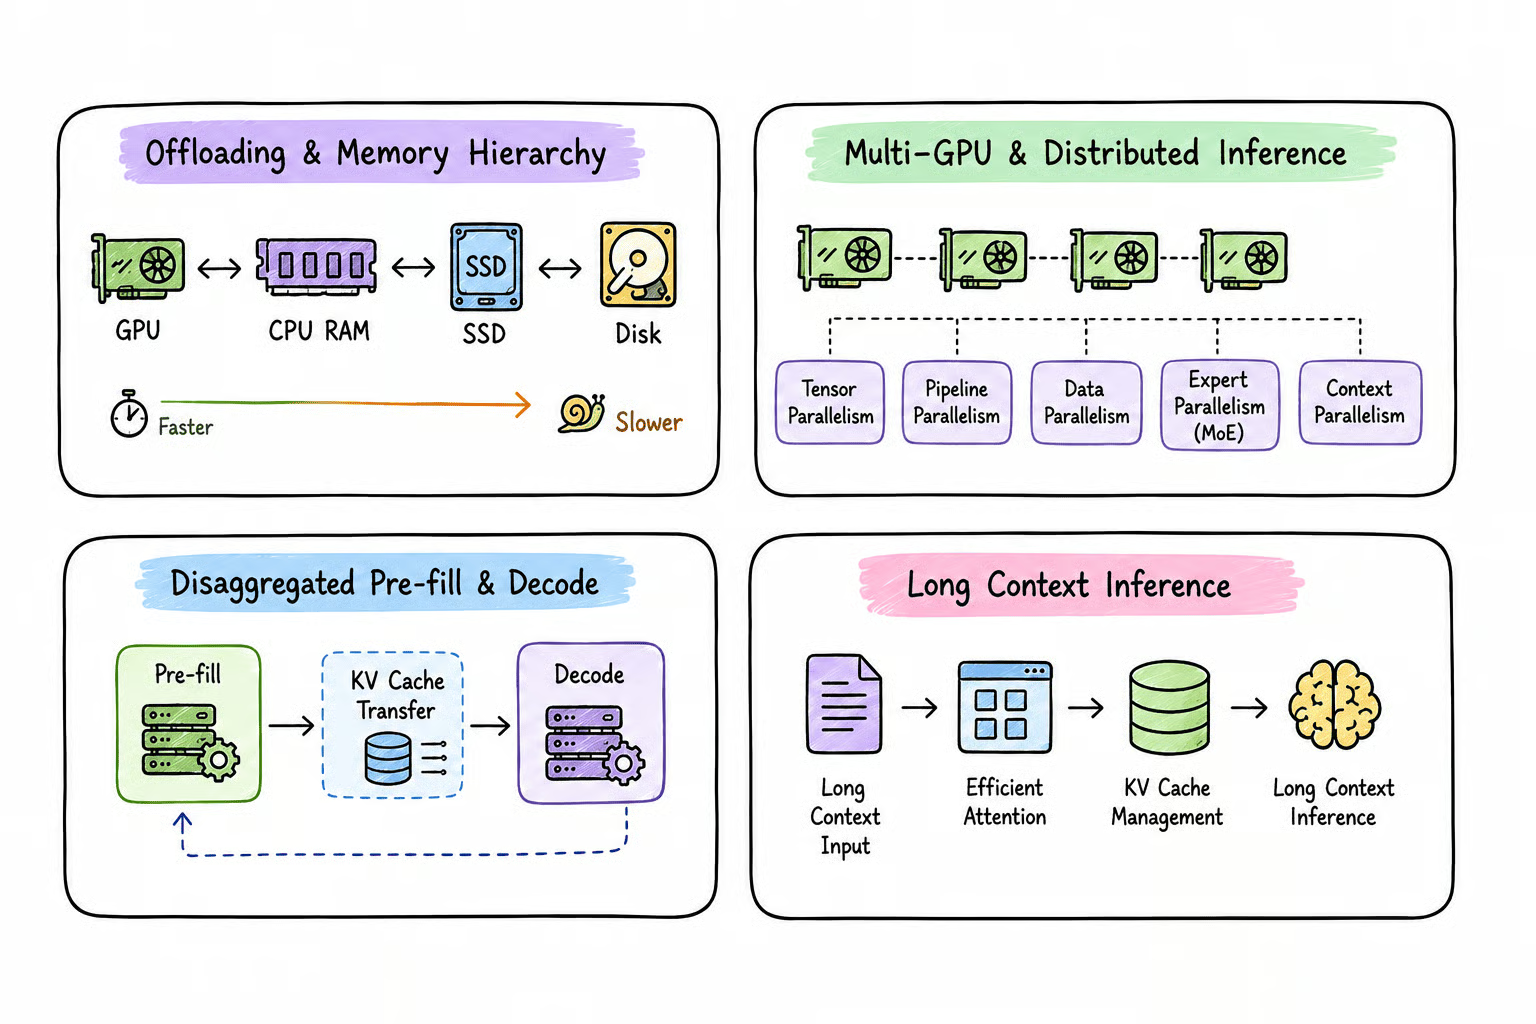
Às vezes o objetivo não é a velocidade máxima, e sim simplesmente fazer o modelo rodar no hardware que você tem.
Sistemas de inferência podem usar diferentes níveis de memória:
HBM da GPU → RAM da CPU → armazenamento NVMe
A memória da GPU é a mais rápida, mas também a mais limitada.
A memória da CPU oferece mais capacidade com menor velocidade, enquanto o armazenamento NVMe fornece ainda mais espaço, porém é muito mais lento.
Se um modelo ou seu KV cache não couber totalmente na VRAM, os mecanismos de inferência podem mover parte da carga para outros lugares usando técnicas como:
Isso aumenta a quantidade de memória disponível, mas geralmente traz um custo de desempenho porque os dados precisam transitar entre camadas de memória mais lentas, muitas vezes via PCIe.
O trade-off básico é simples: quanto mais longe os dados ficam da memória da GPU, mais capacidade você ganha, mas a inferência tende a ficar mais lenta.
Modelos muito grandes frequentemente exigem múltiplos aceleradores.
As estratégias mais comuns incluem:
Quando a inferência abrange várias GPUs, a comunicação vira um gargalo importante.
Tecnologias como NVLink, NVSwitch e redes de alta velocidade podem, portanto, impactar bastante o desempenho.
Prefill e decode se comportam de formas bem diferentes durante a inferência. Prefill costuma ser intensivo em computação, pois processa muitos tokens do prompt em paralelo, enquanto o decode é frequentemente limitado por largura de banda de memória, gerando tokens um a um.
Em vez de fazer as duas etapas competirem pelas mesmas GPUs, sistemas de serving maiores podem separá-las:
Prompt → worker de prefill → transferência do KV cache → worker de decode → resposta
Workers de prefill processam o prompt e constroem o KV cache, que é então transferido para workers dedicados de decode que geram a resposta. Isso permite que cada etapa use hardware, batching e estratégias de paralelismo diferentes.
A grande vantagem é que prefill e decode podem ser otimizados e escalados de forma independente, ajudando a controlar o tempo até o primeiro token (TTFT) e a latência entre tokens (ITL), especialmente para prompts longos e cargas de alto tráfego.
Janelas de contexto longas criam um conjunto diferente de desafios de inferência. À medida que a entrada cresce, o prefill exige mais computação, enquanto o KV cache fica maior, consumindo memória da GPU e tornando o decode mais caro.
Várias técnicas podem ajudar:
O ponto importante é que dar suporte a uma janela de contexto de um milhão de tokens não significa que servir um milhão de tokens seja rápido, barato ou prático.
Contextos mais longos aumentam o uso de memória, o tempo até o primeiro token e o custo total da inferência.
Nem todo modelo se comporta da mesma forma na inferência, então vamos analisar os desafios específicos de modelos MoE, geração estruturada e workloads de raciocínio.
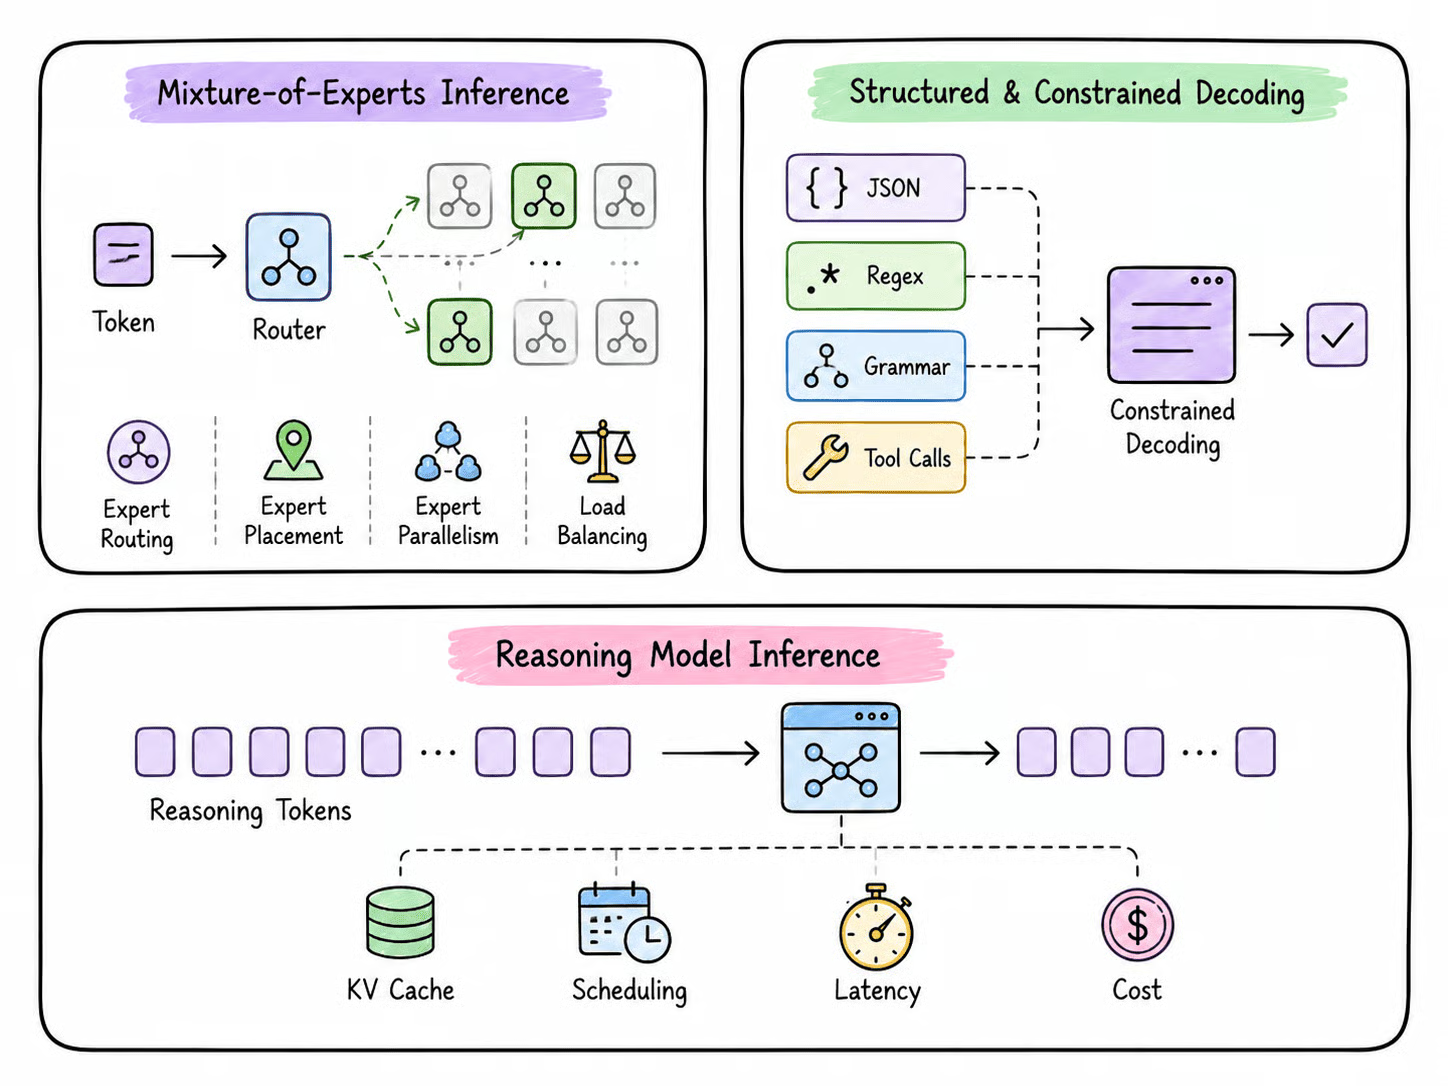
Modelos Mixture-of-Experts (MoE) se comportam de maneira diferente dos modelos densos. Em vez de usar todos os parâmetros para cada token, um roteador seleciona apenas um pequeno conjunto de especialistas para processar cada token.
Isso reduz a computação, mas o conjunto completo de especialistas ainda precisa estar armazenado em algum lugar no hardware de serving.
Portanto, uma inferência MoE eficiente depende de:
Em escala, a comunicação pode virar um grande gargalo, por isso tecnologias como DeepEP fornecem kernels especializados de alta taxa de transferência e baixa latência para mover tokens entre especialistas.
A distinção-chave é que o total de parâmetros determina quanto de capacidade do modelo precisa ser armazenado, enquanto os parâmetros ativos dão uma noção melhor de quanta computação é realizada por token.
Aplicações modernas de LLM muitas vezes exigem algo mais previsível do que texto livre. Agentes, por exemplo, podem precisar gerar JSON, argumentos de ferramentas, SQL ou respostas que sigam um esquema predefinido.
O constrained decoding controla quais tokens o modelo pode gerar em cada etapa, para que o resultado final siga a estrutura exigida. Mecanismos modernos de inferência como o vLLM já suportam restrições, incluindo:
Isso costuma ser mais confiável do que gerar texto irrestrito e tentar consertá-lo depois. No entanto, o constrained decoding garante a estrutura, não necessariamente a correção das informações dentro dela.
Modelos de raciocínio criam um workload de inferência bem diferente, pois podem gerar milhares de tokens intermediários de raciocínio antes de produzir a resposta final.
Diferente de workloads de contexto longo, onde boa parte do custo pode vir do processamento de uma entrada grande, workloads de raciocínio podem permanecer caros durante toda a geração porque a própria fase de decode fica muito longa.
Trajetórias longas de raciocínio afetam:
Outro desafio é que o tamanho do raciocínio é, muitas vezes, difícil de prever.
Uma requisição pode terminar rápido, enquanto outra segue gerando milhares de tokens. Isso dificulta o batching, o agendamento e a alocação do KV cache quando muitos usuários estão sendo atendidos ao mesmo tempo.
Como resultado, servir um chatbot que gera algumas centenas de tokens e um modelo de raciocínio que pode gerar 10.000 tokens pode exigir estratégias de inferência, memória e agendamento muito diferentes.
Otimização de software é só parte da inferência de LLM. O hardware por baixo tem impacto igualmente grande em velocidade, capacidade de memória, escalabilidade e custo.
Características de hardware importantes incluem:
Um conceito útil para entender o desempenho do hardware é a intensidade aritmética, que descreve quanta computação é realizada em relação a quanto dado precisa ser movido. Workloads com alta intensidade aritmética tendem a ser limitados por computação, enquanto workloads com baixa intensidade costumam ser limitados por largura de banda de memória.
Durante o prefill, muitos tokens do prompt podem ser processados em paralelo, permitindo melhor uso dos recursos de computação do hardware. Já durante o decode, os tokens são gerados de forma sequencial, e o sistema acessa repetidamente os pesos do modelo e os dados do KV cache. Isso torna a largura de banda de memória especialmente importante para a velocidade de geração.
É por isso que capacidade de memória e largura de banda de memória são coisas diferentes. Por exemplo, tanto o NVIDIA DGX Spark quanto um sistema Apple M4 Max podem oferecer até 128 GB de memória unificada. Porém, o DGX Spark fornece 273 GB/s de largura de banda de memória, enquanto o M4 Max chega a 546 GB/s. Assim, mesmo que ambos caibam com o mesmo modelo grande na memória, o desempenho de inferência pode ser bem diferente.
O mesmo princípio vale ao comparar GPUs e máquinas de IA locais: fazer o modelo caber resolve o problema de capacidade, não necessariamente o de velocidade.
Para inferência de LLM, desempenho de computação, capacidade de memória, largura de banda de memória e velocidade de interconexão precisam ser considerados em conjunto.
Com tantas técnicas de inferência disponíveis, o essencial é primeiro identificar o que de fato limita seu sistema.
Um modelo que não cabe na VRAM precisa de uma otimização bem diferente de um servidor que sofre com alta latência ou baixo throughput.
|
Problema / cenário |
Técnicas para considerar |
|
O modelo não cabe na VRAM |
Quantização, offloading para CPU, paralelismo de tensor/pipeline |
|
TTFT alto / prefill lento |
Prefix caching, ajuste de prefill em chunks, atenção otimizada |
|
Geração de tokens lenta |
Speculative decoding, kernels otimizados, menor precisão |
|
Baixo throughput / alta concorrência |
Continuous batching, agendamento de requisições, paralelismo de dados |
|
Pressão na memória do KV cache |
Quantização do KV cache, paging, offloading, redução de contexto/concorrência |
|
Workloads de contexto longo |
Prefill em chunks, paralelismo de contexto, otimização do KV cache |
|
Modelos MoE grandes |
Paralelismo de especialistas, alocação de especialistas, balanceamento de carga, kernels MoE otimizados |
|
Prompts repetidos ou compartilhados |
Prefix caching, roteamento ciente de prefixo |
|
Hardware local / limitado |
Quantização, llama.cpp/GGUF, MLX no Apple Silicon |
|
Serving em produção em grande escala |
vLLM, SGLang, TensorRT-LLM, inferência distribuída, desagregação prefill/decode |
O ponto importante é que não existe uma única melhor otimização.
Comece medindo métricas como TTFT, velocidade de geração de tokens, throughput, utilização de GPU e uso de memória. Depois aplique a técnica que ataca o gargalo real e faça novos benchmarks.
Por exemplo, quantização ajuda quando a memória é limitada; continuous batching melhora o throughput; prefix caching reduz trabalho repetido no prefill; e speculative decoding acelera a geração quando os próximos tokens são previsíveis.
O objetivo não é apenas maximizar tokens por segundo, e sim encontrar o melhor equilíbrio entre latência, throughput, uso de memória, qualidade do modelo, hardware e custo.
Rodar um LLM localmente e obter uma resposta com o llama.cpp é um ótimo ponto de partida, mas isso não significa automaticamente que você construiu um sistema de inferência eficiente.
Para projetos pessoais, experimentação e workloads menores, uma configuração local simples pode ser tudo de que você precisa.
Mas, quando você começa a atender muitos usuários, lidar com contextos longos ou construir sistemas complexos de código e agentes, os requisitos mudam rapidamente.
Você precisa de uma stack de inferência que processe muitas requisições ao mesmo tempo, mantenha boa velocidade de geração, gerencie memória de forma eficiente e continue responsiva mesmo com workloads mais exigentes.
É aqui que conceitos como continuous batching, prefix caching, gestão do KV cache, quantização, speculative decoding, kernels otimizados, paralelismo e agendamento de requisições passam a fazer diferença.
Você também precisa entender métricas como TTFT, throughput, latência, concorrência, utilização de GPU e custo por token, em vez de julgar o desempenho apenas por tokens por segundo.
Também não existe configuração universal que funcione para todo modelo ou workload. Uma técnica que funciona bem para code generation pode não trazer o mesmo benefício para raciocínio.
Uma otimização que melhora o throughput pode aumentar a latência. A quantização pode reduzir significativamente os requisitos de memória, mas níveis mais agressivos podem reduzir a qualidade do modelo.
No fim, uma boa engenharia de inferência de LLM é sobre equilíbrio. O objetivo é tirar o máximo do hardware que você já tem, equilibrando velocidade, memória, throughput, latência, qualidade do modelo e custo.
É por isso que aprender sobre inferência importa. Em vez de depender totalmente de padrões ou simplesmente adicionar mais GPUs, você entende onde está o gargalo, escolhe a otimização certa e constrói um sistema de serving realmente desenhado para seu workload.
Para saber mais sobre inferência de LLM, recomendo conferir nosso webinar Understanding LLM Inference.
Principais cursos da DataCamp
Curso
Programa
Curso