Curso
Modelos Transformer con PyTorch
2 h
9.2K
La inferencia de modelos de lenguaje grandes (LLM) se está convirtiendo en todo un arte.
Cada vez más empresas buscan ingenieros de inferencia de LLM y de MLOps que sirvan modelos más rápido, con menos hardware y a menor coste.
Tanto si ejecutas modelos en local, despliegas un servidor de inferencia o experimentas con LLMs de código abierto, entender cómo funciona la inferencia marca una gran diferencia.
Detrás de una inferencia eficiente hay todo un stack de técnicas como cuantización, optimización de la caché KV, batching continuo, kernels de atención optimizados, decodificación especulativa y ajuste consciente del hardware.
Muchos frameworks modernos de inferencia activan parte de esto automáticamente, así que puede que ya te estés beneficiando sin entender del todo qué pasa por debajo.
En esta guía, verás los fundamentos de la inferencia en LLM, las métricas de rendimiento clave, los frameworks de serving más populares y técnicas prácticas para que los modelos sean más rápidos, más eficientes en memoria y más baratos de ejecutar.
Empezaremos por lo básico: qué es la inferencia, cómo funciona, cómo se mide el rendimiento y por qué importa la arquitectura del modelo.
La inferencia de un LLM ocurre cada vez que envías un prompt a un modelo y esperas su respuesta. El modelo procesa la entrada a través de sus capas y genera la salida token a token.
Esto es distinto del entrenamiento. Durante el entrenamiento, el modelo aprende de los datos y actualiza sus pesos. Durante la inferencia, esos pesos están fijos y el modelo entrenado se usa para generar predicciones.
En producción, la mayor parte del coste computacional de los LLM está en la inferencia.
Un modelo puede entrenarse una vez, pero atender millones de solicitudes. Por eso la eficiencia en inferencia es hoy uno de los desafíos de ingeniería más decisivos en la IA aplicada.
Entender técnicamente cómo funciona la inferencia importa porque los cuellos de botella no son obvios.
Un hardware más rápido no siempre implica respuestas más rápidas. Los modelos más grandes no siempre son más lentos. La arquitectura del modelo, la longitud de la entrada, el tamaño del lote y la infraestructura de serving interactúan de formas que conviene entender antes de optimizar.
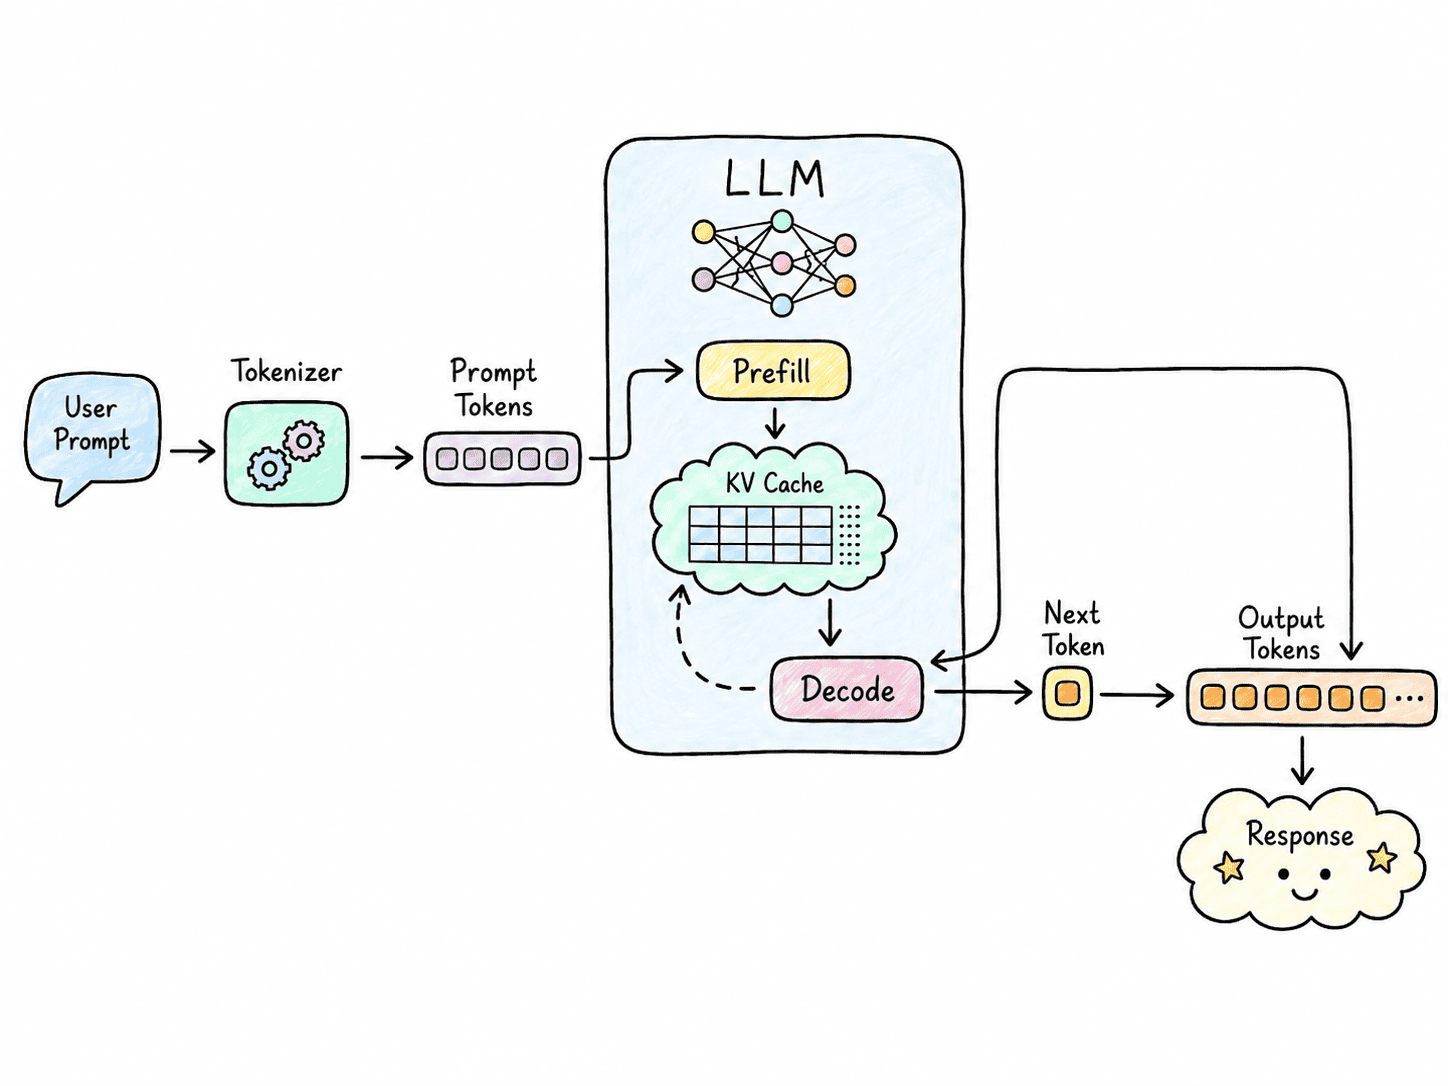
En la mayoría de LLM basados en decodificador, la inferencia tiene dos fases principales: prefill y decode.
Con lotes pequeños, la decodificación suele estar más limitada por el ancho de banda de memoria que por el cómputo bruto de la GPU, porque hay que leer continuamente los pesos del modelo y los estados de atención en caché.
Esta distinción importa porque una optimización que mejora el prefill no tiene por qué mejorar la decodificación.
No existe una única métrica que nos diga si un servidor de inferencia es rápido, eficiente o rentable. Estas métricas ayudan a identificar cuellos de botella, comparar configuraciones de serving y comprobar si una optimización mejora realmente el rendimiento.
Algunas de las más importantes son:
La tasa de aciertos de caché puede ser especialmente importante en producción. Los sistemas agentes suelen reutilizar prompts de sistema extensos, definiciones de herramientas, prefijos de conversación o documentos.
Si el 95% o más de esa entrada se sirve desde caché, el cómputo repetido de prefill se reduce notablemente, mejorando la latencia y bajando el coste efectivo de esas solicitudes.
Estas métricas están muy conectadas.
Lotes más grandes y mayor concurrencia pueden mejorar el throughput y la utilización de GPU, pero pueden aumentar la latencia para cada usuario.
Del mismo modo, bajar la precisión reduce el uso de memoria y los requisitos de hardware, pero puede no acelerar la generación si el hardware no tiene kernels optimizados para ese formato.
El objetivo no es maximizar una sola métrica, sino encontrar el equilibrio adecuado entre latencia, throughput, utilización y coste para tu carga.
El rendimiento de la inferencia está muy condicionado por la propia arquitectura del modelo.
Un transformer denso usa prácticamente todos sus parámetros para cada token. Un modelo Mixture-of-Experts (MoE), en cambio, contiene muchos expertos pero solo activa un subconjunto pequeño por token.
Esto reduce el cómputo por token, pero introduce retos como el enrutado de expertos, el balanceo de carga, la comunicación entre GPUs y la colocación de expertos.
La arquitectura de atención también influye mucho en el uso de memoria y la velocidad de inferencia.
La atención multi-cabeza (MHA) tradicional guarda representaciones de claves y valores separadas para cada cabeza, lo que puede hacer grande la caché KV.
Multi-Query Attention (MQA) reduce este requisito permitiendo que varias cabezas de consulta compartan las mismas claves y valores.
Grouped-Query Attention (GQA) queda a medio camino, con grupos de cabezas que comparten representaciones KV. Arquitecturas más nuevas pueden usar técnicas como Multi-head Latent Attention (MLA), que comprime aún más estas representaciones.
Por eso dos modelos con un número similar de parámetros pueden comportarse de manera muy distinta en inferencia.
Su arquitectura puede afectar de forma notable a los requisitos de cómputo, el tamaño de la caché KV, el uso de memoria y la velocidad de generación.
A continuación, veremos los frameworks más utilizados para ejecutar LLMs, desde entornos locales hasta sistemas de producción a gran escala.
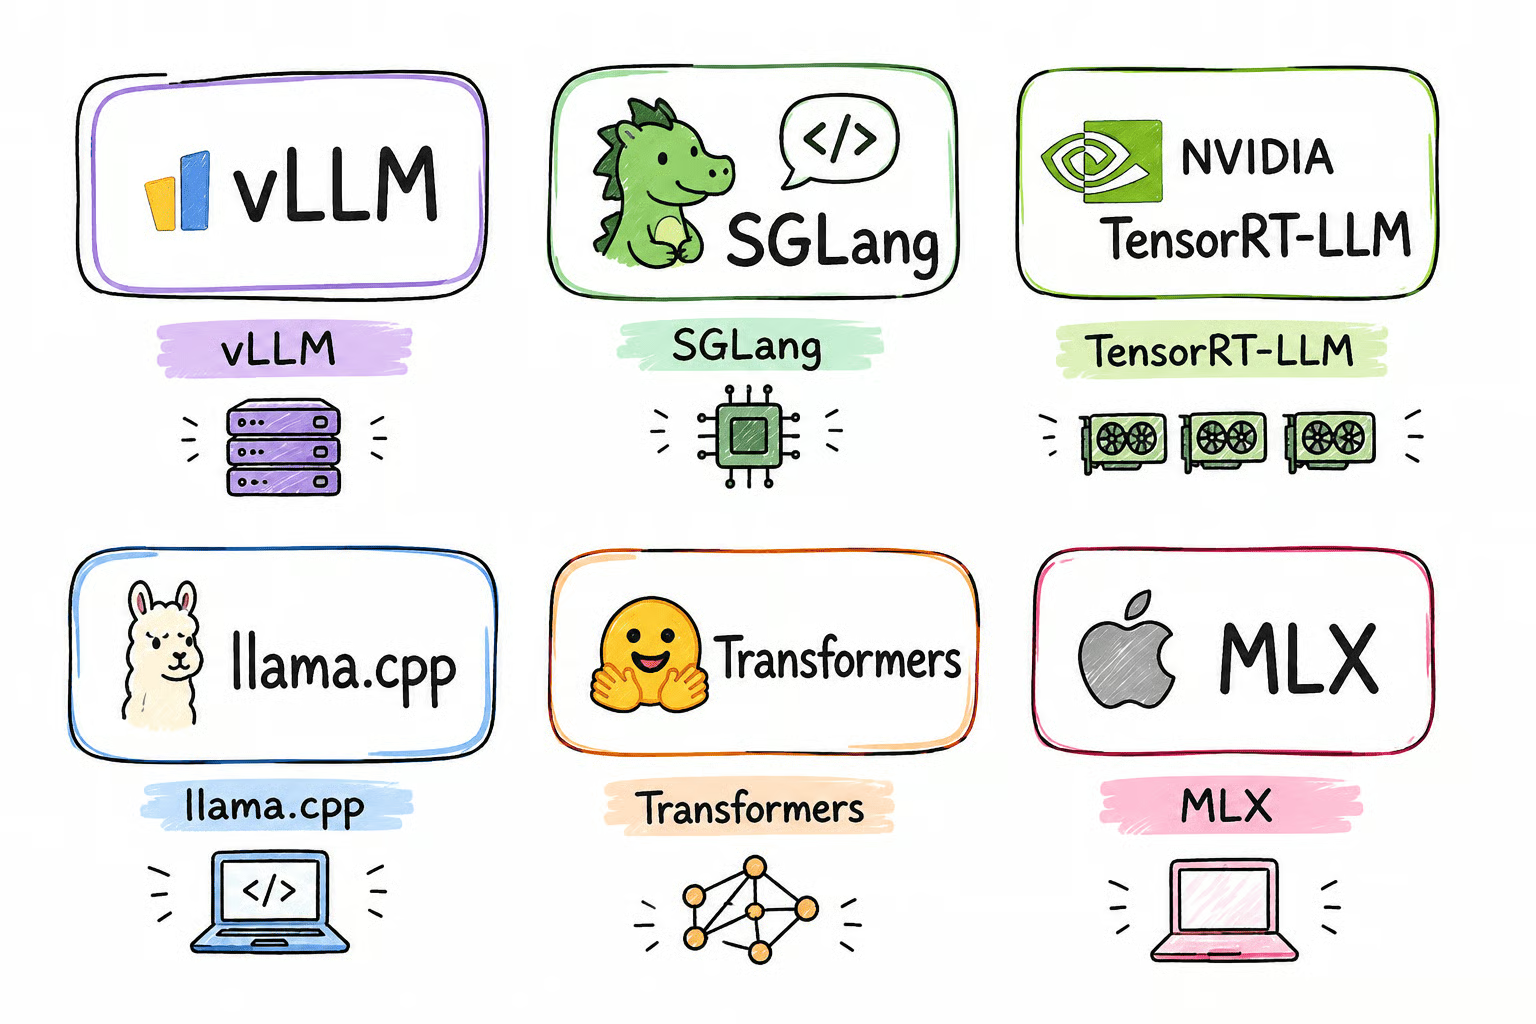
vLLM es uno de los motores de inferencia de uso general más extendidos. Admite batching continuo, PagedAttention, prefill por bloques, caché de prefijos, cuantización, decodificación especulativa, kernels de atención optimizados e inferencia distribuida.
SGLang se centra en la generación de alto rendimiento y en una planificación eficiente de solicitudes. Es especialmente útil para agentes, modelos de razonamiento, contextos repetidos, salidas estructuradas y otras cargas complejas de generación.
TensorRT-LLM es la pila de inferencia optimizada de NVIDIA. Aprovecha características de las GPU NVIDIA, kernels CUDA especializados, formatos de baja precisión, ejecución distribuida, caché KV y batching avanzado.
llama.cpp es especialmente útil para inferencia local y con recursos limitados. Admite cuantización GGUF, inferencia híbrida CPU-GPU y ficheros de modelo mapeados en memoria, lo que permite distribuir los pesos entre la memoria de la GPU, la RAM del sistema y, si es necesario, memoria respaldada en disco.
Esto hace posible ejecutar modelos mucho mayores que la VRAM disponible, aunque depender mucho del disco puede reducir significativamente el rendimiento.
MLX es un framework de inferencia y machine learning diseñado para Apple Silicon. Aprovecha la arquitectura de memoria unificada de los Mac, lo que lo convierte en una opción útil para ejecutar y experimentar con LLMs en local en dispositivos con series M.
Desde la cuantización hasta la decodificación especulativa, aquí verás las técnicas que hacen la inferencia más rápida, barata y eficiente en memoria.
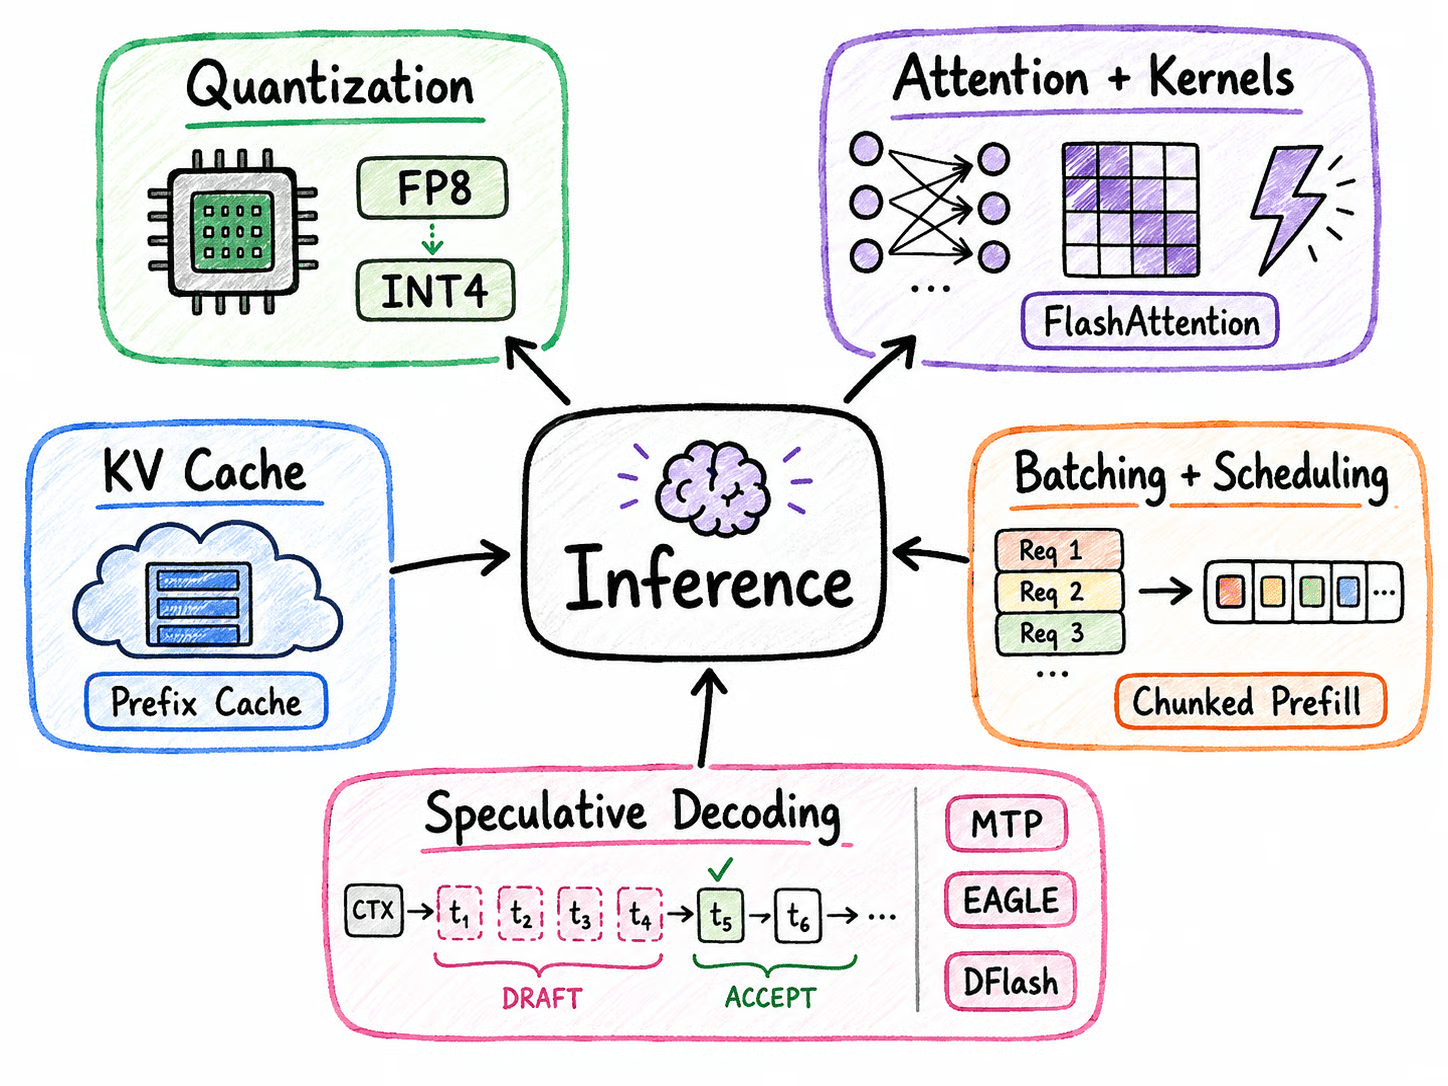
Una de las optimizaciones más comunes en inferencia es la cuantización.
Los modelos suelen entrenarse con precisión BF16 o FP16.
La cuantización representa pesos, activaciones o cachés usando formatos numéricos más pequeños.
Formatos y enfoques comunes incluyen:
Reducir la precisión baja el consumo de memoria y puede reducir las necesidades de ancho de banda de memoria.
Sin embargo, más pequeño no significa automáticamente más rápido. El rendimiento depende mucho de si el hardware destino ofrece kernels eficientes para esa precisión.
La caché KV también puede cuantizarse, lo que es cada vez más valioso para contextos largos y alta concurrencia.
La atención es una de las operaciones más importantes dentro de un transformer. Permite al modelo determinar qué tokens del contexto son más relevantes al generar el siguiente token.
Pero puede volverse costosa computacionalmente, sobre todo cuando crece la ventana de contexto.
Ahí entran los kernels optimizados. Un kernel es una pieza de código muy optimizada que realiza una operación matemática específica en hardware como una GPU. En lugar de cambiar cómo funciona el modelo, los kernels optimizados hacen que esos mismos cálculos se ejecuten más rápido y usen la memoria con más eficiencia.
Un buen ejemplo es FlashAttention. La atención tradicional puede dedicar mucho tiempo a mover grandes resultados intermedios entre la memoria de la GPU y las unidades de cómputo.
FlashAttention reduce esta sobrecarga procesando la atención en bloques más pequeños y manteniendo más cómputo cerca de la GPU.
Los motores de inferencia modernos usan varias optimizaciones similares, entre ellas:
La idea clave es que, por lo general, estas técnicas no cambian el modelo ni su calidad de salida. Optimizan cómo se ejecutan los cálculos, ayudando a que los motores de inferencia generen tokens más rápido y aprovechen mejor el hardware disponible.
Durante la generación, los transformers almacenan las claves y valores de tokens previos en la caché KV.
Sin esta caché, el modelo tendría que recalcular los tokens previos cada vez que genera uno nuevo.
La contrapartida es el consumo de memoria. Contextos largos y muchos usuarios simultáneos pueden hacer que la caché KV ocupe gran parte de la memoria de la GPU.
Varias técnicas abordan este problema.
PagedAttention divide la memoria de la caché KV en bloques manejables en lugar de requerir grandes asignaciones contiguas.
La caché de prefijos permite que solicitudes con prefijos idénticos reutilicen estados KV ya computados. Es especialmente útil para prompts de sistema compartidos, agentes y contextos de documentos repetidos.
Otros enfoques incluyen:
Para sistemas de inferencia a gran escala, gestionar la caché KV puede ser tan importante como optimizar los pesos del modelo.
Cuando un servidor de inferencia recibe muchas solicitudes a la vez, intenta procesarlas juntas para mantener la GPU ocupada. A esto se le llama batching.
El problema es que las solicitudes de LLM rara vez terminan a la vez.
Una puede generar 50 tokens y otra 2.000.
Con batching tradicional, las solicitudes cortas pueden acabar esperando a que termine la más larga del lote.
El batching continuo soluciona esto retirando solicitudes completadas y sustituyéndolas de inmediato por nuevas. Así la GPU sigue trabajando sin dejar capacidad ociosa.
Otra técnica útil es el prefill por bloques. En lugar de procesar un prompt muy grande de una sola vez, el servidor lo divide en partes más pequeñas para no bloquear otras solicitudes que ya están generando tokens.
A medida que crece el tráfico, la inferencia se convierte en un problema de planificación. El servidor debe decidir qué solicitudes procesar, cómo agruparlas y cómo equilibrar memoria de GPU, longitud de secuencia, throughput y latencia.
La decodificación autorregresiva tradicional genera los tokens uno a uno, lo que vuelve la generación inherentemente secuencial.
La decodificación especulativa intenta romper este cuello de botella generando varios tokens candidatos de forma barata y dejando que el modelo objetivo completo los verifique en paralelo.
Si se aceptan varios candidatos, la generación puede avanzar varios tokens de una vez sin cambiar la distribución de salida del modelo objetivo.
Hay distintos enfoques con esta idea:
La idea básica es simple:
Generar varios tokens futuros probables de forma barata y luego verificarlos de forma eficiente con el modelo mayor.
La decodificación especulativa funciona mejor cuando los siguientes tokens son relativamente previsibles y la tasa de aceptación es alta.
Por eso es especialmente útil en programación y otras tareas secuenciales, donde incluso un modelo pequeño suele anticipar qué viene después.
Para razonamiento complejo o generación muy impredecible, se aceptan menos tokens borrador y el beneficio disminuye.
A medida que crecen los modelos y las cargas, la memoria se vuelve una gran limitación. Aquí veremos offloading, inferencia multi-GPU, serving desagregado y optimización para contextos largos.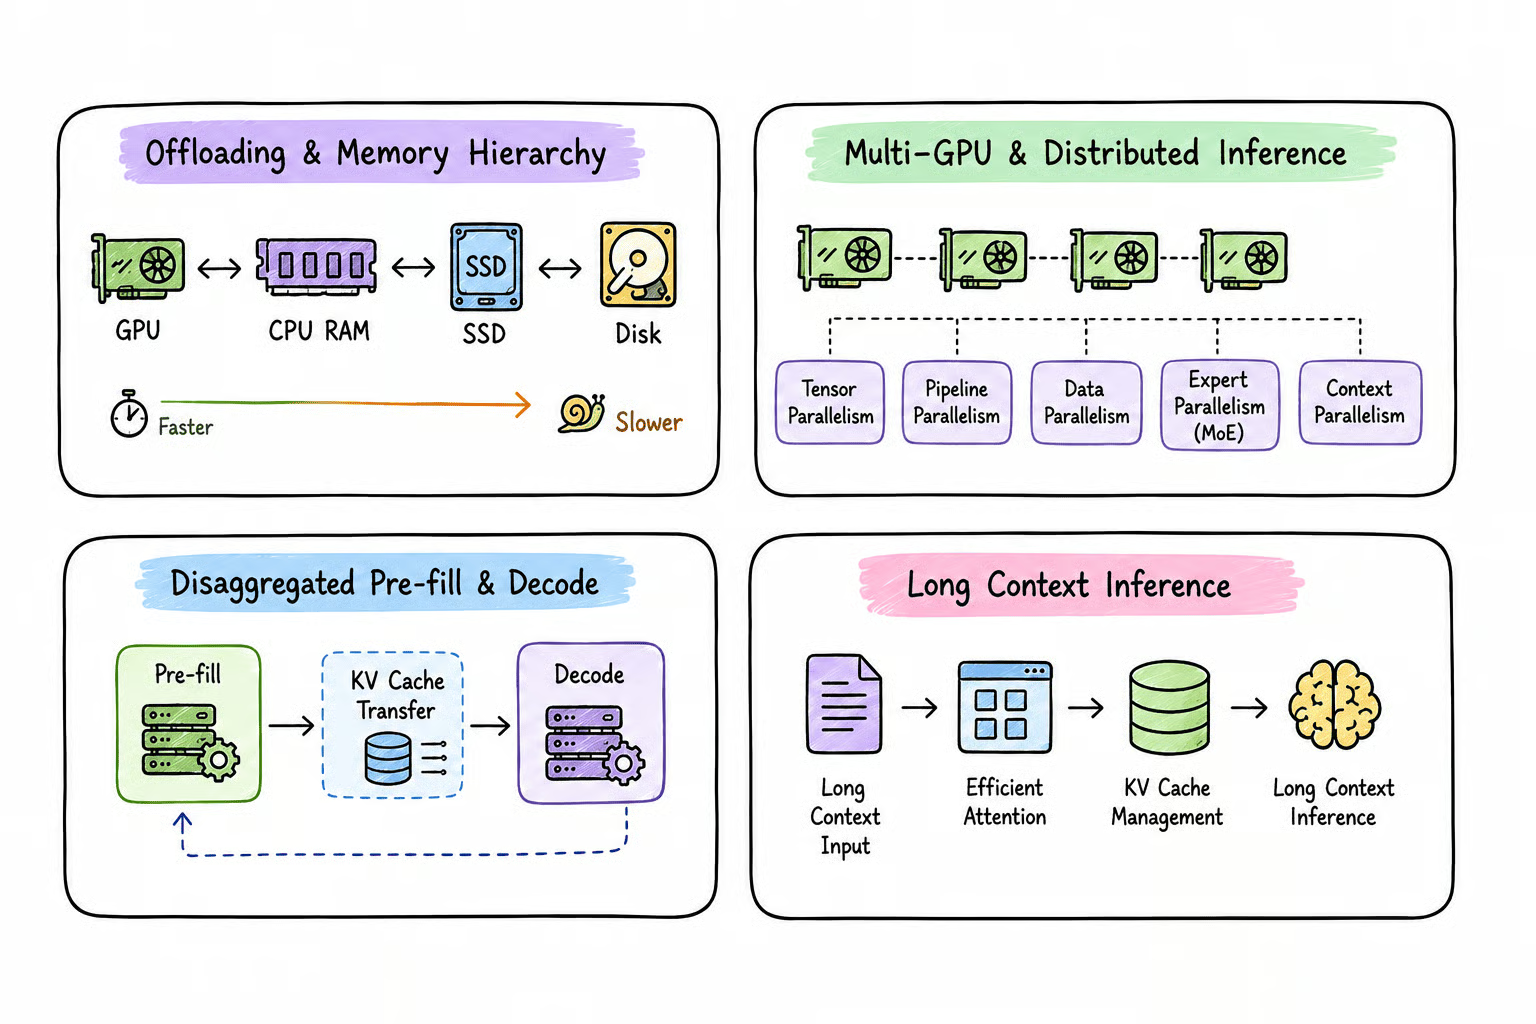
A veces el objetivo no es la máxima velocidad, sino simplemente hacer que un modelo funcione con el hardware que tienes.
Los sistemas de inferencia pueden usar distintos niveles de memoria:
GPU HBM → RAM de CPU → Almacenamiento NVMe
La memoria de GPU es la más rápida, pero también la más limitada.
La memoria de CPU ofrece más capacidad a menor velocidad, y el almacenamiento NVMe aporta aún más espacio, pero es mucho más lento.
Si un modelo o su caché KV no caben íntegramente en la VRAM, los motores de inferencia pueden mover parte de la carga a otros lugares mediante técnicas como:
Esto aumenta la memoria disponible, pero normalmente con coste de rendimiento, porque los datos deben moverse entre capas más lentas, a menudo a través de PCIe.
La contrapartida es clara: cuanto más lejos de la memoria de la GPU se mueven los datos, más capacidad ganas, pero más lenta suele volverse la inferencia.
Los modelos muy grandes suelen requerir múltiples aceleradores.
Estrategias comunes incluyen:
Cuando la inferencia abarca varias GPU, la comunicación se vuelve un cuello de botella importante.
Tecnologías como NVLink, NVSwitch y redes de alta velocidad pueden tener un impacto sustancial en el rendimiento.
Prefill y decode se comportan de forma muy distinta en inferencia. El prefill suele ser intensivo en cómputo, ya que procesa muchos tokens del prompt en paralelo, mientras que el decode suele estar limitado por el ancho de banda de memoria, al generar tokens uno a uno.
En lugar de hacer que ambas fases compitan por las mismas GPU, los sistemas de serving más grandes pueden separarlas:
Prompt → Worker de prefill → Transferencia de caché KV → Worker de decode → Respuesta
Los workers de prefill procesan el prompt y construyen la caché KV, que después se transfiere a workers dedicados de decode que generan la respuesta. Esto permite que cada fase use hardware, batching y estrategias de paralelismo diferentes.
La gran ventaja es que el prefill y el decode pueden optimizarse y escalarse de forma independiente, ayudando a controlar el tiempo hasta el primer token (TTFT) y la latencia entre tokens (ITL), especialmente con prompts largos y cargas de alto tráfico.
Las ventanas de contexto largas plantean retos distintos en inferencia. A medida que crece la entrada, el prefill requiere más cómputo, mientras que la caché KV crece, consumiendo memoria de GPU y encareciendo la decodificación.
Varias técnicas ayudan:
Lo importante es que admitir una ventana de contexto de un millón de tokens no implica que servir un millón de tokens sea rápido, barato o práctico.
Cuanto más largo el contexto, mayor el uso de memoria, el tiempo hasta el primer token y el coste total de la inferencia.
No todos los modelos se comportan igual en inferencia, así que veremos los retos específicos de modelos MoE, generación estructurada y cargas de razonamiento.
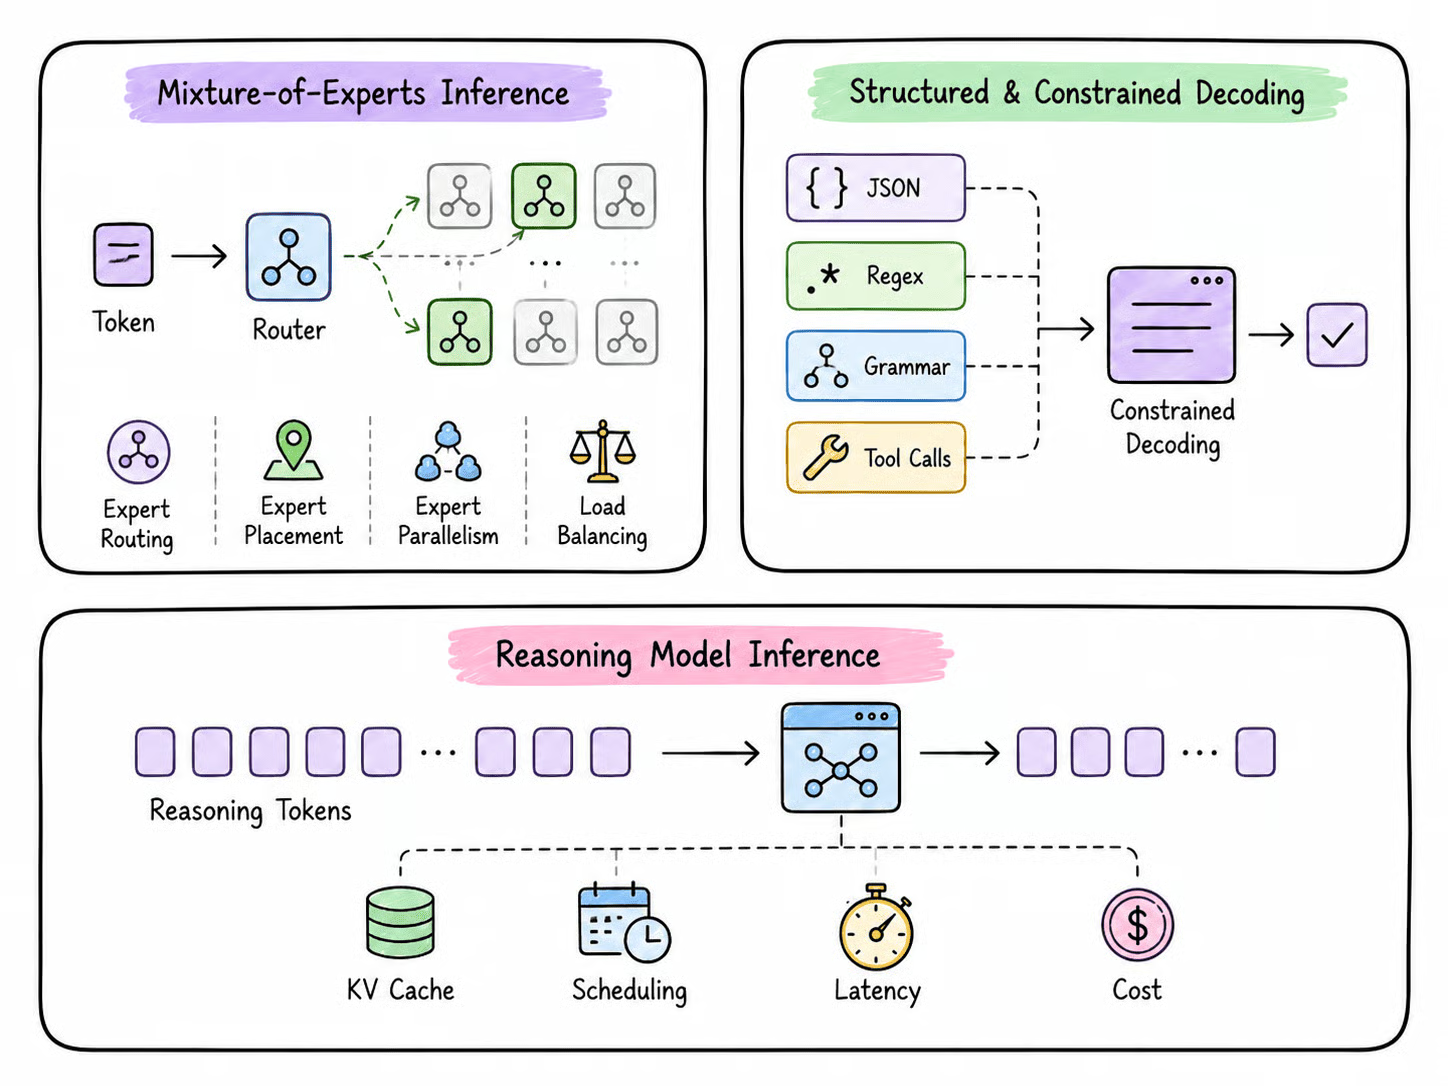
Los modelos Mixture-of-Experts (MoE) se comportan distinto a los densos. En lugar de usar todos los parámetros para cada token, un router selecciona solo unos pocos expertos para procesar cada token.
Esto reduce el cómputo, pero el conjunto completo de expertos igualmente debe almacenarse en algún lugar del hardware de serving.
Por tanto, la inferencia eficiente con MoE depende de:
A gran escala, la comunicación puede convertirse en un gran cuello de botella; por eso tecnologías como DeepEP ofrecen kernels especializados de alto throughput y baja latencia para mover tokens entre expertos.
La diferencia clave es que los parámetros totales determinan cuánta capacidad de modelo hay que almacenar, mientras que los parámetros activos indican mejor cuánto cómputo se realiza por token.
Las aplicaciones modernas con LLM a menudo necesitan algo más predecible que texto libre. Por ejemplo, los agentes pueden necesitar generar JSON válido, argumentos de herramientas, SQL o respuestas que sigan un esquema.
La decodificación con restricciones controla qué tokens puede generar el modelo en cada paso, para que la salida final siga la estructura requerida. Los motores modernos como vLLM admiten restricciones como:
Esto suele ser más fiable que generar texto libre y tratar de repararlo después. Sin embargo, la decodificación con restricciones garantiza la estructura, no necesariamente la corrección del contenido.
Los modelos de razonamiento generan una carga de inferencia muy distinta porque pueden producir miles de tokens intermedios de razonamiento antes de dar la respuesta final.
A diferencia de los contextos largos, donde gran parte del coste proviene de procesar una entrada grande, en razonamiento el coste puede mantenerse alto durante toda la generación porque la fase de decodificación se alarga mucho.
Trazas largas de razonamiento afectan a:
Otro reto es que la longitud del razonamiento suele ser difícil de predecir.
Una solicitud puede terminar rápido, mientras que otra sigue generando miles de tokens. Esto complica el batching, la planificación y la asignación de la caché KV cuando se atienden muchos usuarios a la vez.
En consecuencia, servir un chatbot que genera unos cientos de tokens y un modelo de razonamiento que puede generar 10.000 tokens puede requerir estrategias de inferencia, memoria y planificación muy diferentes.
La optimización software es solo una parte de la inferencia con LLM. El hardware subyacente puede impactar igual o más en velocidad, capacidad de memoria, escalabilidad y coste.
Características de hardware importantes incluyen:
Un concepto útil para entender el rendimiento del hardware es la intensidad aritmética, que describe cuánto cómputo se realiza en relación con cuánto dato hay que mover. Las cargas con alta intensidad aritmética tienden a estar limitadas por cómputo, mientras que las de baja intensidad suelen estar limitadas por ancho de banda de memoria.
Durante el prefill, muchos tokens del prompt se procesan en paralelo, lo que permite aprovechar mejor los recursos de cómputo del hardware. Durante el decode, en cambio, los tokens se generan de forma secuencial y el sistema accede repetidamente a los pesos y a la caché KV. Por eso el ancho de banda de memoria es especialmente importante para la velocidad de generación.
De ahí que capacidad de memoria y ancho de banda de memoria sean cosas distintas. Por ejemplo, tanto el NVIDIA DGX Spark como un sistema Apple M4 Max pueden ofrecer hasta 128 GB de memoria unificada. Sin embargo, DGX Spark aporta 273 GB/s de ancho de banda de memoria, mientras que M4 Max alcanza hasta 546 GB/s. Así, aunque ambos puedan alojar el mismo modelo grande en memoria, su rendimiento en inferencia puede ser muy diferente.
El mismo principio aplica al comparar GPUs y máquinas locales de IA: hacer que el modelo quepa resuelve el problema de capacidad, no necesariamente el de velocidad.
Para inferencia con LLM, rendimiento de cómputo, capacidad de memoria, ancho de banda de memoria y velocidad de interconexión deben considerarse en conjunto.
Con tantas técnicas disponibles, lo clave es identificar primero qué está limitando realmente tu sistema.
Un modelo que no cabe en VRAM requiere una optimización muy distinta a un servidor con alta latencia o poco throughput.
|
Problema / Escenario |
Técnicas a considerar |
|
El modelo no cabe en VRAM |
Cuantización, offloading a CPU, paralelismo de tensores/pipeline |
|
TTFT alto / prefill lento |
Caché de prefijos, afinado de prefill por bloques, atención optimizada |
|
Generación de tokens lenta |
Decodificación especulativa, kernels optimizados, menor precisión |
|
Poco throughput / alta concurrencia |
Batching continuo, planificación de solicitudes, paralelismo de datos |
|
Presión de memoria por caché KV |
Cuantización de caché KV, paginación, offloading, reducir contexto/concurrencia |
|
Cargas con contextos largos |
Prefill por bloques, paralelismo de contexto, optimización de caché KV |
|
Modelos MoE grandes |
Paralelismo de expertos, colocación de expertos, balanceo de carga, kernels MoE optimizados |
|
Prompts repetidos o compartidos |
Caché de prefijos, enrutado con conocimiento de prefijos |
|
Hardware local / limitado |
Cuantización, llama.cpp/GGUF, MLX en Apple Silicon |
|
Serving de producción a gran escala |
vLLM, SGLang, TensorRT-LLM, inferencia distribuida, desagregación prefill/decode |
Lo importante es que no hay una única optimización mejor.
Empieza midiendo métricas como TTFT, velocidad de generación de tokens, throughput, utilización de GPU y uso de memoria. Luego aplica la técnica que ataque el cuello de botella real y vuelve a evaluar.
Por ejemplo, la cuantización ayuda cuando la memoria es limitada; el batching continuo mejora el throughput; la caché de prefijos reduce trabajo repetido de prefill; y la decodificación especulativa acelera la generación cuando los tokens futuros son previsibles.
El objetivo no es simplemente maximizar los tokens por segundo, sino encontrar el mejor equilibrio entre latencia, throughput, uso de memoria, calidad del modelo, hardware y coste.
Ejecutar un LLM en local y obtener una respuesta con llama.cpp es un gran primer paso, pero no significa automáticamente que hayas construido un sistema de inferencia eficiente.
Para proyectos personales, experimentación y cargas pequeñas, una configuración local sencilla puede ser suficiente.
Pero en cuanto empiezas a servir a muchos usuarios, manejar contextos largos o construir sistemas de programación y agentes complejos, los requisitos cambian rápido.
Necesitas una pila de inferencia capaz de procesar muchas solicitudes a la vez, mantener buena velocidad de generación, gestionar la memoria con eficiencia y seguir siendo ágil incluso cuando la carga se vuelve más exigente.
Aquí es donde conceptos como batching continuo, caché de prefijos, gestión de caché KV, cuantización, decodificación especulativa, kernels optimizados, paralelismo y planificación de solicitudes marcan la diferencia.
También necesitas entender métricas como TTFT, throughput, latencia, concurrencia, utilización de GPU y coste por token en lugar de juzgar el rendimiento solo por tokens por segundo.
Tampoco existe una configuración universal que funcione para todo modelo o carga. Una técnica que va bien para programación puede no aportar lo mismo en razonamiento.
Una optimización que mejora el throughput puede aumentar la latencia. La cuantización puede reducir mucho los requisitos de memoria, pero una cuantización más agresiva puede afectar a la calidad del modelo.
En definitiva, la buena ingeniería de inferencia con LLM va de equilibrio. Se trata de sacar el máximo partido al hardware que ya tienes, equilibrando velocidad, memoria, throughput, latencia, calidad del modelo y coste.
Por eso merece la pena aprender sobre inferencia. En lugar de depender solo de ajustes por defecto o de añadir más GPUs, podrás entender dónde está el cuello de botella, elegir la optimización adecuada y construir un sistema de serving realmente diseñado para tu carga.
Si quieres aprender más sobre inferencia de LLM, te recomendamos nuestro webinar sobre Understanding LLM Inference.
Cursos destacados de DataCamp
Curso
Programa
Curso
blog
Stanislav Karzhev
9 min
blog
Stanislav Karzhev
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min