
Khóa học
Các mô hình Transformer với PyTorch
2 giờ
9.2K
Suy luận Mô hình Ngôn ngữ Lớn (LLM) đang dần trở thành một nghệ thuật riêng.
Ngày càng nhiều công ty tìm kiếm kỹ sư suy luận LLM và MLOps có thể phục vụ mô hình nhanh hơn, dùng ít phần cứng hơn và giảm chi phí suy luận.
Dù bạn chạy mô hình cục bộ, triển khai máy chủ suy luận hay thử nghiệm với LLM mã nguồn mở, hiểu cách suy luận vận hành có thể tạo khác biệt lớn.
Đằng sau suy luận LLM hiệu quả là cả một ngăn xếp kỹ thuật, gồm lượng tử hóa, tối ưu KV-cache, batching liên tục, kernel attention tối ưu, giải mã suy đoán và tinh chỉnh theo phần cứng.
Nhiều framework suy luận hiện đại tự động kích hoạt một số kỹ thuật này, nghĩa là bạn có thể đã được hưởng lợi mà chưa thật sự hiểu chuyện gì diễn ra bên dưới.
Trong hướng dẫn này, tôi sẽ đi qua các nền tảng của suy luận LLM, những chỉ số hiệu năng quan trọng nhất, các framework phục vụ phổ biến, và kỹ thuật thực tiễn để khiến mô hình nhanh hơn, tiết kiệm bộ nhớ hơn và rẻ hơn để vận hành.
Bắt đầu từ căn bản: suy luận là gì, hoạt động ra sao, đo hiệu năng thế nào và vì sao kiến trúc mô hình quan trọng.
Suy luận LLM diễn ra mỗi khi bạn gửi một prompt tới mô hình ngôn ngữ và đợi phản hồi. Mô hình xử lý đầu vào qua các tầng rồi sinh đầu ra theo từng token.
Điều này khác với huấn luyện. Trong huấn luyện, mô hình học từ dữ liệu và cập nhật trọng số. Trong suy luận, các trọng số cố định, và mô hình đã huấn luyện chỉ được dùng để tạo dự đoán.
Trong sản xuất, phần lớn chi phí tính toán của LLM nằm ở suy luận.
Một mô hình có thể chỉ được huấn luyện một lần, nhưng xử lý hàng triệu yêu cầu. Vì vậy, hiệu quả suy luận là một trong những bài toán kỹ thuật hệ trọng nhất của AI ứng dụng hiện nay.
Hiểu cách suy luận vận hành ở mức kỹ thuật là cần thiết vì các nút thắt cổ chai thường không hiển nhiên.
Phần cứng nhanh hơn không phải lúc nào cũng cho phản hồi nhanh hơn. Mô hình lớn hơn không phải luôn chậm hơn. Kiến trúc mô hình, độ dài đầu vào, kích thước batch và hạ tầng phục vụ tương tác với nhau theo cách đáng để hiểu rõ trước khi tối ưu.
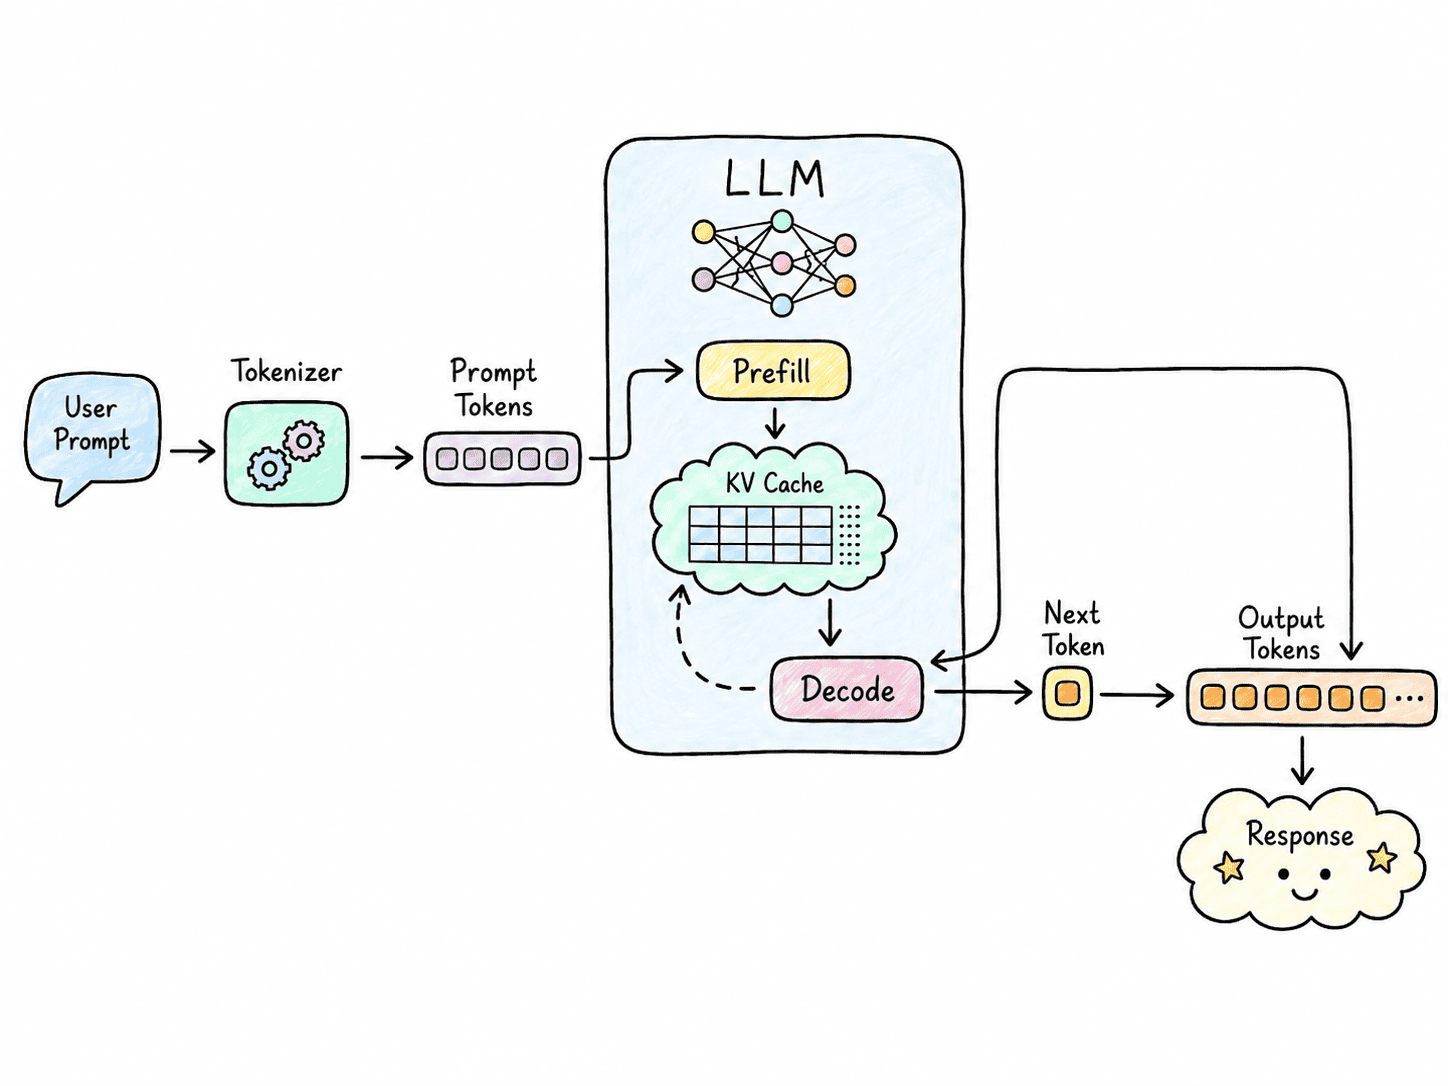
Với hầu hết LLM dựa trên decoder, suy luận gồm hai giai đoạn chính: prefill và decode.
Ở kích thước batch nhỏ, giai đoạn decode thường bị giới hạn bởi băng thông bộ nhớ hơn là năng lực tính toán thô của GPU vì trọng số mô hình và trạng thái attention đã lưu phải được đọc liên tục từ bộ nhớ.
Phân biệt này quan trọng vì một tối ưu hóa cải thiện hiệu năng prefill có thể không nhất thiết cải thiện hiệu năng decode.
Không có một chỉ số duy nhất cho biết máy chủ suy luận có nhanh, hiệu quả hay tiết kiệm chi phí hay không. Những chỉ số này giúp xác định nút thắt, so sánh cấu hình phục vụ và đánh giá liệu một tối ưu hóa có thật sự cải thiện hiệu năng.
Một số chỉ số quan trọng gồm:
Tỷ lệ trúng cache đặc biệt quan trọng trong sản xuất. Các hệ thống agent thường tái sử dụng prompt hệ thống lớn, định nghĩa công cụ, tiền tố hội thoại hoặc tài liệu.
Nếu 95% đầu vào đó có thể phục vụ từ cache, tính toán prefill lặp lại sẽ giảm đáng kể, cải thiện độ trễ và hạ chi phí hiệu dụng để phục vụ các yêu cầu đó.
Các chỉ số này liên hệ chặt chẽ với nhau.
Batch lớn và mức đồng thời cao có thể cải thiện thông lượng và mức sử dụng GPU, nhưng có thể tăng độ trễ cho từng người dùng.
Tương tự, giảm độ chính xác có thể hạ mức dùng bộ nhớ và yêu cầu phần cứng, nhưng có thể không cải thiện tốc độ sinh nếu phần cứng thiếu kernel tối ưu cho định dạng đó.
Vì vậy, mục tiêu không phải tối đa hóa một chỉ số duy nhất, mà là tìm sự cân bằng phù hợp giữa độ trễ, thông lượng, mức sử dụng và chi phí cho khối lượng công việc của bạn.
Hiệu năng suy luận chịu ảnh hưởng lớn từ chính kiến trúc mô hình.
Một transformer dày (dense) về cơ bản sử dụng hầu hết tham số cho mỗi token. Ngược lại, mô hình Mixture-of-Experts (MoE) chứa nhiều chuyên gia nhưng chỉ kích hoạt một tập con nhỏ cho mỗi token.
Điều này có thể giảm lượng tính toán cho mỗi token, nhưng cũng tạo thách thức như định tuyến chuyên gia, cân bằng tải, giao tiếp GPU và bố trí chuyên gia.
Kiến trúc attention cũng tác động lớn tới dùng bộ nhớ và tốc độ suy luận.
Cơ chế Multi-Head Attention (MHA) truyền thống lưu trữ khóa và giá trị riêng cho từng đầu attention, khiến KV cache có thể lớn.
Multi-Query Attention (MQA) giảm nhu cầu bộ nhớ bằng cách cho phép nhiều đầu truy vấn dùng chung khóa và giá trị.
Grouped-Query Attention (GQA) nằm giữa hai cách, với các nhóm đầu truy vấn chia sẻ biểu diễn khóa-giá trị. Kiến trúc mới hơn có thể dùng kỹ thuật như Multi-head Latent Attention (MLA), nén các biểu diễn này hơn nữa.
Đó là lý do hai mô hình có số tham số tương đương có thể hành xử rất khác trong suy luận.
Kiến trúc của chúng có thể ảnh hưởng đáng kể tới nhu cầu tính toán, kích thước KV-cache, mức dùng bộ nhớ và tốc độ sinh.
Tiếp theo, chúng ta sẽ xem các framework được dùng rộng rãi để chạy LLM, từ thiết lập cục bộ đến hệ thống sản xuất quy mô lớn.
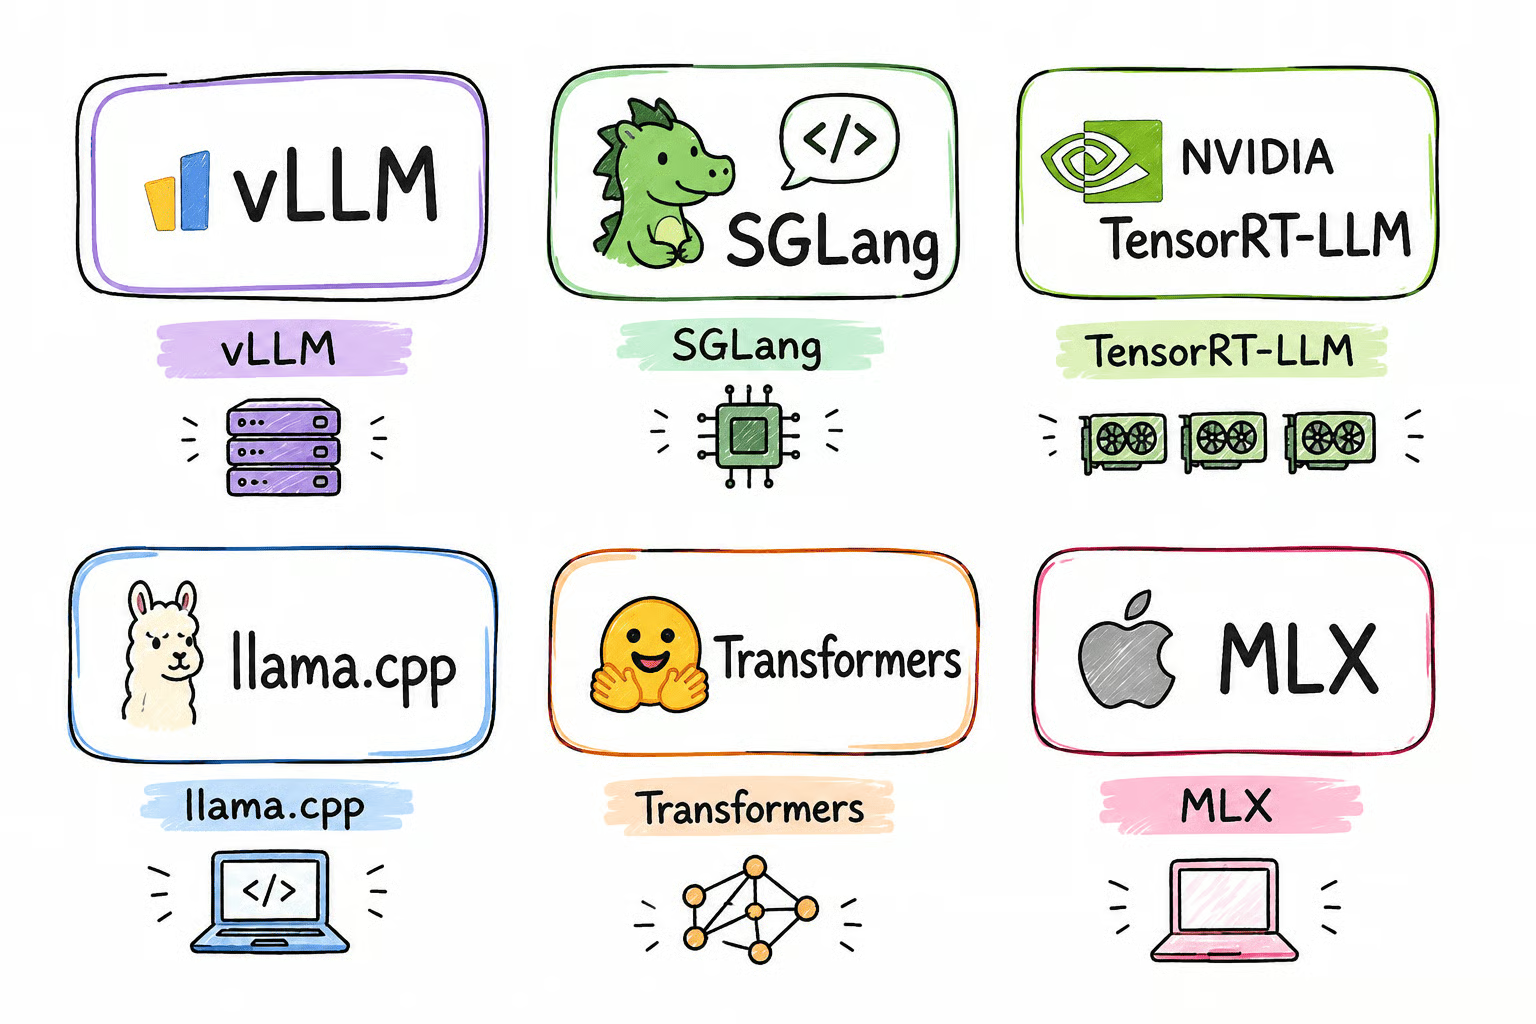
vLLM là một trong những engine suy luận đa dụng phổ biến nhất. Nó hỗ trợ batching liên tục, PagedAttention, prefill theo khối, cache tiền tố, lượng tử hóa, giải mã suy đoán, kernel attention tối ưu và suy luận phân tán.
SGLang tập trung vào sinh đầu ra hiệu năng cao và lập lịch yêu cầu hiệu quả. Đặc biệt hữu ích cho agent, mô hình suy luận, ngữ cảnh lặp lại, đầu ra có cấu trúc và các khối lượng công việc sinh phức tạp khác.
TensorRT-LLM là ngăn xếp suy luận được NVIDIA tối ưu. Nó tận dụng các tính năng GPU NVIDIA, kernel CUDA chuyên biệt, định dạng độ chính xác thấp, thực thi phân tán, bộ đệm KV và batching nâng cao.
llama.cpp đặc biệt hữu ích cho suy luận cục bộ và hạn chế tài nguyên. Nó hỗ trợ lượng tử hóa GGUF, suy luận lai CPU-GPU và tệp mô hình ánh xạ bộ nhớ, cho phép phân phối trọng số giữa bộ nhớ GPU, RAM hệ thống và khi cần, bộ nhớ dựa trên đĩa.
Điều này cho phép chạy các mô hình lớn hơn nhiều so với VRAM sẵn có, dù phụ thuộc nặng vào đĩa có thể làm giảm hiệu năng đáng kể.
MLX là framework suy luận và học máy thiết kế cho Apple Silicon. Nó tận dụng kiến trúc bộ nhớ hợp nhất của Mac, là lựa chọn hữu ích để chạy và thử nghiệm LLM cục bộ trên thiết bị dòng M.
Từ lượng tử hóa đến giải mã suy đoán, phần này bao quát những kỹ thuật giúp suy luận nhanh hơn, rẻ hơn và tiết kiệm bộ nhớ hơn.
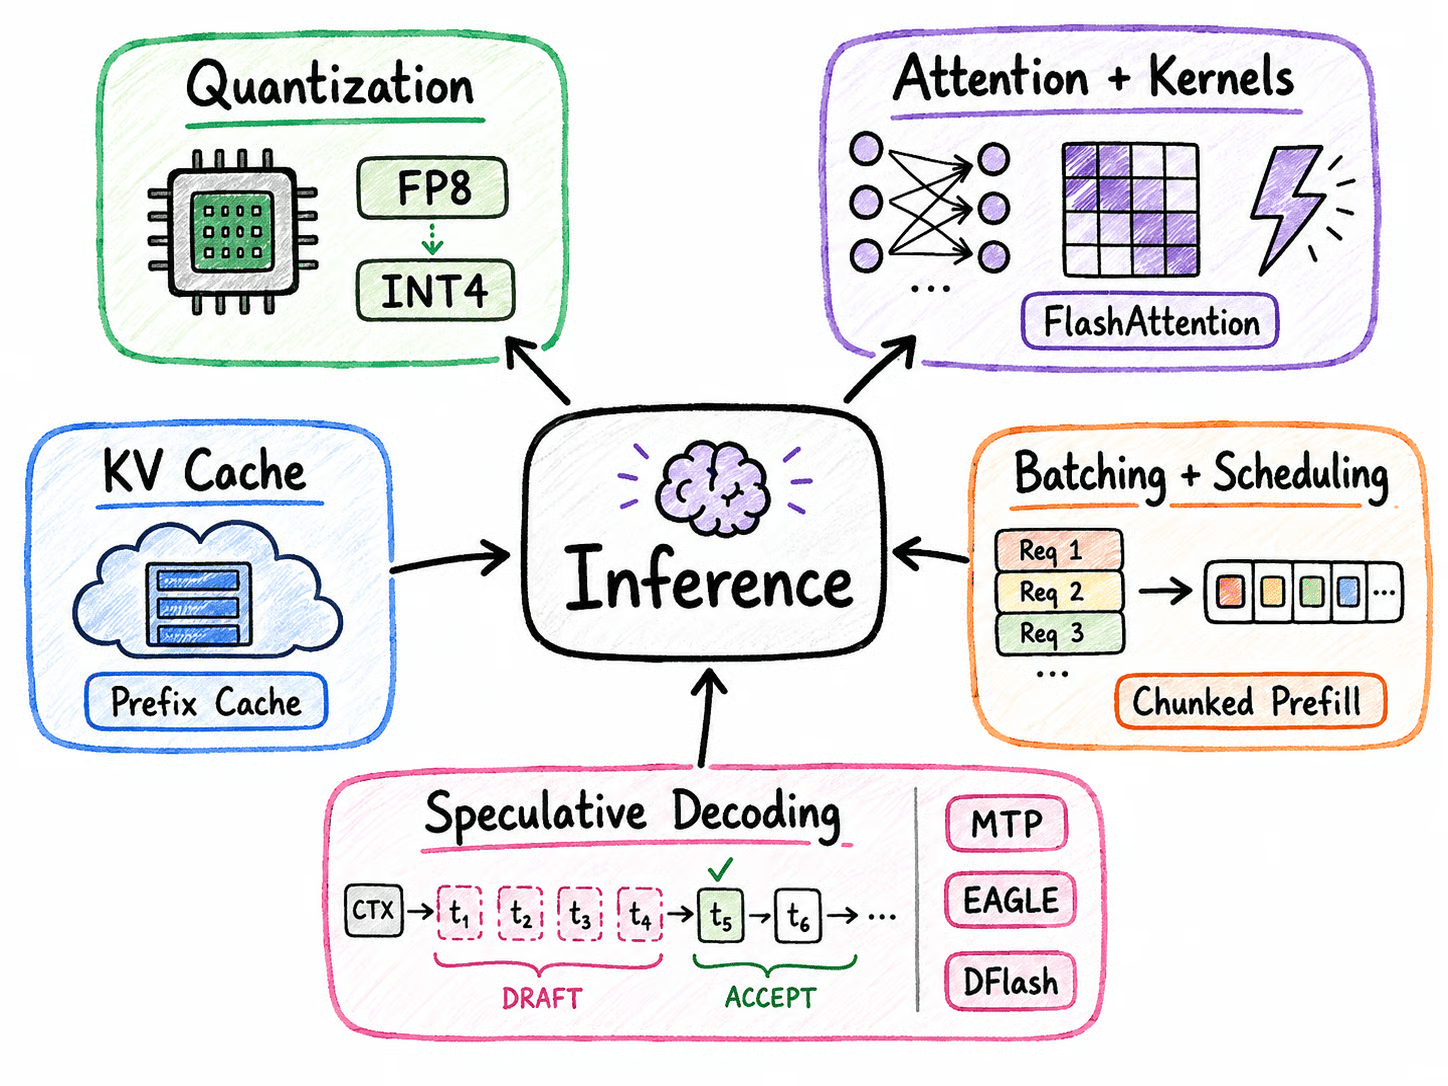
Một trong những tối ưu suy luận phổ biến nhất là lượng tử hóa.
Các mô hình thường được huấn luyện với độ chính xác BF16 hoặc FP16.
Lượng tử hóa biểu diễn trọng số, kích hoạt hoặc cache bằng các định dạng số nhỏ hơn.
Các định dạng và phương pháp phổ biến gồm:
Giảm độ chính xác hạ mức dùng bộ nhớ và có thể giảm yêu cầu băng thông bộ nhớ.
Tuy nhiên, nhỏ hơn không tự động đồng nghĩa nhanh hơn. Hiệu năng phụ thuộc nhiều vào việc phần cứng mục tiêu có cung cấp kernel hiệu quả cho độ chính xác đó hay không.
KV cache cũng có thể được lượng tử hóa, điều này ngày càng có giá trị với ngữ cảnh dài và mức đồng thời cao.
Attention là một trong những phép toán quan trọng nhất trong transformer. Nó cho phép mô hình xác định token nào trong ngữ cảnh là liên quan nhất khi sinh token tiếp theo.
Tuy nhiên, attention có thể trở nên tốn kém về tính toán, đặc biệt khi cửa sổ ngữ cảnh tăng.
Đây là lúc kernel tối ưu trở nên quan trọng. Kernel là đoạn mã tối ưu cao thực hiện một phép toán cụ thể trên phần cứng như GPU. Thay vì thay đổi cách mô hình hoạt động, kernel tối ưu giúp những phép tính đó chạy nhanh hơn và dùng bộ nhớ hiệu quả hơn.
Một ví dụ điển hình là FlashAttention. Attention truyền thống có thể tốn nhiều thời gian di chuyển các kết quả trung gian lớn giữa bộ nhớ GPU và đơn vị tính toán.
FlashAttention giảm chi phí này bằng cách xử lý attention theo khối nhỏ hơn và giữ nhiều tính toán gần GPU hơn.
Các engine suy luận hiện đại dùng nhiều tối ưu tương tự, gồm:
Điểm mấu chốt là các kỹ thuật này nói chung không thay đổi mô hình hay chất lượng đầu ra. Chúng tối ưu cách thực thi phép tính, giúp engine suy luận sinh token nhanh hơn và tận dụng phần cứng hiệu quả hơn.
Trong quá trình sinh, transformer lưu khóa và giá trị từ các token trước vào KV cache.
Nếu không có cache này, mô hình sẽ phải tính lại các token trước mỗi lần sinh thêm một token mới.
Nhược điểm là tiêu thụ bộ nhớ. Ngữ cảnh dài và nhiều người dùng đồng thời có thể khiến KV cache chiếm phần lớn bộ nhớ GPU.
Có một số kỹ thuật giải quyết vấn đề này.
PagedAttention chia bộ nhớ KV-cache thành các khối có thể quản lý được thay vì yêu cầu cấp phát liên tục lớn.
Cache tiền tố (prefix caching) cho phép các yêu cầu có tiền tố giống nhau tái sử dụng trạng thái KV đã tính. Điều này đặc biệt hữu ích cho prompt hệ thống dùng chung, agent và ngữ cảnh tài liệu lặp lại.
Các cách tiếp cận khác gồm:
Với hệ thống suy luận quy mô lớn, quản lý KV-cache có thể quan trọng chẳng kém tối ưu trọng số mô hình.
Khi máy chủ suy luận nhận nhiều yêu cầu cùng lúc, nó cố xử lý chúng cùng nhau để GPU luôn bận rộn. Điều này gọi là batching.
Vấn đề là các yêu cầu LLM hiếm khi kết thúc cùng lúc.
Một người dùng có thể sinh 50 token trong khi người khác sinh 2.000.
Với batching truyền thống, các yêu cầu ngắn có thể phải chờ yêu cầu dài nhất trong batch xong mới được xử lý.
Batching liên tục giải quyết điều này bằng cách loại bỏ các yêu cầu đã hoàn tất và ngay lập tức thay thế bằng yêu cầu mới. Điều này giữ cho GPU làm việc, thay vì để lãng phí công suất.
Một kỹ thuật hữu ích khác là prefill theo khối (chunked prefill). Thay vì xử lý một prompt rất lớn cùng lúc, máy chủ chia nhỏ thành các khối để không chặn những yêu cầu đang sinh token.
Khi lưu lượng tăng, suy luận trở thành bài toán lập lịch. Máy chủ phải quyết định xử lý yêu cầu nào, nhóm chúng ra sao, và cân bằng bộ nhớ GPU, độ dài chuỗi, thông lượng, độ trễ như thế nào.
Giải mã tự hồi quy truyền thống sinh token từng cái một, khiến quá trình sinh mang tính tuần tự.
Giải mã suy đoán cố gắng phá vỡ nút thắt này bằng cách sinh trước nhiều token ứng viên với chi phí rẻ rồi để mô hình đích đầy đủ kiểm chứng song song.
Nếu nhiều ứng viên được chấp nhận, quá trình sinh có thể tiến lên nhiều token cùng lúc mà không thay đổi phân phối đầu ra của mô hình đích.
Có một số hướng tiếp cận theo ý tưởng này:
Ý tưởng cơ bản rất đơn giản:
Sinh rẻ nhiều token tương lai có khả năng cao, rồi xác minh hiệu quả bằng mô hình lớn hơn.
Giải mã suy đoán hoạt động tốt nhất khi token tiếp theo tương đối dễ đoán và tỷ lệ chấp nhận cao.
Điều này đặc biệt hữu ích cho lập trình và các tác vụ tuần tự khác, nơi ngay cả mô hình nhỏ hơn cũng thường đoán được phần tiếp theo.
Với suy luận phức tạp hoặc sinh khó đoán, ít token nháp được chấp nhận hơn, làm giảm lợi ích hiệu năng.
Khi mô hình và khối lượng công việc tăng, bộ nhớ trở thành ràng buộc lớn. Ở đây, chúng ta xem xét offload, suy luận đa GPU, phục vụ tách rời và tối ưu ngữ cảnh dài.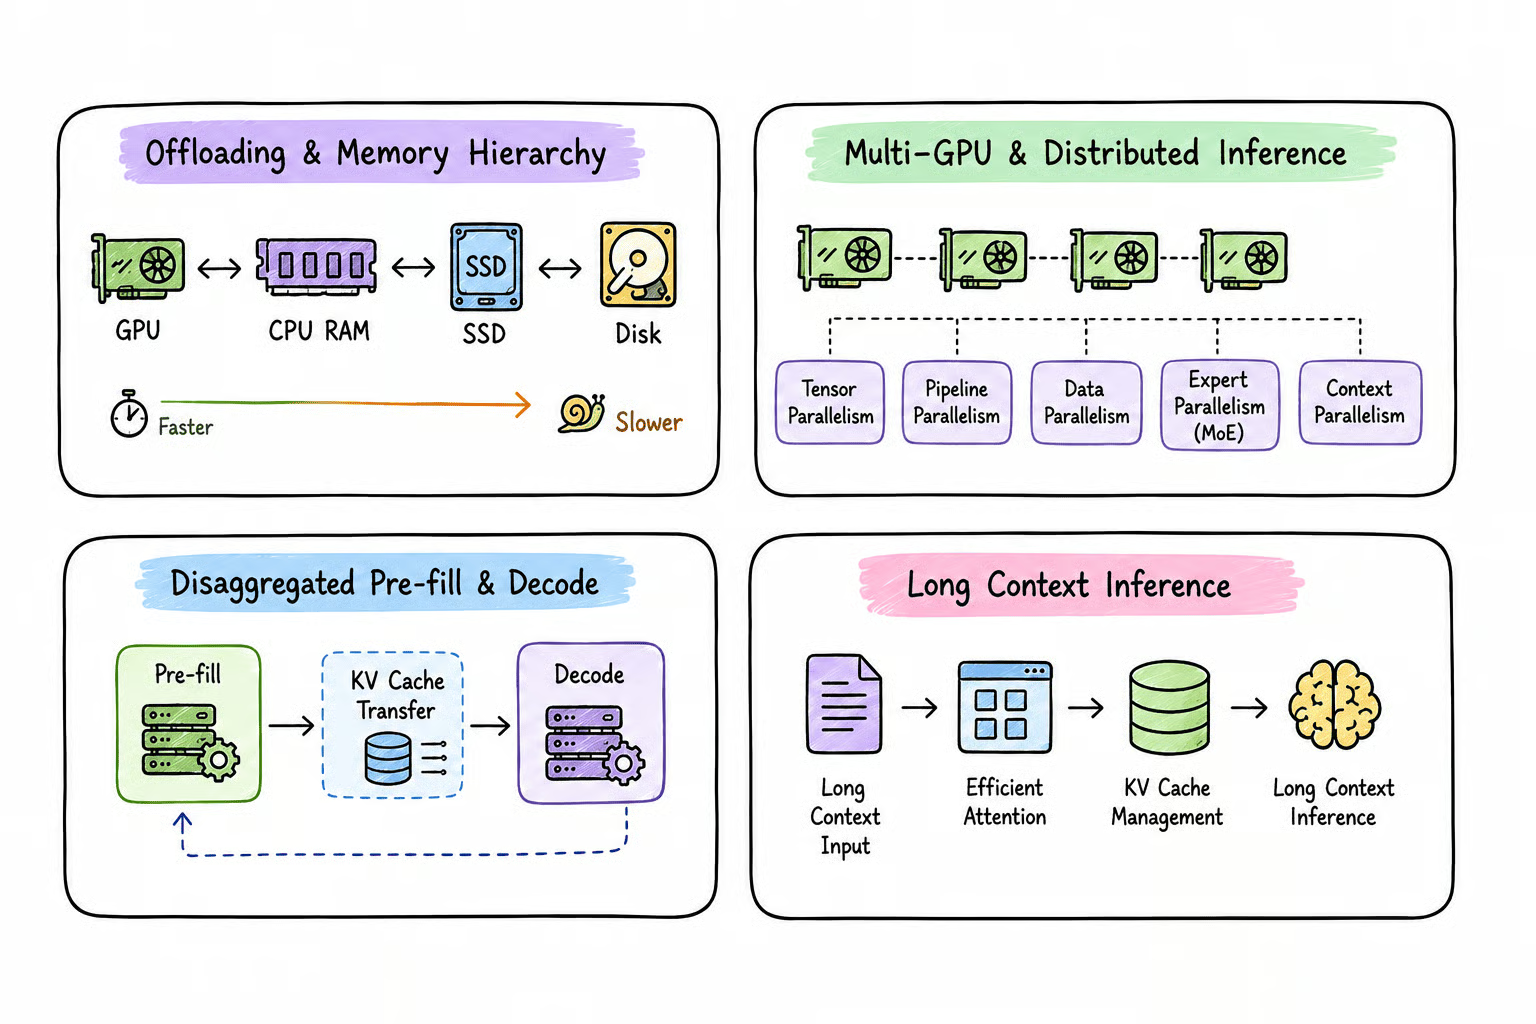
Đôi khi mục tiêu không phải tốc độ tối đa, mà là chạy được mô hình trên phần cứng bạn có.
Hệ thống suy luận có thể dùng các cấp bộ nhớ khác nhau:
GPU HBM → RAM CPU → lưu trữ NVMe
Bộ nhớ GPU nhanh nhất nhưng cũng hạn chế nhất.
Bộ nhớ CPU có dung lượng lớn hơn với tốc độ thấp hơn, còn lưu trữ NVMe cung cấp nhiều không gian hơn nữa nhưng chậm hơn nhiều.
Nếu mô hình hoặc KV cache không thể nằm trọn trong VRAM, engine suy luận có thể chuyển một phần khối lượng công việc sang nơi khác bằng các kỹ thuật như:
Điều này tăng lượng bộ nhớ khả dụng, nhưng thường kèm theo chi phí hiệu năng vì dữ liệu phải di chuyển giữa các tầng bộ nhớ chậm hơn, thường qua PCIe.
Đánh đổi cơ bản rất rõ: dữ liệu càng rời xa bộ nhớ GPU, bạn càng có thêm dung lượng, nhưng suy luận thường càng chậm.
Các mô hình rất lớn thường cần nhiều bộ tăng tốc.
Chiến lược phổ biến gồm:
Khi suy luận trải trên nhiều GPU, giao tiếp trở thành nút thắt quan trọng.
Công nghệ như NVLink, NVSwitch và mạng tốc độ cao vì vậy có thể ảnh hưởng đáng kể đến hiệu năng.
Prefill và decode có hành vi rất khác nhau trong suy luận. Prefill thường nặng về tính toán, vì xử lý nhiều token prompt song song, trong khi decode thường nặng về băng thông bộ nhớ, sinh token từng cái một.
Thay vì để cả hai giai đoạn cạnh tranh trên cùng GPU, hệ thống phục vụ lớn có thể tách chúng ra:
Prompt → Prefill Worker → Truyền KV Cache → Decode Worker → Phản hồi
Worker prefill xử lý prompt và xây dựng KV cache, sau đó chuyển cho worker decode chuyên trách để sinh phản hồi. Việc này cho phép mỗi giai đoạn dùng phần cứng, batching và chiến lược song song khác nhau.
Lợi thế chính là prefill và decode có thể được tối ưu và mở rộng độc lập, giúp kiểm soát thời gian đến token đầu (TTFT) và độ trễ giữa token (ITL), đặc biệt với prompt dài và lưu lượng cao.
Cửa sổ ngữ cảnh dài tạo ra tập thách thức khác trong suy luận. Khi đầu vào tăng, prefill tốn nhiều tính toán hơn, trong khi KV cache phình to, ngốn bộ nhớ GPU và làm decode đắt hơn.
Một số kỹ thuật có thể giúp:
Điểm quan trọng là hỗ trợ cửa sổ ngữ cảnh một triệu token không có nghĩa là phục vụ một triệu token sẽ nhanh, rẻ hay thực tế .
Ngữ cảnh dài hơn làm tăng dùng bộ nhớ, thời gian đến token đầu tiên và tổng chi phí suy luận.
Không phải mọi mô hình đều hành xử giống nhau khi suy luận, nên chúng ta sẽ xem các thách thức riêng của mô hình MoE, sinh có cấu trúc và khối lượng suy luận.
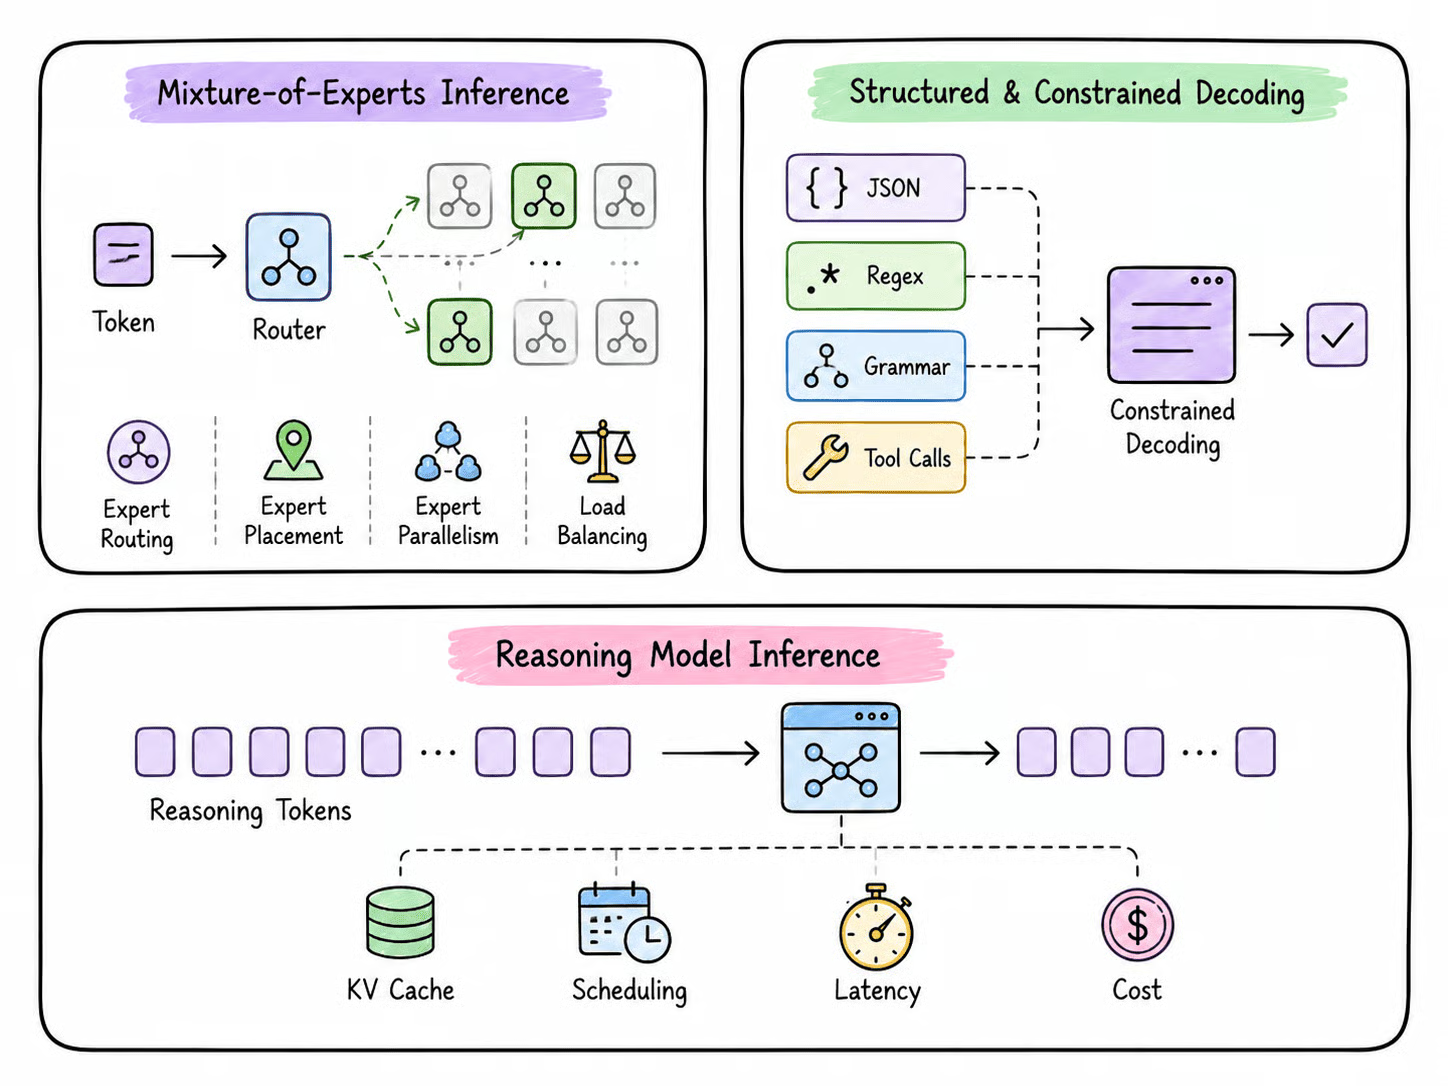
Mixture-of-Experts (MoE) hành xử khác mô hình dày. Thay vì dùng mọi tham số cho mỗi token, một bộ định tuyến (router) chỉ chọn một số ít chuyên gia để xử lý mỗi token.
Điều này giảm tính toán, nhưng toàn bộ tập chuyên gia vẫn cần được lưu đâu đó trên hạ tầng phục vụ.
Vì vậy, suy luận MoE hiệu quả phụ thuộc vào:
Ở quy mô lớn, giao tiếp có thể trở thành nút thắt lớn, đó là lý do công nghệ như DeepEP cung cấp kernel chuyên dụng thông lượng cao, độ trễ thấp để di chuyển token giữa các chuyên gia.
Điểm khác biệt then chốt là tổng số tham số quyết định lượng dung năng mô hình cần lưu, trong khi số tham số hoạt động cho biết lượng tính toán thực hiện cho mỗi token.
Ứng dụng LLM hiện đại thường cần thứ gì đó dự đoán được hơn văn bản tự do. Ví dụ, agent có thể cần sinh JSON hợp lệ, tham số công cụ, SQL hoặc phản hồi theo một schema định sẵn.
Giải mã ràng buộc kiểm soát token mô hình được phép sinh ở mỗi bước, để đầu ra cuối cùng tuân theo cấu trúc yêu cầu. Engine suy luận hiện đại như vLLM hỗ trợ các ràng buộc, bao gồm:
Cách này thường đáng tin cậy hơn so với sinh văn bản tự do rồi cố sửa sau đó. Tuy nhiên, giải mã ràng buộc chỉ đảm bảo cấu trúc, không nhất thiết đảm bảo tính đúng đắn của thông tin bên trong.
Mô hình lý luận tạo ra khối lượng suy luận rất khác vì chúng có thể sinh hàng nghìn token suy luận trung gian trước khi đưa ra câu trả lời cuối.
Không giống khối lượng ngữ cảnh dài, nơi phần lớn chi phí đến từ xử lý đầu vào lớn, khối lượng lý luận có thể tốn kém suốt quá trình sinh vì chính giai đoạn decode kéo dài.
Dấu vết lý luận dài ảnh hưởng tới:
Một thách thức khác là độ dài suy luận thường khó dự đoán.
Một yêu cầu có thể kết thúc nhanh, trong khi yêu cầu khác có thể tiếp tục sinh hàng nghìn token. Điều này làm batching, lập lịch và phân bổ KV-cache khó hơn khi phục vụ nhiều người dùng đồng thời.
Hệ quả là, phục vụ một chatbot sinh vài trăm token và một mô hình lý luận có thể sinh 10.000 token có thể đòi hỏi chiến lược suy luận, bộ nhớ và lập lịch rất khác nhau.
Tối ưu phần mềm chỉ là một phần của suy luận LLM. Phần cứng bên dưới có thể tác động tương đương đến tốc độ, dung lượng bộ nhớ, khả năng mở rộng và chi phí.
Những đặc tính phần cứng quan trọng gồm:
Một khái niệm hữu ích để hiểu hiệu năng phần cứng là cường độ số học (arithmetic intensity), mô tả lượng tính toán thực hiện so với lượng dữ liệu cần di chuyển. Khối lượng công việc có cường độ số học cao thường bị giới hạn bởi tính toán, trong khi khối lượng có cường độ thấp thường bị giới hạn bởi băng thông bộ nhớ.
Trong giai đoạn prefill, nhiều token prompt có thể xử lý song song, cho phép phần cứng tận dụng tốt hơn tài nguyên tính toán. Trong giai đoạn decode, token được sinh tuần tự và hệ thống lặp lại việc truy cập trọng số mô hình và dữ liệu KV-cache. Điều này làm băng thông bộ nhớ đặc biệt quan trọng đối với tốc độ sinh.
Đó là lý do dung lượng và băng thông bộ nhớ là hai thứ khác nhau. Ví dụ, cả NVIDIA DGX Spark và một hệ thống Apple M4 Max có thể cung cấp tới 128 GB bộ nhớ hợp nhất. Tuy nhiên, DGX Spark cung cấp 273 GB/s băng thông bộ nhớ, trong khi M4 Max đạt tới 546 GB/s. Vậy nên, dù cả hai có thể chứa cùng một mô hình lớn trong bộ nhớ, hiệu năng suy luận có thể rất khác nhau.
Nguyên lý tương tự áp dụng khi so sánh GPU và máy AI cục bộ: nhét vừa mô hình giải quyết bài toán dung lượng, không nhất thiết giải quyết bài toán tốc độ.
Với suy luận LLM, hiệu năng tính toán, dung lượng bộ nhớ, băng thông bộ nhớ và tốc độ liên kết đều cần được cân nhắc cùng nhau.
Với rất nhiều kỹ thuật suy luận sẵn có, mấu chốt là trước tiên xác định điều gì thực sự đang giới hạn hệ thống.
Một mô hình không vừa VRAM cần tối ưu rất khác so với một máy chủ gặp khó với độ trễ cao hoặc thông lượng thấp.
|
Vấn đề / Kịch bản |
Kỹ thuật nên cân nhắc |
|
Mô hình không vừa VRAM |
Lượng tử hóa, offload lên CPU, song song tensor/pipeline |
|
TTFT cao / prefill chậm |
Cache tiền tố, tinh chỉnh prefill theo khối, attention tối ưu |
|
Sinh token chậm |
Giải mã suy đoán, kernel tối ưu, độ chính xác thấp hơn |
|
Thông lượng thấp / đồng thời cao |
Batching liên tục, lập lịch yêu cầu, song song dữ liệu |
|
Áp lực bộ nhớ KV-cache |
Lượng tử hóa KV-cache, phân trang, offload, giảm ngữ cảnh/đồng thời |
|
Khối lượng ngữ cảnh dài |
Prefill theo khối, song song ngữ cảnh, tối ưu KV-cache |
|
Mô hình MoE lớn |
Song song chuyên gia, bố trí chuyên gia, cân bằng tải, kernel MoE tối ưu |
|
Prompt lặp lại hoặc chia sẻ |
Cache tiền tố, định tuyến nhận biết tiền tố |
|
Cục bộ / phần cứng hạn chế |
Lượng tử hóa, llama.cpp/GGUF, MLX trên Apple Silicon |
|
Phục vụ sản xuất quy mô lớn |
vLLM, SGLang, TensorRT-LLM, suy luận phân tán, tách prefill/decode |
Điểm quan trọng là không có một tối ưu tốt nhất cho mọi trường hợp.
Hãy bắt đầu bằng cách đo các chỉ số như TTFT, tốc độ sinh token, thông lượng, mức sử dụng GPU và mức dùng bộ nhớ. Sau đó áp dụng kỹ thuật nhắm đúng nút thắt và đo kiểm lại.
Ví dụ, lượng tử hóa hữu ích khi bộ nhớ hạn chế, batching liên tục cải thiện thông lượng, cache tiền tố giảm công việc prefill lặp lại và giải mã suy đoán cải thiện tốc độ sinh khi token tương lai có thể đoán được.
Mục tiêu không chỉ là tối đa hóa token mỗi giây, mà là tìm điểm cân bằng tốt nhất giữa độ trễ, thông lượng, mức dùng bộ nhớ, chất lượng mô hình, phần cứng và chi phí.
Chạy một LLM cục bộ và nhận phản hồi từ llama.cpp là một khởi đầu tuyệt vời, nhưng không đồng nghĩa bạn đã xây dựng hệ thống suy luận hiệu quả.
Với dự án cá nhân, thử nghiệm và khối lượng nhỏ, thiết lập cục bộ đơn giản có thể là đủ.
Nhưng khi bạn bắt đầu phục vụ nhiều người dùng, xử lý ngữ cảnh dài hoặc xây dựng hệ thống lập trình và agent phức tạp, yêu cầu sẽ thay đổi rất nhanh.
Bạn cần một ngăn xếp suy luận có thể xử lý nhiều yêu cầu đồng thời, duy trì tốc độ sinh tốt, quản lý bộ nhớ hiệu quả và vẫn phản hồi nhanh ngay cả khi khối lượng công việc đòi hỏi hơn.
Đây là lúc các khái niệm như batching liên tục, cache tiền tố, quản lý KV-cache, lượng tử hóa, giải mã suy đoán, kernel tối ưu, song song và lập lịch yêu cầu bắt đầu trở nên quan trọng.
Bạn cũng cần hiểu các chỉ số như TTFT, thông lượng, độ trễ, đồng thời, mức sử dụng GPU và chi phí mỗi token thay vì chỉ đánh giá hiệu năng qua token mỗi giây.
Cũng không có cấu hình vạn năng phù hợp với mọi mô hình hay khối lượng công việc. Một kỹ thuật hiệu quả cho lập trình có thể không mang lại lợi ích tương tự cho lý luận.
Một tối ưu cải thiện thông lượng có thể tăng độ trễ. Lượng tử hóa có thể giảm mạnh yêu cầu bộ nhớ, nhưng lượng tử hóa mạnh tay hơn cũng có thể làm giảm chất lượng mô hình.
Cuối cùng, kỹ thuật suy luận LLM tốt là về sự cân bằng. Mục tiêu là tận dụng tốt nhất phần cứng bạn đang có trong khi cân đối tốc độ, bộ nhớ, thông lượng, độ trễ, chất lượng mô hình và chi phí.
Đó là lý do vì sao học về suy luận lại quan trọng. Thay vì hoàn toàn dựa vào thiết lập mặc định hay chỉ thêm GPU, bạn có thể hiểu nút thắt ở đâu, chọn tối ưu phù hợp và xây dựng hệ thống phục vụ thực sự thiết kế cho khối lượng công việc của bạn.
Để tìm hiểu thêm về suy luận LLM, tôi khuyến nghị xem webinar Hiểu về suy luận LLM của chúng tôi.
Các khóa học hàng đầu trên DataCamp
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
