Kurs
Transformer-Modelle mit PyTorch
2 Std.
9.2K
Die Inferenz großer Sprachmodelle (LLMs) wird zur eigenen Kunst.
Unternehmen suchen vermehrt nach LLM-Inferenz- und MLOps-Engineers, die Modelle schneller ausliefern, weniger Hardware einsetzen und die Inferenzkosten senken können.
Ob du Modelle lokal betreibst, einen Inferenzserver ausrollst oder mit Open-Source-LLMs experimentierst – zu verstehen, wie Inferenz funktioniert, macht einen riesigen Unterschied.
Hinter effizienter LLM-Inferenz steckt ein ganzer Werkzeugkasten an Techniken, darunter Quantisierung, KV-Cache-Optimierung, kontinuierliches Batching, optimierte Attention-Kernels, spekulatives Decoding und hardwarebewusstes Tuning.
Viele moderne Inferenz-Frameworks aktivieren einen Teil davon automatisch – du profitierst also womöglich schon, ohne genau zu wissen, was unter der Haube passiert.
In diesem Guide gehe ich auf die Grundlagen der LLM-Inferenz ein, auf die wichtigsten Performance-Kennzahlen, gängige Serving-Frameworks und praxisnahe Methoden, um Modelle schneller, speichereffizienter und günstiger zu betreiben.
Wir starten mit den Basics: Was Inferenz ist, wie sie funktioniert, wie man Leistung misst und warum die Modellarchitektur zählt.
LLM-Inferenz passiert jedes Mal, wenn du einem Sprachmodell einen Prompt schickst und auf eine Antwort wartest. Das Modell verarbeitet die Eingabe durch seine Schichten und generiert dann Token für Token die Ausgabe.
Das unterscheidet sich vom Training. Im Training lernt das Modell aus Daten und aktualisiert seine Gewichte. In der Inferenz sind diese Gewichte fixiert, und das trainierte Modell wird nur für Vorhersagen genutzt.
Die Inferenz verursacht in der Produktion den Großteil der Rechenkosten von LLMs.
Ein Modell wird einmal trainiert, aber verarbeitet Millionen Anfragen. Deshalb ist Inferenz-Effizienz eines der wichtigsten Engineering-Themen in der angewandten KI.
Technisches Verständnis der Inferenz ist entscheidend, weil die Engpässe nicht offensichtlich sind.
Schnellere Hardware bedeutet nicht automatisch schnellere Antworten. Größere Modelle sind nicht immer langsamer. Architektur, Eingabelänge, Batchgröße und Serving-Infrastruktur greifen ineinander – das solltest du verstehen, bevor du optimierst.
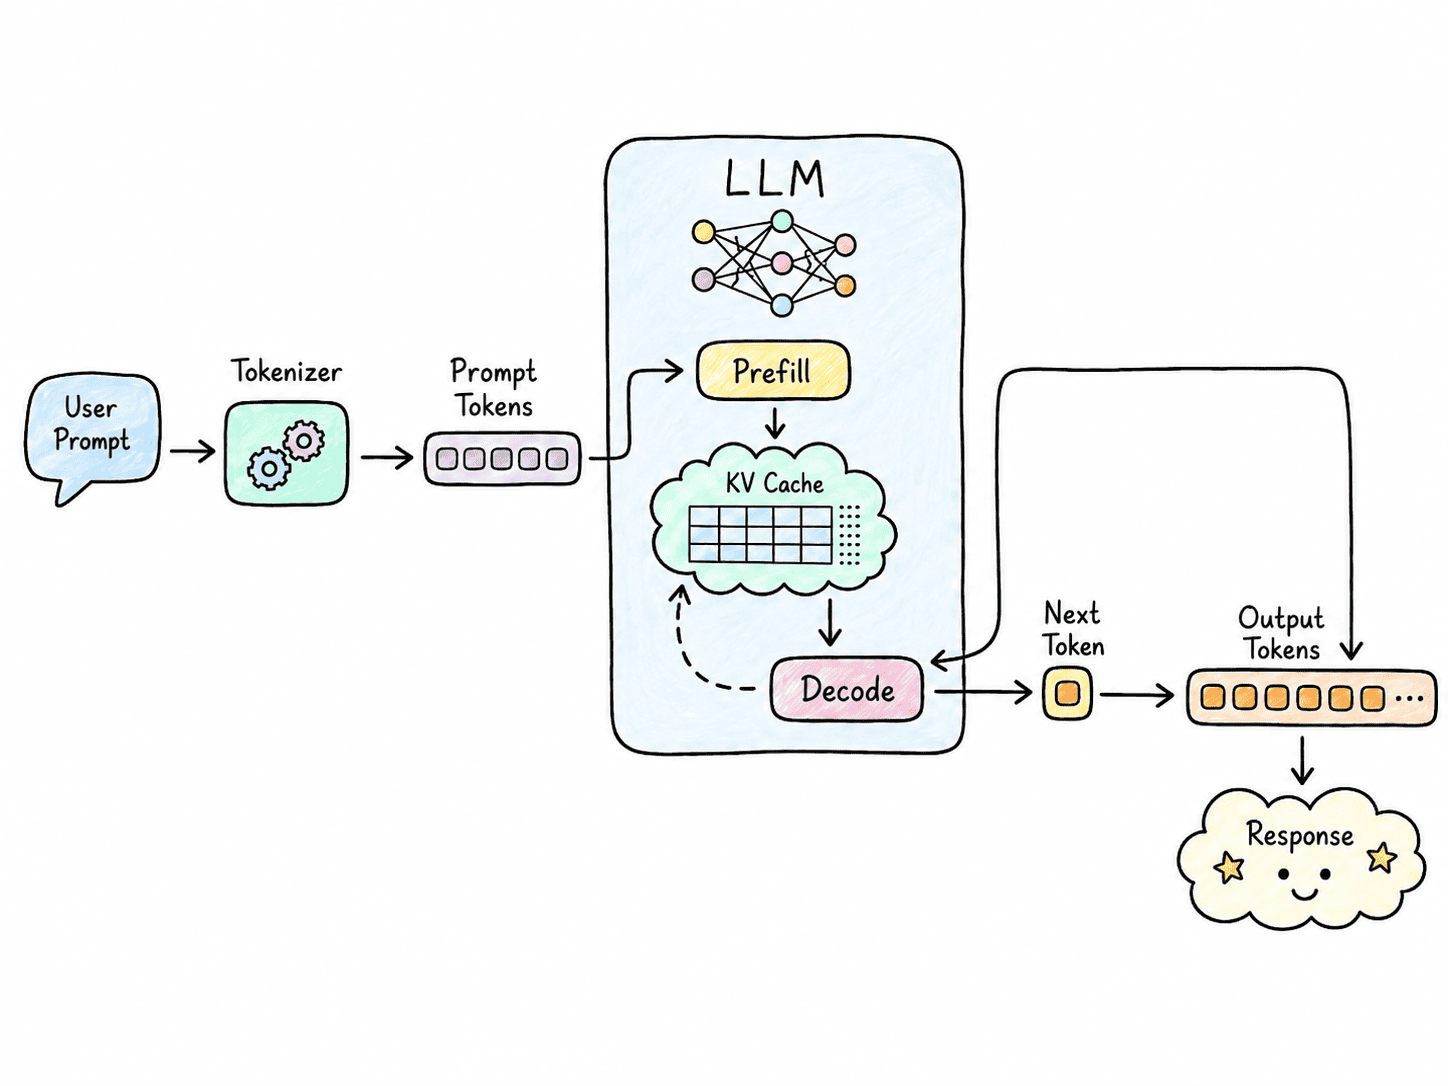
Bei den meisten Decoder-basierten LLMs besteht die Inferenz aus zwei Hauptphasen: Prefill und Decode.
Bei kleineren Batchgrößen wird das Decoding häufig eher durch die Speicherbandbreite als durch rohe GPU-Rechenleistung limitiert, weil Modellgewichte und zwischengespeicherte Attention-Zustände ständig aus dem Speicher gelesen werden müssen.
Diese Unterscheidung ist wichtig, denn eine Optimierung, die das Prefill beschleunigt, verbessert nicht zwingend das Decoding.
Es gibt keine einzelne Kennzahl, die zeigt, ob ein Inferenzserver schnell, effizient oder kosteneffektiv ist. Die folgenden Metriken helfen, Engpässe zu erkennen, Setups zu vergleichen und zu prüfen, ob eine Optimierung wirklich etwas bringt.
Zu den wichtigsten Metriken zählen:
Die Cache-Hit-Rate kann in der Produktion besonders wichtig sein. Agentische Systeme wiederverwenden häufig große Systemprompts, Tool-Definitionen, Gesprächspräfixe oder Dokumente.
Wenn 95% oder mehr dieser Eingabe aus dem Cache bedient werden können, sinkt der wiederholte Prefill-Aufwand deutlich – die Latenz verbessert sich, und die effektiven Kosten für solche Anfragen fallen.
Diese Metriken hängen eng zusammen.
Größere Batches und höhere Parallelität verbessern oft Durchsatz und GPU-Auslastung, können aber die Latenz für Einzelne erhöhen.
Ebenso senkt geringere Präzision den Speicherbedarf und die Hardwareanforderungen, beschleunigt aber die Generierung nicht zwingend, wenn der Hardware optimierte Kernel für dieses Format fehlen.
Das Ziel ist daher nicht, eine einzige Metrik zu maximieren, sondern die richtige Balance aus Latenz, Durchsatz, Auslastung und Kosten für deine Workload zu finden.
Die Inferenzleistung wird stark von der Architektur des Modells selbst geprägt.
Ein dichter Transformer nutzt im Wesentlichen alle Parameter für jedes Token. Ein Mixture-of-Experts (MoE)-Modell hingegen enthält viele Expertinnen und Experten, aktiviert aber pro Token nur eine kleine Teilmenge.
Das kann den Rechenaufwand pro Token reduzieren, bringt aber Herausforderungen wie Expert:innen-Routing, Lastverteilung, GPU-Kommunikation und Platzierung der Expert:innen mit sich.
Auch die Attention-Architektur hat großen Einfluss auf Speicherbedarf und Inferenztempo.
Klassische Multi-Head Attention (MHA) speichert für jeden Attention-Head eigene Key- und Value-Repräsentationen, was den KV-Cache groß macht.
Multi-Query Attention (MQA) reduziert diesen Speicherbedarf, indem mehrere Query-Heads sich dieselben Keys und Values teilen.
Grouped-Query Attention (GQA) liegt dazwischen: Gruppen von Query-Heads teilen sich Key-Value-Repräsentationen. Neuere Architekturen setzen Techniken wie Multi-head Latent Attention (MLA) ein, die diese Repräsentationen weiter komprimieren.
Darum können sich zwei Modelle mit ähnlicher Parameterzahl in der Inferenz sehr unterschiedlich verhalten.
Ihre Architektur beeinflusst maßgeblich Rechenbedarf, KV-Cache-Größe, Speicherverbrauch und Generationsgeschwindigkeit.
Als Nächstes sehen wir uns die verbreitetsten Frameworks zum Betrieb von LLMs an – von lokalen Setups bis zu großskaligen Produktionssystemen.
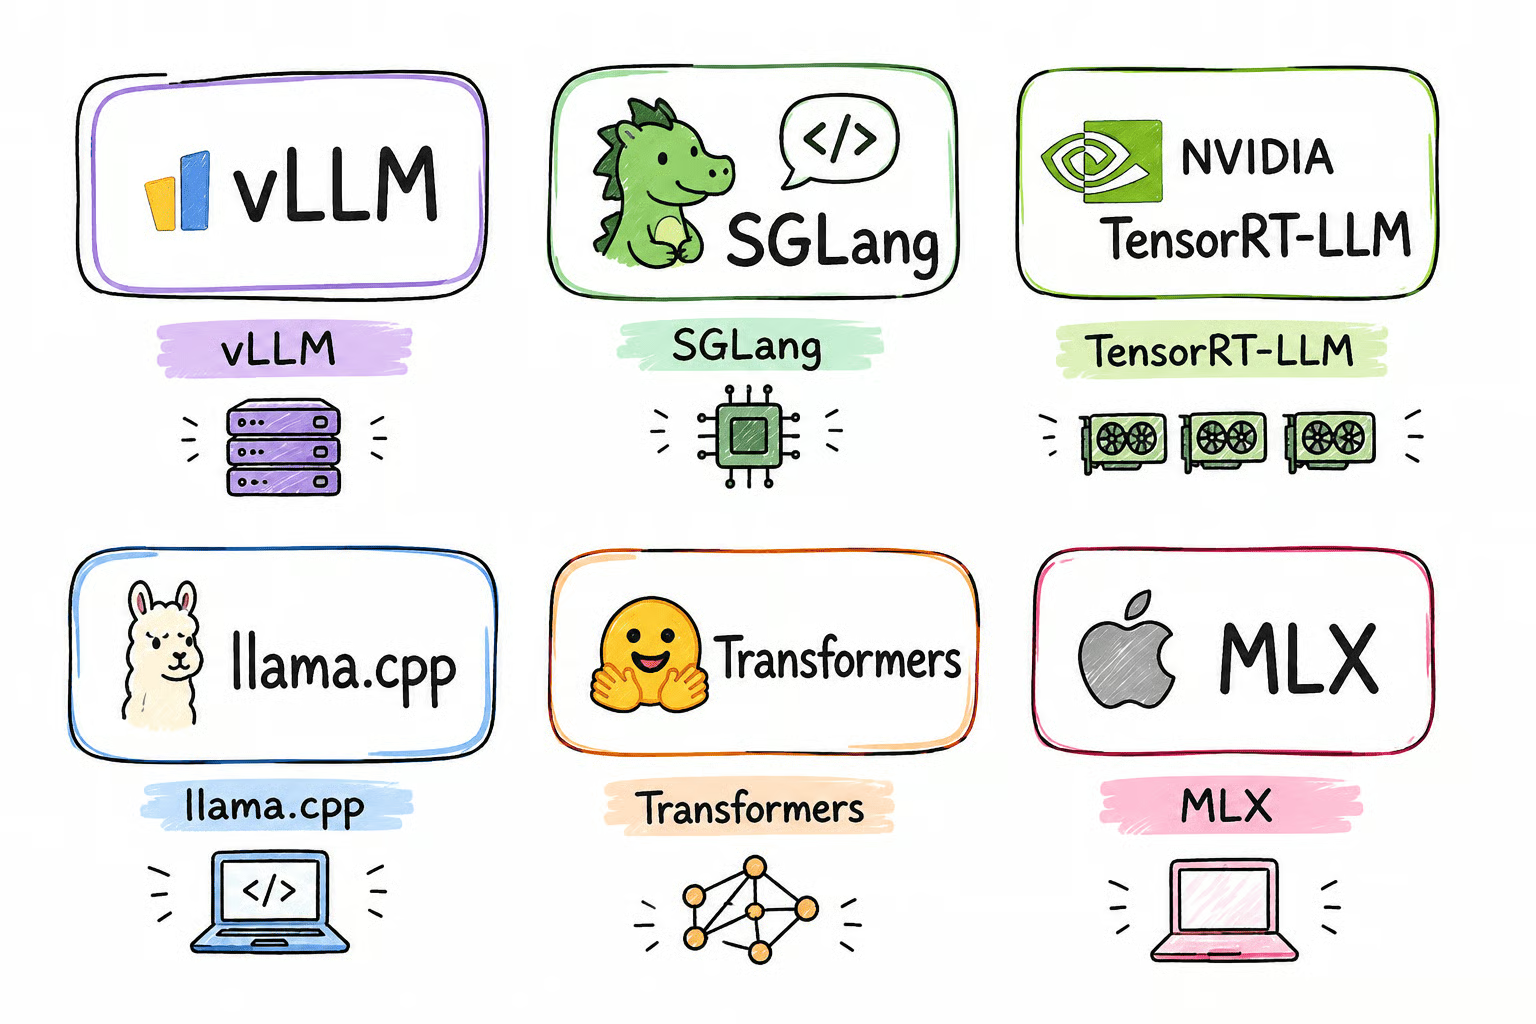
vLLM ist eines der meistgenutzten, allgemeinen Inferenz-Engines. Es unterstützt Continuous Batching, PagedAttention, Chunked Prefill, Prefix Caching, Quantisierung, spekulatives Decoding, optimierte Attention-Kernels und verteilte Inferenz.
SGLang fokussiert sich auf Hochleistungs-Generierung und effizientes Request-Scheduling. Besonders nützlich für Agenten, Reasoning-Modelle, wiederholten Kontext, strukturierte Ausgaben und andere komplexe Generations-Workloads.
TensorRT-LLM ist NVIDIAs optimierter Inferenz-Stack. Er nutzt GPU-Features von NVIDIA, spezialisierte CUDA-Kernels, niedrigpräzise Formate, verteilte Ausführung, KV-Caching und fortgeschrittenes Batching.
llama.cpp ist besonders hilfreich für lokale und ressourcenbeschränkte Inferenz. Es unterstützt GGUF-Quantisierung, hybride CPU-GPU-Inferenz und speichergemapte Modell-Dateien, sodass Gewichte über VRAM, System-RAM und – falls nötig – sogar plattengebundenen Speicher verteilt werden können.
So lassen sich Modelle betreiben, die eigentlich größer sind als der verfügbare VRAM – starker Platteneinsatz bremst die Performance allerdings deutlich.
MLX ist ein Inferenz- und ML-Framework für Apple Silicon. Es nutzt die einheitliche Speicherarchitektur von Macs und ist damit eine gute Option, um LLMs lokal auf M‑Series-Geräten auszuführen und zu testen.
Von Quantisierung bis spekulativem Decoding – dieser Teil behandelt Techniken, die Inferenz schneller, günstiger und speichereffizienter machen.
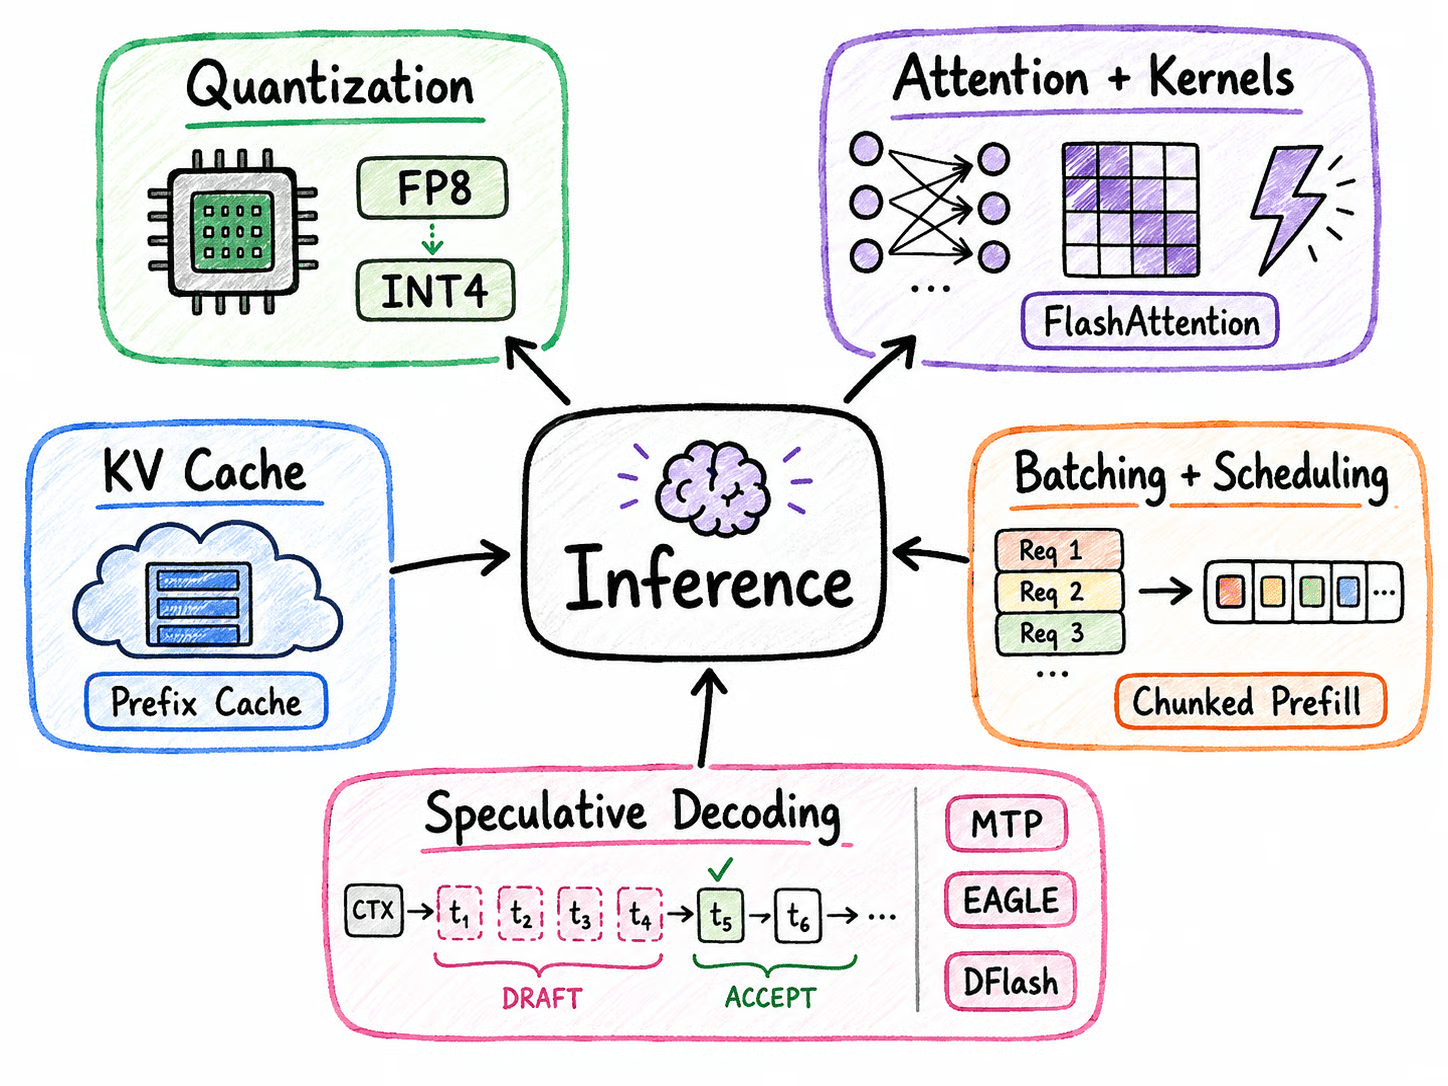
Eine der häufigsten Inferenz-Optimierungen ist die Quantisierung.
Modelle werden oft mit BF16- oder FP16-Präzision trainiert.
Quantisierung speichert Gewichte, Aktivierungen oder Caches in kleineren Zahlenformaten.
Gängige Formate und Verfahren sind:
Weniger Präzision senkt den Speicherverbrauch und kann die Anforderungen an die Speicherbandbreite reduzieren.
Kleiner heißt aber nicht automatisch schneller. Die Leistung hängt stark davon ab, ob die Zielhardware effiziente Kernel für diese Präzision bereitstellt.
Auch der KV-Cache kann quantisiert werden – das wird bei langen Kontexten und hoher Parallelität besonders wertvoll.
Attention ist eine der wichtigsten Operationen im Transformer. Sie ermöglicht dem Modell, die relevantesten Tokens im Kontext für das nächste Token zu bestimmen.
Allerdings kann Attention sehr rechenaufwändig werden, besonders bei wachsenden Kontextfenstern.
Hier kommen optimierte Kernel ins Spiel. Ein Kernel ist hochoptimierter Code für eine bestimmte mathematische Operation auf Hardware wie einer GPU. Statt die Logik des Modells zu ändern, beschleunigen optimierte Kernel die gleichen Berechnungen und gehen sparsamer mit Speicher um.
Ein gutes Beispiel ist FlashAttention. Klassische Attention verbringt viel Zeit damit, große Zwischenresultate zwischen GPU-Speicher und Recheneinheiten zu bewegen.
FlashAttention reduziert diesen Overhead, indem Attention in kleinere Blöcke zerlegt wird und mehr Berechnung nahe an der GPU bleibt.
Moderne Inferenz-Engines nutzen mehrere ähnliche Optimierungen, u. a.:
Wichtig ist: Diese Techniken ändern in der Regel nicht das Modell oder die Ausgabequalität. Sie optimieren, wie die Berechnungen ausgeführt werden, damit Inferenz-Engines schneller Tokens erzeugen und die vorhandene Hardware effizienter nutzen.
Während der Generierung speichern Transformer die Keys und Values vorheriger Tokens im KV-Cache.
Ohne diesen Cache müsste das Modell bei jedem neuen Token die vorherigen Tokens erneut berechnen.
Der Nachteil ist der Speicherbedarf. Lange Kontexte und viele gleichzeitige Nutzer:innen können dazu führen, dass der KV-Cache einen Großteil des GPU-Speichers belegt.
Mehrere Techniken adressieren dieses Problem.
PagedAttention teilt den KV-Cache in handhabbare Blöcke, statt große zusammenhängende Allokationen zu verlangen.
Prefix Caching ermöglicht es Anfragen mit identischen Präfixen, zuvor berechnete KV-Zustände wiederzuverwenden. Besonders hilfreich bei gemeinsamen Systemprompts, Agenten und wiederkehrenden Dokumentkontexten.
Weitere Ansätze sind:
Für großskalige Inferenzsysteme ist das KV-Cache-Management oft ebenso wichtig wie die Optimierung der Modellgewichte.
Wenn ein Inferenzserver viele Anfragen gleichzeitig erhält, versucht er, sie gebündelt zu verarbeiten, damit die GPU ausgelastet bleibt. Das nennt man Batching.
Das Problem: LLM-Anfragen enden selten gleichzeitig.
Eine Person generiert 50 Tokens, eine andere 2.000.
Bei klassischem Batching warten kurze Anfragen dann auf die längste Anfrage im Batch.
Kontinuierliches Batching löst das, indem erledigte Anfragen entfernt und sofort neue nachgeschoben werden. So bleibt die GPU beschäftigt statt ungenutzte Kapazitäten zu lassen.
Eine weitere nützliche Technik ist das Chunked Prefill. Statt einen sehr großen Prompt am Stück zu verarbeiten, teilt der Server ihn in kleinere Teile, damit andere Anfragen, die schon Tokens erzeugen, nicht blockiert werden.
Mit wachsendem Traffic wird Inferenz zu einem Scheduling-Problem. Der Server muss entscheiden, welche Anfragen er wann verarbeitet, wie er sie gruppiert und wie er GPU-Speicher, Sequenzlängen, Durchsatz und Latenz ausbalanciert.
Klassisches autoregressives Decoding erzeugt Tokens nacheinander – die Generierung ist also inhärent sequentiell.
Spekulatives Decoding versucht diesen Flaschenhals zu durchbrechen, indem mehrere Kandidaten-Tokens günstig vorab generiert und dann parallel vom großen Zielmodell verifiziert werden.
Werden mehrere Kandidaten akzeptiert, springt die Generierung mehrere Tokens vor, ohne die Ausgabeverteilung des Zielmodells zu verändern.
Mehrere Ansätze folgen dieser Idee:
Die Grundidee ist simpel:
Mehrere wahrscheinliche Folgetokens günstig vorentwerfen und sie dann effizient mit dem großen Modell verifizieren.
Spekulatives Decoding wirkt am besten, wenn die nächsten Tokens relativ vorhersehbar sind und die Akzeptanzrate hoch ist.
Das ist besonders nützlich fürs Coden und andere sequentielle Aufgaben, bei denen selbst kleinere Modelle oft gut abschätzen, was als Nächstes kommt.
Bei komplexem Reasoning oder sehr unvorhersehbarer Generierung werden weniger Draft-Tokens akzeptiert – der Performancegewinn schrumpft.
Mit zunehmender Modell- und Workload-Größe wird Speicher zum Engpass. Hier betrachten wir Offloading, Multi-GPU-Inferenz, disaggregiertes Serving und Long-Context-Optimierung.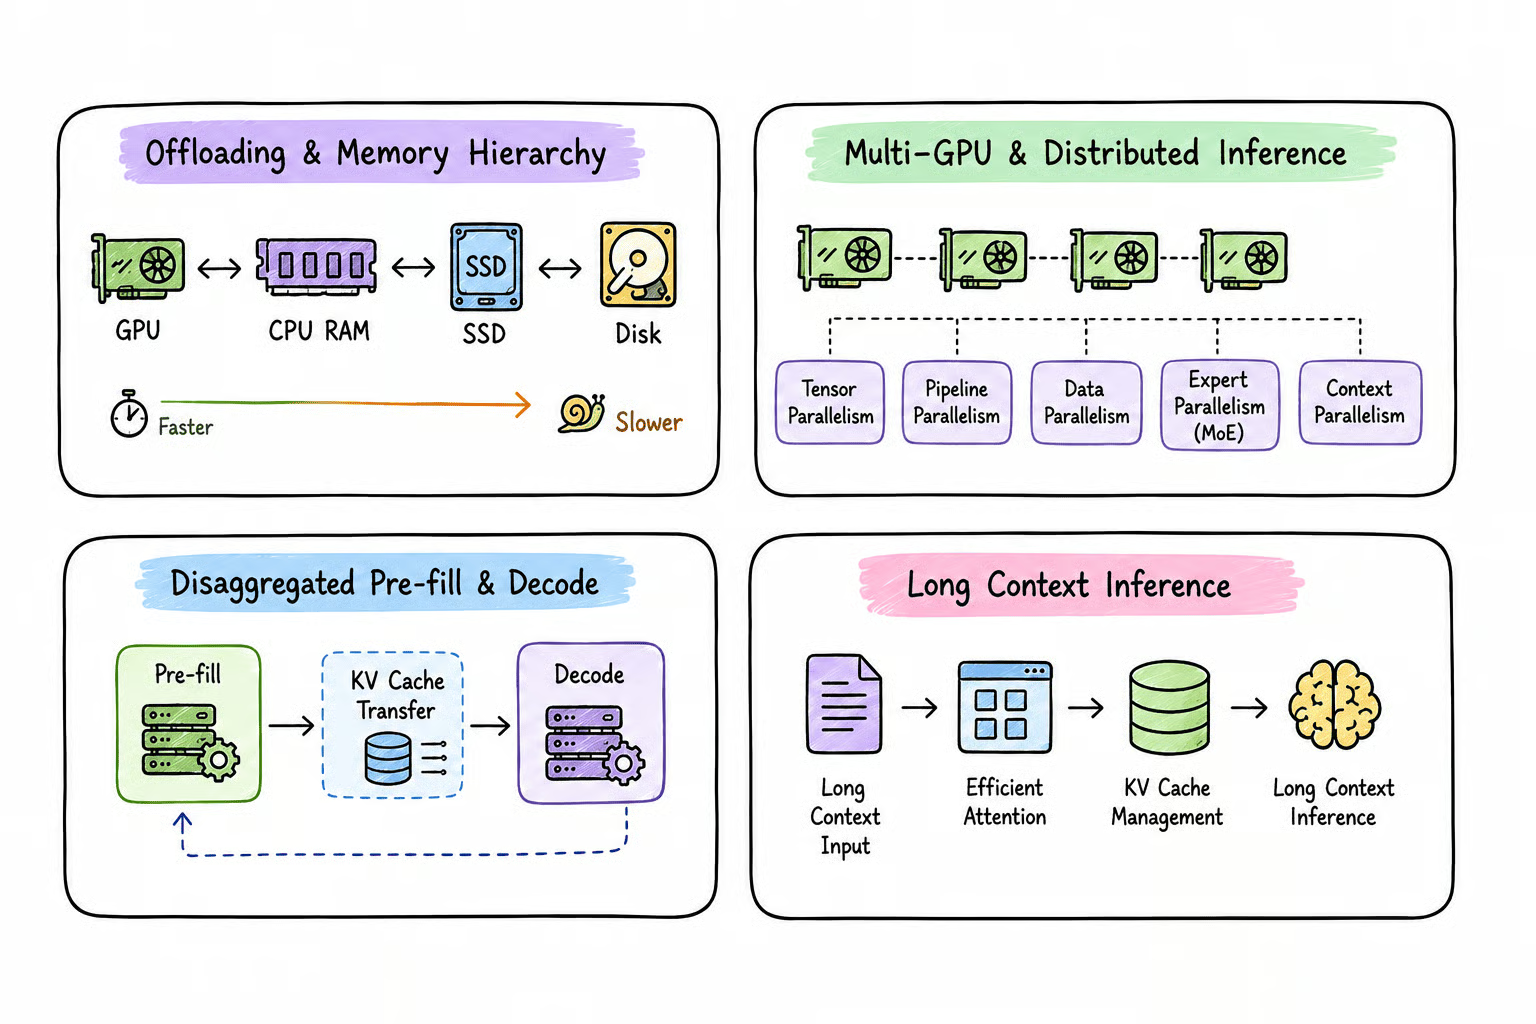
Manchmal geht es nicht um maximale Geschwindigkeit, sondern darum, ein Modell auf vorhandener Hardware überhaupt zum Laufen zu bringen.
Inferenzsysteme können verschiedene Speicherebenen nutzen:
GPU-HBM → CPU-RAM → NVMe-Speicher
GPU-Speicher ist am schnellsten, aber auch am knappsten.
CPU-Speicher bietet mehr Kapazität bei geringerer Geschwindigkeit, NVMe noch mehr Platz, aber deutlich langsamer.
Passen Modell oder KV-Cache nicht vollständig in den VRAM, können Inferenz-Engines Teile der Last auslagern, z. B. via:
Das erhöht die verfügbare Speichermenge, kostet aber meist Performance, da Daten zwischen langsameren Ebenen – oft über PCIe – bewegt werden müssen.
Die Grundregel: Je weiter Daten vom GPU-Speicher entfernt sind, desto mehr Kapazität gewinnst du – aber desto langsamer wird die Inferenz in der Regel.
Sehr große Modelle benötigen oft mehrere Beschleuniger.
Gängige Strategien sind:
Sobald die Inferenz mehrere GPUs umfasst, wird Kommunikation zum Engpass.
Technologien wie NVLink, NVSwitch und schnelle Netzwerke beeinflussen daher die Performance erheblich.
Prefill und Decode verhalten sich in der Inferenz sehr unterschiedlich. Prefill ist meist rechenintensiv, weil viele Prompt-Tokens parallel verarbeitet werden, während Decode oft speicherbandbreitenlimitiert ist und Tokens nacheinander erzeugt.
Statt beide Phasen um dieselben GPUs konkurrieren zu lassen, können größere Servingsysteme sie trennen:
Prompt → Prefill-Worker → KV-Cache-Transfer → Decode-Worker → Antwort
Prefill-Worker verarbeiten den Prompt und bauen den KV-Cache auf, der dann an dedizierte Decode-Worker übertragen wird. So kann jede Phase andere Hardware, Batching- und Parallelisierungsstrategien nutzen.
Der Hauptvorteil: Prefill und Decode lassen sich unabhängig optimieren und skalieren – das hilft, Time to First Token (TTFT) und Inter-Token-Latenz (ITL) im Griff zu behalten, gerade bei langen Prompts und hohem Traffic.
Lange Kontextfenster bringen eigene Inferenzherausforderungen mit sich. Mit wachsender Eingabe steigt der Prefill-Rechenaufwand, während der KV-Cache größer wird, mehr GPU-Speicher verbraucht und das Decoding verteuert.
Mehrere Techniken helfen dabei:
Wichtig ist: Ein Kontextfenster mit einer Million Tokens zu unterstützen heißt nicht, dass das Serving von einer Million Tokens schnell, günstig oder praktikabel ist.
Längere Kontexte erhöhen Speicherverbrauch, Time to First Token und die Gesamtkosten der Inferenz.
Nicht jedes Modell verhält sich zur Inferenzzeit gleich. Wir betrachten daher die besonderen Herausforderungen von MoE-Modellen, strukturierter Generierung und Reasoning-Workloads.
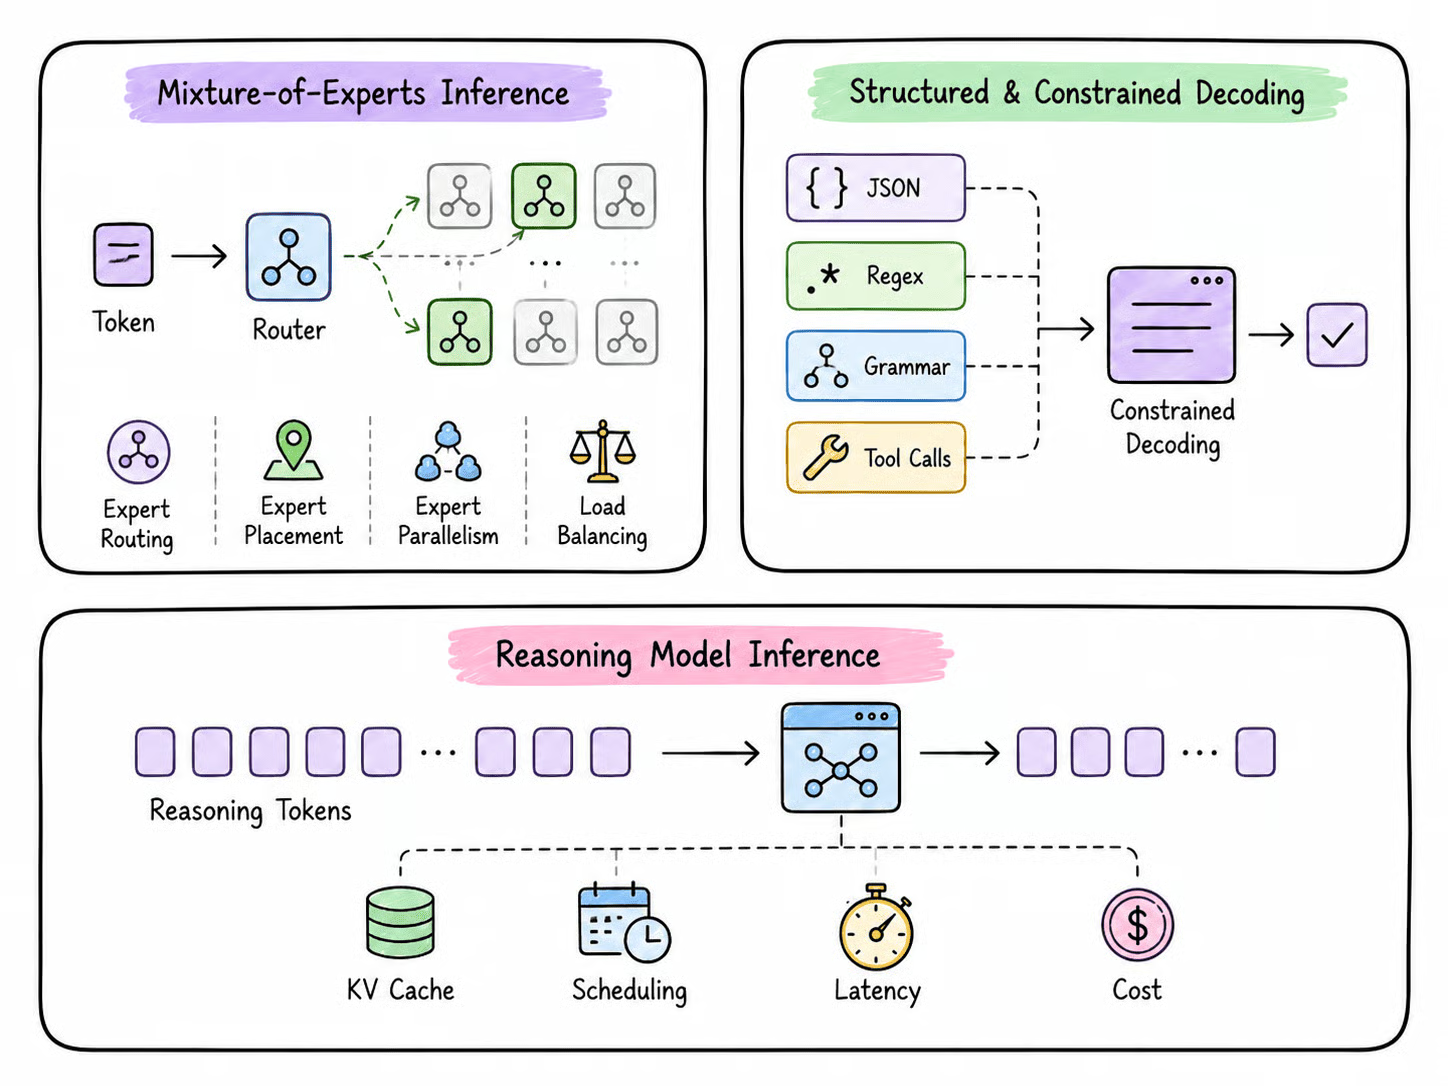
Mixture-of-Experts (MoE)-Modelle verhalten sich anders als dichte Modelle. Statt jeden Parameter für jedes Token zu nutzen, wählt ein Router nur wenige Expert:innen für die Verarbeitung pro Token aus.
Das senkt den Rechenaufwand, doch der vollständige Expert:innen-Pool muss trotzdem irgendwo auf der Serving-Hardware vorgehalten werden.
Effiziente MoE-Inferenz hängt daher ab von:
In großem Maßstab wird Kommunikation zum Flaschenhals – deshalb bieten Technologien wie DeepEP spezialisierte, hochperformante Low-Latency-Kernels für den Token-Transfer zwischen Expert:innen.
Wichtig ist der Unterschied: Gesamtparameter bestimmen, wie viel Modellkapazität gespeichert werden muss, aktive Parameter geben besser an, wie viel Rechenaufwand pro Token entsteht.
Moderne LLM-Anwendungen brauchen oft etwas Vorhersagbareres als freien Text. Agenten müssen z. B. gültiges JSON, Tool-Argumente, SQL oder Antworten nach einem vorgegebenen Schema erzeugen.
Eingeschränktes Decoding steuert, welche Tokens das Modell an jedem Schritt erzeugen darf, sodass die Ausgabe einer gewünschten Struktur folgt. Moderne Inferenz-Engines wie vLLM unterstützen u. a.:
Das ist meist verlässlicher, als freien Text zu generieren und danach zu reparieren. Allerdings garantiert eingeschränktes Decoding die Struktur – nicht zwingend die Korrektheit der Inhalte.
Reasoning-Modelle erzeugen eine ganz andere Inferenzlast, weil sie unter Umständen tausende Zwischen-Reasoning-Tokens generieren, bevor die finale Antwort kommt.
Anders als bei Long-Context-Workloads, bei denen die Kosten stark aus der großen Eingabe stammen, bleiben Reasoning-Workloads über die gesamte Generierung teuer, weil die Decode-Phase selbst sehr lang wird.
Lange Reasoning-Traces beeinflussen:
Eine weitere Herausforderung: Die Reasoning-Länge ist oft schwer vorherzusagen.
Eine Anfrage ist schnell fertig, eine andere generiert tausende Tokens weiter. Das erschwert Batching, Scheduling und KV-Cache-Allokation, wenn viele Nutzer:innen gleichzeitig bedient werden.
Daher erfordern ein Chatbot, der ein paar hundert Tokens erzeugt, und ein Reasoning-Modell, das 10.000 Tokens generiert, sehr unterschiedliche Inferenz-, Speicher- und Scheduling-Strategien.
Software-Optimierung ist nur ein Teil der LLM-Inferenz. Die zugrunde liegende Hardware beeinflusst Geschwindigkeit, Speicherkapazität, Skalierbarkeit und Kosten ebenso stark.
Wichtige Hardware-Eigenschaften sind:
Ein nützliches Konzept zum Verständnis der Hardwareleistung ist die arithmetische Intensität: Sie beschreibt, wie viel gerechnet wird im Verhältnis zu den zu bewegenden Daten. Workloads mit hoher arithmetischer Intensität sind eher compute-bound, solche mit niedriger Intensität oft durch die Speicherbandbreite limitiert.
Im Prefill können viele Prompt-Tokens parallel verarbeitet werden – die Hardware nutzt ihre Rechenressourcen besser. Im Decode dagegen entstehen Tokens sequentiell, und das System greift wiederholt auf Modellgewichte und KV-Cache zu. Das macht die Speicherbandbreite besonders wichtig für die Generationsgeschwindigkeit.
Deshalb sind Speicherkapazität und Speicherbandbreite zwei verschiedene Dinge. Beispiel: Sowohl das NVIDIA DGX Spark als auch ein Apple M4 Max-System können bis zu 128 GB Unified Memory bereitstellen. DGX Spark bietet jedoch 273 GB/s Speicherbandbreite, während M4 Max bis zu 546 GB/s erreicht. Auch wenn beide Systeme dasselbe große Modell in den Speicher bekommen, kann sich die Inferenzleistung stark unterscheiden.
Gleiches gilt beim Vergleich von GPUs und lokalen KI-Rechnern: Das Modell einzupassen löst das Kapazitätsproblem – nicht automatisch das Geschwindigkeitsproblem.
Für LLM-Inferenz müssen Rechenleistung, Speicherkapazität, Speicherbandbreite und Interconnect-Geschwindigkeit gemeinsam betrachtet werden.
Bei so vielen Inferenztechniken ist es entscheidend, zuerst zu identifizieren, was dein System tatsächlich limitiert.
Ein Modell, das nicht in den VRAM passt, braucht eine andere Optimierung als ein Server mit hoher Latenz oder geringem Durchsatz.
|
Problem / Szenario |
Geeignete Techniken |
|
Modell passt nicht in den VRAM |
Quantisierung, CPU-Offloading, Tensor-/Pipeline-Parallelismus |
|
Hohe TTFT / langsames Prefill |
Prefix Caching, Tuning von Chunked Prefill, optimierte Attention |
|
Langsame Token-Generierung |
Spekulatives Decoding, optimierte Kernel, geringere Präzision |
|
Niedriger Durchsatz / hohe Parallelität |
Kontinuierliches Batching, Request-Scheduling, Daten-Parallelismus |
|
KV-Cache-Druck auf den Speicher |
KV-Cache-Quantisierung, Paging, Offloading, reduzierter Kontext/Parallelität |
|
Long-Context-Workloads |
Chunked Prefill, Kontext-Parallelismus, KV-Cache-Optimierung |
|
Große MoE-Modelle |
Expert-Parallelismus, Expert:innen-Platzierung, Lastverteilung, optimierte MoE-Kernels |
|
Wiederholte oder geteilte Prompts |
Prefix Caching, prefix-bewusstes Routing |
|
Lokal / limitierte Hardware |
Quantisierung, llama.cpp/GGUF, MLX auf Apple Silicon |
|
Großskaliges Production-Serving |
vLLM, SGLang, TensorRT-LLM, verteilte Inferenz, Disaggregation von Prefill/Decode |
Wichtig ist: Es gibt nicht die eine beste Optimierung.
Starte mit Messungen wie TTFT, Token-Generationsgeschwindigkeit, Durchsatz, GPU-Auslastung und Speicherverbrauch. Setze dann die Technik ein, die den tatsächlichen Engpass adressiert, und benchmarke erneut.
Quantisierung hilft z. B. bei knappen Speichern, kontinuierliches Batching steigert den Durchsatz, Prefix Caching reduziert wiederholte Prefill-Arbeit, und spekulatives Decoding beschleunigt die Generierung, wenn Folgetokens gut vorhersagbar sind.
Das Ziel ist nicht, einfach nur Tokens pro Sekunde zu maximieren, sondern die beste Balance aus Latenz, Durchsatz, Speicherverbrauch, Modellqualität, Hardware und Kosten zu finden.
Ein LLM lokal zu starten und mit llama.cpp eine Antwort zu erhalten, ist ein super Einstieg – das heißt aber nicht, dass du bereits ein effizientes Inferenzsystem gebaut hast.
Für persönliche Projekte, Experimente und kleinere Workloads reicht ein einfaches lokales Setup meist aus.
Sobald du jedoch viele Nutzer:innen bedienst, lange Kontexte verarbeitest oder komplexe Coding- und Agenten-Systeme baust, ändern sich die Anforderungen schnell.
Du brauchst einen Inferenz-Stack, der viele Anfragen gleichzeitig bewältigt, eine gute Generationsgeschwindigkeit hält, Speicher effizient managt und reaktionsfähig bleibt – auch bei anspruchsvolleren Workloads.
Hier werden Konzepte wie kontinuierliches Batching, Prefix Caching, KV-Cache-Management, Quantisierung, spekulatives Decoding, optimierte Kernel, Parallelismus und Request-Scheduling relevant.
Du solltest außerdem Metriken wie TTFT, Durchsatz, Latenz, Parallelität, GPU-Auslastung und Kosten pro Token verstehen, statt Performance nur an Tokens pro Sekunde zu messen.
Es gibt auch keine Universalkonfiguration für jedes Modell oder jede Workload. Was fürs Coden gut funktioniert, bringt beim Reasoning nicht zwingend denselben Effekt.
Eine Optimierung, die den Durchsatz verbessert, kann die Latenz erhöhen. Quantisierung kann den Speicherbedarf deutlich senken, aber zu aggressive Quantisierung kann die Modellqualität beeinträchtigen.
Gute LLM-Inferenz-Engineers finden letztlich die richtige Balance: vorhandene Hardware optimal nutzen und Geschwindigkeit, Speicher, Durchsatz, Latenz, Modellqualität und Kosten austarieren.
Darum lohnt es sich, Inferenz zu verstehen. Statt dich auf Default-Einstellungen zu verlassen oder einfach mehr GPUs hinzuzufügen, erkennst du Engpässe, wählst die passende Optimierung und baust ein Serving-System, das wirklich zu deiner Workload passt.
Mehr zur LLM-Inferenz findest du in unserem Webinar Understanding LLM Inference.
Top-DataCamp-Kurse
Kurs
Lernpfad
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Zoumana Keita
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Stephen Gruppetta
12 Min.