Cours
Modèles Transformer avec PyTorch
2 h
9.2K
L’inférence des grands modèles de langage (LLM) est en train de devenir un art à part entière.
Les entreprises recherchent de plus en plus des ingénieurs en inférence LLM et en MLOps capables de servir les modèles plus vite, avec moins de ressources matérielles, et à moindre coût.
Que vous exécutiez des modèles en local, déployiez un serveur d’inférence ou expérimentiez des LLM open source, comprendre le fonctionnement de l’inférence peut faire toute la différence.
Derrière une inférence LLM efficace se cache tout un empilement de techniques, dont la quantification, l’optimisation du KV‑cache, le continuous batching, des noyaux d’attention optimisés, le décodage spéculatif et des réglages adaptés au matériel.
Beaucoup de frameworks d’inférence modernes activent automatiquement une partie de ces optimisations : vous en profitez peut‑être déjà sans forcément savoir ce qui se passe sous le capot.
Dans ce guide, j’explore les fondamentaux de l’inférence LLM, les métriques de performance clés, les frameworks de serving les plus utilisés, et des techniques concrètes pour rendre les modèles plus rapides, plus économes en mémoire et moins coûteux à exécuter.
Commençons par l’essentiel : ce qu’est l’inférence, comment elle fonctionne, comment on mesure la performance, et pourquoi l’architecture du modèle compte.
L’inférence LLM se produit chaque fois que vous envoyez un prompt à un modèle de langage et attendez une réponse. Le modèle traite l’entrée à travers ses couches puis génère la sortie, token par token.
C’est différent de l’entraînement. Pendant l’entraînement, le modèle apprend à partir des données et met à jour ses poids. En inférence, ces poids sont figés et le modèle entraîné est simplement utilisé pour produire des prédictions.
C’est en production, lors de l’inférence, que se concentre la majeure partie du coût de calcul des LLM.
Un modèle peut n’être entraîné qu’une seule fois, mais répondre à des millions de requêtes. L’efficacité de l’inférence est donc l’un des sujets d’ingénierie les plus déterminants en IA appliquée aujourd’hui.
Comprendre techniquement comment fonctionne l’inférence est essentiel, car les goulets d’étranglement ne sont pas toujours évidents.
Un matériel plus puissant ne signifie pas toujours des réponses plus rapides. Des modèles plus grands ne sont pas systématiquement plus lents. L’architecture du modèle, la longueur de l’entrée, la taille de lot (batch size) et l’infrastructure de serving interagissent de manières qu’il faut comprendre avant d’optimiser.
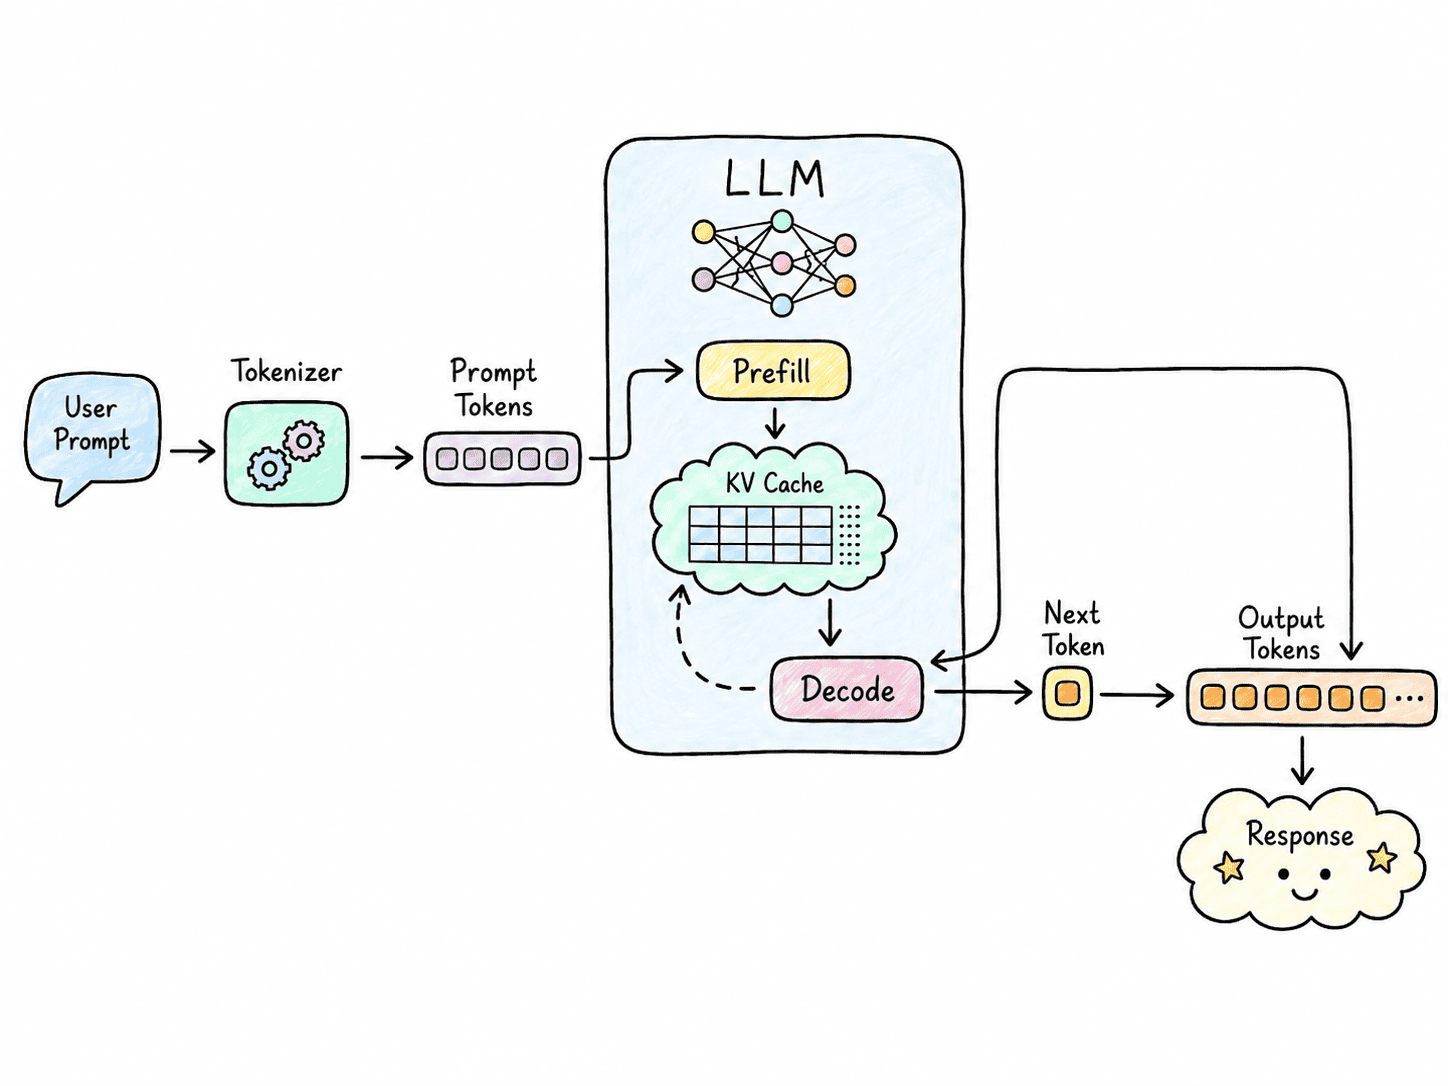
Pour la plupart des LLM de type décodeur, l’inférence comporte deux phases principales : prefill et decode.
Avec de petits batches, le décodage est souvent limité davantage par la bande passante mémoire que par la puissance de calcul brute du GPU, car il faut sans cesse relire en mémoire les poids du modèle et les états d’attention mis en cache.
Cette distinction est importante, car une optimisation qui accélère le prefill n’accélère pas forcément le décodage.
Il n’existe pas une métrique unique qui indique si un serveur d’inférence est rapide, efficace ou économique. Ces indicateurs aident à repérer les goulots d’étranglement, comparer des configurations de serving et vérifier si une optimisation améliore réellement la performance.
Parmi les plus importantes :
Le taux de hit du cache est particulièrement important en production. Les systèmes agents réutilisent souvent de grands prompts système, des définitions d’outils, des préfixes de conversation ou des documents.
Si 95 % (ou plus) de ces entrées peuvent être servies depuis le cache, on réduit fortement les calculs de prefill répétés, ce qui améliore la latence et diminue le coût effectif de ces requêtes.
Ces métriques sont étroitement liées.
Des batches plus grands et une concurrence plus élevée peuvent améliorer le débit et l’utilisation GPU, mais au prix d’une latence accrue pour chaque utilisateur.
De même, réduire la précision peut diminuer l’usage mémoire et les exigences matérielles, sans pour autant accélérer la génération si le matériel ne dispose pas de noyaux optimisés pour ce format.
L’objectif n’est donc pas d’optimiser une seule métrique, mais de trouver le bon équilibre entre latence, débit, utilisation et coût pour votre charge de travail.
Les performances d’inférence dépendent fortement de l’architecture du modèle lui‑même.
Un transformer dense utilise pratiquement tous ses paramètres pour chaque token. Un modèle Mixture‑of‑Experts (MoE), au contraire, contient de nombreux experts mais n’en active qu’un petit sous‑ensemble pour chaque token.
Cela réduit le calcul par token, mais introduit des défis comme le routage vers les experts, l’équilibrage de charge, la communication entre GPU et le placement des experts.
L’architecture d’attention a aussi un effet majeur sur l’usage mémoire et la vitesse d’inférence.
L’attention multi‑têtes (MHA) traditionnelle stocke des représentations clés et valeurs distinctes pour chaque tête, ce qui peut rendre le KV‑cache volumineux.
Multi‑Query Attention (MQA) réduit ce besoin mémoire en autorisant plusieurs têtes de requête à partager les mêmes clés et valeurs.
Grouped‑Query Attention (GQA) se situe entre les deux, avec des groupes de têtes partageant les représentations clé‑valeur. Des architectures plus récentes peuvent utiliser des techniques comme la Multi‑head Latent Attention (MLA), qui compresse encore davantage ces représentations.
C’est pourquoi deux modèles de taille (nombre de paramètres) similaire peuvent se comporter très différemment en inférence.
Leur architecture influe fortement sur les besoins en calcul, la taille du KV‑cache, l’usage mémoire et la vitesse de génération.
Passons aux frameworks les plus utilisés pour exécuter des LLM, des environnements locaux aux systèmes de production à grande échelle.
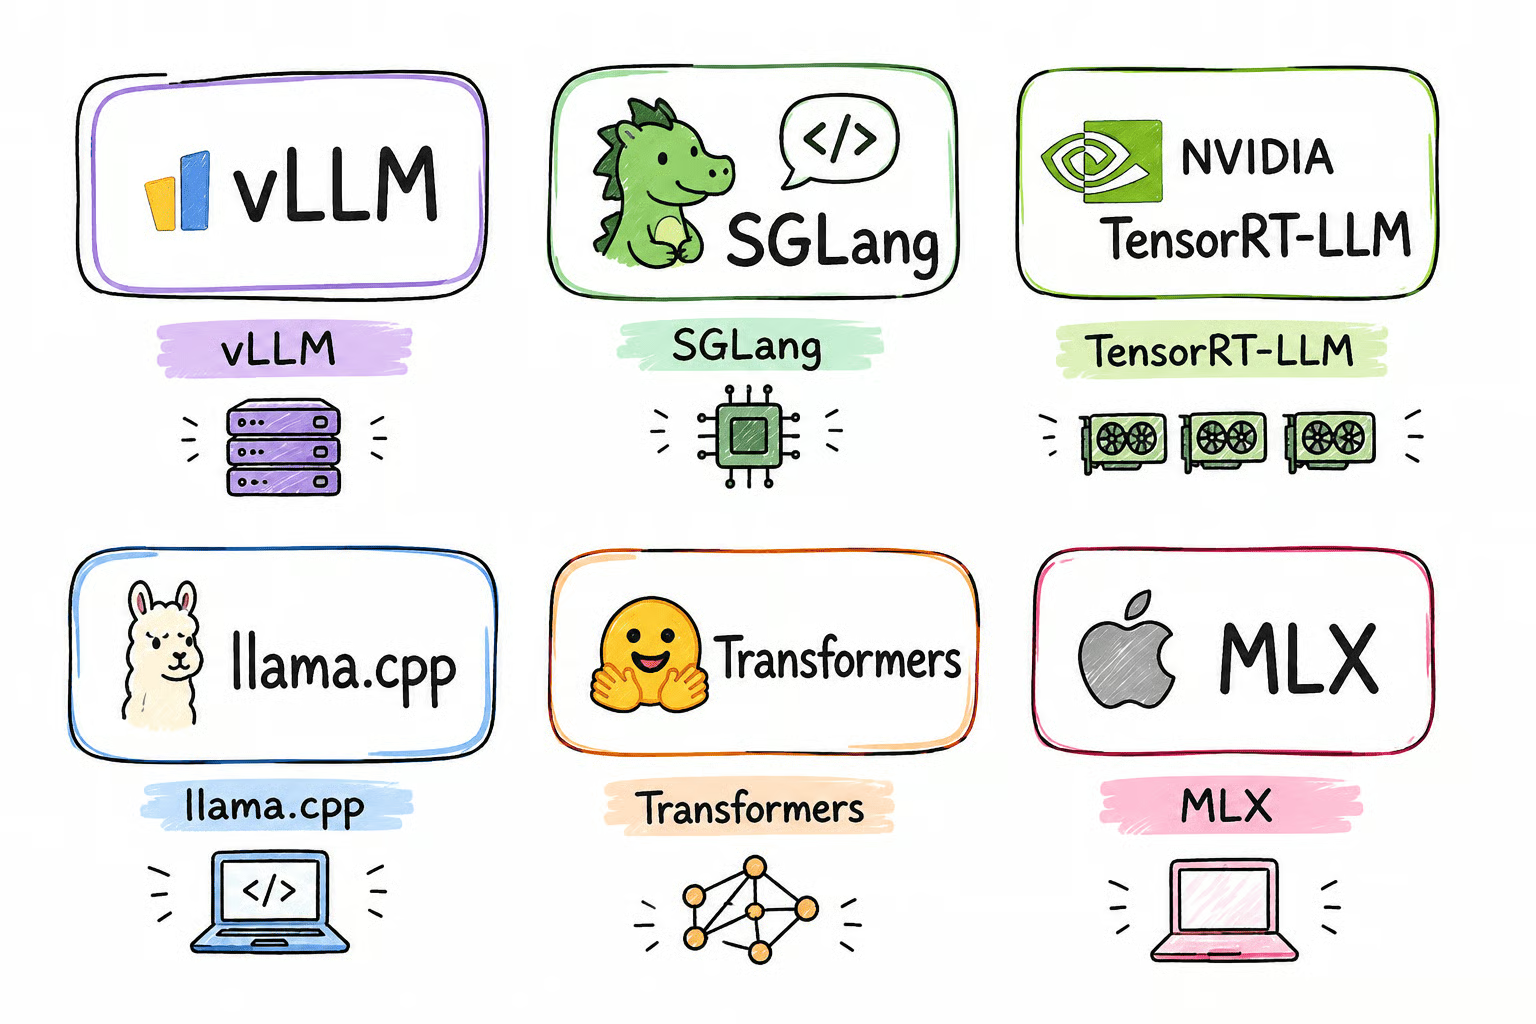
vLLM est l’un des moteurs d’inférence généralistes les plus utilisés. Il prend en charge le continuous batching, PagedAttention, le prefill par segments, le cache de préfixes, la quantification, le décodage spéculatif, des noyaux d’attention optimisés et l’inférence distribuée.
SGLang se concentre sur la génération haute performance et un ordonnancement efficace des requêtes. Il est particulièrement utile pour les agents, les modèles de raisonnement, les contextes répétés, les sorties structurées et d’autres charges de génération complexes.
TensorRT‑LLM est la pile d’inférence optimisée de NVIDIA. Elle exploite les fonctionnalités des GPU NVIDIA, des noyaux CUDA spécialisés, des formats basse précision, l’exécution distribuée, le KV‑cache et un batching avancé.
llama.cpp est particulièrement adapté à l’inférence locale et sous contrainte de ressources. Il prend en charge la quantification GGUF, l’inférence hybride CPU‑GPU et les fichiers de modèles mappés en mémoire, permettant de répartir les poids entre la VRAM, la RAM système et, si nécessaire, un stockage sur disque.
On peut ainsi exécuter des modèles bien plus grands que la VRAM disponible, même si s’appuyer fortement sur le disque dégrade sensiblement les performances.
MLX est un framework d’inférence et de machine learning conçu pour Apple Silicon. Il tire parti de l’architecture mémoire unifiée des Mac, ce qui en fait une option pratique pour exécuter et expérimenter des LLM en local sur les appareils de la série M.
De la quantification au décodage spéculatif, cette section couvre les techniques qui rendent l’inférence plus rapide, moins coûteuse et plus économe en mémoire.
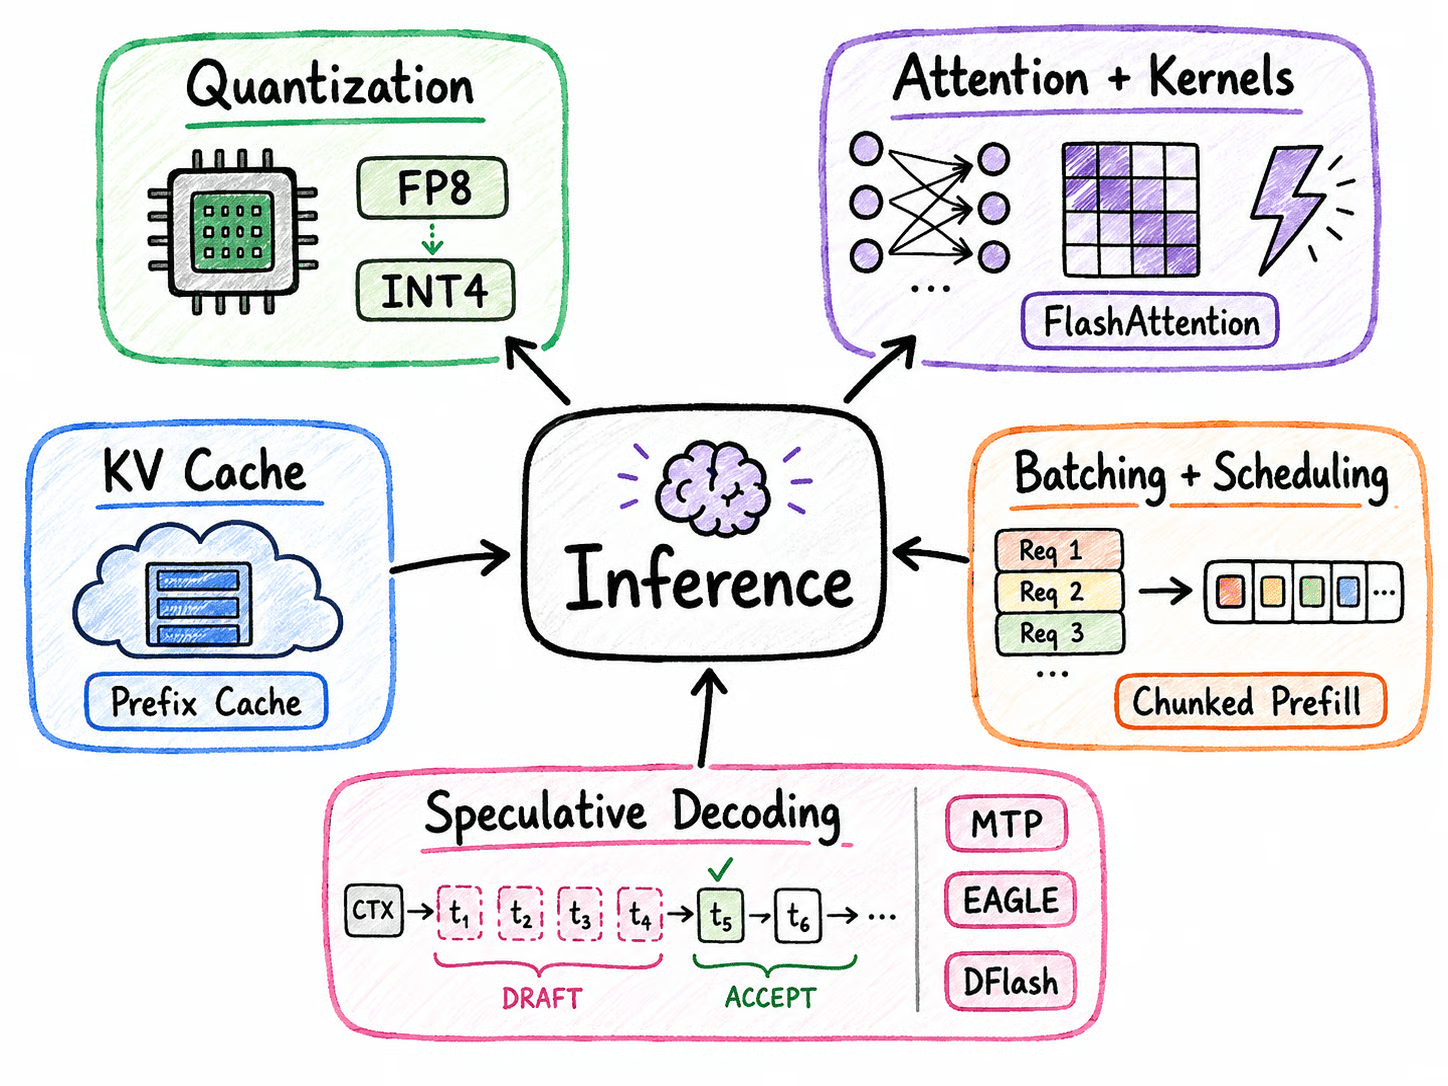
L’une des optimisations d’inférence les plus répandues est la quantification.
Les modèles sont souvent entraînés en précision BF16 ou FP16.
La quantification représente les poids, activations ou caches avec des formats numériques plus petits.
Formats et approches courants :
Réduire la précision diminue la consommation mémoire et peut alléger la pression sur la bande passante mémoire.
Cependant, plus petit ne rime pas automatiquement avec plus rapide. Les performances dépendent fortement de la disponibilité de noyaux efficaces pour cette précision sur le matériel cible.
Le KV‑cache peut aussi être quantifié, ce qui devient crucial pour le long contexte et le serving à forte concurrence.
L’attention est l’une des opérations majeures d’un transformer. Elle permet au modèle d’identifier les tokens du contexte les plus pertinents pour générer le token suivant.
Mais l’attention peut devenir coûteuse en calcul, surtout quand la fenêtre de contexte s’allonge.
C’est là que les noyaux optimisés prennent toute leur importance. Un noyau est un code hautement optimisé qui réalise une opération mathématique précise sur un matériel comme un GPU. Sans changer le fonctionnement du modèle, ces noyaux accélèrent les mêmes calculs et utilisent mieux la mémoire.
Un bon exemple est FlashAttention. L’attention traditionnelle passe beaucoup de temps à déplacer de gros intermédiaires entre la mémoire GPU et les unités de calcul.
FlashAttention réduit cette surcharge en traitant l’attention par blocs plus petits et en gardant davantage de calculs au plus près du GPU.
Les moteurs d’inférence modernes combinent plusieurs optimisations de ce type, notamment :
L’idée clé : ces techniques ne changent pas le modèle ni sa qualité de sortie. Elles optimisent la façon d’exécuter les calculs, pour générer plus vite et mieux exploiter le matériel disponible.
Pendant la génération, les transformers stockent les clés et valeurs des tokens précédents dans le KV‑cache.
Sans ce cache, le modèle devrait recalculer les tokens passés à chaque nouveau token généré.
L’inconvénient, c’est la consommation mémoire. Les longs contextes et de nombreux utilisateurs simultanés peuvent amener le KV‑cache à occuper une large part de la mémoire GPU.
Plusieurs techniques répondent à ce problème.
PagedAttention segmente la mémoire du KV‑cache en blocs gérables au lieu d’exiger de grandes zones contiguës.
Le cache de préfixes permet aux requêtes partageant un même préfixe de réutiliser des états KV déjà calculés. C’est particulièrement utile pour les prompts système communs, les agents et les contextes documentaires répétés.
Autres approches :
À grande échelle, la gestion du KV‑cache peut être tout aussi cruciale que l’optimisation des poids du modèle.
Quand un serveur d’inférence reçoit de nombreuses requêtes en même temps, il essaie de les traiter ensemble pour garder le GPU occupé. C’est le batching.
Le problème : les requêtes LLM finissent rarement en même temps.
Un utilisateur peut générer 50 tokens quand un autre en produit 2 000.
Avec un batching traditionnel, les requêtes courtes peuvent attendre la fin de la plus longue du lot.
Le continuous batching résout ce point en retirant les requêtes terminées et en les remplaçant immédiatement par de nouvelles. Le GPU reste actif au lieu de laisser des capacités inutilisées.
Autre technique utile : le prefill par segments. Plutôt que de traiter un très long prompt d’un seul bloc, le serveur le découpe en morceaux pour ne pas bloquer les requêtes déjà en génération.
Avec la montée du trafic, l’inférence devient un problème d’ordonnancement. Le serveur doit choisir quelles requêtes traiter, comment les grouper, et comment équilibrer mémoire GPU, longueur de séquence, débit et latence.
Le décodage auto‑régresseur classique génère les tokens un par un ; la génération est donc intrinsèquement séquentielle.
Le décodage spéculatif cherche à desserrer ce verrou en générant à moindre coût plusieurs tokens candidats, puis en laissant le modèle cible complet les vérifier en parallèle.
Si plusieurs candidats sont acceptés, la génération peut avancer de plusieurs tokens à la fois sans changer la distribution de sortie du modèle cible.
Plusieurs approches déclinent cette idée :
Le principe est simple :
générer à bas coût plusieurs tokens futurs probables, puis les vérifier efficacement avec le grand modèle.
Le décodage spéculatif est particulièrement efficace quand les prochains tokens sont relativement prévisibles et que le taux d’acceptation est élevé.
Il est donc très utile pour le code et d’autres tâches séquentielles, où même un petit modèle peut souvent bien anticiper la suite.
Pour le raisonnement complexe ou des générations très imprévisibles, moins de tokens brouillons sont acceptés, réduisant le gain de performance.
À mesure que les modèles et les charges grandissent, la mémoire devient une contrainte majeure. Voyons l’offloading, l’inférence multi‑GPU, le serving désagrégé et l’optimisation du long contexte.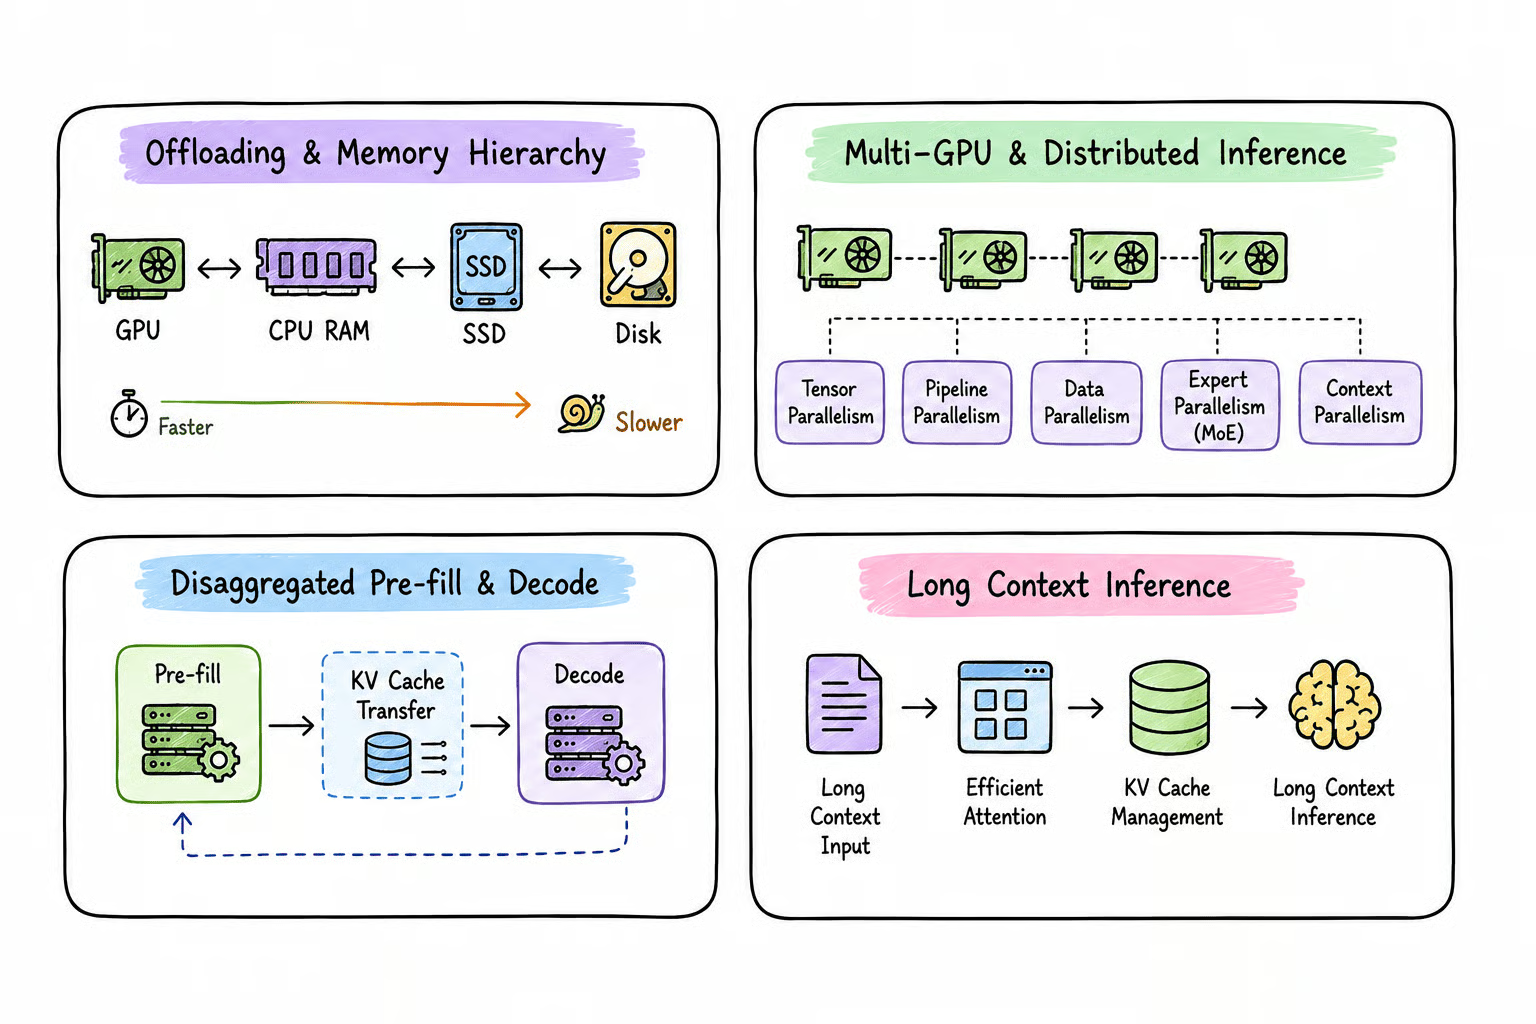
Parfois, l’objectif n’est pas la vitesse maximale, mais simplement de faire tourner un modèle sur le matériel disponible.
Les systèmes d’inférence peuvent exploiter différents niveaux de mémoire :
GPU HBM → RAM CPU → stockage NVMe
La mémoire GPU est la plus rapide mais aussi la plus limitée.
La mémoire CPU offre plus de capacité à moindre vitesse, tandis que le stockage NVMe apporte encore plus d’espace mais bien plus lentement.
Si un modèle ou son KV‑cache ne tient pas entièrement en VRAM, les moteurs d’inférence peuvent déplacer une partie de la charge ailleurs, via :
On augmente ainsi la mémoire disponible, généralement au prix d’une baisse de performance, car les données doivent transiter entre des couches mémoires plus lentes, souvent via le PCIe.
Le compromis est simple : plus les données s’éloignent de la mémoire GPU, plus on gagne en capacité, mais plus l’inférence tend à ralentir.
Les modèles très grands nécessitent souvent plusieurs accélérateurs.
Parmi les stratégies les plus courantes :
Dès que l’inférence s’étend sur plusieurs GPU, la communication devient un goulot d’étranglement important.
Des technologies comme NVLink, NVSwitch et des réseaux haut débit peuvent donc avoir un impact substantiel.
Le prefill et le decode se comportent très différemment en inférence. Le prefill est généralement intensif en calcul, puisqu’il traite de nombreux tokens en parallèle, tandis que le decode est souvent limité par la bande passante mémoire, car il génère les tokens un à un.
Plutôt que de faire concurrencer ces deux étapes sur les mêmes GPU, les grands systèmes de serving peuvent les séparer :
Prompt → worker prefill → transfert du KV‑cache → worker decode → réponse
Les workers prefill traitent le prompt et construisent le KV‑cache, ensuite transféré à des workers decode dédiés qui génèrent la réponse. Chaque étape peut ainsi utiliser des matériels, batchings et stratégies de parallélisme différents.
L’avantage majeur : prefill et decode peuvent être optimisés et mis à l’échelle indépendamment, ce qui aide à maîtriser le TTFT et l’ITL, notamment pour les prompts longs et les charges à fort trafic.
Les grandes fenêtres de contexte posent d’autres défis. Quand l’entrée s’allonge, le prefill demande plus de calcul, tandis que le KV‑cache grossit, consomme plus de mémoire GPU et rend le décodage plus coûteux.
Plusieurs techniques aident :
Point crucial : prendre en charge une fenêtre de contexte d’un million de tokens ne signifie pas que la servir est rapide, économique ou pratique.
Des contextes plus longs augmentent l’usage mémoire, le TTFT et le coût global d’inférence.
Tous les modèles ne se comportent pas de la même manière en inférence : voyons les défis spécifiques des modèles MoE, de la génération structurée et des charges de raisonnement.
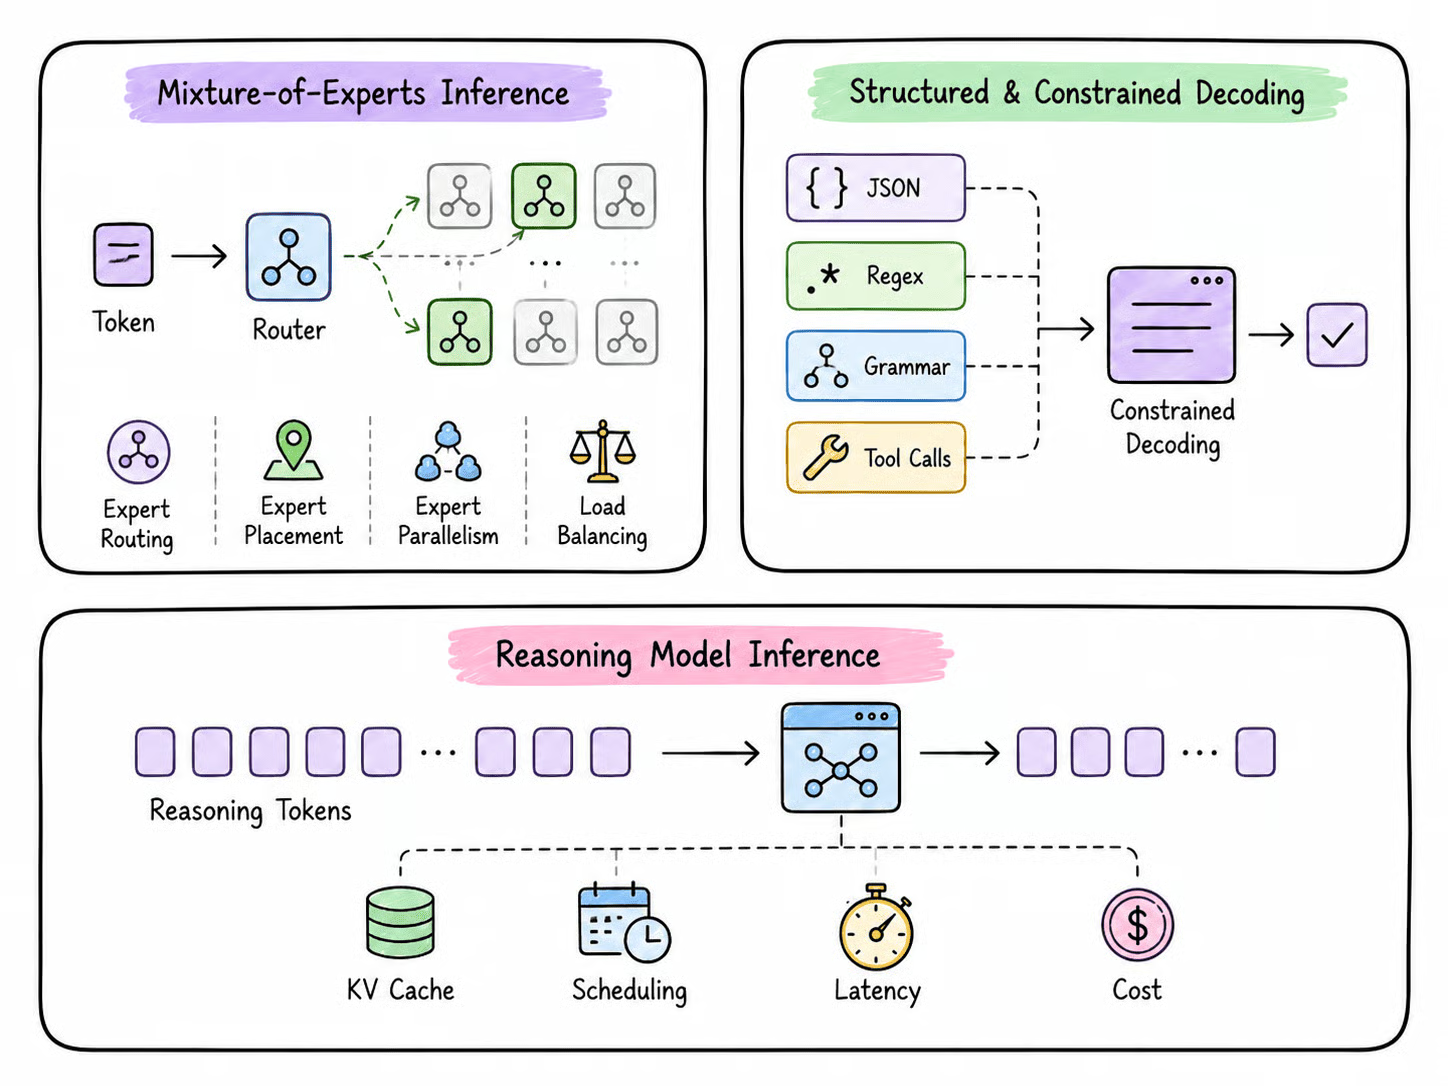
Les modèles Mixture‑of‑Experts (MoE) diffèrent des modèles denses. Au lieu d’utiliser tous les paramètres pour chaque token, un routeur ne sélectionne qu’un petit nombre d’experts pour traiter chaque token.
Cela réduit le calcul, mais l’ensemble des experts doit malgré tout être stocké quelque part sur l’infrastructure de serving.
L’inférence MoE efficace dépend donc de :
À grande échelle, la communication peut devenir le principal verrou, d’où l’intérêt de technologies comme DeepEP, qui fournit des noyaux spécialisés à haut débit et faible latence pour déplacer les tokens entre experts.
La distinction clé : les paramètres totaux déterminent la capacité à stocker le modèle, tandis que les paramètres actifs reflètent mieux la quantité de calcul par token.
Les applications LLM modernes ont souvent besoin d’autre chose que de texte libre. Les agents, par exemple, doivent parfois générer un JSON valide, des arguments d’outils, du SQL ou des réponses suivant un schéma prédéfini.
Le décodage contraint contrôle les tokens autorisés à chaque étape, afin que la sortie respecte la structure requise. Les moteurs d’inférence modernes comme vLLM gèrent des contraintes telles que :
C’est généralement plus fiable que de générer du texte libre puis de le corriger après coup. Toutefois, le décodage contraint garantit la structure, pas nécessairement l’exactitude des informations qu’elle contient.
Les modèles de raisonnement créent une charge d’inférence très différente, car ils peuvent générer des milliers de tokens intermédiaires de raisonnement avant la réponse finale.
Contrairement aux charges « long contexte », où l’essentiel du coût vient parfois d’une entrée massive, les charges de raisonnement restent coûteuses tout au long de la génération, car la phase de décodage elle‑même s’allonge fortement.
De longs tracés de raisonnement impactent :
Autre difficulté : la longueur du raisonnement est souvent imprévisible.
Une requête peut se terminer vite, quand une autre enchaîne des milliers de tokens. Cela complique le batching, l’ordonnancement et l’allocation du KV‑cache quand on sert de nombreux utilisateurs simultanément.
En conséquence, servir un chatbot qui génère quelques centaines de tokens et un modèle de raisonnement qui peut en générer 10 000 nécessite des stratégies d’inférence, mémoire et ordonnancement très différentes.
L’optimisation logicielle n’est qu’une partie de l’équation. Le matériel sous‑jacent influe tout autant sur la vitesse, la capacité mémoire, l’évolutivité et le coût.
Caractéristiques matérielles importantes :
Un concept utile pour comprendre les performances matérielles est l’intensité arithmétique, qui décrit la quantité de calcul par rapport à la quantité de données déplacées. Les charges à forte intensité arithmétique sont plutôt limitées par le calcul, tandis que celles à faible intensité le sont souvent par la bande passante mémoire.
Pendant le prefill, de nombreux tokens du prompt peuvent être traités en parallèle, ce qui permet de mieux exploiter les ressources de calcul. En decode, en revanche, les tokens sont générés séquentiellement et le système accède sans cesse aux poids et au KV‑cache. La bande passante mémoire est alors déterminante pour la vitesse de génération.
C’est pourquoi capacité mémoire et bande passante mémoire sont deux choses distinctes. Par exemple, un NVIDIA DGX Spark et un système Apple M4 Max offrent tous deux jusqu’à 128 Go de mémoire unifiée. Mais le DGX Spark fournit 273 Go/s de bande passante mémoire, contre 546 Go/s pour le M4 Max. Ainsi, même si les deux peuvent charger le même grand modèle, leurs performances d’inférence peuvent diverger fortement.
Le même principe vaut en comparant GPU et machines locales d’IA : faire tenir le modèle règle le problème de capacité, pas nécessairement celui de vitesse.
Pour l’inférence LLM, il faut considérer ensemble performances de calcul, capacité mémoire, bande passante mémoire et vitesse des interconnexions.
Face à la profusion de techniques, la priorité est d’identifier d’abord ce qui limite réellement votre système.
Un modèle qui ne tient pas en VRAM n’appelle pas les mêmes optimisations qu’un serveur pénalisé par une forte latence ou un faible débit.
|
Problème / scénario |
Techniques à envisager |
|
Le modèle ne tient pas en VRAM |
Quantification, offloading CPU, parallélisme tenseur/pipeline |
|
TTFT élevé / prefill lent |
Cache de préfixes, réglage du prefill par segments, attention optimisée |
|
Génération de tokens lente |
Décodage spéculatif, noyaux optimisés, précision réduite |
|
Faible débit / forte concurrence |
Continuous batching, ordonnancement des requêtes, parallélisme de données |
|
Pression mémoire du KV‑cache |
Quantification du KV‑cache, paging, offloading, contexte/concurrence réduits |
|
Charges long contexte |
Prefill par segments, parallélisme de contexte, optimisation du KV‑cache |
|
Grands modèles MoE |
Parallélisme d’experts, placement des experts, équilibrage de charge, noyaux MoE optimisés |
|
Prompts répétés ou partagés |
Cache de préfixes, routage sensible au préfixe |
|
Local / matériel limité |
Quantification, llama.cpp/GGUF, MLX sur Apple Silicon |
|
Serving de production à grande échelle |
vLLM, SGLang, TensorRT‑LLM, inférence distribuée, désagrégation prefill/decode |
Retenez qu’il n’existe pas d’optimisation universelle.
Commencez par mesurer TTFT, vitesse de génération, débit, utilisation GPU et usage mémoire. Appliquez ensuite la technique ciblant le véritable goulot d’étranglement, puis re‑benchmarkez.
Par exemple : la quantification aide quand la mémoire limite, le continuous batching améliore le débit, le cache de préfixes réduit le travail de prefill répété, et le décodage spéculatif accélère la génération quand les tokens futurs sont prévisibles.
Le but n’est pas seulement de maximiser les tokens par seconde, mais de trouver le meilleur compromis entre latence, débit, usage mémoire, qualité du modèle, matériel et coût.
Faire tourner un LLM en local et obtenir une réponse via llama.cpp est un excellent départ, mais cela ne signifie pas pour autant que vous avez bâti un système d’inférence efficace.
Pour des projets personnels, de l’expérimentation et de petites charges, une configuration locale simple peut suffire.
Mais dès que vous servez de nombreux utilisateurs, gérez de longs contextes, ou construisez des systèmes d’agent et de code complexes, les exigences évoluent rapidement.
Il vous faut une pile d’inférence capable de traiter de nombreuses requêtes en parallèle, de maintenir une bonne vitesse de génération, de gérer la mémoire efficacement et de rester réactive malgré la montée en charge.
C’est là que des notions comme le continuous batching, le cache de préfixes, la gestion du KV‑cache, la quantification, le décodage spéculatif, des noyaux optimisés, le parallélisme et l’ordonnancement des requêtes deviennent clés.
Vous devez aussi comprendre des métriques comme le TTFT, le débit, la latence, la concurrence, l’utilisation GPU et le coût par token, plutôt que de juger la performance uniquement aux tokens par seconde.
Il n’existe pas non plus de configuration universelle valable pour tous les modèles ou charges. Une technique efficace pour le code n’apportera pas forcément le même bénéfice au raisonnement.
Une optimisation qui augmente le débit peut accroître la latence. La quantification peut réduire fortement les besoins mémoire, mais une quantification trop agressive peut aussi dégrader la qualité du modèle.
Au final, bien concevoir l’inférence LLM, c’est une question d’équilibre : tirer le meilleur parti du matériel existant en arbitrant entre vitesse, mémoire, débit, latence, qualité du modèle et coût.
C’est pourquoi il est utile d’apprendre l’inférence. Plutôt que de se reposer sur les réglages par défaut ou d’ajouter des GPU, vous identifiez le goulet d’étranglement, choisissez la bonne optimisation et concevez un système de serving réellement adapté à votre charge.
Pour aller plus loin, nous vous recommandons notre webinaire « Understanding LLM Inference ».
Les meilleurs cours DataCamp
Cours
Cursus
Cours
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
blog
Tutoriel
Josef Waples
8 min
Tutoriel
Samuel Shaibu
9 min
Tutoriel