
Last chance! 50% off DataCamp Premium
Sale ends in
Sejak peluncuran ChatGPT pada November 2022, Chatbot LLM muncul sebagai fitur menonjol di berbagai kasus penggunaan.
Gagasan chatbot bukan hal baru. Kita semua pernah melihat chatbot yang tidak berguna di mana-mana yang harus dikonfigurasi begitu dalam hingga nyaris terskrip dengan aturan if-and-else. Menjaganya menjadi mimpi buruk, dan tidak membantu pengguna akhir; malah sebaliknya, membuat frustrasi pengguna.
Namun kini, pada 2024, Chatbot kembali, berkat Large Language Models (LLM).
Dalam blog ini, Anda akan mempelajari:
Anda juga dapat melihat kursus kami Vector Databases for Embeddings with Pinecone, dan code-along tentang Membangun Chatbot dengan OpenAI API dan Pinecone untuk mempelajari lebih lanjut.
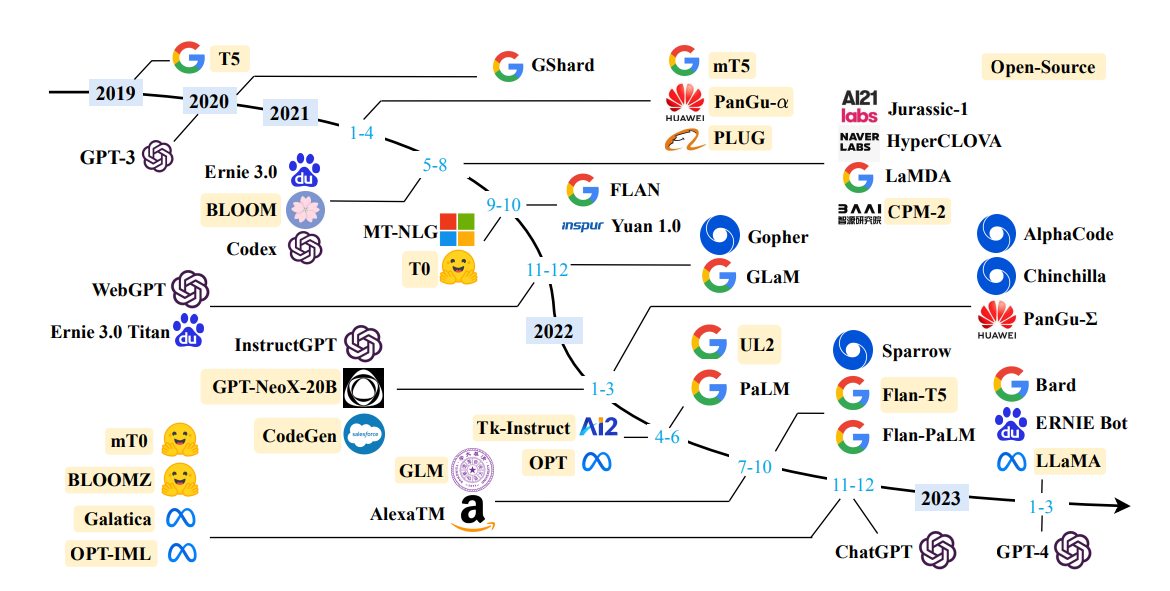
Large Language Models (LLM) seperti GPT-4 adalah algoritme machine learning tingkat lanjut yang memanfaatkan teknik deep learning, khususnya arsitektur transformer, untuk memahami dan menghasilkan bahasa alami.
Model ini dilatih pada dataset masif yang berisi triliunan kata dari berbagai teks di internet, seperti buku, artikel, situs web, dan repositori kode. Pelatihan ekstensif ini memungkinkan model melakukan beragam tugas kompleks terkait pemrosesan bahasa.
Salah satu fitur utama LLM adalah kemampuannya menghasilkan teks tentang hampir topik apa pun. Kemampuan ini mencakup berbagai gaya dan format, mulai dari penulisan kreatif hingga dokumentasi teknis.
LLM cakap dalam tugas seperti peringkasan, di mana model dapat merangkum dokumen panjang menjadi ringkasan singkat, dan AI percakapan, yang memungkinkan terjalinnya dialog yang alami dan lancar dengan pengguna. Model ini juga mahir menerjemahkan teks lintas bahasa, bahkan menangkap nuansa seperti slang dan dialek regional.
Namun, LLM bukan tanpa tantangan. Salah satu isu signifikan adalah LLM dapat "berhalusinasi" atau menghasilkan informasi yang masuk akal tetapi salah atau tidak logis, terutama saat menangani kueri di luar cakupan data latihannya atau prompt yang ambigu.
Masalah utama lainnya adalah potensi bias dalam keluaran LLM, yang berasal dari bias yang ada dalam data pelatihan atau yang diperkenalkan selama pengembangan model.
LLM merepresentasikan lompatan besar dalam AI, menawarkan potensi besar untuk inovasi dan efisiensi di berbagai bidang, namun juga memerlukan pengelolaan yang cermat untuk mengurangi risiko seperti bias dan disinformasi.
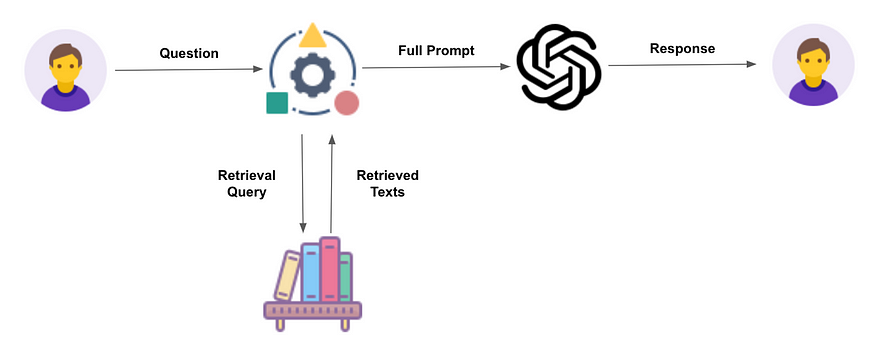
LLM, meski kuat, memiliki keterbatasan tertentu. Model dapat memberikan informasi yang usang, generik, atau bahkan salah jika kueri melampaui cakupan data latihannya.
Model juga dapat menghasilkan informasi yang keliru secara faktual atau tidak masuk akal yang disajikan seolah benar atau logis. Fenomena ini dikenal sebagai halusinasi.
RAG bertujuan mengurangi masalah ini dengan mengarahkan LLM untuk mengambil informasi relevan dari sumber yang telah ditentukan. Pendekatan ini meningkatkan kepercayaan pengguna karena keluaran model lebih akurat dan dapat ditelusuri ke sumber tepercaya.
Ini juga memberikan kontrol lebih kepada pengembang atas respons yang dihasilkan LLM, sehingga meningkatkan kualitas dan kegunaan sistem secara keseluruhan.
Anda dapat mempelajari lebih lanjut tentang retrieval augmented generation di tutorial terpisah kami. Namun, di bawah ini kami uraikan langkah-langkah utama prosesnya.
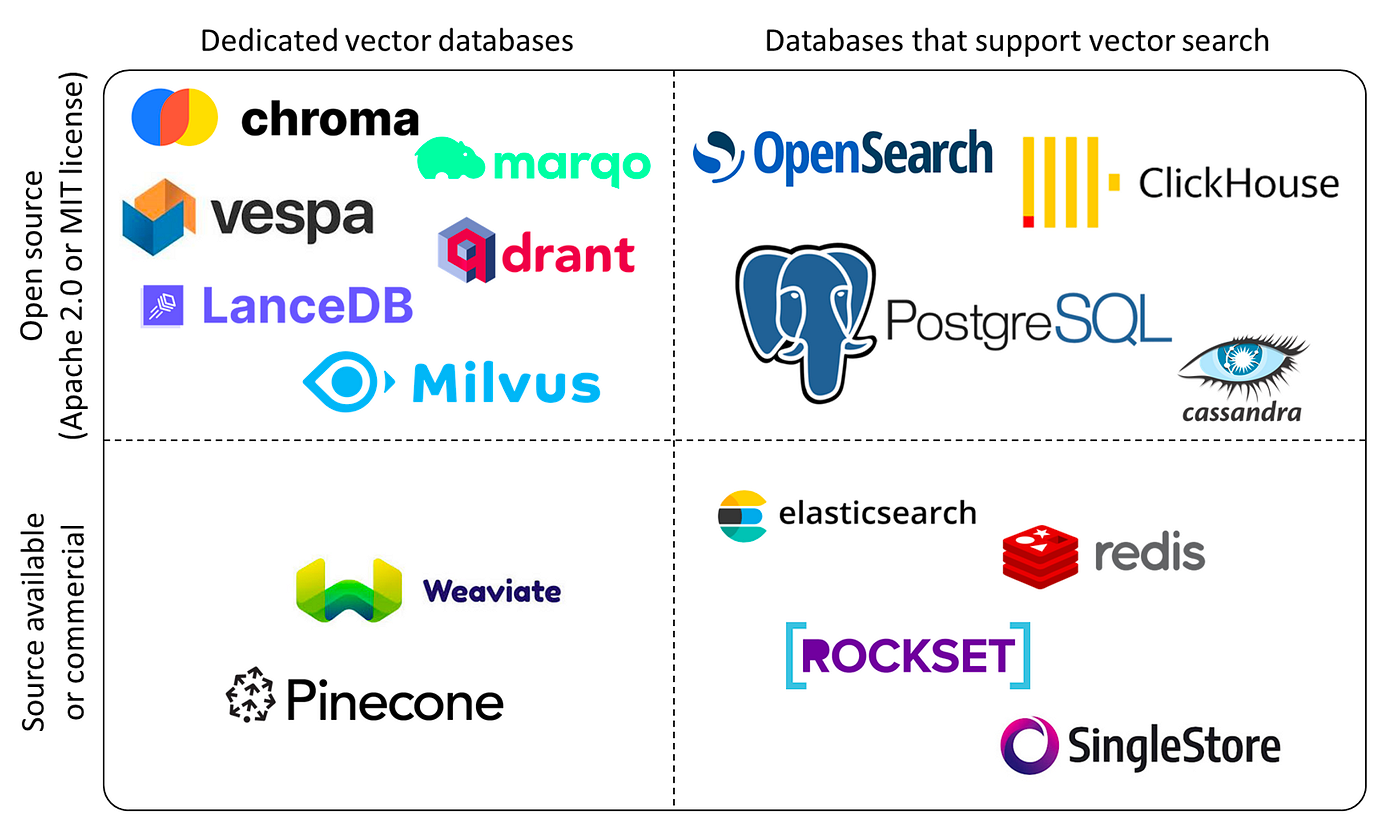
Basis data vektor adalah jenis basis data khusus yang dirancang untuk menangani vektor berdimensi tinggi, yang merupakan representasi matematis dari atribut atau fitur data. Vektor ini dapat berkisar dari puluhan hingga ribuan dimensi, tergantung pada kompleksitas dan granularitas data.
Jenis basis data ini sangat andal dalam melakukan pencarian dan pengambilan berdasarkan kemiripan dengan cepat dan akurat, menggunakan jarak atau kesamaan vektor, sehingga memungkinkan pendekatan kueri data yang lebih semantik atau kontekstual alih-alih bergantung pada pencocokan persis tradisional atau kriteria yang telah ditentukan.
Secara praktis, basis data vektor dapat dimanfaatkan untuk berbagai tujuan. Misalnya, menemukan gambar yang mirip dengan sebuah gambar berdasarkan konten dan gaya visual, menemukan dokumen yang mirip dengan dokumen tertentu berdasarkan topik dan sentimen, atau mengidentifikasi produk yang mirip dengan produk tertentu berdasarkan fitur dan penilaiannya.
Proses kueri dalam basis data vektor melibatkan penggunaan vektor kueri yang merepresentasikan informasi atau kriteria yang diinginkan dan menerapkan ukuran kemiripan untuk menentukan kedekatan vektor dalam ruang vektor. Proses ini menghasilkan daftar peringkat vektor dengan skor kemiripan tinggi terhadap vektor kueri, sehingga memungkinkan akses ke data mentah yang terkait dengan setiap vektor.
Basis data vektor didukung oleh berbagai algoritme, seperti indeks k-nearest neighbor (k-NN) dan dibangun dengan metode seperti algoritme Hierarchical Navigable Small World (HNSW) dan Inverted File Index (IVF).
Basis data vektor merupakan bagian integral dari aplikasi retrieval augmented generation (RAG). Basis data ini menyediakan pencarian kemiripan yang efisien, perluasan konten, keberagaman, dan pengambilan data multimodal yang dinamis. Kapabilitas ini krusial dalam AI generatif, di mana akses ke dataset berskala besar dan beragam penting untuk mengurangi bias dan halusinasi pada model AI.
Pinecone adalah basis data vektor populer yang menonjol karena efisiensi dan kemudahan penggunaannya, khususnya dalam menangani skenario data berskala besar. Ini dirancang untuk pengembang dan data scientist yang ingin mengimplementasikan kemampuan pencarian vektor di berbagai aplikasi.
Pinecone menggunakan teknik pengindeksan canggih seperti product quantization dan locality-sensitive hashing, yang memungkinkan pencarian kemiripan yang efisien dan akurat dalam ruang vektor berdimensi tinggi. Hal ini membuatnya sangat berguna untuk aplikasi RAG. Anda dapat mempelajari lebih lanjut tentang menguasai basis data vektor dengan Pinecone di tutorial terpisah kami.
Dalam tutorial ini, kita akan menggunakan Pinecone sebagai basis data vektor.
Platform API OpenAI menyediakan akses ke semua model yang dilatih oleh OpenAI dan tersedia untuk publik. Ini mencakup GPT, DALL-E, Whisper, dan model lainnya.
API diakses melalui permintaan HTTP, sehingga Anda dapat mengintegrasikannya dengan bahasa pemrograman apa pun yang mendukung pembuatan permintaan HTTP. Namun, untuk Python, ada pustaka bernama openai yang dapat Anda pasang dengan pip install openai dan akan mempermudah bekerja dengan API ini.
Bekerja dengan OpenAI API di Python menggunakan pustaka openai hanya membutuhkan beberapa baris kode.
Contoh Python:
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)
LangChain adalah kerangka kerja untuk mengembangkan aplikasi yang didukung oleh model bahasa. Kerangka ini menyediakan tingkat abstraksi tertentu yang memudahkan dan mempercepat pengembangan prototipe sekaligus mempercepat transisi dari prototipe ke produksi. Pertumbuhan dan popularitas kerangka ini terlihat dari jumlah bintang di halaman Github mereka.
Ini adalah kerangka yang luar biasa. Namun, satu catatan kehati-hatian saat ini adalah kerangka ini masih belum stabil. API terus berubah dan ada kemungkinan saat Anda membaca kode di bagian berikutnya, kode tersebut sudah tidak berfungsi lagi. Ini wajar karena pustaka masih dalam tahap pre-release. Saat penulisan blog ini, versi terbaru LangChain adalah 0.1.4.
Agar dapat mengimplementasikan back-end RAG, kita memerlukan embedding dari data eksternal. Jika mulai dari data mentah, kita harus melakukan embedding menggunakan OpenAI embedding API atau embedding open-source lainnya.
Menyematkan data mentah cukup mudah. Namun, jika Anda menggunakan API OpenAI, Anda akan dikenai biaya per token.
Untuk tujuan tutorial ini, saya mereproduksi sebagian besar kode di bagian ini dari panduan resmi Pinecone tentang LangChain. Dokumentasi Pinecone sangat baik dan selalu mutakhir.
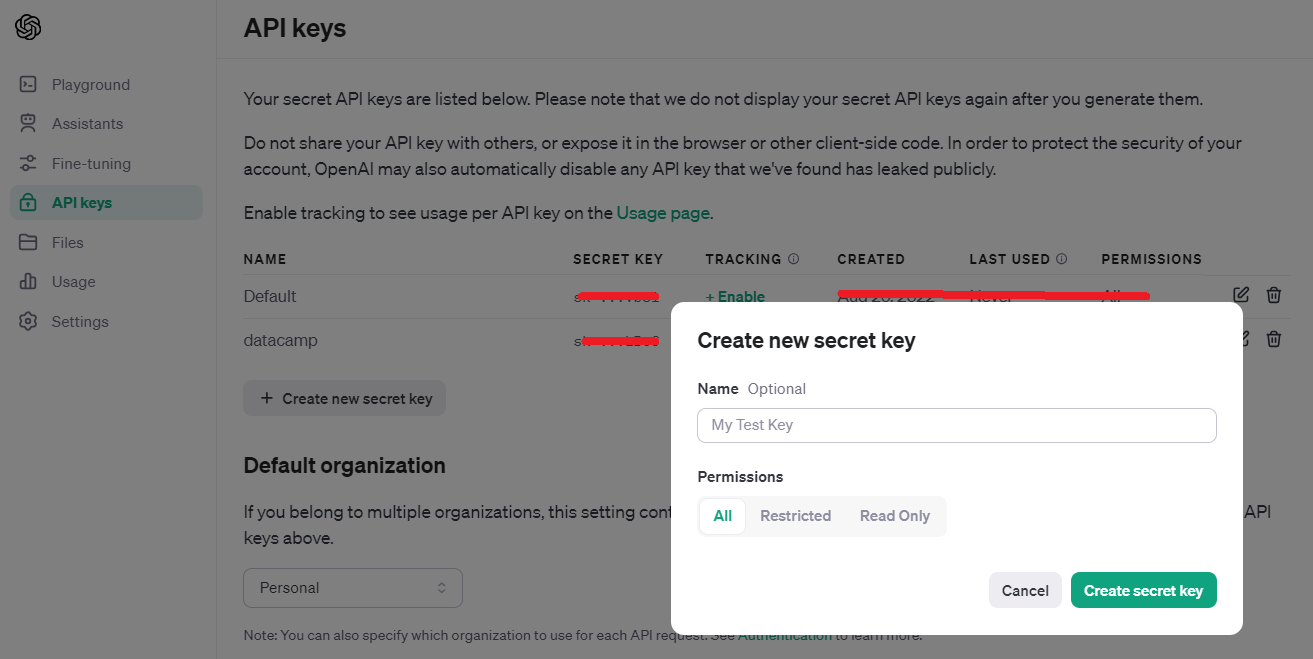
Setelah Anda mendaftar akun OpenAI, langsung menuju ke https://platform.openai.com/api-keys
Anda harus menyalin kunci saat Anda membuatnya karena tidak ada opsi untuk melihat atau menyalin kunci tersebut setelahnya.
Untuk Pinecone, masuk ke akun Anda dan klik API Keys. Anda dapat mengklik tombol `Click API Key` di pojok kanan.
Berbeda dengan OpenAI, pada Pinecone Anda tidak harus menyalin kunci API saat membuatnya karena ada ikon salin di kolom Actions yang dapat Anda gunakan kapan saja.
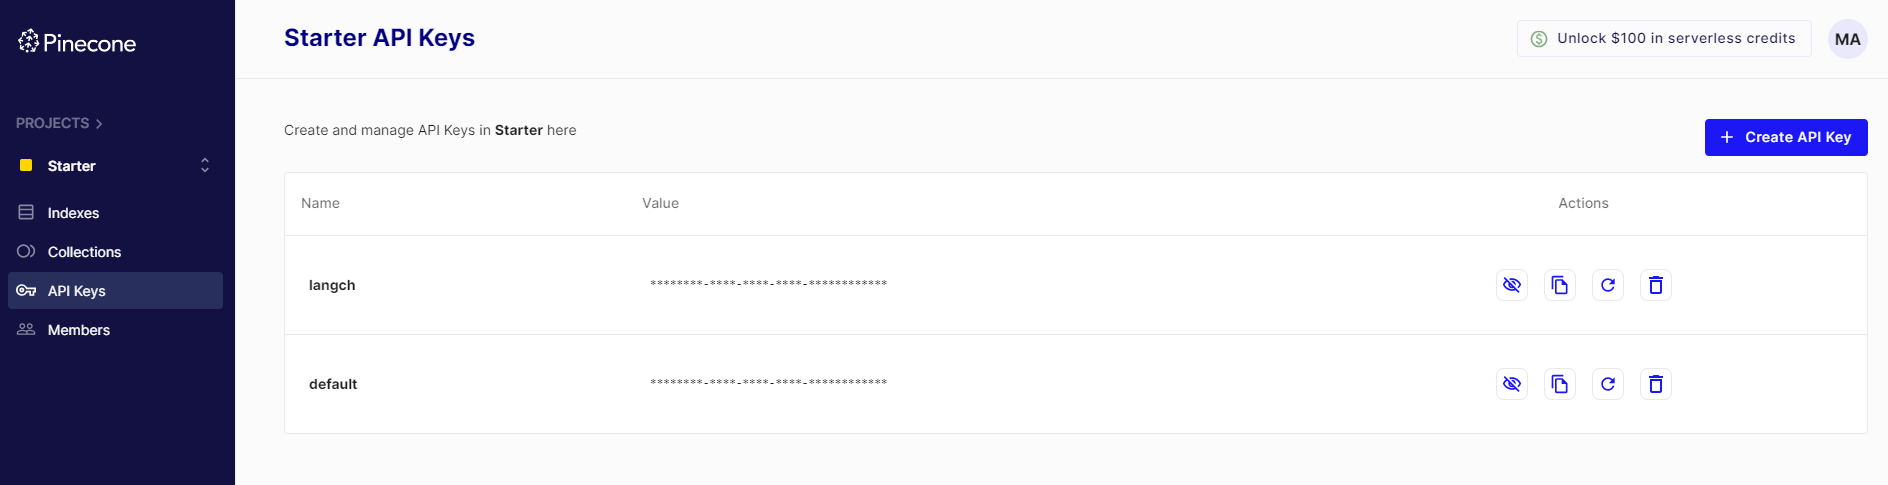
Setelah Anda memiliki kunci API dari OpenAI dan Pinecone, tetapkan ke variabel di Notebook. Atau, Anda juga dapat menggunakan modul `os` di Python dan menetapkan kunci ini sebagai variabel lingkungan. Anda kemudian harus menyesuaikan kode di bawah ini, jika memilih cara tersebut.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Untuk mengimplementasikan tutorial ini, Anda memerlukan pustaka berikut yang dipasang menggunakan pip.
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0Pustaka pinecone-datasets menyediakan beberapa dataset contoh yang sudah di-embed menggunakan model embedding-ada-002 dari OpenAI. Kita akan menggunakan salah satu dataset contoh bernama wikipedia-simple-text-embedding-ada-002-100K.
Sesuai namanya, ada 100.000 dokumen. Namun, kita hanya akan mengambil sampel 30.000 catatan pertama dalam tutorial ini. Meskipun tidak ada dampak biaya karena embedding disediakan untuk semua 100.000 dokumen, pengambilan sampel dilakukan semata agar proses lebih cepat.
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')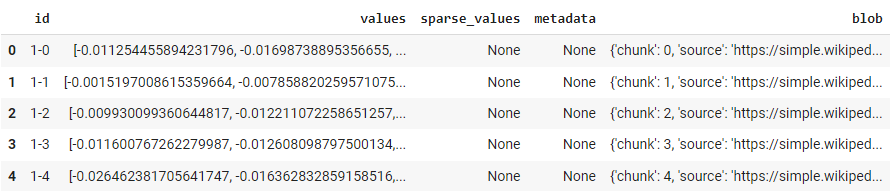
# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# sample 30k documents
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)
# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# check for and delete index if already exists
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# we create a new index
pc.create_index(
index_name,
dimension=1536, # dimensionality of text-embedding-ada-002
metric='dotproduct',
spec=spec
)
Untuk terhubung ke indeks dan memeriksa statistik indeks:
index = pc.Index(index_name)
index.describe_index_stats()
Ini akan menjadi keluarannya:
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536 adalah bentuk embedding dari model ada-002. Anda dapat melihat jumlah vektor nol karena kita belum memasukkan data (vektor) apa pun.
Memasukkan data ke dalam indeks langchain-retrieval-augmentation-fast ini cukup mudah:
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Perintah ini akan memakan waktu beberapa menit untuk selesai.
Setelah memasukkan data, Anda juga dapat melihatnya di UI Pinecone:
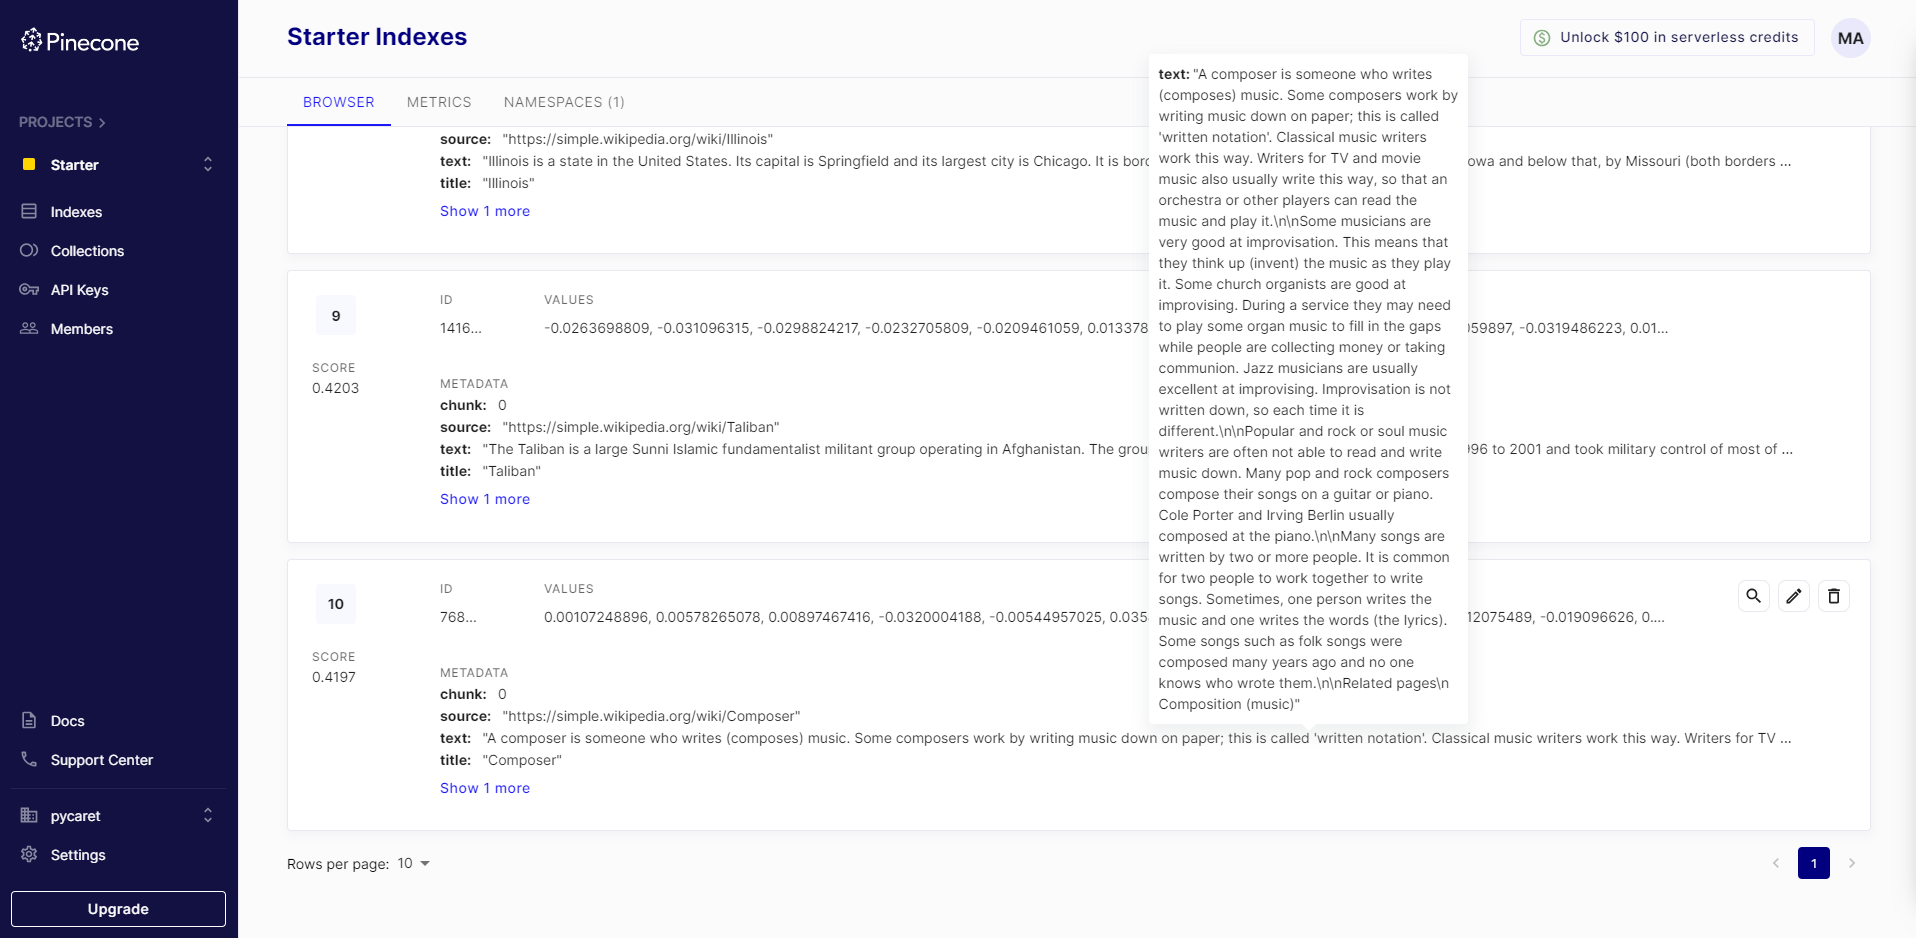
Sekarang kita telah membuat indeks dan memasukkan data ke indeks menggunakan API Pinecone, kita akan beralih menggunakan LangChain. Langkah selanjutnya melibatkan inisialisasi penyimpanan vektor LangChain menggunakan LangChain dan memanfaatkan indeks yang sama yang telah kita buat.
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
Untuk menginisialisasi penyimpanan vektor:
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
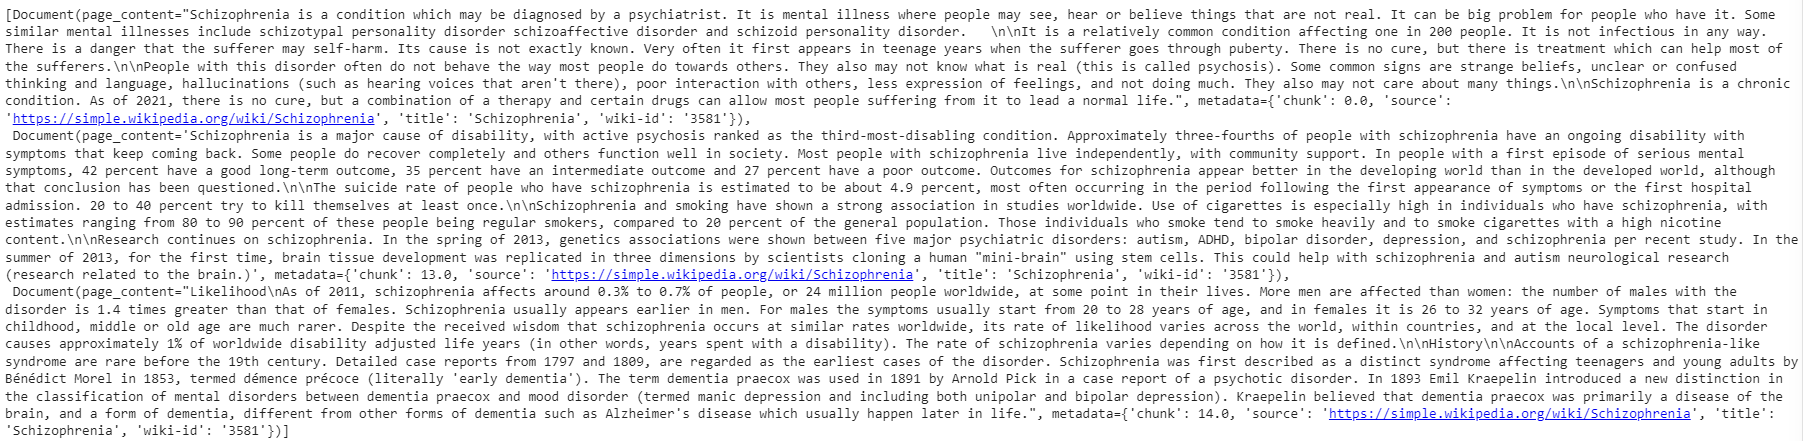
Sekarang Anda dapat menggunakan objek vectorstore untuk mengajukan kueri data dan melihat N Teratas hasilnya:
query = "What is Schizophrenia?"


vectorstore.similarity_search(query, k=3)
Keluaran berupa objek dokumen dari mana Anda dapat dengan mudah mengurai string, tetapi pada dasarnya ini menunjukkan 3 dokumen paling cocok berdasarkan metrik yang kita pilih di Langkah 4, yang dalam hal ini adalah dotmatrix.
Ini adalah langkah terakhir aplikasi kita. Sekarang kita ingin membungkusnya dengan LLM. Untuk itu, Anda akan mengimpor kelas ChatOpenAI dan RetrievalQA dari LangChain.
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# completion llm
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
Keluaran dari qa.run(query) adalah respons dari model bahasa.
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....Jawaban ini berasal dari salah satu dokumen dalam `dataset`. Jika Anda juga ingin mengambil sumbernya (yang sering diperlukan dalam aplikasi RAG) Anda harus membuat satu perubahan kecil pada kode di atas.
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
Keluaran:
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
Perhatikan kali ini keluaran berupa dictionary yang memuat `source`.
Dalam blog ini, kita telah mengeksplorasi aplikasi LLM yang paling populer, yaitu teknik Retrieval Augmented Generation (RAG), dengan menelaah bagaimana teknik ini meningkatkan keandalan dan relevansi respons chatbot berbasis Large Language Models seperti GPT-4.
Evolusi chatbot dari sistem sederhana berbasis aturan menjadi agen percakapan canggih yang didorong AI menandai lompatan besar dalam kemajuan teknologi. LLM menghadirkan tingkat fleksibilitas dan kecerdasan baru pada chatbot, yang mampu terlibat dalam percakapan yang lebih alami dan peka konteks.
Kita juga membahas peran basis data vektor, dengan fokus pada Pinecone, dalam menyimpan dan mengambil vektor data berdimensi tinggi. Basis data ini sangat penting untuk mengimplementasikan RAG.
Implementasi praktis dari konsep-konsep ini ditunjukkan melalui contoh kode, memanfaatkan API OpenAI dan Pinecone serta kerangka kerja LangChain di Python. Alat-alat ini menyederhanakan proses pengembangan, sehingga memudahkan pengembang menciptakan chatbot bertenaga AI yang disesuaikan untuk beragam aplikasi dengan cepat dan efisien.
Untuk mempelajari lebih lanjut tentang Vector Databases for Embeddings with Pinecone atau bekerja dengan OpenAI API, lihat kursus kami, yang dapat membantu Anda memperluas pengetahuan di bidang ini.
Mulai Perjalanan AI Anda Hari Ini!
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




