
Cursus
Werken met de OpenAI API
3 uur
179.5K
Sinds de release van ChatGPT in november 2022 zijn LLM-chatbots uitgegroeid tot prominente features voor talloze toepassingen.
Het idee van een chatbot is niet nieuw. We hebben allemaal nutteloze chatbots gezien die zo diep geconfigureerd moeten worden dat ze vrijwel gescript zijn met if-en-else-regels. Het onderhoud wordt een nachtmerrie en ze helpen de eindgebruiker niet; integendeel, ze frustreren gebruikers juist.
Maar in 2024 zijn chatbots terug, dankzij Large Language Models (LLM’s).
In deze blog leer je:
Bekijk ook onze cursus Vector Databases for Embeddings with Pinecone, en de code-along Building Chatbots with OpenAI API and Pinecone om meer te leren.
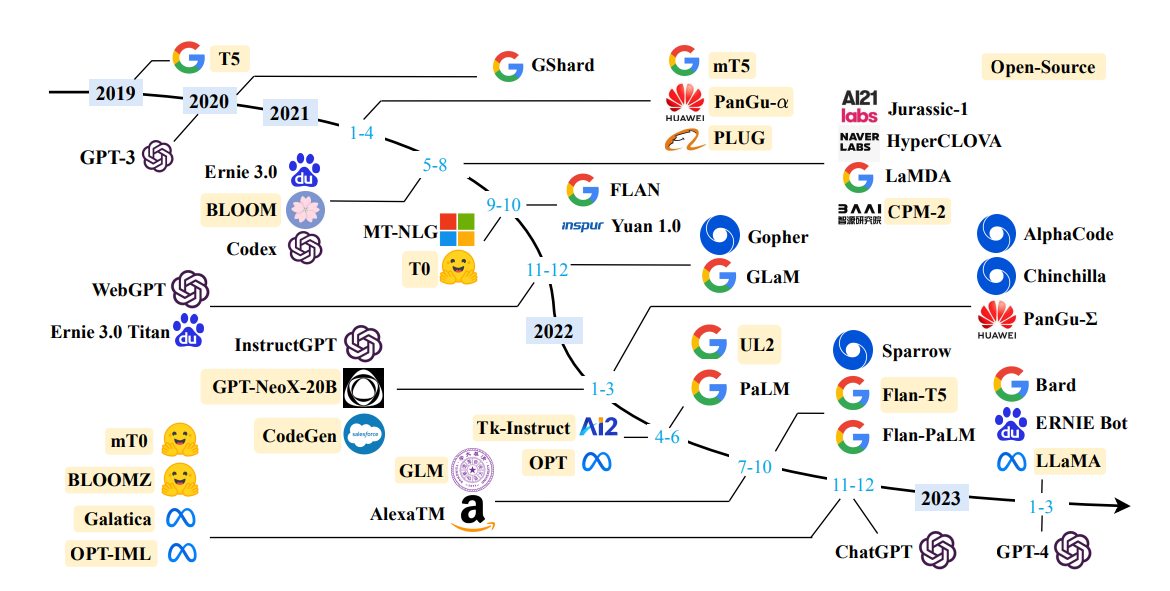
Large Language Models (LLM’s) zoals GPT-4 zijn geavanceerde machinelearning-algoritmen die gebruikmaken van deep learning-technieken, met name de transformer-architectuur, om natuurlijke taal te begrijpen en te genereren.
Ze worden getraind op enorme datasets met triljoenen woorden uit allerlei online teksten, zoals boeken, artikelen, websites en coderepositories. Dankzij deze uitgebreide training kunnen ze uiteenlopende complexe taken op het gebied van taalverwerking uitvoeren.
Een van de belangrijkste eigenschappen van LLM’s is hun vermogen om tekst te genereren over vrijwel elk onderwerp. Dit strekt zich uit tot verschillende stijlen en formats, van creatief schrijven tot technische documentatie.
LLM’s zijn bedreven in taken als samenvatten, waarbij ze lange documenten kunnen terugbrengen tot bondige samenvattingen, en conversatie-AI, waardoor ze natuurlijk en vloeiend met gebruikers kunnen praten. Ze zijn ook goed in het vertalen van teksten tussen talen en kunnen zelfs nuances als slang en dialecten oppikken.
Toch zijn er ook uitdagingen. Een belangrijk probleem is dat LLM’s kunnen "hallucineren", oftewel aannemelijk klinkende maar onjuiste of onsamenhangende informatie genereren, vooral bij vragen buiten hun trainingsdata of bij onduidelijke prompts.
Een ander probleem is het potentiële bias in LLM-uitvoer, afkomstig van vooroordelen in de trainingsdata of geïntroduceerd tijdens de modelontwikkeling.
LLM’s vormen een grote sprong voorwaarts in AI en bieden veel potentieel voor innovatie en efficiëntie in diverse domeinen, maar vereisen ook zorgvuldige beheersing om risico’s zoals bias en desinformatie te beperken.
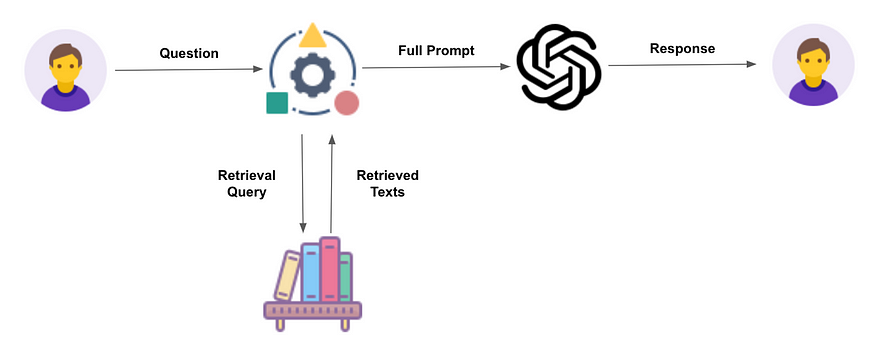
LLM’s zijn krachtig, maar hebben beperkingen. Ze kunnen verouderde, algemene of zelfs onjuiste informatie geven als de vraag buiten hun trainingsbereik valt.
Ze kunnen ook feitelijk onjuiste of onsamenhangende informatie verzinnen die het model als waar of logisch presenteert. Dit fenomeen staat bekend als hallucinatie.
RAG wil deze problemen verminderen door LLM’s relevante informatie te laten ophalen uit vooraf bepaalde bronnen. Dit vergroot het vertrouwen van gebruikers, omdat de uitvoer nauwkeuriger is en herleid kan worden tot betrouwbare bronnen.
Het geeft ontwikkelaars ook meer controle over de reacties die het LLM genereert, wat de algehele kwaliteit en toepasbaarheid van het systeem verbetert.
Je kunt meer leren over retrieval augmented generation in onze aparte tutorial. Hieronder vind je de belangrijkste stappen van het proces.
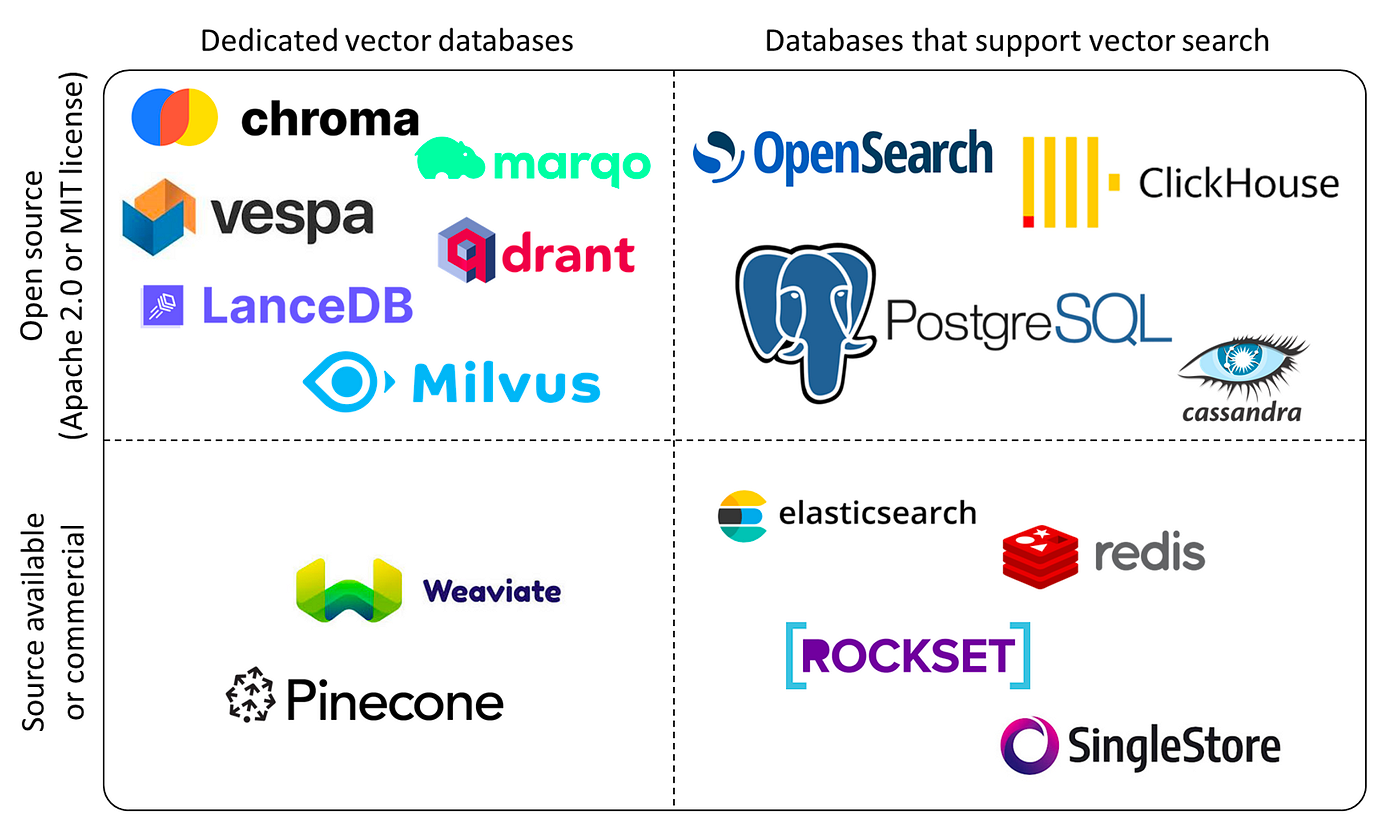
Vectordatabanken zijn gespecialiseerde databases voor het verwerken van hoog-dimensionale vectoren, wiskundige representaties van data-attributen of -kenmerken. Afhankelijk van de complexiteit en granulariteit van de data kunnen deze vectoren variëren van tientallen tot duizenden dimensies.
Dit type database blinkt uit in snelle en nauwkeurige similariteitszoektochten en -ophaalacties op basis van afstand of gelijkenis tussen vectoren, waardoor je semantischer of contextueler kunt zoeken dan met traditionele exacte matches of vooraf gedefinieerde criteria.
In de praktijk kun je vectordatabanken voor van alles inzetten. Zo kunnen ze afbeeldingen vinden die lijken op een opgegeven afbeelding op basis van visuele inhoud en stijl, documenten opsporen die lijken op een bepaald document op basis van onderwerp en sentiment, of producten identificeren die lijken op een specifiek product op basis van kenmerken en beoordelingen.
Vragen in een vectordatabank gebeurt met een queryvector die de gewenste informatie of criteria representeert, en een similariteitsmaat om de nabijheid van vectoren in de vectorruimte te bepalen. Dit levert een gerangschikte lijst op van vectoren met hoge similariteitsscores ten opzichte van de queryvector, waarna je toegang hebt tot de bijbehorende ruwe data van elke vector.
Vectordatabanken worden aangedreven door verschillende algoritmen, zoals k-nearest neighbor (k-NN)-indexen, en zijn gebouwd met methoden zoals de Hierarchical Navigable Small World (HNSW) en Inverted File Index (IVF)-algoritmen.
Vectordatabanken zijn onmisbaar voor retrieval augmented generation (RAG)-toepassingen. Ze bieden efficiënte similariteitszoektochten, contentuitbreiding, diversiteit en dynamisch ophalen van multimodale data. Dit is cruciaal in generatieve AI, waar toegang tot grootschalige, diverse datasets essentieel is om bias en hallucinaties in AI-modellen te verminderen.
Pinecone is een populaire vectordatabank die uitblinkt in efficiëntie en gebruiksgemak, vooral bij grootschalige data. Het is ontworpen voor ontwikkelaars en data scientists die vector search-functionaliteit in uiteenlopende toepassingen willen implementeren.
Pinecone gebruikt geavanceerde indexeringstechnieken zoals productkwantisatie en locality-sensitive hashing, waardoor efficiënte en accurate similariteitszoektochten in hoog-dimensionale vectorruimtes mogelijk zijn. Dit maakt het bijzonder nuttig voor RAG-toepassingen. Je kunt meer leren over werken met vectordatabanken met Pinecone in onze aparte tutorial.
In deze tutorial gebruiken we Pinecone als onze vectordatabank.
Het API-platform van OpenAI biedt toegang tot alle door OpenAI getrainde modellen die publiek beschikbaar zijn. Dit omvat GPT, DALL-E, Whisper en andere modellen.
De API is toegankelijk via HTTP-requests, dus je kunt hem integreren met elke programmeertaal die HTTP-requests ondersteunt. Voor Python is er echter een library genaamd openai die je kunt installeren met pip install openai, waarmee het werken met deze API’s nog eenvoudiger wordt.
Werken met de OpenAI API in Python met de openai-library kost maar een paar regels code.
Python-voorbeeld:
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)
LangChain is een framework voor het bouwen van applicaties die worden aangedreven door taalmodellen. Het biedt een laag van abstractie die het makkelijk en snel maakt om prototypes te ontwikkelen en snel van prototype naar productie te gaan. De groei en populariteit van dit framework blijkt wel uit het aantal sterren op hun Github-pagina.
Het is een geweldig framework. Een kanttekening: het is nog niet stabiel. De API verandert voortdurend en het is mogelijk dat de code in de volgende sectie niet meer werkt tegen de tijd dat je dit leest. Dat is te verwachten omdat de library nog in pre-release is. Op het moment van schrijven is de nieuwste versie van LangChain 0.1.4.
Om een RAG-back-end te implementeren, hebben we embeddings van externe data nodig. Als we starten met ruwe data, moeten we die embedden met de OpenAI embedding API of een andere open-source-embedding.
Ruwe data embedden is eenvoudig. Als je echter OpenAI-API’s gebruikt, betaal je per token.
Voor deze tutorial heb ik het grootste deel van de code in deze sectie overgenomen uit de officiële Pinecone-gids over LangChain. De documentatie van Pinecone is uitzonderlijk goed en altijd up-to-date.
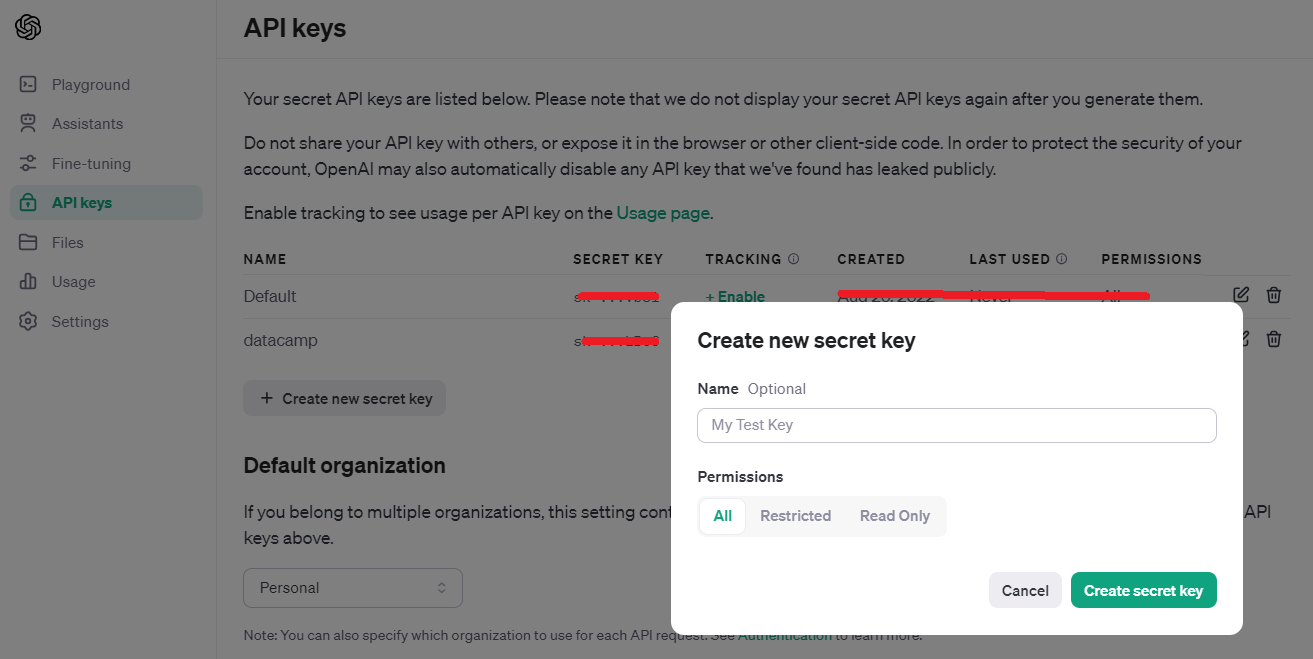
Nadat je een OpenAI-account hebt aangemaakt, ga je naar https://platform.openai.com/api-keys
Kopieer de sleutel zodra je die hebt gegenereerd, want daarna kun je hem niet meer bekijken of kopiëren.
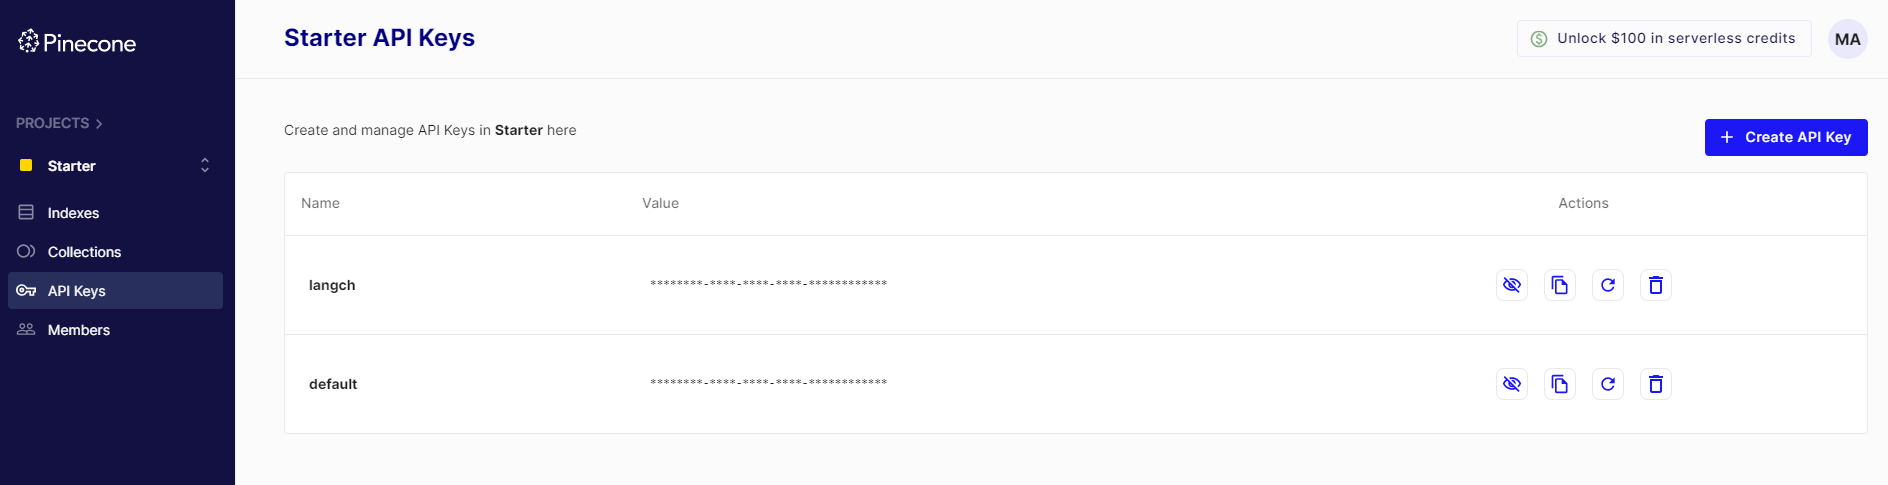
Voor Pinecone: log in op je account en klik op API Keys. Je kunt op de knop `Click API Key` in de rechterhoek klikken.
In tegenstelling tot OpenAI hoef je bij Pinecone de API-sleutel niet per se meteen te kopiëren, omdat er onder de kolom Actions een kopieericoon staat dat je altijd kunt gebruiken.
Zodra je de API-sleutels van OpenAI en Pinecone hebt, zet je ze als variabelen in je Notebook. Je kunt ook de module `os` in Python gebruiken en deze sleutels als omgevingsvariabelen instellen. Pas dan de code hieronder dienovereenkomstig aan, als je daarvoor kiest.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Voor deze tutorial heb je de volgende libraries nodig, te installeren met pip.
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0De library pinecone-datasets bevat enkele voorbeeld-datasets die al zijn ge-embed met OpenAI’s embedding-ada-002-model. We gebruiken de dataset wikipedia-simple-text-embedding-ada-002-100K.
Zoals de naam aangeeft zijn er 100.000 documenten. In deze tutorial nemen we echter alleen een steekproef van de eerste 30.000 records. Hoewel er geen kostenverschil is omdat er embeddings zijn voor alle 100.000 documenten, doen we dit om het proces te versnellen.
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')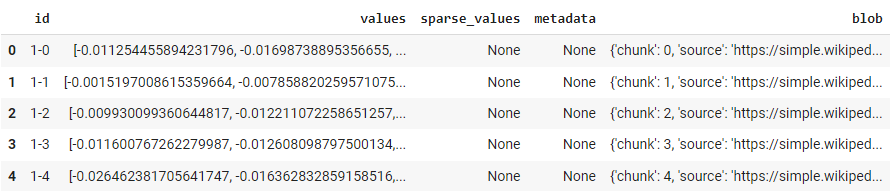
# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# sample 30k documents
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)
# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# check for and delete index if already exists
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# we create a new index
pc.create_index(
index_name,
dimension=1536, # dimensionality of text-embedding-ada-002
metric='dotproduct',
spec=spec
)
Verbinding maken met de index en de statistieken van de index bekijken:
index = pc.Index(index_name)
index.describe_index_stats()
Dit is de output:
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536 is de vorm van de embeddings van het ada-002-model. Je ziet dat het aantal vectoren nul is omdat we nog geen data (vectoren) hebben ingeladen.
Data invoegen in deze index langchain-retrieval-augmentation-fast is vrij eenvoudig:
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Dit commando duurt enkele minuten om te voltooien.
Na het invoegen van data kun je dit ook zien in de Pinecone-UI:
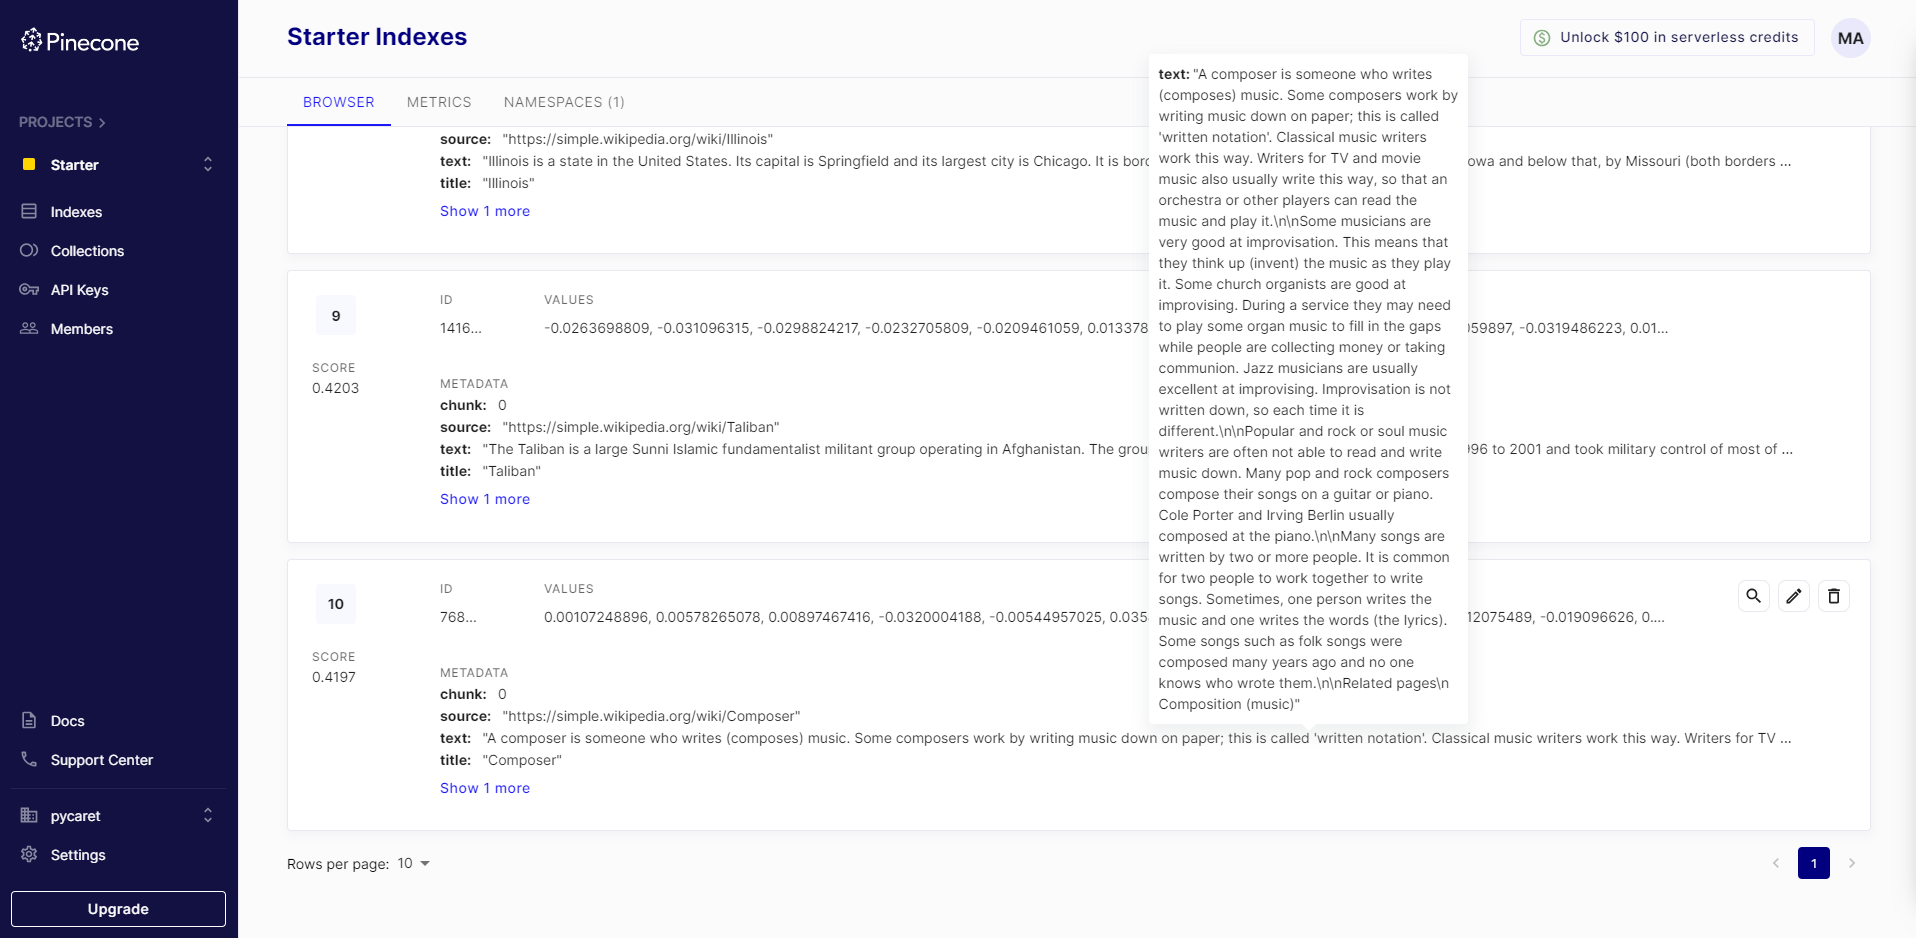
Nu we een index hebben gemaakt en data via de Pinecone-API hebben ingevoegd, stappen we over op LangChain. De volgende stap is het initialiseren van een LangChain-vector store met LangChain en het hergebruiken van dezelfde index die we hebben gemaakt.
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
De vector store initialiseren:
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
Je kunt nu het object vectorstore gebruiken om de data te bevragen en de Top N-resultaten te bekijken:
query = "What is Schizophrenia?"


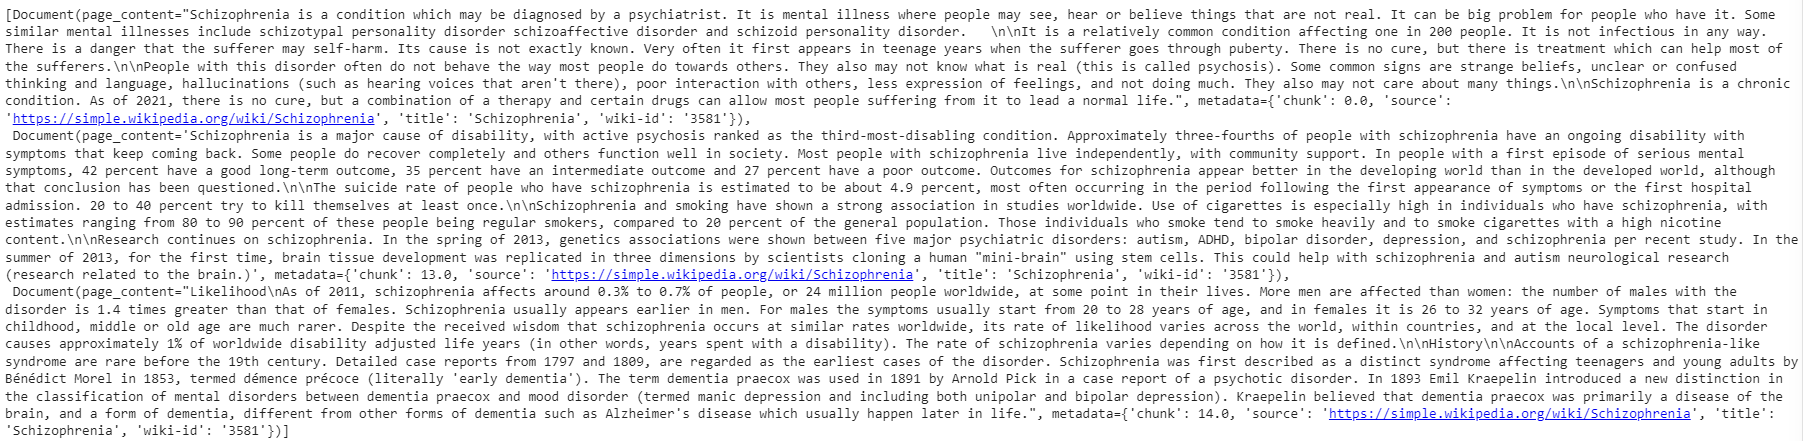
vectorstore.similarity_search(query, k=3)
De output is een documentobject waaruit je eenvoudig strings kunt parsen, maar het komt er in essentie op neer dat de top 3 overeenkomende documenten worden getoond op basis van de metriek die we in stap 4 hebben gekozen, in dit geval dotmatrix.
Dit is de laatste stap van onze applicatie. We willen nu een LLM eromheen bouwen. Importeer daarvoor de klassen ChatOpenAI en RetrievalQA uit LangChain.
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# completion llm
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
De output van qa.run(query) is de reactie van het taalmodel.
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....Dit antwoord komt uit een van de documenten in de `dataset`. Als je ook de bron wilt ophalen (wat vaak nodig is in RAG-toepassingen), moet je één kleine aanpassing in de bovenstaande code doen.
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
Output:
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
Let op: de output is dit keer een dictionary waarin je de `source` kunt vinden.
In deze blog hebben we de populairste toepassing van LLM’s besproken: de Retrieval Augmented Generation (RAG)-techniek, met een diepere kijk op hoe die de betrouwbaarheid en relevantie van chatbotantwoorden op basis van Large Language Models zoals GPT-4 vergroot.
De evolutie van chatbots van eenvoudige, regelgebaseerde systemen naar geavanceerde, AI-gedreven gesprekspartners markeert een grote technologische sprong. LLM’s brengen een nieuw niveau van veelzijdigheid en intelligentie naar chatbots, die natuurlijkere, contextbewuste gesprekken kunnen voeren.
We hebben ook de rol van vectordatabanken onderzocht, met een focus op Pinecone, voor het opslaan en ophalen van hoog-dimensionale datavectoren. Deze databases zijn cruciaal voor de implementatie van RAG.
De praktische implementatie van deze concepten is gedemonstreerd met codevoorbeelden, waarbij we de API’s van OpenAI en Pinecone en het LangChain-framework in Python hebben gebruikt. Deze tools vereenvoudigen het ontwikkelproces, zodat ontwikkelaars snel en efficiënt AI-chatbots kunnen bouwen die zijn afgestemd op uiteenlopende toepassingen.
Wil je meer leren over Vector Databases for Embeddings with Pinecone of werken met de OpenAI API? Bekijk onze cursussen, die je helpen je kennis op deze gebieden uit te breiden.
Begin vandaag nog met je AI-reis!
Cursus
Cursus
blog
Adel Nehme
15 min

