
Last chance! 50% off DataCamp Premium
Sale ends in
नवंबर 2022 में ChatGPT के रिलीज़ होने के बाद से, LLM चैटबॉट्स कई अलग-अलग उपयोग मामलों में प्रमुख विशेषताओं के रूप में उभरे हैं।
चैटबॉट का विचार नया नहीं है। हम सभी ने ऐसे बेकार चैटबॉट्स देखे हैं जिन्हें इतने विस्तार से कॉन्फ़िगर करना पड़ता है कि वे लगभग if-and-else नियमों से स्क्रिप्टेड हो जाते हैं। उनका रखरखाव एक दुःस्वप्न बन जाता है, और वे अंतिम उपयोगकर्ता की मदद नहीं करते; बल्कि उल्टा करते हैं—उपयोगकर्ताओं को निराश करते हैं।
लेकिन अब, 2024 में, बड़े भाषा मॉडल्स (LLMs) की बदौलत चैटबॉट्स वापसी कर चुके हैं।
इस ब्लॉग में, आप सीखेंगे:
आप हमारा Vector Databases for Embeddings with Pinecone कोर्स और OpenAI API और Pinecone के साथ चैटबॉट बनाना पर कोड-अलॉन्ग भी देख सकते हैं ताकि और अधिक सीख सकें।
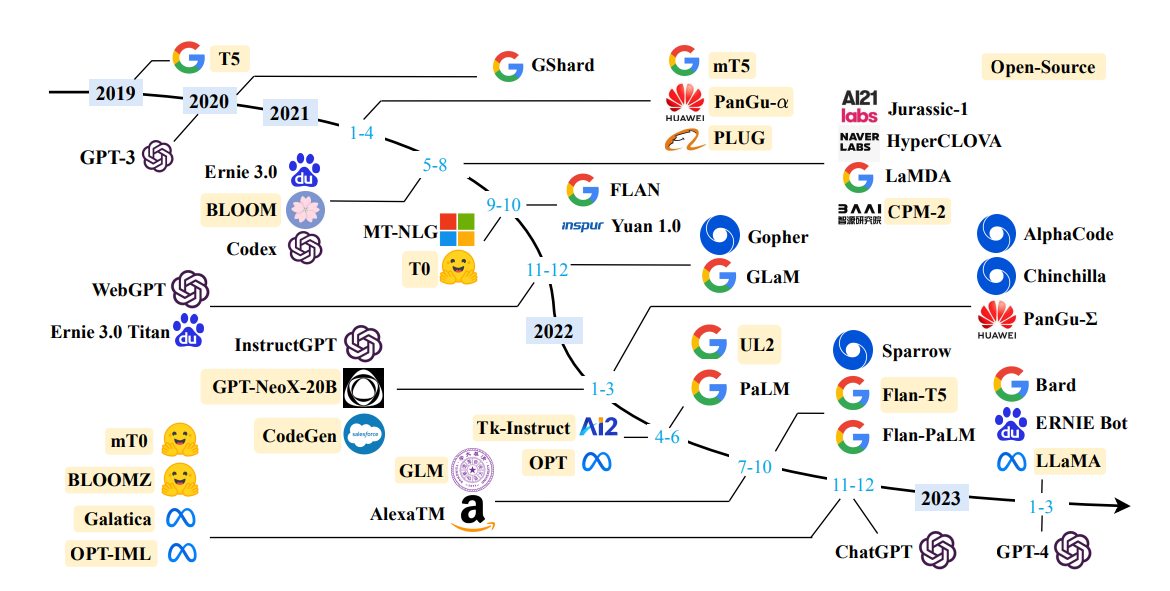
GPT-4 जैसे बड़े भाषा मॉडल्स (LLMs) उन्नत मशीन लर्निंग एल्गोरिदम हैं जो डीप लर्निंग तकनीकों—विशेष रूप से ट्रांसफॉर्मर आर्किटेक्चर—का उपयोग करके प्राकृतिक भाषा को समझते और जनरेट करते हैं।
उन्हें इंटरनेट पर उपलब्ध विभिन्न प्रकार के पाठ्य स्रोतों—जैसे किताबें, लेख, वेबसाइट्स और कोडिंग रिपॉजिटरी—से जुटाए गए खरबों शब्दों वाले विशाल डेटासेट्स पर प्रशिक्षित किया जाता है। यह व्यापक प्रशिक्षण उन्हें भाषा प्रसंस्करण से जुड़े कई जटिल कार्यों को करने में सक्षम बनाता है।
LLMs की एक प्रमुख विशेषता है लगभग किसी भी विषय पर पाठ उत्पन्न करने की उनकी क्षमता। यह क्षमता रचनात्मक लेखन से लेकर तकनीकी दस्तावेज़ीकरण तक विभिन्न शैली और फॉर्मेट में फैली हुई है।
LLMs सारांशण जैसे कार्यों में दक्ष हैं—जहां वे लंबे दस्तावेज़ों को संक्षिप्त सार में बदल सकते हैं—और वार्तालापी AI में, जहां वे उपयोगकर्ताओं के साथ स्वाभाविक और धाराप्रवाह संवाद कर सकते हैं। वे भाषाओं के बीच अनुवाद करने में भी निपुण हैं, यहां तक कि स्लैंग और क्षेत्रीय बोलियों जैसी बारीकियों को भी पकड़ लेते हैं।
हालांकि, LLMs चुनौतियों से मुक्त नहीं हैं। एक महत्वपूर्ण मुद्दा यह है कि LLMs "हैलुसिनेट" कर सकते हैं—यानी, यथार्थसंगत दिखने वाली लेकिन गलत या निरर्थक जानकारी उत्पन्न कर सकते हैं, खासकर तब जब प्रश्न उनके प्रशिक्षण डेटा से बाहर हो या संकेत अस्पष्ट हों।
एक अन्य प्रमुख समस्या है आउटपुट में पूर्वाग्रह की संभावना, जो प्रशिक्षण डेटा में मौजूद पक्षपात या मॉडल के विकास के दौरान जोड़े गए पक्षपात से उत्पन्न हो सकती है।
LLMs AI में एक महत्वपूर्ण प्रगति का प्रतिनिधित्व करते हैं—वे विभिन्न क्षेत्रों में नवोन्मेष और दक्षता की अपार संभावनाएं प्रदान करते हैं—लेकिन पूर्वाग्रह और गलत सूचनाओं जैसे जोखिमों को कम करने के लिए सावधानीपूर्वक प्रबंधन की आवश्यकता होती है।
शक्तिशाली होने के बावजूद, LLMs की कुछ सीमाएं हैं। यदि क्वेरी उनके प्रशिक्षण डेटा के दायरे से बाहर जाती है, तो वे पुरानी, सामान्यीकृत, या यहां तक कि गलत जानकारी भी दे सकते हैं।
वे तथ्यात्मक रूप से गलत या निरर्थक जानकारी भी बना सकते हैं, जिसे मॉडल सच्चा या तार्किक रूप में पेश करता है। इस घटना को प्रसिद्ध रूप से हैलुसिनेशन कहा जाता है।
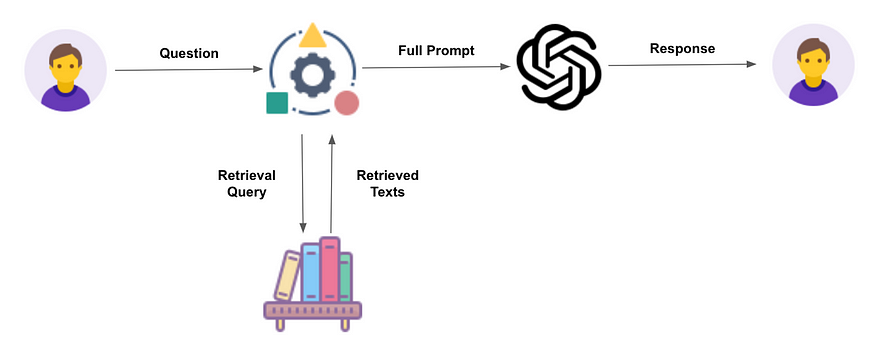
RAG इन समस्याओं को कम करने के लिए LLMs को पूर्वनिर्धारित स्रोतों से प्रासंगिक जानकारी प्राप्त करने के लिए निर्देशित करता है। यह दृष्टिकोण उपयोगकर्ता के भरोसे को बढ़ाता है क्योंकि मॉडल के आउटपुट अधिक सटीक होते हैं और उन्हें विश्वसनीय स्रोतों से जोड़ा जा सकता है।
यह डेवलपर्स को LLM द्वारा उत्पन्न प्रतिक्रियाओं पर अधिक नियंत्रण भी देता है, जिससे सिस्टम की समग्र गुणवत्ता और लागूता में सुधार होता है।
आप हमारे अलग ट्यूटोरियल में retrieval augmented generation के बारे में और जान सकते हैं। हालांकि, नीचे हमने प्रक्रिया के मुख्य चरणों का संक्षेप दिया है।
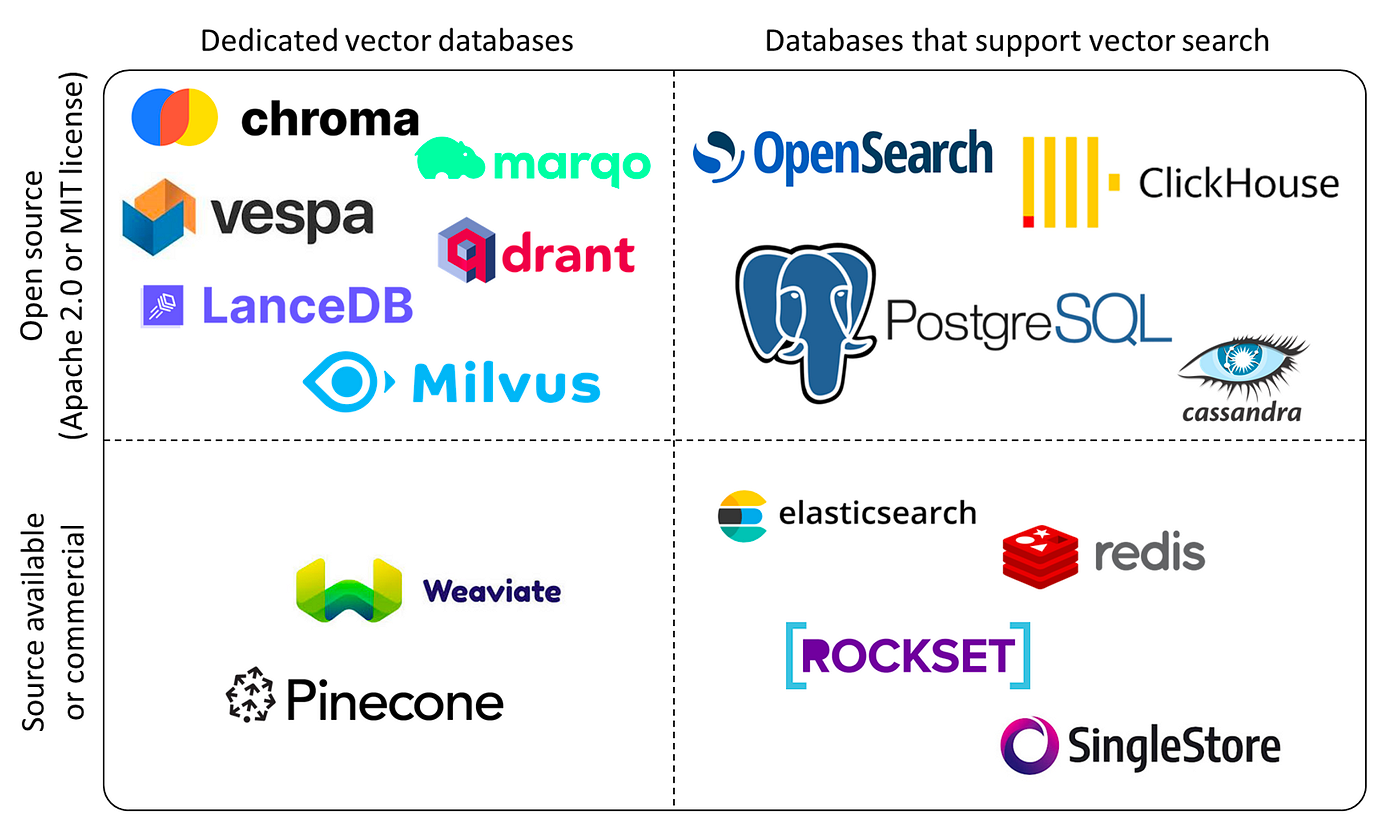
वेक्टर डेटाबेस उच्च-आयामी वेक्टरों को संभालने के लिए डिज़ाइन किए गए विशेष प्रकार के डेटाबेस हैं, जो डेटा की विशेषताओं या फीचर्स के गणितीय प्रतिनिधित्व होते हैं। डेटा की जटिलता और सूक्ष्मता के आधार पर ये वेक्टर दर्जनों से लेकर हजारों आयामों तक हो सकते हैं।
यह प्रकार का डेटाबेस वेक्टर दूरी या समानता के आधार पर तेज़ और सटीक समानता खोज और पुनर्प्राप्ति करने में विशेष रूप से सक्षम होता है, जिससे पारंपरिक सटीक मिलान या पूर्वनिर्धारित मानदंडों पर निर्भर होने के बजाय अधिक सेमांटिक या संदर्भात्मक क्वेरी करना संभव होता है।
व्यावहारिक रूप से, वेक्टर डेटाबेस का विभिन्न उद्देश्यों के लिए उपयोग किया जा सकता है। उदाहरण के लिए, वे किसी दी गई छवि के दृश्य सामग्री और शैली के आधार पर समान छवियां ढूंढ सकते हैं; किसी विशेष विषय और भाव के आधार पर समान दस्तावेज़ पहचान सकते हैं; या किसी उत्पाद के फीचर्स और रेटिंग्स के आधार पर समान उत्पाद ढूंढ सकते हैं।
वेक्टर डेटाबेस में क्वेरी करने की प्रक्रिया में एक क्वेरी वेक्टर का उपयोग होता है, जो वांछित जानकारी या मानदंड का प्रतिनिधित्व करता है, और समानता माप लागू करके वेक्टर स्पेस में वेक्टरों की निकटता का निर्धारण किया जाता है। यह प्रक्रिया क्वेरी वेक्टर से उच्च समानता स्कोर वाले वेक्टरों की रैंक की गई सूची देती है, जिससे प्रत्येक वेक्टर से जुड़े कच्चे डेटा तक पहुंच मिलती है।
वेक्टर डेटाबेस विभिन्न एल्गोरिदम—जैसे k-nearest neighbor (k-NN) इंडेक्स—द्वारा संचालित होते हैं और HNSW (Hierarchical Navigable Small World) तथा IVF (Inverted File Index) जैसे तरीकों से बनाए जाते हैं।
वेक्टर डेटाबेस retrieval augmented generation (RAG) अनुप्रयोगों के लिए अभिन्न हैं। वे कुशल समानता खोज, सामग्री विस्तार, विविधता, और गतिशील मल्टी-मोडल डेटा पुनर्प्राप्ति प्रदान करते हैं। यह क्षमता जनरेटिव AI में महत्वपूर्ण है, जहां बड़े पैमाने के, विविध डेटासेट्स तक पहुंच पूर्वाग्रह और हैलुसिनेशन को कम करने के लिए आवश्यक है।
Pinecone एक लोकप्रिय वेक्टर डेटाबेस है, जो विशेष रूप से बड़े पैमाने के डेटा पर कुशलता और उपयोग में सरलता के लिए जाना जाता है। यह उन डेवलपर्स और डेटा वैज्ञानिकों के लिए बनाया गया है जो विभिन्न अनुप्रयोगों में वेक्टर सर्च क्षमताओं को लागू करना चाहते हैं।
Pinecone, product quantization और locality-sensitive hashing जैसी उन्नत इंडेक्सिंग तकनीकों का उपयोग करता है, जो उच्च-आयामी वेक्टर स्पेस में कुशल और सटीक समानता खोज को सक्षम करती हैं। यह इसे विशेष रूप से RAG अनुप्रयोगों के लिए उपयोगी बनाता है। आप हमारे अलग ट्यूटोरियल में Pinecone के साथ वेक्टर डेटाबेस में महारत के बारे में और सीख सकते हैं।
इस ट्यूटोरियल में, हम अपने वेक्टर डेटाबेस के रूप में Pinecone का उपयोग करेंगे।
OpenAI का API प्लेटफ़ॉर्म, OpenAI द्वारा प्रशिक्षित उन सभी मॉडलों तक पहुंच प्रदान करता है जो सार्वजनिक रूप से उपलब्ध हैं। इसमें GPT, DALL-E, Whisper और अन्य मॉडल शामिल हैं।
API तक HTTP अनुरोधों के माध्यम से पहुंचा जाता है, इसलिए आप इसे किसी भी प्रोग्रामिंग भाषा के साथ एकीकृत कर सकते हैं जो HTTP अनुरोधों का समर्थन करती है। हालांकि, Python के लिए openai नामक एक लाइब्रेरी है जिसे आप pip install openai से इंस्टॉल कर सकते हैं, और यह इन APIs के साथ काम करना और भी आसान बना देती है।
OpenAI API के साथ कार्य करना Python में openai लाइब्रेरी का उपयोग करके कुछ ही लाइनों के कोड में हो जाता है।
Python उदाहरण:
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)
LangChain भाषा मॉडल्स द्वारा संचालित अनुप्रयोग विकसित करने के लिए एक फ्रेमवर्क है। यह एक ऐसा एब्स्ट्रैक्शन स्तर प्रदान करता है जो प्रोटोटाइप विकसित करना आसान और तेज़ बनाता है, और प्रोटोटाइप से प्रोडक्शन तक जल्दी पहुंचने में मदद करता है। इस फ्रेमवर्क की वृद्धि और लोकप्रियता उनके Github पेज पर सितारों की संख्या से स्पष्ट है।
यह एक शानदार फ्रेमवर्क है। हालांकि, एक सावधानी यह है कि यह अभी स्थिर नहीं है। API लगातार बदल रहा है और यह भी संभव है कि जब तक आप अगला सेक्शन पढ़ेंगे, कोड काम न करे। यह अपेक्षित है क्योंकि लाइब्रेरी अभी pre-release में है। इस ब्लॉग को लिखते समय LangChain का नवीनतम संस्करण 0.1.4 है।
RAG बैक-एंड लागू करने के लिए, हमें बाहरी डेटा की एंबेडिंग्स चाहिए। यदि हम कच्चे डेटा से शुरू करते हैं, तो हमें उसे OpenAI एंबेडिंग API या किसी अन्य ओपन-सोर्स एंबेडिंग से एंबेड करना होगा।
कच्चे डेटा को एंबेड करना सीधा-सादा है। हालांकि, यदि आप OpenAI APIs का उपयोग कर रहे हैं, तो आपसे प्रति टोकन शुल्क लिया जाएगा।
इस ट्यूटोरियल के उद्देश्य से, मैंने इस सेक्शन में अधिकांश कोड आधिकारिक Pinecone गाइड ऑन LangChain से लिया है। Pinecone का दस्तावेज़ीकरण अत्यंत अच्छा और हमेशा अद्यतन रहता है।
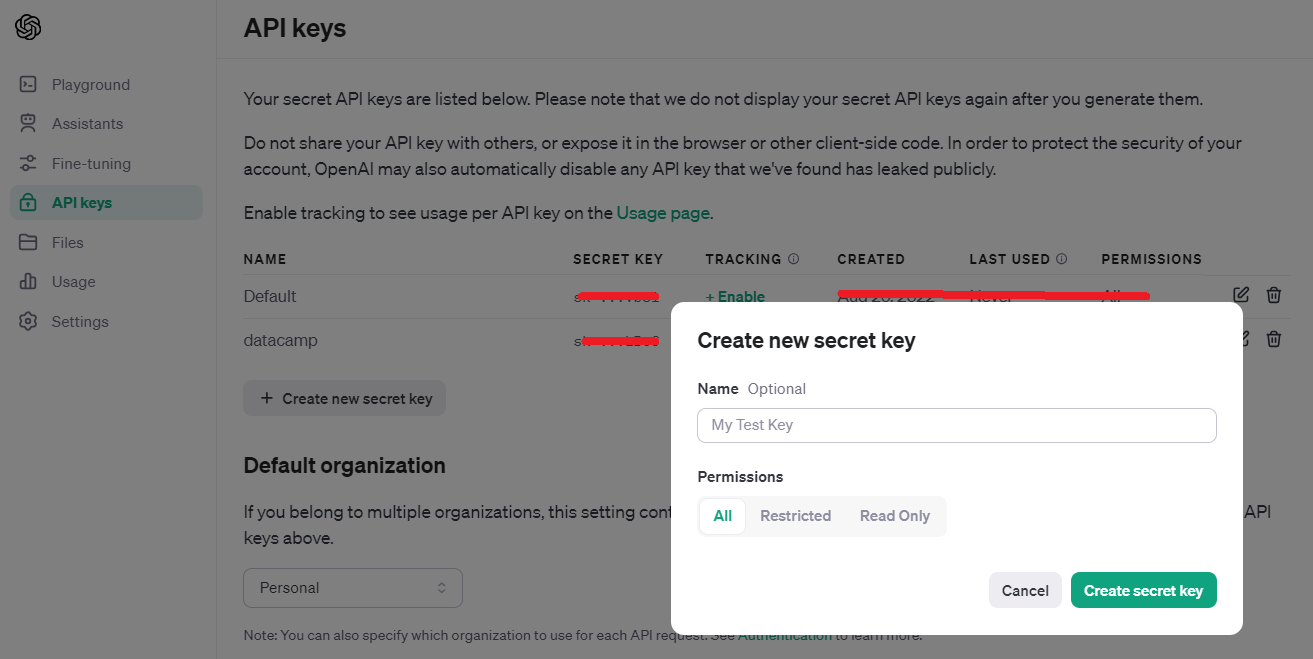
OpenAI खाते पर साइन अप करने के बाद सीधे यहाँ जाएँ: https://platform.openai.com/api-keys
जब आप एक कुंजी जनरेट करते हैं तो आपको उसे कॉपी करना होगा, क्योंकि बाद में उसे देखने या कॉपी करने का कोई विकल्प नहीं होता।
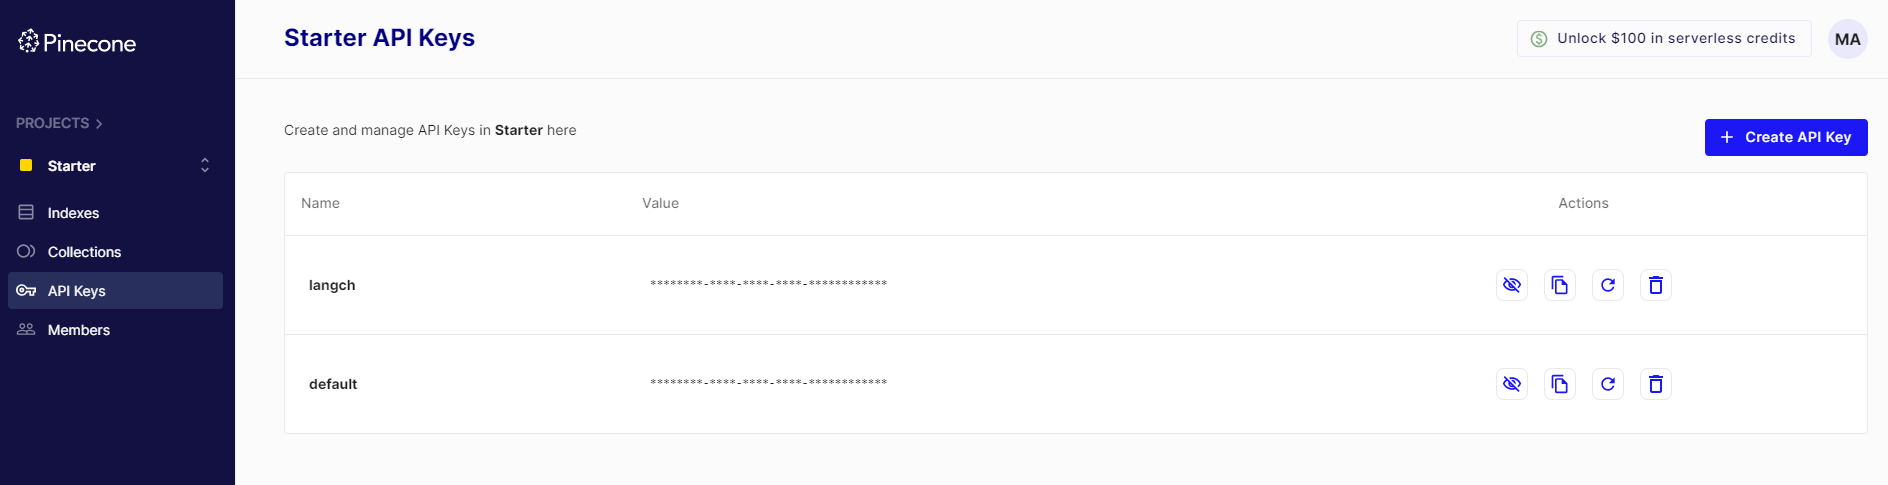
Pinecone के लिए, अपने खाते में लॉगइन करें और API Keys पर क्लिक करें। आप दाएँ कोने में `Click API Key` बटन पर क्लिक कर सकते हैं।
OpenAI के विपरीत, Pinecone में API कुंजी जनरेट करते समय उसे तुरंत कॉपी करना आवश्यक नहीं है, क्योंकि Actions कॉलम के नीचे एक कॉपी आइकन होता है जिसे आप कभी भी उपयोग कर सकते हैं।
जब आपके पास OpenAI और Pinecone की API keys आ जाएँ, तो उन्हें Notebook में वेरिएबल्स में सेट करें। वैकल्पिक रूप से, आप Python में `os` मॉड्यूल का उपयोग करके इन्हें environment variables के रूप में भी सेट कर सकते हैं। यदि आप ऐसा करते हैं, तो आपको नीचे दिए गए कोड में उसी अनुसार बदलाव करने होंगे।
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'इस ट्यूटोरियल को लागू करने के लिए, आपको pip का उपयोग करके निम्नलिखित लाइब्रेरीज़ इंस्टॉल करनी होंगी।
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0pinecone-datasets लाइब्रेरी कुछ सैंपल डेटासेट्स प्रदान करती है जो पहले से OpenAI के embedding-ada-002 मॉडल का उपयोग करके एंबेड किए गए हैं। हम wikipedia-simple-text-embedding-ada-002-100K नामक सैंपल डेटासेट का उपयोग करेंगे।
जैसा कि नाम से स्पष्ट है, इसमें 100,000 दस्तावेज़ हैं। हालांकि, इस ट्यूटोरियल में हम केवल पहले 30,000 रिकॉर्ड्स का सैंपल लेंगे। भले ही लागत पर कोई प्रभाव नहीं है क्योंकि सभी 100,000 दस्तावेज़ों के लिए एंबेडिंग्स दी गई हैं, सैंपलिंग केवल प्रक्रिया को तेज़ बनाने के लिए की जाती है।
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')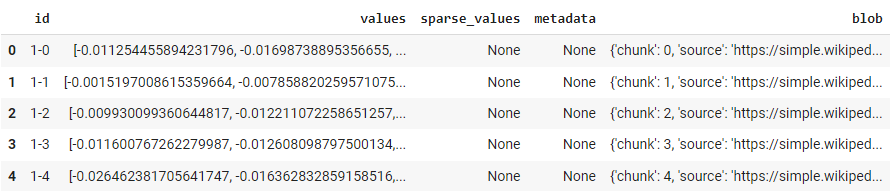
# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# sample 30k documents
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)
# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# check for and delete index if already exists
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# we create a new index
pc.create_index(
index_name,
dimension=1536, # dimensionality of text-embedding-ada-002
metric='dotproduct',
spec=spec
)
इंडेक्स से कनेक्ट करने और उसके आँकड़े देखने के लिए:
index = pc.Index(index_name)
index.describe_index_stats()
आउटपुट कुछ ऐसा होगा:
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536, ada-002 मॉडल से आने वाली एंबेडिंग्स का आकार है। आप देख सकते हैं कि वेक्टर काउंट शून्य है क्योंकि हमने अभी तक कोई डेटा (वेक्टर) इन्गेस्ट नहीं किया है।
इस इंडेक्स langchain-retrieval-augmentation-fast में डेटा डालना काफी सीधा है:
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
यह कमांड पूर्ण होने में कुछ मिनट लेगा।
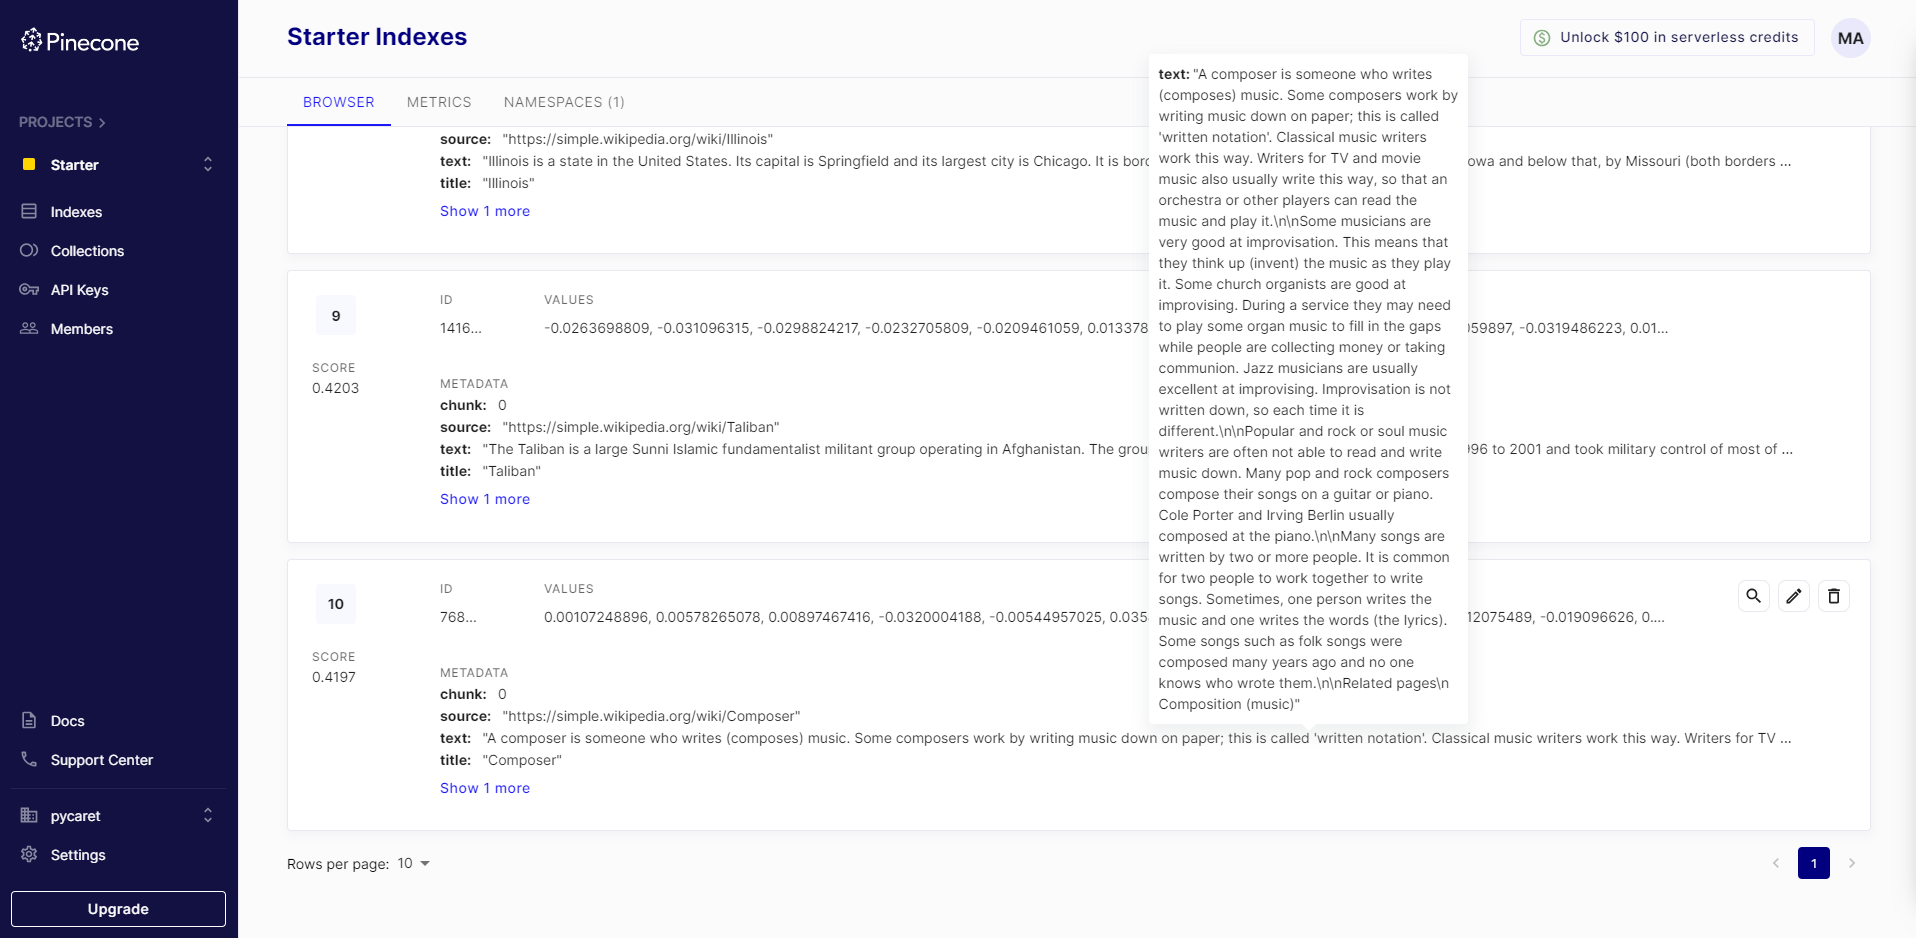
डेटा डालने के बाद, आप इसे Pinecone UI पर भी देख सकते हैं:
अब जब हमने Pinecone API का उपयोग करके एक इंडेक्स बना लिया है और उसमें डेटा डाल दिया है, तो हम LangChain का उपयोग करने की ओर बढ़ेंगे। अगला चरण LangChain का उपयोग करके एक LangChain वेक्टर स्टोर इनिशियलाइज़ करना और उसी इंडेक्स का उपयोग करना है जिसे हमने बनाया है।
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
वेक्टर स्टोर को इनिशियलाइज़ करने के लिए:
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
अब आप vectorstore ऑब्जेक्ट का उपयोग करके डेटा को क्वेरी कर सकते हैं और शीर्ष N परिणाम देख सकते हैं:
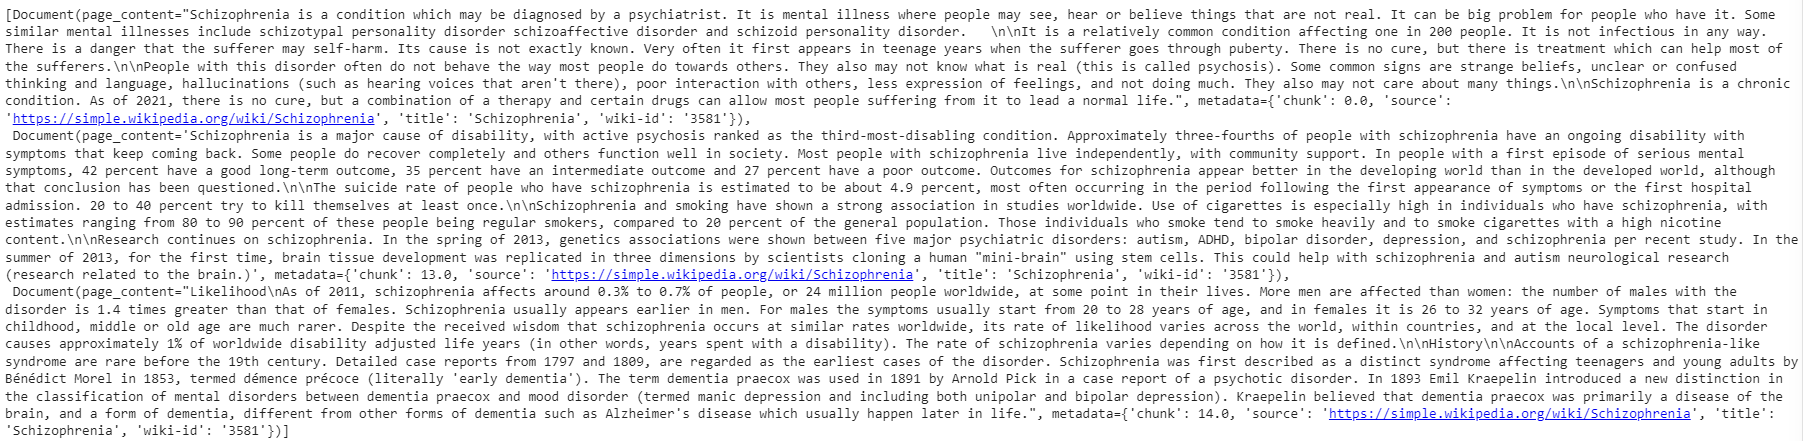
query = "What is Schizophrenia?"


vectorstore.similarity_search(query, k=3)
आउटपुट एक डॉक्यूमेंट ऑब्जेक्ट होता है जिससे आप आसानी से स्ट्रिंग्स पार्स कर सकते हैं, लेकिन मूलतः यह उन शीर्ष 3 मिलते-जुलते दस्तावेज़ों को दिखा रहा है जो हमने चरण 4 में चुने गए मेट्रिक—जो इस मामले में dotmatrix है—पर आधारित हैं।
यह हमारे एप्लिकेशन का अंतिम चरण है। अब हम इसके चारों ओर LLM लपेटना चाहते हैं। ऐसा करने के लिए, आप LangChain से ChatOpenAI और RetrievalQA क्लास इंपोर्ट करेंगे।
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# completion llm
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
qa.run(query) का आउटपुट भाषा मॉडल की प्रतिक्रिया है।
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....यह उत्तर `dataset` में से किसी एक दस्तावेज़ से आ रहा है। यदि आप स्रोत भी प्राप्त करना चाहते हैं (जो RAG अनुप्रयोगों में अक्सर आवश्यक होता है), तो आपको ऊपर दिए गए कोड में एक छोटा सा बदलाव करना होगा।
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
आउटपुट:
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
ध्यान दें कि इस बार आउटपुट एक डिक्शनरी है जिसमें आप `source` पा सकते हैं।
इस ब्लॉग में, हमने LLM के सबसे लोकप्रिय अनुप्रयोग—Retrieval Augmented Generation (RAG) तकनीक—का अन्वेषण किया, और देखा कि यह GPT-4 जैसे बड़े भाषा मॉडल्स पर आधारित चैटबॉट प्रतिक्रियाओं की विश्वसनीयता और प्रासंगिकता को कैसे बढ़ाती है।
सरल, नियम-आधारित सिस्टम से लेकर परिष्कृत, AI-संचालित वार्तालाप एजेंटों तक चैटबॉट्स का विकास तकनीकी प्रगति में एक महत्वपूर्ण छलांग का प्रतीक है। LLMs चैटबॉट्स को बहुमुखी प्रतिभा और बुद्धिमत्ता का एक नया स्तर देते हैं, जो अधिक स्वाभाविक, संदर्भ-सचेत वार्तालाप करने में सक्षम हैं।
हमने वेक्टर डेटाबेस—विशेष रूप से Pinecone—की भूमिका का भी अध्ययन किया, जो उच्च-आयामी डेटा वेक्टरों को स्टोर और रिट्रीव करने में काम आते हैं। ये डेटाबेस RAG को लागू करने में केंद्रीय भूमिका निभाते हैं।
इन अवधारणाओं के व्यावहारिक कार्यान्वयन को कोड उदाहरणों के माध्यम से प्रदर्शित किया गया, जिसमें Python में OpenAI और Pinecone API तथा LangChain फ्रेमवर्क का लाभ उठाया गया। ये टूल्स विकास प्रक्रिया को सरल बनाते हैं, जिससे डेवलपर्स विभिन्न अनुप्रयोगों के लिए अनुकूलित AI-संचालित चैटबॉट्स को तेज़ी और कुशलता से बना सकें।
और अधिक जानने के लिए Vector Databases for Embeddings with Pinecone या OpenAI API के साथ कार्य पर हमारे कोर्स देखें, जो इन क्षेत्रों में आपका ज्ञान बढ़ाने में मदद कर सकते हैं।
आज ही अपनी AI यात्रा शुरू करें!
कोर्स
कोर्स
