
Cours
Travailler avec l'API OpenAI
3 h
174.3K
Depuis la sortie de ChatGPT en novembre 2022, les chatbots basés sur des LLM se sont imposés dans de très nombreux cas d’usage.
L’idée du chatbot n’est pas nouvelle. Nous avons tous croisé des chatbots inutiles, à configurer si finement qu’ils finissent par être des scripts d’instructions if/else. Ingérables à maintenir, ils n’aident pas l’utilisateur final ; au contraire, ils génèrent de la frustration.
Mais en 2024, les chatbots font leur grand retour, grâce aux grands modèles de langage (LLM).
Dans cet article, vous allez découvrir :
Vous pouvez aussi consulter notre cours Vector Databases for Embeddings with Pinecone et le code-along Building Chatbots with OpenAI API and Pinecone pour aller plus loin.
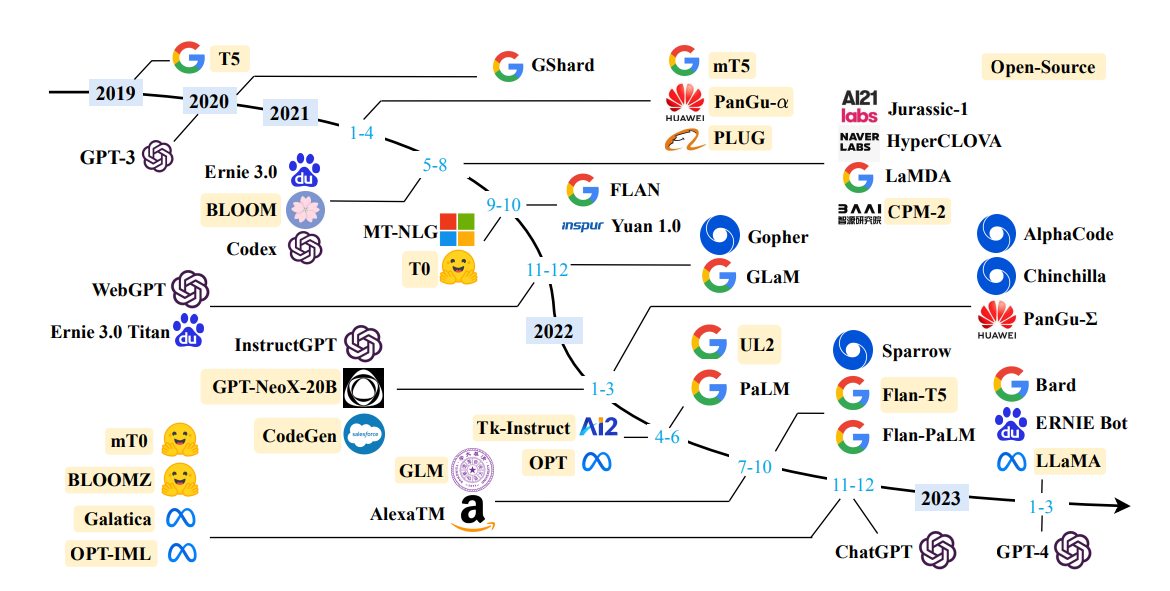
Les grands modèles de langage (LLM) comme GPT-4 sont des algorithmes d’apprentissage automatique avancés qui s’appuient sur l’apprentissage profond, en particulier l’architecture Transformer, pour comprendre et générer du langage naturel.
Ils sont entraînés sur d’immenses jeux de données contenant des milliers de milliards de mots issus d’une grande variété de textes disponibles sur Internet : livres, articles, sites web, dépôts de code, etc. Cet entraînement massif leur permet d’accomplir de nombreuses tâches complexes liées au traitement du langage.
L’une des caractéristiques clés des LLM est leur capacité à générer du texte sur pratiquement n’importe quel sujet, dans des styles et formats variés, de l’écriture créative à la documentation technique.
Les LLM excellent en synthèse de documents, en conversation naturelle (assistant conversationnel), et en traduction multilingue, en capturant même des nuances comme l’argot ou des particularismes régionaux.
Cependant, les LLM ne sont pas exempts de défis. Un problème majeur est la tendance à « halluciner » : produire des informations plausibles mais incorrectes ou absurdes, notamment sur des questions hors de leur périmètre d’entraînement ou à partir d’invites ambiguës.
Autre enjeu clé : le risque de biais dans les réponses, hérité des données d’entraînement ou introduit lors du développement du modèle.
Les LLM représentent une avancée majeure de l’IA, avec un fort potentiel d’innovation et de gains d’efficacité dans de nombreux domaines, mais ils nécessitent une gouvernance rigoureuse pour limiter les risques de biais et de désinformation.
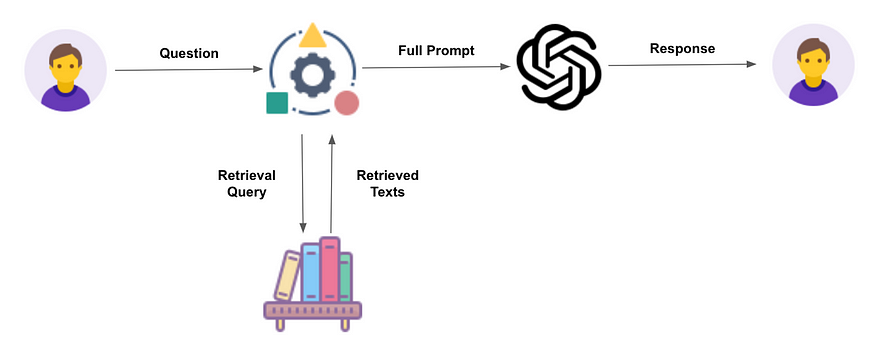
Aussi puissants soient-ils, les LLM ont des limites. Ils peuvent fournir des informations obsolètes, génériques, voire erronées si la requête dépasse leur périmètre d’entraînement.
Ils peuvent également produire des contenus factuellement faux ou incohérents, tout en les présentant comme vrais et logiques : c’est le phénomène bien connu d’hallucination.
RAG vise à atténuer ces problèmes en amenant les LLM à récupérer des informations pertinentes depuis des sources prédéfinies. Cette approche renforce la confiance, car les réponses sont plus exactes et traçables jusqu’à des sources fiables.
Elle offre aussi davantage de contrôle aux développeurs sur les réponses générées, améliorant la qualité et la pertinence des résultats.
Vous pouvez en savoir plus sur la retrieval augmented generation dans notre tutoriel dédié. Voici toutefois les étapes principales du processus.
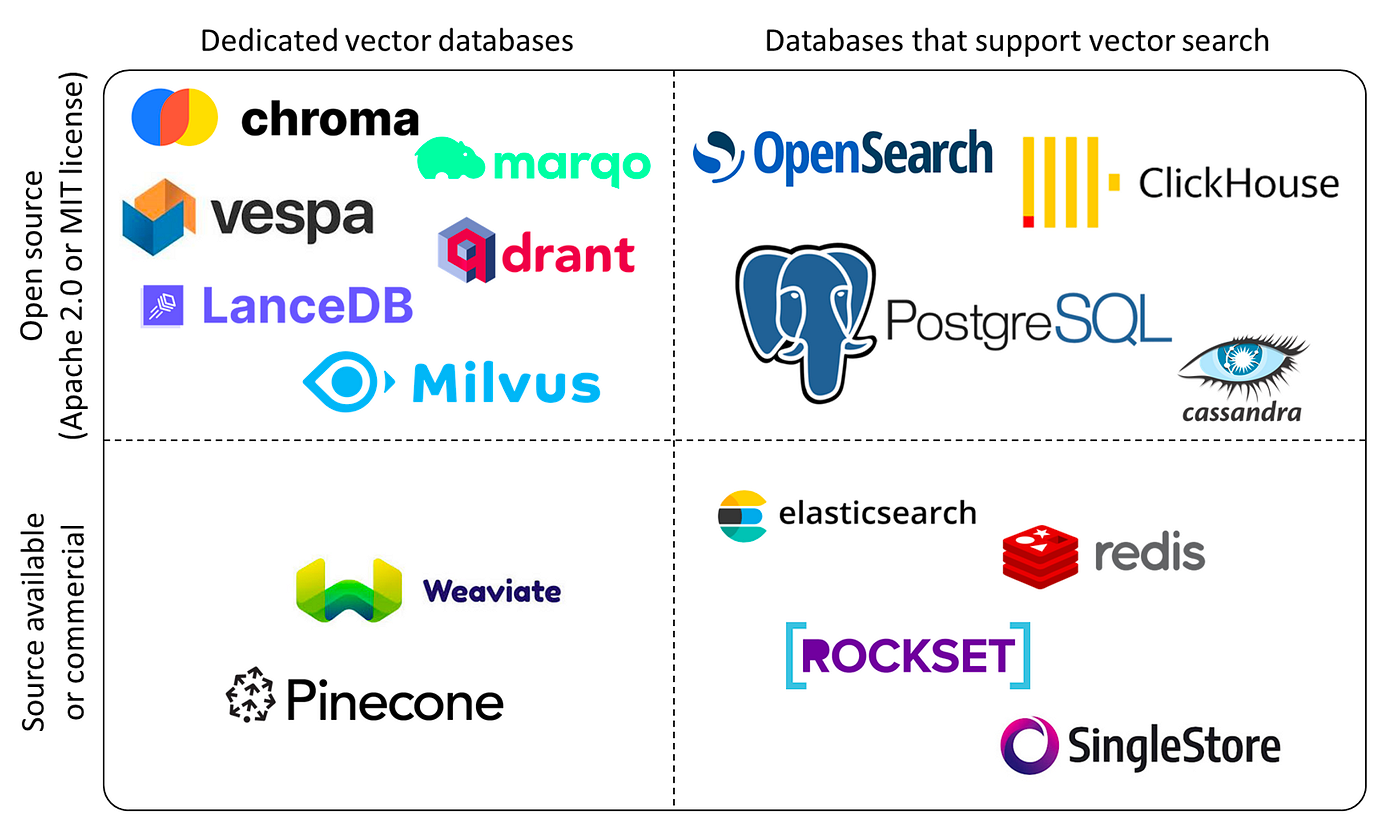
Les bases de données vectorielles sont conçues pour gérer des vecteurs de grande dimension, représentations mathématiques d’attributs ou de caractéristiques. Selon la complexité des données, ces vecteurs peuvent comporter de quelques dizaines à plusieurs milliers de dimensions.
Elles excellent dans les recherches de similarité rapides et précises basées sur la distance ou la similarité entre vecteurs, ce qui permet d’interroger les données de manière sémantique et contextuelle plutôt que par correspondance exacte ou critères pré-définis.
Concrètement, elles servent, par exemple, à retrouver des images similaires (contenu et style), à localiser des documents proches (thème, tonalité), ou à identifier des produits analogues (caractéristiques, notes).
La requête s’effectue via un vecteur représentant l’information recherchée, puis une mesure de similarité évalue la proximité dans l’espace vectoriel. Le résultat est une liste classée de vecteurs les plus proches, avec accès aux données brutes associées à chacun.
Ces bases s’appuient sur divers algorithmes, comme les index k-plus proches voisins (k-NN), et des méthodes telles que HNSW (Hierarchical Navigable Small World) ou IVF (Inverted File Index).
Elles sont essentielles aux applications de RAG : recherche de similarité efficace, enrichissement de contenu, diversité et récupération dynamique de données multimodales. C’est crucial en IA générative, où l’accès à des jeux de données vastes et variés aide à réduire biais et hallucinations.
Pinecone est une base vectorielle populaire, reconnue pour son efficacité et sa simplicité d’usage, notamment à grande échelle. Elle s’adresse aux développeurs et data scientists souhaitant intégrer la recherche vectorielle dans leurs applications.
Pinecone utilise des techniques d’indexation avancées comme la quantification de produit et le hachage sensible à la localité, permettant des recherches de similarité efficaces et précises dans des espaces vectoriels de haute dimension. C’est particulièrement utile pour RAG. Pour en savoir plus, consultez notre tutoriel mastering vector databases with Pinecone.
Dans ce tutoriel, nous utiliserons Pinecone comme base vectorielle.
La plateforme d’API d’OpenAI donne accès à tous les modèles entraînés par OpenAI et disponibles au public : GPT, DALL‑E, Whisper, et d’autres.
L’API s’appelle via des requêtes HTTP, ce qui permet de l’intégrer avec n’importe quel langage pouvant effectuer des appels HTTP. En Python, la bibliothèque openai, installable avec pip install openai, simplifie encore le travail avec ces API.
Working with OpenAI API en Python avec la bibliothèque openai tient en quelques lignes de code.
Exemple Python :
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)
LangChain est un framework pour développer des applications alimentées par des modèles de langage. Il offre un certain niveau d’abstraction qui facilite le prototypage et accélère le passage du prototype à la production. Sa popularité se voit au nombre d’étoiles sur sa page Github.
C’est un framework remarquable. Attention toutefois : il n’est pas encore totalement stable. L’API évolue régulièrement, et il est possible que, lorsque vous lirez la section de code suivante, elle ne fonctionne plus à l’identique. C’est attendu, la bibliothèque étant toujours en pre-release. Au moment d’écrire ces lignes, la dernière version de LangChain est 0.1.4.
Pour mettre en place un back‑end RAG, nous avons besoin d’embeddings de données externes. Si l’on part de données brutes, il faut les transformer en embeddings via l’API d’OpenAI ou d’autres modèles open source.
Générer des embeddings depuis des données brutes est simple. En revanche, avec les API d’OpenAI, la facturation se fait au token.
Pour ce tutoriel, j’ai repris l’essentiel du code ci‑dessous depuis le guide officiel Pinecone sur LangChain. La documentation Pinecone est d’excellente qualité et régulièrement mise à jour.
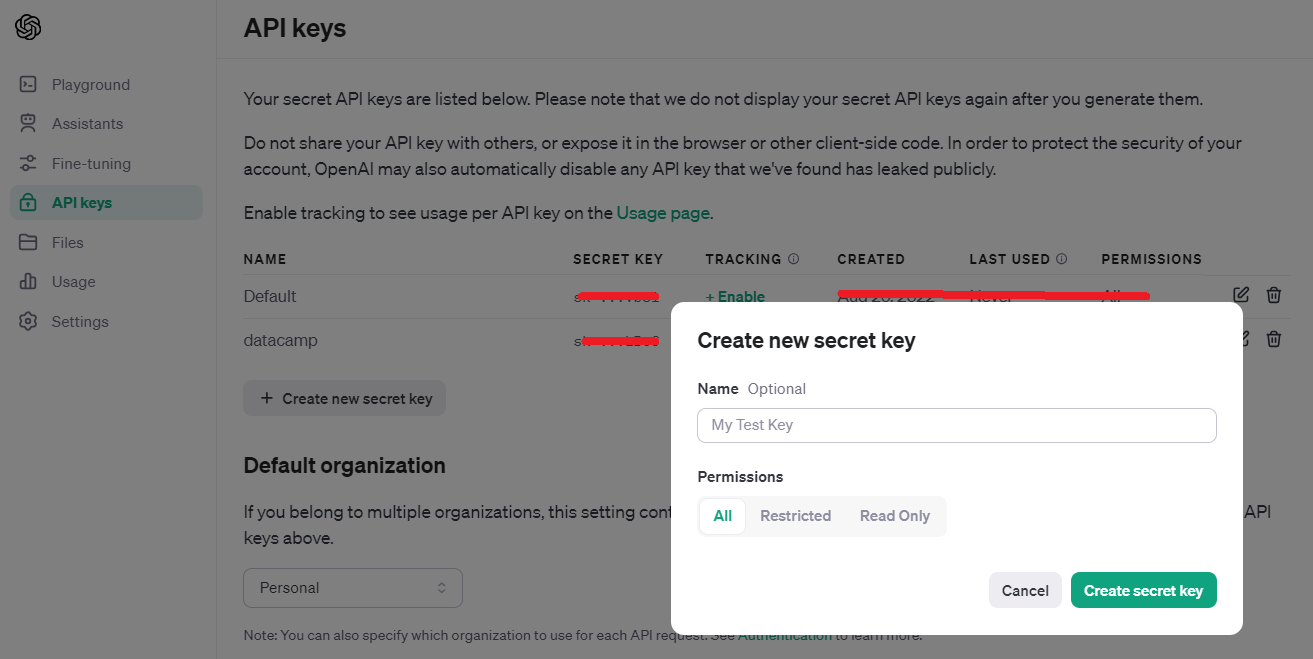
Après avoir créé votre compte OpenAI, rendez‑vous sur https://platform.openai.com/api-keys
Copiez la clé au moment de sa création, car vous ne pourrez plus l’afficher ensuite.
Pour Pinecone, connectez‑vous et cliquez sur API Keys. Utilisez le bouton `Click API Key` dans le coin droit.
Contrairement à OpenAI, avec Pinecone vous n’êtes pas obligé de copier la clé immédiatement : une icône de copie est disponible dans la colonne Actions à tout moment.
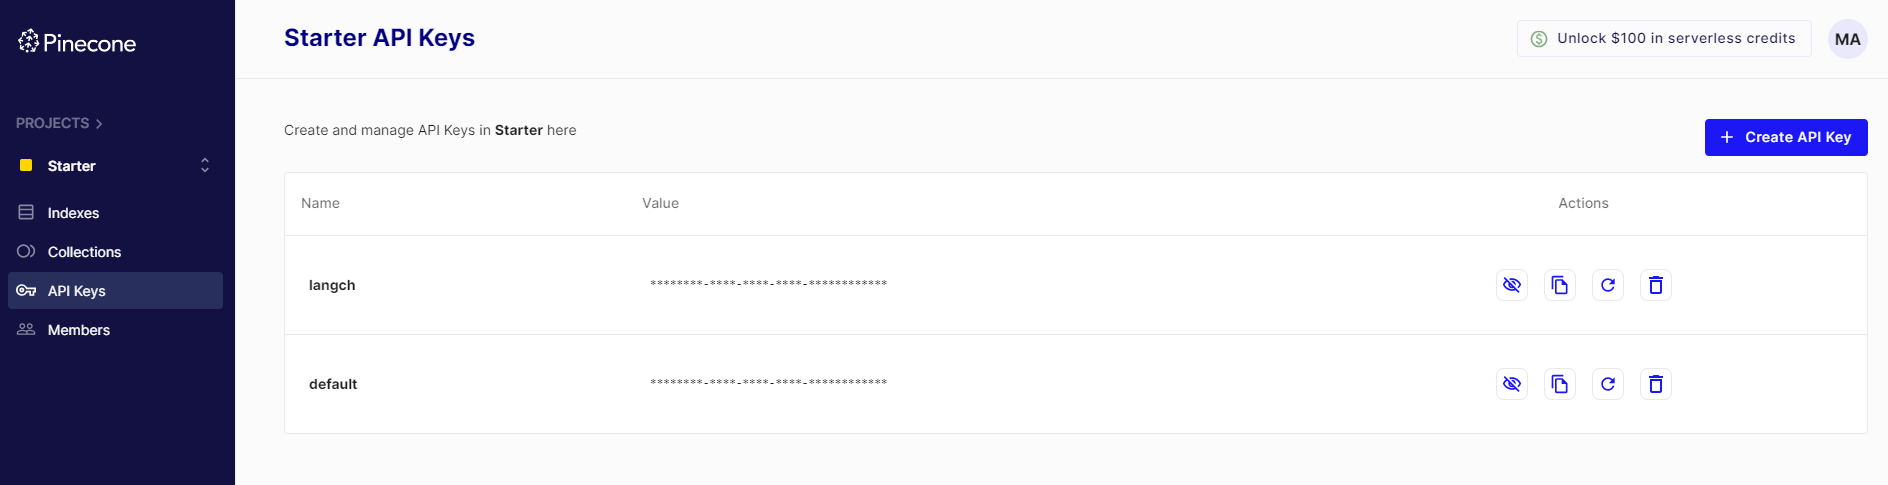
Une fois vos clés API OpenAI et Pinecone récupérées, définissez‑les dans des variables dans votre Notebook. Vous pouvez aussi utiliser le module `os` de Python pour les définir comme variables d’environnement, et adapter le code ci‑dessous en conséquence.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Pour suivre ce tutoriel, installez les bibliothèques suivantes avec pip.
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0La bibliothèque pinecone-datasets propose quelques jeux de données déjà vectorisés avec le modèle embedding-ada-002 d’OpenAI. Nous utiliserons l’exemple wikipedia-simple-text-embedding-ada-002-100K.
Comme son nom l’indique, il contient 100 000 documents. Nous n’en échantillonnerons que 30 000 pour ce tutoriel. Même s’il n’y a pas d’impact de coût (les embeddings sont fournis pour les 100 000 documents), cet échantillonnage accélère le processus.
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')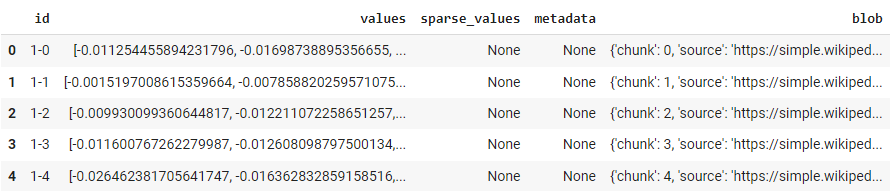
# suppression de la colonne metadata et renommage de blob en metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# échantillon de 30k documents
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configuration du client
pc = Pinecone(api_key=PINECONE_API_KEY)
# configuration du spec serverless
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# suppression de l'index s'il existe déjà
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# création d'un nouvel index
pc.create_index(
index_name,
dimension=1536, # dimension de text-embedding-ada-002
metric='dotproduct',
spec=spec
)
Pour se connecter à l’index et consulter ses statistiques :
index = pc.Index(index_name)
index.describe_index_stats()
Sortie attendue :
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536 est la dimension des embeddings du modèle ada-002. Le nombre de vecteurs est nul car nous n’avons pas encore ingéré de données.
L’insertion dans l’index langchain-retrieval-augmentation-fast est très simple :
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Cette commande prend quelques minutes.
Après l’insertion, vous pouvez visualiser les données dans l’interface Pinecone :
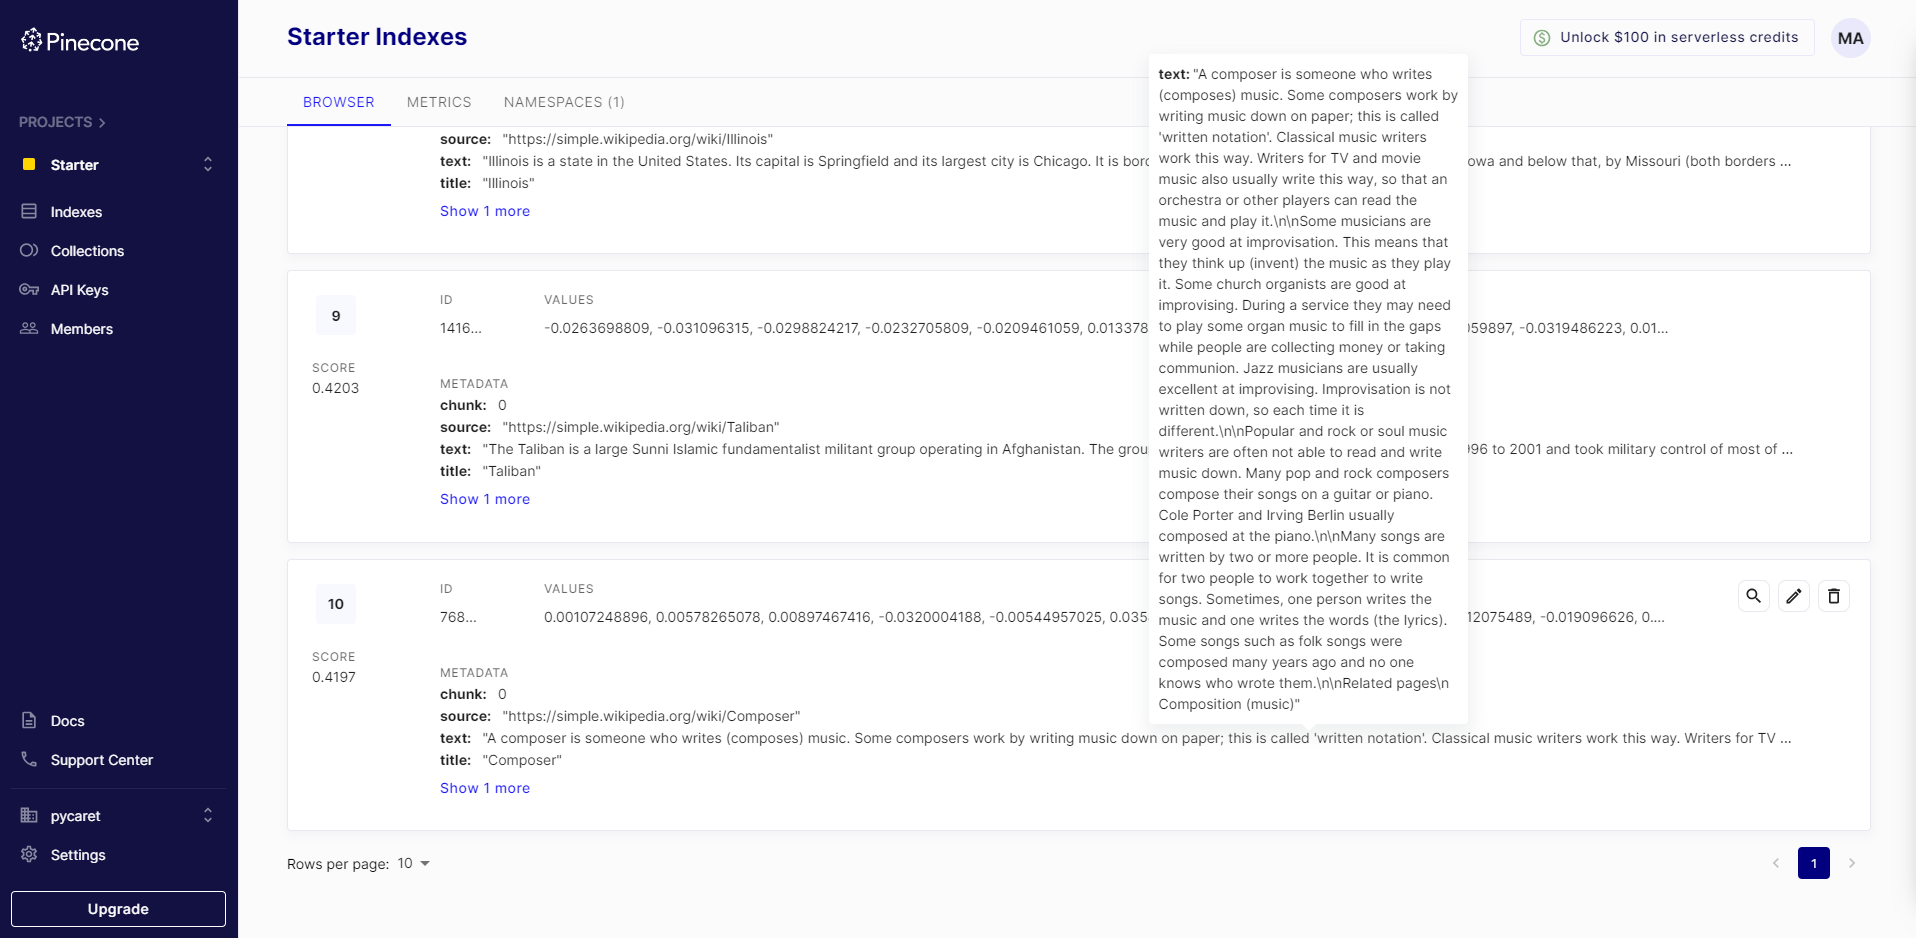
Maintenant que l’index est créé et alimenté via l’API Pinecone, passons à LangChain. L’étape suivante consiste à initialiser un magasin vectoriel LangChain avec le même index.
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
Initialiser le magasin vectoriel :
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
Vous pouvez maintenant utiliser l’objet vectorstore pour interroger les données et afficher les N meilleurs résultats :
query = "What is Schizophrenia?"


vectorstore.similarity_search(query, k=3)
La sortie est un objet document à partir duquel vous pouvez extraire facilement le texte. Il retourne ici les 3 meilleurs résultats selon la métrique définie à l’étape 4, en l’occurrence dotmatrix.
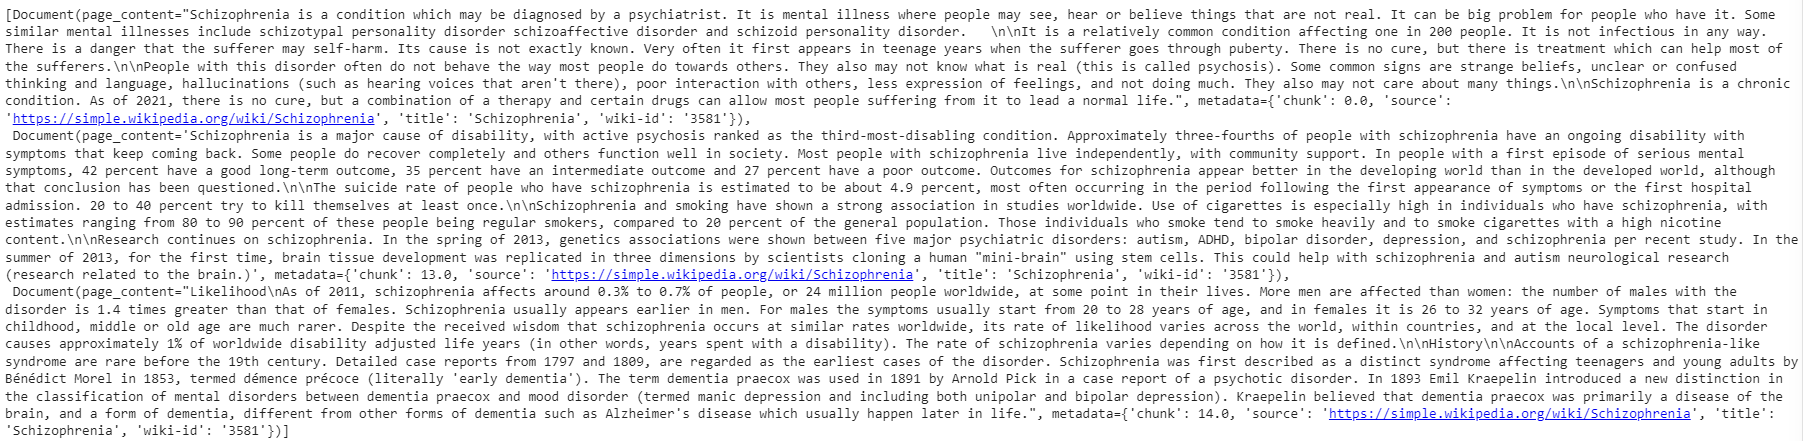
Il ne reste plus qu’à encapsuler un LLM. Pour cela, importez les classes ChatOpenAI et RetrievalQA de LangChain.
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# modèle de complétion
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
La sortie de qa.run(query) est la réponse du modèle de langage.
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....Cette réponse provient d’un des documents du `dataset`. Si vous souhaitez aussi récupérer la source (souvent nécessaire dans les applications RAG), modifiez légèrement le code ci‑dessus.
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
Sortie :
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
Remarquez que la sortie est cette fois un dictionnaire qui inclut la `source`.
Dans cet article, nous avons exploré l’une des applications phares des LLM : la technique de Retrieval Augmented Generation (RAG), qui améliore la fiabilité et la pertinence des réponses des chatbots basés sur des modèles comme GPT‑4.
L’évolution des chatbots, des systèmes à règles simples vers des agents conversationnels pilotés par l’IA, marque un tournant technologique. Les LLM apportent polyvalence et intelligence, capables de conversations plus naturelles et contextualisées.
Nous avons aussi vu le rôle des bases de données vectorielles, en nous concentrant sur Pinecone, pour stocker et retrouver des vecteurs de grande dimension : un pilier de RAG.
La mise en pratique s’est appuyée sur des exemples de code utilisant les API d’OpenAI et de Pinecone, ainsi que le framework LangChain en Python. Ces outils simplifient le développement, pour créer rapidement des chatbots dopés à l’IA, adaptés à de nombreux usages.
Pour approfondir Vector Databases for Embeddings with Pinecone ou working with the OpenAI API, découvrez nos cours afin d’élargir vos compétences sur ces sujets.
Commencez votre parcours en IA dès aujourd’hui !
Cours
Cours