
Last chance! 50% off DataCamp Premium
Sale ends in
Dalla pubblicazione di ChatGPT a novembre 2022, i chatbot basati su LLM sono diventati protagonisti in moltissimi casi d’uso.
L’idea di chatbot non è nuova. Abbiamo tutti visto chatbot inutili ovunque, che richiedono una configurazione così capillare da sembrare quasi script con regole if-else. Diventano un incubo da mantenere e non aiutano l’utente finale; anzi, spesso ottengono l’effetto opposto, frustandolo.
Ma nel 2024, i chatbot sono tornati, grazie ai Large Language Models (LLM).
In questo blog imparerai:
Puoi anche dare un’occhiata al nostro corso Vector Databases for Embeddings with Pinecone e al code-along su Building Chatbots with OpenAI API and Pinecone per approfondire.
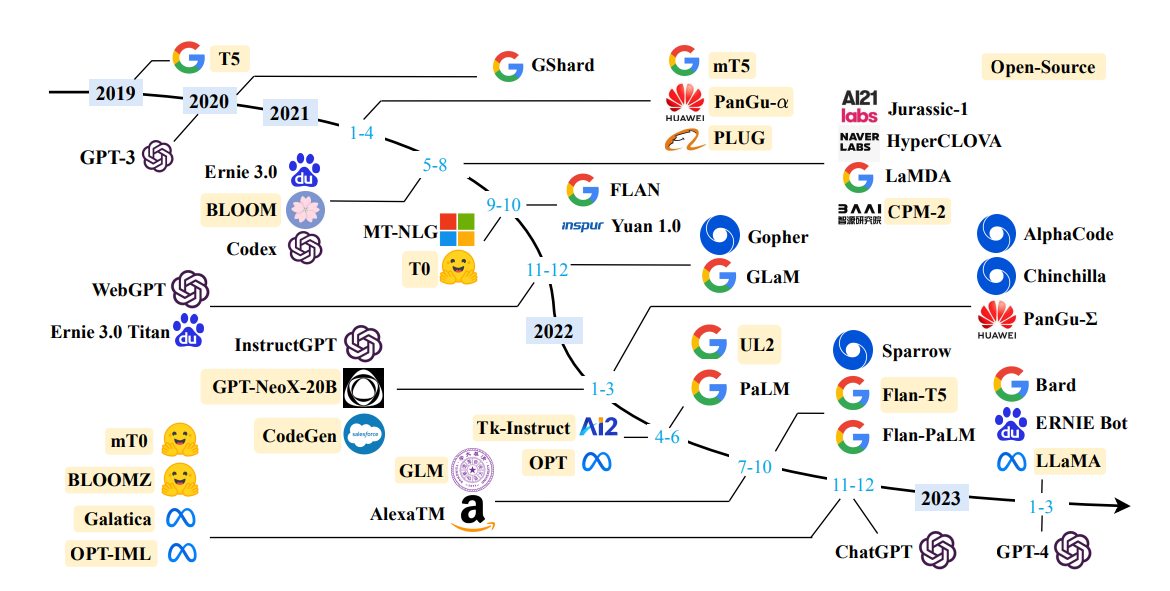
I Large Language Models (LLM) come GPT-4 sono avanzati algoritmi di machine learning che sfruttano tecniche di deep learning, in particolare l’architettura transformer, per comprendere e generare linguaggio naturale.
Sono addestrati su dataset enormi contenenti trilioni di parole provenienti da un’ampia gamma di testi disponibili su Internet, come libri, articoli, siti web e repository di codice. Questo addestramento esteso permette loro di svolgere una varietà di compiti complessi legati all’elaborazione del linguaggio.
Una delle caratteristiche chiave degli LLM è la capacità di generare testo praticamente su qualsiasi argomento. Questa abilità si estende a stili e formati diversi, dalla scrittura creativa alla documentazione tecnica.
Gli LLM sono abili in compiti come il riassunto, in cui sanno condensare documenti lunghi in sintesi concise, e nella conversazione, permettendo di sostenere dialoghi naturali e scorrevoli con gli utenti. Sono anche efficaci nella traduzione tra lingue, cogliendo persino sfumature come gerghi e dialetti regionali.
Tuttavia, gli LLM non sono privi di sfide. Un problema importante è che possono "allucinare", ovvero generare informazioni plausibili ma errate o senza senso, soprattutto quando affrontano richieste al di fuori dei loro dati di addestramento o prompt ambigui.
Un altro problema chiave è il potenziale bias negli output degli LLM, derivante da bias presenti nei dati di addestramento o introdotti durante lo sviluppo del modello.
Gli LLM rappresentano un progresso significativo nell’IA, offrendo un enorme potenziale di innovazione ed efficienza in vari settori, ma richiedono anche una gestione attenta per mitigare rischi come bias e disinformazione.
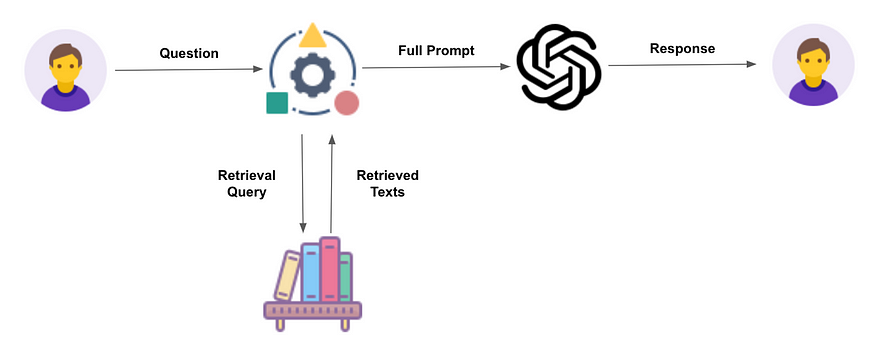
Gli LLM, pur essendo potenti, hanno alcune limitazioni. Possono fornire informazioni datate, generiche o persino false se la domanda va oltre l’ambito dei loro dati di addestramento.
Possono anche generare contenuti fattualmente scorretti o privi di senso che il modello presenta come veri o logici. Questo fenomeno è noto come allucinazione.
RAG mira a mitigare questi problemi indirizzando gli LLM a recuperare informazioni pertinenti da fonti predefinite. Questo approccio aumenta la fiducia degli utenti, poiché gli output del modello sono più accurati e attribuibili a fonti affidabili.
Fornisce anche maggiore controllo agli sviluppatori sulle risposte generate dall’LLM, migliorando la qualità e l’applicabilità complessiva del sistema.
Puoi approfondire la retrieval augmented generation nel nostro tutorial dedicato. Qui sotto, però, riassumiamo i passaggi principali del processo.
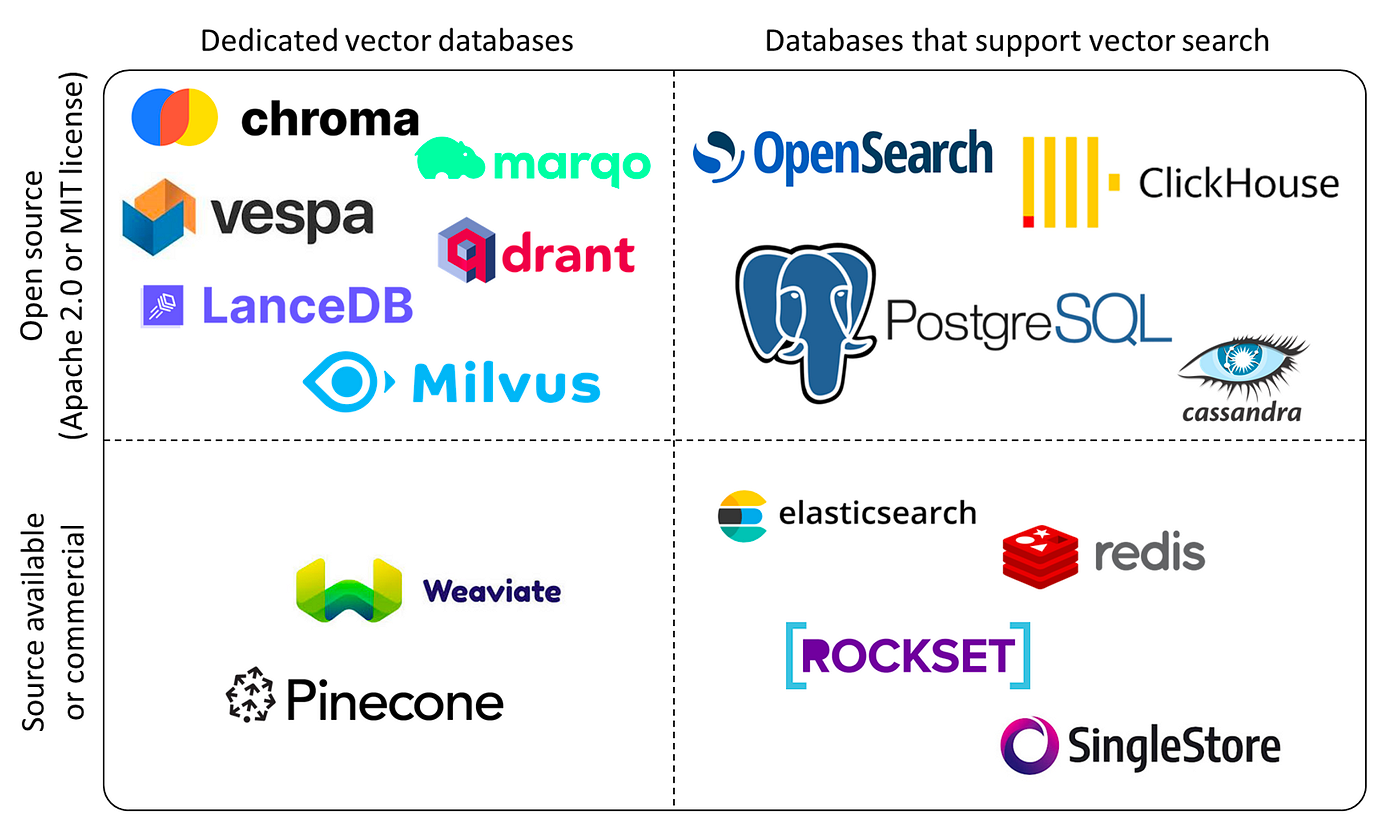
I database vettoriali sono tipi specializzati di database progettati per gestire vettori ad alta dimensionalità, rappresentazioni matematiche di attributi o caratteristiche dei dati. A seconda della complessità e granularità dei dati, questi vettori possono avere da decine a migliaia di dimensioni.
Questo tipo di database è particolarmente adatto a eseguire ricerche e recuperi per similarità in modo rapido e accurato, basandosi sulla distanza o similarità tra vettori, consentendo un approccio di interrogazione più semantico o contestuale rispetto a corrispondenze esatte o criteri predefiniti.
In pratica, i database vettoriali possono essere utilizzati per vari scopi. Ad esempio, possono trovare immagini simili a una data immagine in base ai contenuti visivi e allo stile, individuare documenti simili a uno specifico in base a tema e sentiment, oppure identificare prodotti simili a un certo prodotto in base a caratteristiche e valutazioni.
Il processo di interrogazione in un database vettoriale prevede l’uso di un vettore di query che rappresenta le informazioni o i criteri desiderati e l’applicazione di una misura di similarità per determinare la vicinanza dei vettori nello spazio vettoriale. Il risultato è un elenco ordinato di vettori con punteggi di similarità elevati rispetto al vettore di query, che consente di accedere ai dati grezzi corrispondenti associati a ciascun vettore.
I database vettoriali sono alimentati da vari algoritmi, come gli indici k-nearest neighbor (k-NN), e costruiti con metodi come gli algoritmi HNSW (Hierarchical Navigable Small World) e IVF (Inverted File Index).
I database vettoriali sono fondamentali per le applicazioni di retrieval augmented generation (RAG). Offrono ricerca per similarità efficiente, espansione dei contenuti, diversità e recupero dinamico di dati multimodali. Questa capacità è cruciale nell’IA generativa, dove l’accesso a dataset su larga scala e diversificati è essenziale per ridurre bias e allucinazioni nei modelli di IA.
Pinecone è un database vettoriale popolare che si distingue per efficienza e facilità d’uso, soprattutto nella gestione di scenari con dati su larga scala. È pensato per sviluppatori e data scientist che vogliono implementare funzionalità di vector search in varie applicazioni.
Pinecone impiega tecniche di indicizzazione avanzate come la quantizzazione di prodotto e il locality-sensitive hashing, che consentono ricerche per similarità efficienti e accurate in spazi vettoriali ad alta dimensionalità. Questo lo rende particolarmente utile per le applicazioni RAG. Puoi saperne di più su come padroneggiare i database vettoriali con Pinecone nel nostro tutorial dedicato.
In questo tutorial useremo Pinecone come database vettoriale.
La piattaforma API di OpenAI fornisce accesso a tutti i modelli addestrati da OpenAI e disponibili al pubblico. Include GPT, DALL-E, Whisper e altri modelli.
L’API è accessibile tramite richieste HTTP, quindi puoi integrarla con qualsiasi linguaggio di programmazione che supporti tali richieste. Tuttavia, per Python esiste una libreria chiamata openai che puoi installare con pip install openai e che semplifica ulteriormente il lavoro con queste API.
Lavorare con le API di OpenAI in Python usando la libreria openai richiede solo poche righe di codice.
Esempio in Python:
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)
LangChain è un framework per sviluppare applicazioni alimentate da modelli linguistici. Fornisce un certo livello di astrazione che rende facile e veloce sviluppare prototipi e accelerare il passaggio dal prototipo alla produzione. La crescita e la popolarità del framework sono evidenti dal numero di stelle sulla loro pagina Github.
È un framework straordinario. Tuttavia, una cautela al momento è che non è ancora stabile. L’API continua a cambiare ed è possibile che, quando leggerai il codice nella prossima sezione, non funzioni più. È normale, perché la libreria è ancora in pre-release. Al momento della stesura di questo blog, l’ultima versione di Langchain è la 0.1.4.
Per implementare un back-end RAG, ci servono gli embedding dei dati esterni. Se partiamo da dati grezzi, dovremo effettuare l’embedding usando le API di embedding di OpenAI o altri embedding open source.
Effettuare l’embedding di dati grezzi è semplice. Tuttavia, se usi le API di OpenAI, pagherai in base ai token.
Per questo tutorial, ho ripreso la maggior parte del codice in questa sezione dalla guida ufficiale di Pinecone su LangChain. La documentazione di Pinecone è eccezionalmente ben fatta e sempre aggiornata.
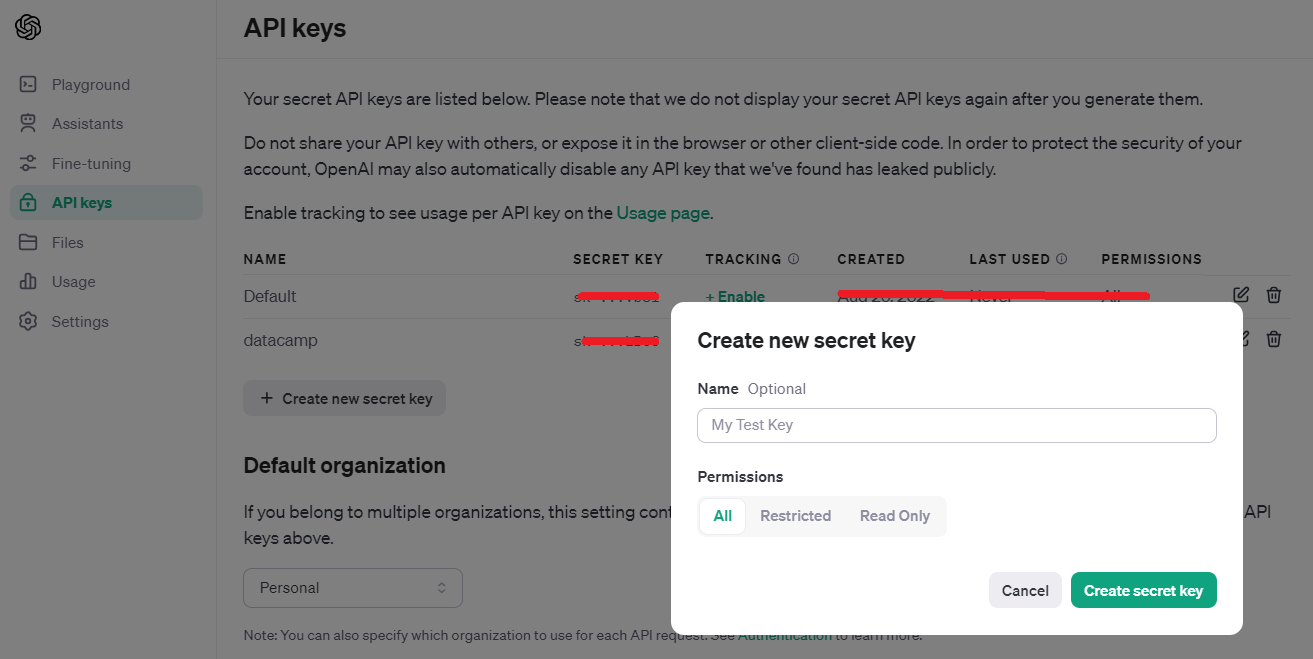
Dopo aver creato un account OpenAI, vai su https://platform.openai.com/api-keys
Devi copiare la chiave quando la generi, perché non c’è modo di vederla o copiarla in seguito.
Per Pinecone, accedi al tuo account e fai clic su API Keys. Puoi premere il pulsante `Click API Key` nell’angolo destro.
A differenza di OpenAI, con Pinecone non è necessario copiare la chiave API al momento della generazione, perché sotto la colonna Actions c’è un’icona di copia che puoi usare quando vuoi.
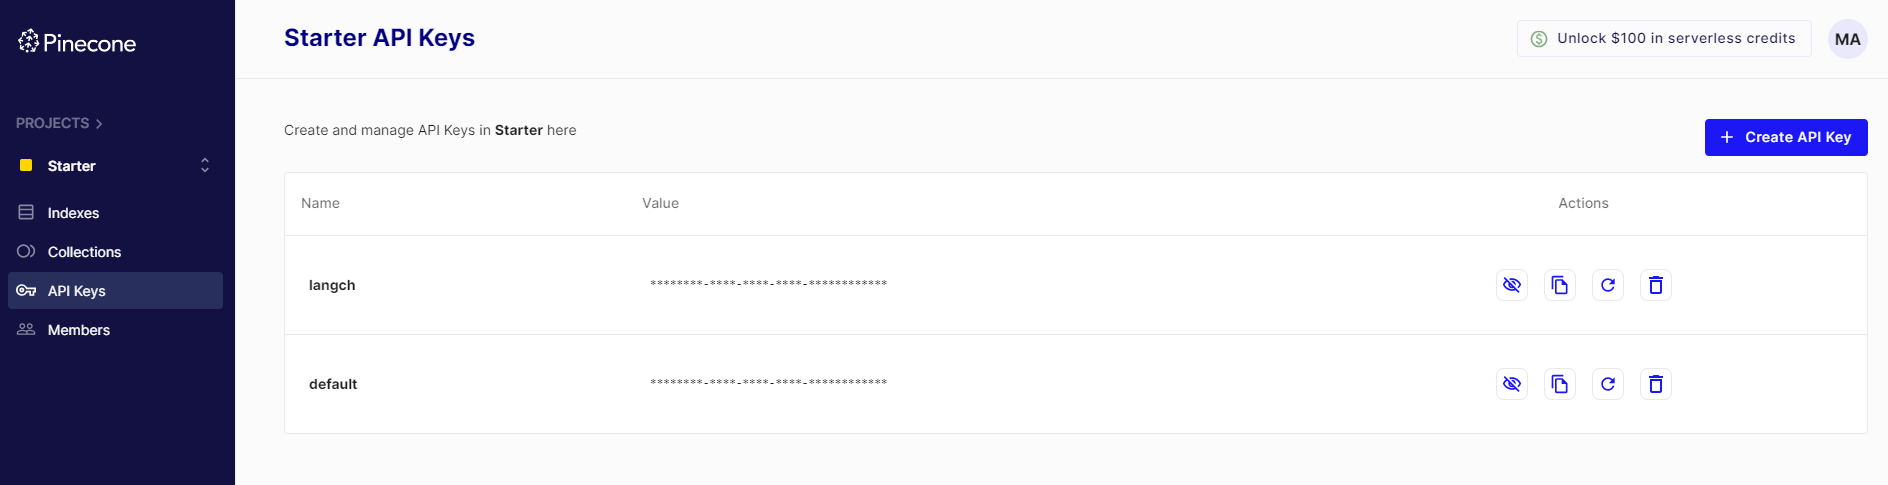
Una volta ottenute le chiavi API da OpenAI e Pinecone, impostale in variabili nel Notebook. In alternativa, puoi usare il modulo `os` in Python e impostarle come variabili d’ambiente. Dovrai poi apportare le modifiche corrispondenti al codice qui sotto, se scegli questa strada.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Per realizzare questo tutorial, ti servono le seguenti librerie installate con pip.
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0La libreria pinecone-datasets fornisce alcuni dataset di esempio già convertiti in embedding con il modello embedding-ada-002 di OpenAI. Useremo un dataset di esempio chiamato wikipedia-simple-text-embedding-ada-002-100K.
Come suggerisce il nome, contiene 100.000 documenti. Tuttavia, in questo tutorial preleveremo solo i primi 30.000 record. Anche se il costo non cambia perché gli embedding sono forniti per tutti i 100.000 documenti, il campionamento serve solo ad accelerare il processo.
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')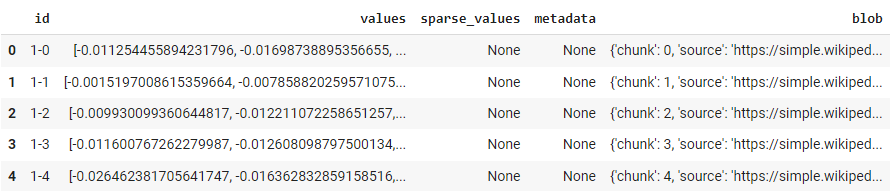
# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# sample 30k documents
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)
# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# check for and delete index if already exists
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# we create a new index
pc.create_index(
index_name,
dimension=1536, # dimensionality of text-embedding-ada-002
metric='dotproduct',
spec=spec
)
Per connetterti all’indice e verificarne le statistiche:
index = pc.Index(index_name)
index.describe_index_stats()
Questo sarà l’output:
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536 è la dimensionalità degli embedding del modello ada-002. Il conteggio dei vettori è zero perché non abbiamo ancora inserito alcun dato (vettori).
Inserire i dati in questo indice langchain-retrieval-augmentation-fast è piuttosto semplice:
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Questo comando richiederà alcuni minuti per completarsi.
Dopo l’inserimento, puoi vederli anche nella UI di Pinecone:
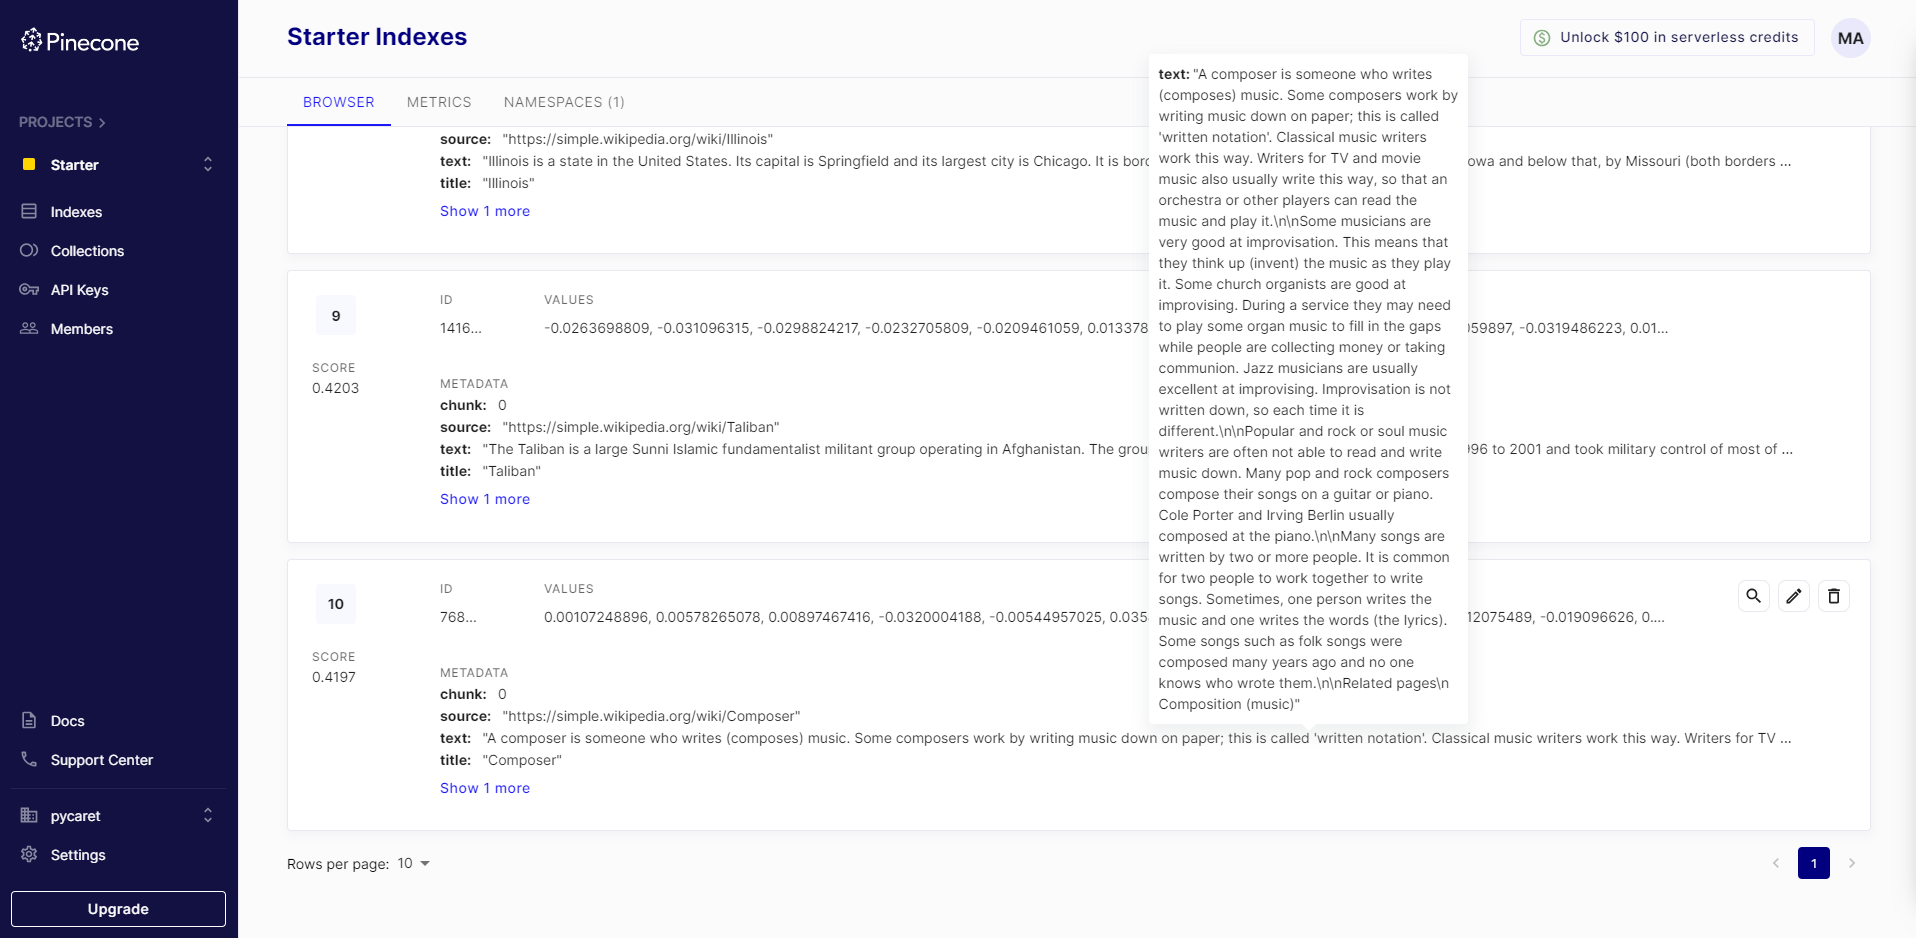
Ora che abbiamo creato un indice e inserito i dati nell’indice usando le API di Pinecone, passiamo a LangChain. Il prossimo passo consiste nell’inizializzare un archivio vettoriale LangChain usando LangChain e riutilizzando lo stesso indice che abbiamo creato.
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
Per inizializzare l’archivio vettoriale:
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
Ora puoi usare l’oggetto vectorstore per interrogare i dati e vedere i primi N risultati:
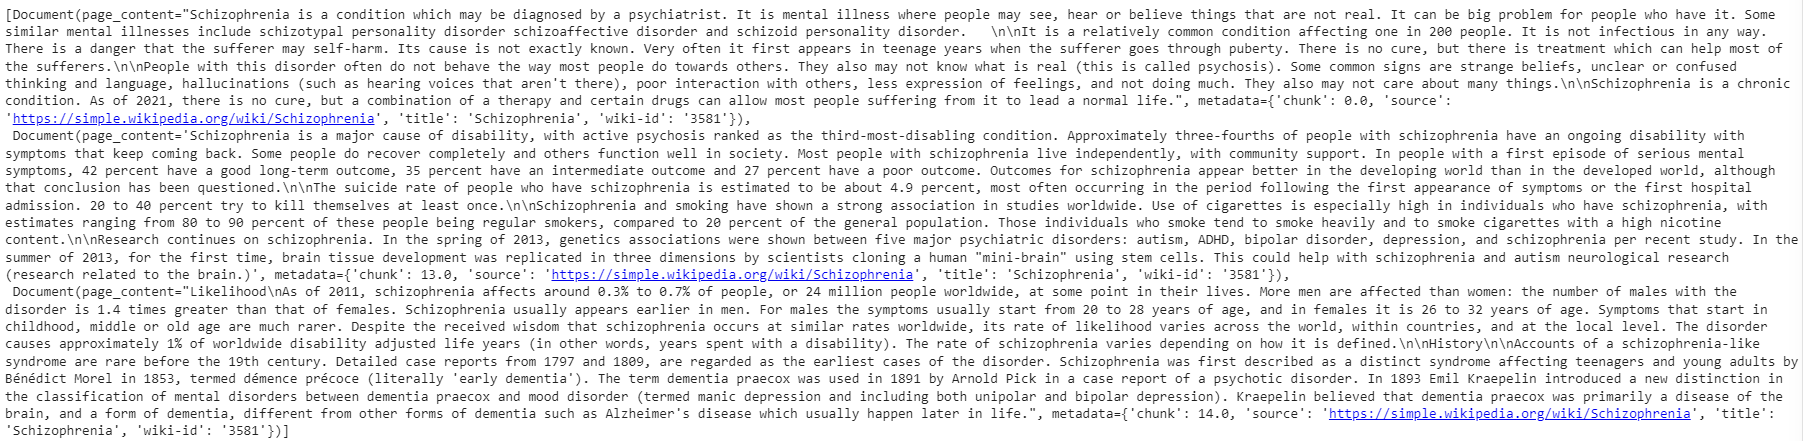
query = "What is Schizophrenia?"


vectorstore.similarity_search(query, k=3)
L’output è un oggetto documento da cui puoi facilmente estrarre stringhe, ma in sostanza mostra i primi 3 documenti corrispondenti in base alla metrica scelta nel Passo 4, che in questo caso è dotmatrix.
Questo è il passaggio finale della nostra applicazione. Ora vogliamo metterci intorno un LLM. Per farlo, importerai le classi ChatOpenAI e RetrievalQA da LangChain.
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# completion llm
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
L’output di qa.run(query) è la risposta del modello linguistico.
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....Questa risposta proviene da uno dei documenti nel `dataset`. Se vuoi anche recuperare la fonte (spesso necessario nelle applicazioni RAG) devi apportare una piccola modifica al codice sopra.
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
Output:
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
Nota che questa volta l’output è un dizionario in cui puoi trovare la `source`.
In questo blog abbiamo esplorato l’applicazione più popolare degli LLM, la tecnica Retrieval Augmented Generation (RAG), approfondendo come migliori affidabilità e pertinenza delle risposte dei chatbot basati su Large Language Models come GPT-4.
L’evoluzione dei chatbot da sistemi semplici e basati su regole ad agenti conversazionali sofisticati e guidati dall’IA segna un salto tecnologico significativo. Gli LLM portano nei chatbot un nuovo livello di versatilità e intelligenza, in grado di sostenere conversazioni più naturali e consapevoli del contesto.
Abbiamo anche esaminato il ruolo dei database vettoriali, con un focus su Pinecone, nello storage e nel recupero di vettori ad alta dimensionalità. Questi database sono fondamentali per implementare RAG.
L’implementazione pratica di questi concetti è stata dimostrata con esempi di codice che sfruttano le API di OpenAI e Pinecone e il framework LangChain in Python. Questi strumenti semplificano il processo di sviluppo, rendendo più accessibile la creazione rapida ed efficace di chatbot basati sull’IA, su misura per un’ampia gamma di applicazioni.
Per saperne di più su Vector Databases for Embeddings with Pinecone o su come lavorare con le API di OpenAI, dai un’occhiata ai nostri corsi, che possono aiutarti ad approfondire questi argomenti.
Inizia oggi il tuo percorso nell’IA!
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min




