
Kurs
OpenAI API ile Çalışmak
3 sa
178.4K
Kasım 2022’de ChatGPT’nin yayınlanmasından bu yana, LLM Chatbot’lar pek çok farklı kullanım alanında öne çıkan özellikler haline geldi.
Chatbot fikri yeni değil. Hepimiz, if-else kurallarıyla neredeyse betiklenmiş olacak kadar derin yapılandırma gerektiren, faydadan çok zarar veren, kullanıcıyı hayal kırıklığına uğratan kullanışsız botları gördük.
Ancak 2024’te Chatbot’lar geri döndü; bunun sebebi Büyük Dil Modelleri (LLM’ler).
Bu blogda şunları öğreneceksiniz:
Daha fazlası için Pinecone ile Gömeler için Vektör Veritabanları kursumuzu ve OpenAI API ve Pinecone ile Chatbot Geliştirme kod eşliğini inceleyebilirsiniz.
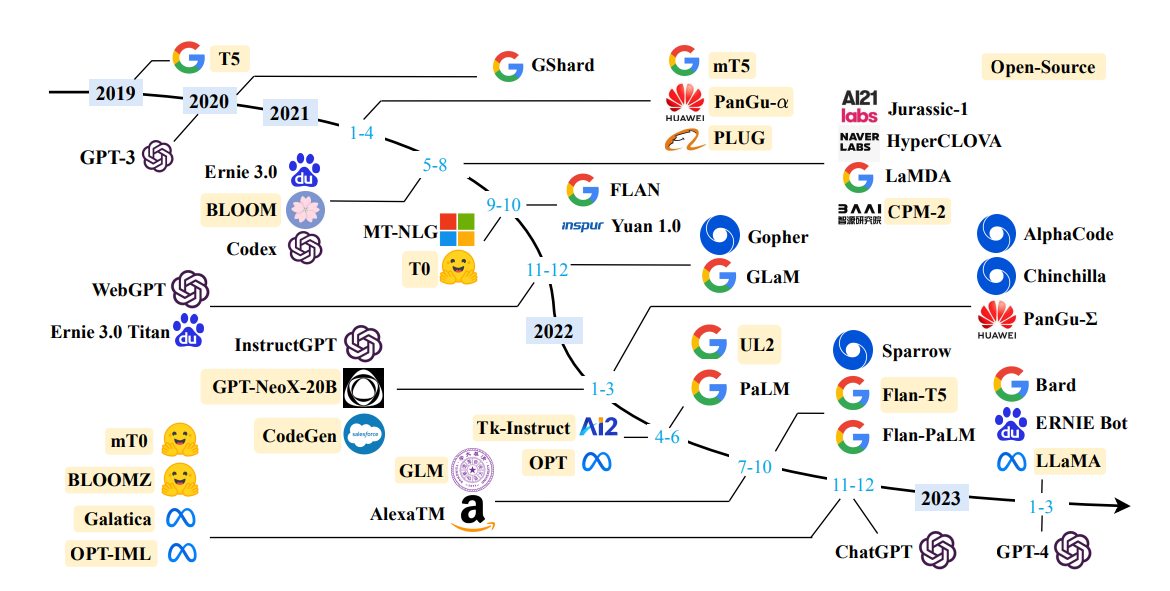
GPT-4 gibi Büyük Dil Modelleri (LLM’ler), doğal dili anlamak ve üretmek için derin öğrenme tekniklerinden, özellikle de transformer mimarisinden yararlanan gelişmiş makine öğrenmesi algoritmalarıdır.
Kitaplar, makaleler, web siteleri ve kod depoları gibi internetten derlenen çok çeşitli metinlerden oluşan trilyonlarca kelime içeren devasa veri kümeleri üzerinde eğitilirler. Bu kapsamlı eğitim, dili işle ilgili çok çeşitli karmaşık görevleri gerçekleştirmelerini sağlar.
LLM’lerin temel özelliklerinden biri, neredeyse her konuda metin üretebilme yeteneğidir. Bu yetenek, yaratıcı yazılardan teknik dokümantasyona kadar çeşitli üslup ve formatları kapsar.
LLM’ler, uzun belgeleri özlü özetlere indirgeyebildikleri özetleme ve kullanıcılarla doğal ve akıcı diyaloglar kurabilen sohbet yapay zekâsı gibi görevlerde yetkindir. Dilleri arası çeviri konusunda da başarılıdırlar; argo ve bölgesel ağızlar gibi incelikleri dahi yakalayabilirler.
Bununla birlikte LLM’lerin zorlukları da vardır. Önemli bir sorun, eğitim verisinin kapsamı dışındaki sorgular veya muğlak istemler söz konusu olduğunda, makul görünen ancak yanlış ya da anlamsız bilgiler üretebilmeleridir; bu olgu “halüsinasyon” olarak bilinir.
Bir diğer önemli sorun ise, eğitim verilerinde bulunan veya model geliştirilirken eklenen önyargılardan kaynaklanabilen LLM çıktılarındaki önyargı potansiyelidir.
LLM’ler, yapay zekâda kayda değer bir ilerlemeyi temsil eder; birçok alanda yenilik ve verimlilik için büyük potansiyel sunarlar. Ancak önyargı ve yanlış bilgi gibi riskleri azaltmak için dikkatli yönetim gerektirirler.
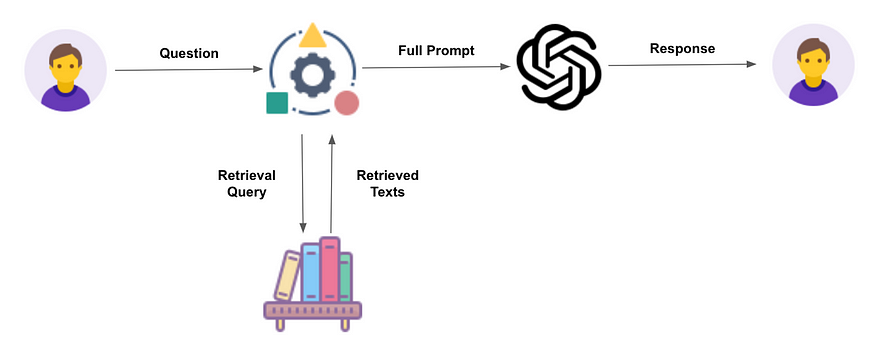
LLM’ler güçlü olmakla birlikte belirli sınırlamalara sahiptir. Sorgu, eğitim verilerinin kapsamını aştığında eski, genel geçer veya hatta yanlış bilgi sağlayabilirler.
Ayrıca, modeli gerçek ya da mantıklıymış gibi sunduğu gerçeğe aykırı veya anlamsız bilgiler de üretebilirler. Bu olgu, meşhur şekilde Halüsinasyon olarak bilinir.
RAG, LLM’leri önceden belirlenmiş kaynaklardan ilgili bilgileri almaya yönlendirerek bu sorunları hafifletmeyi amaçlar. Bu yaklaşım, model çıktıları daha doğru ve güvenilir kaynaklara dayandırılabildiği için kullanıcı güvenini artırır.
Ayrıca geliştiricilere LLM’in ürettiği yanıtlara daha fazla kontrol sağlar ve sistemin genel kalite ve uygulanabilirliğini artırır.
Retrieval augmented generation hakkında ayrı dersimizde daha fazla bilgi edinebilirsiniz. Ancak aşağıda sürecin ana adımlarını özetledik.
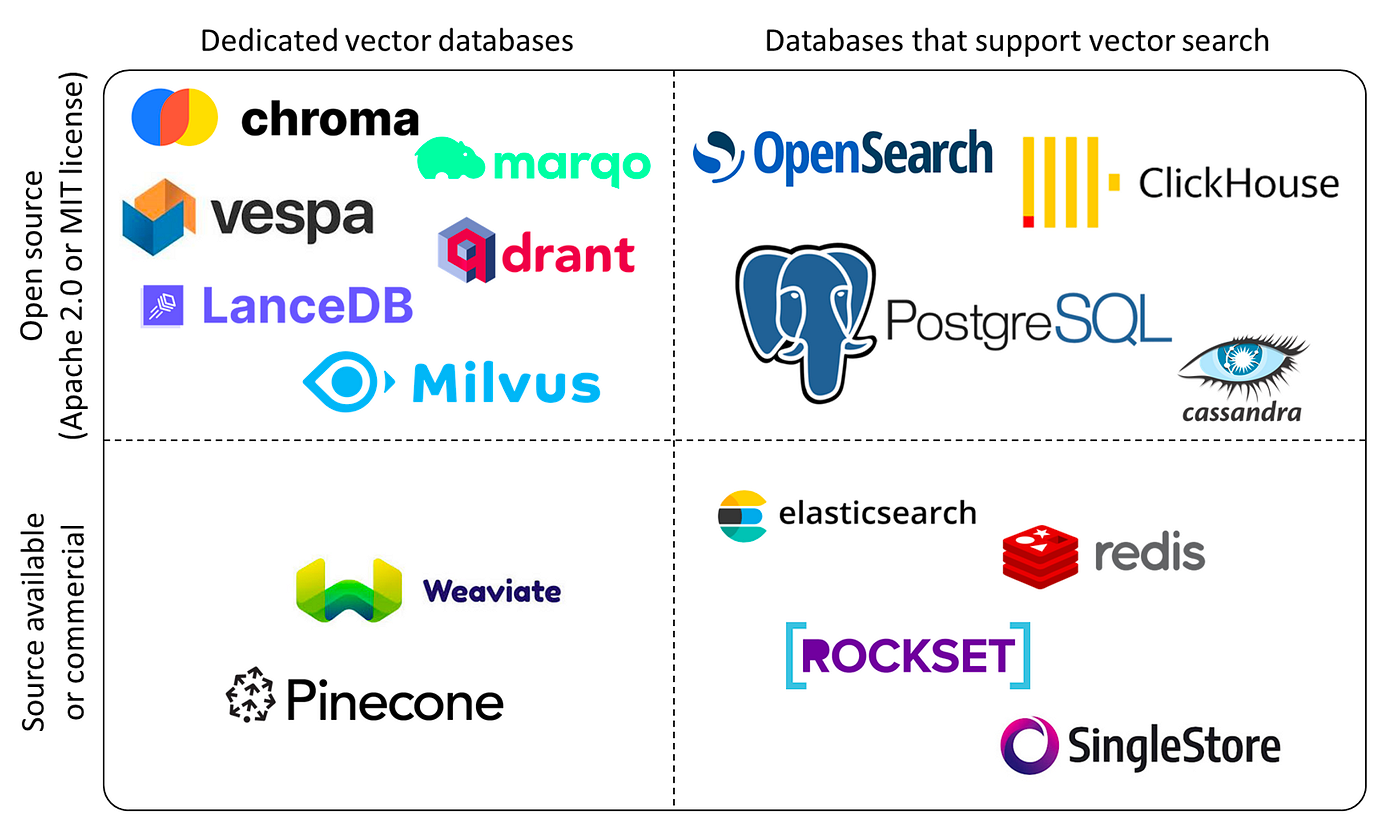
Vektör veritabanları, veri özniteliklerinin veya özelliklerinin matematiksel temsilleri olan yüksek boyutlu vektörleri işlemek için tasarlanmış özel veritabanlarıdır. Bu vektörler, verinin karmaşıklığı ve ayrıntı düzeyine bağlı olarak onlarca ila binlerce boyuta sahip olabilir.
Bu veritabanı türü, vektör uzaklığına veya benzerliğine dayalı hızlı ve doğru benzerlik aramaları ve getirimi gerçekleştirmede özellikle yetkindir; böylece geleneksel birebir eşleşmelere veya önceden tanımlanmış kriterlere güvenmek yerine daha anlamsal ya da bağlamsal bir sorgu yaklaşımı sağlar.
Pratikte vektör veritabanları çeşitli amaçlarla kullanılabilir. Örneğin, görsel içerik ve stile göre verilen bir görsele benzer görselleri bulabilir, konu ve duygu durumuna göre belirli bir belgeye benzer belgeleri tespit edebilir veya özellikler ve puanlamalara göre belirli bir ürüne benzer ürünleri belirleyebilirler.
Bir vektör veritabanında sorgulama süreci, arzu edilen bilgi veya kriterleri temsil eden bir sorgu vektörünün kullanılması ve vektör uzayındaki yakınlığı belirlemek için bir benzerlik ölçütünün uygulanmasını içerir. Bu süreç, sorgu vektörüne yüksek benzerlik puanına sahip vektörlerin sıralı bir listesini üretir ve her bir vektörle ilişkili ham veriye erişim sağlar.
Vektör veritabanları, k-en yakın komşu (k-NN) indeksleri gibi çeşitli algoritmalarla desteklenir ve Hierarchical Navigable Small World (HNSW) ve Inverted File Index (IVF) gibi yöntemlerle inşa edilir.
Vektör veritabanları, retrieval augmented generation (RAG) uygulamalarının ayrılmaz bir parçasıdır. Verimli benzerlik araması, içerik genişletme, çeşitlilik ve dinamik çok modlu veri getirimi sağlarlar. Bu yetenek, üretici yapay zekâda büyük ölçekli, çeşitli veri kümelerine erişimin önyargıları ve halüsinasyonları azaltmak için kritik olduğu durumlarda çok önemlidir.
Pinecone, özellikle büyük ölçekli veri senaryolarını ele almadaki verimliliği ve kullanım kolaylığı ile öne çıkan popüler bir vektör veritabanıdır. Vektör arama yeteneklerini çeşitli uygulamalara eklemek isteyen geliştiriciler ve veri bilimciler için tasarlanmıştır.
Pinecone, ürün niceleme ve yerel duyarlı karma (locality-sensitive hashing) gibi gelişmiş indeksleme tekniklerini kullanarak yüksek boyutlu vektör uzaylarında verimli ve doğru benzerlik aramaları sağlar. Bu da onu RAG uygulamaları için özellikle faydalı kılar. Pinecone ile vektör veritabanlarında ustalaşma üzerine ayrı bir dersimizde daha fazlasını öğrenebilirsiniz.
Bu derste, vektör veritabanı olarak Pinecone kullanacağız.
OpenAI’nin API platformu, halka açık olan OpenAI tarafından eğitilmiş tüm modellere erişim sağlar. Buna GPT, DALL-E, Whisper ve diğer modeller dahildir.
API’ye HTTP istekleriyle erişilir; dolayısıyla HTTP isteği göndermeyi destekleyen herhangi bir programlama diliyle entegre edebilirsiniz. Ancak Python için pip install openai ile kurulabilen openai adlı bir kütüphane vardır ve bu API’lerle çalışmayı daha da kolaylaştırır.
OpenAI API ile Çalışmak Python’da openai kütüphanesi kullanılarak yalnızca birkaç satır kodla mümkündür.
Python Örneği:
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)LangChain, dil modelleriyle güçlendirilmiş uygulamalar geliştirmek için bir çerçevedir. Belirli bir soyutlama düzeyi sağlayarak prototipleri hızlı ve kolay şekilde geliştirmenizi ve prototipten üretime daha hızlı geçmenizi sağlar. Çerçevenin büyümesi ve popülerliği, Github sayfasındaki yıldız sayısından da anlaşılmaktadır.
Harika bir çerçevedir. Ancak bir uyarı: Hâlâ tam kararlı değil. API sürekli değişiyor ve bir sonraki bölümdeki kodu okuduğunuzda çalışmaması mümkün. Bu beklenen bir durum; zira kütüphane hâlâ pre-release aşamasında. Bu blog yazıldığı sırada Langchain’in en güncel sürümü 0.1.4’tü.
Bir RAG arka ucunu uygulayabilmek için harici verilerin gömelerine ihtiyaç duyarız. Ham veriden başlıyorsak, OpenAI gömme API’sini veya başka bir açık kaynak gömme modelini kullanarak gömme işlemi yapmamız gerekir.
Ham veriyi gömmek oldukça basittir. Ancak OpenAI API’lerini kullanıyorsanız, token başına ücretlendirilirsiniz.
Bu ders kapsamında, bu bölümdeki kodların çoğunu LangChain üzerine resmi Pinecone rehberinden yeniden ürettim. Pinecone dokümantasyonu son derece iyi ve her zaman günceldir.
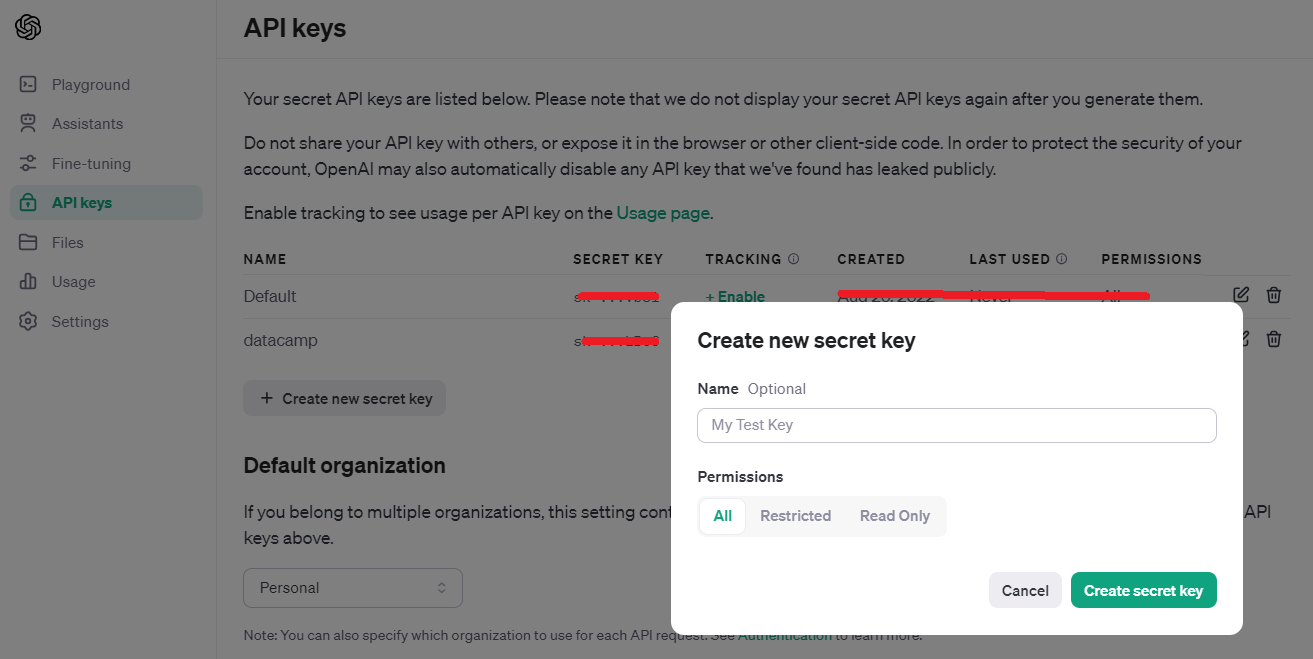
OpenAI hesabınıza kaydolduktan sonra https://platform.openai.com/api-keys adresine gidin.
Bir anahtar oluşturduğunuzda, onu mutlaka kopyalayın; daha sonra anahtarı görme veya kopyalama seçeneğiniz yoktur.
Pinecone için, hesabınıza giriş yapın ve API Keys’e tıklayın. Sağ köşedeki `Click API Key` düğmesine tıklayabilirsiniz.
OpenAI’nin aksine, Pinecone’da bir API anahtarı oluşturduğunuzda hemen kopyalamanız gerekmez; İlgili eylemler sütununun altında istediğiniz zaman kullanabileceğiniz bir kopyalama simgesi bulunur.
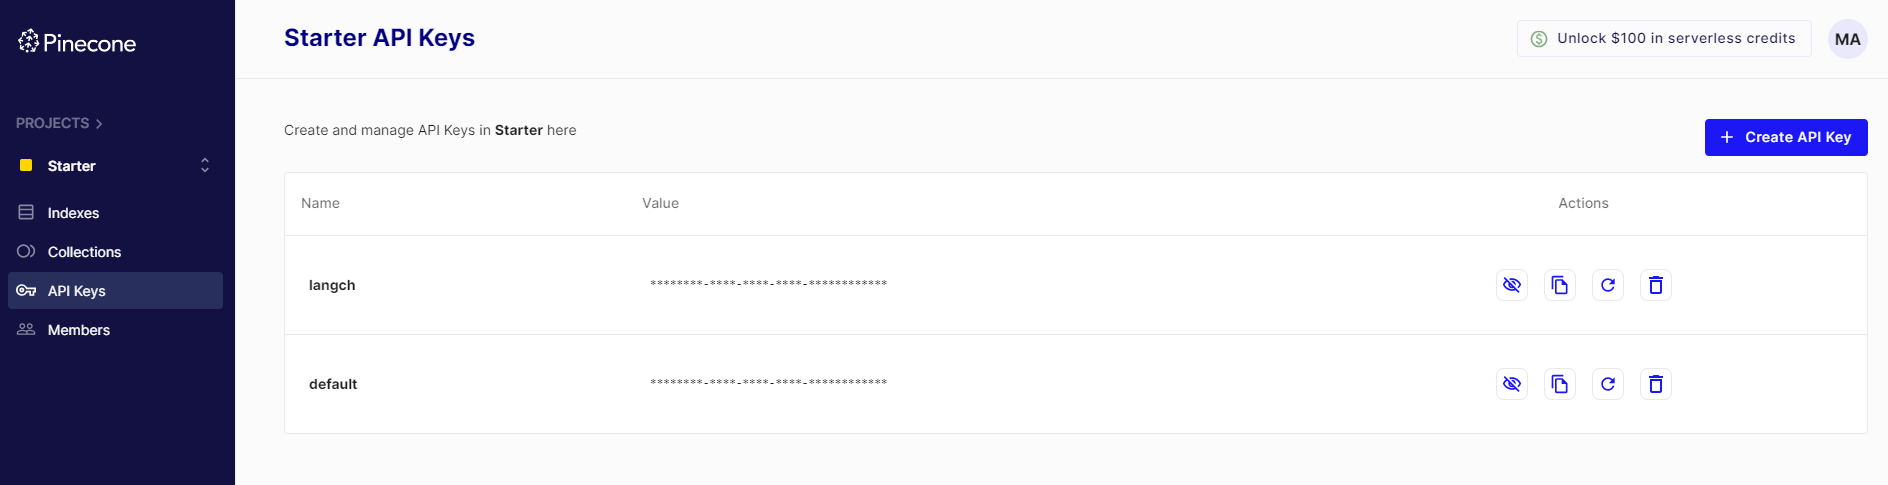
OpenAI ve Pinecone’dan API anahtarlarını aldıktan sonra, bunları Notebook içinde değişkenlere atayın. Alternatif olarak Python’daki `os` modülünü kullanarak bu anahtarları ortam değişkeni olarak da ayarlayabilirsiniz. Bunu tercih ederseniz aşağıdaki kodda gerekli değişiklikleri yapmanız gerekir.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Bu dersi uygulamak için aşağıdaki kütüphanelerin pip ile kurulu olması gerekir.
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0pinecone-datasets kütüphanesi, OpenAI’nin embedding-ada-002 modeliyle önceden gömülmüş birkaç örnek veri kümesi sağlar. wikipedia-simple-text-embedding-ada-002-100K adlı örnek veri kümesini kullanacağız.
Adından da anlaşılacağı gibi 100.000 belge vardır. Ancak bu derste yalnızca ilk 30.000 kaydı örnekleyeceğiz. Her ne kadar tüm 100.000 belge için gömeler sağlandığından maliyet etkisi olmasa da, süreci hızlandırmak için örnekleme yapılmıştır.
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')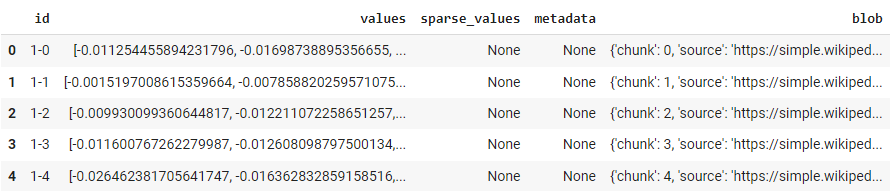
# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# sample 30k documents
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)
# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# check for and delete index if already exists
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# we create a new index
pc.create_index(
index_name,
dimension=1536, # dimensionality of text-embedding-ada-002
metric='dotproduct',
spec=spec
)
Dizine bağlanmak ve dizin istatistiklerini kontrol etmek için:
index = pc.Index(index_name)
index.describe_index_stats()
Çıktı şu şekilde olacaktır:
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536, ada-002 modelinden gelen gömelerin boyutudur. Henüz herhangi bir veri (vektör) almadığımız için vektör sayısının sıfır olduğunu görebilirsiniz.
langchain-retrieval-augmentation-fast dizinine veri eklemek oldukça basittir:
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Bu komutun tamamlanması birkaç dakika sürecektir.
Veri ekledikten sonra, Pinecone arayüzünde de görebilirsiniz:
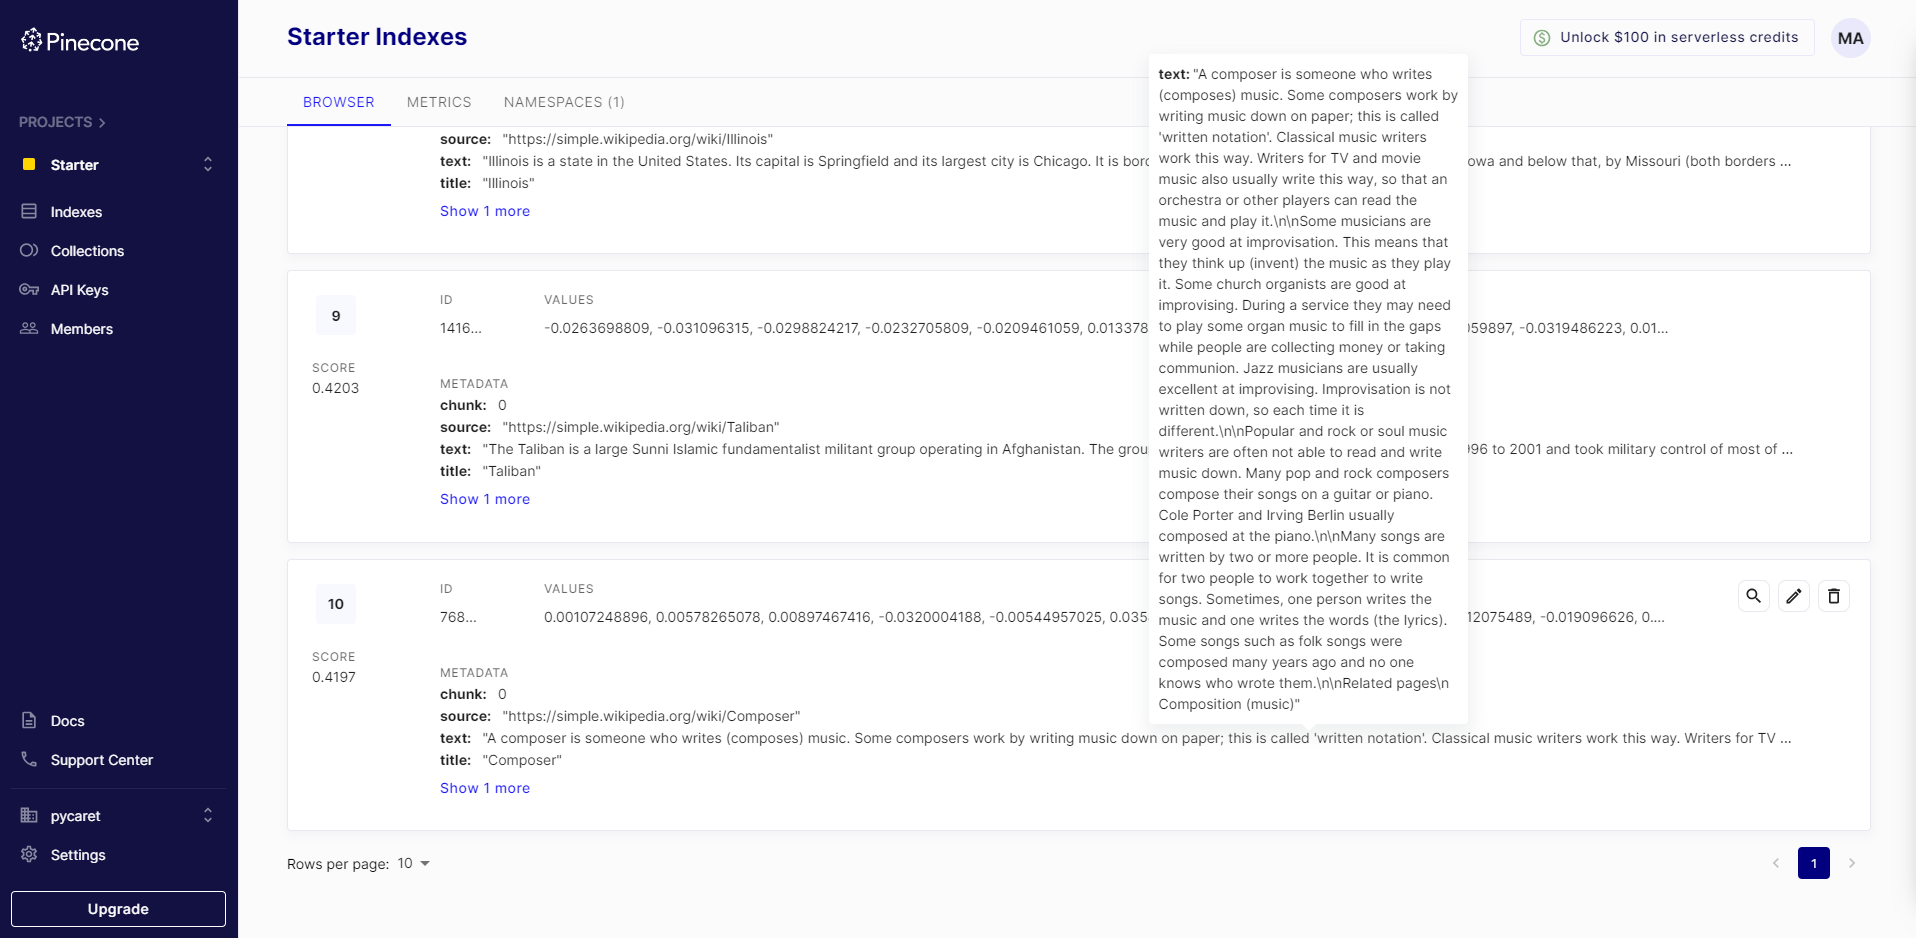
Artık Pinecone API’sini kullanarak bir dizin oluşturup veriyi eklediğimize göre, LangChain kullanımına geçeceğiz. Bir sonraki adımda, oluşturduğumuz aynı dizini kullanarak LangChain ile bir LangChain vektör deposu başlatacağız.
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
Vektör deposunu başlatmak için:
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
vectorstore nesnesini kullanarak veriyi sorgulayabilir ve En İyi N sonucu görebilirsiniz:
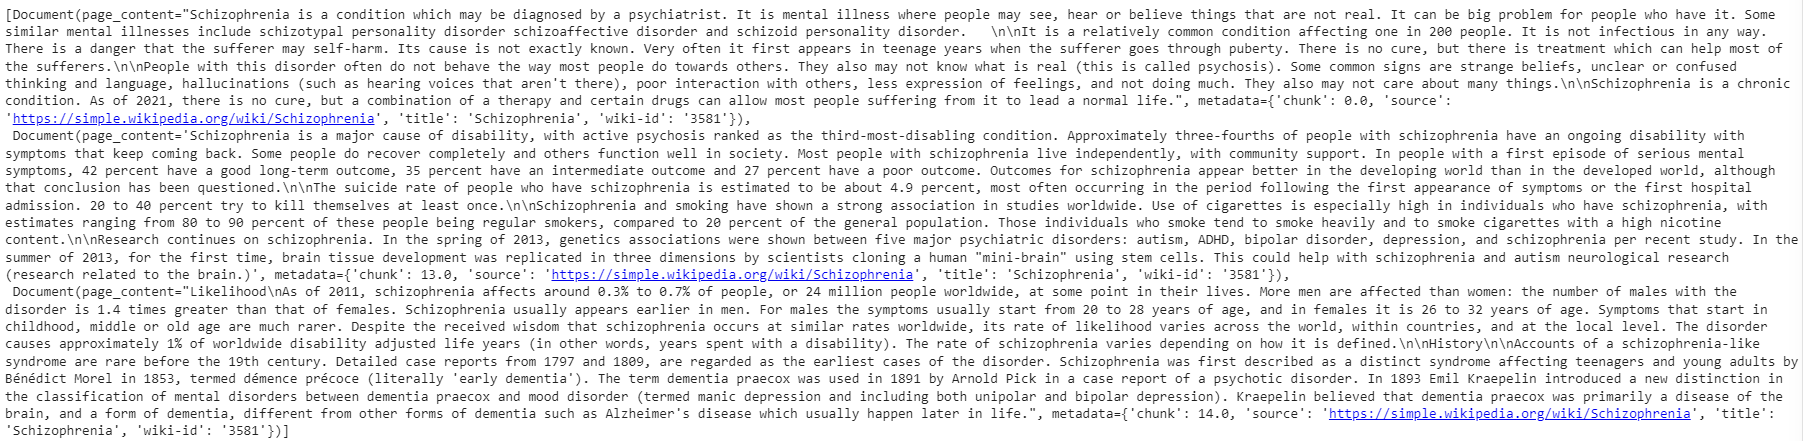
query = "What is Schizophrenia?"


vectorstore.similarity_search(query, k=3)
Çıktı, içinden metinleri kolayca ayrıştırabileceğiniz bir belge nesnesidir; özünde, 4. Adımda seçtiğimiz ölçüte göre — bu örnekte dotmatrix — en iyi eşleşen 3 belgeyi gösterir.
Bu, uygulamamızın son adımı. Şimdi bunun etrafına bir LLM sarmak istiyoruz. Bunun için Langchain’den ChatOpenAI ve RetrievalQA sınıflarını içe aktaracaksınız.
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# completion llm
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
qa.run(query) çıktısı, dil modelinden gelen yanıttır.
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....Bu yanıt, `dataset` içindeki belgelerden birinden gelmektedir. Kaynağı da almak istiyorsanız (ki RAG uygulamalarında sıklıkla gerekir) yukarıdaki koda küçük bir değişiklik yapmanız yeterlidir.
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
Çıktı:
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
Dikkat ederseniz bu kez çıktı, `source` bilgisini bulabileceğiniz bir sözlüktür.
Bu blogda, LLM’lerin en popüler uygulaması olan Retrieval Augmented Generation (RAG) tekniğini ele alarak, GPT-4 gibi Büyük Dil Modellerine dayalı chatbot yanıtlarının güvenilirliğini ve bağlamsal uygunluğunu nasıl artırdığını inceledik.
Chatbot’ların basit, kural tabanlı sistemlerden sofistike, yapay zekâ destekli sohbet ajanlarına evrimi, teknolojik gelişimde kayda değer bir sıçramayı temsil ediyor. LLM’ler, daha doğal ve bağlama duyarlı konuşmalar kurabilen yeni bir esneklik ve zekâ düzeyi getiriyor.
Ayrıca, yüksek boyutlu veri vektörlerini depolama ve getirme konusunda Pinecone’a odaklanarak vektör veritabanlarının rolünü inceledik. Bu veritabanları, RAG’in uygulanmasında kilit öneme sahiptir.
Bu kavramların pratik uygulaması, Python’da OpenAI ve Pinecone API’leri ile LangChain çerçevesinden yararlanılan kod örnekleriyle gösterildi. Bu araçlar, geliştirme sürecini basitleştirerek, geliştiricilerin geniş bir yelpazedeki uygulamalara yönelik yapay zekâ destekli chatbot’ları hızlı ve verimli şekilde oluşturmalarını daha erişilebilir kılar.
Daha fazla bilgi için Pinecone ile Gömeler için Vektör Veritabanları veya OpenAI API ile çalışma kurslarımızı inceleyin; bu alanlardaki bilginizi derinleştirmenize yardımcı olabilir.
Yapay Zekâ Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




