
Kurs
Arbeiten mit der OpenAI-API
3 Std.
172.6K
Seit der Veröffentlichung von ChatGPT im November 2022 sind LLM-Chatbots in zahlreichen Anwendungsfällen zum festen Bestandteil geworden.
Die Idee eines Chatbots ist nicht neu. Wir alle kennen diese nutzlosen Chatbots, die so stark konfiguriert werden müssen, dass sie praktisch nur noch if-else-Skripten folgen. Ihre Pflege wird zum Albtraum, und anstatt Nutzerinnen und Nutzern zu helfen, sorgen sie vor allem für Frust.
Doch 2024 feiern Chatbots ein Comeback – dank Large Language Models (LLMs).
In diesem Blog erfährst du:
Schau dir außerdem unseren Kurs Vector Databases for Embeddings with Pinecone und das Code-Along Building Chatbots with OpenAI API and Pinecone an, um tiefer einzusteigen.
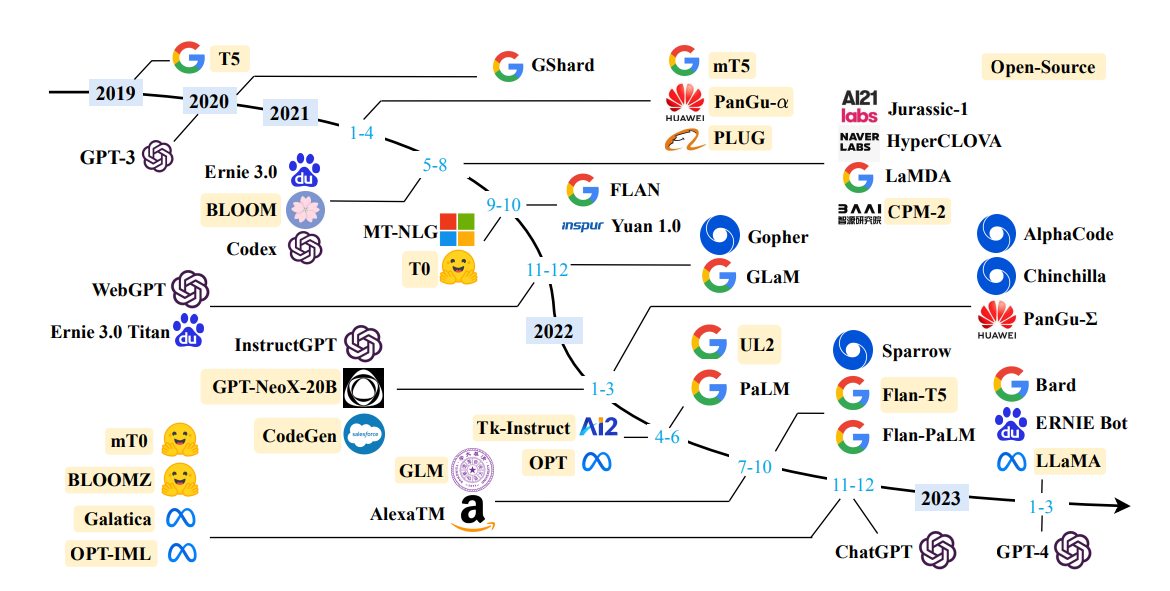
Large Language Models (LLMs) wie GPT-4 sind fortgeschrittene Machine-Learning-Modelle, die Deep-Learning-Techniken – insbesondere die Transformer-Architektur – nutzen, um natürliche Sprache zu verstehen und zu generieren.
Sie werden auf gewaltigen Datensätzen mit Billionen von Wörtern trainiert, die aus unterschiedlichsten Internetquellen stammen – etwa Bücher, Artikel, Websites und Code-Repositorien. Dieses umfangreiche Training ermöglicht ihnen, eine Vielzahl komplexer Aufgaben der Sprachverarbeitung zu meistern.
Eine der zentralen Stärken von LLMs ist die Fähigkeit, zu nahezu jedem Thema Text zu erzeugen – und das in ganz unterschiedlichen Stilen und Formaten, von kreativen Texten bis hin zu technischer Dokumentation.
LLMs beherrschen Aufgaben wie Zusammenfassungen, bei denen sie lange Dokumente auf den Punkt bringen, sowie Conversational AI und können so natürliche, flüssige Dialoge mit Nutzerinnen und Nutzern führen. Sie übersetzen außerdem zwischen Sprachen und erfassen dabei auch Nuancen wie Umgangssprache und regionale Dialekte.
Allerdings sind LLMs nicht frei von Herausforderungen. Ein wesentliches Problem ist, dass LLMs „halluzinieren“ können – also plausibel klingende, aber falsche oder unsinnige Informationen erzeugen, insbesondere bei Anfragen außerhalb ihres Trainingsspektrums oder bei mehrdeutigen Prompts.
Ein weiteres Problem ist ein potenzieller Bias in den Ausgaben, der aus verzerrten Trainingsdaten oder der Modellentwicklung resultieren kann.
LLMs sind ein großer Sprung für die KI und eröffnen enormes Potenzial für Innovation und Effizienz in vielen Bereichen. Zugleich erfordern sie ein umsichtiges Management, um Risiken wie Verzerrungen und Fehlinformationen zu minimieren.
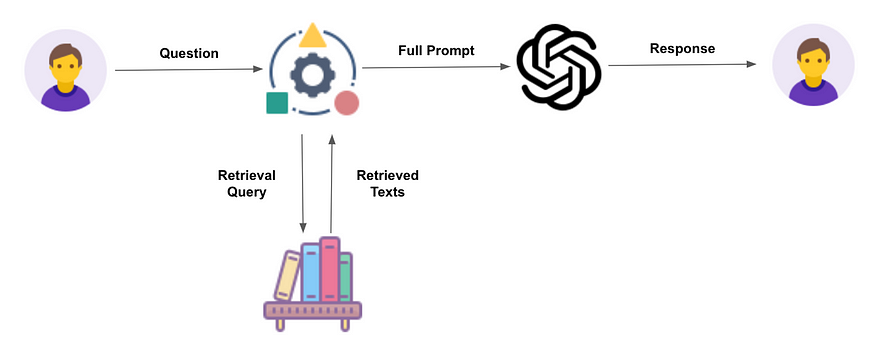
LLMs sind mächtig, haben aber Grenzen. Wenn eine Anfrage über den Trainingsstand hinausgeht, können sie veraltete, generische oder sogar falsche Informationen liefern.
Sie können zudem faktisch falsche oder unsinnige Inhalte erzeugen und als korrekt darstellen – das ist als Halluzination bekannt.
RAG setzt genau hier an: LLMs greifen auf vorher definierte, relevante Quellen zu und beziehen diese in die Antwort ein. Das erhöht das Vertrauen der Nutzer, weil die Ausgaben präziser sind und auf verlässliche Quellen zurückgeführt werden können.
Zugleich behalten Entwicklerinnen und Entwickler mehr Kontrolle über die Antworten des LLM – die Qualität und Praxistauglichkeit des Systems steigen.
Mehr zu Retrieval Augmented Generation findest du in unserem separaten Tutorial. Die wichtigsten Schritte haben wir hier kurz zusammengefasst.
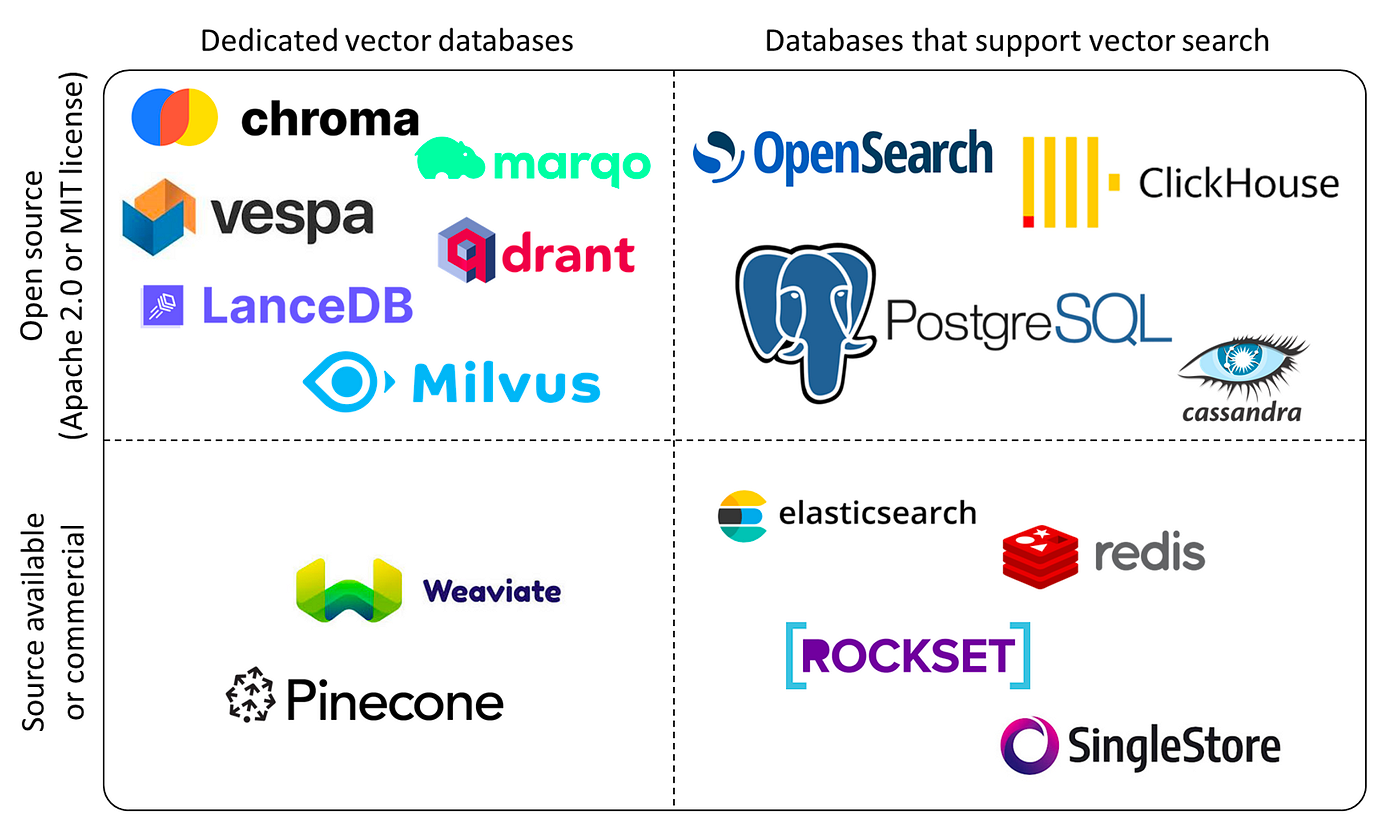
Vektordatenbanken sind spezialisierte Datenbanken zum Verarbeiten hochdimensionaler Vektoren – also mathematischer Repräsentationen von Datenmerkmalen. Je nach Komplexität können diese Vektoren Dutzende bis Tausende Dimensionen haben.
Solche Datenbanken sind besonders gut in schnellen, präzisen Ähnlichkeitssuchen auf Basis von Vektordistanzen oder -ähnlichkeiten. Dadurch ermöglichen sie semantische bzw. kontextuelle Abfragen statt starrer exakter Übereinstimmungen.
Praktisch lassen sich Vektordatenbanken vielseitig einsetzen: Sie finden z. B. Bilder, die einem gegebenen Bild in Inhalt und Stil ähneln, lokalisieren thematisch oder stimmungsseitig ähnliche Dokumente oder identifizieren Produkte mit ähnlichen Eigenschaften und Bewertungen.
Für Anfragen nutzt man einen Query-Vektor, der die gesuchte Information repräsentiert, und berechnet eine Ähnlichkeitsmetrik, um nahe Vektoren im Raum zu bestimmen. Das Ergebnis ist eine Rankingliste mit Vektoren, die besonders ähnlich zum Query sind – samt Zugriff auf die zugehörigen Rohdaten.
Unter der Haube arbeiten verschiedene Algorithmen, etwa k-nearest neighbor (k-NN) mit Strukturen wie Hierarchical Navigable Small World (HNSW) oder Inverted File Index (IVF).
Für Retrieval Augmented Generation (RAG) sind Vektordatenbanken zentral: Sie ermöglichen effiziente Ähnlichkeitssuche, Inhaltsanreicherung, Diversität und dynamisches Retrieval über verschiedene Modalitäten. Das ist in generativer KI entscheidend, um auf große, vielfältige Datensätze zuzugreifen und Bias sowie Halluzinationen zu reduzieren.
Pinecone ist eine beliebte Vektordatenbank, die durch Effizienz und einfache Handhabung überzeugt – gerade bei großen Datenmengen. Sie richtet sich an Developer und Data Scientists, die Vector Search in Anwendungen integrieren möchten.
Pinecone nutzt fortgeschrittene Indexierungsverfahren wie Product Quantization und Locality-Sensitive Hashing für effiziente, präzise Ähnlichkeitssuchen in hochdimensionalen Räumen – ideal für RAG. Mehr dazu im Tutorial Mastering Vector Databases with Pinecone.
In diesem Tutorial verwenden wir Pinecone als unsere Vektordatenbank.
Die API-Plattform von OpenAI bietet Zugriff auf alle öffentlich verfügbaren, von OpenAI trainierten Modelle – darunter GPT, DALL·E, Whisper und weitere.
Der Zugriff erfolgt über HTTP-Requests, sodass du sie mit jeder Programmiersprache nutzen kannst, die HTTP-Anfragen unterstützt. Für Python gibt es zudem die Bibliothek openai, die du mit pip install openai installierst und die die Arbeit mit den APIs noch einfacher macht.
Working with OpenAI API in Python mit der Bibliothek openai ist in wenigen Zeilen erledigt.
Python-Beispiel:
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)
LangChain ist ein Framework zum Entwickeln von Anwendungen mit Sprachmodellen. Es abstrahiert viele Schritte und macht Prototyping sowie den Übergang in Produktion deutlich schneller. Das Wachstum und die Beliebtheit zeigen sich an den Sternen auf Github.
Das Framework ist stark – mit einem Hinweis: Es ist noch nicht stabil. Die API ändert sich häufig, und es kann sein, dass der Code im nächsten Abschnitt beim Lesen schon nicht mehr läuft. Das ist in der pre-release-Phase normal. Zum Zeitpunkt dieses Blogs war die aktuelle Version LangChain 0.1.4.
Für ein RAG-Backend brauchen wir Embeddings externer Daten. Starten wir von Rohdaten, müssen wir sie mit der OpenAI Embeddings API oder offenen Embedding-Modellen einbetten.
Das Einbetten von Rohdaten ist unkompliziert. Beachte aber: Bei Nutzung der OpenAI-APIs fallen Kosten pro Token an.
Für dieses Tutorial habe ich den Großteil des Codes in diesem Abschnitt aus dem offiziellen Pinecone-Guide zu LangChain übernommen. Die Pinecone-Dokumentation ist hervorragend und stets aktuell.
Nach der Registrierung bei OpenAI gehst du einfach zu https://platform.openai.com/api-keys
Kopiere den Key direkt nach dem Generieren. Danach kannst du ihn nicht mehr einsehen oder kopieren.
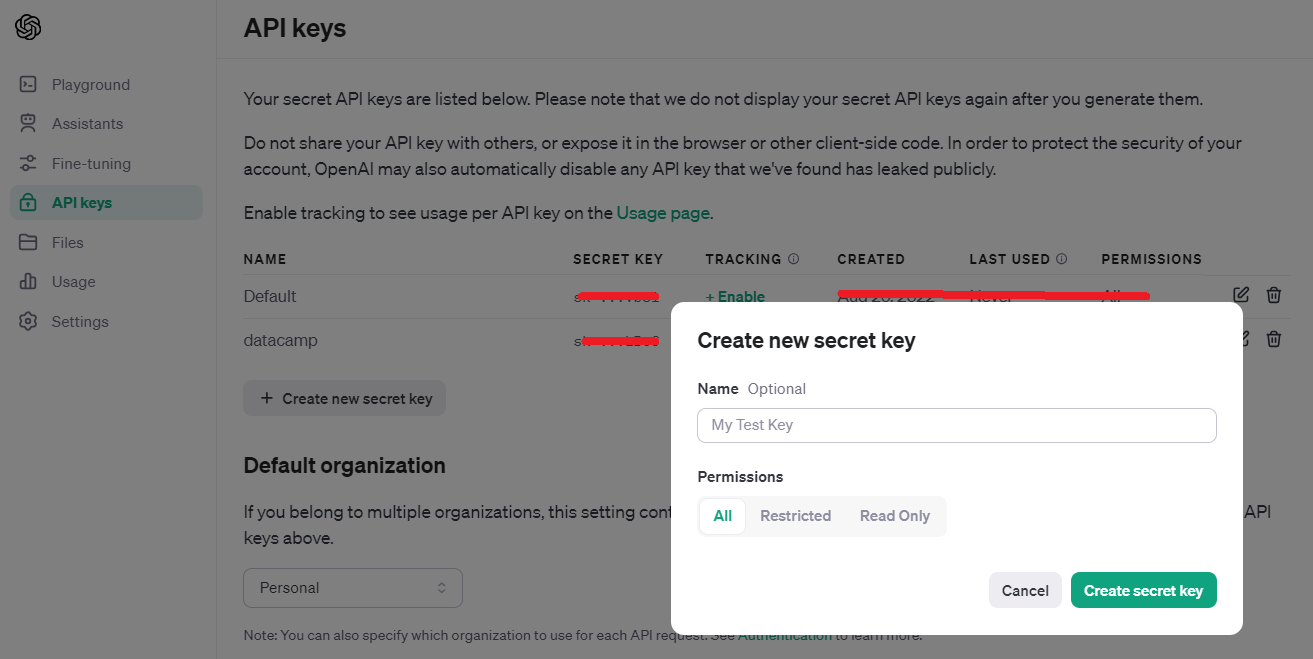
Melde dich bei Pinecone an und klicke auf API Keys. Über die Schaltfläche „Click API Key“ oben rechts kannst du einen Key erzeugen.
Anders als bei OpenAI musst du ihn bei Pinecone nicht sofort kopieren – unter „Actions“ gibt es ein Kopier-Icon, das du jederzeit nutzen kannst.
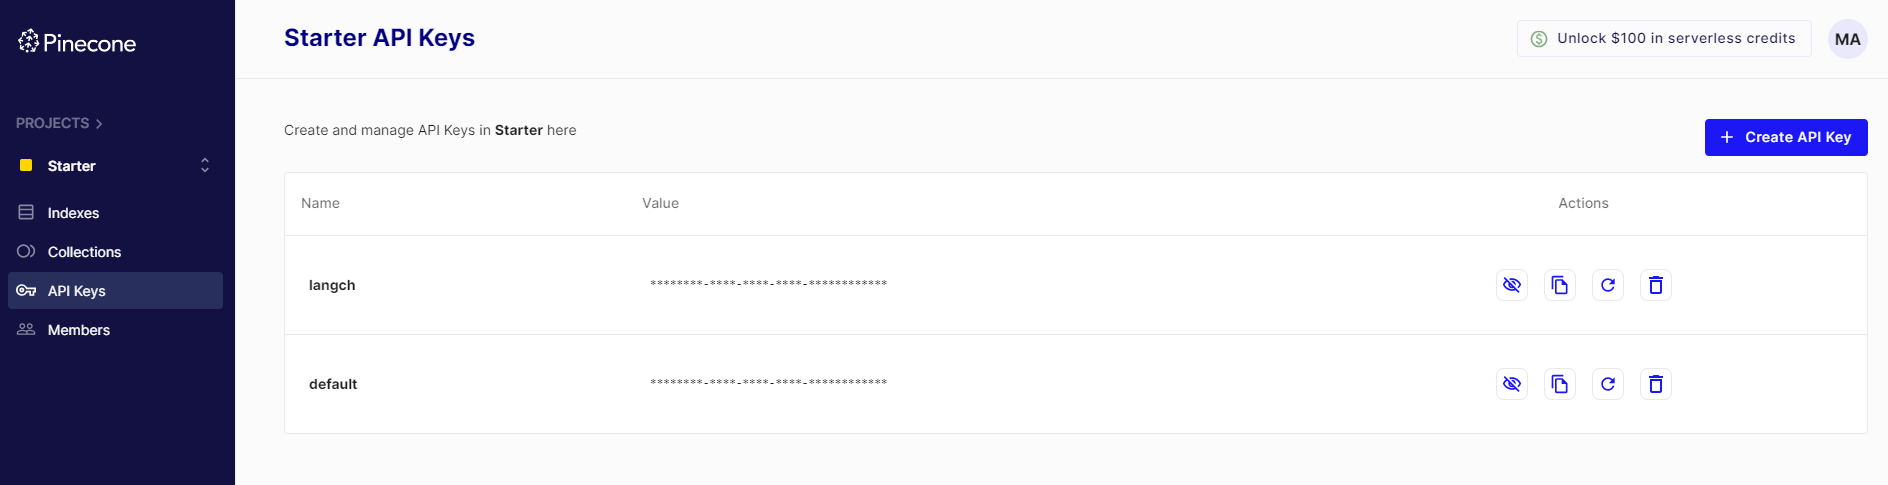
Sobald du die API Keys von OpenAI und Pinecone hast, setze sie in Variablen in deinem Notebook. Alternativ kannst du sie mit dem Python-Modul os als Umgebungsvariablen setzen und den Code unten entsprechend anpassen.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Für dieses Tutorial benötigst du folgende Pakete, die du mit pip installierst.
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0Die Bibliothek pinecone-datasets stellt einige Beispieldatensätze bereit, die bereits mit OpenAIs Modell embedding-ada-002 eingebettet wurden. Wir verwenden den Datensatz wikipedia-simple-text-embedding-ada-002-100K.
Wie der Name sagt, umfasst er 100.000 Dokumente. Für dieses Tutorial ziehen wir jedoch nur die ersten 30.000. Auch wenn alle 100.000 bereits Embeddings haben und keine Kosten anfallen, beschleunigt das Sampling den Ablauf.
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')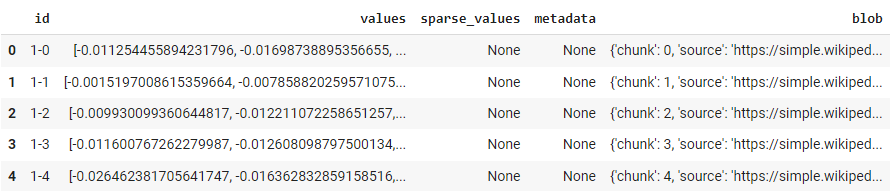
# drop metadata column and renamed blob to metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# sample 30k documents
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configure client
pc = Pinecone(api_key=PINECONE_API_KEY)
# configure serverless spec
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# check for and delete index if already exists
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# we create a new index
pc.create_index(
index_name,
dimension=1536, # dimensionality of text-embedding-ada-002
metric='dotproduct',
spec=spec
)
So stellst du die Verbindung her und prüfst Index-Statistiken:
index = pc.Index(index_name)
index.describe_index_stats()
Die Ausgabe sieht so aus:
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536 ist die Dimension der Embeddings des Modells ada-002. Die Vektoranzahl ist null, da wir noch keine Daten (Vektoren) ingestiert haben.
Das Einfügen in den Index langchain-retrieval-augmentation-fast ist unkompliziert:
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Dieser Schritt dauert ein paar Minuten.
Nach dem Einfügen kannst du die Daten auch im Pinecone-UI sehen:
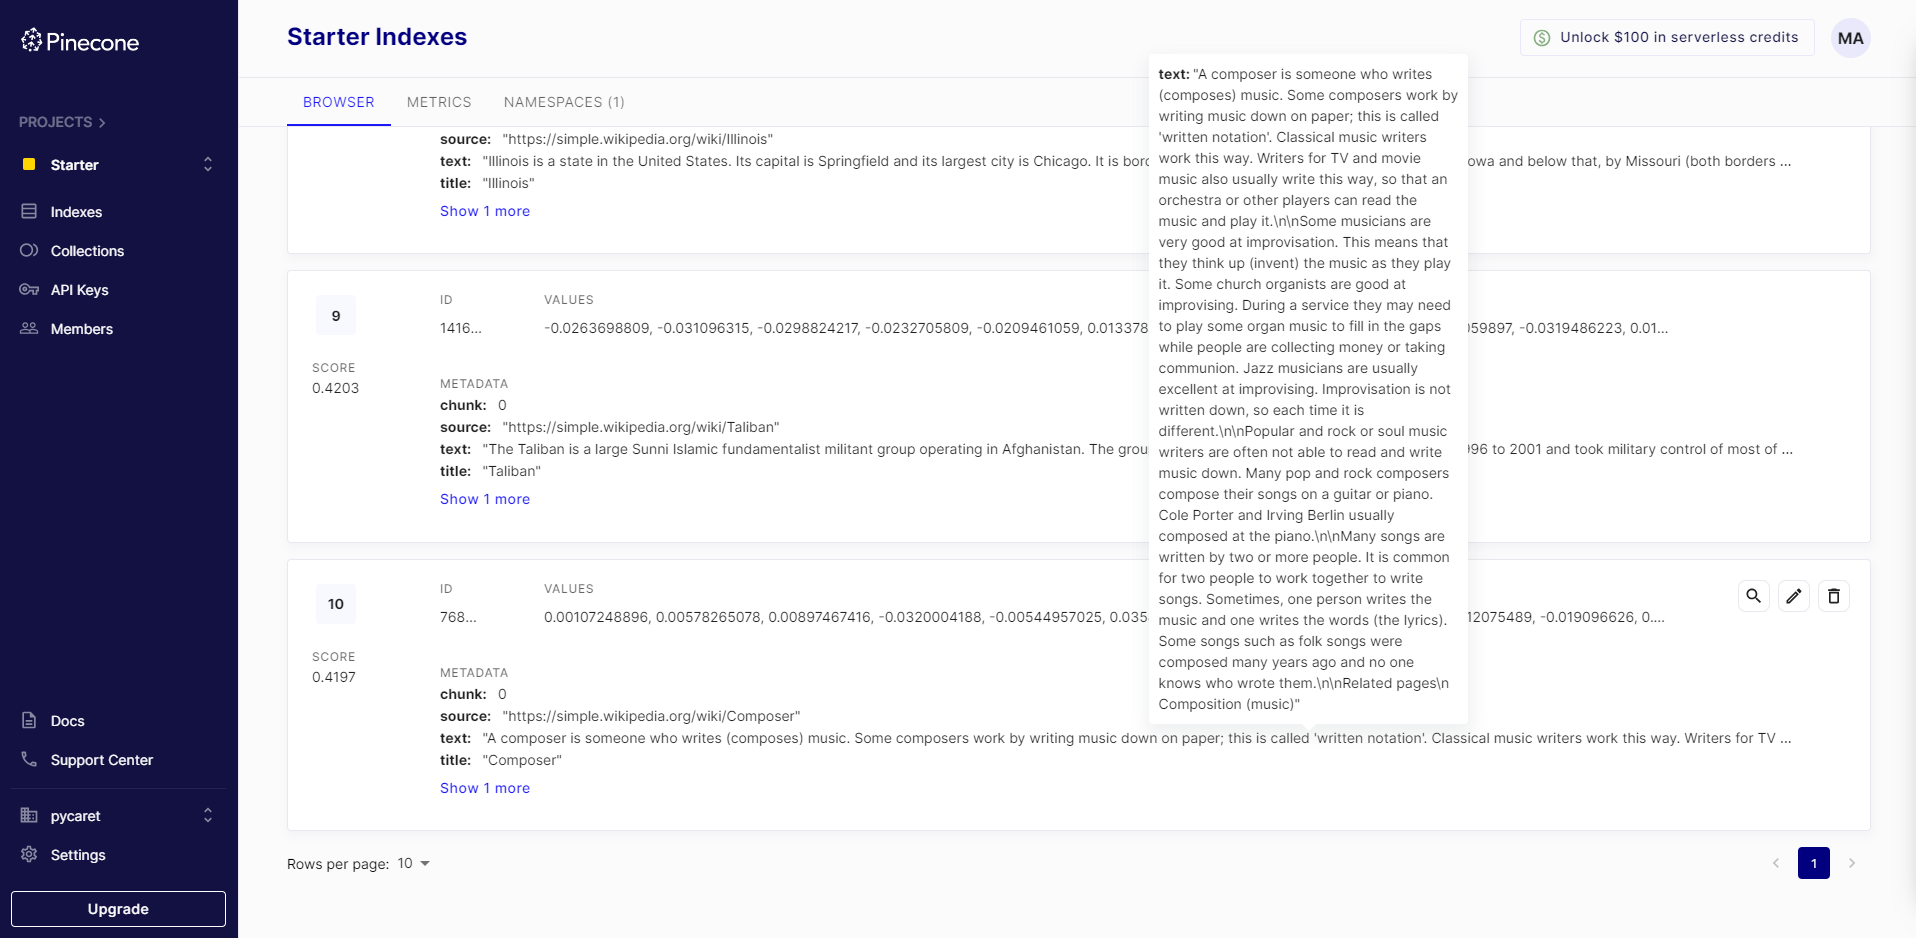
Nachdem wir den Index erstellt und mit der Pinecone API befüllt haben, wechseln wir zu LangChain. Als Nächstes initialisieren wir einen LangChain Vector Store mit LangChain und nutzen den eben erstellten Index.
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
So initialisierst du den Vector Store:
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
Mit dem Objekt vectorstore kannst du nun Daten abfragen und die Top-N-Ergebnisse sehen:
query = "What is Schizophrenia?"


vectorstore.similarity_search(query, k=3)
Die Ausgabe ist ein Dokumentobjekt, aus dem du leicht Strings extrahieren kannst. Im Kern siehst du die drei besten Treffer – basierend auf der in Schritt 4 gewählten Metrik, hier dotmatrix.
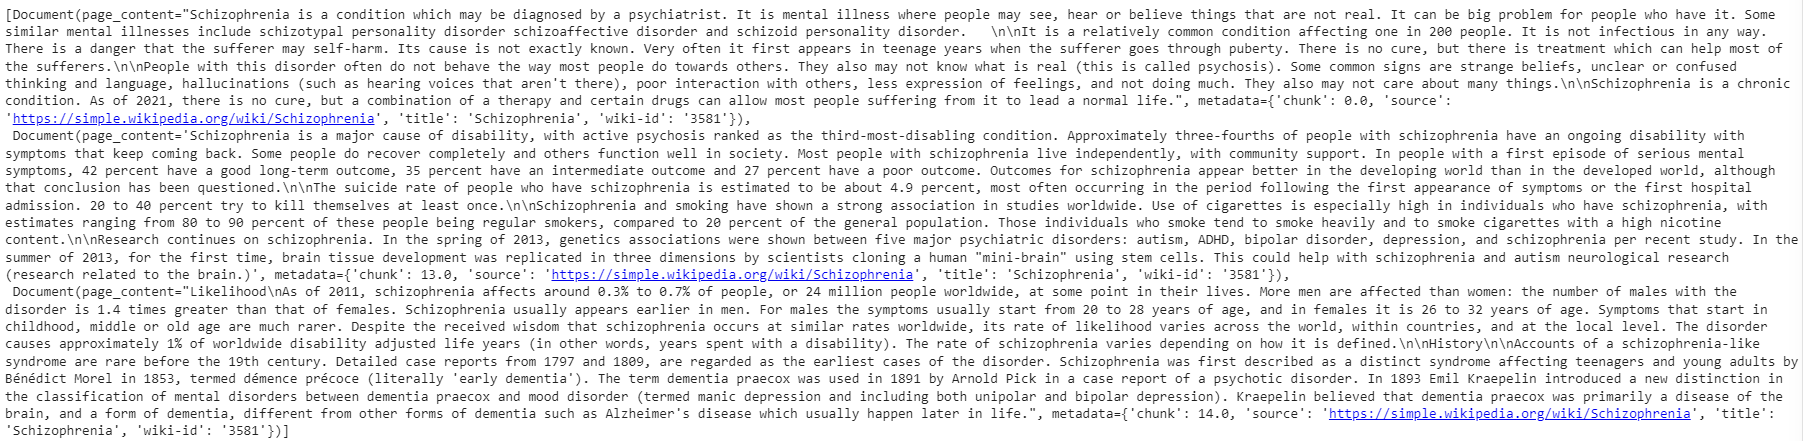
Zum Schluss binden wir ein LLM ein. Dazu importierst du die Klassen ChatOpenAI und RetrievalQA aus LangChain.
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# completion llm
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
Die Ausgabe von qa.run(query) ist die Antwort des Sprachmodells.
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....Diese Antwort stammt aus einem der Dokumente im `dataset`. Wenn du zusätzlich die Quelle ausgeben willst (was bei RAG oft nötig ist), reicht eine kleine Codeänderung.
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
Ausgabe:
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
Beachte: Diesmal ist die Ausgabe ein Dictionary, das auch die `source` enthält.
In diesem Blog haben wir eine der populärsten LLM-Anwendungen beleuchtet: Retrieval Augmented Generation (RAG). Du hast gesehen, wie RAG die Zuverlässigkeit und Relevanz von Antworten großer Sprachmodelle wie GPT-4 deutlich erhöht.
Der Wandel von einfachen, regelbasierten Chatbots hin zu leistungsfähigen, KI-gestützten Gesprächspartnern ist ein großer Technologiesprung. LLMs verleihen Chatbots eine neue Flexibilität und Intelligenz und ermöglichen natürlichere, kontextbewusste Dialoge.
Außerdem haben wir die Rolle von Vektordatenbanken – mit Fokus auf Pinecone – beim Speichern und Abrufen hochdimensionaler Vektoren betrachtet. Sie sind der Kern von RAG.
Die praktische Umsetzung haben wir anhand von Codebeispielen gezeigt – mit den APIs von OpenAI und Pinecone sowie dem LangChain-Framework in Python. Diese Tools vereinfachen die Entwicklung und helfen dir, schnell und effizient KI-gestützte Chatbots für viele Einsatzszenarien zu bauen.
Wenn du mehr über Vector Databases for Embeddings with Pinecone oder das Arbeiten mit der OpenAI API lernen möchtest, schau dir unsere Kurse an und vertiefe dein Wissen gezielt.
Starte heute deine KI-Reise!
Kurs
Kurs