
Lộ trình
Cơ bản về Trí tuệ Nhân tạo
10 giờ
Kể từ khi ChatGPT ra mắt, dường như cứ vài ngày lại xuất hiện một Mô hình Ngôn ngữ Lớn (LLM) mới, cùng với các công ty chuyên về công nghệ này. Mỗi LLM mới được huấn luyện để vượt trội hơn mô hình trước theo nhiều cách. Chẳng hạn, chúng ta thấy ngày càng nhiều LLM được điều chỉnh cho một trường hợp sử dụng cụ thể: mô hình trò chuyện, trợ lý lập trình và hiểu văn bản bối cảnh dài, v.v.
Việc chọn đúng mô hình cho một ứng dụng hoặc dự án mới dựa trên LLM có thể là nhiệm vụ đáng ngại, chưa kể đến thách thức phải liên tục cập nhật các mô hình mới nhất và tính năng của chúng.
Với tôi, điều này thường dẫn đến việc mặc định dùng ChatGPT hoặc các mô hình GPT qua các lệnh gọi API.
Ở đây, tôi muốn đi sâu vào bức tranh đa dạng của các mô hình hiện có và nêu bật những năng lực chính mà bạn nên cân nhắc khi chọn mô hình phù hợp theo đặc thù dự án.
Chúng ta sẽ đặc biệt tập trung vào các phương thức tương tác khác nhau với các mô hình này như một trong những điểm mấu chốt khi lựa chọn giữa tất cả các mô hình hiện có.
Mục tiêu là biến hướng dẫn toàn diện này thành một tờ ghi chú nhanh, giúp bạn định hướng giữa rừng LLM để chọn cho tác vụ cụ thể của mình.
Nếu bạn mới bước vào thế giới LLM, tôi thực sự khuyên bạn nên theo học các khóa AI Fundamentals và Large Language Models Concepts để làm quen với thuật ngữ và mô hình cơ bản.
Truy cập LLM và giao tiếp với chúng trong một ứng dụng hay dự án dùng LLM có thể thực hiện qua nhiều phương thức tùy nhu cầu kỹ thuật.
Cách thân thiện nhất với người dùng để tương tác với LLM là qua các giao diện trò chuyện trên trình duyệt. Đây là trường hợp của ChatGPT, nơi giao diện người dùng đơn giản là một khung chat cho phép bạn tương tác với mô hình.
Nhìn chung, các giao diện này cho phép người dùng rất ít hoặc không thể điều chỉnh mô hình, nhưng là cách dễ dàng để thử nghiệm mô hình cho các tác vụ đơn giản. ChatGPT của OpenAI và Gemini của Google cung cấp các giao diện như vậy:
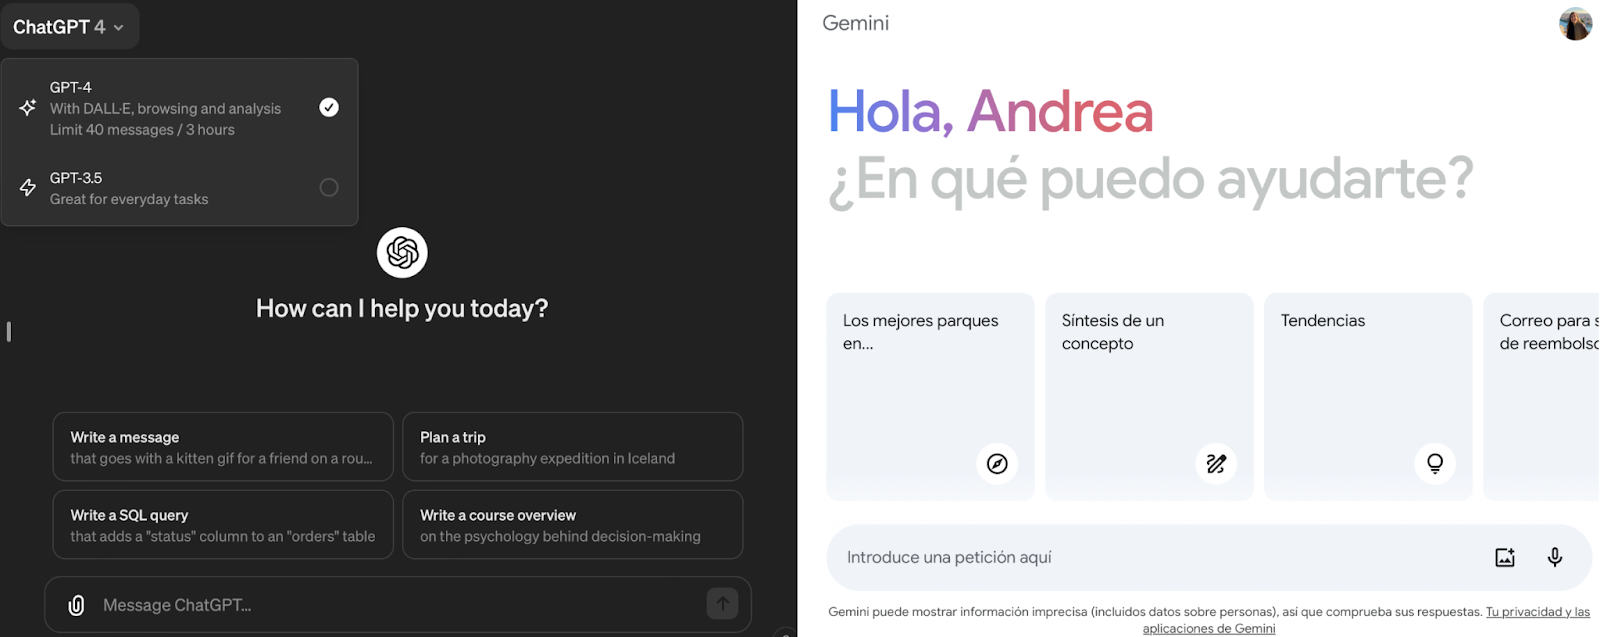
Ảnh chụp màn hình giao diện chat của ChatGPT (trái) và Gemini (phải) của Google.
Đôi khi, một số nhà cung cấp cũng cho phép tùy chỉnh ở mức độ nhất định thông qua các giao diện chat thân thiện tương tự. Với OpenAI, nền tảng này được gọi là “Playground”.
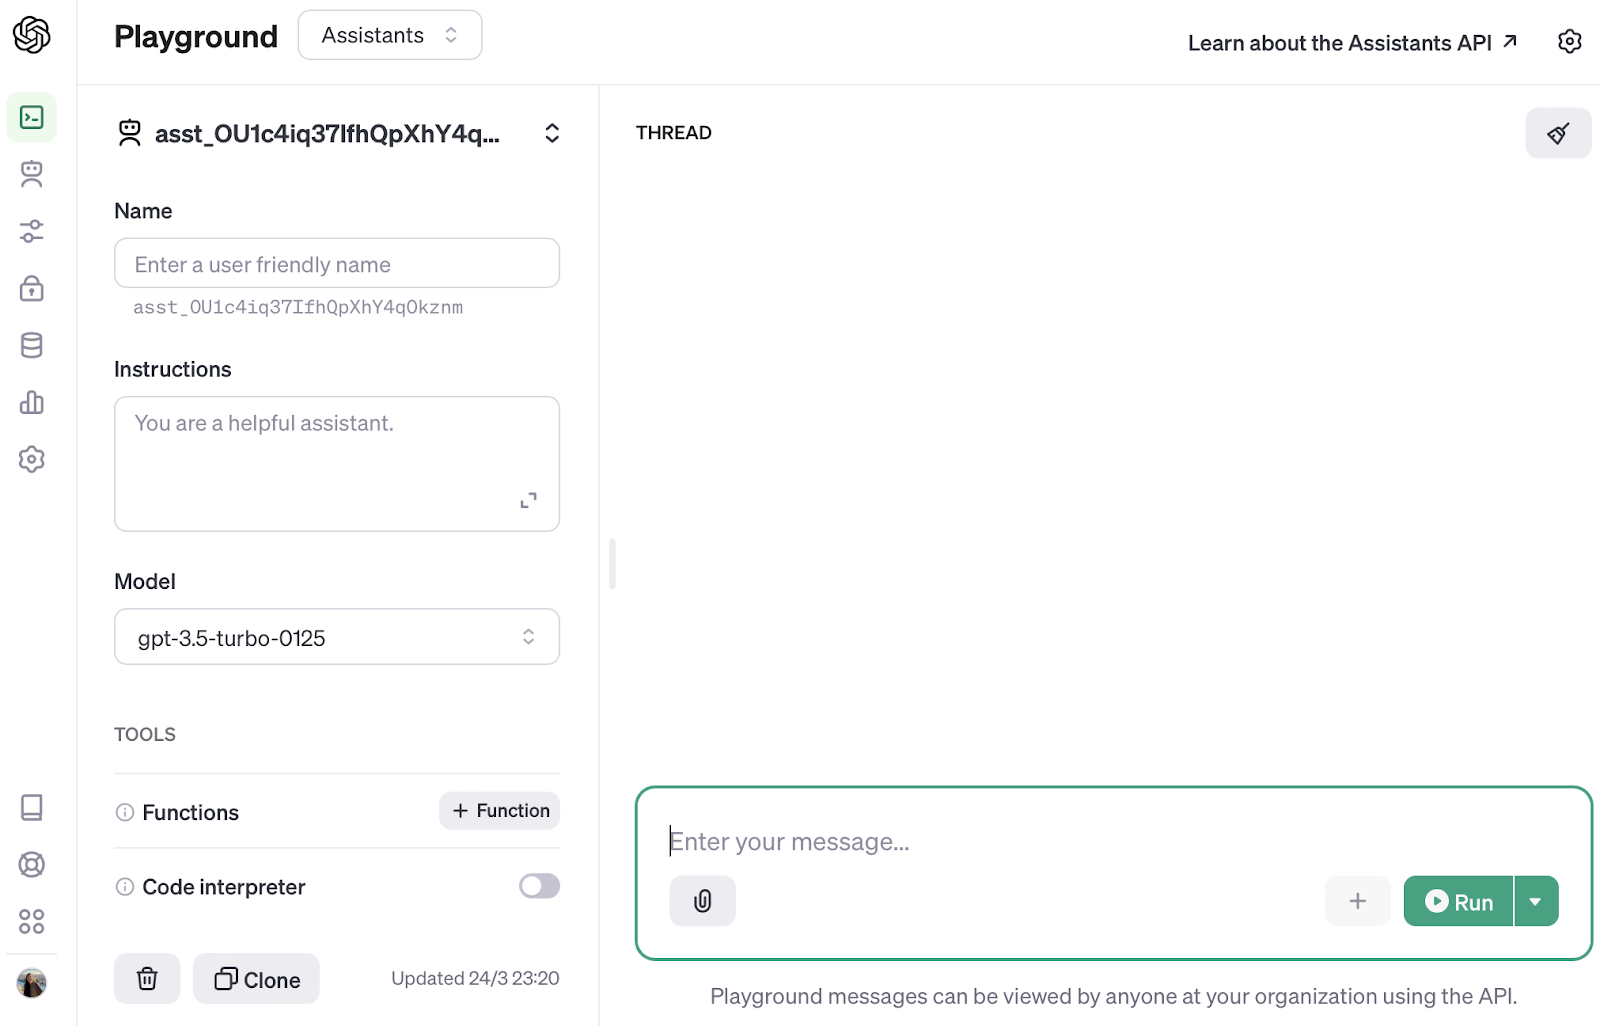
Ảnh chụp màn hình giao diện OpenAI Playground.
Playground cho phép chúng ta thử các mô hình khác nhau với quyền kiểm soát hạn chế đối với thiết lập. Nhờ đó, ta có thể khám phá tham số nào phù hợp với tác vụ. Tuy nhiên, như bạn có lẽ đã nhận ra, playground hay giao diện chat không cho phép nhúng tương tác với LLM vào một ứng dụng hay dự án.
Một trong những cách phổ biến để truy vấn LLM là thông qua API. Cách tiếp cận này đặc biệt có lợi khi chúng ta không cần tùy biến mô hình sâu hơn.
Các lệnh gọi API có thể tích hợp liền mạch vào script của chúng ta, loại bỏ nhu cầu tự thiết lập và vận hành hạ tầng.
Tuy nhiên, sự tiện lợi đi kèm chi phí, và dù phụ thuộc vào dịch vụ bên ngoài — một phụ thuộc bạn sẽ luôn có nếu không muốn tự lưu trữ mô hình và quản lý hạ tầng cần thiết — chi phí sẽ tăng theo mức sử dụng.
Với các lệnh gọi API, một thực hành tốt là xây dựng một lớp bọc đơn giản quanh chính lệnh gọi API để tương tác với mô hình theo cách mô-đun. Với OpenAI API, mà tôi dùng nhiều nhất cho đến nay, tôi luôn dùng lớp bọc ở phần tiếp theo, để việc chọn mô hình trở nên “trong suốt” với người dùng.
Viết một phương thức tiêu chuẩn nhưng linh hoạt để truy vấn các mô hình GPT qua OpenAI API rất hữu ích nếu bạn muốn tương tác mượt mà và giảm lỗi. Vì vậy, tôi thường thiết lập lệnh gọi GPT trong một hàm bọc ở đầu chương trình, đảm bảo việc sử dụng mô hình là “trong suốt” với ứng dụng.
Thư viện openai (pip install openai) đã cung cấp endpoint ChatCompletion cho phép chúng ta gọi bất kỳ mô hình GPT nào bằng phương thức .create.
Phương thức .create có hai tham số bắt buộc:
gpt-4.Với hai tham số này, ta có thể viết lệnh gọi GPT như sau:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Khi gọi mô hình, chúng ta sẽ nhận về phần hoàn tất dưới dạng JSON:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Do đó, sẽ hữu ích nếu chỉ lấy phần hoàn tất của mô hình làm giá trị trả về của hàm. Ghép tất cả mảnh ghép lại, triển khai lớp bọc có thể viết như sau:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Nếu bạn quan tâm chi tiết hơn về triển khai này, bài viết ChatGPT API Calls: A Gentle Introduction đi sâu hơn nữa!
Cuối cùng, cũng đáng lưu ý là hầu hết nhà cung cấp API, bao gồm OpenAI, đều cung cấp một số lượt gọi miễn phí khi bạn tạo tài khoản. Dù vậy, tín dụng có hạn (thường dưới 20$) và thường bị giới hạn trong một khoảng thời gian (thường là một tháng).
Dù thế nào, luôn là thực hành tốt để bọc các lệnh gọi LLM trong một hàm — hoặc một tập hợp hàm — để mô hình trở nên “trong suốt” với ứng dụng, bất kể nhà cung cấp nào.
Tự lưu trữ mô hình đồng nghĩa tải trọng số mô hình và chạy trên máy cục bộ hoặc máy chủ riêng.
Cách này hấp dẫn vì cho phép toàn quyền kiểm soát hạ tầng mô hình, nhưng cũng đồng nghĩa nỗ lực kỹ thuật tăng lên đáng kể.
Nếu bạn tò mò về các bước vận hành hạ tầng cho một LLM, hãy xem bài LLMOps Essentials!
Chạy mô hình cục bộ cho phép tùy chỉnh sâu hơn theo nhu cầu. Trong bối cảnh này, một lựa chọn tự lưu trữ phổ biến là dòng mô hình LLaMa của Meta AI. Họ đã phát hành các mô hình gọn nhẹ có thể chạy trên laptop chỉ với 8GB RAM.
Chạy mô hình LLaMa trên laptop khá dễ, nhờ các nền tảng như Ollama.
Ollama cung cấp nền tảng để chạy các LLM như LLaMa 2 và Code LLaMa cục bộ trên thiết bị của chúng ta. Hỗ trợ macOS, Linux và Windows, cho phép tùy chỉnh và tạo mô hình riêng. Xem thêm tại trang web của Ollama.
Tải Ollama có thể thực hiện từ trang chính thức, còn trọng số mô hình có thể kéo trực tiếp qua giao diện terminal.
Hãy cài Ollama trước bằng cách truy cập trang chủ!
 Ảnh chụp màn hình trang chủ trang web của Ollama.
Trong trường hợp này, Ollama là một tiện ích dòng lệnh:
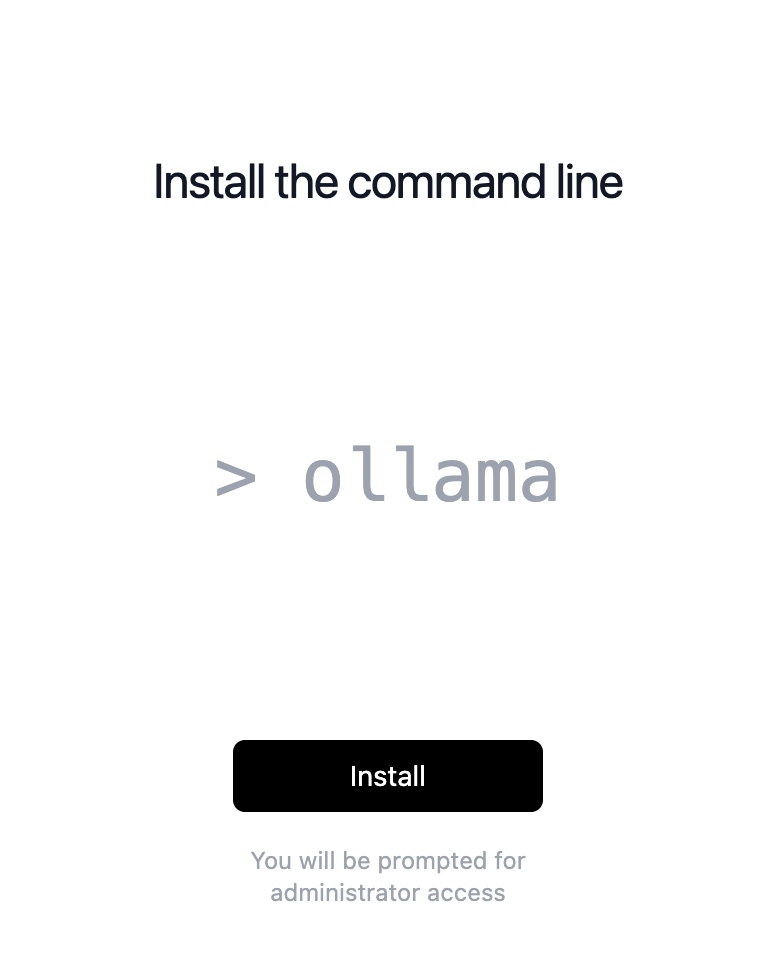
Ảnh chụp màn hình cài đặt công cụ dòng lệnh Ollama.
Khi đã cài tiện ích dòng lệnh, ta có thể khởi chạy mô hình với lệnh ollama run <model name>. Nếu đây là lần đầu chạy mô hình trên thiết bị, Ollama sẽ tự kéo về cho chúng ta:
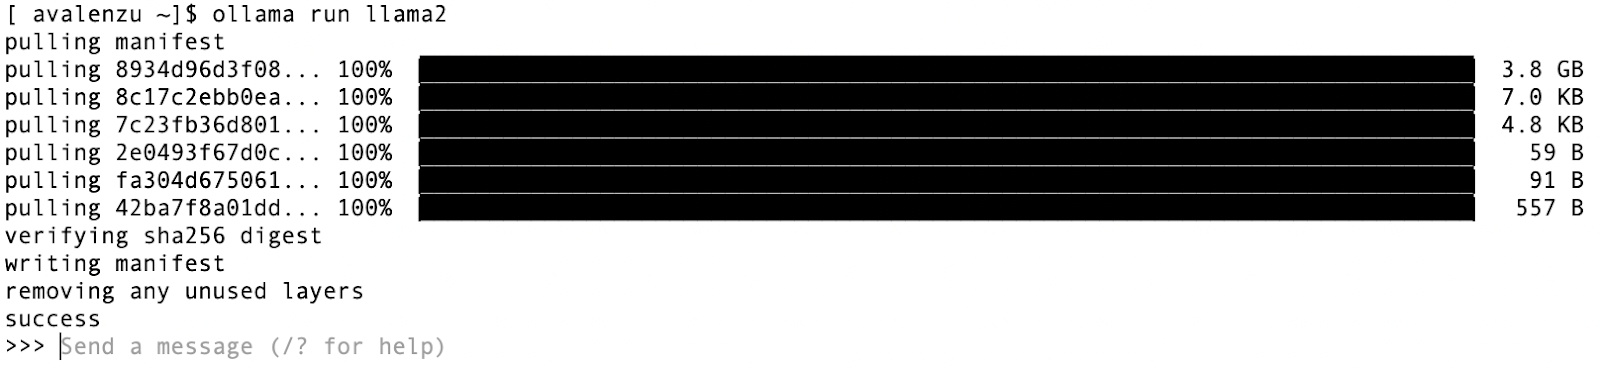
Ảnh chụp màn hình lần chạy đầu tiên mô hình LLaMa 2 với công cụ dòng lệnh Ollama. Mô hình được tự động kéo về nếu là lần đầu sử dụng.
Từ đó về sau, việc nhập prompt và thoát mô hình qua dòng lệnh rất đơn giản:
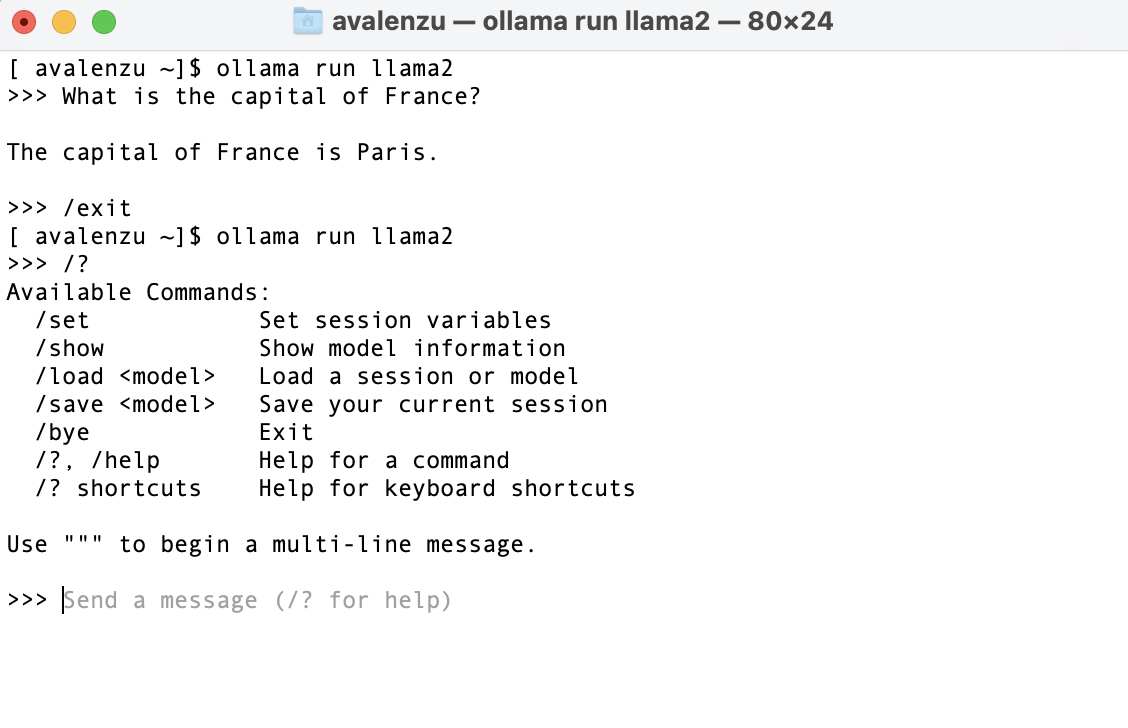
Ảnh chụp màn hình tương tác người dùng với mô hình qua công cụ dòng lệnh Ollama.
Như thấy ở hình trên, mô hình cũng có một tập lệnh bổ sung nhỏ.
Ollama cũng hỗ trợ các mô hình khác, như Mistral mới:
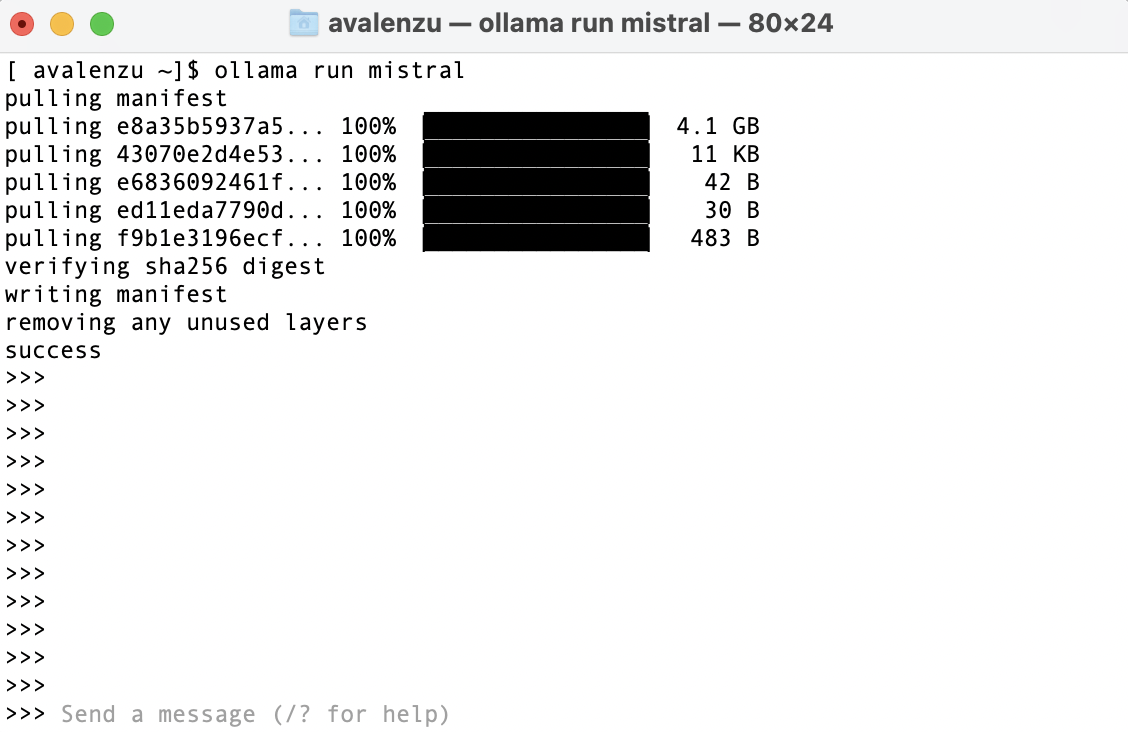
Ảnh chụp màn hình lần chạy đầu tiên mô hình Mistral với công cụ dòng lệnh Ollama. Mô hình được tự động kéo về nếu là lần đầu sử dụng.
Mô hình lại sẵn sàng dùng ngay chỉ với một lệnh!
Cách này có lợi vì chỉ tiêu tốn tài nguyên từ thiết bị của chúng ta. Tuy nhiên, cần nhớ rằng hiệu năng mô hình thường tăng theo số lượng tham số.
Do đó, mô hình càng nhiều tham số càng đòi hỏi nhiều tài nguyên. Vì vậy, các mô hình lớn nhiều khả năng phải chạy trên máy chủ riêng cho các ứng dụng LLM tự lưu trữ.
Nếu muốn xây dựng ứng dụng quy mô lớn, cũng đáng lưu ý rằng Ollama có thể chạy với Docker Desktop trên Mac và chạy trong container Docker với tăng tốc GPU trên Linux.
Có thể bạn đang thắc mắc: Tôi có thể nhúng OLLAMA vào script của mình không?
Thực ra, tự lưu trữ mô hình không có nghĩa là bạn không thể tích hợp nó vào script Python! Ollama cũng cung cấp khả năng giao tiếp với mô hình tự lưu trữ qua Python.
Thư viện Python và JavaScript của Ollama cho phép chúng ta tích hợp suy luận mô hình vào script.
Ollama không phải lựa chọn duy nhất nếu chúng ta muốn tự lưu trữ mô hình. Nhìn chung, LLM thường có thể tải về trên nhiều nền tảng mã nguồn mở, đồng thời có hỗ trợ cộng đồng.
Các LLM mã nguồn mở thường miễn phí cho mục đích học thuật và nghiên cứu. Tuy nhiên, điều khoản sử dụng thương mại có thể khác nhau tùy giấy phép phát hành. Luôn xác định rõ bạn đang thử nghiệm LLM hay xây dựng ứng dụng dựa trên LLM cho mục đích thương mại.
Bạn sẵn sàng bắt đầu hành trình phát triển LLM ngay hôm nay? Vậy khóa học Developing Large Language Models là dành cho bạn!
Lưu trữ các mô hình mạnh mẽ cục bộ có thể rất tốn tài nguyên, vì vậy dịch vụ đám mây là lựa chọn thay thế khả thi, cho phép mở rộng tài nguyên theo nhu cầu và nhận hỗ trợ từ nhà cung cấp đám mây.
Đáng chú ý là các dịch vụ đám mây truyền thống như Azure nay cung cấp pipeline tùy chỉnh để lưu trữ LLM, như Mistral, để chúng ta không cần tự triển khai lưu trữ chuyên biệt.
Đây là lợi thế lớn khi triển khai ứng dụng trong tổ chức của bạn, vì nhiều công ty vốn đã có hợp đồng với các nhà cung cấp này cho email và các giải pháp đám mây nói chung.
Chọn nhà cung cấp bên thứ ba có thể mang lại cân bằng giữa việc không phải quản lý hạ tầng lưu trữ và có một mức độ kiểm soát mô hình nhất định, so với chỉ dùng dịch vụ API gốc.
Các nhà cung cấp này thường cung cấp truy cập API, nhưng cần lưu ý chi phí có thể tăng đáng kể khi dùng nhiều, tương tự như dùng OpenAI API gốc.
Điểm khác biệt chính nằm ở đơn vị lưu trữ. Nhà cung cấp bên thứ ba, chứ không phải dịch vụ LLM gốc, lưu trữ mô hình trên hạ tầng của họ và mở endpoint API, thường cung cấp nhiều mô hình từ các nguồn khác nhau để tích hợp linh hoạt.
Một nhà cung cấp API bên thứ ba phổ biến là LLAMA API.
Ảnh chụp màn hình trang chủ trang web LLAMA API.
API không miễn phí, nhưng bạn có thể dùng thử vì tài khoản mới được cấp 5$ tín dụng miễn phí. Tuy nhiên, hãy nhớ các tín dụng này chỉ có hiệu lực trong một tháng kể từ khi cấp.
Việc dùng LLAMA API rất đơn giản. Sau khi cài đặt (pip install llamaapi), chúng ta có thể thử gọi đầu tiên như sau:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Tuy nhiên, cũng như với OpenAI API, thực hành tốt là nhúng lệnh gọi API trong một hàm bọc. Làm theo cách tiếp cận như trước:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Với triển khai này, chúng ta sẽ nhận chuỗi phản hồi từ LLM chỉ bằng cách gọi llm_call():
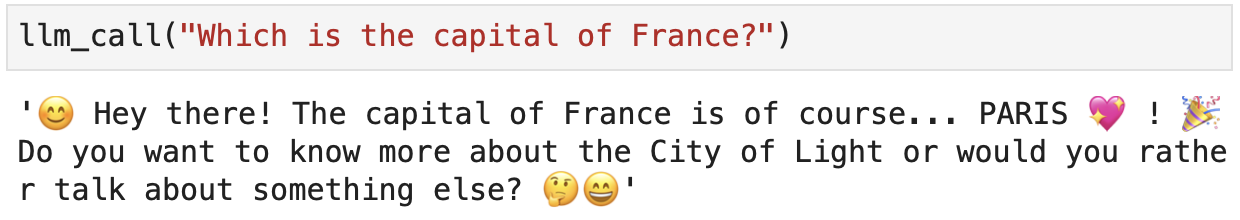
LLAMA API hỗ trợ nhiều mô hình tiên tiến, không chỉ LLaMa của Meta. Chúng ta sẽ tìm hiểu các mô hình được hỗ trợ ở phần tiếp theo!
Cuối cùng, với LLAMA API, chi phí API phụ thuộc vào số lượng tham số của mô hình, và có vẻ là cố định giữa các mô hình:
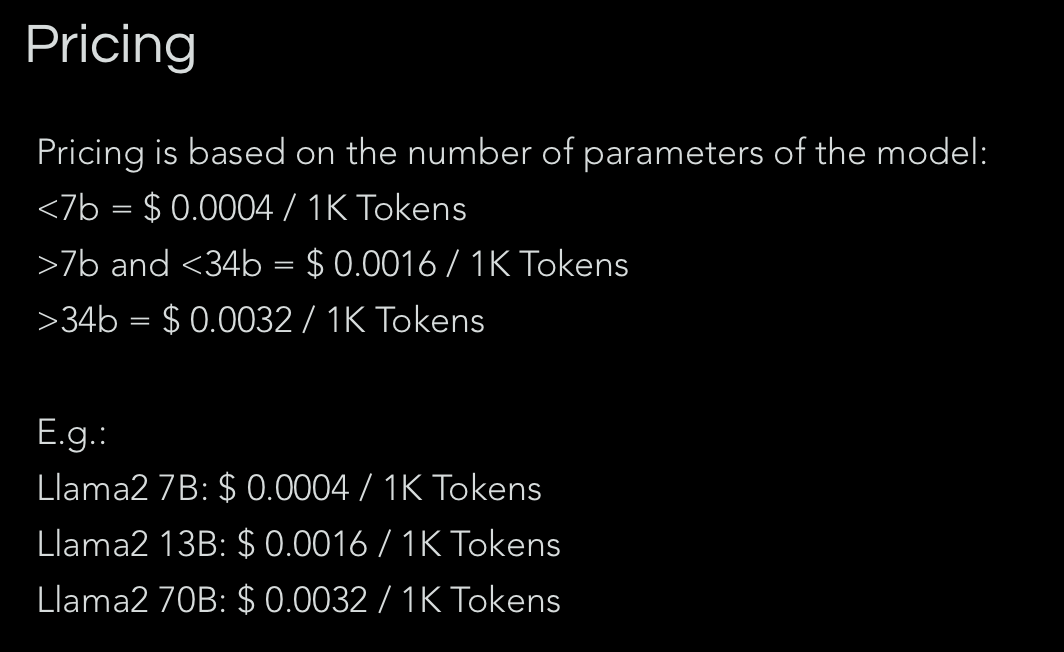
Ảnh chụp màn hình bảng giá LLAMA API. Thông tin này chỉ hiển thị sau khi bạn tạo tài khoản.
Nhà cung cấp bên thứ ba phổ biến nhất cho LLM là Hugging Face. Hugging Face được biết đến nhiều nhất với thư viện transformers, thư viện Python phổ biến nhất cho Xử lý Ngôn ngữ Tự nhiên.
Hugging Face cung cấp nhiều giao diện truy cập LLM. Họ có một playground thân thiện với người dùng gọi là “Spaces”:

Ảnh chụp màn hình playground “Spaces” trên Hugging Face.
Họ cũng cho phép lưu trữ mô hình và triển khai endpoint, cũng như tải trực tiếp và dùng cục bộ các mô hình.
Cần nhớ rằng Hugging Face là kiểu “trang dành cho lập trình viên”, nên dù bạn có thể tìm hướng dẫn khởi động, việc dùng mô hình của họ để mở rộng một ứng dụng đòi hỏi kiến thức kỹ thuật.
Nếu bạn muốn tìm hiểu thêm về Hugging Face, tôi rất khuyên đọc bài What is Hugging Face? The AI Community's Open-Source Oasis.
Một công cụ bổ trợ mà tôi thường dùng để xây dựng ứng dụng dùng LLM từ đầu, cùng với Hugging Face, là LangChain. Hướng dẫn How to Build LLM Applications with LangChain cung cấp phần thực hành nhập môn rất hay.
Chúng ta đã bàn về các phương thức truy cập và chạy LLM như GPT, LLaMa và Mistral. Tuy nhiên, còn rất nhiều mô hình khác, bao gồm nhiều biến thể của các mô hình kể trên. Trong phần này, chúng ta sẽ phân loại các mô hình chính hiện nay, liệt kê đặc điểm, giá và trường hợp sử dụng.
Các mô hình của OpenAI đã trở nên rất phổ biến kể từ khi ChatGPT ra mắt, hiện được vận hành bởi GPT-3.5 hoặc GPT-4, tùy gói đăng ký của bạn. Với nhiều tác vụ cơ bản, khác biệt giữa GPT-3.5 và GPT-4 không quá lớn.
Tuy nhiên, GPT-4 thể hiện năng lực vượt trội hơn nhiều trong các tình huống lập luận phức tạp so với các mô hình trước đó.
Ngoài ra, GPT-4 là mô hình đa phương thức, nhận đầu vào văn bản hoặc hình ảnh và xuất ra văn bản. Nó cũng cho phép dùng plugin để kết nối nguồn bên ngoài. Duyệt Internet là một ví dụ, như việc dùng tìm kiếm Bing.
Có ba biến thể chính của GPT-4 truy cập qua OpenAI API dành cho khách hàng trả phí:
|
Model |
Characteristics |
Context Window |
API |
Local |
Token Pricing |
Training Data |
|
GPT-4 |
Ảnh chụp gpt-4 từ 13/06/2023. Endpoint này nhận cập nhật liên tục. Tối ưu cho hội thoại. |
8.192 token |
Không |
$0,03 / 1K token (đầu vào) $0,06 / 1K token (đầu ra) |
Thg 12 2023 |
|
|
GPT-4 Turbo |
Tên API là gpt-4-turbo-preview. Xuất sắc trong các tác vụ như sinh mã và hướng tới giảm các trường hợp “lười”. |
128k token |
Không |
$0,01 / 1K token (đầu vào) $0,03 / 1K token (đầu ra) |
Thg 12 2023 |
|
|
GPT-4 Vision |
Tên API là gpt-4-vision-preview. GPT-4 với khả năng hiểu hình ảnh, bên cạnh tất cả năng lực của GPT-4 Turbo. |
128k token |
Không |
$0,01 / 1K token (đầu vào) $0,03 / 1k token (đầu ra) |
Thg 4 2023 |
Nhìn chung, điều đáng chú ý là các mô hình GPT, không như LLaMa, là mã nguồn đóng. Điều này có nghĩa chúng ta không thể chạy cục bộ hay tự triển khai endpoint.
Tuy nhiên, vẫn có thể tùy chỉnh qua Fine-tuning API của OpenAI. Ngoài ra, chúng không thể truy cập qua nhà cung cấp bên thứ ba như Ollama, LLAMA API hay Hugging Face.
Về OpenAI Playground, thông tin mô hình bên dưới không hiển thị rõ ràng, nhưng dường như dựa trên GPT-4 với khả năng DALL-E, duyệt web và phân tích.
Hãy cùng xem các mô hình GPT-3 còn lại!
|
Model |
Characteristics |
Context Window |
API |
Local |
Token Pricing |
Training Data |
|
GPT-3.5 Turbo |
Tên API là gpt-3.5-turbo. Là mô hình chủ lực của dòng này. Tối ưu cho đối thoại và chính xác hơn khi phản hồi theo định dạng yêu cầu. |
16.385 token |
Không |
$0,0005 / 1K token (đầu vào) $0,0015 / 1K token (đầu ra) |
Thg 9 2021 |
|
|
GPT-3.5 Turbo Instruct |
Tên API là gpt-3.5-turbo-instruct. Tập trung vào độ chính xác và mức độ liên quan của phản hồi, bám sát nhu cầu người dùng. |
4.096 token |
Không |
$0,0015 / 1K token (đầu vào) $0,0020 / 1K token (đầu ra) |
Thg 9 2021 |
Mô hình GPT-3.5 Turbo Instruct trong bảng đã được fine-tune để theo sát ý định người dùng nhờ Học tăng cường từ phản hồi con người (RLHF).
RLHF là kỹ thuật tích hợp phản hồi của con người vào quá trình học tăng cường để định hướng và cải thiện kết quả học của tác tử AI. Cách tiếp cận này giúp phát triển các mô hình phù hợp hơn với giá trị và sở thích của con người bằng cách đưa phán xét, chỉnh sửa hay ưu tiên của con người trực tiếp vào vòng lặp huấn luyện.
Cuối cùng, như thấy trong bảng, đáng lưu ý là dùng bất kỳ mô hình GPT-3.5 nào cũng rẻ hơn đáng kể so với GPT-4.
Về điểm này, tôi thường khuyên so sánh hiệu năng từng mô hình trên một tập ví dụ xác định rõ để xem GPT-3.5 có đủ cho tác vụ không, qua đó tiết kiệm chi phí suy luận.
Như đã bàn ở các phần trước, các mô hình LLaMa có thể tải xuống miễn phí và chạy cục bộ hoặc xây dựng tùy chỉnh bên trên.
Các mô hình LLaMa thực chất là một đại gia đình mô hình mở với nhiều kích cỡ và biến thể do Meta AI cung cấp:
|
Model |
Characteristics |
Context Window |
API |
Local |
Variant |
Training Data |
|
LLaMa 2 |
Mô hình cơ sở không-chat cho tác vụ completion. |
4096 token |
Có |
Có* |
7B 13B 70B |
Thg 9 2022 |
|
LLaMa 2 Chat |
LLaMa 2 cơ sở với instruction tuning để biến completion đơn giản thành mô hình chat theo sát ý định người dùng. |
4096 token |
Có |
Có* |
7B 13B 70B |
Thg 9 2022 |
|
LLaMa 2 Guard |
Mô hình bảo vệ input-output, huấn luyện để phát hiện nội dung độc hại và gây hại. |
4096 token |
Có** |
Không |
7B |
Thg 9 2022* |
*Hugging Face cũng cung cấp một số biến thể LLaMa, như mô hình cơ sở và chat. **Hiện tại, LLaMa 2 Guard khả dụng trong môi trường đám mây của Amazon SageMaker.
Không giống các mô hình GPT có năng lực lập trình tích hợp sẵn, LLaMa có các mô hình chuyên cho lập trình với cửa sổ ngữ cảnh lớn hơn tới 16k token đạt được qua quá trình fine-tune cho bối cảnh dài.
|
Model |
Characteristics |
Context Window |
API |
Local |
Variant |
Training Data |
|
Code LLaMa |
Mô hình cơ sở không-chat cho tác vụ hoàn thành mã, như GitHub Copilot. Bao gồm một mô hình LLaMa 2 với huấn luyện bổ sung về mã và fine-tune cho bối cảnh dài. |
16k |
Không |
Có |
7B 13B 34B |
Thg 9 2022* |
|
Code LLaMa - Instruct |
Phát sinh từ các mô hình Instruct. Xuất sắc trong hoàn thành và giải thích đoạn mã. |
16k |
Có |
Có |
7B 13B 34B |
Thg 9 2022* |
|
Code LLaMa - Python |
Fine-tune cho ngôn ngữ lập trình Python. |
16k |
Không |
Có |
34B |
Thg 9 2022* |
* Ngày chốt dữ liệu chính thức của LLaMa là Thg 9 2022. Tuy nhiên, dữ liệu tuning mới hơn, từ 2023, đặc biệt với các biến thể mới.
Google có lịch sử dài phát triển Mô hình Ngôn ngữ Lớn. Với việc giới thiệu Gemini, Google bắt đầu thế hệ LLM đa phương thức.
Trong hệ sinh thái của Google, Gemini nổi lên như mô hình chủ lực, là mã nguồn đóng, tương tự ChatGPT. Tuy nhiên, họ gần đây ra mắt Gemma, giới thiệu bộ mô hình mã nguồn mở phát sinh từ Gemini, nhắm tới việc giúp phát triển AI dễ tiếp cận.
Trong bài này, chúng ta sẽ tập trung vào cả Gemini và Gemma:
|
Model |
Characteristics |
API |
Local |
Variants |
|
Gemini |
Mô hình mã nguồn đóng cho các tác vụ tổng quát (tạo văn bản, dịch, hỏi đáp, mã hoá, v.v.) |
Có* |
Không |
Ultra - Giải quyết tác vụ phức tạp. Pro - Phổ tác vụ rộng. Khả năng mở rộng. Nano - Hiệu quả trên thiết bị. |
|
Gemma |
Tác vụ tương tự Gemini, nhưng tập trung tích hợp vào ứng dụng tùy chỉnh và nghiên cứu. Là mô hình gọn nhẹ. |
Có**LLAMA API |
CóOllama |
2B 7B |
*Có API cho Gemini cho mục đích thương mại (không mở cho triển khai). Dù vậy, chúng ta có thể thử mô hình qua playground của nó.
**Không có endpoint gốc của Google, nhưng mô hình truy cập được qua Kaggle và Google Colab. Thông tin chi tiết trong tài liệu chính thức của Google.
Về các biến thể Gemini, Gemini Ultra là mô hình đa phương thức vượt trội trong các tác vụ phân tích phức tạp. Gemini Pro cân bằng hiệu năng và khả năng mở rộng, nổi bật ở tác vụ tạo mã và văn bản. Cuối cùng, Gemini Nano tập trung vào hiệu quả cho chạy trên thiết bị, hoạt động trên thiết bị di động và biên mà không đòi hỏi tài nguyên lớn.
Đối với các mô hình của Google, hiện chưa có nhiều thông tin công khai về cửa sổ ngữ cảnh và ngày chốt dữ liệu huấn luyện vào thời điểm viết bài.
Mistral AI là công ty AI của Pháp thành lập tháng 4/2023 bởi cựu nhân viên Meta Platforms và Google DeepMind. Họ tập trung phát triển LLM mã nguồn mở, nhấn mạnh tầm quan trọng của phần mềm nguồn mở trước các mô hình đóng. Công ty cung cấp các mô hình như Mistral 7B và Mixtral 8x7B với năng lực xử lý ngôn ngữ tiên tiến.
|
Model |
Characteristics |
Context Window |
API |
Local |
Token Pricing |
Training Data |
|
Mistral |
Mô hình mục đích chung với 7B tham số. Tối ưu cho tiếng Anh và các tác vụ sinh mã. |
32k |
Có* |
Có |
$0,25 / 1M token (đầu vào và đầu ra) |
Thg 9 2023 |
|
Mixtral |
Mô hình mục đích chung mạnh mẽ nhất. Thông thạo tiếng Anh, Pháp, Ý, Đức, Tây Ban Nha và mạnh về lập trình. Dựa trên kiến trúc Mixture-of-Expert thưa 7B tham số. |
32k |
Có* |
Có |
$0,7 / 1M token (đầu vào và đầu ra) |
Thg 12 2023 |
*Chúng ta có thể tương tác với các mô hình của Mistral AI bằng playground “La Plataforme”.
** Hugging Face cũng cung cấp môi trường thử nghiệm suy luận thời gian thực qua API cho một số mô hình. Đây cũng là nhà cung cấp bên thứ ba cho phép bạn triển khai endpoint trả phí cho các mô hình sẵn có.
Về mô hình Mixtral, kiến trúc “Mixture-of-Experts” cho phép mô hình phân chia tổng năng lực thành các nhóm chuyên gia khác nhau. Mỗi chuyên gia được tối ưu cho dạng tác vụ hay dữ liệu cụ thể.
Khi xử lý đầu vào, Mixtral sẽ kích hoạt động các chuyên gia liên quan, giúp xử lý tác vụ phức tạp hiệu quả bằng cách chỉ dùng một phần tham số cho mỗi token. Cách này nâng cao hiệu năng Mixtral, giúp mô hình giỏi nhiều ngôn ngữ và tác vụ, đồng thời tối ưu tài nguyên tính toán. Tên “Mixtral 8x7B” ám chỉ việc dùng 8 nhóm “chuyên gia” riêng biệt.
Cuối cùng, Mistral AI cũng cung cấp ba mô hình thương mại: Mistral Small, Mistral Medium và Mistral Large. Nếu quan tâm, bạn có thể xem thêm thông tin về mô hình và giá trong tài liệu chính thức.
Đến giờ, chúng ta đã thấy nhiều mô hình và biến thể từ các công ty nổi tiếng. Tuy vậy, còn rất nhiều thứ để khám phá!
Tôi muốn nhấn mạnh các mô hình Falcon từ Technology Innovation Institute, khả dụng trên cả Ollama và LLAMA API. Cũng có Orca2 của Microsoft Research nổi bật về lập luận, khả dụng trên Ollama và Hugging Face.
Bạn có thể đọc về các mô hình mã nguồn mở khác tại 8 Top Open-Source LLMs for 2024 and Their Uses.
Trong bài này, chúng ta đã bàn nhiều khía cạnh cần cân nhắc khi chọn Mô hình Ngôn ngữ Lớn tốt nhất cho ứng dụng mục tiêu. Dù mục tiêu của hướng dẫn là làm tờ ghi chú nhanh, không có quy tắc vàng để chọn ngay mô hình tốt nhất.
Theo kinh nghiệm cá nhân, tôi cho rằng xác định cách chúng ta muốn tương tác với LLM là điểm khởi đầu tốt vì nó sẽ rút gọn đáng kể số mô hình — và biến thể — cần xét.
Khía cạnh thứ hai là tác vụ mục tiêu mà mô hình sẽ thực hiện: chatbot tổng quát, chuyên gia tóm tắt, trợ lý lập trình, v.v.
Dù chúng ta luôn có thể fine-tune mô hình cho tác vụ mong muốn, chúng ta đã thấy có những biến thể đã fine-tune sẵn cho một số trường hợp, giúp tiết kiệm thời gian, tài nguyên tính toán và chuyên môn kỹ thuật. Cân nhắc cửa sổ ngữ cảnh cần cho ứng dụng cũng rất quan trọng để chọn mô hình tốt nhất.
Cuối cùng, giá luôn là chỉ dấu tốt để chọn mô hình. Đáng tiếc, phần lớn thời gian, dự án bị giới hạn bởi đầu tư ban đầu và chi phí duy trì theo thời gian. Về chi phí, luôn nhớ rằng huấn luyện và fine-tuning không miễn phí trong quá trình phát triển dự án và thực sự tốn thời gian.
Tiếp tục hành trình AI của bạn ngay hôm nay!
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
