
Programma
Nozioni di base sull'intelligenza artificiale
10 ore
Dall'uscita di ChatGPT, sembra che ogni pochi giorni compaia un nuovo Large Language Model (LLM), insieme a nuove aziende specializzate in questa tecnologia. Ogni nuovo LLM viene addestrato per superare il precedente in vari modi. Per esempio, vediamo sempre più spesso LLM pensati per migliorare un caso d'uso specifico: modelli per chat, assistenti per il coding e comprensione di contesti lunghi, tra gli altri.
Scegliere il modello giusto per una nuova applicazione o progetto basato su LLM può essere un compito scoraggiante, senza contare la difficoltà di restare aggiornati sugli ultimi modelli e le loro funzionalità.
Nel mio caso, questo spesso mi porta a usare di default ChatGPT o i modelli GPT tramite chiamate API.
Qui voglio approfondire la variegata gamma di modelli disponibili e mettere in evidenza le principali capacità da considerare quando si sceglie il modello giusto in base alle caratteristiche del progetto.
Ci concentreremo in particolare sui diversi metodi di interazione con questi modelli, come una delle funzionalità chiave da valutare quando si sceglie tra tutti i modelli disponibili.
L'obiettivo è che questa guida completa funzioni come un cheat sheet, aiutandoti a orientarti nella vasta selezione di LLM disponibili per i tuoi compiti specifici.
Se sei alle prime armi con gli LLM, ti consiglio davvero di seguire i corsi AI Fundamentals e Large Language Models Concepts per familiarizzare con termini e modelli di base.
Accedere agli LLM e interfacciarsi con loro in un'applicazione o progetto basato su LLM può avvenire in vari modi a seconda delle esigenze tecniche.
L'approccio più intuitivo per interfacciarsi con gli LLM è tramite interfacce conversazionali nel browser. È il caso di ChatGPT, dove l'interfaccia utente è semplicemente una chat che ti permette di interagire con il modello.
In generale, queste interfacce consentono poco o nessun controllo o personalizzazione del modello da parte dell'utente, ma sono un modo semplice per provare i modelli per compiti di base. ChatGPT di OpenAI e Gemini di Google offrono questo tipo di interfacce:
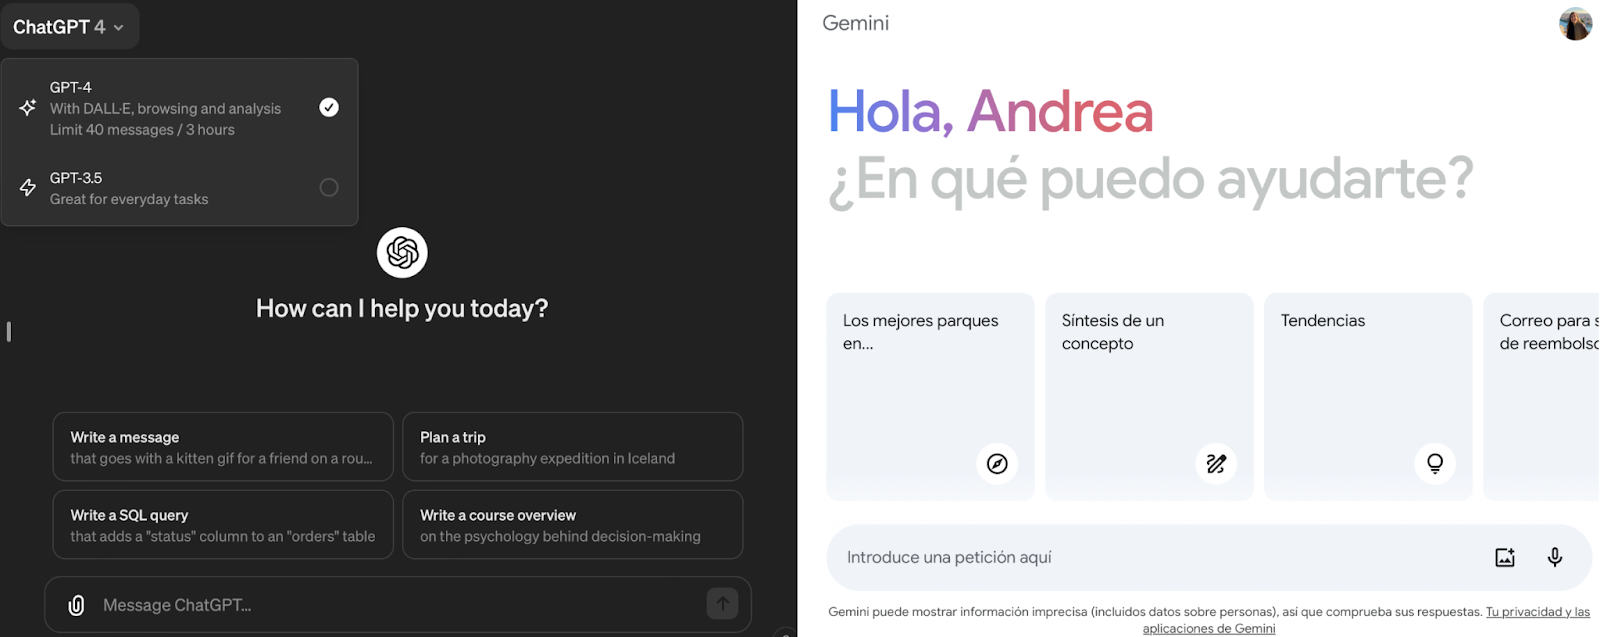
Screenshot delle interfacce di chat di ChatGPT di OpenAI (sinistra) e Gemini di Google (destra).
A volte, alcuni provider consentono anche un certo grado di personalizzazione tramite interfacce chat ugualmente semplici da usare. Nel caso di OpenAI, la piattaforma si chiama "Playground".
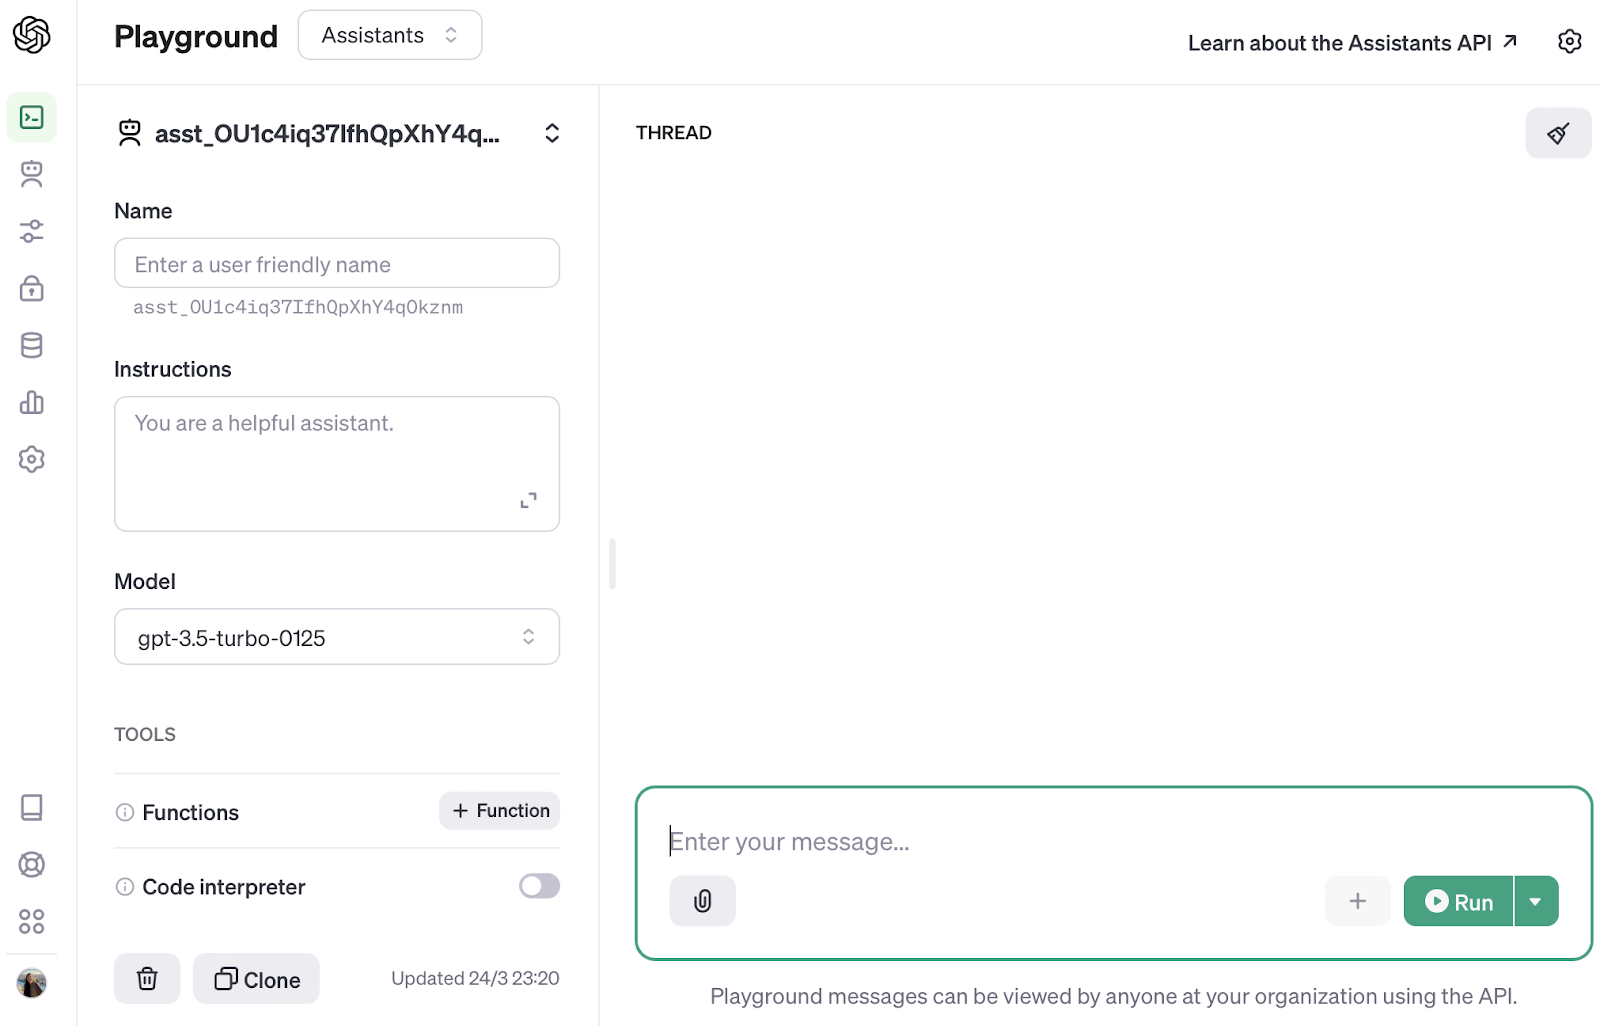
Screenshot dell'interfaccia OpenAI Playground.
Le interfacce Playground ci permettono di provare modelli diversi con un controllo limitato delle impostazioni. In questo modo possiamo esplorare quali parametri sono adatti al tuo compito. Tuttavia, come avrai probabilmente già notato, le interfacce playground o chat non permettono di incorporare l'interazione con l'LLM in un'applicazione o progetto.
Una delle interfacce più popolari per interrogare gli LLM è l'accesso via API. Questo approccio è particolarmente vantaggioso quando non richiediamo ulteriore personalizzazione del modello.
Le chiamate API possono essere integrate senza soluzione di continuità nei nostri script, eliminando la necessità di configurare e mantenere l'infrastruttura da parte nostra.
Tuttavia, la comodità ha un prezzo e, nonostante la dipendenza da servizi esterni — una dipendenza che avrai sempre se preferisci non ospitare il modello e gestirne l'infrastruttura necessaria — i costi inevitabilmente scaleranno con l'uso.
Nel caso delle chiamate API, una buona pratica è implementare un semplice wrapper attorno alla chiamata API stessa per interfacciarsi con il modello in modo modulare. Per l'API di OpenAI, che è quella che ho usato di più finora, utilizzo sempre il wrapper nella prossima sezione, in modo che la selezione del modello sia trasparente per l'utente.
Scrivere un metodo standardizzato ma flessibile per interrogare i modelli GPT tramite l'API di OpenAI è molto utile se vuoi interfacciarti con il modello in modo fluido e meno soggetto a errori. Ecco perché di solito imposto la chiamata GPT in una funzione wrapper all'inizio del programma, assicurandomi che l'uso del modello sia trasparente per l'applicazione.
La libreria openai (pip install openai) fornisce già un endpoint ChatCompletion che ci permette di chiamare qualsiasi modello GPT usando il metodo .create.
Il metodo .create ha due parametri obbligatori:
gpt-4.Dati questi due parametri, possiamo scrivere la chiamata a GPT come segue:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Quando chiamiamo il modello, otterremo la completion in formato JSON:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Pertanto, sarebbe utile ottenere solo la completion del modello come valore di ritorno della funzione. Mettendo insieme tutti i pezzi, la nostra implementazione del wrapper può essere scritta così:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Se ti interessano maggiori dettagli su questa implementazione, l'articolo ChatGPT API Calls: A Gentle Introduction approfondisce ulteriormente!
Infine, vale anche la pena notare che la maggior parte dei provider API, inclusa OpenAI, offre alcune chiamate gratuite quando crei il tuo account. I crediti però sono limitati (di solito a meno di 20 $) e in genere vincolati a una finestra temporale (di solito un mese).
In ogni caso, è sempre una buona pratica incapsulare le chiamate agli LLM in una funzione — o in una raccolta di funzioni — così che il modello sia trasparente per l'applicazione indipendentemente dal provider.
Ospitare il modello in proprio significa scaricare i pesi del modello ed eseguirlo su macchine locali o server privati.
Questo approccio è interessante perché consente il pieno controllo sull'infrastruttura del modello, ma significa anche che lo sforzo tecnico aumenta considerevolmente.
Se sei curioso dei passaggi necessari per gestire l'infrastruttura per un LLM, dai un'occhiata all'articolo LLMOps Essentials!
Eseguire il modello in locale consente un'ulteriore personalizzazione in base alle nostre esigenze. In questo contesto, una delle scelte più popolari per l'auto-hosting sono i noti modelli LLaMa di Meta AI. Hanno rilasciato modelli leggeri che possono essere eseguiti su un laptop con soli 8 GB di RAM.
Eseguire il modello LLaMa sul nostro laptop è abbastanza semplice, grazie a piattaforme come Ollama.
Ollama offre una piattaforma progettata per eseguire in locale LLM come LLaMa 2 e Code LLaMa sui nostri dispositivi. Supporta macOS, Linux e Windows, consentendo la personalizzazione e la creazione di modelli proprietari. Per maggiori dettagli, puoi visitare il sito di Ollama.
Il download della piattaforma Ollama può essere effettuato dalla pagina ufficiale, mentre i pesi del modello possono essere scaricati direttamente tramite l'interfaccia da terminale.
Installiamo prima Ollama navigando sulla sua pagina principale!
 Screenshot della pagina principale del sito di Ollama.
In questo caso, Ollama è un'utilità da riga di comando:
Screenshot dell'installazione dello strumento a riga di comando Ollama.
Una volta installata l'utilità a riga di comando, possiamo avviare il modello con il comando ollama run <model name>. Se è la prima volta che esegui il modello sul nostro dispositivo, Ollama lo scaricherà per noi:
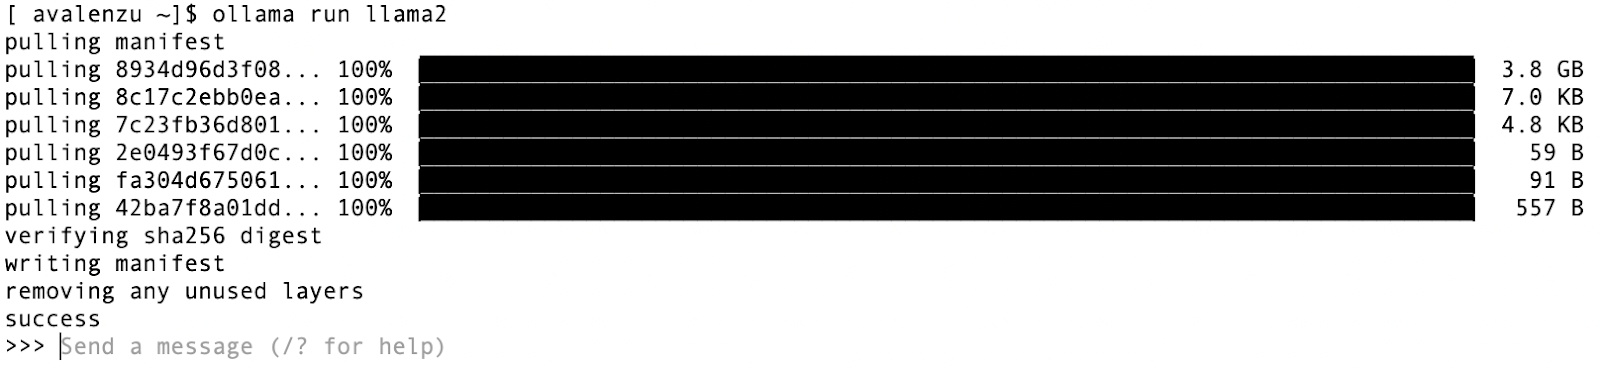
Screenshot del primo avvio del modello LLaMa 2 con lo strumento a riga di comando Ollama. Il modello viene scaricato automaticamente al primo utilizzo.
Da quel momento in poi, inviare prompt ed uscire dal modello da riga di comando è molto semplice:
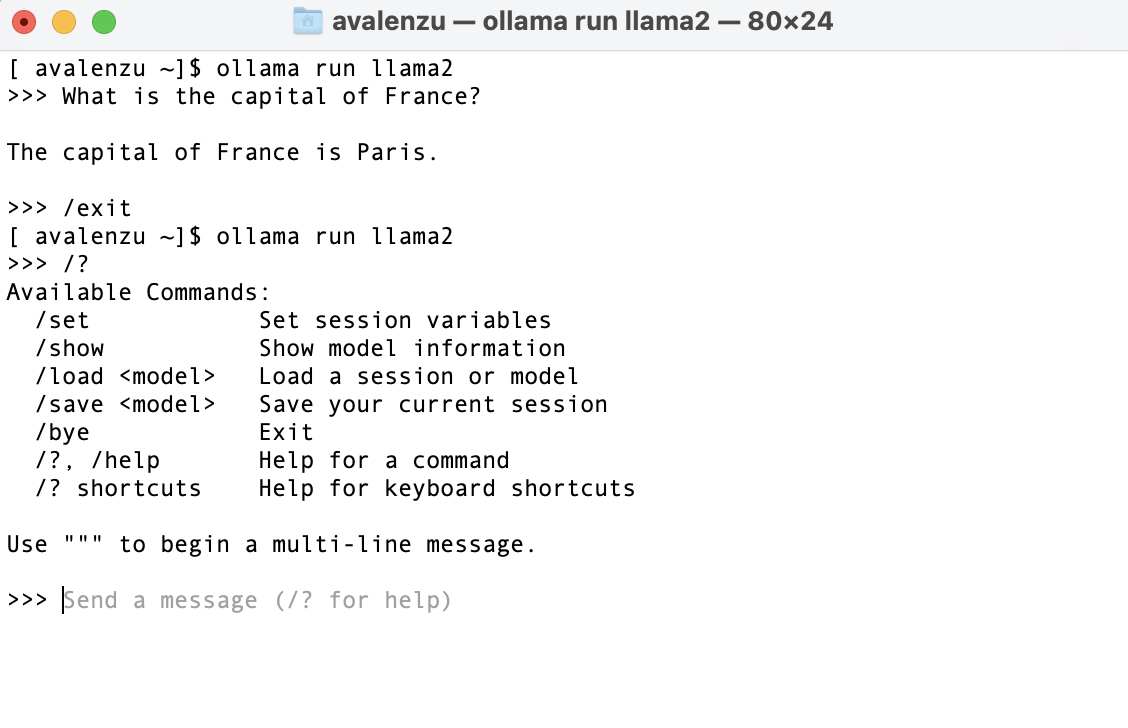
Screenshot dell'interazione dell'utente con il modello tramite lo strumento a riga di comando Ollama.
Come possiamo vedere nell'immagine qui sopra, il modello dispone anche di un piccolo set di comandi extra.
Ollama supporta anche altri modelli, come il nuovo Mistral:
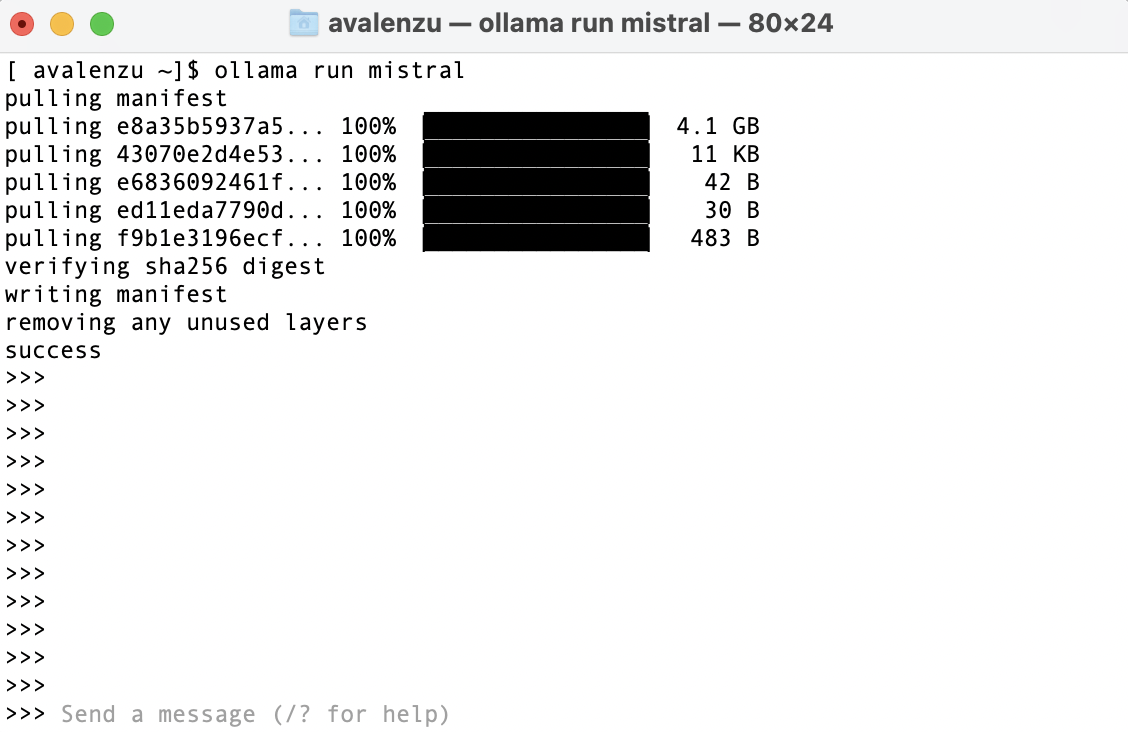
Screenshot del primo avvio del modello Mistral con lo strumento a riga di comando Ollama. Il modello viene scaricato automaticamente al primo utilizzo.
Anche in questo caso, il modello è pronto all'uso con un solo comando!
Questo approccio è vantaggioso perché consuma solo le risorse del nostro dispositivo. Tuttavia, è importante ricordare che le prestazioni del modello in genere aumentano con il numero di parametri.
Di conseguenza, più parametri ha un modello, più risorse richiederà. Pertanto, per applicazioni LLM self-hosted, i modelli più grandi probabilmente dovranno essere eseguiti su server privati.
Nel caso in cui vogliamo costruire un'applicazione su larga scala, vale la pena notare che Ollama può anche essere eseguito con Docker Desktop su Mac ed essere eseguito all'interno di container Docker con accelerazione GPU su Linux.
A questo punto potresti chiederti: Posso incorporare OLLAMA nei miei script?
Certo, ospitare il modello in proprio non significa che tu non possa integrarlo nei tuoi script Python! Ollama offre anche la possibilità di interfacciarsi con il tuo modello self-hosted via Python.
Le librerie Python e JavaScript di Ollama ci permettono di incorporare l'inferenza del modello nei nostri script.
Ollama non è l'unica opzione se vogliamo ospitare il modello in proprio. In generale, gli LLM sono spesso disponibili per il download su più piattaforme open-source che offrono anche supporto dalla community.
Gli LLM open-source sono generalmente disponibili gratuitamente per scopi accademici e di ricerca. Tuttavia, i termini d'uso commerciale possono variare in base alla specifica licenza con cui un modello viene rilasciato. Ricorda sempre se stai sperimentando con gli LLM o costruendo applicazioni basate su LLM per scopi commerciali.
Vuoi iniziare oggi il tuo percorso di sviluppo di LLM? Allora il corso Developing Large Language Models fa per te!
Ospitare modelli potenti in locale può essere molto intensivo in termini di risorse, motivo per cui i servizi cloud possono essere un'alternativa valida, consentendo la scalabilità delle risorse on-demand e il supporto da parte dei provider cloud.
È interessante notare che i servizi cloud tradizionali, come Azure, ora offrono pipeline personalizzate per ospitare LLM, come Mistral, così da non dover implementare un hosting specializzato.
Questo è un grande vantaggio per distribuire applicazioni all'interno della tua organizzazione, poiché molte aziende hanno già contratti con questi provider per servizi come email e soluzioni cloud generiche.
Scegliere provider di terze parti può offrire un equilibrio tra il non dover gestire l'infrastruttura di hosting e l'avere un certo controllo sul modello, rispetto al semplice utilizzo di un servizio API nativo.
Questi provider in genere offrono accesso via API, ma è importante notare che i costi possono aumentare significativamente con un uso intensivo, in modo analogo all'uso della API nativa di OpenAI.
La differenza chiave risiede nel soggetto che ospita. I provider di terze parti, anziché i servizi LLM nativi, ospitano il modello sulla loro infrastruttura ed espongono l'endpoint API, offrendo spesso una varietà di modelli da fonti diverse per un'integrazione flessibile.
Un popolare provider di API di terze parti è la LLAMA API.
Screenshot della pagina principale del sito LLAMA API.
L'API non è gratuita, ma puoi provarla gratis dato che vengono emessi 5 $ di crediti gratuiti per ogni nuovo account. Ricorda però che tali crediti sono validi solo per un mese dalla loro emissione.
Usare LLAMA API è molto semplice. Una volta installata (pip install llamaapi), possiamo fare una prima chiamata di prova così:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Tuttavia, come per l'API di OpenAI, è una buona pratica incapsulare la chiamata API in una funzione wrapper. Seguendo lo stesso approccio di prima:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Data questa implementazione, otterremo la risposta in stringa dall'LLM semplicemente chiamando llm_call():
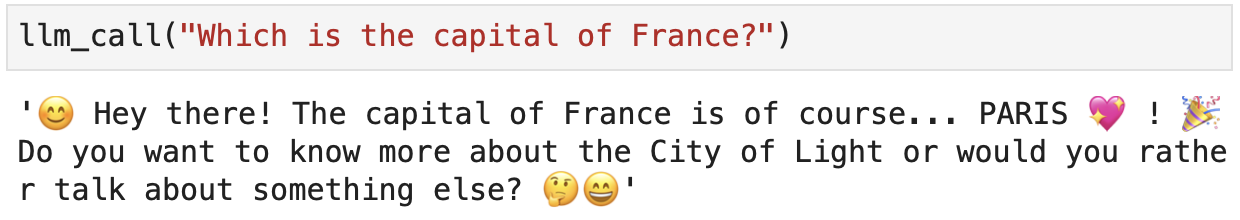
LLAMA API supporta una varietà di modelli all'avanguardia, non solo LLaMa di Meta. Scopriremo quali modelli supporta nella prossima sezione!
Infine, nel caso di LLAMA API, il costo dell'API dipende dal numero di parametri del modello e sembra essere costante tra tutti i modelli:
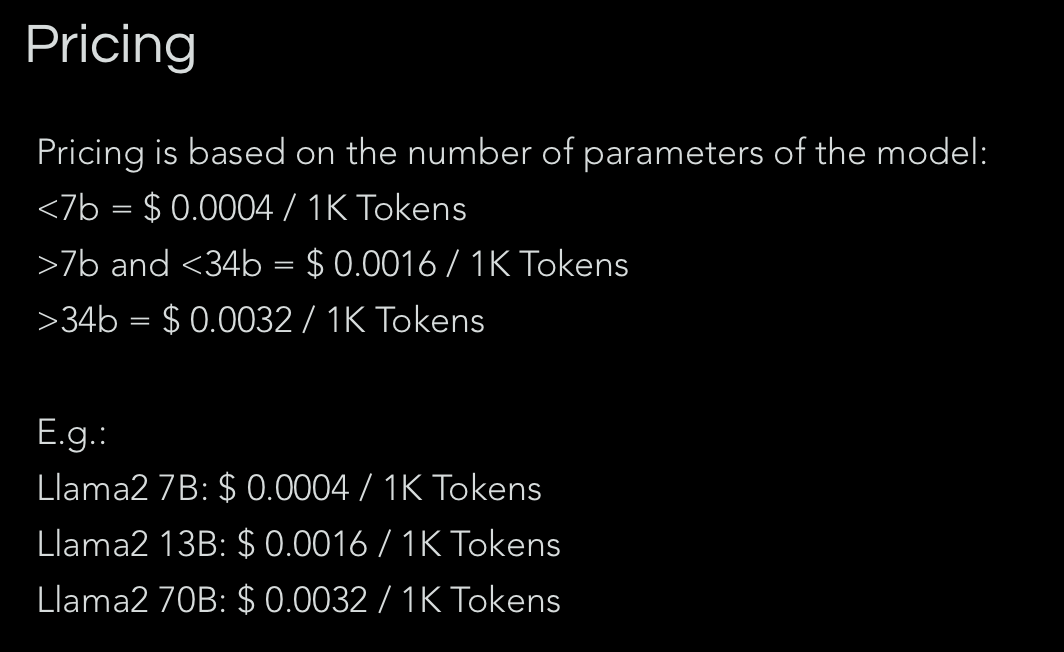
Screenshot del pricing di LLAMA API. Queste informazioni sono disponibili solo dopo la creazione di un account.
Il provider di terze parti più popolare per gli LLM è Hugging Face. Hugging Face è conosciuto soprattutto per la libreria transformers, la più popolare in Python per il Natural Language Processing.
Hugging Face fornisce molteplici interfacce per accedere agli LLM. Dispone di un'interfaccia playground intuitiva chiamata "Spaces":

Screenshot del playground "Spaces" in Hugging Face.
Consente anche l'hosting dei modelli e il deployment di endpoint, oltre al download diretto e all'uso locale dei modelli.
È importante tenere a mente che Hugging Face è una sorta di "sito per sviluppatori", quindi, nonostante si possano trovare tutorial per iniziare, usare i loro modelli per far scalare un'applicazione richiede conoscenze tecniche.
Se vuoi saperne di più su Hugging Face, ti consiglio vivamente l'articolo What is Hugging Face? The AI Community's Open-Source Oasis.
Uno strumento complementare che uso spesso per costruire da zero applicazioni basate su LLM, insieme a Hugging Face, è LangChain. Il tutorial How to Build LLM Applications with LangChain offre una bella introduzione pratica.
Abbiamo discusso i diversi metodi di accesso ed esecuzione degli LLM, come i modelli GPT, LLaMa e Mistral. Tuttavia, esistono molti altri modelli, incluse varie varianti di quelli citati. In questa sezione classificheremo i principali modelli esistenti oggi, elencandone caratteristiche, prezzi e casi d'uso.
I modelli di OpenAI sono diventati molto popolari dall'uscita di ChatGPT, oggi alimentato da GPT-3.5 o GPT-4 a seconda dell'abbonamento. Per molti compiti di base, la differenza tra i modelli GPT-3.5 e GPT-4 non è significativa.
Tuttavia, GPT-4 mostra una capacità molto maggiore in scenari di ragionamento complesso rispetto a qualsiasi modello precedente.
Inoltre, GPT-4 è un modello multimodale che accetta input testuali o di immagini e produce testo. Offre anche la possibilità di usare plugin per interfacciarsi con fonti esterne. La navigazione in Internet è un esempio, come dimostra l'uso delle ricerche Bing.
Esistono tre principali varianti di GPT-4 accessibili tramite l'API di OpenAI per clienti paganti:
|
Modello |
Caratteristiche |
Finestra di contesto |
API |
Locale |
Prezzo per token |
Dati di training |
|
GPT-4 |
Snapshot di gpt-4 del 13 giugno 2023. Questo endpoint riceve aggiornamenti costanti. Ottimizzato per la chat. |
8.192 token |
No |
$0,03 / 1K token (input) $0,06 / 1K token (output) |
Dic 2023 |
|
|
GPT-4 Turbo |
Il nome API è gpt-4-turbo-preview. Eccelle in compiti come la generazione di codice ed è pensato per ridurre i casi di "pigrizia". |
128k token |
No |
$0,01 / 1K token (input) $0,03 / 1K token (output) |
Dic 2023 |
|
|
GPT-4 Vision |
Il nome API è gpt-4-vision-preview. GPT-4 con la capacità di comprendere le immagini, oltre a tutte le altre funzionalità di GPT-4 Turbo. |
128k token |
No |
$0,01 / 1K token (input) $0,03 / 1k token (output) |
Apr 2023 |
In generale, è interessante notare che i modelli GPT, a differenza dei modelli LLaMa, sono closed-source. Ciò significa che non possiamo eseguirli in locale né distribuire un nostro endpoint.
Tuttavia, c'è la possibilità di personalizzazione tramite la Fine-tuning API di OpenAI. Inoltre, non sono accessibili tramite provider terzi come Ollama, LLAMA API o Hugging Face.
Per quanto riguarda l'OpenAI Playground, le informazioni sul modello sottostante non sono chiaramente mostrate, ma sembra basato sul modello GPT-4 con capacità di DALL-E, browsing e analisi.
Diamo anche uno sguardo ai modelli GPT-3 disponibili!
|
Modello |
Caratteristiche |
Finestra di contesto |
API |
Locale |
Prezzo per token |
Dati di training |
|
GPT-3.5 Turbo |
Il nome API è gpt-3.5-turbo. È il modello di punta di questa famiglia. È ottimizzato per il dialogo e mostra maggiore accuratezza nel rispondere nei formati richiesti. |
16.385 token |
No |
$0,0005 / 1K token (input) $0,0015 / 1K token (output) |
Set 2021 |
|
|
GPT-3.5 Turbo Instruct |
Il nome API è gpt-3.5-turbo-instruct. Si concentra su accuratezza e pertinenza delle risposte, allineandosi strettamente alle esigenze dell'utente. |
4.096 token |
No |
$0,0015 / 1K token (input) $0,0020 / 1K token (output) |
Set 2021 |
Il modello GPT-3.5 Turbo Instruct presentato in tabella è stato migliorato per seguire meglio le intenzioni dell'utente tramite Reinforcement Learning from Human Feedback (RLHF).
RLHF è una tecnica in cui il feedback umano viene integrato nel processo di reinforcement learning per guidare e migliorare i risultati di apprendimento degli agenti di IA. Questo approccio consente di sviluppare modelli più allineati ai valori e alle preferenze umane, incorporando giudizi, correzioni o preferenze umane direttamente nel ciclo di training.
Infine, come possiamo osservare dalla tabella, vale la pena notare che l'uso di uno qualsiasi dei due modelli GPT-3.5 è considerevolmente più economico di GPT-4.
In questo senso, consiglio di confrontare le prestazioni di ciascun modello su un insieme di esempi ben definiti per vedere se GPT-3.5 è sufficiente per il compito in questione, risparmiando così sui costi di inferenza.
Come discusso nelle sezioni precedenti, i modelli LLaMa sono gratuiti da scaricare ed eseguire in locale o disponibili per costruirci sopra personalizzazioni.
I modelli LLaMa sono in realtà una grande famiglia di modelli open in termini di dimensioni e varianti fornita da Meta AI:
|
Modello |
Caratteristiche |
Finestra di contesto |
API |
Locale |
Variante |
Dati di training |
|
LLaMa 2 |
Modello base non chat per compiti di completion. |
4096 token |
Sì |
Sì* |
7B 13B 70B |
Set 2022 |
|
LLaMa 2 Chat |
LLaMa 2 base con instruction tuning per trasformare semplici completion in un modello di chat che segue l'intento dell'utente. |
4096 token |
Sì |
Sì* |
7B 13B 70B |
Set 2022 |
|
LLaMa 2 Guard |
Modello di salvaguardia input-output addestrato per rilevare contenuti tossici e dannosi. |
4096 token |
Sì** |
No |
7B |
Set 2022* |
*Hugging Face fornisce anche alcune varianti di LLaMa, come i modelli base e chat. **Per il momento, LLaMa 2 Guard è accessibile nell'ambiente cloud di Amazon SageMaker.
A differenza dei modelli GPT che hanno capacità di coding integrate, i modelli LLaMa hanno modelli dedicati al coding con finestre di contesto più ampie di 16k token ottenute tramite un processo di fine-tuning per contesti lunghi.
|
Modello |
Caratteristiche |
Finestra di contesto |
API |
Locale |
Variante |
Dati di training |
|
Code LLaMa |
Modello base non chat per compiti di completamento del codice, come GitHub Copilot. Consiste in un modello LLaMa 2 con addestramento aggiuntivo su codice e fine-tuning per contesti lunghi. |
16k |
No |
Sì |
7B 13B 34B |
Set 2022* |
|
Code LLaMa - Instruct |
Derivato dai modelli Instruct. Eccelle nelle completion di codice e nelle spiegazioni su frammenti di codice. |
16k |
Sì |
Sì |
7B 13B 34B |
Set 2022* |
|
Code LLaMa - Python |
Ottimizzato per il linguaggio di programmazione Python. |
16k |
No |
Sì |
34B |
Set 2022* |
* La data di cut-off ufficiale dei modelli LLaMa è settembre 2022. Tuttavia, i dati di tuning sono più recenti, risalenti al 2023, soprattutto per le varianti più nuove.
Google ha una lunga storia nello sviluppo di Large Language Model. Con l'introduzione del modello Gemini, Google ha avviato la sua generazione di LLM multimodali.
Nel contesto delle offerte di Google, Gemini emerge come modello di punta, ed è closed-source, analogamente a ChatGPT. Tuttavia, di recente hanno lanciato Gemma, che introduce una suite di modelli open-source derivati da Gemini, pensati per facilitare lo sviluppo di IA accessibile.
In questo articolo ci concentreremo sia su Gemini che su Gemma:
|
Modello |
Caratteristiche |
API |
Locale |
Varianti |
|
Gemini |
Modello closed-source per compiti generici (generazione di testo, traduzione, question answering, codice, ecc.) |
Sì* |
No |
Ultra - Risolve compiti complessi. Pro - Ampia gamma di compiti. Scalabile. Nano - Efficiente su dispositivo. |
|
Gemma |
Compiti simili a Gemini, ma focalizzato sull'integrazione in applicazioni personalizzate e nella ricerca. È un modello leggero. |
Sì**LLAMA API |
SìOllama |
2B 7B |
*Esiste un'API per Gemini per scopi commerciali (non aperta a deployment). Tuttavia, possiamo provare il modello tramite la sua interfaccia Playground.
**Non esiste un endpoint Google nativo, ma il modello è accessibile tramite Kaggle e Google Colab. Maggiori informazioni sono disponibili nella documentazione ufficiale di Google.
Per quanto riguarda le varianti di Gemini, Gemini Ultra è un modello multimodale che eccelle in compiti di analisi complessa. Gemini Pro bilancia prestazioni e scalabilità e si distingue in compiti come generazione di codice e testo. Infine, Gemini Nano punta all'efficienza su dispositivo, girando su dispositivi mobili ed edge senza pesanti richieste di risorse.
Riguardo ai modelli di Google, al momento della stesura non sono disponibili molte informazioni pubbliche sulle finestre di contesto e sulla data di cut-off dei dati di training.
Mistral AI è un'azienda francese di IA fondata nell'aprile 2023 da ex dipendenti di Meta Platforms e Google DeepMind. Si concentra sullo sviluppo di LLM open-source, sottolineando l'importanza dell'open-source in risposta ai modelli proprietari. L'azienda offre modelli come Mistral 7B e Mixtral 8x7B con avanzate capacità di elaborazione del linguaggio.
|
Modello |
Caratteristiche |
Finestra di contesto |
API |
Locale |
Prezzo per token |
Dati di training |
|
Mistral |
Modello general-purpose con 7B parametri. Ottimizzato per la lingua inglese e per compiti di generazione di codice. |
32k |
Sì* |
Sì |
$0,25 / 1M token (input e output) |
Set 2023 |
|
Mixtral |
Modello general-purpose più potente. Fluente in inglese, francese, italiano, tedesco, spagnolo, e molto forte nei compiti di coding. Si basa su un'architettura sparsa Mixture-of-Experts con 7B parametri. |
32k |
Sì* |
Sì |
$0,7 / 1M token (input e output) |
Dic 2023 |
*Possiamo interagire con i modelli di Mistral AI usando il loro Playground chiamato "La Plataforme".
** Hugging Face offre anche un banco di prova per l'inferenza in tempo reale usando la sua API per alcuni modelli. È anche un provider di terze parti che consente di distribuire endpoint a pagamento ai modelli disponibili.
Per quanto riguarda il modello Mixtral, l'architettura "Mixture-of-Experts" consente al modello di suddividere le sue capacità complessive in diversi gruppi specializzati o "esperti". Ogni esperto è ottimizzato per specifici tipi di compiti o dati.
Durante l'elaborazione di un input, Mixtral attiva dinamicamente solo gli esperti pertinenti, consentendogli di gestire in modo efficiente compiti complessi utilizzando una frazione dei parametri totali per ciascun token. Questo metodo migliora le prestazioni di Mixtral, rendendolo adatto a una varietà di lingue e compiti, ottimizzando al contempo le risorse computazionali. Il nome del modello Mixtral è infatti "Mixtral 8x7B" proprio perché utilizza 8 distinti gruppi di "esperti".
Infine, Mistral AI offre anche tre modelli commerciali: Mistral Small, Mistral Medium e Mistral Large. Se ti interessa, puoi trovare maggiori informazioni sui modelli e sul pricing nella documentazione ufficiale.
Finora abbiamo visto più modelli e varianti delle aziende più famose del settore. Tuttavia, c'è molto altro da esplorare!
Vorrei evidenziare i modelli Falcon del Technology Innovation Institute, disponibili sia su Ollama che su LLAMA API. C'è anche il modello Orca2 di Microsoft Research, che eccelle in particolare nel ragionamento, anch'esso disponibile su Ollama e Hugging Face.
Puoi leggere altri modelli open-source disponibili in 8 Top Open-Source LLMs for 2024 and Their Uses.
In questo articolo, abbiamo discusso diversi aspetti da considerare quando si seleziona il miglior Large Language Model per la nostra applicazione target. Sebbene l'obiettivo di questa guida fosse fungere da cheat sheet, non esiste una regola d'oro per scegliere subito il modello migliore.
In base alla mia esperienza personale, credo che definire come vorremmo interfacciarci con l'LLM sia un buon punto di partenza, poiché ridurrà già il numero di modelli — e varianti — disponibili.
Il secondo aspetto da considerare è il compito obiettivo che il modello svolgerà: chatbot generico, esperto di riassunti, assistente per il coding, ecc.
Sebbene possiamo sempre fare fine-tuning di un modello per il nostro compito desiderato, abbiamo visto che esistono varianti già ottimizzate per determinati casi d'uso che ci faranno risparmiare tempo, risorse computazionali e competenze tecniche. Considerare la finestra di contesto necessaria per l'applicazione è anche fondamentale per selezionare il modello migliore.
Infine, il prezzo è sempre un buon indicatore di quale modello usare. Purtroppo, molto spesso, il progetto stesso è limitato dall'investimento iniziale e dal costo di mantenimento nel tempo. Per quanto riguarda il prezzo, è sempre importante ricordare che il training e il fine-tuning sono servizi a pagamento da considerare durante lo sviluppo del progetto e in realtà abbastanza dispendiosi in termini di tempo.
Continua oggi il tuo percorso nell'IA!
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



