
Last chance! 50% off DataCamp Premium
Sale ends in
ChatGPT के लॉन्च के बाद से, ऐसा लगता है कि हर कुछ दिनों में एक नया Large Language Model (LLM) सामने आता है, साथ ही इस तकनीक में विशेषज्ञता रखने वाली नई कंपनियाँ भी। प्रत्येक नया LLM अलग-अलग तरीकों से पिछले मॉडल से बेहतर बनने के लिए प्रशिक्षित होता है। उदाहरण के लिए, अब अक्सर हम देखते हैं कि विशिष्ट उपयोग-प्रकरणों को बेहतर करने के लिए तैयार किए गए LLMs सामने आते हैं: चैट मॉडल, कोडिंग असिस्टेंट, और लंबे सन्दर्भ की समझ, आदि।
किसी नए LLM-आधारित अनुप्रयोग या प्रोजेक्ट के लिए सही मॉडल चुनना एक चुनौतीपूर्ण काम हो सकता है, और साथ ही नवीनतम मॉडलों और उनकी विशेषताओं से अद्यतन बने रहना भी।
मेरे मामले में, इसका परिणाम अक्सर यही होता है कि मैं डिफ़ॉल्ट रूप से API कॉल्स के माध्यम से ChatGPT या GPT मॉडलों का उपयोग करता/करती हूँ।
यहाँ, मेरा उद्देश्य उपलब्ध मॉडलों की विविध शृंखला में गहराई से जाना और उन प्रमुख क्षमताओं पर प्रकाश डालना है जिन पर प्रोजेक्ट की विशेषताओं के अनुसार सही मॉडल चुनते समय ध्यान देना चाहिए।
हम विशेष रूप से इन मॉडलों के साथ इंटरैक्ट करने के विभिन्न तरीकों पर ध्यान केंद्रित करेंगे, जो उपलब्ध सभी मॉडलों में से चयन करते समय विचार करने लायक एक प्रमुख विशेषता है।
लक्ष्य यह है कि यह व्यापक मार्गदर्शिका एक चीट शीट के रूप में काम करे, जो आपको आपकी विशिष्ट कार्यों के लिए उपलब्ध LLMs के विशाल चयन में राह दिखाए।
यदि आप LLM की दुनिया में नए हैं, तो मैं दृढ़ता से सुझाव देता/देती हूँ कि आप AI Fundamentals और Large Language Models Concepts पाठ्यक्रमों का अनुसरण करें ताकि बुनियादी शब्दावली और मॉडलों से परिचित हो सकें।
LLMs तक पहुँच और उन्हें किसी LLM-समर्थित अनुप्रयोग या प्रोजेक्ट में इंटरफेस करना तकनीकी आवश्यकताओं पर निर्भर विभिन्न तरीकों से किया जा सकता है।
LLMs को इंटरफेस करने का सबसे उपयोगकर्ता-मित्रवत तरीका हमारे ब्राउज़र में संवादात्मक इंटरफ़ेस के माध्यम से है। यह ChatGPT के मामले में दिखता है, जहाँ यूज़र इंटरफ़ेस बस एक चैट इंटरफ़ेस होता है जो आपको मॉडल के साथ संवाद करने देता है।
आम तौर पर, ये इंटरफ़ेस उपयोगकर्ता द्वारा मॉडल के नियंत्रण या अनुकूलन की बहुत कम या बिलकुल अनुमति देते हैं, पर यह साधारण कार्यों के लिए मॉडलों को आज़माने का आसान तरीका है। OpenAI का ChatGPT और Google का Gemini ऐसे इंटरफ़ेस प्रदान करते हैं:
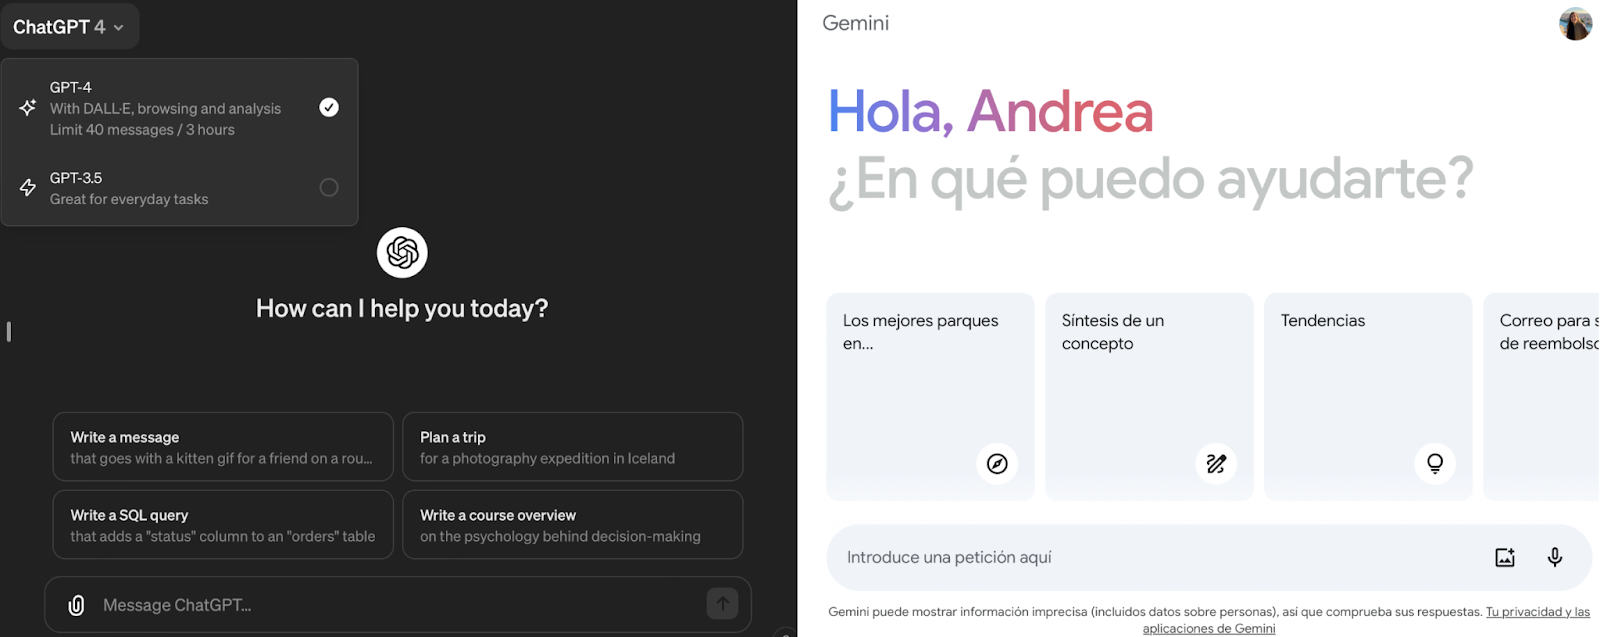
OpenAI के ChatGPT (बाएँ) और Google के Gemini (दाएँ) के चैट इंटरफ़ेस का स्क्रीनशॉट।
कभी-कभी, कुछ प्रदाता इसी तरह के उपयोगकर्ता-मित्रवत चैट इंटरफ़ेस के माध्यम से कुछ हद तक अनुकूलन करने की अनुमति भी देते हैं। OpenAI के मामले में, इस प्लेटफ़ॉर्म को "Playground" कहा जाता है।
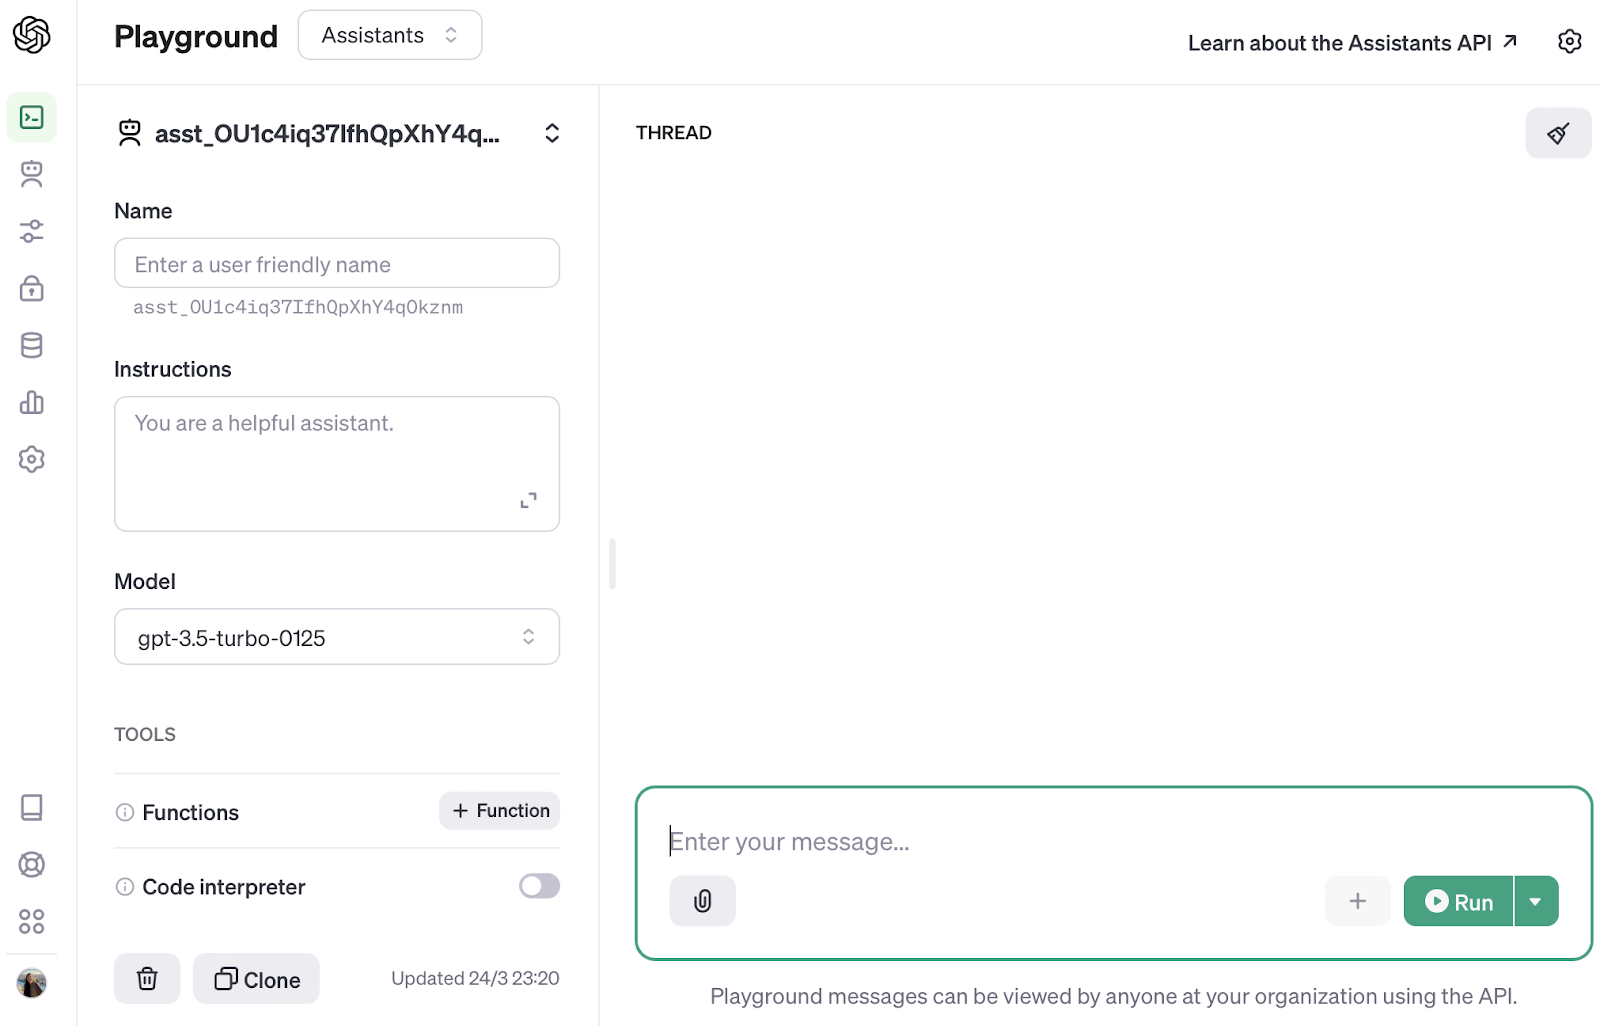
OpenAI Playground इंटरफ़ेस का स्क्रीनशॉट।
Playground इंटरफ़ेस हमें सीमित सेटिंग नियंत्रण के साथ विभिन्न मॉडलों को आज़माने देते हैं। इस प्रकार, हम यह खोज सकते हैं कि आपके कार्य के लिए कौन-से पैरामीटर उपयुक्त हैं। फिर भी, जैसा कि आप शायद समझ चुके होंगे, playground या चैट इंटरफ़ेस हमें किसी अनुप्रयोग या प्रोजेक्ट में LLM के साथ अंतःक्रिया को एम्बेड करने की अनुमति नहीं देते।
LLMs को क्वेरी करने के लिए सबसे लोकप्रिय इंटरफ़ेस में से एक API एक्सेस है। यह तरीका विशेष रूप से तब लाभकारी है जब हमें मॉडल का अतिरिक्त अनुकूलन नहीं चाहिए।
API कॉल्स को हमारे स्क्रिप्ट्स में सहजता से एकीकृत किया जा सकता है, जिससे हमें इंफ्रास्ट्रक्चर सेटअप और मेंटेनेंस की ज़रूरत नहीं रहती।
हालाँकि, सुविधा की एक कीमत होती है, और बाहरी सेवाओं पर निर्भरता के बावजूद—यह निर्भरता बनी ही रहती है यदि आप मॉडल को होस्ट नहीं करना चाहते और उसकी आवश्यक इंफ्रास्ट्रक्चर का प्रबंधन नहीं करना चाहते—लागत उपयोग के साथ अनिवार्य रूप से बढ़ेगी।
API कॉल्स के मामले में, एक अच्छी प्रैक्टिस यह है कि API कॉल के चारों ओर एक साधारण रैपर लागू किया जाए, ताकि मॉडल के साथ मॉड्यूलर तरीके से इंटरफेस किया जा सके। OpenAI API के लिए, जिसे मैंने अब तक सबसे ज़्यादा इस्तेमाल किया है, मैं हमेशा अगले सेक्शन में दिए रैपर का उपयोग करता/करती हूँ ताकि उपयोगकर्ता के लिए मॉडल का चयन पारदर्शी रहे।
OpenAI API के माध्यम से GPT मॉडलों को क्वेरी करने के लिए एक मानकीकृत किन्तु लचीला तरीका लिखना बहुत उपयोगी है, यदि आप मॉडल के साथ आसानी से और कम त्रुटि-प्रवण तरीके से इंटरफेस करना चाहते हैं। इसलिए मैं आमतौर पर प्रोग्राम की शुरुआत में ही GPT कॉल को एक रैपर फ़ंक्शन में सेट करता/करती हूँ, जिससे एप्लिकेशन के लिए मॉडल का उपयोग पारदर्शी बना रहता है।
openai लाइब्रेरी (pip install openai) पहले से ही एक ChatCompletion एन्डपॉइंट प्रदान करती है जो हमें .create मेथड का उपयोग करके किसी भी GPT मॉडल को कॉल करने की अनुमति देता है।
.create मेथड के दो आवश्यक पैरामीटर होते हैं:
gpt-4 शामिल है।इन दो पैरामीटरों को ध्यान में रखते हुए, हम GPT कॉल को इस प्रकार लिख सकते हैं:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
मॉडल को कॉल करते समय, हमें JSON फ़ॉर्मेट में completion वापस मिलेगा:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
अतः, यह उचित होगा कि फ़ंक्शन रिटर्न के रूप में केवल मॉडल का completion ही प्राप्त हो। यदि हम सभी टुकड़ों को जोड़ दें, तो हमारा रैपर इम्प्लीमेंटेशन इस प्रकार लिखा जा सकता है:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
यदि आप इस इम्प्लीमेंटेशन के और विवरणों में रुचि रखते हैं, तो लेख ChatGPT API Calls: A Gentle Introduction उन्हें गहराई से समझाता है!
अंततः, यह भी ध्यान देने योग्य है कि अधिकांश API प्रदाता, जिनमें OpenAI भी शामिल है, आपका खाता बनाने पर कुछ मुफ्त कॉल्स प्रदान करते हैं। फिर भी, क्रेडिट सीमित होते हैं (आमतौर पर $20 से कम) और आम तौर पर एक समय-सीमा (आमतौर पर एक माह) तक मान्य होते हैं।
किसी भी स्थिति में, यह हमेशा अच्छी प्रैक्टिस है कि LLM कॉल्स को एक फ़ंक्शन—या फ़ंक्शनों के समूह—में रैप किया जाए, ताकि प्रदाता चाहे जो भी हो, एप्लिकेशन के लिए मॉडल पारदर्शी रहे।
मॉडल को स्वयं होस्ट करना मतलब मॉडल वेट्स डाउनलोड करना और उन्हें लोकल मशीनों या निजी सर्वरों पर चलाना।
यह तरीका आकर्षक है क्योंकि यह मॉडल इंफ्रास्ट्रक्चर पर पूर्ण नियंत्रण देता है, लेकिन इसका अर्थ यह भी है कि तकनीकी प्रयास काफ़ी बढ़ जाएगा।
यदि आप यह जानने के इच्छुक हैं कि किसी LLM के लिए इंफ्रास्ट्रक्चर चलाने में कौन-कौन से चरण शामिल हैं, तो LLMOps Essentials लेख देखें!
मॉडल को लोकली चलाने से हमारी आवश्यकताओं के अनुसार और अधिक अनुकूलन संभव हो जाता है। इस संदर्भ में, स्वयं-होस्टिंग के लिए सबसे लोकप्रिय विकल्पों में से एक Meta AI के प्रसिद्ध LLaMa मॉडल हैं। उन्होंने हल्के मॉडल जारी किए हैं जिन्हें मात्र 8GB RAM वाले लैपटॉप पर भी चलाया जा सकता है।
हमारे लैपटॉप पर LLaMa मॉडल चलाना Ollama जैसे प्लेटफ़ॉर्म की बदौलत काफी आसान है।
Ollama एक ऐसा प्लेटफ़ॉर्म प्रदान करता है जो हमारे डिवाइस पर लोकली LLaMa 2 और Code LLaMa जैसे LLMs चलाने के लिए डिज़ाइन किया गया है। यह macOS, Linux और Windows को सपोर्ट करता है, जिससे हम अपने स्वामित्व वाले मॉडल अनुकूलित और बना सकते हैं। अधिक विवरण के लिए आप Ollama की वेबसाइट देख सकते हैं।
Ollama प्लेटफ़ॉर्म को आधिकारिक पेज से डाउनलोड किया जा सकता है, जबकि मॉडल वेट्स सीधे टर्मिनल इंटरफ़ेस के माध्यम से खींचे जा सकते हैं।
चलिए पहले Ollama को उसकी मुख्य पेज पर जाकर इंस्टॉल करते हैं!
 Ollama की वेबसाइट के मुख्य पेज का स्क्रीनशॉट।
इस मामले में, Ollama एक कमांड लाइन यूटिलिटी है:
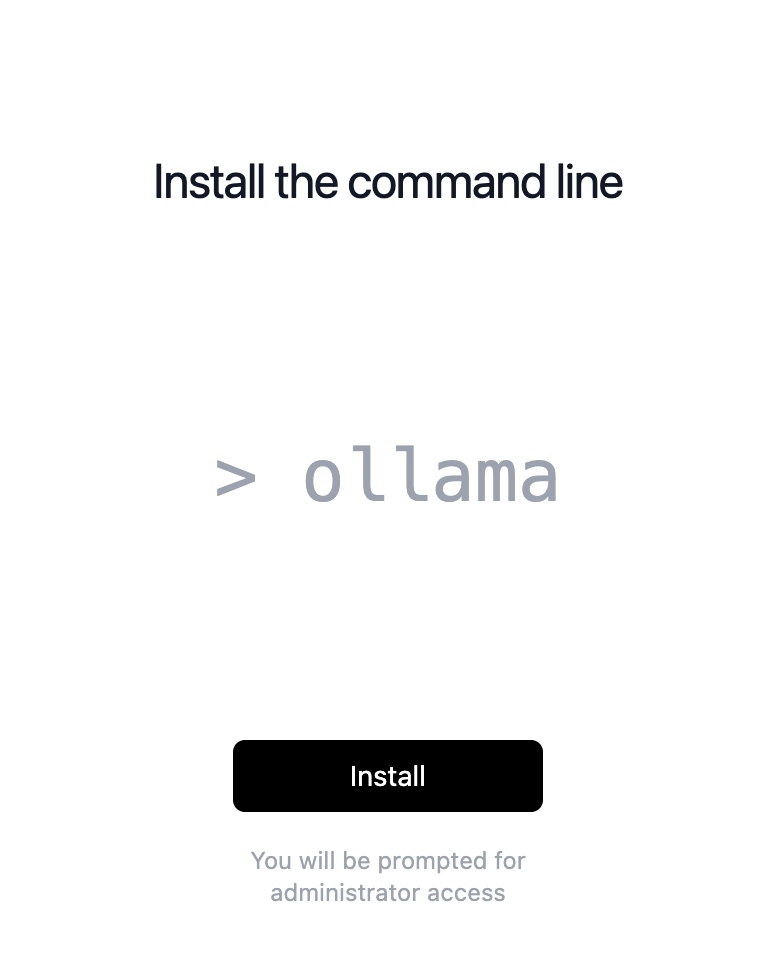
Ollama कमांड लाइन टूल की स्थापना का स्क्रीनशॉट।
एक बार कमांड लाइन यूटिलिटी इंस्टॉल हो जाने पर, हम ollama run <model name> कमांड से मॉडल शुरू कर सकते हैं। यदि यह हमारे डिवाइस पर मॉडल को पहली बार चलाना है, तो Ollama इसे हमारे लिए पुल कर देगा:
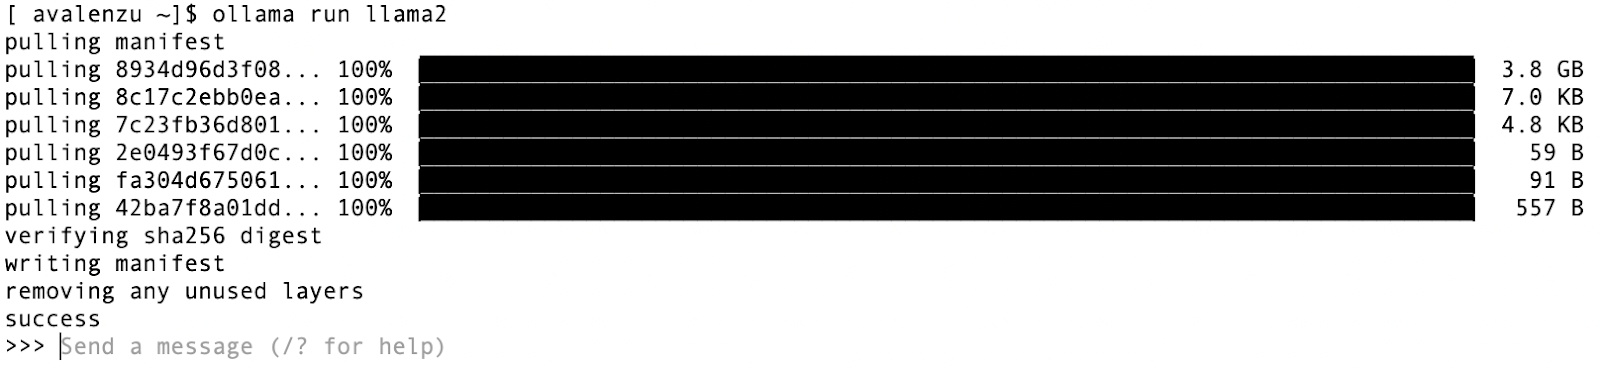
Ollama कमांड लाइन टूल के साथ LLaMa 2 मॉडल के पहले रन का स्क्रीनशॉट। पहली बार उपयोग पर मॉडल अपने-आप पुल हो जाता है।
उस क्षण से, कमांड लाइन से मॉडल को प्रॉम्प्ट करना और बाहर निकलना बहुत सीधा-सादा हो जाता है:
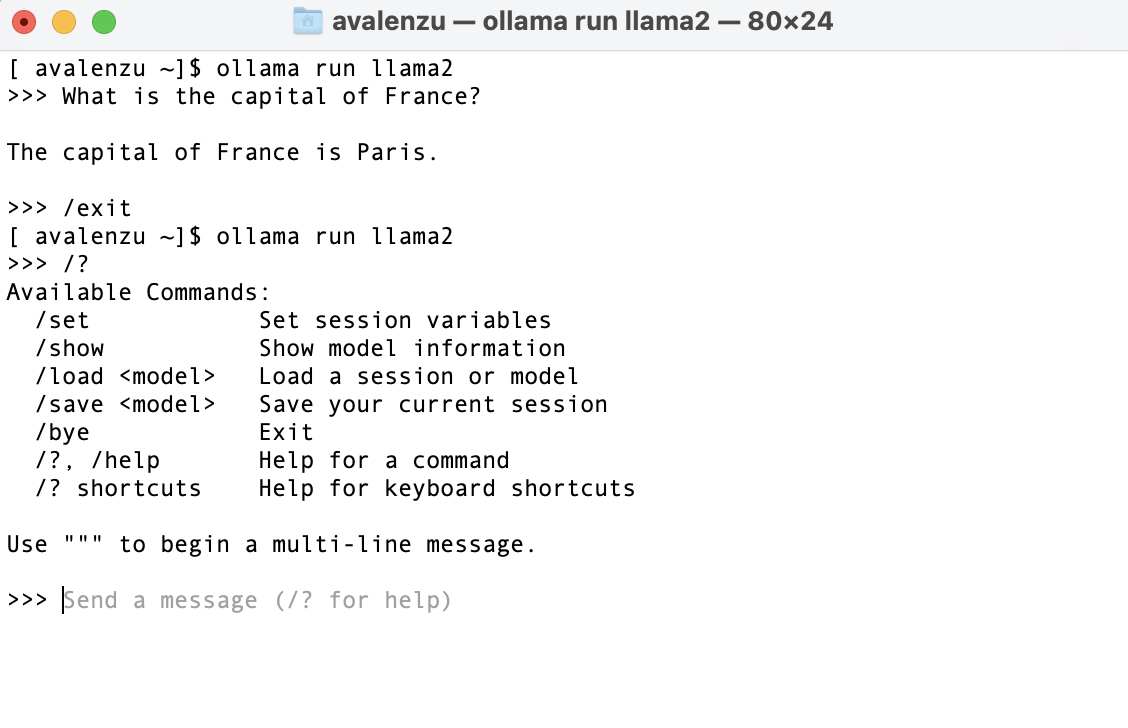
Ollama कमांड लाइन टूल के माध्यम से मॉडल के साथ उपयोगकर्ता इंटरैक्शन का स्क्रीनशॉट।
जैसा कि हम ऊपर की छवि में देख सकते हैं, मॉडल में कुछ अतिरिक्त कमांड्स का छोटा सेट भी उपलब्ध है।
Ollama अन्य मॉडलों का भी समर्थन करता है, जैसे नया Mistral:
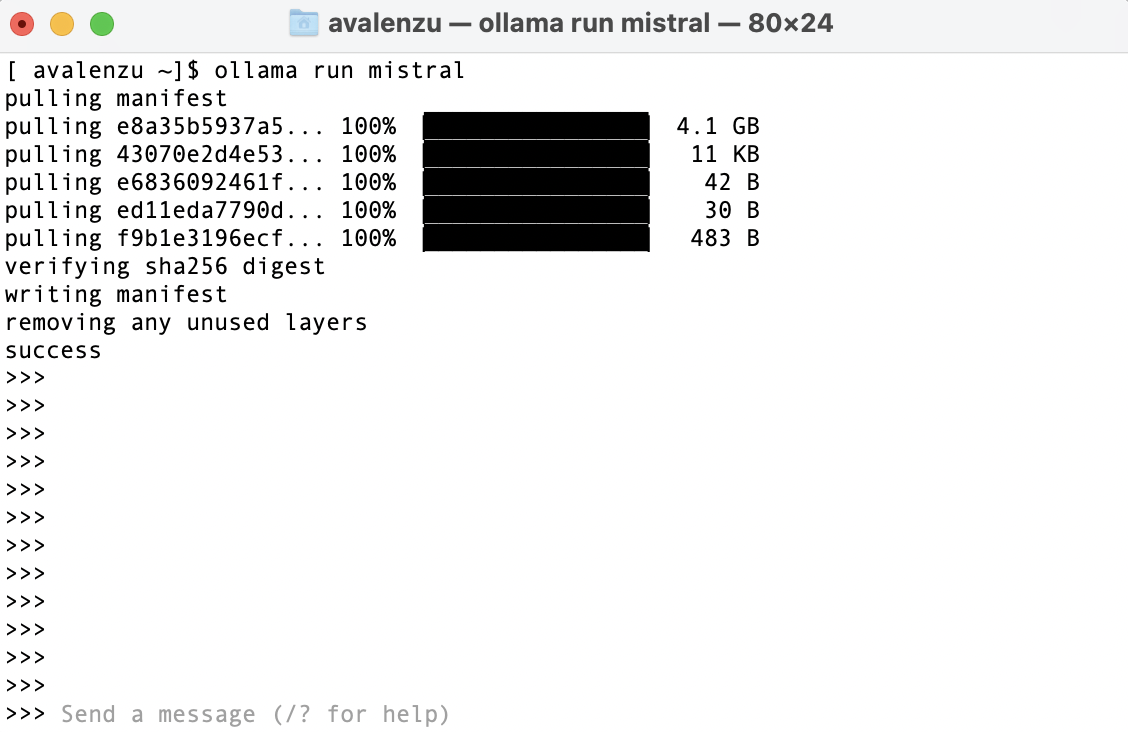
Ollama कमांड लाइन टूल के साथ Mistral मॉडल के पहले रन का स्क्रीनशॉट। पहली बार उपयोग पर मॉडल अपने-आप पुल हो जाता है।
मॉडल फिर से एक ही कमांड में बॉक्स से बाहर उपयोग के लिए तैयार है!
यह तरीका फायदेमंद है क्योंकि यह केवल हमारे डिवाइस के संसाधनों का उपभोग करता है। हालाँकि, यह याद रखना महत्वपूर्ण है कि मॉडल का प्रदर्शन आमतौर पर पैरामीटर्स की संख्या के साथ बढ़ता है।
नतीजतन, जितने अधिक पैरामीटर्स किसी मॉडल में होंगे, उतने ही अधिक संसाधनों की आवश्यकता होगी। इसलिए, बड़े मॉडल संभवतः स्वयं-होस्टेड LLM अनुप्रयोगों के लिए निजी सर्वरों पर चलाने होंगे।
यदि हम बड़े पैमाने का अनुप्रयोग बनाना चाहते हैं, तो यह ध्यान देने योग्य है कि Ollama मैक पर Docker Desktop के साथ चल सकता है और Linux पर GPU त्वरक के साथ Docker कंटेनरों के अंदर भी चल सकता है।
इस बिंदु पर आपके मन में एक सवाल आ सकता है: क्या मैं OLLAMA को अपनी स्क्रिप्ट्स में एम्बेड कर सकता/सकती हूँ?
वास्तव में, मॉडल को स्वयं होस्ट करने का मतलब यह नहीं है कि आप उसे अपनी Python स्क्रिप्ट्स में एकीकृत नहीं कर सकते! Ollama आपके स्वयं-होस्टेड मॉडल के साथ Python के माध्यम से इंटरफेस करने की सुविधा भी देता है।
Ollama की Python और JavaScript लाइब्रेरियाँ हमें अपनी स्क्रिप्ट्स में मॉडल इन्फ़रेंस सम्मिलित करने देती हैं।
यदि हम मॉडल को स्वयं होस्ट करना चाहें तो हमारे पास केवल Ollama ही विकल्प नहीं है। सामान्यतः, LLMs अक्सर कई ओपन-सोर्स प्लेटफ़ॉर्म पर डाउनलोड के लिए उपलब्ध होते हैं जो सामुदायिक समर्थन भी प्रदान करते हैं।
ओपन-सोर्स LLMs आमतौर पर शैक्षणिक और शोध उद्देश्यों के लिए बिना लागत के उपलब्ध होते हैं। हालाँकि, वाणिज्यिक उपयोग की शर्तें उस विशिष्ट लाइसेंस के आधार पर भिन्न हो सकती हैं जिसके अंतर्गत कोई मॉडल जारी किया गया है। हमेशा इस बात से अवगत रहें कि आप LLMs के साथ प्रयोग कर रहे हैं या वाणिज्यिक उद्देश्यों के लिए LLM-आधारित अनुप्रयोग बना रहे हैं।
क्या आप आज ही LLMs विकसित करने की अपनी यात्रा शुरू करने के इच्छुक हैं? तो Developing Large Language Models पाठ्यक्रम आपके लिए है!
शक्तिशाली मॉडलों को लोकल रूप से होस्ट करना बहुत संसाधन-गहन हो सकता है, इसलिए क्लाउड सेवाओं का उपयोग एक व्यावहारिक विकल्प हो सकता है, जो ऑन-डिमांड संसाधनों की स्केलेबिलिटी और क्लाउड प्रदाताओं का समर्थन प्रदान करता है।
गौरतलब है कि Azure जैसी पारंपरिक क्लाउड सेवाएँ अब LLMs, जैसे Mistral, को होस्ट करने के लिए कस्टमाइज़्ड पाइपलाइंस प्रदान करती हैं, ताकि हमें विशेष होस्टिंग लागू करने की ज़रूरत न पड़े।
यह आपके संगठन के भीतर अनुप्रयोगों को तैनात करने के लिए एक महत्वपूर्ण लाभ है, क्योंकि कई कंपनियों के पास पहले से ही ईमेल और सामान्य क्लाउड समाधानों जैसी सेवाओं के लिए इन प्रदाताओं के साथ अनुबंध होते हैं।
थर्ड-पार्टी प्रदाताओं का चयन होस्ट इंफ्रास्ट्रक्चर का प्रबंधन न करने और केवल नेटिव API सेवा का उपयोग करने की तुलना में मॉडल पर कुछ नियंत्रण रखने के बीच संतुलन प्रदान कर सकता है।
ये प्रदाता आमतौर पर API एक्सेस प्रदान करते हैं, लेकिन यह ध्यान रखना महत्वपूर्ण है कि व्यापक उपयोग के साथ लागत काफ़ी बढ़ सकती है, बिल्कुल नेटिव OpenAI API के उपयोग की तरह।
मुख्य अंतर होस्टिंग इकाई में निहित है। थर्ड-पार्टी प्रदाता, नेटिव LLM सेवाओं के बजाय, अपने इंफ्रास्ट्रक्चर पर मॉडल होस्ट करते हैं और API एन्डपॉइंट को एक्सपोज़ करते हैं, और अक्सर लचीले एकीकरण के लिए विभिन्न स्रोतों के मॉडलों की विविधता पेश करते हैं।
एक लोकप्रिय थर्ड-पार्टी API प्रदाता है LLAMA API।
LLAMA API वेबसाइट के मुख्य पेज का स्क्रीनशॉट।
API मुफ़्त नहीं है, लेकिन आप इसे आज़मा सकते हैं क्योंकि किसी भी नए खाते के लिए $5 के मुफ्त क्रेडिट जारी किए जाते हैं। हालाँकि, याद रखें कि ये क्रेडिट जारी होने के एक महीने तक ही मान्य होते हैं।
LLAMA API का उपयोग करना बहुत सीधा-सादा है। एक बार इसे इंस्टॉल करने के बाद (pip install llamaapi), हम इस प्रकार पहली ट्रायल कॉल कर सकते हैं:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
हालाँकि, OpenAI API की तरह, API कॉल को एक रैपर फ़ंक्शन में एम्बेड करना एक अच्छी प्रैक्टिस है। पहले की तरह ही तरीका अपनाते हुए:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
इस इम्प्लीमेंटेशन के अनुसार, हम केवल llm_call() कॉल करके LLM से स्ट्रिंग रिस्पॉन्स प्राप्त कर लेंगे:
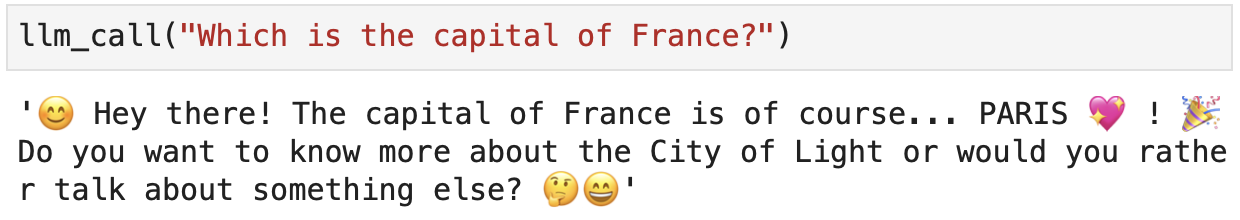
LLAMA API, केवल Meta के LLaMa ही नहीं, बल्कि अनेक अत्याधुनिक मॉडलों का समर्थन करता है। अगले सेक्शन में हम जानेंगे कि यह किन मॉडलों का समर्थन करता है!
अंत में, LLAMA API के मामले में, API लागत मॉडल के पैरामीटर्स की संख्या पर निर्भर करती है, और यह सभी मॉडलों में समान प्रतीत होती है:
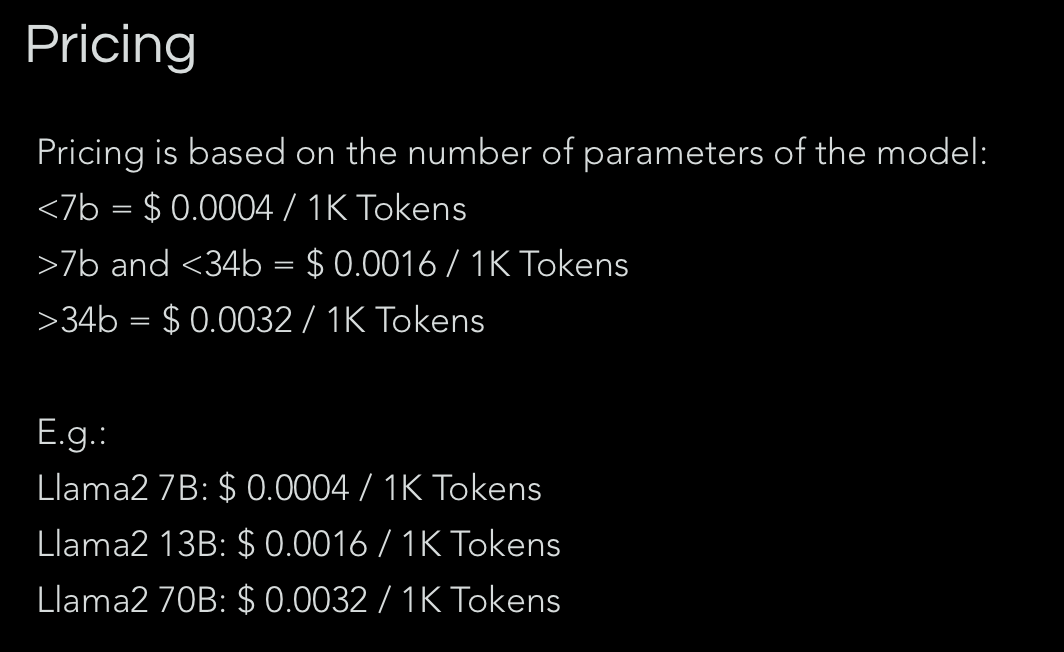
LLAMA API की प्राइसिंग का स्क्रीनशॉट। यह जानकारी केवल खाता बनाने के बाद उपलब्ध होती है।
LLMs के लिए सबसे लोकप्रिय थर्ड-पार्टी प्रदाता Hugging Face है। Hugging Face मुख्यतः अपनी transformers लाइब्रेरी के लिए जाना जाता है, जो Python में Natural Language Processing के लिए सबसे लोकप्रिय लाइब्रेरी है।
Hugging Face, LLMs तक पहुँच के लिए अनेक इंटरफ़ेस प्रदान करता है। इसमें "Spaces" नामक उपयोगकर्ता-मित्रवत playground इंटरफ़ेस है:

Hugging Face में "Spaces" playground का स्क्रीनशॉट।
यह मॉडल होस्टिंग और एन्डपॉइंट डिप्लॉयमेंट के साथ-साथ मॉडलों के सीधे डाउनलोड और लोकल उपयोग की भी अनुमति देता है।
यह ध्यान में रखना महत्वपूर्ण है कि Hugging Face एक तरह का "डेवलपर का साइट" है, इसलिए भले ही आपको शुरुआत करने के लिए ट्यूटोरियल मिल जाएँ, उनके मॉडलों का उपयोग करके किसी अनुप्रयोग को स्केल-अप करने के लिए तकनीकी ज्ञान आवश्यक है।
यदि आप Hugging Face के बारे में अधिक जानना चाहते हैं, तो मैं दृढ़ता से What is Hugging Face? The AI Community's Open-Source Oasis लेख की सिफारिश करता/करती हूँ।
एक पूरक टूल जिसे मैं आमतौर पर शुरू से LLM-समर्थित अनुप्रयोग बनाने के लिए Hugging Face के साथ उपयोग करता/करती हूँ, वह है LangChain। ट्यूटोरियल How to Build LLM Applications with LangChain एक बढ़िया हैंड्स-ऑन परिचय प्रदान करता है।
हमने GPT, LLaMa और Mistral मॉडलों जैसे LLMs तक पहुँचने और उन्हें चलाने के विभिन्न तरीकों पर चर्चा की है। हालाँकि, और भी कई मॉडल उपलब्ध हैं, जिनमें उपर्युक्त मॉडलों के विभिन्न वेरिएंट भी शामिल हैं। इस खंड में, हम आज मौजूद प्रमुख मॉडलों का वर्गीकरण करेंगे, उनकी विशेषताओं, कीमतों और उपयोग-प्रकरणों की सूची के साथ।
OpenAI के मॉडल, ChatGPT के लॉन्च के बाद से बहुत लोकप्रिय हो गए हैं, जो अब आपके सब्सक्रिप्शन पर निर्भर करते हुए GPT-3.5 या GPT-4 द्वारा संचालित हैं। कई बुनियादी कार्यों के लिए, GPT-3.5 और GPT-4 मॉडलों के बीच का अंतर बहुत बड़ा नहीं है।
हालाँकि, GPT-4 जटिल तर्क-संबंधी परिदृश्यों में किसी भी पूर्ववर्ती मॉडल की तुलना में कहीं अधिक क्षमता दिखाता है।
इसके अलावा, GPT-4 एक मल्टीमॉडल मॉडल है जो टेक्स्ट या छवि इनपुट स्वीकार करता है और टेक्स्ट आउटपुट देता है। यह प्लगइन्स का उपयोग करके बाहरी स्रोतों के साथ इंटरफेस करने की संभावना भी प्रदान करता है। इंटरनेट ब्राउज़िंग इसका एक उदाहरण है, जैसा कि Bing सर्च के उपयोग से दिखता है।
OpenAI API के माध्यम से भुगतान करने वाले ग्राहकों के लिए GPT-4 की तीन मुख्य वैरिएंट्स उपलब्ध हैं:
|
मॉडल |
विशेषताएँ |
सन्दर्भ विंडो |
API |
लोकल |
टोकन प्राइसिंग |
प्रशिक्षण डेटा |
|
GPT-4 |
13 जून 2023 के gpt-4 का स्नैपशॉट। यह एन्डपॉइंट लगातार अपडेट प्राप्त करता है। चैट के लिए अनुकूलित। |
8,192 टोकन |
No |
$0.03 / 1K टोकन (इनपुट) $0.06 / 1K टोकन (आउटपुट) |
Dec 2023 |
|
|
GPT-4 Turbo |
API नाम gpt-4-turbo-preview है। यह कोड जनरेशन जैसे कार्यों में उत्कृष्ट है और "laziness" के मामलों को कम करने के लिए बनाया गया है। |
128k टोकन |
No |
$0.01 / 1K टोकन (इनपुट) $0.03 / 1K टोकन (आउटपुट) |
Dec 2023 |
|
|
GPT-4 Vision |
API नाम gpt-4-vision-preview है। GPT-4 जिसमें छवियों को समझने की क्षमता है, साथ ही GPT-4 Turbo की अन्य सभी क्षमताएँ। |
128k टोकन |
No |
$0.01 / 1K टोकन (इनपुट) $0.03 / 1k टोकन (आउटपुट) |
Apr 2023 |
सामान्यतः, यह ध्यान देने योग्य है कि GPT मॉडल, LLaMa मॉडलों के विपरीत, क्लोज़्ड-सोर्स हैं। इसका मतलब है कि हम उन्हें लोकल रूप से नहीं चला सकते या अपना स्वयं का एन्डपॉइंट डिप्लॉय नहीं कर सकते।
फिर भी, OpenAI की Fine-tuning API का उपयोग करके अनुकूलन की संभावना है। इसके अलावा, वे Ollama, LLAMA API या Hugging Face जैसे थर्ड-पार्टी प्रदाताओं के माध्यम से सुलभ नहीं हैं।
OpenAI Playground के संबंध में, अंदर चल रहे मॉडल की जानकारी स्पष्ट रूप से प्रदर्शित नहीं होती, लेकिन ऐसा लगता है कि यह DALL-E, ब्राउज़िंग और विश्लेषण क्षमताओं के साथ GPT-4 मॉडल पर आधारित है।
आइए GPT-3 मॉडलों पर भी नज़र डालते हैं!
|
मॉडल |
विशेषताएँ |
सन्दर्भ विंडो |
API |
लोकल |
टोकन प्राइसिंग |
प्रशिक्षण डेटा |
|
GPT-3.5 Turbo |
API नाम gpt-3.5-turbo है। यह इस परिवार का फ्लैगशिप मॉडल है। यह संवाद के लिए अनुकूलित है और अनुरोधित फ़ॉर्मैट्स में उत्तर देने में अधिक सटीकता दिखाता है। |
16,385 टोकन |
No |
$0.0005 / 1K टोकन (इनपुट) $0.0015 / 1K टोकन (आउटपुट) |
Sep 2021 |
|
|
GPT-3.5 Turbo Instruct |
API नाम gpt-3.5-turbo-instruct है। यह उत्तरों में सटीकता और प्रासंगिकता पर केंद्रित है, और उपयोगकर्ता की आवश्यकताओं के साथ निकटता से संरेखित होता है। |
4,096 टोकन |
No |
$0.0015 / 1K टोकन (इनपुट) $0.0020 / 1K टोकन (आउटपुट) |
Sep 2021 |
तालिका में प्रस्तुत GPT-3.5 Turbo Instruct मॉडल को Reinforcement Learning from Human Feedback (RLHF) के माध्यम से उपयोगकर्ता के इरादों का बेहतर पालन करने के लिए फाइन-ट्यून किया गया है।
RLHF एक तकनीक है जिसमें मानवीय फीडबैक को रिइन्फोर्समेंट लर्निंग प्रक्रिया में एकीकृत किया जाता है ताकि AI एजेंट्स के सीखने के परिणामों का मार्गदर्शन और सुधार किया जा सके। यह तरीका मानवीय निर्णयों, सुधारों या वरीयताओं को सीधे प्रशिक्षण चक्र में शामिल करके ऐसे मॉडल विकसित करने में सक्षम बनाता है जो मानवीय मूल्यों और पसंदों के साथ बेहतर तालमेल रखते हैं।
अंत में, जैसा कि हम तालिका से देख सकते हैं, किसी भी दो GPT-3.5 मॉडलों का उपयोग GPT-4 की तुलना में काफ़ी सस्ता है।
इस संदर्भ में, मैं आमतौर पर सलाह देता/देती हूँ कि सुगठित उदाहरणों के एक सेट में प्रत्येक मॉडल के प्रदर्शन की तुलना करें ताकि देखें कि क्या GPT-3.5 मेरे मौजूदा कार्य के लिए पर्याप्त है, जिससे इन्फ़रेंस की लागत बच सके।
जैसा कि हमने पिछले खंडों में चर्चा की, LLaMa मॉडल मुफ्त में डाउनलोड करके लोकली चलाए जा सकते हैं या इनके ऊपर कस्टमाइज़ेशन्स बनाए जा सकते हैं।
LLaMa मॉडल वास्तव में आकारों और वैरिएंट्स के संदर्भ में खुले मॉडलों का बड़ा परिवार है, जिसे Meta AI द्वारा प्रदान किया गया है:
|
मॉडल |
विशेषताएँ |
सन्दर्भ विंडो |
API |
लोकल |
वैरिएंट |
प्रशिक्षण डेटा |
|
LLaMa 2 |
कम्प्लीशन कार्यों के लिए बेस नॉन-चैट मॉडल। |
4096 टोकन |
Yes |
Yes* |
7B 13B 70B |
Sep 2022 |
|
LLaMa 2 Chat |
बेस LLaMa 2 जिसमें इंस्ट्रक्शन ट्यूनिंग की गई है ताकि सरल कम्प्लीशन्स को चैट मॉडल में बदला जा सके जो उपयोगकर्ता इरादे का पालन करे। |
4096 टोकन |
Yes |
Yes* |
7B 13B 70B |
Sep 2022 |
|
LLaMa 2 Guard |
इनपुट-आउटपुट सेफ़गार्ड मॉडल जो विषाक्त और हानिकारक सामग्री का पता लगाने के लिए प्रशिक्षित है। |
4096 टोकन |
Yes** |
No |
7B |
Sep 2022* |
*Hugging Face भी LLaMa के कुछ वैरिएंट्स प्रदान करता है, जैसे बेस और चैट मॉडल। **फिलहाल, LLaMa 2 Guard Amazon SageMaker के क्लाउड वातावरण में सुलभ है।
उन GPT मॉडलों के विपरीत जिनमें कोडिंग क्षमताएँ एकीकृत होती हैं, LLaMa मॉडलों में कोडिंग के लिए समर्पित मॉडल होते हैं जिनमें 16k टोकन की बड़ी सन्दर्भ विंडो होती है, जो लॉन्ग-कॉन्टेक्स्ट फाइन-ट्यूनिंग प्रक्रिया से हासिल होती है।
|
मॉडल |
विशेषताएँ |
सन्दर्भ विंडो |
API |
लोकल |
वैरिएंट |
प्रशिक्षण डेटा |
|
Code LLaMa |
कोड कम्प्लीशन कार्यों के लिए बेस नॉन-चैट मॉडल, जैसे GitHub Copilot। यह LLaMa 2 मॉडल है जिसमें कोड और लॉन्ग कॉन्टेक्स्ट पर अतिरिक्त प्रशिक्षण फाइन-ट्यूनिंग शामिल है। |
16k |
No |
Yes |
7B 13B 34B |
Sep 2022* |
|
Code LLaMa - Instruct |
Instruct मॉडलों से व्युत्पन्न। यह कोड कम्प्लीशन और कोड के अंशों की व्याख्या में उत्कृष्ट है। |
16k |
Yes |
Yes |
7B 13B 34B |
Sep 2022* |
|
Code LLaMa - Python |
Python प्रोग्रामिंग भाषा के लिए फाइन-ट्यून किया गया। |
16k |
No |
Yes |
34B |
Sep 2022* |
* LLaMa मॉडलों की आधिकारिक कट-ऑफ तिथि Sep 2022 है। फिर भी, ट्यूनिंग डेटा अधिक हाल का है, विशेषकर नए वैरिएंट्स के लिए 2023 का।
Google का बड़े भाषा मॉडलों को विकसित करने का लंबा इतिहास रहा है। Gemini मॉडल के परिचय के साथ, Google ने अपने मल्टीमॉडल LLMs की पीढ़ी शुरू की।
Google की पेशकशों के संदर्भ में, Gemini इसका फ्लैगशिप मॉडल है, जो ChatGPT की तरह क्लोज़्ड-सोर्स है। हालाँकि, हाल ही में उन्होंने Gemma लॉन्च किया, जो Gemini से व्युत्पन्न ओपन-सोर्स मॉडलों का एक सूट पेश करता है, जिसका उद्देश्य सुलभ AI विकास को सुगम बनाना है।
इस लेख में, हम Gemini और Gemma दोनों पर ध्यान केंद्रित करेंगे:
|
मॉडल |
विशेषताएँ |
API |
लोकल |
वैरिएंट्स |
|
Gemini |
सामान्य-उद्देश्य कार्यों (टेक्स्ट जनरेशन, अनुवाद, प्रश्नोत्तर, कोड, आदि) के लिए क्लोज़्ड-सोर्स मॉडल |
Yes* |
No |
Ultra - जटिल कार्यों का समाधान। Pro - कार्यों की व्यापक शृंखला। स्केलेबल। Nano - डिवाइस पर कुशल उपयोग। |
|
Gemma |
Gemini जैसे ही कार्य, परंतु कस्टम अनुप्रयोगों और शोध में एकीकरण पर केंद्रित। यह एक हल्का मॉडल है। |
Yes**LLAMA API |
YesOllama |
2B 7B |
*Gemini के लिए वाणिज्यिक उद्देश्यों हेतु एक API है (डिप्लॉयमेंट्स के लिए खुला नहीं)। फिर भी, हम इसके Playground इंटरफ़ेस के माध्यम से मॉडल को आज़मा सकते हैं।
**कोई नेटिव Google एन्डपॉइंट नहीं है, पर मॉडल Kaggle और Google Colab के माध्यम से सुलभ है। अधिक जानकारी आधिकारिक Google दस्तावेज़ में उपलब्ध है।
Gemini वैरिएंट्स के संदर्भ में, Gemini Ultra एक मल्टीमॉडल मॉडल है जो जटिल विश्लेषण कार्यों में उत्कृष्ट है। Gemini Pro प्रदर्शन और स्केलेबिलिटी का संतुलन बनाता है और कोड व टेक्स्ट जनरेशन जैसे कार्यों में अलग नज़र आता है। अंत में, Gemini Nano मोबाइल और एज़ डिवाइसेज़ पर भारी संसाधन मांग के बिना चलने के लिए दक्षता पर केंद्रित है।
Google के मॉडलों के बारे में, इस लेखन के समय सन्दर्भ विंडो और प्रशिक्षण डेटा की कट-ऑफ तिथि पर सार्वजनिक रूप से बहुत अधिक जानकारी उपलब्ध नहीं है।
Mistral AI एक फ्रांसीसी AI कंपनी है जिसकी स्थापना अप्रैल 2023 में Meta Platforms और Google DeepMind के पूर्व कर्मचारियों द्वारा की गई थी। यह ओपन-सोर्स LLMs विकसित करने पर केंद्रित है, और स्वामित्व वाले मॉडलों के जवाब में ओपन-सोर्स सॉफ़्टवेयर के महत्व पर जोर देती है। कंपनी Mistral 7B और Mixtral 8x7B जैसे मॉडल प्रदान करती है जिनमें उन्नत भाषा प्रसंस्करण क्षमताएँ हैं।
|
मॉडल |
विशेषताएँ |
सन्दर्भ विंडो |
API |
लोकल |
टोकन प्राइसिंग |
प्रशिक्षण डेटा |
|
Mistral |
7B पैरामीटर्स वाला सामान्य-उद्देश्य मॉडल। अंग्रेज़ी भाषा और कोड जनरेशन कार्यों के लिए अनुकूलित। |
32k |
Yes* |
Yes |
$0.25 / 1M टोकन (इनपुट और आउटपुट) |
Sep 2023 |
|
Mixtral |
सबसे शक्तिशाली सामान्य-उद्देश्य मॉडल। अंग्रेज़ी, फ्रेंच, इटालियन, जर्मन, स्पैनिश में दक्ष, और कोडिंग कार्यों में मज़बूत। यह 7B-पैरामीटर वाले sparse Mixture-of-Expert आर्किटेक्चर पर आधारित है। |
32k |
Yes* |
Yes |
$0.7 / 1M टोकन (इनपुट और आउटपुट) |
Dec 2023 |
*हम Mistral AI के मॉडलों के साथ उनके "La Plataforme" नामक Playground इंटरफ़ेस का उपयोग करके इंटरैक्ट कर सकते हैं।
** Hugging Face कुछ मॉडलों के लिए अपनी API का उपयोग करके रीयल-टाइम इन्फ़रेंस हेतु एक टेस्ट बेड भी प्रदान करता है। यह उपलब्ध मॉडलों के लिए सशुल्क एन्डपॉइंट्स डिप्लॉय करने की सुविधा देने वाला थर्ड-पार्टी प्रदाता भी है।
Mixtral मॉडल के संबंध में, ''Mixture-of-Experts'' आर्किटेक्चर मॉडल को अपनी कुल क्षमताओं को विभिन्न विशिष्ट समूहों या "विशेषज्ञों" में बाँटने की अनुमति देता है। प्रत्येक विशेषज्ञ विशिष्ट प्रकार के कार्यों या डेटा के लिए अनुकूलित होता है।
इनपुट को प्रोसेस करते समय, Mixtral केवल प्रासंगिक विशेषज्ञों को गतिशील रूप से सक्रिय करता है, जिससे वह प्रत्येक टोकन के लिए अपने कुल पैरामीटर्स के एक भाग का उपयोग करके जटिल कार्यों को कुशलतापूर्वक संभाल पाता है। यह तरीका Mixtral के प्रदर्शन को बढ़ाता है, जिससे वह अनेक भाषाओं और कार्यों में निपुण होता है और कम्प्यूटेशनल संसाधनों का अनुकूलन करता है। Mixtral मॉडल का नाम वास्तव में "Mixtral 8x7B" है, जो इस तथ्य की ओर संकेत करता है कि यह 8 अलग-अलग "विशेषज्ञ" समूहों का उपयोग करता है।
अंत में, Mistral AI तीन वाणिज्यिक मॉडल भी प्रस्तुत करता है: Mistral Small, Mistral Medium और Mistral Large। यदि आप रुचि रखते हैं, तो आप आधिकारिक दस्तावेज़ों में मॉडल्स और प्राइसिंग के बारे में अधिक जानकारी पा सकते हैं।
अब तक, हमने व्यवसाय की सबसे प्रसिद्ध कंपनियों के कई मॉडल और वैरिएंट्स देखे हैं। फिर भी, खोजने के लिए बहुत कुछ और है!
मैं Falcon मॉडलों पर प्रकाश डालना चाहूँगा/चाहूँगी, जो Technology Innovation Institute से हैं और Ollama और LLAMA API दोनों में उपलब्ध हैं। इसके अलावा Microsoft Research का Orca2 मॉडल भी है जो विशेष रूप से तर्क करने में उत्कृष्ट है, और Ollama तथा Hugging Face में उपलब्ध है।
आप अन्य ओपन-सोर्स, उपलब्ध मॉडलों के बारे में 8 Top Open-Source LLMs for 2024 and Their Uses पर पढ़ सकते हैं।
इस लेख में, हमने लक्षित अनुप्रयोग के लिए सर्वश्रेष्ठ Large Language Model का चयन करते समय विचार करने योग्य कई पहलुओं पर चर्चा की है। यद्यपि इस गाइड का लक्ष्य एक चीट शीट के रूप में काम करना था, लेकिन तुरंत सर्वश्रेष्ठ मॉडल चुनने का कोई स्वर्णिम नियम नहीं है।
मेरे व्यक्तिगत अनुभव के आधार पर, मेरा मानना है कि हम LLM के साथ कैसे इंटरफेस करना चाहेंगे, इसे परिभाषित करना एक अच्छा शुरुआती बिंदु है, क्योंकि यह पहले से ही उपलब्ध मॉडलों—और वैरिएंट्स—की संख्या कम कर देगा।
दूसरा पहलू उस उद्देश्यपूर्ण कार्य पर विचार करना है जो मॉडल करेगा: सामान्य चैटबॉट, सार-संक्षेप विशेषज्ञ, कोडिंग असिस्टेंट, आदि।
हालाँकि हम हमेशा अपने इच्छित कार्य के लिए किसी मॉडल को फाइन-ट्यून कर सकते हैं, हमने देखा है कि कुछ उपयोग-प्रकरणों के लिए पहले से फाइन-ट्यून किए गए वैरिएंट्स मौजूद हैं जो हमारा समय, कम्प्यूटेशनल संसाधन और तकनीकी विशेषज्ञता बचाएँगे। अनुप्रयोग के लिए आवश्यक सन्दर्भ विंडो पर विचार करना भी सर्वश्रेष्ठ मॉडल चुनने के लिए महत्वपूर्ण है।
अंत में, प्राइसिंग हमेशा यह संकेत देने का एक अच्छा साधन है कि कौन-सा मॉडल उपयोग करना है। दुर्भाग्य से, अधिकांश समय, प्रोजेक्ट स्वयं प्रारंभिक निवेश और समय के साथ प्रोजेक्ट को बनाए रखने की लागत से सीमित होता है। कीमत के संबंध में, यह हमेशा ध्यान में रखना महत्वपूर्ण है कि ट्रेनिंग और फाइन-ट्यूनिंग प्रोजेक्ट विकास के दौरान विचार करने योग्य सशुल्क सेवाएँ हैं और वास्तव में काफ़ी समय लेने वाली होती हैं।
आज ही अपनी AI यात्रा जारी रखें!
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
