

Mengapa Menggunakan Metode Policy Gradient?
Salah satu keunggulan utama metode policy gradient adalah kemampuannya menangani ruang aksi yang kompleks, di mana pendekatan berbasis nilai tradisional kesulitan.
Menangani ruang aksi berdimensi tinggi
Metode berbasis nilai, seperti Q-learning, bekerja dengan mengestimasi fungsi nilai untuk semua kemungkinan aksi. Ini menjadi sulit ketika ruang aksi lingkungan bersifat kontinu atau diskret tetapi besar.
Metode policy gradient memparametrisasi kebijakan dan mengestimasi gradien dari imbalan kumulatif terhadap parameter kebijakan. Mereka menggunakan gradien ini untuk langsung mengoptimalkan kebijakan dengan memperbarui parameternya. Karena itu, metode ini dapat secara efisien menangani ruang aksi yang berdimensi tinggi atau kontinu. Policy gradient juga menjadi dasar metode Reinforcement Learning using Human Feedback (RLHF).
Dengan memparametrisasi kebijakan dan menyesuaikan parameternya berdasarkan gradien, policy gradient dapat secara efisien menangani aksi yang kontinu dan berdimensi tinggi. Pendekatan langsung ini memungkinkan generalisasi yang lebih baik dan eksplorasi yang lebih fleksibel, sehingga cocok untuk tugas seperti kontrol robotik dan lingkungan kompleks lainnya.
Mempelajari kebijakan stokastik
Diberikan seperangkat observasi:
- Kebijakan deterministik menentukan aksi apa yang diambil agen.
- Kebijakan stokastik memberikan sekumpulan aksi dan probabilitas agen memilih setiap aksi.
Saat mengikuti kebijakan stokastik, observasi yang sama dapat mengarah pada pemilihan aksi yang berbeda pada iterasi yang berbeda. Ini mendorong eksplorasi ruang aksi dan mencegah kebijakan terjebak pada optimum lokal. Karena itu, kebijakan stokastik berguna di lingkungan di mana eksplorasi penting untuk menemukan jalur yang mengarah pada return maksimum.
Dalam metode berbasis kebijakan, keluaran kebijakan diubah menjadi distribusi probabilitas, dengan setiap aksi kemungkinan diberi probabilitas. Agen memilih aksi dengan melakukan sampling pada distribusi ini, sehingga memungkinkan implementasi kebijakan stokastik. Dengan demikian, metode policy gradient menggabungkan eksplorasi dan eksploitasi, berguna di lingkungan dengan struktur imbalan yang kompleks.
Penurunan Teorema Policy Gradient
Sebelum masuk ke penurunan, penting untuk menetapkan notasi matematis dan konsep kunci yang digunakan sepanjang pembuktian.
Notasi matematis dan prasyarat
Seperti disebutkan di bagian sebelumnya, teorema policy gradient menyatakan bahwa turunan dari ekspektasi return adalah ekspektasi dari hasil kali antara return dan turunan dari logaritma kebijakan.
Sebelum menurunkan teorema policy gradient, kami memperkenalkan notasi berikut:
- E[X] merujuk pada ekspektasi probabilistik dari peubah acak X.
- Secara matematis, kebijakan diekspresikan sebagai matriks probabilitas yang memberikan probabilitas memilih aksi berbeda berdasarkan observasi berbeda. Sebuah kebijakan biasanya dimodelkan sebagai fungsi terparametrisasi, dengan parameter dilambangkan sebagai θ.
- πθ merujuk pada kebijakan yang diparametrisasi oleh θ. Dalam praktik, parameter ini adalah bobot jaringan saraf yang memodelkan kebijakan.
- Trajektori, τ, merujuk pada urutan state, biasanya dimulai dari state awal yang diacak hingga timestep saat ini atau state terminal.
- ∇θf merujuk pada gradien dari fungsi f terhadap parameter θ.
- J(πθ) merujuk pada return yang diharapkan dicapai agen saat mengikuti kebijakan πθ. Ini juga merupakan fungsi objektif untuk gradient ascent.
- Lingkungan memberikan imbalan pada setiap timestep, tergantung pada aksi agen. Return merujuk pada imbalan kumulatif dari state awal hingga timestep saat ini.
- R(τ) merujuk pada return yang dihasilkan sepanjang trajektori τ.
Langkah-langkah penurunan
Kami menunjukkan cara menurunkan dan membuktikan teorema policy gradient dari prinsip pertama, dimulai dengan pengembangan fungsi objektif dan menggunakan trik turunan-log.
Fungsi objektif (Persamaan 1)
Fungsi objektif dalam metode policy gradient adalah return
J yang terakumulasi dengan mengikuti trajektori berdasarkan kebijakan π yang diekspresikan dalam parameter θ. Fungsi objektif ini diberikan sebagai:
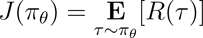
Pada persamaan di atas:
- Sisi kiri (LHS) adalah return yang diharapkan saat mengikuti kebijakan πθ.
- Sisi kanan (RHS) adalah ekspektasi (atas trajektori τ yang dihasilkan dengan mengikuti kebijakan πθ di setiap langkah) dari return R(τ) yang dihasilkan sepanjang trajektori τ.
Diferensial fungsi objektif (Persamaan 2)
Mendiferensialkan (terhadap θ) kedua sisi persamaan di atas menghasilkan:
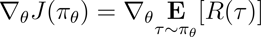
Gradien dari ekspektasi (Persamaan 3)
Ekspektasi (di sisi kanan) dapat diekspresikan sebagai integral atas hasil kali dari:
- Probabilitas mengikuti sebuah trajektori τ
- Return yang dihasilkan sepanjang trajektori τ
Dengan demikian, sisi kanan Persamaan 2 dinyatakan ulang sebagai:
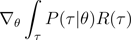
Gradien dari sebuah integral sama dengan integral dari gradien. Jadi, pada ekspresi di atas, kita dapat membawa gradien ∇θ ke bawah tanda integral. Sehingga sisi kanan menjadi:
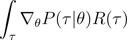
Dengan demikian, Persamaan 2 dapat ditulis ulang sebagai:
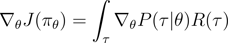
Probabilitas trajektori (Persamaan 4)
Sekarang kita melihat lebih dekat pada P(τ|θ), probabilitas agen mengikuti trajektori τ tertentu dengan parameter kebijakan θ (dan karena itu kebijakan πθ). Sebuah trajektori terdiri dari serangkaian langkah. Dengan demikian:
- Probabilitas memperoleh trajektori τ adalah hasil kali dari:
- Probabilitas mengikuti semua langkah individual.
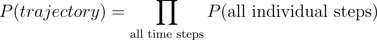
- Pada timestep t, agen berpindah dari state s ke state st+1 dengan mengikuti aksi at. Probabilitas ini diberikan oleh hasil kali dari:
- Probabilitas kebijakan memprediksi aksi at pada state st
- Probabilitas berakhir pada state st+1 diberikan aksi at dan state st
Dengan demikian, mulai dari state awal s0, probabilitas agen mengikuti trajektori τ berdasarkan kebijakan πθ diberikan sebagai:
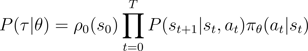
Untuk menyederhanakan, kita ingin mengekspresikan hasil kali di sisi kanan atas sebagai penjumlahan. Jadi, kita ambil logaritma pada kedua sisi persamaan di atas:
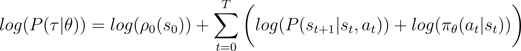
Turunan dari log-probabilitas (Persamaan 5)
Sekarang kita ambil turunan (terhadap θ) dari log probabilitas pada persamaan di atas.
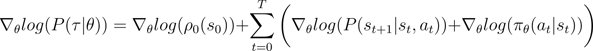
Pada sisi kanan persamaan di atas:
- Suku pertama log ρ0(s0) konstan terhadap θ. Jadi turunannya adalah 0.
- Suku pertama di dalam penjumlahan P(st+1|st, at) juga independen dari θ dan turunannya terhadap θ juga 0.
Dengan menghapus suku-suku nol di atas dari persamaan, kita memperoleh (Persamaan 5):
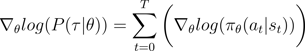
Ingat dari Persamaan 2 bahwa:
Persamaan 5 mengevaluasi log dari bagian pertama sisi kanan Persamaan 2. Kita perlu mengaitkan turunan dari suatu suku dengan logaritmanya. Kita lakukan ini menggunakan aturan rantai (chain rule) dan trik turunan-log.
Trik turunan-log (log-derivative)
Kita menyimpang sejenak dan menggunakan kaidah kalkulus untuk menurunkan sebuah hasil, yang akan kita gunakan untuk menyederhanakan persamaan sebelumnya dan membuatnya sesuai untuk metode komputasional.
Dalam kalkulus, turunan dari logaritma dapat dinyatakan sebagai:
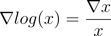
Dengan demikian, dengan mengatur ulang persamaan di atas, turunan dari x dapat dinyatakan dalam bentuk turunan dari logaritma x:
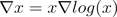
Ini kadang disebut trik turunan-log.
Aturan rantai (chain rule)
Menurut aturan rantai, diberikan z(y) sebagai fungsi dari y, di mana y sendiri adalah fungsi dari θ, y(θ), turunan z terhadap θ diberikan sebagai:

Dalam kasus ini, y(θ) menyatakan P(θ) dan z(y) menyatakan log(y). Dengan demikian,
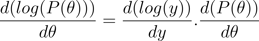
Menerapkan aturan rantai
Kita tahu dari kalkulus bahwa d(log(y)) / dy = 1/y. Gunakan ini pada ekspresi pertama di sisi kanan atas.
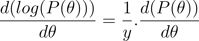
Pindahkan y ke sisi kiri dan gunakan notasi :
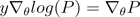
y menyatakan P(θ). Jadi persamaan di atas ekuivalen dengan:

Menerapkan trik turunan-log
Hasil di atas memberikan ekspresi pertama dari sisi kanan Persamaan 2 (ditunjukkan di bawah).
Menggunakan hasil tersebut pada sisi kanan Persamaan 2, kita peroleh:
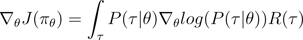
Kami menyusun ulang suku-suku di bawah integral sisi kanan sebagai berikut:
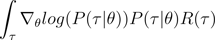
Menurunkan hasil akhir
Perhatikan bahwa ekspresi di atas memuat perluasan integral dari sebuah ekspektasi: ∫P(θ)∇logP(θ) = E[∇logP(θ)]
Dengan demikian, sisi kanan di atas dapat diekspresikan sebagai ekspektasi:
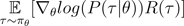
Kami substitusikan turunan dari log probabilitas ke dalam ekspresi imbalan yang diharapkan:

Pada persamaan di atas, substitusikan nilai ∇logP(θ) dari Persamaan 5 untuk memperoleh:
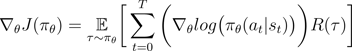
Ini adalah ekspresi untuk gradien dari fungsi imbalan menurut teorema policy gradient.
Intuisi di balik policy gradient
Metode policy gradient mengonversi keluaran kebijakan menjadi distribusi probabilitas. Agen melakukan sampling dari distribusi ini untuk memilih aksi. Metode policy gradient menyesuaikan parameter kebijakan. Ini mengarah pada pembaruan distribusi probabilitas tersebut di setiap iterasi. Distribusi probabilitas yang diperbarui memiliki kemungkinan lebih tinggi memilih aksi yang menghasilkan imbalan lebih besar.
Algoritme policy gradient menghitung gradien dari return yang diharapkan terhadap parameter kebijakan. Dengan menggerakkan parameter kebijakan ke arah gradien ini, agen meningkatkan probabilitas memilih aksi yang menghasilkan imbalan lebih besar selama pelatihan.
Pada dasarnya, aksi yang menghasilkan keluaran lebih baik menjadi lebih mungkin dipilih di masa depan, secara bertahap memperbaiki kebijakan untuk memaksimalkan imbalan jangka panjang.
Mengimplementasikan Policy Gradient di Python
Setelah membahas prinsip dasar policy gradient, kami menunjukkan cara mengimplementasikannya menggunakan PyTorch dan Gymnasium.
Menyiapkan lingkungan
Sebagai langkah pertama, kita perlu memasang gymnasium dan beberapa pustaka pendukung seperti NumPy dan PyTorch.
Untuk memasang gymnasium dan dependensinya pada server atau mesin lokal, jalankan:
$ pip install gymnasium Untuk memasang menggunakan Notebook seperti Google Colab atau DataLab, gunakan:
!pip install gymnasiumAnda mengimpor paket-paket ini di dalam lingkungan Python:
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
import torch.distributions as distributions
import numpy as np
import gymnasium as gym Membuat agen policy gradient sederhana
Buat instance lingkungan menggunakan metode .make().
env = gym.make('CartPole-v1')Seperti metode pembelajaran mesin lainnya, kita menggunakan jaringan saraf untuk mengimplementasikan agen policy gradient.
CartPole-v1 adalah lingkungan sederhana, jadi kami merancang jaringan sederhana dengan 1 lapisan tersembunyi berisi 64 neuron. Dimensi lapisan input setara dengan dimensi ruang observasi. Dimensi lapisan output setara dengan ukuran ruang aksi lingkungan. Dengan demikian, jaringan kebijakan memetakan state yang diamati ke aksi. Diberikan observasi sebagai input, jaringan menghasilkan aksi yang diprediksi sesuai kebijakan.
Kode di bawah ini mengimplementasikan jaringan kebijakan:
class PolicyNetwork(nn.Module):
def __init__(self, input_dim, hidden_dim, output_dim, dropout):
super().__init__()
self.layer1 = nn.Linear(input_dim, hidden_dim)
self.layer2 = nn.Linear(hidden_dim, output_dim)
self.dropout = nn.Dropout(dropout)
def forward(self, x):
x = self.layer1(x)
x = self.dropout(x)
x = F.relu(x)
x = self.layer2(x)
return xMelatih agen
Lingkungan memberikan imbalan pada setiap timestep bergantung pada state dan aksi agen. Pendekatan policy gradient terdiri dari menjalankan gradient descent pada imbalan kumulatif (return). Tujuannya adalah memaksimalkan total return.
Untuk menghitung return dalam satu episode, Anda mengakumulasi (dengan faktor diskonto) imbalan dari semua timestep dalam episode tersebut. Selain itu, menormalkan return membantu memastikan pelatihan yang mulus dan stabil. Kode di bawah ini menunjukkan caranya:
def calculate_stepwise_returns(rewards, discount_factor):
returns = []
R = 0
for r in reversed(rewards):
R = r + R * discount_factor
returns.insert(0, R)
returns = torch.tensor(returns)
normalized_returns = (returns - returns.mean()) / returns.std()
return normalized_returnsPada setiap iterasi forward pass, kita melakukan langkah-langkah berikut:
- Jalankan agen berdasarkan kebijakan saat ini menggunakan fungsi
.step(). Kebijakan memprediksi probabilitas mengambil aksi yang dipilih pada setiap timestep. - Terima imbalan dari lingkungan berdasarkan aksi agen.
- Kumpulkan imbalan per langkah dan log probabilitas aksi hingga agen mencapai state terminal.
Kode di bawah ini mengimplementasikan forward pass:
def forward_pass(env, policy, discount_factor):
log_prob_actions = []
rewards = []
done = False
episode_return = 0
policy.train()
observation, info = env.reset()
while not done:
observation = torch.FloatTensor(observation).unsqueeze(0)
action_pred = policy(observation)
action_prob = F.softmax(action_pred, dim = -1)
dist = distributions.Categorical(action_prob)
action = dist.sample()
log_prob_action = dist.log_prob(action)
observation, reward, terminated, truncated, info = env.step(action.item())
done = terminated or truncated
log_prob_actions.append(log_prob_action)
rewards.append(reward)
episode_return += reward
log_prob_actions = torch.cat(log_prob_actions)
stepwise_returns = calculate_stepwise_returns(rewards, discount_factor)
return episode_return, stepwise_returns, log_prob_actionsMenggunakan backpropagation dan gradient ascent untuk memperbarui kebijakan
Dalam pembelajaran mesin tradisional:
- Loss merujuk pada perbedaan antara keluaran prediksi dan aktual.
- Kita meminimalkan loss menggunakan gradient descent.
Dalam RL:
- Loss adalah proksi untuk besaran yang akan diterapkan gradient descent (atau ascent).
- Kita memaksimalkan return (imbalan kumulatif) menggunakan gradient ascent.
- Nilai return yang diharapkan digunakan sebagai proksi loss untuk gradient descent. Nilai return yang diharapkan adalah hasil kali dari:
- Return yang diharapkan dari setiap langkah dengan
- Probabilitas memilih aksi yang di-sample pada setiap langkah.
- Untuk menerapkan gradient ascent menggunakan backpropagation, kita menggunakan negatif dari loss.
Kode di bawah ini menghitung loss:
def calculate_loss(stepwise_returns, log_prob_actions):
loss = -(stepwise_returns * log_prob_actions).sum()
return lossSerupa dengan algoritme pembelajaran mesin standar, untuk memperbarui kebijakan, Anda menjalankan backpropagation terhadap fungsi loss. Metode update_policy() di bawah ini memanggil metode calculate_loss(). Kemudian menjalankan backpropagation pada loss ini untuk memperbarui parameter kebijakan, yaitu bobot model dari jaringan kebijakan.
def update_policy(stepwise_returns, log_prob_actions, optimizer):
stepwise_returns = stepwise_returns.detach()
loss = calculate_loss(stepwise_returns, log_prob_actions)
optimizer.zero_grad()
loss.backward()
optimizer.step()
return loss.item()Loop pelatihan
Kita menggunakan fungsi-fungsi yang didefinisikan sebelumnya untuk melatih kebijakan. Sebelum memulai pelatihan, kita memerlukan:
- Kebijakan yang belum terlatih yang diinisialisasi sebagai instance acak dari kelas PolicyNetwork.
- Sebuah optimizer yang menggunakan algoritme Adam.
- Hiperparameter untuk faktor diskonto, laju pembelajaran, tingkat dropout, ambang imbalan, dan jumlah maksimum epoch pelatihan.
Kita mengiterasi loop pelatihan hingga return rata-rata melampaui ambang imbalan. Pada setiap iterasi, kita mengeksekusi langkah-langkah berikut:
- Untuk setiap episode, jalankan forward pass sekali. Kumpulkan log probabilitas aksi, return per langkah, dan total return dari episode tersebut. Akumulasikan return per episode dalam sebuah array.
- Hitung loss menggunakan log probabilitas dan return per langkah. Jalankan backpropagation pada loss. Gunakan optimizer untuk memperbarui parameter kebijakan.
- Periksa apakah return rata-rata selama
N_TRIALSmelampaui ambang imbalan.
Kode di bawah ini mengimplementasikan langkah-langkah tersebut:
def main():
MAX_EPOCHS = 500
DISCOUNT_FACTOR = 0.99
N_TRIALS = 25
REWARD_THRESHOLD = 475
PRINT_INTERVAL = 10
INPUT_DIM = env.observation_space.shape[0]
HIDDEN_DIM = 128
OUTPUT_DIM = env.action_space.n
DROPOUT = 0.5
episode_returns = []
policy = PolicyNetwork(INPUT_DIM, HIDDEN_DIM, OUTPUT_DIM, DROPOUT)
LEARNING_RATE = 0.01
optimizer = optim.Adam(policy.parameters(), lr = LEARNING_RATE)
for episode in range(1, MAX_EPOCHS+1):
episode_return, stepwise_returns, log_prob_actions = forward_pass(env, policy, DISCOUNT_FACTOR)
_ = update_policy(stepwise_returns, log_prob_actions, optimizer)
episode_returns.append(episode_return)
mean_episode_return = np.mean(episode_returns[-N_TRIALS:])
if episode % PRINT_INTERVAL == 0:
print(f'| Episode: {episode:3} | Mean Rewards: {mean_episode_return:5.1f} |')
if mean_episode_return >= REWARD_THRESHOLD:
print(f'Reached reward threshold in {episode} episodes')
breakJalankan program pelatihan dengan memanggil fungsi main():
main()Workbook DataLab ini berisi implementasi di atas dari algoritme policy gradient. Anda dapat menjalankannya langsung atau menggunakannya sebagai titik awal untuk memodifikasi algoritme.
Keunggulan dan Tantangan Metode Policy Gradient
Metode policy gradient menawarkan beberapa keunggulan, seperti:
- Menangani ruang aksi kontinu: Metode berbasis nilai (seperti Q-learning) tidak efisien pada ruang aksi kontinu karena harus mengestimasi nilai di seluruh ruang aksi. Metode policy gradient dapat langsung mengoptimalkan kebijakan menggunakan gradien return yang diharapkan. Pendekatan ini bekerja baik dengan distribusi aksi kontinu. Dengan demikian, metode policy gradient sesuai untuk tugas seperti kontrol robotik yang berbasis ruang aksi kontinu.
- Kebijakan stokastik: Metode policy gradient dapat mempelajari kebijakan stokastik—yang memberikan probabilitas pemilihan setiap aksi yang mungkin. Ini memungkinkan agen mencoba berbagai aksi dan mengurangi risiko terjebak pada optimum lokal. Hal ini membantu di lingkungan kompleks di mana agen perlu mengeksplorasi ruang aksi untuk menemukan kebijakan optimal. Sifat stokastik membantu menyeimbangkan eksplorasi (mencoba aksi baru) dan eksploitasi (memilih aksi terbaik yang diketahui), yang krusial untuk lingkungan dengan ketidakpastian atau imbalan yang jarang.
- Optimisasi kebijakan secara langsung: Policy gradient mengoptimalkan kebijakan secara langsung alih-alih menggunakan fungsi nilai. Pada ruang aksi kontinu atau berdimensi tinggi, mengaproksimasi nilai untuk setiap aksi dapat menjadi sangat mahal secara komputasional. Dengan demikian, metode berbasis kebijakan berkinerja baik di lingkungan seperti itu.
Terlepas dari banyak keunggulannya, metode policy gradient memiliki beberapa tantangan bawaan:
- Varians tinggi pada estimasi gradien: Metode policy gradient memilih aksi dengan melakukan sampling pada distribusi probabilitas. Pada praktiknya, mereka melakukan sampling trajektori untuk mengestimasi return yang diharapkan. Karena proses sampling secara inheren acak, return yang diestimasi pada iterasi berikutnya dapat memiliki varians tinggi. Ini dapat mempersulit agen untuk belajar secara efisien karena pembaruan pada kebijakan dapat berfluktuasi secara signifikan antar iterasi.
- Instabilitas selama pelatihan:
- Metode policy gradient sensitif terhadap hiperparameter seperti laju pembelajaran. Jika laju pembelajaran terlalu tinggi, pembaruan parameter kebijakan dapat terlalu besar, menyebabkan pelatihan melewatkan parameter optimum. Sebaliknya, jika laju pembelajaran terlalu kecil, konvergensi bisa lambat.
- Metode policy gradient perlu menyeimbangkan eksplorasi dan eksploitasi. Jika agen tidak cukup mengeksplorasi, ia mungkin tidak mencapai lingkungan kebijakan optimal. Sebaliknya, jika terlalu banyak eksplorasi, ia tidak akan berkonvergensi pada kebijakan optimal dan berosilasi di sekitar ruang aksi.
- Inefisiensi sampel: Metode policy gradient mengestimasi return dengan mengikuti setiap kebijakan hingga terminasi dan mengakumulasi imbalan dari setiap langkah. Dengan demikian, mereka membutuhkan banyak interaksi dengan lingkungan untuk menarik sejumlah besar sampel trajektori. Ini tidak efisien dan mahal untuk lingkungan dengan ruang state atau aksi yang besar.
Solusi untuk stabilitas
Karena instabilitas merupakan masalah yang relatif umum pada metode policy gradient, pengembang telah mengadopsi berbagai solusi untuk menstabilkan proses pelatihan. Di bawah ini, kami perkenalkan solusi umum untuk menstabilkan pelatihan menggunakan policy gradient:
Menggunakan fungsi baseline
Karena sampling yang tidak efisien, gradien dari return yang diestimasi selama iterasi pelatihan dapat memiliki varians tinggi, membuat pelatihan menjadi tidak stabil dan lambat. Pendekatan umum untuk mengurangi varians adalah menggunakan fungsi baseline, seperti metode Advantage Actor-Critic (A2C). Idenya adalah menggunakan proksi (fungsi advantage) alih-alih return yang diestimasi untuk fungsi objektif.
Advantage dihitung sebagai selisih antara return aktual dari trajektori yang di-sample dan return yang diharapkan diberikan state awal. Pendekatan ini melibatkan penggunaan fungsi nilai sebagai nilai yang diharapkan dari state dan pasangan state-aksi. Dengan merepresentasikan loss sebagai selisih antara return aktual dan return yang diharapkan alih-alih hanya return, A2C mengurangi varians pada fungsi loss dan, karenanya, pada gradien, sehingga membuat pelatihan lebih stabil.
Menggunakan regularisasi entropi
Dalam lingkungan tertentu, seperti yang memiliki imbalan jarang (hanya sangat sedikit state yang memberikan imbalan), kebijakan dengan cepat mengadopsi pendekatan deterministik. Ia juga mengadopsi pendekatan rakus (greedy) dan mengeksploitasi jalur yang telah dieksplorasi. Ini mencegah eksplorasi lebih lanjut dan sering kali mengarah pada konvergensi ke optimum lokal dan kebijakan suboptimal.
Solusinya adalah mendorong eksplorasi dengan memberi penalti pada kebijakan saat menjadi terlalu deterministik. Ini dilakukan dengan menambahkan suku berbasis entropi ke fungsi objektif. Entropi mengukur tingkat keacakan pada kebijakan. Semakin besar entropi, semakin besar keacakan pada aksi yang dipilih agen. Suku berbasis entropi ini adalah hasil kali antara koefisien entropi dan entropi kebijakan saat ini.
Menjadikan entropi bagian dari fungsi objektif membantu mencapai keseimbangan antara eksploitasi dan eksplorasi.
Ekstensi Policy Gradient
Di antara berbagai ekstensi metode policy gradient, salah satu yang paling mendasar adalah algoritme REINFORCE. Ia menyediakan implementasi langsung dari teorema policy gradient dan menjadi fondasi bagi teknik yang lebih lanjut.
Algoritme REINFORCE
Algoritme REINFORCE, juga dikenal sebagai Monte Carlo Reinforce, adalah salah satu implementasi dasar dari teorema policy gradient. Ia menggunakan metode Monte Carlo untuk mengestimasi return dan policy gradient. Saat mengikuti algoritme REINFORCE, agen secara langsung melakukan sampling semua aksi (dari state awal hingga state terminal) dari lingkungan. Ini berbeda dengan metode lain seperti TD-Learning dan Dynamic Programming, yang melakukan bootstrap aksinya berdasarkan estimasi fungsi nilai.
Di bawah ini, kami sajikan langkah-langkah dasar algoritme REINFORCE:
- Inisialisasi kebijakan dengan parameter acak
- Ulangi beberapa episode pelatihan. Untuk setiap episode:
- Bangkitkan setiap langkah dari seluruh episode sebagai berikut:
- Umpankan state ke fungsi kebijakan.
- Fungsi kebijakan menghasilkan probabilitas untuk setiap aksi yang mungkin.
- Secara acak sampling sebuah aksi dari distribusi probabilitas ini.
- Untuk setiap state dalam episode, estimasi return (imbalan kumulatif terdiskonto) hingga langkah tersebut.
- Estimasi gradien dari fungsi objektif (menurut teorema policy gradient), yang dinyatakan sebagai hasil kali antara return per langkah dan probabilitas aksi untuk setiap langkah.
- Perbarui parameter kebijakan dengan menerapkan gradien
Untuk setiap kebijakan, Anda dapat melakukan sampling satu trajektori untuk mengestimasi gradien (seperti di atas) atau merata-ratakan gradien atas beberapa trajektori yang di-sample di bawah kebijakan yang sama.
Metode actor-critic
Metode actor-critic menggabungkan metode policy gradient (seperti REINFORCE) dengan fungsi nilai.
- Cara kerja actor serupa dengan metode policy gradient. Actor mengimplementasikan kebijakan, memilih aksi di setiap langkah berdasarkan kebijakan. Ia memperbarui kebijakan dengan mengikuti gradien dari return yang diharapkan.
- Critic mengimplementasikan fungsi nilai, yang digunakan sebagai baseline (dibahas di bagian sebelumnya). Ini membantu membuat pelatihan lebih efisien dan stabil.
Metode policy gradient seperti REINFORCE mengestimasi gradien sepanjang setiap trajektori menggunakan return mentah. Karena trajektori ini diambil melalui proses sampling, hal ini dapat menghasilkan varians besar pada return dan gradien. Menggunakan fungsi advantage alih-alih return mentah menyelesaikan masalah ini. Fungsi advantage adalah selisih antara return aktual dan return yang diharapkan (yaitu fungsi nilai). Metode actor-critic adalah kelas algoritme. Ketika critic diimplementasikan menggunakan fungsi advantage (pendekatan yang paling umum), ia juga disebut Advantage actor-critic (A2C).
Proximal Policy Optimization (PPO)
Dalam lingkungan kompleks, metode actor-critic seperti A2C saja tidak cukup untuk mengendalikan varians pada return dan gradien. Dalam kasus seperti itu, membatasi secara artifisial besaran perubahan kebijakan pada setiap iterasi membantu. Ini memaksa kebijakan yang diperbarui (setelah gradient ascent) berada di sekitar kebijakan lama.
Metode seperti Proximal Policy Optimization membuat dua modifikasi pada policy gradient:
- Menggunakan fungsi advantage. Biasanya, fungsi advantage ini menggunakan fungsi nilai sebagai baseline. Dalam hal ini, mereka mirip dengan metode A2C.
- Membatasi besarnya perubahan parameter kebijakan pada setiap iterasi. Ini dilakukan menggunakan fungsi objektif surrogate yang dipotong (clipped). Algoritme menentukan rentang di mana rasio kebijakan baru terhadap kebijakan lama harus berada. Ketika rasio (setelah pembaruan gradien) melampaui nilai yang telah ditentukan, rasio tersebut dipotong agar berada dalam rentang.
Dengan demikian, PPO secara signifikan meningkatkan metode policy gradient standar (vanilla), yang meningkatkan stabilitas di lingkungan kompleks. Fungsi objektif yang dipotong mencegah varians besar pada return dan gradien yang dapat mengganggu pembaruan kebijakan. Untuk mencapai keseimbangan antara eksplorasi dan eksploitasi, dimungkinkan juga memodifikasi PPO agar menggunakan regularisasi entropi. Ini dilakukan dengan menambahkan suku entropi (parameter penskalaan dikalikan dengan entropi kebijakan) ke fungsi objektif.
Kemajuan terbaru
Policy gradient termasuk di antara metode paling awal yang digunakan untuk menyelesaikan masalah RL. Setelah hadirnya GPU yang cepat, berbagai pendekatan baru telah diajukan untuk menerapkan teknik ML modern pada policy gradient.
Gradient-Boosted Reinforcement Learning
Dalam beberapa tahun terakhir, kemajuan telah dibuat dalam menerapkan metode seperti gradient boosting pada algoritme RL. Gradient boosting menggabungkan prediksi dari beberapa model lemah untuk menghasilkan satu model kuat. Ini disebut Gradient-Boosted Reinforcement Learning (GBRL). GBRL adalah paket Python yang mirip dengan XGBoost yang mengimplementasikan teknik ini untuk algoritme RL.
Transfer Reinforcement Learning
Transfer learning (TL) adalah teknik di mana pengetahuan yang diperoleh oleh satu model diterapkan untuk meningkatkan kinerja model lain. Transfer learning bermanfaat karena melatih model ML dari nol itu mahal. Pendekatan TL telah digunakan dengan policy gradient untuk meningkatkan kinerja model RL. Pendekatan ini disebut Transfer Reinforcement Learning (TRL).
Kesimpulan
Policy gradient merupakan salah satu pendekatan paling mendasar untuk menyelesaikan masalah RL.
Dalam artikel ini, kami menyajikan prinsip pertama dari policy gradient dan menunjukkan cara menurunkan teorema policy gradient. Kami juga mendemonstrasikan cara mengimplementasikan algoritme sederhana berbasis gradien menggunakan PyTorch dalam lingkungan Gymnasium. Terakhir, kami membahas tantangan praktis dan ekstensi umum terhadap algoritme policy gradient dasar.
Jika Anda ingin memperdalam pemahaman tentang reinforcement learning dan deep learning dengan PyTorch, lihat kursus-kursus berikut:
- Reinforcement Learning Track – Pelajari fondasi RL, dari metode berbasis nilai hingga teknik optimisasi kebijakan.
- Introduction to Deep Learning with PyTorch – Dapatkan pengalaman praktis dengan PyTorch dan bangun model deep learning dari nol.

Arun adalah mantan pendiri startup yang gemar membangun hal-hal baru. Saat ini ia mengeksplorasi landasan teknis dan matematis Kecerdasan Buatan. Ia senang berbagi apa yang dipelajarinya, sehingga ia menulis tentang topik tersebut.
Selain di DataCamp, Anda dapat membaca publikasinya di Medium, Airbyte, dan Vultr.




Policy gradient dalam reinforcement learning (RL) adalah sekumpulan algoritme yang secara langsung mengoptimalkan kebijakan (policy) agen dengan mengestimasi gradien dari ekspektasi imbalan terhadap parameter kebijakan.
Dalam tutorial ini, kami menjelaskan teorema policy gradient beserta penurunannya dan menunjukkan cara mengimplementasikan algoritme policy gradient menggunakan PyTorch.
Apa itu Teorema Policy Gradient?
Dalam reinforcement learning, kebijakan (policy) agen merujuk pada algoritme yang digunakannya untuk menentukan aksi berdasarkan pengamatannya terhadap lingkungan. Tujuan dalam masalah RL adalah memaksimalkan imbalan yang diperoleh agen dari interaksinya dengan lingkungan. Kebijakan yang menghasilkan imbalan maksimum adalah kebijakan optimal.
Dua kelas algoritme yang digunakan untuk memaksimalkan return adalah metode berbasis kebijakan (policy-based) dan berbasis nilai (value-based):
Menurut teorema policy gradient, turunan dari ekspektasi return adalah ekspektasi dari hasil kali antara return dan turunan dari logaritma kebijakan (biasanya diekspresikan sebagai distribusi probabilitas).
Sebuah kebijakan biasanya dimodelkan sebagai fungsi terparametrisasi. Ketika kebijakan dimodelkan sebagai jaringan saraf, parameter kebijakan merujuk pada bobot jaringan. Dengan demikian, menghitung gradien dari return yang diharapkan (imbalan kumulatif) terhadap parameter kebijakan mengarah pada pembaruan kebijakan untuk meningkatkan kinerjanya. Gradien ini dapat digunakan untuk memperbarui parameter kebijakan secara iteratif ke arah yang meningkatkan ekspektasi return. Pelatihan seharusnya berkonvergensi pada kebijakan optimal yang memaksimalkan ekspektasi return.
Pada bagian selanjutnya, kami menjelaskan teorema ini secara rinci dan menunjukkan cara menurunkannya.