

Neden Politika Gradyanı Yöntemlerini Kullanmalı?
Politika gradyanı yöntemlerinin başlıca avantajlarından biri, geleneksel değer tabanlı yaklaşımların zorlandığı karmaşık eylem uzaylarını ele alabilmeleridir.
Yüksek boyutlu eylem uzaylarını ele alma
Q-learning gibi değer tabanlı yöntemler, tüm olası eylemler için değer fonksiyonunu tahmin ederek çalışır. Çevrenin eylem uzayı sürekli olduğunda ya da ayrık ama büyük olduğunda bu zorlaşır.
Politika gradyanı yöntemleri politikayı parametrize eder ve kümülatif ödüllerin gradyanını politika parametrelerine göre tahmin eder. Bu gradyanı, parametrelerini güncelleyerek politikayı doğrudan optimize etmek için kullanırlar. Böylece, yüksek boyutlu ya da sürekli eylem uzaylarını verimli biçimde ele alabilirler. Politika gradyanları ayrıca İnsan Geri Bildirimiyle Pekiştirmeli Öğrenme (RLHF) yöntemlerinin de temelini oluşturur.
Politikayı parametrize edip parametrelerini gradyanlara göre ayarlayarak, politika gradyanları sürekli ve yüksek boyutlu eylemleri verimli biçimde işleyebilir. Bu doğrudan yaklaşım, daha iyi genelleme ve daha esnek keşif olanağı sağlar; robotik kontrol ve diğer karmaşık çevreler gibi görevler için uygundur.
Stokastik politikaları öğrenme
Bir dizi gözlem verildiğinde:
- Deterministik bir politika, ajanın hangi eylemi yapacağını belirtir.
- Stokastik bir politika ise olası eylemler kümesini ve ajanın her eylemi seçme olasılığını verir.
Stokastik bir politika izlendiğinde, aynı gözlem farklı yinelemelerde farklı eylemlerin seçilmesine yol açabilir. Bu durum, eylem uzayının keşfini teşvik eder ve politikanın yerel optimumlarda takılıp kalmasını önler. Bu nedenle, stokastik politikalar, maksimum getiriye giden yolu keşfetmek için keşfin hayati olduğu ortamlarda faydalıdır.
Politika tabanlı yöntemlerde, politika çıktısı bir olasılık dağılımına dönüştürülür ve her olası eyleme bir olasılık atanır. Ajan, bu dağılımdan örnekleme yaparak bir eylem seçer; böylece stokastik bir politikanın uygulanması mümkün olur. Bu sayede, politika gradyanı yöntemleri, karmaşık ödül yapılarının bulunduğu ortamlarda faydalı olan keşif ile sömürüyü birleştirir.
Politika Gradyanı Teoreminin Türetimi
Türetime dalmadan önce, kanıt boyunca kullanılan matematiksel gösterimi ve temel kavramları ortaya koymak önemlidir.
Matematiksel gösterim ve önbilgiler
Önceki bir bölümde belirtildiği gibi, politika gradyanı teoremi beklenen getirinin türevinin, getiri ile politikanın logaritmasının türevinin çarpımının beklentisi olduğunu söyler.
Politika gradyanı teoremini türetmeden önce, gösterimi tanıtıyoruz:
- E[X], rassal değişken X’in olasılıksal beklentisini ifade eder.
- Matematiksel olarak politika, farklı gözlemlere göre farklı eylemleri seçme olasılığını veren bir olasılık matrisi olarak ifade edilir. Bir politika tipik olarak parametrik bir fonksiyon olarak modellenir ve parametreler θ ile gösterilir.
- πθ θ ile parametrik hale getirilmiş bir politikayı ifade eder. Pratikte bu parametreler, politikayı modelleyen sinir ağının ağırlıklarıdır.
- Yörünge, τ, tipik olarak rastgeleleştirilmiş bir başlangıç durumundan ya mevcut zaman adımına ya da terminal duruma kadar olan durumlar dizisini ifade eder.
- ∇θf, f fonksiyonunun θ parametre(ler)ine göre gradyanını ifade eder.
- J(πθ), ajanın πθ politikasını izlemesiyle elde ettiği beklenen getiriyi ifade eder. Bu aynı zamanda gradyan artışı için amaç fonksiyonudur.
- Çevre, her zaman adımında ajanın eylemine bağlı olarak bir ödül verir. Getiri, başlangıç durumundan mevcut zaman adımına kadar olan kümülatif ödülleri ifade eder.
- R(τ), τ yörüngesi boyunca üretilen getiriye atıfta bulunur.
Türetim adımları
Amaç fonksiyonunun açılımı ve log-türev hilesiyle başlayarak politika gradyanı teoreminin temel ilkelerden nasıl türetilip kanıtlanacağını gösteriyoruz.
Amaç fonksiyonu (Denklem 1)
Politika gradyanı yöntemindeki amaç fonksiyonu,
J olup, π politikası temel alınarak izlenen yörünge sonunda, parametreler θ cinsinden ifade edilen birikimli geri dönüşü gösterir. Bu amaç fonksiyonu şöyledir:
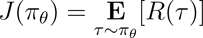
Yukarıdaki denklemde:
- Sol taraf (LHS), πθ politikasını izleyerek elde edilen beklenen getiridir.
- Sağ taraf (RHS), her adımda τ yörüngesi üzerinden (politikayı πθ izleyerek üretilen) getirilerin beklentisidir R(τ).
Amaç fonksiyonunun türevi (Denklem 2)
Yukarıdaki denklemin her iki tarafını θ’ya göre türevlediğimizde şu sonucu elde ederiz:
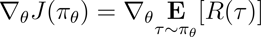
Beklentinin gradyanı (Denklem 3)
Beklenti (RHS’de) şu ikilinin çarpımı üzerindeki bir integral olarak ifade edilebilir:
- Bir τ yörüngesini izleme olasılığı
- Yörünge τ boyunca üretilen getiriler
Dolayısıyla, Denklem 2’nin sağ tarafı şu şekilde yeniden ifade edilir:
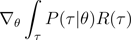
Bir integralin gradyanı, gradyanın integraline eşittir. Bu nedenle, yukarıdaki ifadede gradyanı ∇θ integral işaretinin altına alabiliriz. Böylece, RHS şu hale gelir:
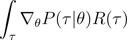
Dolayısıyla Denklem 2 şu şekilde yeniden yazılabilir:
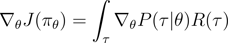
Yörüngenin olasılığı (Denklem 4)
Şimdi P(τ|θ) ifadesini, yani ajanın τ yörüngesini politika parametreleri θ (dolayısıyla politika πθ) verildiğinde izlemesi olasılığını daha yakından inceliyoruz. Bir yörünge bir dizi adımdan oluşur. Dolayısıyla:
- τ yörüngesini elde etme olasılığı şu çarpımın sonucudur:
- Tüm bireysel adımları izleme olasılığının.
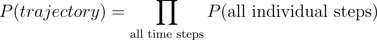
- Zaman adımı t’de, ajan s durumundan st+1 durumuna, at eylemini izleyerek geçer. Bunun olma olasılığı şu çarpım ile verilir:
- Politikanın at eylemini st durumunda tahmin etme olasılığı
- Verilen at eylemi ve st durumu ile st+1 durumuna ulaşma olasılığı
Dolayısıyla başlangıç durumu s0’dan başlayarak, ajanın τ yörüngesini πθ’ya dayalı olarak izlemesinin olasılığı şöyledir:
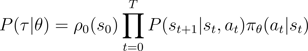
Basitleştirmek için, yukarıdaki RHS’deki çarpımı bir toplam olarak ifade etmek istiyoruz. Bu nedenle her iki tarafa da logaritma alıyoruz:
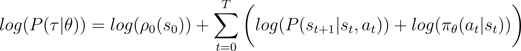
Log-olasılığın türevi (Denklem 5)
Şimdi yukarıdaki denklemde log olasılığın θ’ya göre türevini alıyoruz.
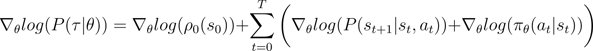
Yukarıdaki denklemin sağ tarafında:
- İlk terim log ρ0(s0), θ’ya göre sabittir. Dolayısıyla türevi 0’dır.
- Toplam içindeki ilk terim P(st+1|st, at) da θ’dan bağımsızdır ve θ’ya göre türevi de 0’dır.
Yukarıdaki sıfır terimleri denklemden çıkardığımızda elimizde (Denklem 5) kalır:
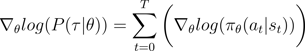
Denklem 2’yi hatırlayın:
Denklem 5, Denklem 2’nin sağ tarafındaki ilk kısmın log’unu değerlendirir. Bir terimin türevini logaritmasıyla ilişkilendirmemiz gerekir. Bunu zincir kuralı ve log-türev hilesiyle yapıyoruz.
Log-türev hilesi
Kısa bir yol alıp, önceki denklemi basitleştirmek ve hesaplamalı yöntemlere uygun hale getirmek için kullanacağımız bir sonucu, analiz kurallarıyla türetiyoruz.
Analizde, bir logaritmanın türevi şu şekilde ifade edilebilir:
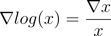
Dolayısıyla, yukarıdaki denklemi yeniden düzenleyerek, x’in türevini x’in logaritmasının türevi cinsinden ifade edebiliriz:
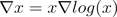
Bu, bazen log-türev hilesi olarak adlandırılır.
Zincir kuralı
Zincir kuralına göre, z(y)’nin y’nin bir fonksiyonu olduğu, y’nin de θ’nın bir fonksiyonu olduğu durumda, y(θ) ile gösterildiğinde, z’nin θ’ya göre türevi şöyledir:

Bu durumda, y(θ), P(θ)’yi, z(y) ise log(y)’yi temsil eder. Dolayısıyla,
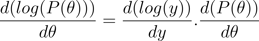
Zincir kuralını uygulama
Analizden biliyoruz ki d(log(y)) / dy = 1/y. Bunu yukarıdaki RHS’nin ilk ifadesinde kullanın.
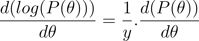
y’yi sol tarafa alın ve gösterimini kullanın:
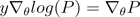
y, P(θ)’yi ifade eder. Dolayısıyla, yukarıdaki denklem şu anlama gelir:

Log-türev hilesini uygulama
Yukarıdaki sonuç, (aşağıda gösterilen) Denklem 2’nin sağ tarafındaki ilk ifadeyi verir.
Bu sonucu Denklem 2’nin sağ tarafında kullanırsak şunu elde ederiz:
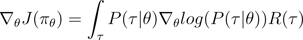
RHS integralinin altındaki terimleri aşağıdaki gibi yeniden düzenleriz:
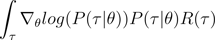
Nihai sonucun türetilmesi
Yukarıdaki ifadenin, bir beklentinin integral açılımını içerdiğine dikkat edin: ∫P(θ)∇logP(θ) = E[∇logP(θ)]
Dolayısıyla, yukarıdaki RHS bir beklenti olarak ifade edilebilir:
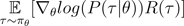
Beklenen ödül ifadesinde log olasılığın türevini yerine koyarız:

Yukarıdaki denklemde, ∇logP(θ) değerini Denklem 5’ten yerine koyarak şunu elde ederiz:
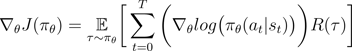
Bu, politika gradyanı teoremine göre ödül fonksiyonunun gradyanı için ifadedir.
Politika gradyanının sezgisi
Politika gradyanı yöntemleri, politikanın çıktısını bir olasılık dağılımına dönüştürür. Ajan, bir eylem seçmek için bu dağılımdan örnekler. Politika gradyanı yöntemleri politika parametrelerini ayarlar. Bu da her yinelemede bu olasılık dağılımının güncellenmesine yol açar. Güncellenen dağılım, daha yüksek ödüllere götüren eylemleri seçme olasılığını artırır.
Politika gradyanı algoritması, beklenen getirinin politika parametrelerine göre gradyanını hesaplar. Politika parametrelerini bu gradyanın yönünde hareket ettirerek, ajan eğitim sırasında daha yüksek ödüllerle sonuçlanan eylemleri seçme olasılığını artırır.
Özetle, daha iyi sonuçlara yol açan eylemler gelecekte seçilmeye daha yatkın hale gelir ve politika, uzun vadeli getirileri maksimize edecek şekilde kademeli olarak iyileştirilir.
Python ile Politika Gradyanlarının Uygulanması
Politika gradyanlarının temel ilkelerini tartıştığımıza göre, bunları PyTorch ve Gymnasium kullanarak nasıl uygulayacağımızı gösterelim.
Ortamın kurulumu
İlk adım olarak, gymnasium ve NumPy ile PyTorch gibi birkaç destekleyici kütüphaneyi kurmamız gerekiyor.
Bir sunucuya veya yerel makineye gymnasium ve bağımlılıklarını kurmak için şunu çalıştırın:
$ pip install gymnasium Google Colab veya DataLab gibi bir Notebook kullanarak kurmak için:
!pip install gymnasiumBu paketleri Python ortamında şöyle içe aktarırsınız:
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
import torch.distributions as distributions
import numpy as np
import gymnasium as gym Basit bir politika gradyanı ajanı kodlama
.make() yöntemiyle ortamın bir örneğini oluşturun.
env = gym.make('CartPole-v1')Makine öğrenimi yöntemlerinde olduğu gibi, politika gradyanı ajanını uygulamak için bir sinir ağı kullanıyoruz.
CartPole-v1 basit bir ortamdır; bu yüzden 64 nöronlu 1 gizli katmana sahip basit bir ağ tasarlarız. Girdi katmanının boyutu gözlem uzayının boyutlarına eşittir. Çıkış katmanının boyutu çevrenin eylem uzayının boyutuna eşittir. Böylece politika ağı, gözlenen durumları eylemlere eşler. Girdi olarak bir gözlem verildiğinde, ağ politika uyarınca tahmin edilen eylemi çıktılar.
Aşağıdaki kod politika ağını uygular:
class PolicyNetwork(nn.Module):
def __init__(self, input_dim, hidden_dim, output_dim, dropout):
super().__init__()
self.layer1 = nn.Linear(input_dim, hidden_dim)
self.layer2 = nn.Linear(hidden_dim, output_dim)
self.dropout = nn.Dropout(dropout)
def forward(self, x):
x = self.layer1(x)
x = self.dropout(x)
x = F.relu(x)
x = self.layer2(x)
return xAjani eğitme
Çevre, her zaman adımında ajanın durumuna ve eylemine bağlı olarak bir ödül verir. Politika gradyanı yaklaşımı, kümülatif ödüller (getiri) üzerinde gradyan inişi çalıştırmaktan oluşur. Amaç, toplam getiriyi maksimize etmektir.
Bir bölümde getiriyi hesaplamak için, o bölümdeki tüm zaman adımlarından gelen ödülleri (indirim faktörü ile) biriktirirsiniz. Ek olarak, getirilerin normalize edilmesi, eğitimin düzgün ve kararlı olmasına yardımcı olur. Aşağıdaki kod bunun nasıl yapılacağını gösterir:
def calculate_stepwise_returns(rewards, discount_factor):
returns = []
R = 0
for r in reversed(rewards):
R = r + R * discount_factor
returns.insert(0, R)
returns = torch.tensor(returns)
normalized_returns = (returns - returns.mean()) / returns.std()
return normalized_returnsİleri geçişin her yinelemesinde aşağıdaki adımları uygularız:
- Ajanı mevcut politikaya göre
.step()işlevini kullanarak çalıştırın. Politika, her zaman adımında seçilen eylemi gerçekleştirme olasılığını tahmin eder. - Ajanın eylemine bağlı olarak çevreden ödülü alın.
- Ajan terminal duruma ulaşıncaya kadar adım adım ödülleri ve eylemlerin log olasılıklarını biriktirin.
Aşağıdaki kod ileri geçişi uygular:
def forward_pass(env, policy, discount_factor):
log_prob_actions = []
rewards = []
done = False
episode_return = 0
policy.train()
observation, info = env.reset()
while not done:
observation = torch.FloatTensor(observation).unsqueeze(0)
action_pred = policy(observation)
action_prob = F.softmax(action_pred, dim = -1)
dist = distributions.Categorical(action_prob)
action = dist.sample()
log_prob_action = dist.log_prob(action)
observation, reward, terminated, truncated, info = env.step(action.item())
done = terminated or truncated
log_prob_actions.append(log_prob_action)
rewards.append(reward)
episode_return += reward
log_prob_actions = torch.cat(log_prob_actions)
stepwise_returns = calculate_stepwise_returns(rewards, discount_factor)
return episode_return, stepwise_returns, log_prob_actionsPolitikayı güncellemek için geri yayılım ve gradyan artışı kullanma
Geleneksel makine öğreniminde:
- Kayıp, tahmin edilen çıktı ile gerçek çıktı arasındaki farka karşılık gelir.
- Kaybı gradyan inişi ile minimize ederiz.
RL’de:
- Kayıp, gradyan inişi (veya artışı) uygulanacak niceliğin bir vekilidir.
- Getiriyi (kümülatif ödülleri) gradyan artışı ile maksimize ederiz.
- Beklenen getiri değeri, gradyan inişi için kaybın vekili olarak kullanılır. Beklenen getiri değeri, şunların çarpımıdır:
- Her adımdan beklenen getiriler ile
- Her adımda örneklenen eylemi seçme olasılığı.
- Geri yayılım kullanarak gradyan artışı uygulamak için kaybın negatifini kullanırız.
Aşağıdaki kod kaybı hesaplar:
def calculate_loss(stepwise_returns, log_prob_actions):
loss = -(stepwise_returns * log_prob_actions).sum()
return lossStandart makine öğrenimi algoritmalarına benzer şekilde, politikayı güncellemek için kayıp fonksiyonuna göre geri yayılım çalıştırırsınız. Aşağıdaki update_policy() yöntemi calculate_loss() yöntemini çağırır. Ardından bu kayıp üzerinde geri yayılım çalıştırarak politika parametrelerini, yani politika ağının model ağırlıklarını günceller.
def update_policy(stepwise_returns, log_prob_actions, optimizer):
stepwise_returns = stepwise_returns.detach()
loss = calculate_loss(stepwise_returns, log_prob_actions)
optimizer.zero_grad()
loss.backward()
optimizer.step()
return loss.item()Eğitim döngüsü
Politikayı eğitmek için daha önce tanımlanan işlevleri kullanırız. Eğitime başlamadan önce ihtiyacımız olanlar:
- PolicyNetwork sınıfının rastgeleleştirilmiş bir örneği olarak başlatılmış eğitilmemiş bir politika.
- Adam algoritmasını kullanan bir optimize edici.
- İndirim faktörü, öğrenme oranı, dropout oranı, ödül eşiği ve maksimum eğitim dönem sayısı için hiperparametreler.
Eğitim döngüsünde, ortalama getiri ödül eşiğini aşana kadar yineleme yaparız. Her yinelemede şu adımları uygularız:
- Her bölüm için bir kez ileri geçiş çalıştırın. O bölümden eylemlerin log olasılıklarını, adım adım getirileri ve toplam getiriyi toplayın. Bölümsel getirileri bir dizide biriktirin.
- Log olasılıkları ve adım adım getirileri kullanarak kaybı hesaplayın. Kayıp üzerinde geri yayılım çalıştırın. Politikayı güncellemek için optimize ediciyi kullanın.
N_TRIALSüzerindeki ortalama getiri ödül eşiğini aşıyor mu kontrol edin.
Aşağıdaki kod bu adımları uygular:
def main():
MAX_EPOCHS = 500
DISCOUNT_FACTOR = 0.99
N_TRIALS = 25
REWARD_THRESHOLD = 475
PRINT_INTERVAL = 10
INPUT_DIM = env.observation_space.shape[0]
HIDDEN_DIM = 128
OUTPUT_DIM = env.action_space.n
DROPOUT = 0.5
episode_returns = []
policy = PolicyNetwork(INPUT_DIM, HIDDEN_DIM, OUTPUT_DIM, DROPOUT)
LEARNING_RATE = 0.01
optimizer = optim.Adam(policy.parameters(), lr = LEARNING_RATE)
for episode in range(1, MAX_EPOCHS+1):
episode_return, stepwise_returns, log_prob_actions = forward_pass(env, policy, DISCOUNT_FACTOR)
_ = update_policy(stepwise_returns, log_prob_actions, optimizer)
episode_returns.append(episode_return)
mean_episode_return = np.mean(episode_returns[-N_TRIALS:])
if episode % PRINT_INTERVAL == 0:
print(f'| Episode: {episode:3} | Mean Rewards: {mean_episode_return:5.1f} |')
if mean_episode_return >= REWARD_THRESHOLD:
print(f'Reached reward threshold in {episode} episodes')
breakEğitim programını main() işlevini çağırarak çalıştırın:
main()Bu DataLab çalışma kitabı söz konusu politika gradyanı algoritmasının yukarıdaki uygulamasını içerir. Bunu doğrudan çalıştırabilir veya algoritmayı değiştirmek için başlangıç noktası olarak kullanabilirsiniz.
Politika Gradyanı Yöntemlerinin Avantajları ve Zorlukları
Politika gradyanı yöntemleri çeşitli avantajlar sunar, örneğin:
- Sürekli eylem uzaylarını ele alma: Değer tabanlı yöntemler (Q-learning gibi) sürekli eylem uzaylarında verimsizdir; çünkü tüm eylem uzayı üzerinde değerleri tahmin etmeleri gerekir. Politika gradyanı yöntemleri, beklenen getirilerin gradyanını kullanarak politikayı doğrudan optimize edebilir. Bu yaklaşım, sürekli eylem dağılımlarıyla iyi çalışır. Dolayısıyla politika gradyanı yöntemleri, sürekli eylem uzaylarına dayalı robotik kontrol gibi görevler için uygundur.
- Stokastik politikalar: Politika gradyanı yöntemleri, her olası eylemi seçme olasılığını veren stokastik politikaları öğrenebilir. Bu, ajanın çeşitli eylemleri denemesine olanak tanır ve yerel optimumlarda takılma riskini azaltır. Ajanın optimal politikayı bulmak için eylem uzayını keşfetmesi gereken karmaşık ortamlarda yardımcı olur. Stokastik doğa, belirsizlik veya seyrek ödüllerin bulunduğu ortamlarda kritik olan keşif (yeni eylemleri deneme) ile sömürü (bilinen en iyi eylemleri seçme) arasında denge kurulmasına yardımcı olur.
- Doğrudan politika optimizasyonu: Politika gradyanları, değer fonksiyonları yerine politikayı doğrudan optimize eder. Sürekli veya yüksek boyutlu eylem uzaylarında, her eylem için değerleri yaklaşık hesaplamak hesaplama açısından pahalı olabilir. Bu nedenle, politika tabanlı yöntemler bu tür ortamlarda iyi performans gösterir.
Birçok avantajına karşın, politika gradyanı yöntemlerinin bazı doğuştan gelen zorlukları vardır:
- Gradyan tahminlerinde yüksek varyans: Politika gradyanı yöntemleri eylemleri bir olasılık dağılımından örnekleyerek seçer. Etkide, beklenen getiriyi tahmin etmek için yörüngeden örneklerler. Örnekleme süreci doğası gereği rastgele olduğundan, ardışık yinelemelerde tahmin edilen getiriler yüksek varyansa sahip olabilir. Bu durum, politika güncellemelerinin yinelemeler arasında önemli ölçüde dalgalanmasına neden olarak ajanın verimli bir şekilde öğrenmesini zorlaştırabilir.
- Eğitim sırasında kararsızlık:
- Politika gradyanı yöntemleri, gibi hiperparametrelere duyarlıdır. Öğrenme oranı çok yüksekse, politika parametrelerindeki güncellemeler çok büyük olabilir ve eğitimin en iyi parametreleri kaçırmasına neden olabilir. Öte yandan, öğrenme oranı çok düşükse yakınsama yavaş olabilir.
- Politika gradyanı yöntemlerinin keşif ve sömürü arasında denge kurması gerekir. Ajan yeterince keşfetmezse, optimal politikanın civarına ulaşamayabilir. Tersine, çok fazla keşif yaparsa optimal politikaya yakınsama olmaz ve eylem uzayı etrafında salınım yapar.
- Örnek verimsizliği: Politika gradyanı yöntemleri, her politikayı terminale kadar izleyip her adımdan gelen ödülleri biriktirerek getiriyi tahmin eder. Bu nedenle, çok sayıda örnek yörünge elde etmek için çevreyle çok sayıda etkileşime ihtiyaç duyarlar. Bu, büyük durum veya eylem uzaylarına sahip ortamlar için verimsiz ve maliyetlidir.
Kararlılık için çözümler
Kararsızlık, politika gradyanı yöntemlerinde nispeten yaygın bir sorun olduğundan, geliştiriciler eğitim sürecini stabilize etmek için çeşitli çözümler benimsemiştir. Aşağıda, politika gradyanlarıyla eğitimi stabilize etmek için yaygın çözümleri tanıtıyoruz:
Temel (baseline) fonksiyonları kullanma
Verimsiz örnekleme nedeniyle, eğitim yinelemeleri sırasında tahmin edilen getirilerin gradyanları yüksek varyansa sahip olabilir; bu da eğitimi kararsız ve yavaş hale getirir. Varyansı azaltmanın yaygın bir yolu, Advantage Actor-Critic (A2C) yöntemi gibi temel fonksiyonları kullanmaktır. Fikir, amaç fonksiyonu için tahmin edilen getiri yerine bir vekil (avantaj fonksiyonu) kullanmaktır.
Avantaj, örneklenen yörüngeden elde edilen gerçek getiri ile başlangıç durumu verildiğinde beklenen getiri arasındaki fark olarak hesaplanır. Bu yaklaşım, beklenen değer olarak değer fonksiyonunu (durumların ve durum-eylem çiftlerinin beklenen değeri) kullanmayı içerir. Kaybı yalnızca getiriler olarak değil de gerçek getiri ile beklenen getiri arasındaki fark olarak ifade etmek, A2C’nin kayıp fonksiyonundaki ve dolayısıyla gradyanlardaki varyansı azaltmasına yardımcı olur; böylece eğitimi daha kararlı hale getirir.
Entropi düzenlileştirme kullanma
Ödüllerin seyrek olduğu (yalnızca çok az sayıda durumun ödül verdiği) gibi bazı ortamlarda, politika hızla deterministik bir yaklaşım benimser. Aynı zamanda açgözlü bir yaklaşım izleyerek zaten keşfettiği yolları sömürür. Bu, daha fazla keşfi engeller ve çoğunlukla yerel optimumlara ve optimal olmayan politikalara yakınsamaya yol açar.
Çözüm, politika çok deterministik hale geldiğinde onu cezalandırarak keşfi teşvik etmektir. Bu, amaç fonksiyonuna entropi temelli bir terim eklenerek yapılır. Entropi, politikadaki rastgelelik miktarını ölçer. Entropi ne kadar büyükse, ajanın seçtiği eylemlerde o kadar fazla rastgelelik vardır. Bu entropi tabanlı terim, entropi katsayısı ile mevcut politikanın entropisinin çarpımıdır.
Entropiyi amaç fonksiyonunun bir parçası yapmak, sömürü ile keşif arasında bir denge kurulmasına yardımcı olur.
Politika Gradyanı Genişletmeleri
Politika gradyanı yöntemlerinin çeşitli genişletmeleri arasında, en temel olanlardan biri REINFORCE algoritmasıdır. Politika gradyanı teoreminin doğrudan bir uygulamasını sağlar ve daha gelişmiş tekniklerin temelini oluşturur.
REINFORCE algoritması
REINFORCE algoritması, Monte Carlo Reinforce olarak da bilinir ve politika gradyanı teoreminin temel uygulamalarından biridir. Getirileri ve politika gradyanlarını tahmin etmek için Monte Carlo yöntemlerini kullanır. REINFORCE algoritması izlenirken, ajan başlangıç durumundan terminal duruma kadar tüm eylemleri doğrudan çevreden örnekler. Bu, eylemlerini değer fonksiyonu tahminlerine göre önyükleyen TD-Öğrenme ve Dinamik Programlama gibi diğer yöntemlerle tezat oluşturur.
Aşağıda REINFORCE algoritmasının temel adımlarını sunuyoruz:
- Politikayı rastgele parametrelerle başlatın
- Birden fazla eğitim bölümü tekrarlayın. Her bölüm için:
- Tüm bölümün her adımını şu şekilde üretin:
- Durumu politika fonksiyonuna iletin.
- Politika fonksiyonu her olası eylem için olasılıklar üretir.
- Bu olasılık dağılımından rastgele bir eylem örnekleyin.
- Bölümdeki her durum için, adıma kadar olan getirileri (iskontolu kümülatif ödüller) tahmin edin.
- Amaç fonksiyonunun gradyanını (politika gradyanı teoremine göre), her adım için adım adım getiriler ile eylem olasılıklarının çarpımı olarak ifade edilip tahmin edin.
- Gradyanları uygulayarak politika parametrelerini güncelleyin
Her politika için, gradyanı tahmin etmek üzere tek bir yörünge örnekleyebilir (yukarıda gösterildiği gibi) veya aynı politika altında örneklenen birden çok yörünge üzerinden gradyanın ortalamasını alabilirsiniz.
Aktör-eleştirmen (actor-critic) yöntemleri
Aktör-eleştirmen yöntemleri, politika gradyanı yöntemlerini (REINFORCE gibi) değer fonksiyonlarıyla birleştirir.
- Aktörün işleyişi politika gradyanı yöntemlerine benzer. Aktör, her adımda politikaya göre eylem seçen politikayı uygular. Beklenen getirinin gradyanını izleyerek politikayı günceller.
- Eleştirmen, önceki bölümde tartışılan temel (baseline) olarak kullanılan değer fonksiyonunu uygular. Bu, eğitimin daha verimli ve kararlı olmasına yardımcı olur.
REINFORCE gibi politika gradyanı yöntemleri, gradyanları her yörünge boyunca ham getiriyle tahmin eder. Bu yörüngeler bir örnekleme süreciyle elde edildiğinden, getirilerde ve gradyanlarda büyük varyanslara yol açabilir. Ham getiriler yerine avantaj fonksiyonunu kullanmak bu sorunu çözer. Avantaj fonksiyonu, gerçek ve beklenen getiriler (yani değer fonksiyonu) arasındaki farktır. Aktör-eleştirmen yöntemleri bir algoritma sınıfıdır. Eleştirmen avantaj fonksiyonunu kullanarak uygulandığında (en yaygın yaklaşım), Advantage actor-critic (A2C) olarak da adlandırılır.
Yakınsak Politika Optimizasyonu (PPO)
Karmaşık ortamlarda, A2C gibi aktör-eleştirmen yöntemleri tek başına getirilerdeki ve gradyanlardaki varyansı kontrol etmek için yeterli olmaz. Bu gibi durumlarda, politikanın her yinelemede ne kadar değişebileceğini yapay olarak sınırlamak yardımcı olur. Bu, güncellenmiş (gradyan artışından sonra) politikanın eski politikanın komşuluğunda kalmaya zorlanması anlamına gelir.
Yakınsak Politika Optimizasyonu gibi yöntemler, politika gradyanlarında iki değişiklik yapar:
- Avantaj fonksiyonu kullanın. Tipik olarak bu avantaj fonksiyonu, temel olarak değer fonksiyonunu kullanır. Bu açıdan A2C yöntemlerine benzer.
- Politika parametrelerinin her yinelemede ne kadar değişebileceğini sınırlayın. Bu, kırpılmış vekil (surrogate) amaç fonksiyonu kullanılarak yapılır. Algoritma, yeni politikanın eski politikaya oranının yatması gereken bir aralık belirtir. Oran (gradyan güncellemesinden sonra) bu önceden belirlenmiş değerleri aştığında, aralık içinde kalacak şekilde kırpılır.
Böylece PPO, sade politika gradyanı yöntemlerine göre belirgin biçimde iyileşme sağlar ve karmaşık ortamlarda kararlılığı artırır. Kırpılmış amaç fonksiyonu, getiriler ve gradyanlardaki büyük varyansların politika güncellemelerini dengesizleştirmesini engeller. Keşif ile sömürü arasında denge sağlamak için, entropi düzenlileştirmesi kullanacak şekilde PPO’yu değiştirmek de mümkündür. Bu, amaç fonksiyonuna bir entropi terimi (politikanın entropisi ile bir ölçeklendirme parametresinin çarpımı) eklenerek yapılır.
Güncel gelişmeler
Politika gradyanları, RL problemlerini çözmek için kullanılan en eski yaklaşımlardandır. Hızlı GPU’ların ortaya çıkmasından sonra, modern ML tekniklerinin politika gradyanlarına uygulanması için çeşitli yeni yaklaşımlar önerilmiştir.
Gradyan Artırmalı Pekiştirmeli Öğrenme
Son yıllarda, gradyan artırma gibi yöntemlerin RL algoritmalarına uygulanmasında ilerleme kaydedilmiştir. Gradyan artırma, birden çok zayıf modelin tahminlerini birleştirerek tek bir güçlü model üretir. Buna Gradyan Artırmalı Pekiştirmeli Öğrenme (GBRL) denir. GBRL, bu teknikleri RL algoritmaları için uygulayan, XGBoost’a benzer bir Python paketidir.
Aktarım Pekiştirmeli Öğrenme
Aktarım öğrenmesi (TL), bir modelin edindiği bilginin başka bir modelin performansını iyileştirmek için uygulandığı bir tekniktir. Aktarım öğrenmesi, sıfırdan ML modeli eğitmenin maliyetli olması nedeniyle faydalıdır. TL yaklaşımları politika gradyanlarıyla birlikte kullanılarak RL modellerinin performansı iyileştirilmiştir. Bu yaklaşıma Aktarım Pekiştirmeli Öğrenme (TRL) denir.
Sonuç
Politika gradyanları, RL problemlerini çözmenin en temel yaklaşımları arasındadır.
Bu yazıda, politika gradyanlarının birinci ilkelerini sunduk ve politika gradyanı teoremini nasıl türeteceğimizi gösterdik. Ayrıca, Gymnasium ortamında PyTorch kullanarak gradyan tabanlı basit bir algoritmanın nasıl uygulanacağını da gösterdik. Son olarak, pratik zorlukları ve temel politika gradyanı algoritmasının yaygın genişletmelerini tartıştık.
Pekiştirmeli öğrenme ve PyTorch ile derin öğrenme konusundaki bilginizi derinleştirmek isterseniz, şu kurslara göz atın:
- Pekiştirmeli Öğrenme Yolu – Değer tabanlı yöntemlerden politika optimizasyon tekniklerine kadar RL’in temellerini öğrenin.
- PyTorch ile Derin Öğrenmeye Giriş – PyTorch ile uygulamalı deneyim kazanın ve sıfırdan derin öğrenme modelleri oluşturun.






Pekiştirmeli öğrenmede (RL) politika gradyanları, beklenen ödülün politika parametrelerine göre gradyanını tahmin ederek ajanın politikasını doğrudan optimize eden bir algoritma sınıfıdır.
Bu eğitimde, politika gradyanı teoremini ve türetimini açıklıyor ve PyTorch kullanarak politika gradyanı algoritmasının nasıl uygulanacağını gösteriyoruz.
Politika Gradyanı Teoremi Nedir?
Pekiştirmeli öğrenmede, ajanın politikası, çevreye ilişkin gözlemlerine dayanarak hangi eylemi seçeceğine karar vermek için kullandığı algoritmayı ifade eder. RL problemlerindeki amaç, ajanın çevreyle etkileşiminden elde ettiği ödülleri en üst düzeye çıkarmaktır. Maksimum ödüllerle sonuçlanan politika, en iyi (optimal) politikadır.
Getirileri en üst düzeye çıkarmak için kullanılan iki geniş algoritma sınıfı politika tabanlı yöntemler ve değer tabanlı yöntemlerdir:
Politika gradyanı teoremine göre, beklenen getirinin türevi, getiri ile politikanın logaritmasının türevinin (genellikle bir olasılık dağılımı olarak ifade edilir) çarpımının beklentisidir.
Bir politika genellikle parametrik bir fonksiyon olarak modellenir. Politika bir sinir ağıyla modellendiğinde, politika parametreleri ağın ağırlıklarına karşılık gelir. Dolayısıyla, beklenen getirinin (kümülatif ödüllerin) politika parametrelerine göre gradyanını hesaplamak, performansı iyileştirmek üzere politikanın güncellenmesine yol açar. Bu gradyan, beklenen getiriyi artıran yönde politika parametrelerini yinelemeli olarak güncellemek için kullanılabilir. Eğitim, beklenen getiriyi maksimize eden optimal politikada yakınsamalıdır.
İlerleyen bölümlerde bu teoremi ayrıntılı olarak açıklayıp nasıl türetileceğini gösteriyoruz.