

Waarom policy-gradientmethoden gebruiken?
Een belangrijk voordeel van policy-gradientmethoden is dat ze complexe actieruimtes aankunnen, waar traditionele waardegebaseerde benaderingen moeite mee hebben.
Omgaan met hoogdimensionale actieruimtes
Waardegebaseerde methoden, zoals Q-learning, werken door de waardefunctie voor alle mogelijke acties te schatten. Dit wordt lastig wanneer de actieruimte van de omgeving continu is of discreet maar groot.
Policy-gradientmethoden parametriseren de policy en schatten de gradiënt van de cumulatieve beloningen ten opzichte van de policyparameters. Ze gebruiken deze gradiënt om de policy direct te optimaliseren door de parameters bij te werken. Daardoor kunnen ze efficiënt omgaan met hoogdimensionale of continue actieruimtes. Policy-gradients vormen ook de basis van Reinforcement Learning using Human Feedback (RLHF)-methoden.
Door de policy te parametriseren en de parameters op basis van gradiënten aan te passen, kunnen policy-gradients continu en hoogdimensionaal gedrag efficiënt aan. Deze directe aanpak zorgt voor betere generalisatie en flexibelere exploratie, waardoor ze goed passen bij taken als robotbesturing en andere complexe omgevingen.
Stochastische policies leren
Gegeven een set observaties:
- Een deterministische policy specificeert welke actie de agent neemt.
- Een stochastische policy geeft een set acties en de kans dat de agent elke actie kiest.
Bij het volgen van een stochastische policy kan dezelfde observatie in verschillende iteraties tot verschillende acties leiden. Dit bevordert de exploratie van de actieruimte en voorkomt dat de policy vastloopt in lokale optima. Daarom zijn stochastische policies nuttig in omgevingen waar verkennen essentieel is om het pad naar maximale opbrengst te vinden.
Bij policy-gebaseerde methoden wordt de policy-uitvoer omgezet in een kansverdeling, waarbij aan elke mogelijke actie een kans wordt toegekend. De agent kiest een actie door uit deze verdeling te sampelen, wat het mogelijk maakt een stochastische policy te implementeren. Zo combineren policy-gradientmethoden exploratie met exploitatie, wat nuttig is in omgevingen met complexe beloningsstructuren.
Afleiding van de Policy Gradient Theorem
Voordat we in de afleiding duiken, is het belangrijk de wiskundige notatie en kernconcepten vast te leggen die in het bewijs worden gebruikt.
Wiskundige notatie en preliminaire begrippen
Zoals in een eerdere sectie vermeld, stelt het policy gradient-theorema dat de afgeleide van de verwachte opbrengst gelijk is aan de verwachting van het product van de opbrengst en de afgeleide van het logaritme van de policy.
Voordat we het policy gradient-theorema afleiden, introduceren we de notatie:
- E[X] verwijst naar de kansverwachting van een toevalsvariabele X.
- Wiskundig wordt de policy uitgedrukt als een waarschijnlijkheidsmatrix die de kans geeft om verschillende acties te kiezen op basis van verschillende observaties. Een policy wordt doorgaans gemodelleerd als een geparametriseerde functie, met de parameters weergegeven als θ.
- πθ verwijst naar een policy geparametriseerd door θ. In de praktijk zijn dit de gewichten van het neurale netwerk dat de policy modelleert.
- De trajectorie, τ, verwijst naar een reeks toestanden, doorgaans beginnend bij een gerandomiseerde initiële toestand tot aan de huidige tijdstap of de terminale toestand.
- ∇θf verwijst naar de gradiënt van een functie f ten opzichte van parameter(s) θ.
- J(πθ) verwijst naar de verwachte opbrengst die de agent behaalt door de policy πθ te volgen. Dit is ook de doelstellingsfunctie voor gradiëntstijging.
- De omgeving geeft bij elke tijdstap een beloning, afhankelijk van de actie van de agent. De opbrengst verwijst naar de cumulatieve beloningen van de initiële toestand tot de huidige tijdstap.
- R(τ) verwijst naar de opbrengst die over de trajectorie τ wordt gegenereerd.
Afleidingsstappen
We laten zien hoe je het policy gradient-theorema afleidt en bewijst vanuit eerste principes, te beginnen met het uitschrijven van de doelstellingsfunctie en gebruikmakend van de log-derivatie-truc.
De doelstellingsfunctie (Vergelijking 1)
De doelstellingsfunctie in de policy-gradientmethode is de opbrengst
J die wordt opgebouwd door de trajectorie te volgen op basis van de policy π uitgedrukt in termen van parameters θ. Deze doelstellingsfunctie wordt gegeven als:
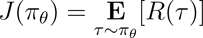
In de bovenstaande vergelijking:
- De linkerkant (LHS) is de verwachte opbrengst die wordt behaald door de policy πθ.
- De rechterkant (RHS) is de verwachting (over de trajectorie τ gegenereerd door in elke stap de policy πθ te volgen) van de opbrengsten R(τ) die over de trajectorie τ worden gegenereerd.
Het differentiaal van de doelstellingsfunctie (Vergelijking 2)
Differentieëren (ten opzichte van θ) van beide kanten van de bovenstaande vergelijking geeft:
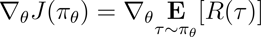
De gradiënt van de verwachting (Vergelijking 3)
De verwachting (aan de RHS) kan worden uitgedrukt als een integraal over het product van:
- De kans op het volgen van een trajectorie τ
- De opbrengsten die over de trajectorie τ
Dus kan de RHS van Vergelijking 2 worden herschreven als:
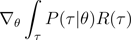
De gradiënt van een integraal is gelijk aan de integraal van de gradiënt. Dus in de bovenstaande uitdrukking kunnen we de gradiënt ∇θ onder het integraalteken brengen. De RHS wordt dan:
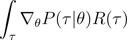
Zo kan Vergelijking 2 worden herschreven als:
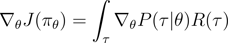
De kans op de trajectorie (Vergelijking 4)
We kijken nu nader naar P(τ|θ), de kans dat de agent de trajectorie τ volgt gegeven de policyparameters θ (en dus policy πθ). Een trajectorie bestaat uit een set stappen. Dus:
- De kans op het verkrijgen van trajectorie τ is het product van:
- De kans op het volgen van alle individuele stappen.
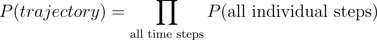
- In tijdstap t gaat de agent van toestand s naar toestand st+1 door actie at te volgen. De kans hierop is het product van:
- De kans dat de policy actie at voorspelt in toestand st
- De kans om in toestand st+1 te eindigen gegeven actie at en toestand st
Dus, beginnend bij een initiële toestand s0, is de kans dat de agent trajectorie τ volgt op basis van policy πθ gegeven als:
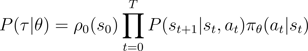
Om het eenvoudiger te maken willen we het product in de RHS hierboven als een som uitdrukken. Daarom nemen we aan beide kanten van de bovenstaande vergelijking de logaritme:
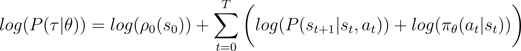
De afgeleide van de log-kans (Vergelijking 5)
We nemen nu de afgeleide (ten opzichte van θ) van de log-kans in de bovenstaande vergelijking.
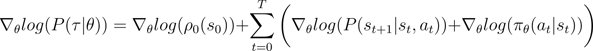
Aan de RHS van de bovenstaande vergelijking:
- De eerste term log ρ0(s0) is constant ten opzichte van θ. Dus is de afgeleide 0.
- De eerste term binnen de som P(st+1|st, at) is ook onafhankelijk van θ en de afgeleide ten opzichte van θ is ook 0.
Door de bovenstaande nul-termen uit de vergelijking te verwijderen, houden we over (Vergelijking 5):
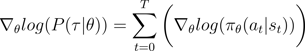
Herinner je uit Vergelijking 2 dat:
Vergelijking 5 evalueert de log van het eerste deel van de rechterkant van Vergelijking 2. We moeten de afgeleide van een term relateren aan de logaritme ervan. Dat doen we met de kettingregel en de log-afgeleide-truc.
De log-afgeleide-truc
We maken een zijsprong en gebruiken rekenregels om een resultaat af te leiden, dat we vervolgens gebruiken om de vorige vergelijking te vereenvoudigen en geschikt te maken voor computationele methoden.
In de analyse kan de afgeleide van een logaritme worden uitgedrukt als:
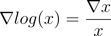
Door de bovenstaande vergelijking te herschikken, kan de afgeleide van x worden uitgedrukt in termen van de afgeleide van de logaritme van x:
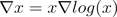
Dit wordt soms de log-afgeleide-truc genoemd.
De kettingregel
Volgens de kettingregel, gegeven z(y) als functie van y, waarbij y zelf een functie is van θ, y(θ), wordt de afgeleide van z ten opzichte van θ gegeven door:

In dit geval staat y(θ) voor P(θ) en z(y) voor log(y). Dus,
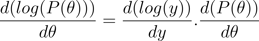
De kettingregel toepassen
We weten uit de analyse dat d(log(y)) / dy = 1/y. Gebruik dit in de eerste expressie van de rechterkant hierboven.
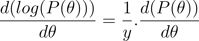
Verplaats y naar de linkerkant en gebruik de notatie:
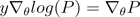
y staat voor P(θ). Dus is de bovenstaande vergelijking equivalent aan:

De log-afgeleide-truc toepassen
Het bovenstaande resultaat geeft de eerste expressie van de rechterkant van Vergelijking 2 (hieronder weergegeven).
Door het resultaat te gebruiken in de rechterkant van Vergelijking 2, krijgen we:
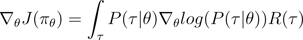
We herschikken de termen onder het integraalteken aan de rechterkant als volgt:
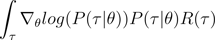
Het eindresultaat afleiden
Merk op dat de bovenstaande expressie de integraalvorm van een verwachting bevat: ∫P(θ)∇logP(θ) = E[∇logP(θ)]
Dus kan de rechterkant hierboven worden uitgedrukt als de verwachting:
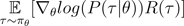
We vullen de afgeleide van de logkans in in de expressie van de verwachte beloning:

Vervang in de bovenstaande vergelijking de waarde van ∇logP(θ) uit Vergelijking 5 om te krijgen:
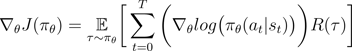
Dit is de expressie voor de gradiënt van de beloningsfunctie volgens het policy gradient-theorema.
De intuïtie achter de policy gradient
Policy gradient-methoden zetten de output van de policy om in een kansverdeling. De agent bemonstert deze verdeling om een actie te kiezen. Policy gradient-methoden passen de parameters van de policy aan. Dit leidt ertoe dat deze kansverdeling in elke iteratie wordt bijgewerkt. De bijgewerkte kansverdeling heeft een grotere kans om acties te kiezen die tot hogere beloningen leiden.
Het policy gradient-algoritme berekent de gradiënt van de verwachte opbrengst ten opzichte van de policy-parameters. Door de policy-parameters in de richting van deze gradiënt te verplaatsen, vergroot de agent de kans om tijdens training acties te kiezen die tot hogere beloningen leiden.
Kort gezegd: acties die tot betere uitkomsten leidden, worden in de toekomst waarschijnlijker gekozen, waardoor de policy geleidelijk verbetert om langetermijnbeloningen te maximaliseren.
Policy Gradients implementeren in Python
Nu we de basisprincipes van policy gradients hebben besproken, laten we zien hoe je ze implementeert met PyTorch en Gymnasium.
De omgeving instellen
Als eerste stap moeten we gymnasium en een paar ondersteunende bibliotheken zoals NumPy en PyTorch installeren.
Om gymnasium en de afhankelijkheden op een server of lokale machine te installeren, voer je uit:
$ pip install gymnasium Om te installeren in een Notebook zoals Google Colab of DataLab, gebruik je:
!pip install gymnasiumJe importeert deze pakketten binnen de Python-omgeving:
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
import torch.distributions as distributions
import numpy as np
import gymnasium as gym Een eenvoudige policy gradient-agent coderen
Maak een instantie van de omgeving met de .make()-methode.
env = gym.make('CartPole-v1')Zoals bij andere machine learning-methoden gebruiken we een neuraal netwerk om de policy gradient-agent te implementeren.
CartPole-v1 is een eenvoudige omgeving, dus ontwerpen we een simpel netwerk met 1 verborgen laag met 64 neuronen. De dimensie van de invoerlaag is gelijk aan de dimensies van de observatieruimte. De dimensie van de uitvoerlaag is gelijk aan de grootte van de actieruimte van de omgeving. De policy-netwerkkaart zet dus geobserveerde toestanden om naar acties. Gegeven een observatie als invoer, geeft het netwerk de voorspelde actie volgens de policy terug.
De onderstaande code implementeert het policy-netwerk:
class PolicyNetwork(nn.Module):
def __init__(self, input_dim, hidden_dim, output_dim, dropout):
super().__init__()
self.layer1 = nn.Linear(input_dim, hidden_dim)
self.layer2 = nn.Linear(hidden_dim, output_dim)
self.dropout = nn.Dropout(dropout)
def forward(self, x):
x = self.layer1(x)
x = self.dropout(x)
x = F.relu(x)
x = self.layer2(x)
return xDe agent trainen
De omgeving geeft in elke timestep een beloning afhankelijk van de toestand en actie van de agent. De policy gradient-aanpak bestaat uit het uitvoeren van gradient descent op de cumulatieve beloningen (return). Het doel is de totale return te maximaliseren.
Om de return in een episode te berekenen, tel je (met een discontovoet) de beloningen van alle timesteps in die episode op. Daarnaast is het nuttig de returns te normaliseren om een soepele en stabiele training te waarborgen. De onderstaande code laat zien hoe je dit doet:
def calculate_stepwise_returns(rewards, discount_factor):
returns = []
R = 0
for r in reversed(rewards):
R = r + R * discount_factor
returns.insert(0, R)
returns = torch.tensor(returns)
normalized_returns = (returns - returns.mean()) / returns.std()
return normalized_returnsIn elke iteratie van de forward pass doen we het volgende:
- Voer de agent uit op basis van de huidige policy met de
.step()-functie. De policy voorspelt in elke timestep de kans om de gekozen actie te nemen. - Ontvang de beloning van de omgeving op basis van de actie van de agent.
- Verzamel stapsgewijze beloningen en de logkansen van de acties totdat de agent een terminale toestand bereikt.
De onderstaande code implementeert de forward pass:
def forward_pass(env, policy, discount_factor):
log_prob_actions = []
rewards = []
done = False
episode_return = 0
policy.train()
observation, info = env.reset()
while not done:
observation = torch.FloatTensor(observation).unsqueeze(0)
action_pred = policy(observation)
action_prob = F.softmax(action_pred, dim = -1)
dist = distributions.Categorical(action_prob)
action = dist.sample()
log_prob_action = dist.log_prob(action)
observation, reward, terminated, truncated, info = env.step(action.item())
done = terminated or truncated
log_prob_actions.append(log_prob_action)
rewards.append(reward)
episode_return += reward
log_prob_actions = torch.cat(log_prob_actions)
stepwise_returns = calculate_stepwise_returns(rewards, discount_factor)
return episode_return, stepwise_returns, log_prob_actionsBackpropagation en gradient ascent gebruiken om de policy bij te werken
In traditionele machine learning:
- Verwijst loss naar het verschil tussen de voorspelde en de werkelijke output.
- We minimaliseren de loss met gradient descent.
In RL:
- Is de loss een proxy voor de grootheid waarop gradient descent (of ascent) wordt toegepast.
- We maximaliseren de return (cumulatieve beloningen) met gradient ascent.
- De verwachte return wordt gebruikt als proxy voor de loss voor gradient descent. De verwachte return is het product van:
- De returns die in elke stap worden verwacht met
- De kans om in elke stap de bemonsterde actie te kiezen.
- Om gradient ascent met backpropagation toe te passen, gebruiken we het negatieve van de loss.
De onderstaande code berekent de loss:
def calculate_loss(stepwise_returns, log_prob_actions):
loss = -(stepwise_returns * log_prob_actions).sum()
return lossVergelijkbaar met standaard machine learning-algoritmen voer je backpropagation uit ten opzichte van de verliesfunctie om de policy bij te werken. De methode update_policy() hieronder roept de methode calculate_loss() aan. Vervolgens voert hij backpropagation uit op deze loss om de policy-parameters, d.w.z. de modelgewichten van het policy-netwerk, bij te werken.
def update_policy(stepwise_returns, log_prob_actions, optimizer):
stepwise_returns = stepwise_returns.detach()
loss = calculate_loss(stepwise_returns, log_prob_actions)
optimizer.zero_grad()
loss.backward()
optimizer.step()
return loss.item()De trainingslus
We gebruiken de eerder gedefinieerde functies om de policy te trainen. Voor we met trainen beginnen, hebben we nodig:
- Een ongetrainde policy, geïnitialiseerd als een gerandomiseerde instantie van de PolicyNetwork-klasse.
- Een optimizer die het Adam-algoritme gebruikt.
- Hyperparameters voor de discontovoet, leersnelheid, dropoutpercentage, beloningsdrempel en het maximale aantal trainingsepochs.
We herhalen de trainingslus totdat de gemiddelde return de beloningsdrempel overschrijdt. In elke iteratie voeren we de volgende stappen uit:
- Voor elke episode voer je eenmaal de forward pass uit. Verzamel de logkans van acties, de stapsgewijze returns en de totale return van die episode. Stapel de episodische returns in een array.
- Bereken de loss met de logkansen en de stapsgewijze returns. Voer backpropagation uit op de loss. Gebruik de optimizer om de policy-parameters bij te werken.
- Controleer of de gemiddelde return over
N_TRIALSde beloningsdrempel overschrijdt.
De onderstaande code implementeert deze stappen:
def main():
MAX_EPOCHS = 500
DISCOUNT_FACTOR = 0.99
N_TRIALS = 25
REWARD_THRESHOLD = 475
PRINT_INTERVAL = 10
INPUT_DIM = env.observation_space.shape[0]
HIDDEN_DIM = 128
OUTPUT_DIM = env.action_space.n
DROPOUT = 0.5
episode_returns = []
policy = PolicyNetwork(INPUT_DIM, HIDDEN_DIM, OUTPUT_DIM, DROPOUT)
LEARNING_RATE = 0.01
optimizer = optim.Adam(policy.parameters(), lr = LEARNING_RATE)
for episode in range(1, MAX_EPOCHS+1):
episode_return, stepwise_returns, log_prob_actions = forward_pass(env, policy, DISCOUNT_FACTOR)
_ = update_policy(stepwise_returns, log_prob_actions, optimizer)
episode_returns.append(episode_return)
mean_episode_return = np.mean(episode_returns[-N_TRIALS:])
if episode % PRINT_INTERVAL == 0:
print(f'| Episode: {episode:3} | Mean Rewards: {mean_episode_return:5.1f} |')
if mean_episode_return >= REWARD_THRESHOLD:
print(f'Reached reward threshold in {episode} episodes')
breakVoer het trainingsprogramma uit door de functie main() aan te roepen:
main()Deze DataLab-workbook bevat de bovenstaande implementatie van het policy gradient-algoritme. Je kunt het direct uitvoeren of gebruiken als startpunt om het algoritme aan te passen.
Voordelen en uitdagingen van policy gradient-methoden
Policy gradient-methoden bieden verschillende voordelen, zoals:
- Omgaan met continue actieruimtes: Waardegestuurde methoden (zoals Q-learning) zijn inefficiënt bij continue actieruimtes omdat ze waarden over de hele actieruimte moeten schatten. Policy gradient-methoden kunnen het beleid direct optimaliseren met de gradiënt van de verwachte opbrengst. Deze aanpak werkt goed met continue actieverdelingen. Daardoor zijn policy gradient-methoden geschikt voor taken zoals robotbesturing die op continue actieruimtes zijn gebaseerd.
- Stochastische beleidsfuncties: Policy gradient-methoden kunnen stochastische beleidsfuncties leren — die voor elke mogelijke actie een kans toekennen. Dit stelt de agent in staat een verscheidenheid aan acties te proberen en verkleint de kans om vast te lopen in lokale optima. Het helpt in complexe omgevingen waar de agent de actieruimte moet verkennen om het optimale beleid te vinden. Het stochastische karakter helpt de balans te bewaren tussen exploratie (nieuwe acties proberen) en exploitatie (de best bekende acties kiezen), wat cruciaal is voor omgevingen met onzekerheid of schaarse beloningen.
- Directe beleidoptimalisatie: Policy gradients optimaliseren het beleid direct in plaats van via waardefuncties. In continue of hoog-dimensionale actieruimtes kan het benaderen van waarden voor iedere actie computationeel duur worden. Daarom presteren beleidsgestuurde methoden goed in zulke omgevingen.
Ondanks hun vele voordelen hebben policy gradient-methoden enkele inherente uitdagingen:
- Hoge variantie in gradiëntschattingen: Policy gradient-methoden kiezen acties door te sampelen uit een kansverdeling. Feitelijk sampelen ze de trajecten om de verwachte opbrengst te schatten. Omdat het sampleproces inherent willekeurig is, kunnen de geschatte opbrengsten tussen opeenvolgende iteraties een hoge variantie hebben. Dit kan het moeilijk maken voor de agent om efficiënt te leren, omdat de updates van het beleid aanzienlijk kunnen fluctueren tussen iteraties.
- Instabiliteit tijdens training:
- Policy gradient-methoden zijn gevoelig voor hyperparameters zoals de leersnelheid. Als de leersnelheid te hoog is, kunnen de updates van de beleidsparameters te groot zijn, waardoor de training de optimale parameters mist. Is de leersnelheid te laag, dan verloopt de convergentie traag.
- Policy gradient-methoden moeten balans vinden tussen exploratie en exploitatie. Als de agent niet genoeg verkent, bereikt hij mogelijk niet de buurt van het optimale beleid. Verkent hij daarentegen te veel, dan convergeert hij niet naar het optimale beleid en blijft hij rond de actieruimte oscilleren.
- Sample-inefficiëntie: Policy gradient-methoden schatten de opbrengst door elk beleid te volgen tot terminatie en de beloningen per stap te accumuleren. Ze hebben dus veel interacties met de omgeving nodig om een groot aantal trajecten te sampelen. Dit is inefficiënt en kostbaar voor omgevingen met grote toestands- of actieruimtes.
Oplossingen voor stabiliteit
Omdat instabiliteit een relatief veelvoorkomend probleem is bij policy gradient-methoden, hebben ontwikkelaars diverse oplossingen toegepast om het trainingsproces te stabiliseren. Hieronder bespreken we gangbare oplossingen om training met policy gradients te stabiliseren:
Gebruik van baseline-functies
Door inefficiënt sampelen kunnen de gradiënten van de opbrengsten die tijdens de trainingsiteraties worden geschat een hoge variantie hebben, wat de training onstabiel en traag maakt. Een veelgebruikte aanpak om de variantie te verkleinen is het gebruik van baseline-functies, zoals de Advantage Actor-Critic (A2C)-methode. Het idee is om een proxy (de advantage-functie) te gebruiken in plaats van de geschatte opbrengst voor de doelfunctie.
De advantage wordt berekend als het verschil tussen de daadwerkelijke opbrengst uit het gesampelde traject en de verwachte opbrengst gegeven de initiële toestand. Deze aanpak gebruikt de waardefunctie als de verwachte waarde van toestanden en toestand-actieparen. Door het verlies uit te drukken als het verschil tussen de daadwerkelijke en de verwachte opbrengst in plaats van enkel de opbrengsten, vermindert A2C de variantie in de verliesfunctie en daarmee in de gradiënten, wat de training stabieler maakt.
Gebruik van entropieregularisatie
In bepaalde omgevingen, zoals die met schaarse beloningen (slechts heel weinig toestanden geven een beloning), wordt het beleid al snel deterministisch. Het wordt ook hebzuchtig en exploiteert de paden die al zijn verkend. Dit belemmert verdere exploratie en leidt vaak tot convergentie naar lokale optima en suboptimale beleidsfuncties.
De oplossing is om exploratie te stimuleren door het beleid te straffen wanneer het te deterministisch wordt. Dit gebeurt door een entropiegebaseerde term toe te voegen aan de doelfunctie. De entropie meet de hoeveelheid willekeur in het beleid. Hoe groter de entropie, hoe meer willekeur in de acties die de agent kiest. Deze entropieterm is het product van de entropiecoëfficiënt en de entropie van het huidige beleid.
Door entropie op te nemen in de doelfunctie wordt een balans bereikt tussen exploitatie en exploratie.
Uitbreidingen van policy gradients
Onder de verschillende uitbreidingen van policy gradient-methoden is een van de meest fundamentele het REINFORCE-algoritme. Het biedt een rechttoe-rechtaan implementatie van de policy gradient-stelling en vormt de basis voor geavanceerdere technieken.
REINFORCE-algoritme
Het REINFORCE-algoritme, ook wel Monte Carlo Reinforce genoemd, is een van de basisimplementaties van de policy gradient-stelling. Het gebruikt Monte Carlo-methoden om opbrengsten en policy gradients te schatten. Bij het volgen van het REINFORCE-algoritme sampelt de agent direct alle acties (van de initiële tot de terminale toestand) uit de omgeving. Dit staat in contrast met methoden als TD-Learning en Dynamic Programming, die hun acties baseren op schattingen van waardefuncties.
Hieronder staan de basisstappen van het REINFORCE-algoritme:
- Initialiseer het beleid met willekeurige parameters
- Herhaal meerdere trainingsafleveringen. Voor elke aflevering:
- Genereer elke stap van de volledige aflevering als volgt:
- Geef de toestand door aan de beleidsfunctie.
- De beleidsfunctie genereert kansen voor elke mogelijke actie.
- Sample willekeurig een actie uit deze kansverdeling.
- Schat voor elke toestand in de aflevering de opbrengst (gedisconteerde cumulatieve beloningen) tot stap t.
- Schat de gradiënt van de doelfunctie (volgens de policy gradient-stelling), uitgedrukt als het product van de stapgewijze opbrengsten en de actiekansen per stap.
- Werk de beleidsparameters bij door de gradiënten toe te passen
Voor elk beleid kun je één enkel traject sampelen om de gradiënt te schatten (zoals hierboven getoond) of de gradiënt middelen over meerdere trajecten die onder hetzelfde beleid zijn gesampeld.
Actor-critic-methoden
Actor-critic-methoden combineren policy gradient-methoden (zoals REINFORCE) met waardefuncties.
- De actor werkt vergelijkbaar met policy gradient-methoden. De actor implementeert het beleid en selecteert bij elke stap acties op basis van het beleid. Hij werkt het beleid bij door de gradiënt van de verwachte opbrengst te volgen.
- De critic implementeert de waardefunctie, die wordt gebruikt als baseline (besproken in de vorige sectie). Dit helpt de training efficiënter en stabieler te maken.
Policy gradient-methoden zoals REINFORCE schatten de gradiënten langs elk traject met de ruwe opbrengst. Omdat deze trajecten door een sampleproces worden getrokken, kan dit leiden tot grote varianties in de opbrengsten en gradiënten. Het gebruik van een advantage-functie in plaats van de ruwe opbrengsten lost dit probleem op. De advantage-functie is het verschil tussen de werkelijke en de verwachte opbrengst (d.w.z. de waardefunctie). Actor-critic-methoden vormen een klasse algoritmen. Wanneer de critic wordt geïmplementeerd met de advantage-functie (de meest gangbare aanpak), heet dit ook Advantage actor-critic (A2C).
Proximal Policy Optimization (PPO)
In complexe omgevingen volstaat een actor-critic-methode als A2C alleen niet om de variantie in de opbrengsten en gradiënten te beheersen. In zulke gevallen helpt het om kunstmatig te beperken hoeveel het beleid per iteratie mag veranderen. Dit dwingt het geüpdatete beleid (na gradiëntstijging) in de buurt te blijven van het oude beleid.
Methoden zoals Proximal Policy Optimization brengen twee wijzigingen aan in policy gradients:
- Gebruik een advantage-functie. Doorgaans gebruikt deze advantage-functie de waardefunctie als baseline. Hiermee lijken ze op A2C-methoden.
- Beperk hoeveel de beleidsparameters per iteratie mogen veranderen. Dit gebeurt met een afgesneden surrogaatdoelfunctie. Het algoritme specificeert een bereik waarbinnen de verhouding van het nieuwe beleid tot het oude beleid moet liggen. Wanneer de verhouding (na gradiëntupdate) deze vooraf bepaalde waarden overschrijdt, wordt deze afgeknipt zodat hij binnen het bereik blijft.
Zo verbetert PPO de eenvoudige policy gradient-methoden aanzienlijk, wat de stabiliteit in complexe omgevingen vergroot. De afgesneden doelfunctie voorkomt dat grote varianties in opbrengsten en gradiënten de beleidsupdates destabiliseren. Om de balans tussen exploratie en exploitatie te bereiken, is het ook mogelijk PPO aan te passen met entropieregularisatie. Dit gebeurt door een entropieterm (een schaalparameter vermenigvuldigd met de entropie van het beleid) toe te voegen aan de doelfunctie.
Recente vooruitgang
Policy gradients behoren tot de vroegste methoden die zijn gebruikt om RL-problemen op te lossen. Na de opkomst van snelle GPU's zijn er diverse nieuwe benaderingen voorgesteld om moderne ML-technieken toe te passen op policy gradients.
Gradient-Boosted Reinforcement Learning
De afgelopen jaren is vooruitgang geboekt met het toepassen van methoden zoals gradient boosting op RL-algoritmen. Gradient boosting combineert de voorspellingen van meerdere zwakke modellen tot één sterk model. Dit staat bekend als Gradient-Boosted Reinforcement Learning (GBRL). GBRL is een Python-pakket, vergelijkbaar met XGBoost, dat deze technieken voor RL-algoritmen implementeert.
Transfer Reinforcement Learning
Transfer learning (TL) is een techniek waarbij de kennis die door het ene model is opgedaan, wordt toegepast om de prestaties van een ander model te verbeteren. Transfer learning is nuttig omdat het trainen van ML-modellen vanaf nul kostbaar is. TL-benaderingen zijn gebruikt met policy gradients om de prestaties van RL-modellen te verbeteren. Deze aanpak heet Transfer Reinforcement Learning (TRL).
Conclusie
Policy gradients behoren tot de meest fundamentele benaderingen om RL-problemen op te lossen.
In dit artikel hebben we de eerste principes van policy gradients behandeld en laten zien hoe je de policy gradient-stelling kunt afleiden. We hebben ook gedemonstreerd hoe je een eenvoudig gradiëntgebaseerd algoritme implementeert met PyTorch in een Gymnasium-omgeving. Tot slot bespraken we praktische uitdagingen en veelvoorkomende uitbreidingen op het basispolicy gradient-algoritme.
Wil je je begrip van reinforcement learning en deep learning met PyTorch verdiepen? Bekijk dan deze cursussen:
- Reinforcement Learning Track – Leer de basis van RL, van waardegestuurde methoden tot beleidoptimalisatietechnieken.
- Introduction to Deep Learning with PyTorch – Doe praktijkervaring op met PyTorch en bouw deep learning-modellen vanaf nul.

Policy gradients in reinforcement learning (RL) zijn een klasse algoritmen die het beleid (policy) van de agent direct optimaliseren door de gradiënt te schatten van de verwachte beloning ten opzichte van de policyparameters.
In deze tutorial leggen we de policy gradient-stelling en de afleiding ervan uit en laten we zien hoe je het policy gradient-algoritme implementeert met PyTorch.
Wat is de Policy Gradient-stelling?
In reinforcement learning verwijst het beleid (policy) van de agent naar het algoritme dat het gebruikt om op basis van observaties van de omgeving een actie te kiezen. Het doel in RL-problemen is om de beloningen te maximaliseren die de agent verdient door interactie met de omgeving. Het beleid dat tot de maximale beloningen leidt, is het optimale beleid.
De twee brede klassen van algoritmen die worden gebruikt om de opbrengst te maximaliseren zijn policy-gebaseerde methoden en value-gebaseerde methoden:
Volgens de policy gradient-stelling is de afgeleide van de verwachte opbrengst de verwachting van het product van de opbrengst en de afgeleide van het logaritme van het beleid (meestal uitgedrukt als een kansverdeling).
Een beleid wordt doorgaans gemodelleerd als een geparametriseerde functie. Wanneer het beleid als een neuraal netwerk wordt gemodelleerd, verwijzen de policyparameters naar de netwerkgewichten. Het berekenen van de gradiënt van de verwachte opbrengst (cumulatieve beloningen) ten opzichte van de policyparameters leidt dus tot het updaten van het beleid om de prestaties te verbeteren. Deze gradiënt kan worden gebruikt om de policyparameters iteratief bij te werken in de richting die de verwachte opbrengst verhoogt. De training zou moeten convergeren naar het optimale beleid dat de verwachte opbrengst maximaliseert.
In latere secties leggen we deze stelling in detail uit en laten we zien hoe je haar afleidt.