

Perché usare i metodi di Policy Gradient?
Un vantaggio chiave dei metodi di policy gradient è la capacità di gestire spazi d’azione complessi, dove gli approcci tradizionali basati su valore faticano.
Gestione di spazi d’azione ad alta dimensionalità
I metodi basati su valore, come il Q-learning, stimano la funzione di valore per tutte le possibili azioni. Questo diventa difficile quando lo spazio d’azione dell’ambiente è continuo o discreto ma ampio.
I metodi di policy gradient parametrizzano la policy e stimano il gradiente delle ricompense cumulative rispetto ai parametri dei della policy. Usano questo gradiente per ottimizzare direttamente la policy aggiornandone i parametri. Per questo riescono a gestire in modo efficiente spazi d’azione continui o ad alta dimensionalità. I policy gradient sono anche alla base dei metodi di Reinforcement Learning con feedback umano (RLHF).
Parametrizzando la policy e regolando i suoi parametri in base ai gradienti, i policy gradient possono gestire in modo efficiente azioni continue e ad alta dimensionalità. Questo approccio diretto consente una migliore generalizzazione e un’esplorazione più flessibile, risultando adatto a compiti come il controllo robotico e altri ambienti complessi.
Apprendimento di policy stocastiche
Dato un insieme di osservazioni:
- Una policy deterministica specifica quale azione intraprende l’agente.
- Una policy stocastica fornisce un insieme di azioni e la probabilità che l’agente scelga ciascuna azione.
Seguendo una policy stocastica, la stessa osservazione può portare a scegliere azioni diverse in iterazioni differenti. Questo favorisce l’esplorazione dello spazio d’azione e impedisce alla policy di bloccarsi in ottimi locali. Per questo, le policy stocastiche sono utili in ambienti in cui l’esplorazione è essenziale per scoprire il percorso che conduce ai ritorni massimi.
Nei metodi basati su policy, l’output della policy è convertito in una distribuzione di probabilità, con a ciascuna azione possibile assegnata una probabilità. L’agente sceglie un’azione campionando da questa distribuzione, rendendo possibile implementare una policy stocastica. Così, i metodi di policy gradient combinano esplorazione ed exploit, utili in ambienti con strutture di ricompensa complesse.
Derivazione del Teorema del Policy Gradient
Prima di entrare nella derivazione, è importante fissare la notazione matematica e i concetti chiave usati nella dimostrazione.
Notazione matematica e preliminari
Come menzionato in una sezione precedente, il teorema del policy gradient afferma che la derivata del ritorno atteso è l’aspettazione del prodotto tra il ritorno e la derivata del logaritmo della policy.
Prima di derivare il teorema del policy gradient, introduciamo la notazione:
- E[X] indica l’aspettazione probabilistica di una variabile aleatoria X.
- Matematicamente, la policy è espressa come una matrice di probabilità che fornisce la probabilità di scegliere azioni diverse in base a osservazioni diverse. Una policy è tipicamente modellata come una funzione parametrica, con i parametri rappresentati da θ.
- πθ indica una policy parametrizzata da θ. In pratica, questi parametri sono i pesi della rete neurale che modella la policy.
- La traiettoria, τ, indica una sequenza di stati, in genere a partire da uno stato iniziale randomizzato fino all’istante di tempo corrente o allo stato terminale.
- ∇θf indica il gradiente di una funzione f rispetto al(i) parametro(i) θ.
- J(πθ) indica il ritorno atteso ottenuto dall’agente seguendo la policy π&theta. È anche la funzione obiettivo per l’ascesa del gradiente.
- L’ambiente fornisce una ricompensa a ogni timestep, a seconda dell’azione dell’agente. Il ritorno indica le ricompense cumulative dallo stato iniziale all’istante di tempo corrente.
- R(τ) indica il ritorno generato sulla traiettoria τ.
Passaggi della derivazione
Mostriamo come derivare e dimostrare il teorema del policy gradient dai primi principi, a partire dall’espansione della funzione obiettivo e usando il trucco della derivata del logaritmo.
La funzione obiettivo (Equazione 1)
La funzione obiettivo nel metodo di policy gradient è il ritorno
J accumulato seguendo la traiettoria basata sulla policy π espressa in termini di parametri θ. Questa funzione obiettivo è data da:
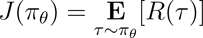
Nell’equazione sopra:
- Il lato sinistro (LHS) è il ritorno atteso ottenuto seguendo la policy πθ.
- Il lato destro (RHS) è l’aspettazione (sulla traiettoria τ generata seguendo la policy πθ a ogni passo) dei ritorni R(τ) generati sulla traiettoria τ.
La derivata della funzione obiettivo (Equazione 2)
Derivando (rispetto a θ) entrambi i membri dell’equazione sopra si ottiene:
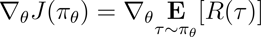
Il gradiente dell’aspettazione (Equazione 3)
L’aspettazione (sul RHS) può essere espressa come un integrale sul prodotto di:
- La probabilità di seguire una traiettoria τ
- I ritorni generati sulla traiettoria τ
Pertanto, il RHS dell’Equazione 2 è riformulato come:
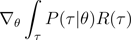
Il gradiente di un integrale è uguale all’integrale del gradiente. Quindi, nell’espressione sopra, possiamo portare il gradiente ∇ sotto il segno di integrale. Quindi, il RHS diventa:
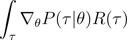
Così, l’Equazione 2 può essere riscritta come:
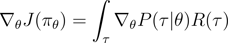
La probabilità della traiettoria (Equazione 4)
Esaminiamo ora più da vicino P(τ|θ), la probabilità che l’agente segua la traiettoria τ dato i parametri della policy θ (e quindi la policy πθ). Una traiettoria è composta da una serie di passi. Quindi:
- La probabilità di ottenere la traiettoria τ è il prodotto di:
- La probabilità di tutti i singoli passi.
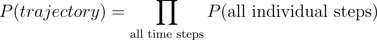
- Al passo temporale t, l’agente passa dallo stato s allo stato st+1 seguendo l’azione at. La probabilità che ciò accada è data dal prodotto di:
- La probabilità che la policy predica l’azione at nello stato st
- La probabilità di finire nello stato st+1 data l’azione at e lo stato st
Quindi, a partire da uno stato iniziale s0, la probabilità che l’agente segua la traiettoria τ in base alla policy πθ è data da:
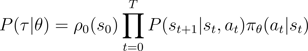
Per semplificare, vogliamo esprimere il prodotto nel RHS sopra come somma. Quindi prendiamo il logaritmo di entrambi i membri dell’equazione:
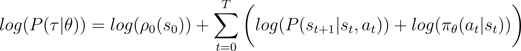
La derivata della log-probabilità (Equazione 5)
Ora prendiamo la derivata (rispetto a θ) della log-probabilità nell’equazione sopra.
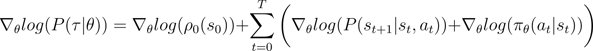
Nel RHS dell’equazione sopra:
- Il primo termine log ρ0(s0) è costante rispetto a θ. Quindi la sua derivata è 0.
- Il primo termine dentro la sommatoria P(st+1|st, at) è anch’esso indipendente da θ e la sua derivata rispetto a θ è anch’essa 0.
Rimuovendo i termini nulli dall’equazione, rimaniamo con (Equazione 5):
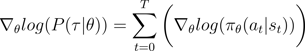
Ricorda dall’Equazione 2 che:
L’Equazione 5 valuta il log della prima parte del RHS dell’Equazione 2. Dobbiamo collegare la derivata di un termine con il suo logaritmo. Lo facciamo usando la regola della catena e il trucco della derivata del logaritmo.
Il trucco della derivata del logaritmo
Facciamo una digressione e usiamo le regole del calcolo per derivare un risultato che useremo per semplificare l’equazione precedente e renderla adatta ai metodi computazionali.
Nel calcolo, la derivata di un logaritmo può essere espressa come:
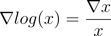
Riordinando l’equazione sopra, la derivata di x può essere espressa in termini della derivata del logaritmo di x:
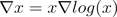
Questo è talvolta chiamato trucco della derivata del logaritmo.
La regola della catena
Secondo la regola della catena, data z(y) come funzione di y, dove y è a sua volta funzione di θ, y(θ), la derivata di z rispetto a θ è data da:

In questo caso, y(θ) sta per P(θ) e z(y) sta per log(y). Quindi,
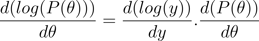
Applicare la regola della catena
Sappiamo dal calcolo che d(log(y)) / dy = 1/y. Usiamolo nella prima espressione del RHS sopra.
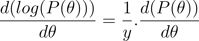
Porta y al LHS e usa la notazione :
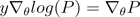
y sta per P(θ). Quindi l’equazione sopra è equivalente a:

Applicare il trucco della derivata del logaritmo
Il risultato sopra fornisce la prima espressione del RHS dell’Equazione 2 (mostrata sotto).
Usando il risultato nel RHS dell’Equazione 2, otteniamo:
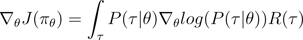
Riorganizziamo i termini sotto l’integrale del RHS come segue:
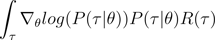
Derivare il risultato finale
Osserva che l’espressione sopra contiene l’espansione integrale di un’aspettazione: ∫P(θ)∇logP(θ) = E[∇logP(θ)]
Pertanto, il RHS sopra può essere espresso come aspettazione:
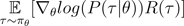
Sostituiamo la derivata della log-probabilità nell’espressione della ricompensa attesa:

Nell’equazione sopra, sostituisci il valore di ∇logP(θ) dall’Equazione 5 per ottenere:
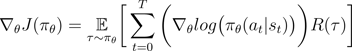
Questa è l’espressione per il gradiente della funzione di ricompensa secondo il teorema del policy gradient.
L’intuizione dietro il policy gradient
I metodi di policy gradient convertono l’output della policy in una distribuzione di probabilità. L’agente campiona questa distribuzione per scegliere un’azione. I metodi di policy gradient regolano i parametri della policy. Questo porta ad aggiornare la distribuzione di probabilità a ogni iterazione. La distribuzione aggiornata ha una probabilità maggiore di scegliere azioni che producono ricompense più alte.
L’algoritmo di policy gradient calcola il gradiente del ritorno atteso rispetto ai parametri della policy. Spostando i parametri della policy nella direzione di questo gradiente, l’agente aumenta la probabilità di scegliere azioni che portano a ricompense maggiori durante l’addestramento.
In sostanza, le azioni che hanno portato a risultati migliori diventano più probabili in futuro, migliorando gradualmente la policy per massimizzare le ricompense a lungo termine.
Implementare i Policy Gradient in Python
Dopo aver discusso i principi fondamentali dei policy gradient, mostriamo come implementarli usando PyTorch e Gymnasium.
Configurare l’ambiente
Come primo passo, dobbiamo installare gymnasium e alcune librerie di supporto come NumPy e PyTorch.
Per installare gymnasium e le sue dipendenze su un server o una macchina locale, esegui:
$ pip install gymnasium Per installare usando un Notebook come Google Colab o DataLab, usa:
!pip install gymnasiumImporta questi pacchetti nell’ambiente Python:
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
import torch.distributions as distributions
import numpy as np
import gymnasium as gym Scrivere un semplice agente di policy gradient
Crea un’istanza dell’ambiente usando il metodo .make().
env = gym.make('CartPole-v1')Come con altri metodi di machine learning, usiamo una rete neurale per implementare l’agente di policy gradient.
CartPole-v1 è un ambiente semplice, quindi progettiamo una rete semplice con 1 livello nascosto da 64 neuroni. La dimensione del livello di input è uguale alle dimensioni dello spazio delle osservazioni. La dimensione del livello di output è uguale alla dimensione dello spazio d’azione dell’ambiente. Quindi, la rete di policy mappa gli stati osservati alle azioni. Data un’osservazione in input, la rete produce l’azione prevista secondo la policy.
Il codice seguente implementa la rete di policy:
class PolicyNetwork(nn.Module):
def __init__(self, input_dim, hidden_dim, output_dim, dropout):
super().__init__()
self.layer1 = nn.Linear(input_dim, hidden_dim)
self.layer2 = nn.Linear(hidden_dim, output_dim)
self.dropout = nn.Dropout(dropout)
def forward(self, x):
x = self.layer1(x)
x = self.dropout(x)
x = F.relu(x)
x = self.layer2(x)
return xAddestrare l’agente
L’ambiente fornisce una ricompensa a ogni timestep a seconda dello stato e dell’azione dell’agente. L’approccio dei policy gradient consiste nell’eseguire la discesa del gradiente sulle ricompense cumulative (ritorno). L’obiettivo è massimizzare il ritorno totale.
Per calcolare il ritorno in un episodio, accumuli (con un fattore di sconto) le ricompense di tutti i timesteps in quell’episodio. Inoltre, normalizzare i ritorni è utile per garantire un addestramento fluido e stabile. Il codice seguente mostra come farlo:
def calculate_stepwise_returns(rewards, discount_factor):
returns = []
R = 0
for r in reversed(rewards):
R = r + R * discount_factor
returns.insert(0, R)
returns = torch.tensor(returns)
normalized_returns = (returns - returns.mean()) / returns.std()
return normalized_returnsA ogni iterazione della forward pass, facciamo i seguenti passaggi:
- Esegui l’agente in base alla policy corrente usando la funzione
.step(). La policy prevede la probabilità di intraprendere l’azione scelta a ogni timestep. - Ricevi la ricompensa dall’ambiente in base all’azione dell’agente.
- Accumula le ricompense passo-passo e le log-probabilità delle azioni finché l’agente non raggiunge uno stato terminale.
Il codice seguente implementa la forward pass:
def forward_pass(env, policy, discount_factor):
log_prob_actions = []
rewards = []
done = False
episode_return = 0
policy.train()
observation, info = env.reset()
while not done:
observation = torch.FloatTensor(observation).unsqueeze(0)
action_pred = policy(observation)
action_prob = F.softmax(action_pred, dim = -1)
dist = distributions.Categorical(action_prob)
action = dist.sample()
log_prob_action = dist.log_prob(action)
observation, reward, terminated, truncated, info = env.step(action.item())
done = terminated or truncated
log_prob_actions.append(log_prob_action)
rewards.append(reward)
episode_return += reward
log_prob_actions = torch.cat(log_prob_actions)
stepwise_returns = calculate_stepwise_returns(rewards, discount_factor)
return episode_return, stepwise_returns, log_prob_actionsUsare backpropagation e ascesa del gradiente per aggiornare la policy
Nel machine learning tradizionale:
- La loss indica la differenza tra output previsto e reale.
- Minimizziamo la loss con la discesa del gradiente.
Nel RL:
- La loss è un proxy per la quantità su cui applicare la discesa (o ascesa) del gradiente.
- Massimizziamo il ritorno (ricompense cumulative) usando l’ascesa del gradiente.
- Il valore del ritorno atteso è usato come proxy per la loss per la discesa del gradiente. Il valore del ritorno atteso è il prodotto di:
- I ritorni attesi da ciascun passo con
- La probabilità di scegliere l’azione campionata a ogni passo.
- Per applicare l’ascesa del gradiente usando la backpropagation, usiamo il negativo della loss.
Il codice seguente calcola la loss:
def calculate_loss(stepwise_returns, log_prob_actions):
loss = -(stepwise_returns * log_prob_actions).sum()
return lossCome nei comuni algoritmi di machine learning, per aggiornare la policy esegui la backpropagation rispetto alla funzione di loss. Il metodo update_policy() sotto richiama il metodo calculate_loss(). Quindi esegue la backpropagation su questa loss per aggiornare i parametri della policy, cioè i pesi del modello della rete di policy.
def update_policy(stepwise_returns, log_prob_actions, optimizer):
stepwise_returns = stepwise_returns.detach()
loss = calculate_loss(stepwise_returns, log_prob_actions)
optimizer.zero_grad()
loss.backward()
optimizer.step()
return loss.item()Il ciclo di training
Usiamo le funzioni definite in precedenza per addestrare la policy. Prima di iniziare l’addestramento, ci servono:
- Una policy non addestrata inizializzata come istanza randomizzata della classe PolicyNetwork.
- Un ottimizzatore che usa l’algoritmo Adam.
- Iperparametri per fattore di sconto, learning rate, tasso di dropout, soglia di ricompensa e numero massimo di epoche di training.
Iteriamo nel ciclo di training finché il ritorno medio non supera la soglia di ricompensa. In ogni iterazione, eseguiamo i seguenti passaggi:
- Per ogni episodio, esegui una forward pass. Raccogli la log-probabilità delle azioni, i ritorni passo-passo e il ritorno totale di quell’episodio. Accumula i ritorni episodici in un array.
- Calcola la loss usando le log-probabilità e i ritorni passo-passo. Esegui la backpropagation sulla loss. Usa l’ottimizzatore per aggiornare i parametri della policy.
- Controlla se il ritorno medio su
N_TRIALSsupera la soglia di ricompensa.
Il codice seguente implementa questi passaggi:
def main():
MAX_EPOCHS = 500
DISCOUNT_FACTOR = 0.99
N_TRIALS = 25
REWARD_THRESHOLD = 475
PRINT_INTERVAL = 10
INPUT_DIM = env.observation_space.shape[0]
HIDDEN_DIM = 128
OUTPUT_DIM = env.action_space.n
DROPOUT = 0.5
episode_returns = []
policy = PolicyNetwork(INPUT_DIM, HIDDEN_DIM, OUTPUT_DIM, DROPOUT)
LEARNING_RATE = 0.01
optimizer = optim.Adam(policy.parameters(), lr = LEARNING_RATE)
for episode in range(1, MAX_EPOCHS+1):
episode_return, stepwise_returns, log_prob_actions = forward_pass(env, policy, DISCOUNT_FACTOR)
_ = update_policy(stepwise_returns, log_prob_actions, optimizer)
episode_returns.append(episode_return)
mean_episode_return = np.mean(episode_returns[-N_TRIALS:])
if episode % PRINT_INTERVAL == 0:
print(f'| Episode: {episode:3} | Mean Rewards: {mean_episode_return:5.1f} |')
if mean_episode_return >= REWARD_THRESHOLD:
print(f'Reached reward threshold in {episode} episodes')
breakEsegui il programma di training chiamando la funzione main():
main()Questo workbook DataLab contiene l’implementazione sopra dell’algoritmo di policy gradient. Puoi eseguirlo direttamente o usarlo come punto di partenza per modificare l’algoritmo.
Vantaggi e sfide dei metodi di Policy Gradient
I metodi di policy gradient offrono diversi vantaggi, tra cui:
- Gestione di spazi d’azione continui: I metodi basati su valore (come il Q-learning) sono inefficienti con spazi d’azione continui perché devono stimare i valori su tutto lo spazio d’azione. I metodi di policy gradient possono ottimizzare direttamente la policy usando il gradiente dei ritorni attesi. Questo approccio funziona bene con distribuzioni di azioni continue. Quindi, i metodi di policy gradient sono adatti a compiti come il controllo robotico basati su spazi d’azione continui.
- Policy stocastiche: I metodi di policy gradient possono apprendere policy stocastiche, che forniscono la probabilità di selezionare ciascuna azione possibile. Questo consente all’agente di provare una varietà di azioni e riduce il rischio di bloccarsi in ottimi locali. Aiuta in ambienti complessi in cui l’agente deve esplorare lo spazio d’azione per trovare la policy ottimale. La natura stocastica aiuta a bilanciare esplorazione (provare nuove azioni) ed exploit (scegliere le azioni migliori note), cruciale in ambienti con incertezza o ricompense scarse.
- Ottimizzazione diretta della policy: I policy gradient ottimizzano direttamente la policy invece di usare funzioni di valore. In spazi d’azione continui o ad alta dimensionalità, approssimare i valori per ogni azione può essere computazionalmente costoso. Quindi, i metodi basati su policy si comportano bene in tali ambienti.
Nonostante i molti vantaggi, i metodi di policy gradient presentano alcune sfide intrinseche:
- Alta varianza nelle stime del gradiente: I metodi di policy gradient selezionano le azioni campionando da una distribuzione di probabilità. In pratica, campionano la traiettoria per stimare il ritorno atteso. Poiché il processo di campionamento è intrinsecamente casuale, i ritorni stimati in iterazioni successive possono avere alta varianza. Questo può rendere difficile l’apprendimento dell’agente perché gli aggiornamenti della policy possono fluttuare significativamente tra iterazioni.
- Instabilità durante l’addestramento:
- I metodi di policy gradient sono sensibili agli iperparametri come il learning rate. Se il learning rate è troppo alto, gli aggiornamenti dei parametri della policy possono essere troppo grandi, facendo perdere l’ottimo. Se invece è troppo basso, la convergenza può essere lenta.
- I metodi di policy gradient devono bilanciare esplorazione ed exploit. Se l’agente non esplora abbastanza, potrebbe non raggiungere il intorno della policy ottimale. Al contrario, se esplora troppo, non convergerà sulla policy ottimale e oscillerà nello spazio d’azione.
- Inefficienza di campionamento: I metodi di policy gradient stimano il ritorno seguendo ogni policy fino alla terminazione e accumulando le ricompense di ogni passo. Quindi necessitano di molte interazioni con l’ambiente per ottenere un gran numero di traiettorie campionate. Questo è inefficiente e costoso per ambienti con spazi di stato o d’azione ampi.
Soluzioni per la stabilità
Poiché l’instabilità è un problema relativamente comune nei metodi di policy gradient, gli sviluppatori hanno adottato varie soluzioni per stabilizzare il processo di training. Di seguito introduciamo soluzioni comuni per stabilizzare l’addestramento usando i policy gradient:
Uso di funzioni baseline
A causa del campionamento inefficiente, i gradienti dei ritorni stimati durante le iterazioni di training possono avere alta varianza, rendendo l’addestramento instabile e lento. Un approccio comune per ridurre la varianza è usare funzioni baseline, come nel metodo Advantage Actor-Critic (A2C). L’idea è usare un proxy (la funzione vantaggio) al posto del ritorno stimato per la funzione obiettivo.
Il vantaggio è calcolato come differenza tra il ritorno effettivo dalla traiettoria campionata e il ritorno atteso dato lo stato iniziale. Questo approccio prevede l’uso della funzione di valore come valore atteso degli stati e delle coppie stato-azione. Rappresentando la loss come differenza tra ritorno effettivo e atteso invece che come i soli ritorni, A2C riduce la varianza nella loss e quindi nei gradienti, rendendo l’addestramento più stabile.
Uso della regolarizzazione di entropia
In alcuni ambienti, come quelli con ricompense scarse (solo pochissimi stati danno una ricompensa), la policy adotta rapidamente un approccio deterministico. Adotta anche un approccio greedy e sfrutta i percorsi già esplorati. Questo impedisce ulteriore esplorazione e spesso porta alla convergenza a ottimi locali e policy subottimali.
La soluzione è incoraggiare l’esplorazione penalizzando la policy quando diventa troppo deterministica. Si fa aggiungendo un termine basato sull’entropia alla funzione obiettivo. L’entropia misura la quantità di casualità nella policy. Maggiore è l’entropia, maggiore è la casualità nelle azioni scelte dall’agente. Questo termine basato sull’entropia è il prodotto del coefficiente di entropia e dell’entropia della policy corrente.
Rendere l’entropia parte della funzione obiettivo aiuta a raggiungere un equilibrio tra exploit ed esplorazione.
Estensioni del Policy Gradient
Tra le varie estensioni dei metodi di policy gradient, una delle più fondamentali è l’algoritmo REINFORCE. Fornisce un’implementazione diretta del teorema del policy gradient ed è la base per tecniche più avanzate.
Algoritmo REINFORCE
L’algoritmo REINFORCE, noto anche come Monte Carlo Reinforce, è una delle implementazioni di base del teorema del policy gradient. Usa metodi Monte Carlo per stimare ritorni e gradienti della policy. Seguendo l’algoritmo REINFORCE, l’agente campiona direttamente tutte le azioni (dallo stato iniziale a quello terminale) dall’ambiente. Questo contrasta con altri metodi come TD-Learning e Programmazione Dinamica, che effettuano bootstrapping delle azioni basandosi su stime della funzione di valore.
Di seguito presentiamo i passaggi di base dell’algoritmo REINFORCE:
- Inizializza la policy con parametri casuali
- Ripeti più episodi di training. Per ogni episodio:
- Genera ogni passo dell’intero episodio come segue:
- Passa lo stato alla funzione di policy.
- La funzione di policy genera le probabilità per ciascuna azione possibile.
- Campiona casualmente un’azione da questa distribuzione di probabilità.
- Per ogni stato nell’episodio, stima i ritorni (ricompense cumulative scontate) fino al passo.
- Stima il gradiente della funzione obiettivo (secondo il teorema del policy gradient), espresso come prodotto dei ritorni passo-passo e delle probabilità d’azione a ogni passo.
- Aggiorna i parametri della policy applicando i gradienti
Per ogni policy, puoi campionare una singola traiettoria per stimare il gradiente (come mostrato sopra) o mediare il gradiente su più traiettorie campionate sotto la stessa policy.
Metodi actor-critic
I metodi actor-critic combinano i metodi di policy gradient (come REINFORCE) con le funzioni di valore.
- Il funzionamento dell’actor è simile ai metodi di policy gradient. L’actor implementa la policy, selezionando le azioni a ogni passo in base alla policy. Aggiorna la policy seguendo il gradiente del ritorno atteso.
- Il critic implementa la funzione di valore, utilizzata come baseline (discussa nella sezione precedente). Questo aiuta a rendere l’addestramento più efficiente e stabile.
I metodi di policy gradient come REINFORCE stimano i gradienti lungo ogni traiettoria usando il ritorno grezzo. Poiché queste traiettorie sono ottenute tramite un processo di campionamento, possono portare a grandi varianze nei ritorni e nei gradienti. Usare una funzione vantaggio al posto dei ritorni grezzi risolve il problema. La funzione vantaggio è la differenza tra ritorni effettivi e attesi (cioè la funzione di valore). I metodi actor-critic sono una classe di algoritmi. Quando il critic è implementato usando la funzione vantaggio (l’approccio più comune), si parla anche di Advantage actor-critic (A2C).
Proximal Policy Optimization (PPO)
In ambienti complessi, i metodi actor-critic come A2C da soli non sono sufficienti a controllare la varianza nei ritorni e nei gradienti. In questi casi, aiuta limitare artificialmente l’entità del cambiamento della policy a ogni iterazione. Questo forza la policy aggiornata (dopo l’ascesa del gradiente) a rimanere nel intorno della policy precedente.
Metodi come la Proximal Policy Optimization apportano due modifiche ai policy gradient:
- Usare una funzione vantaggio. Tipicamente, questa funzione vantaggio usa la funzione di valore come baseline. In questo sono simili ai metodi A2C.
- Limitare l’entità del cambiamento dei parametri della policy a ogni iterazione. Questo viene fatto con una funzione obiettivo surrogata ritagliata (clipped). L’algoritmo specifica un intervallo entro cui deve rientrare il rapporto tra la nuova policy e la vecchia policy. Quando il rapporto (dopo l’aggiornamento del gradiente) supera i valori predefiniti, viene ritagliato per rientrare nell’intervallo.
Così, PPO migliora significativamente i policy gradient “vanilla”, migliorando la stabilità in ambienti complessi. La funzione obiettivo ritagliata impedisce che grandi varianze nei ritorni e nei gradienti destabilizzino gli aggiornamenti della policy. Per bilanciare esplorazione ed exploit, è anche possibile modificare PPO per usare la regolarizzazione di entropia, aggiungendo un termine di entropia (un parametro di scala moltiplicato per l’entropia della policy) alla funzione obiettivo.
Progressi recenti
I policy gradient sono tra i primi metodi usati per risolvere problemi di RL. Dopo l’avvento di GPU veloci, sono stati proposti vari nuovi approcci per applicare tecniche di ML moderne ai policy gradient.
Gradient-Boosted Reinforcement Learning
Negli ultimi anni, sono stati fatti progressi nell’applicazione di metodi come il gradient boosting agli algoritmi di RL. Il gradient boosting combina le previsioni di più modelli deboli per generare un singolo modello forte. Questo è noto come Gradient-Boosted Reinforcement Learning (GBRL). GBRL è un pacchetto Python simile a XGBoost che implementa queste tecniche per algoritmi di RL.
Transfer Reinforcement Learning
Transfer learning (TL) è una tecnica in cui la conoscenza acquisita da un modello viene applicata per migliorare le prestazioni di un altro modello. Il transfer learning è utile perché addestrare modelli di ML da zero è costoso. Approcci TL sono stati usati con i policy gradient per migliorare le prestazioni dei modelli RL. Questo approccio è chiamato Transfer Reinforcement Learning (TRL).
Conclusione
I policy gradient sono tra gli approcci più fondamentali per risolvere problemi di RL.
In questo articolo abbiamo presentato i primi principi dei policy gradient e mostrato come derivare il teorema del policy gradient. Abbiamo anche dimostrato come implementare un semplice algoritmo basato su gradienti usando PyTorch in un ambiente Gymnasium. Infine, abbiamo discusso le sfide pratiche e le estensioni comuni dell’algoritmo base di policy gradient.
Se vuoi approfondire il reinforcement learning e il deep learning con PyTorch, dai un’occhiata a questi corsi:
- Percorso Reinforcement Learning – Impara le basi dell’RL, dai metodi basati su valore alle tecniche di ottimizzazione della policy.
- Introduzione al Deep Learning con PyTorch – Metti le mani in pasta con PyTorch e crea modelli di deep learning da zero.






I policy gradient nel reinforcement learning (RL) sono una classe di algoritmi che ottimizzano direttamente la policy dell’agente stimando il gradiente della ricompensa attesa rispetto ai parametri della policy.
In questo tutorial spieghiamo il teorema del policy gradient e la sua derivazione e mostriamo come implementare l’algoritmo di policy gradient usando PyTorch.
Che cos’è il Teorema del Policy Gradient?
Nel reinforcement learning, la policy dell’agente è l’algoritmo che usa per decidere quale azione intraprendere in base alle osservazioni dell’ambiente. L’obiettivo nei problemi di RL è massimizzare le ricompense che l’agente ottiene interagendo con l’ambiente. La policy che massimizza le ricompense è la policy ottimale.
Le due grandi famiglie di algoritmi utilizzati per massimizzare i ritorni sono i metodi basati su policy e i metodi basati su valore:
Secondo il teorema del policy gradient, la derivata del ritorno atteso è l’aspettazione del prodotto tra il ritorno e la derivata del logaritmo della policy (tipicamente espressa come distribuzione di probabilità).
Una policy è in genere modellata come funzione parametrica. Quando è modellata come rete neurale, i parametri della policy sono i pesi della rete. Di conseguenza, calcolare il gradiente del ritorno atteso (ricompense cumulative) rispetto ai parametri della policy porta ad aggiornare la policy per migliorarne le prestazioni. Questo gradiente può essere usato per aggiornare iterativamente i parametri della policy nella direzione che aumenta il ritorno atteso. L’addestramento dovrebbe convergere verso la policy ottimale che massimizza il ritorno atteso.
Nelle sezioni successive spieghiamo in dettaglio questo teorema e mostriamo come derivarlo.