
Last chance! 50% off DataCamp Premium
Sale ends in
Di dunia big data, kita jarang menatap data mentah. Agar data lebih mudah dicerna, pengelompokan dan pengagregasian data adalah operasi yang umum dan kuat. Saat bekerja dengan sistem terdistribusi seperti Apache Spark dan Python, memiliki fungsi groupBy di PySpark memungkinkan kita mengumpulkan dan merangkum data terdistribusi. Fungsinya mencerminkan klausa GROUP BY di SQL, tetapi dirancang untuk menangani pemrosesan data terdistribusi pada dataset besar secara efisien.
Fungsi groupBy di PySpark memungkinkan pengguna mempartisi data berdasarkan berbagai kolom, yang kemudian dapat diagregasi menjadi berbagai metrik seperti jumlah, rata-rata, dan seterusnya. Untuk melakukan ini secara efisien, PySpark mengikuti paradigma split-apply-combine:
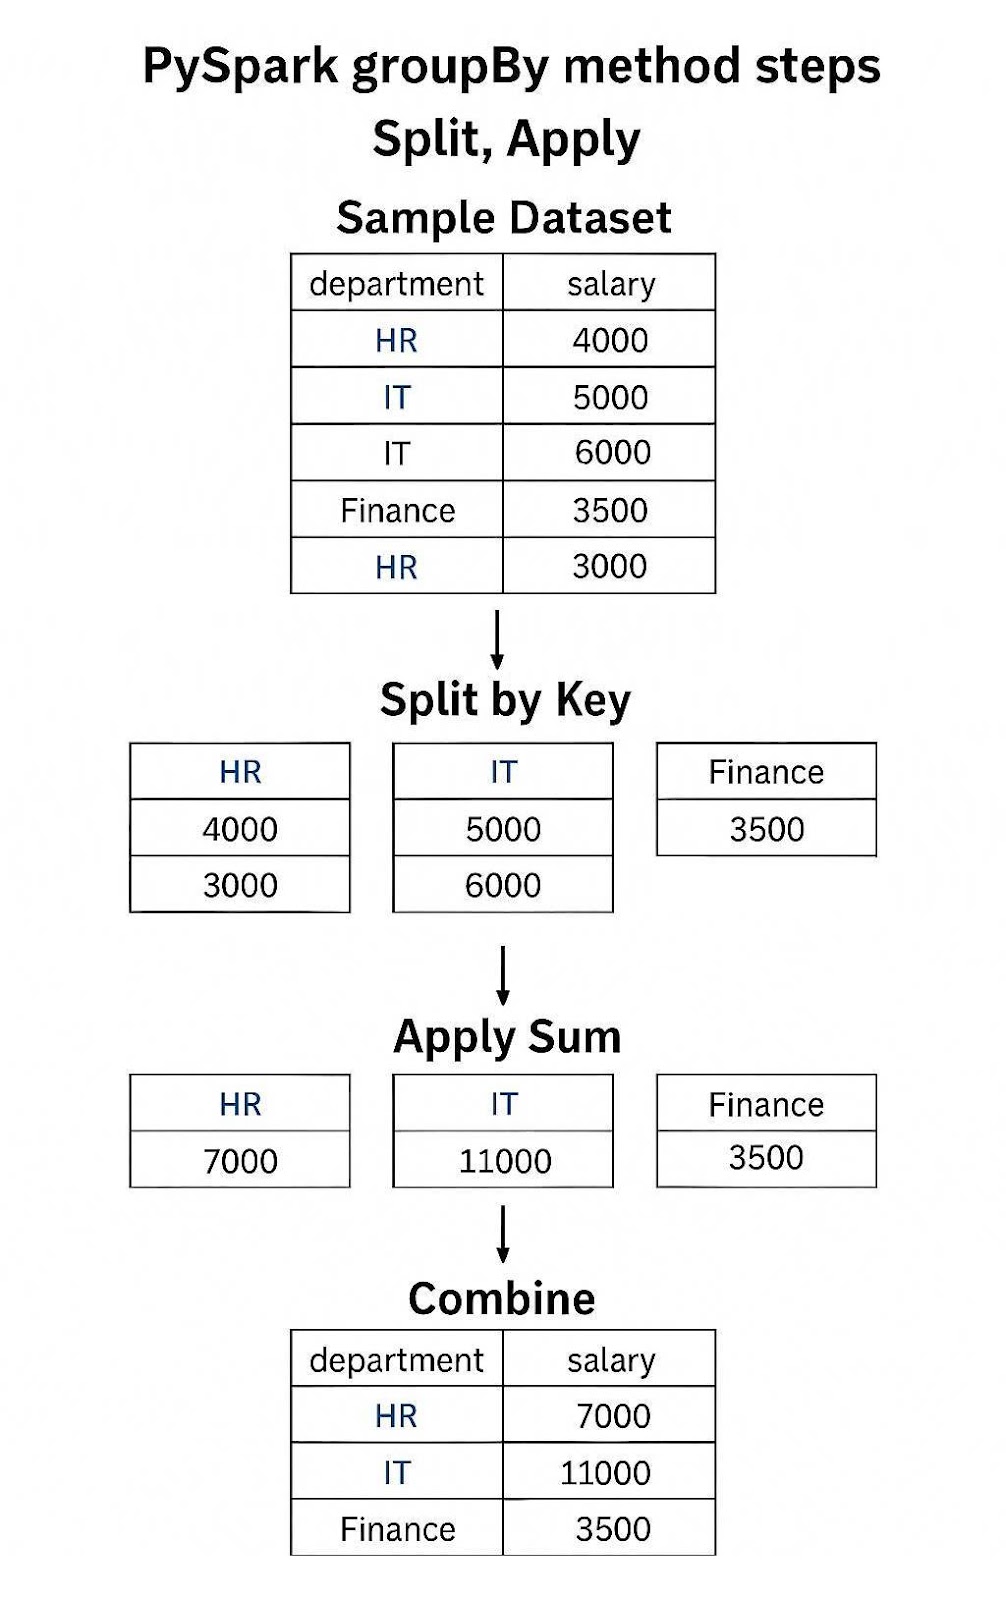
Contoh metode groupBy() di PySpark menerapkan Sum
PySpark memanfaatkan evaluasi malas (lazy evaluation), artinya operasi seperti groupBy hanya dihitung ketika aksi (seperti show() atau collect()) dipanggil. Alih-alih, PySpark terlebih dahulu membangun DAG (Directed Acyclic Graph) awal yang disempurnakan untuk kinerja. Ini membantu Spark mengoptimalkan rencana kueri sebelum eksekusi.
Jika Anda belum berkesempatan bekerja dengan PySpark, saya sangat merekomendasikan mempelajari Big Data Fundamentals with PySpark.
Pertama-tama, kita perlu memiliki DataFrame PySpark. Jika Anda butuh penyegaran tentang berbagai perintah PySpark, lihat Cheatsheet PySpark DataFrame yang bagus ini.
Kita akan membahas beberapa langkah dan perintah kunci yang membantu kita memulai dengan PySpark. Sebelum mulai, pastikan PySpark sudah terpasang di lingkungan Python Anda serta Java dan Java JDK. Jika Anda perlu bantuan, ikuti panduan ini tentang memulai dengan PySpark.
Langkah pertama adalah menjalankan PySpark Anda!
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()Mari kita bangun DataFrame sampel untuk kita gunakan.
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()Keluaran:
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
+----------+--------+------+PySpark groupBy adalah transformasi yang digunakan untuk membagi data menjadi kelompok berdasarkan satu atau lebih kolom, yang kemudian dapat diagregasi atau ditransformasikan secara independen.
Menggunakan metode groupBy itu sederhana; Anda dapat memanggilnya pada dataframe yang diinginkan. Anda bisa menggunakannya pada tipe kolom apa pun selama cocok untuk dipartisi. Misalnya, Anda mungkin ingin menghindari float.
grouped = df.groupBy("department")Ini membuat objek GroupedData, yang bukan DataFrame itu sendiri. Ini memberi tahu Spark bagaimana ia akan mulai mempartisi data. Setelah Anda memiliki objek GroupedData ini, Anda dapat menerapkan agregasi .count() atau .sum() untuk mendapatkan DataFrame baru.
grouped.count().show()Satu-satunya parameter untuk metode ini adalah *cols yang menerima nama kolom, ekspresi kolom, ordinal kolom (int), atau daftar kolom. Selama kolomnya adalah sesuatu yang ingin Anda jadikan dasar partisi, Anda dapat menggunakannya dalam operasi. Metode ini selalu mengembalikan objek GroupedData.
# grouping by column name like above
	df.groupBy("department")

# grouping by column expression
	df.groupBy(df.department)

#grouping by column ordinal
	df.groupBy(1)

#grouping by list of columns, you can mix the methods!
df.groupBy(["department", 2])Seperti ditunjukkan di atas, Anda dapat mengelompokkan pada satu atau banyak kolom. Satu kolom cocok saat Anda hanya tertarik pada satu sumbu, seperti departemen atau tahun. Banyak kolom cocok jika Anda ingin mendapatkan lebih banyak lapisan detail, misalnya tenaga penjualan tertentu di berbagai departemen, atau bulan tertentu dalam satu tahun.
# grouping by single column
	df.groupBy("department").sum(“salary”).show()

#grouping by multiple columns
	df.groupBy(["department", 2]).sum(“salary”).show()
Seperti yang mungkin Anda perhatikan, metode groupBy bekerja sangat mirip dengan pernyataan GROUP BY di SQL. Nanti kami juga akan menunjukkan cara menggunakan bahasa itu di PySpark.
PySpark mendukung beragam metode agregasi bawaan untuk bekerja dengan data yang dikelompokkan. Jika Anda familier dengan SQL, Anda akan mengenali banyak di antaranya seperti count(), sum(), avg(), dan seterusnya. Anda dapat melihat panduan fungsi agregat di SQL kami sebagai penyegar.
Mari kita bahas fungsi-fungsi agregasi bawaan:
count(): menghitung jumlah rekaman dalam partisi inisum(): meringkas total nilai numerikavg(): menghitung rata-rata nilai numerikmin(): mengembalikan nilai terkecil dari partisimax(): mengembalikan nilai terbesar dari partisiSelain fungsi agregasi, Anda dapat menambahkan metode .alias() untuk mengganti nama kolom agar lebih mudah dipahami. Kami akan menunjukkan contohnya di bawah.
Alih-alih melakukan setiap agregasi secara terpisah, Anda dapat melakukan beberapa agregasi sekaligus menggunakan metode agg(). Setiap agregasi akan membuat kolom baru di dataframe Anda. Ini juga mengurangi kebutuhan pemanggilan groupBy berkali-kali, yang meningkatkan kinerja. Kita tidak harus mengagregasi pada kolom yang sama dengan agg(), Anda dapat menentukan kolom berbeda untuk setiap fungsi agregasi.
# After already starting your session
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()Keluaran:
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+Keuntungan PySpark adalah kemampuan menggunakan pola agregasi yang lebih lanjut, seperti memutar (pivot) data Anda, rollup, dan membuat kubus data. Anda juga bisa membuat grouping set.
Seperti membuat pivot table di Excel, Anda dapat memutar data pada kolom-kolom yang berbeda. Dalam contoh ini, kita mengelompokkan berdasarkan department dan memutar pada kolom employee untuk melihat total gaji setiap karyawan.
Ini berarti setiap baris akan menampilkan departemen, dan setiap kolom adalah karyawan di departemen tersebut. Anda bisa melihat betapa kuatnya ini jika kita memiliki data per tahun, dan ingin melihat kinerja setiap departemen dari tahun ke tahun.
df.groupBy("department").pivot("employee").sum("salary").show()Dua cara yang sangat kuat untuk mengagregasi data adalah rollup() dan cube(). Sementara groupby() biasa akan menampilkan hasil untuk agregasi yang ada, rollup() dan cube() keduanya adalah struktur hierarkis. Artinya mereka mengagregasi data pada tingkat yang lebih terperinci.
Misalnya, rollup() melakukan agregasi dari kiri ke kanan, menampilkan setiap kemungkinan permutasi jika kita menjalani iterasi selangkah demi selangkah. Untuk setiap departemen, kita menampilkan setiap orang yang ada di departemen tersebut dan juga kelompok akhir dari mereka yang tidak ada.
Di sisi lain, cube() menampilkan semua permutasi yang mungkin untuk semua kolom agregat, jadi untuk setiap departemen secara terpisah, setiap karyawan secara terpisah, dan setiap kombinasi keduanya.
Sebagai rangkuman:
Anda bisa melihat contoh pada kode dan keluarannya di bawah:
rollup() Kode:
# using rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() Keluaran:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() Kode:
#using cube
df.cube("department", "employee").sum("salary").show()
cube() Keluaran:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+
Grouping set memungkinkan Anda menentukan beberapa level agregasi. Dalam contoh ini, saya mengagregasi pada level departemen dan karyawan, level departemen, dan semua level untuk mendapatkan total gaji.
Anda akan melihat sintaksnya sedikit berbeda untuk metode groupingSets(). Anda terlebih dahulu menentukan daftar set [(“department”, “employee”), (“department”, ), ()] di mana set pertama adalah departemen dan karyawan, set kedua hanya departemen, dan set terakhir () berarti semua.
Lalu Anda mendefinisikan kolom agregasi di dalam set. Sisanya ditulis seperti biasa menggunakan .agg().
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()Keluaran:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+Terakhir, kita dapat membuat fungsi agregasi kustom menggunakan User Defined Functions (UDF) di PySpark. Ada dua cara: udf dan pandas_udf. Keduanya memungkinkan Anda membuat fungsi kustom sendiri dengan kelebihan/kekurangan masing-masing.
UDF spark standar udf memungkinkan Anda membuat fungsi native Spark. Artinya sintaks dan tipe data harus bekerja secara native di Spark. Walau ini membatasi sebagian dari apa yang bisa dilakukan dalam UDF, pendekatan ini memungkinkan Anda memanfaatkan penuh kekuatan komputasi terdistribusi Spark dan lebih baik untuk dataset besar.
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
Di sisi lain, pandas_udf memungkinkan Anda membuat fungsi kustom yang lebih Pythonik. Kini Anda hanya terikat pada apa yang mungkin dilakukan di Pandas dan tidak hanya Spark.
Namun, itu berarti Anda tidak dapat menggunakan kekuatan komputasi terdistribusi Spark, dan Anda bergantung pada komputasi lokal. Ini lebih cocok untuk dataset kecil hingga menengah.
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
Secara keseluruhan, Anda sebaiknya hanya menggunakan fungsi kustom jika dan hanya jika tidak ada cara yang lebih baik untuk melakukan agregasi. Jangan menciptakan ulang roda!
Juga, jika sesuatu dapat divektorkan (seperti fungsi kita di atas), maka pilih gunakan versi tervektor dari fungsi alih-alih UDF agregasi. Untuk info lebih lanjut tentang groupBy(), baca artikel ini yang mengulas lebih dalam kerangka kerja split-apply-combine dengan pandas.
Di PySpark, Anda dapat memfilter kelompok berdasarkan metrik agregat pasca-pengelompokan menggunakan metode filter(). Dalam metode ini, Anda memberikan kondisi dalam ekspresi Python atau SQL.
Perlu dicatat, Anda juga dapat menggunakan where() jika Anda lebih suka, karena ini hanyalah alias untuk filter() dan melakukan operasi yang sama.
Anda dapat memilih untuk memfilter sebelum atau setelah agregasi. Memfilter sebelum akan memengaruhi agregasi dengan membatasi data yang diagregasi dan dapat meningkatkan kinerja.
Misalnya, mungkin kita hanya ingin menghitung jumlah karyawan di atas gaji tertentu untuk menemukan jumlah karyawan “bergaji tinggi”.
#filter for high salaries
filter_df = df.filter(df.salary > 4000)

#aggregate and find the total of high salary employees
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
Namun, memfilter setelah agregasi tidak akan memengaruhi agregasi asli. Mungkin kita ingin menghitung semua karyawan di sebuah departemen dan hanya ingin melihat departemen di atas ukuran tertentu. Ini akan menambahkan lapisan pemrosesan ekstra, tetapi seharusnya tidak banyak menambah beban komputasi.
# creating a dataframe counting the number of employees
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# filtering for departments where there is more than 1 employee
agg_df.where("num_employees > 1").show()
Pilih waktu pemfilteran dengan bijak, karena ini akan memengaruhi akurasi dan hasil akhir. Memfilter sebelum dapat mengurangi total akhir, sedangkan memfilter setelahnya bisa membuat terlalu banyak yang tersisa dalam jawaban akhir.
Meskipun PySpark secara otomatis mengoptimalkan operasi groupBy, ada strategi yang dapat semakin meningkatkan kecepatan pemrosesan. Hal-hal seperti meminimalkan data shuffling, mitigasi skew, dan optimasi eksekusi semuanya berperan dalam meningkatkan kinerja groupBy.
groupBy menyebabkan shuffle, yang mendistribusikan ulang data di seluruh partisi untuk mengelompokkan key serupa. Shuffle intensif jaringan dan disk, jadi meminimalkan atau mengoptimalkannya sangat penting. Berikut beberapa teknik optimasi kunci:
repartition() dengan bijak, Anda dapat memberi tahu PySpark kolom mana yang harus digunakan untuk partisi sehingga pencarian data terjadi di lebih sedikit tempatBerikut beberapa contoh bagaimana Anda dapat meningkatkan manajemen shuffle.
# reduce the number of shuffle partitions
spark.conf.set("spark.sql.shuffle.partitions", "64")  # Adjust based on cluster size

# make sure spark compresses the data
spark.conf.set("spark.shuffle.compress", "true") # compresses network transfer
spark.conf.set("spark.shuffle.spill.compress", "true") # compresses disk spillage

# repartitions the data prior to grouping to optimize aggregation
df.repartition("department").groupBy("department").sum("salary").show()Data skew terjadi saat key tertentu muncul secara tidak proporsional lebih banyak daripada yang lain, sehingga beban partisi tidak merata dan tugas menjadi lambat. Ini membebani beberapa pekerja lebih dari yang lain. Kita dapat meminimalkan skew dan mendistribusikan pekerjaan lebih merata dengan salting, meminimalkan join yang skew, dan broadcast join untuk dimensi yang lebih kecil.
# Salting example:

df = df.withColumn("salted_key", sf.rand()) #Create column of random
df = df.repartition(2, 'salted_key') # use this to repartition data
df.groupBy(sf.spark_partition_id()).count().show()Rencana eksekusi logis dan fisik dari job PySpark dapat dioptimalkan menggunakan fitur bawaan. Ini dapat meningkatkan kinerja agregasi groupBy Anda.
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # you can cache your intermediate results

# use broadcasting (pseudocode here):
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
Untuk detail lebih lanjut tentang bagaimana kita dapat mengoptimalkan operasi PySpark, baca artikel tentang PySpark Joins untuk memahami beberapa mekanisme di balik layar.
Meskipun API DataFrame adalah antarmuka yang direkomendasikan bagi sebagian besar pengguna PySpark karena abstraksi tingkat tingginya dan efisiensi kinerja berkat Catalyst Optimizer, memahami lapisan Resilient Distributed Dataset (RDD) dapat bernilai, terutama bagi mereka yang menginginkan kontrol lebih atau sedang memigrasikan kode Spark lama. Namun secara umum, menggunakan API DataFrame atau SQL akan memberi Anda kinerja yang lebih baik.
RDD adalah komponen inti PySpark, yang menjadi fondasi semua hal (termasuk API DataFrame). Ia cenderung bekerja di memori dan sedikit lebih baik menangani data streaming dibanding API DataFrame. Namun, data bersifat immutable sehingga tidak dapat diubah setelah RDD dibuat.
Bagian ini membandingkan groupBy di API DataFrame dengan padanannya di API RDD, menganalisis kinerja dan kecocokan kasus penggunaan.
Pertama, mari ubah dataframe menjadi RDD.
# Convert DataFrame to RDD of (key, value)
rdd = df[['department','salary']].rdd
rdd.collect()
Sekarang kita dapat melakukan hal seperti groupByKey() dan reduceByKey() pada RDD. Mari kita bahas groupByKey() terlebih dahulu.
Metode groupByKey() melakukan shuffle semua nilai dengan key yang sama ke eksekutor yang sama lalu mengelompokkannya. Karena ini, prosesnya bisa memakan waktu lama untuk men-shuffle data ke key yang tepat. Ini juga dapat menyebabkan data skew.
rdd.groupByKey().mapValues(list).collect()Sebagai gantinya, kita dapat mencoba metode reduceByKey() berikut. Metode ini terlebih dahulu mengagregasi pada setiap partisi dan kemudian memindahkan data melalui jaringan. Ini meminimalkan jumlah data yang di-shuffle dan akibatnya bekerja lebih cepat.
Jadi, reduceByKey jauh lebih disukai daripada groupByKey karena secara signifikan mengurangi operasi shuffle.
Jadi, ini mengagregasi di setiap partisi, lalu menggabungkan data, dan kemudian mengagregasikannya bersama. Ini paling cocok untuk agregasi yang menyatukan key, seperti sum() dan max().
from operator import add

rdd.reduceByKey(add).collect()Berikut tabel yang merangkum manfaat setiap metode agregasi.
|
Fitur |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
Tingkat Abstraksi |
Tinggi |
Rendah |
Rendah |
|
Eksekusi Teroptimasi |
Ya (Catalyst & Tungsten) |
Tidak |
Tidak |
|
Minimisasi Shuffle |
Ya |
❌ (Shuffle penuh) |
✅ (Dengan combiner) |
|
Efisiensi Memori |
Tinggi |
Rendah |
Menengah–Tinggi |
|
Fleksibilitas |
Sedang |
Tinggi |
Menengah |
|
Kinerja pada Big Data |
Sangat baik |
Buruk |
Baik |
|
Penggunaan yang Direkomendasikan |
Kebanyakan kasus |
Jarang/spesifik |
Agregasi kustom tingkat rendah |
Big Data Fundamentals with PySpark membahas pemrograman dengan RDD secara lebih rinci dan menjelaskan bagaimana RDD membentuk tulang punggung PySpark.
Cara lain untuk melakukan agregasi di PySpark adalah menggunakan API SQL untuk menulis pernyataan dengan SQL. Ini bisa menjadi cara yang bagus jika Anda lebih nyaman menulis SQL.
Langkah pertama adalah membuat tampilan sementara menggunakan metode createOrReplaceTempView() dari DataFrame. Lalu Anda dapat menggunakan spark.sql() untuk menulis pernyataan Anda.
# Create a temporary view using the DataFrame
df.createOrReplaceTempView("employees")

# Write a SQL-like statement
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()Keluaran:
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
Seperti yang Anda lihat, semudah menulis kueri SQL biasa. Waktu utama menggunakan API SQL adalah untuk faktor keakraban dan kemudahan saat menulis kueri. API DataFrame sering kali lebih baik karena akan menyediakan tipe data yang konsisten dan biasanya lebih optimal.
Anda dapat mengakses metode DataFrame yang tidak dapat Anda akses dengan Spark SQL API. Untuk informasi lebih lanjut tentang GROUP BY di SQL, Anda dapat membaca artikel ini tentang GROUP BY dan HAVING di SQL.
Ada banyak aplikasi dunia nyata untuk mengagregasi data Anda. Faktanya, Anda hampir pasti harus mengagregasi data Anda dalam beberapa cara agar dapat dianalisis dan dibagikan.
Di bawah ini, kami akan memberikan beberapa contoh berbagai kasus penggunaan agregasi. Beberapa mungkin berupa pseudo-code atau tidak persis berlaku untuk dataset uji kita, namun bertujuan memberi gambaran bagaimana Anda dapat menulis agregasi tersebut.
Salah satu tema umum yang kita bahas adalah ide menggunakan groupBy sebagai sarana analisis hierarkis. Bayangkan kita memiliki kolom bernama “revenue” dan kita tertarik pada kinerja setiap departemen. Kita dapat mengelompokkan setiap departemen dan menilai kontribusi pendapatan tiap departemen.
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()Agregasi memberi Anda akses ke fungsi jendela (window functions). Fungsi-fungsi ini melihat jendela data yang bergulir, baik serangkaian baris secara berurutan atau periode waktu secara berurutan.
Kita terlebih dahulu mendefinisikan sebuah window menggunakan objek Window untuk menunjukkan apa yang ingin kita partitonBy dan orderBy. Lalu kita gunakan objek ini dalam metode over() dari fungsi agregasi pilihan kita. Misalnya, rata-rata bergulir akan tampak seperti sf.avg().over(window).show().
Bayangkan kita ingin melihat rata-rata bergulir gaji untuk setiap departemen. Kita akan mengelompokkan berdasarkan department dan mengurutkan berdasarkan kolom baru yang bisa kita sebut employeeId. Karena ID karyawan seringkali berurutan, kita bisa melihat bagaimana rata-rata gaji berubah seiring waktu.
from pyspark.sql.window import Window

#Define the window we wish to partition and order by
windowSpec = Window.partitionBy("department").orderBy("employeeId")

#Perform the sf.avg function on the “salary” column over the windowSpec.
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
Ini sangat mirip dengan cara kita melakukan fungsi jendela di SQL.
Mungkin kita ingin memahami berbagai metrik pengguna untuk perusahaan media kita. Kita menginginkan hal-hal seperti total waktu tonton dan video unik. Kita dapat groupBy() pada kolom user_id diikuti dengan .agg() dengan fungsi berbeda seperti sum() dan countDistinct() untuk metrik berbeda.
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), #sum minutes watched
    sf.countDistinct("video_id").alias("unique_views") #count unique videos watched
).show()Saat mengagregasi data di PySpark, mudah terjebak dalam kesalahan yang menyebabkan kinerja buruk dan waktu eksekusi lama. Mengikuti praktik terbaik ini membantu memastikan kinerja, kebenaran, dan skalabilitas.
Berikut beberapa cara umum yang mengubah kueri sederhana menjadi program yang berjalan lama.
groupByKey() pada RDD:groupByKey() pada RDD, karena mekanismenya membuat PySpark men-shuffle data di seluruh partisi. Ini dapat menyebabkan banyak overhead jaringan dan disk.reduceByKey() atau tetap pada API DataFrame.repartition().sum() dalam satu groupBy lalu count() pada dataset yang sama di baris berbeda, menghasilkan rencana yang tidak efisien dengan memutus kemampuan PySpark untuk mengoptimalkan.persist() atau cache() saat menggunakan kembali data yang sudah dikelompokkan.Berikut beberapa cara Anda dapat mengoptimalkan agregasi PySpark agar berjalan lancar!
na.fill() atau na.drop() sebelum agregasi.df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions berdasarkan volume data dan cari berapa jumlah partisi yang paling baik untuk data Anda..explain() untuk memahami eksekusi fisik.df.groupBy("department").sum("salary").explain(True)Keluaran:
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
Spark memiliki banyak konfigurasi yang dapat disetel untuk beban kerja groupBy yang besar. Lihat tabel di bawah untuk beberapa konfigurasi kunci.
|
Konfigurasi |
Deskripsi |
|
|
Mengontrol jumlah partisi untuk shuffle. Kurangi untuk pekerjaan kecil, tingkatkan untuk pekerjaan besar. (Default: 200) |
|
|
Mengaktifkan broadcast otomatis untuk tabel kecil. Setel ke -1 untuk menonaktifkan atau tingkatkan untuk mendukung join yang lebih besar. (Default: 10MB) |
|
|
Mengontrol memori yang tersedia per executor. Tingkatkan ini untuk agregasi besar. (Default: 4g) |
|
|
Mengaktifkan Adaptive Query Execution (AQE), yang dapat secara dinamis mengoptimalkan shuffle, skew, dan join. (Default: true) |
Bagi pengguna tingkat lanjut atau mereka yang menangani dataset yang sangat besar, memahami bagaimana groupBy berperilaku di balik layar itu penting. Mari kita bahas beberapa poin detail tentang cara kerja metode ini.
Semua operasi DataFrame di PySpark, termasuk groupBy, dievaluasi secara malas. Artinya tidak ada komputasi nyata yang terjadi sampai sebuah aksi (seperti show() atau collect()) dipicu.
Ini memungkinkan Catalyst optimizer untuk menyusun ulang, menggabungkan, atau menghapus operasi untuk meningkatkan kinerja. Manfaatkan hal ini dan rangkai beberapa agregasi dan metode bersama agar Spark dapat membuat rencana yang teroptimasi.
Saat menggunakan groupBy() ia mengembalikan objek GroupedData. Melakukan fungsi agregasi, seperti sum() kemudian akan mengembalikan objek mirip DataFrame. Jika menggunakan show() hasilnya akan ditampilkan.
Ingat bahwa groupBy().agg() mengembalikan DataFrame baru dengan kolom yang baru dinamai. Selalu gunakan alias dengan metode alias() untuk mencegah tabrakan penamaan dan memperjelas keluaran. Jika Anda membiarkan kolom tanpa alias, hal ini dapat menyebabkan tabrakan nama kolom atau masalah pada join ke depannya.
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)Perlu dicatat tentang PySpark, hasil agregasi yang dikembalikan tidak mempertahankan urutan baris. Gunakan orderBy() untuk keluaran yang dapat diprediksi dan pengurutan baris yang konsisten.
df.groupBy("department").sum("salary").orderBy("department").show()Ada beberapa perubahan dan keterbatasan spesifik pada tiap versi PySpark. Catalyst diperkenalkan di 1.3 dan meningkat signifikan di 2.0. Beberapa metode baru diperkenalkan pada versi PySpark yang lebih baru, seperti groupingSets().
Berikut bagan yang membahas beberapa perubahan fungsional besar untuk PySpark. Pastikan Anda menggunakan versi Spark dan PySpark yang tepat untuk fitur yang Anda butuhkan!
|
Fitur |
Versi Spark |
Deskripsi |
|
|
1.4+ |
Agregasi hierarkis yang berguna dalam analitik gaya OLAP (3.4+ mendukung Spark Connect) |
|
|
2.3+ |
UDF tervektorisasi menggunakan Apache Arrow untuk eksekusi lebih cepat, (3.4+ mendukung Spark Connect, 4.0+ mendukung SCALAR) |
|
Adaptive Query Execution (AQE) |
3.0+ |
Menyesuaikan join, shuffle, dan penanganan skew secara dinamis saat runtime |
|
Mode kompatibilitas ANSI SQL |
3.0+ |
Pelaporan error dan perilaku ekspresi yang lebih akurat |
|
|
4.0+ |
Memungkinkan beberapa pengelompokan dalam satu agregasi (mis., untuk subtotal) |
Fungsi groupBy di PySpark adalah alat esensial untuk agregasi data di lingkungan terdistribusi. Baik untuk meringkas data per wilayah, menghitung metrik rata-rata, atau melakukan analitik multi-level yang kompleks, groupBy menyediakan API yang dapat diskalakan dan fleksibel untuk menangani beban kerja big data.
Ingat untuk menjaga praktik terbaik ini agar waktu jalan dan biaya minimal:
Seiring PySpark terus berkembang, kita dapat mengharapkan optimasi yang makin cerdas, dukungan native untuk agregasi kompleks, dan integrasi yang lebih baik dengan Pandas dan sintaks bergaya SQL. Bisa jadi juga ada integrasi yang lebih baik untuk model berskala lebih besar. Jika Anda tertarik mempelajari lebih lanjut tentang PySpark, lihat sumber daya rinci dari DataCamp berikut:
Kursus PySpark Teratas
Kursus
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt




