
Corso
Fondamenti di PySpark
4 ore
157.9K
Nel mondo dei big data, raramente osserviamo i dati grezzi. Per rendere i dati più fruibili, raggrupparli e aggregarli è un’operazione comune e potente. Quando si lavora con sistemi distribuiti come Apache Spark e Python, disporre della funzione groupBy di PySpark ci permette di raccogliere e riassumere i dati distribuiti. Rispecchia la funzionalità della clausola GROUP BY di SQL, ma è progettata per gestire in modo efficiente l’elaborazione distribuita su dataset enormi.
Il groupBy di PySpark consente di partizionare i dati in base a diverse colonne, che possono poi essere aggregate in varie misure come somme, medie e così via. Per farlo in modo efficiente, PySpark segue il paradigma split-apply-combine:
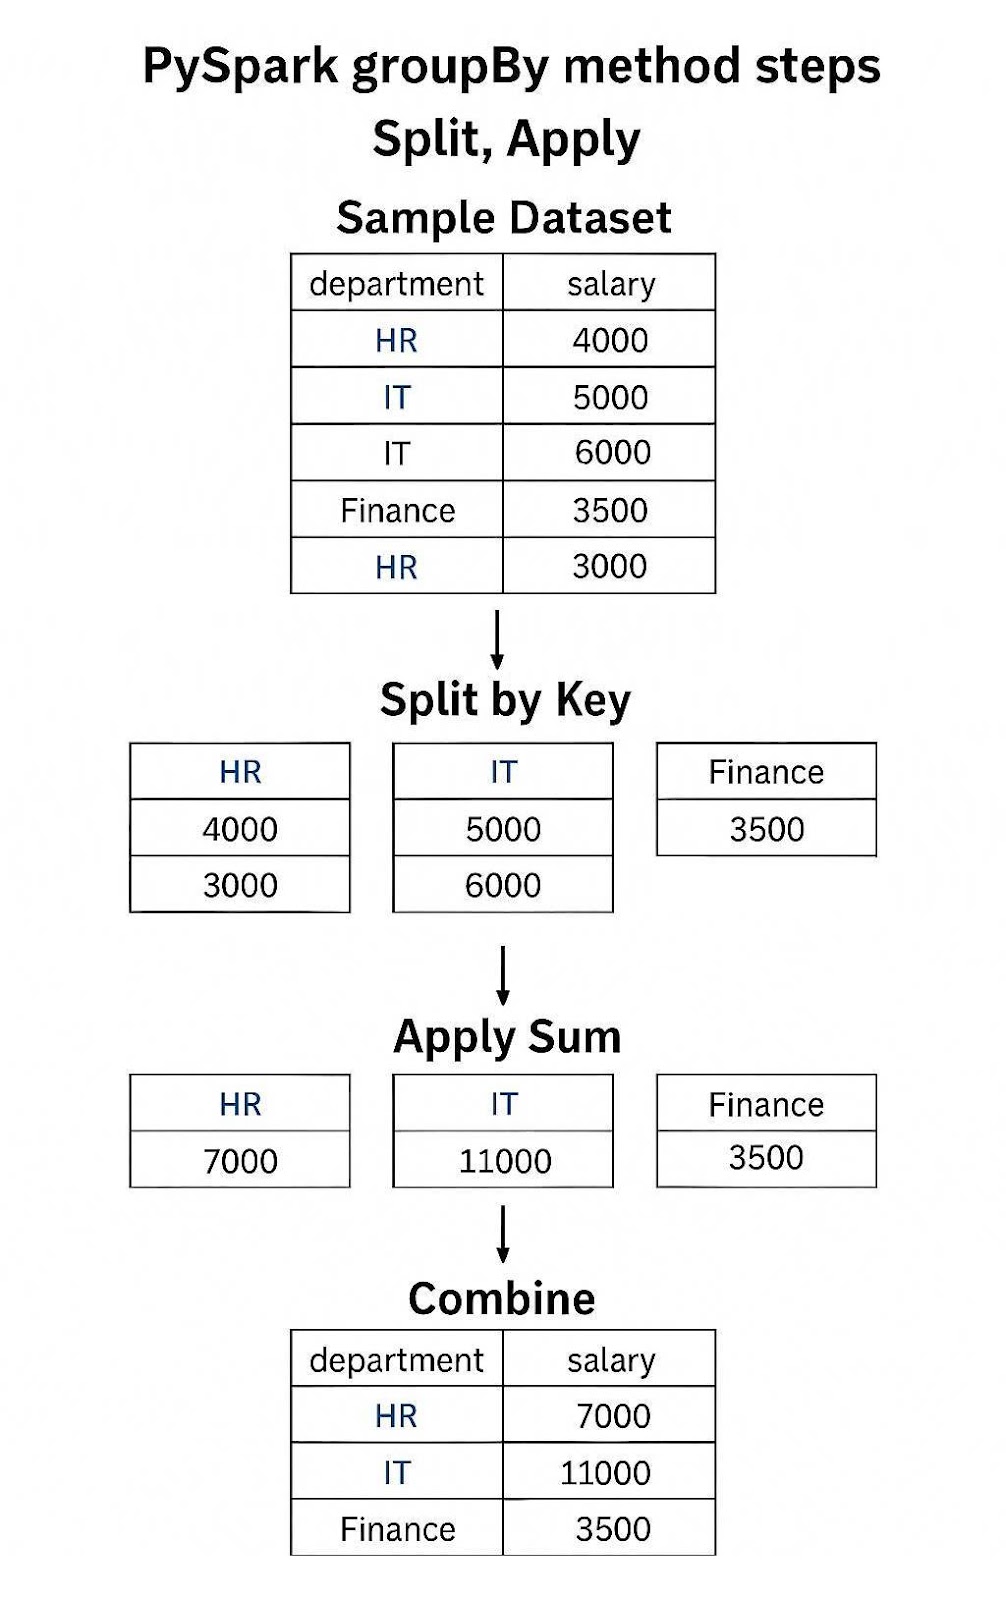
Esempio del metodo groupBy() di PySpark che applica Sum
PySpark sfrutta la valutazione pigra (lazy evaluation), il che significa che operazioni come groupBy vengono calcolate solo quando vengono invocate azioni (come show() o collect()). Invece, PySpark costruisce prima un DAG (Directed Acyclic Graph) iniziale che viene affinato per le prestazioni. Questo aiuta Spark a ottimizzare il piano di query prima dell’esecuzione.
Se non hai ancora avuto modo di lavorare con PySpark, ti consiglio vivamente di dare un’occhiata a Big Data Fundamentals with PySpark.
Per prima cosa, ci serve un DataFrame PySpark. Se ti serve un ripasso dei vari comandi PySpark, consulta questo ottimo cheat sheet sui DataFrame PySpark.
Vedremo alcuni dei passaggi e dei comandi chiave che ci aiuteranno a iniziare con PySpark. Prima di cominciare, assicurati di avere PySpark installato nel tuo ambiente Python, oltre a Java e al Java JDK. Se ti serve assistenza, segui questa guida per iniziare con PySpark.
Il primo passo è far partire PySpark!
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()Costruiamo un DataFrame di esempio su cui lavorare.
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()Output:
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
+----------+--------+------+Il groupBy di PySpark è una trasformazione usata per suddividere i dati in gruppi in base a una o più colonne, che poi possono essere aggregati o trasformati in modo indipendente.
Usare il metodo groupBy è semplice; puoi richiamarlo sul dataframe di interesse. Puoi usarlo su qualsiasi tipo di colonna purché sia adatto alla partizione. Ad esempio, potresti voler evitare i float.
grouped = df.groupBy("department")Questo crea un oggetto GroupedData, che non è un DataFrame in sé. Indica a Spark come iniziare a partizionare i dati. Una volta ottenuto questo oggetto GroupedData, puoi applicare aggregazioni .count() o .sum() per ottenere un nuovo DataFrame.
grouped.count().show()L’unico parametro del metodo è *cols, che accetta nomi di colonne, espressioni di colonne, indici di colonne (int) o una lista di colonne. Finché la colonna è qualcosa su cui vuoi partizionare, puoi usarla nell’operazione. Restituisce sempre un oggetto GroupedData.
# raggruppare per nome colonna come sopra
	df.groupBy("department")

# raggruppare per espressione di colonna
	df.groupBy(df.department)

# raggruppare per indice di colonna
	df.groupBy(1)

# raggruppare per lista di colonne, puoi mescolare i metodi!
df.groupBy(["department", 2])Come mostrato sopra, puoi raggruppare su una o più colonne. Una singola colonna è ottima quando ti interessa un solo asse, come reparti o anni. Più colonne sono utili se vuoi più livelli di dettaglio, ad esempio specifici venditori in reparti diversi, o mesi specifici all’interno di un anno.
# raggruppare per singola colonna
	df.groupBy("department").sum(“salary”).show()

# raggruppare per più colonne
	df.groupBy(["department", 2]).sum(“salary”).show()
Come avrai notato, il metodo groupBy funziona in modo molto simile alle istruzioni GROUP BY di SQL. Più avanti mostreremo anche un modo per usare quel linguaggio in PySpark.
PySpark supporta un’ampia gamma di metodi di aggregazione integrati per lavorare con dati raggruppati. Se conosci SQL, molte di queste ti saranno familiari, come count(), sum(), avg() e così via. Per un ripasso, dai un’occhiata alla nostra guida alle funzioni di aggregazione in SQL.
Passiamo in rassegna le funzioni di aggregazione integrate:
count(): conta il numero di record in questa partizionesum(): riassume il totale dei valori numericiavg(): calcola la media dei valori numericimin(): restituisce il valore più piccolo della partizionemax(): restituisce il valore più grande della partizioneOltre alle funzioni di aggregazione, puoi aggiungere il metodo .alias() per rinominare le colonne in modo che siano più comprensibili. Mostreremo un esempio qui sotto.
Invece di eseguire ogni aggregazione indipendentemente, puoi farne più di una alla volta usando il metodo agg(). Ogni aggregazione creerà una nuova colonna nel tuo dataframe. Riduce anche la necessità di chiamare più volte groupBy, migliorando le prestazioni. Non è necessario aggregare sulla stessa colonna con agg(): puoi definire una colonna diversa per ogni funzione di aggregazione.
# After already starting your session
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()Output:
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+Il vantaggio di PySpark è la possibilità di usare schemi di aggregazione più avanzati, come pivotare i dati, eseguire rollup e creare data cube. Puoi anche creare grouping set.
Proprio come creare una tabella pivot in Excel, puoi pivotare i tuoi dati su colonne diverse. In questo caso, stiamo raggruppando per department e facendo pivot sulla colonna employee per vedere il salario totale di ciascun dipendente.
Questo significa che ogni riga mostra il reparto e ogni colonna i dipendenti di quel reparto. Puoi intuire quanto sarebbe potente se avessimo dati per anno e volessimo vedere come si è comportato ogni reparto anno su anno.
df.groupBy("department").pivot("employee").sum("salary").show()Due modi molto potenti per aggregare i dati sono rollup() e cube(). Mentre un semplice groupby() mostrerebbe i risultati per le aggregazioni esistenti, rollup() e cube() sono entrambe strutture gerarchiche. Significa che aggregano i dati a un livello più granulare.
Ad esempio, rollup() aggrega da sinistra a destra, mostrando ogni possibile permutazione se seguissimo le iterazioni passo dopo passo. Per ogni reparto mostriamo ogni persona nel reparto e anche il gruppo finale di chi non rientra.
D’altra parte, cube() mostra tutte le permutazioni possibili per tutte le colonne aggregate, quindi per ogni reparto separatamente, ogni dipendente separatamente e ogni combinazione di entrambi.
In sintesi:
Puoi vedere un esempio nel codice e nell’output qui sotto:
rollup() Codice:
# using rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() Output:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() Codice:
#using cube
df.cube("department", "employee").sum("salary").show()
cube() Output:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+I grouping set ti permettono di definire più livelli di aggregazione. In questo esempio, sto aggregando a livello di reparto e dipendente, a livello di reparto e a tutti i livelli per ottenere il salario totale.
Noterai che la sintassi è un po’ diversa per il metodo groupingSets(). Prima definisci la lista dei set [(“department”, “employee”), (“department”, ), ()] dove il primo set è reparto e dipendente, il secondo set sono solo i reparti e l’ultimo set di () significa tutti.
Definisci poi le colonne di aggregazione all’interno dei set. Il resto si scrive come al solito usando .agg().
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()Output:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+Infine, possiamo creare funzioni di aggregazione personalizzate usando le User Defined Functions (UDF) in PySpark. Esistono due modi: udf e pandas_udf. Entrambi permettono di creare funzioni personalizzate, ciascuno con pro e contro.
La udf standard di Spark ti consente di creare funzioni native Spark. Ciò significa che la sintassi e i tipi di dato devono funzionare nativamente in Spark. Pur limitando alcune possibilità all’interno della UDF, ti permette di sfruttare appieno la potenza computazionale distribuita di Spark ed è migliore per dataset di grandi dimensioni.
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
D’altra parte, pandas_udf ti consente di creare funzioni personalizzate più “pythoniche”. Ora sei vincolato solo a ciò che è possibile in Pandas e non solo in Spark.
Tuttavia, questo significa che non puoi sfruttare la potenza computazionale distribuita di Spark e ti affidi al calcolo locale. È più adatto a dataset piccoli o medio-piccoli.
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
In generale, conviene usare funzioni personalizzate solo se e solo se non esistono modi migliori per eseguire l’aggregazione. Non reinventare la ruota!
Inoltre, se qualcosa può essere vettorizzato (come le funzioni sopra), scegli una versione vettorizzata della funzione invece di una UDF di aggregazione. Per ulteriori informazioni su groupBy(), leggi questo articolo che approfondisce il framework split-apply-combine con pandas.
In PySpark, puoi filtrare i gruppi in base a metriche aggregate post-raggruppamento usando il metodo filter(). In questo metodo fornisci una condizione, in espressioni Python o SQL.
A tal proposito, puoi anche usare where() se preferisci, poiché è semplicemente un alias di filter() e svolge la stessa operazione.
Puoi scegliere se filtrare prima o dopo l’aggregazione. Filtrare prima inciderà sull’aggregazione limitando i dati che vengono aggregati e può migliorare le prestazioni.
Ad esempio, magari vogliamo contare solo il numero di dipendenti sopra una certa retribuzione per trovare il numero di dipendenti “ad alto salario”.
#filter per salari alti
filter_df = df.filter(df.salary > 4000)

#aggregare e trovare il totale dei dipendenti con salario alto
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
Tuttavia, filtrare dopo l’aggregazione non influenzerà l’aggregazione originale. Magari vogliamo contare tutti i dipendenti in un reparto e poi vedere solo i reparti sopra una certa dimensione. Questo aggiunge uno strato extra di elaborazione, ma non dovrebbe aumentare molto il carico computazionale.
# creare un dataframe che conta il numero di dipendenti
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# filtrare per reparti con più di 1 dipendente
agg_df.where("num_employees > 1").show()
Scegli con attenzione quando filtrare, perché influirà sull’accuratezza e sul risultato finale. Filtrare prima può ridurre il totale finale, mentre filtrare dopo può lasciare troppi elementi nella risposta finale.
Sebbene PySpark ottimizzi automaticamente l’operazione groupBy, esistono strategie che possono migliorare ulteriormente la velocità di elaborazione. Elementi come la minimizzazione dello shuffle dei dati, la mitigazione dello skew e l’ottimizzazione dell’esecuzione contribuiscono tutti a migliorare le prestazioni di groupBy.
groupBy causa uno shuffle, che ridistribuisce i dati tra le partizioni per raggruppare insieme le chiavi simili. Gli shuffle sono intensivi per rete e disco, quindi ridurli o ottimizzarli è cruciale. Ecco alcune tecniche chiave di ottimizzazione:
repartition() con criterio: puoi dire a PySpark in base a quale colonna partizionare i dati in modo che cerchi in meno punti i datiEcco alcuni esempi di come migliorare la gestione dello shuffle.
# ridurre il numero di partizioni di shuffle
spark.conf.set("spark.sql.shuffle.partitions", "64")  # Regola in base alla dimensione del cluster

# assicurarsi che spark comprima i dati
spark.conf.set("spark.shuffle.compress", "true") # comprime il trasferimento in rete
spark.conf.set("spark.shuffle.spill.compress", "true") # comprime gli spill su disco

# ripartiziona i dati prima del raggruppamento per ottimizzare l'aggregazione
df.repartition("department").groupBy("department").sum("salary").show()Lo skew dei dati si verifica quando alcune chiavi compaiono in proporzione molto maggiore rispetto ad altre, causando carichi di partizione sbilanciati e task lenti. Questo mette più pressione su alcuni worker rispetto ad altri. Possiamo ridurre lo skew e distribuire il lavoro in modo più uniforme usando salting, minimizzando join sbilanciati e broadcast join per dimensioni più piccole.
# Esempio di salting:

df = df.withColumn("salted_key", sf.rand()) #Crea colonna di numeri casuali
df = df.repartition(2, 'salted_key') # usa questo per ripartizionare i dati
df.groupBy(sf.spark_partition_id()).count().show()I piani di esecuzione logici e fisici dei job PySpark possono essere ottimizzati con funzionalità integrate. Queste possono migliorare le prestazioni delle tue aggregazioni groupBy.
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # puoi mettere in cache i risultati intermedi

# usa il broadcasting (pseudocodice qui):
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
Per maggiori dettagli su come ottimizzare le operazioni di PySpark, leggi questo articolo sui join in PySpark per capire alcuni meccanismi interni.
Sebbene la DataFrame API sia l’interfaccia consigliata per la maggior parte degli utenti PySpark grazie a un livello di astrazione più alto ed efficienza prestazionale, merito del Catalyst Optimizer, comprendere il livello Resilient Distributed Dataset (RDD) può essere utile, specialmente per chi vuole più controllo o sta migrando codice Spark legacy. In generale, però, usare la DataFrame o la SQL API offre prestazioni migliori.
L’RDD è il componente fondamentale di PySpark, su cui si basa tutto (inclusa la DataFrame API). Tende a lavorare in memoria e gestisce lo streaming dei dati un po’ meglio della DataFrame API. Tuttavia, i dati sono immutabili e quindi non possono essere modificati una volta creato l’RDD.
Questa sezione confronta groupBy nella DataFrame API con i suoi equivalenti nella RDD API, analizzando sia le prestazioni sia l’adeguatezza ai casi d’uso.
Per prima cosa, trasformiamo il dataframe in un RDD.
# Convert DataFrame to RDD of (key, value)
rdd = df[['department','salary']].rdd
rdd.collect()
Ora possiamo eseguire operazioni come groupByKey() e reduceByKey() sull’RDD. Vediamo prima groupByKey().
Il metodo groupByKey() invia tutte le valori con la stessa chiave allo stesso executor e poi li raggruppa. Per questo motivo, può volerci molto tempo affinché i dati vengano rimescolati verso la chiave giusta. Questo può anche portare a skew dei dati.
rdd.groupByKey().mapValues(list).collect()Invece, possiamo provare il metodo reduceByKey(). Questo metodo aggrega prima su ogni partizione e poi sposta i dati sulla rete. Ciò minimizza la quantità di dati rimescolati e di conseguenza funziona più velocemente.
Quindi, reduceByKey è fortemente preferito rispetto a groupByKey perché riduce in modo significativo le operazioni di shuffle.
In pratica, aggrega in ogni partizione, poi combina i dati e poi li aggrega insieme. È ideale per aggregazioni che riuniscono le chiavi, come sum() e max().
from operator import add

rdd.reduceByKey(add).collect()Ecco una tabella che riassume i vantaggi di ciascun metodo di aggregazione.
|
Caratteristica |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
Livello di astrazione |
Alto |
Basso |
Basso |
|
Esecuzione ottimizzata |
Sì (Catalyst & Tungsten) |
No |
No |
|
Minimizzazione dello shuffle |
Sì |
❌ (Shuffle completo) |
✅ (Con combiner) |
|
Efficienza della memoria |
Alta |
Bassa |
Media–Alta |
|
Flessibilità |
Moderata |
Alta |
Media |
|
Prestazioni su Big Data |
Eccellenti |
Scarse |
Buone |
|
Uso consigliato |
Nella maggior parte dei casi |
Raro/specializzato |
Aggregazioni personalizzate, basso livello |
Il corso Big Data Fundamentals with PySpark copre in dettaglio la programmazione con gli RDD e descrive come costituiscano l’ossatura di PySpark.
Un altro modo per eseguire aggregazioni in PySpark è usare la SQL API per scrivere istruzioni in SQL. Può essere un’ottima strada se ti senti più a tuo agio a scrivere SQL.
Il primo passo è creare una vista temporanea usando il metodo createOrReplaceTempView() del DataFrame. Poi puoi usare spark.sql() per scrivere la tua istruzione.
# Create a temporary view using the DataFrame
df.createOrReplaceTempView("employees")

# Write a SQL-like statement
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()Output:
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
Come vedi, è facile quanto scrivere una normale query SQL. Il momento principale per usare la SQL API è per familiarità e per scrivere le query con più facilità. La DataFrame API spesso è migliore perché fornisce tipi di dato coerenti e di solito ottimizza meglio.
Con essa puoi accedere a metodi dei DataFrame a cui non avresti accesso con la Spark SQL API. Per maggiori informazioni sul GROUP BY in SQL, puoi leggere questo articolo su GROUP BY e HAVING in SQL.
Ci sono molte applicazioni reali per l’aggregazione dei dati. Anzi, è quasi certo che dovrai aggregare i dati in qualche modo per analizzarli e condividerli.
Di seguito forniremo alcuni esempi di diversi casi d’uso delle aggregazioni. Alcuni potrebbero essere pseudo-codice o non perfettamente applicabili al nostro dataset di test, ma servono a darti un’idea di come potresti scrivere queste aggregazioni.
Un tema comune di cui abbiamo parlato è l’idea di usare groupBy come mezzo di analisi gerarchica. Immagina di avere una colonna “revenue” e fossi interessato a come si è comportato ciascun reparto. Possiamo raggruppare per reparto e valutare il contributo di ricavi di ogni reparto.
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()Le aggregazioni ti danno accesso alle funzioni finestra. Queste funzioni considerano una finestra scorrevole di dati, in sequenza per righe o per periodi di tempo.
Definiamo prima una finestra usando l’oggetto Window per indicare cosa vogliamo partitonBy e orderBy. Usiamo poi questo oggetto nel metodo over() della funzione di aggregazione scelta. Ad esempio, una media mobile sarebbe sf.avg().over(window).show().
Immagina di voler vedere una media mobile dei salari per ogni reparto. Raggrupperemmo per department e ordineremmo per una nuova colonna che possiamo chiamare employeeId. Poiché gli ID dipendente sono spesso sequenziali, possiamo vedere come è cambiato nel tempo il salario medio.
from pyspark.sql.window import Window

#Define the window we wish to partition and order by
windowSpec = Window.partitionBy("department").orderBy("employeeId")

#Perform the sf.avg function on the “salary” column over the windowSpec.
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
Questo è molto simile a come faremmo le funzioni finestra in SQL.
Magari vogliamo capire metriche utente diverse per la nostra media company. Vogliamo cose come tempo totale di visione e video unici. Possiamo fare groupBy() sulla colonna user_id seguito da .agg() con funzioni diverse come sum() e countDistinct() per metriche differenti.
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), #somma dei minuti visti
    sf.countDistinct("video_id").alias("unique_views") #conteggio dei video unici visti
).show()Quando aggreghi dati in PySpark, è facile cadere in alcune trappole che portano a prestazioni scarse e tempi di esecuzione lunghi. Seguire queste best practice aiuta a garantire prestazioni, correttezza e scalabilità.
Ecco alcuni modi comuni con cui si trasformano query semplici in programmi a lunga esecuzione.
groupByKey() negli RDD:groupByKey() negli RDD, poiché il suo meccanismo fa sì che PySpark effettui shuffle dei dati tra le partizioni. Questo può comportare molto overhead di rete e disco.reduceByKey() o resta sulla DataFrame API.repartition().sum() in un groupBy e poi count() sullo stesso dataset raggruppato in un’altra riga, porta a piani inefficienti rompendo la capacità di ottimizzazione di PySpark.persist() o cache() quando riutilizzi dati raggruppati.Ecco alcuni modi per ottimizzare le tue aggregazioni PySpark e mantenerle fluide!
na.fill() o na.drop() prima dell’aggregazione.df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions in base al volume di dati e verifica quale numero di partizioni funziona meglio per i tuoi dati..explain() per capire l’esecuzione fisica.df.groupBy("department").sum("salary").explain(True)Output:
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
Spark ha molte configurazioni che possono essere ottimizzate per carichi di lavoro groupBy ampi. Consulta la tabella qui sotto per alcune configurazioni chiave.
|
Configurazione |
Descrizione |
|
|
Controlla il numero di partizioni per gli shuffle. Riduci per job piccoli, aumenta per quelli grandi. (Default: 200) |
|
|
Abilita il broadcast automatico delle tabelle piccole. Imposta a -1 per disabilitare o aumenta per supportare join più grandi. (Default: 10MB) |
|
|
Controlla la memoria disponibile per ogni executor. Aumentala per aggregazioni ampie. (Default: 4g) |
|
|
Abilita l’Adaptive Query Execution (AQE), che può ottimizzare dinamicamente shuffle, skew e join. (Default: true) |
Per utenti avanzati o per chi lavora con dataset molto grandi, capire come groupBy si comporta “sotto il cofano” è essenziale. Vediamo alcuni dettagli su come funziona questo metodo.
Tutte le operazioni sui DataFrame in PySpark, incluso groupBy, sono valutate in modo lazy. Significa che non avviene alcun calcolo finché non viene attivata un’azione (come show() o collect()).
Questo permette al Catalyst optimizer di riordinare, combinare o rimuovere operazioni per migliorare le prestazioni. Sfrutta questo aspetto concatenando più aggregazioni e metodi, così Spark può creare un piano ottimizzato.
Quando usi groupBy() viene restituito un oggetto GroupedData. Eseguire una funzione di aggregazione, come sum(), restituisce poi un oggetto simile a un DataFrame. Se usi show() ne vedrai i risultati.
Ricorda che groupBy().agg() restituisce un nuovo DataFrame con colonne rinominate. Usa sempre alias con il metodo alias() per evitare collisioni di nome e rendere gli output più chiari. Se lasci colonne senza alias, potresti incorrere in collisioni di nomi o problemi con i join più avanti.
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)Da notare che in PySpark l’aggregazione restituita non preserva l’ordine delle righe. Usa orderBy() per output prevedibili e un ordinamento coerente delle righe.
df.groupBy("department").sum("salary").orderBy("department").show()Esistono alcuni cambiamenti e limitazioni specifici per ciascuna versione di PySpark. Catalyst è stato introdotto nella 1.3 e notevolmente migliorato nella 2.0. Alcuni metodi sono stati introdotti solo in versioni successive di PySpark, come groupingSets().
Ecco una tabella che copre alcuni dei cambiamenti funzionali più importanti per PySpark. Assicurati di usare la versione giusta di Spark e PySpark per le funzionalità di cui hai bisogno!
|
Caratteristica |
Versione Spark |
Descrizione |
|
|
1.4+ |
Aggregazioni gerarchiche utili in analytics stile OLAP (3.4+ supporta Spark Connect) |
|
|
2.3+ |
UDF vettorizzate con Apache Arrow per esecuzione più rapida (3.4+ supporta Spark Connect, 4.0+ supporta SCALAR) |
|
Adaptive Query Execution (AQE) |
3.0+ |
Regola dinamicamente join, shuffle e gestione dello skew a runtime |
|
Modalità di compatibilità ANSI SQL |
3.0+ |
Segnalazione errori e comportamento delle espressioni più accurati |
|
|
4.0+ |
Consente più raggruppamenti in un’unica aggregazione (ad es., per subtotali) |
La funzione groupBy di PySpark è uno strumento essenziale per l’aggregazione dei dati in ambienti distribuiti. Che si tratti di sintetizzare dati per regione, calcolare metriche medie o eseguire analisi multilivello complesse, groupBy offre un’API scalabile e flessibile per gestire carichi di lavoro su big data.
Ricorda solo queste best practice per minimizzare tempi e costi:
Man mano che PySpark evolve, possiamo aspettarci ottimizzazioni ancora più intelligenti, supporto nativo per aggregazioni complesse e una migliore integrazione con Pandas e la sintassi in stile SQL. Potrebbe anche offrire un’integrazione migliore per modelli su larga scala. Se vuoi saperne di più su PySpark, dai un’occhiata a queste risorse dettagliate di DataCamp:
I migliori corsi su PySpark
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



