Curso
Fundamentos de PySpark
4 h
157.8K
En el mundo del big data, rara vez trabajamos con datos en bruto. Para hacerlos más manejables, agrupar y agregar datos es una operación habitual y muy potente. Cuando trabajas con sistemas distribuidos como Apache Spark y Python, contar con la función groupBy de PySpark te permite reunir y resumir datos distribuidos. Refleja la funcionalidad de la cláusula GROUP BY de SQL, pero está diseñada para procesar datos distribuidos en conjuntos masivos de forma eficiente.
El groupBy de PySpark permite particionar datos en función de distintas columnas, que luego se pueden agregar en medidas como sumas, medias, etc. Para hacerlo de forma eficiente, PySpark sigue el paradigma split-apply-combine:
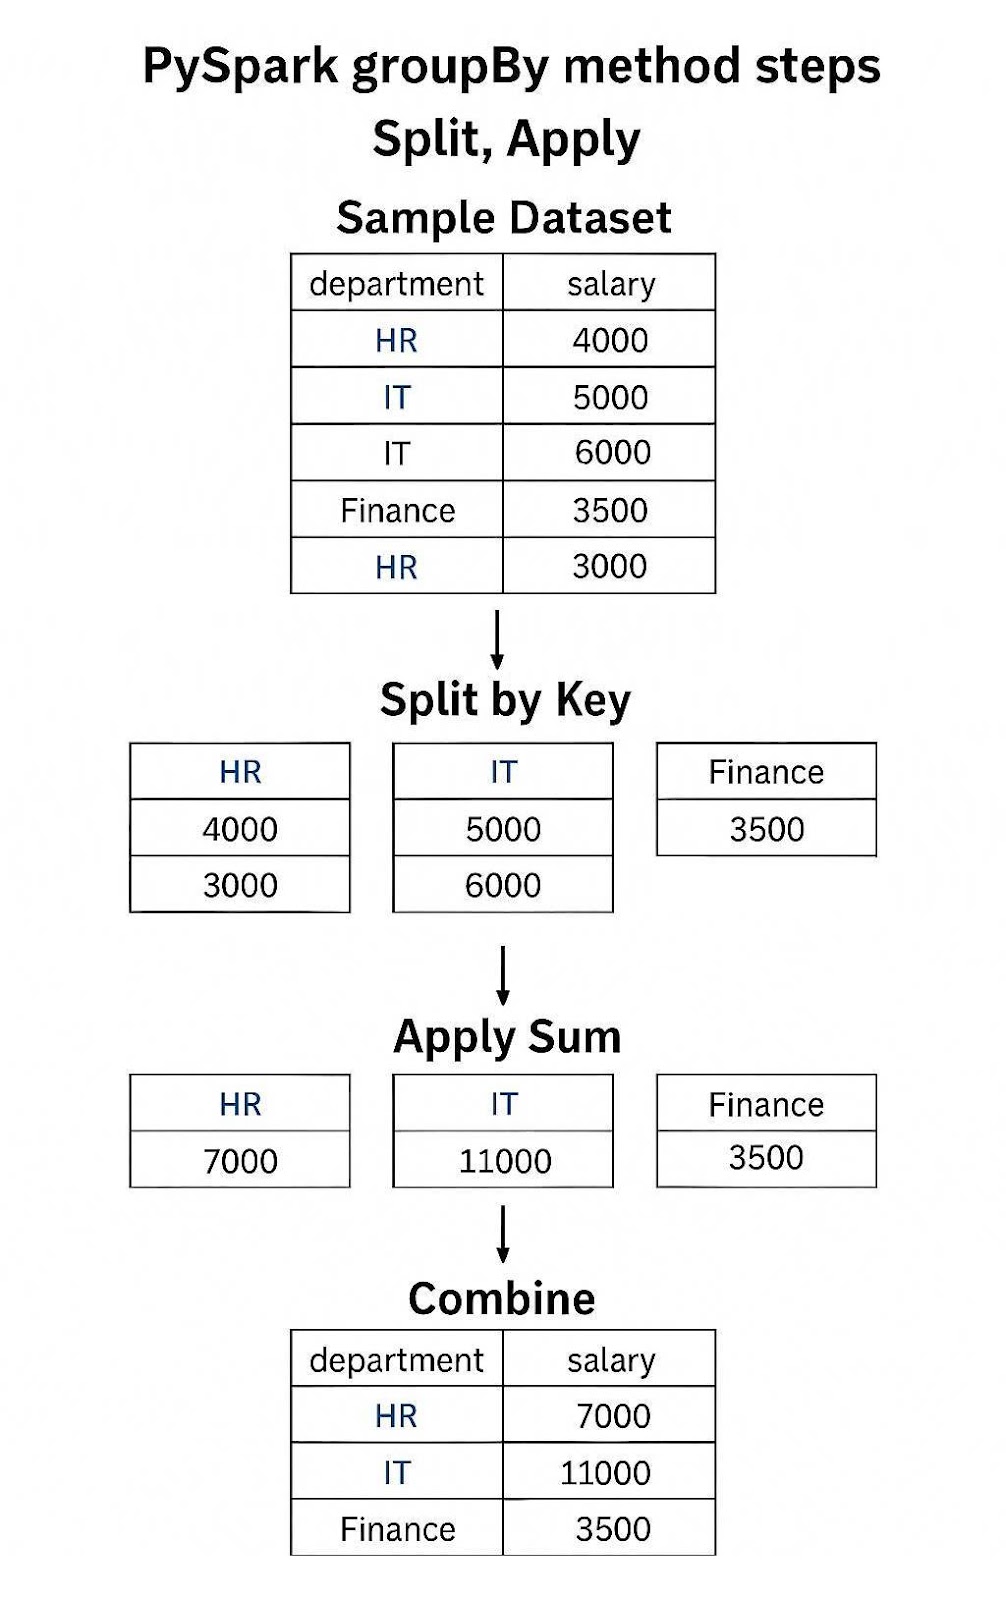
Ejemplo del método groupBy() de PySpark aplicando Sum
PySpark emplea evaluación perezosa (lazy), es decir, operaciones como groupBy solo se computan cuando se lanzan acciones (como show() o collect()). Antes, PySpark construye un DAG (grafo acíclico dirigido) inicial que se refina para mejorar el rendimiento. Esto ayuda a Spark a optimizar el plan de consulta antes de ejecutarlo.
Si aún no has trabajado con PySpark, te recomiendo repasar los fundamentos de Big Data con PySpark.
Lo primero es tener un DataFrame de PySpark. Si necesitas refrescar los distintos comandos de PySpark, echa un vistazo a esta chuleta de DataFrames de PySpark.
Veremos algunos pasos y comandos clave para ponernos en marcha con PySpark. Antes de empezar, asegúrate de tener PySpark instalado en tu entorno de Python, además de Java y el JDK de Java. Si necesitas ayuda, sigue esta guía para empezar con PySpark.
¡El primer paso es poner PySpark en marcha!
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()Vamos a crear un DataFrame de ejemplo para trabajar.
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()Salida:
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
+----------+--------+------+El groupBy de PySpark es una transformación que divide los datos en grupos basándose en una o varias columnas, que después se pueden agregar o transformar de forma independiente.
Usar el método groupBy es sencillo: lo llamas sobre el dataframe que te interesa. Puedes emplearlo con cualquier tipo de columna siempre que tenga sentido particionar por ella. Por ejemplo, suele evitarse particionar por floats.
grouped = df.groupBy("department")Esto crea un objeto GroupedData, que no es un DataFrame en sí. Le indica a Spark cómo empezaría a particionar los datos. Una vez tienes este objeto GroupedData, puedes aplicar agregaciones como .count() o .sum() para obtener un nuevo DataFrame.
grouped.count().show()El único parámetro del método es *cols, que acepta nombres de columna, expresiones de columna, índices de columna (int) o una lista de columnas. Mientras sea una columna por la que quieras particionar, podrás usarla en la operación. Siempre devuelve un objeto GroupedData.
# grouping by column name like above
	df.groupBy("department")

# grouping by column expression
	df.groupBy(df.department)

#grouping by column ordinal
	df.groupBy(1)

#grouping by list of columns, you can mix the methods!
df.groupBy(["department", 2])Como se ve arriba, puedes agrupar por una o varias columnas. Una sola columna es ideal si solo te interesa un eje, como departamentos o años. Varias columnas son útiles para añadir capas de detalle, por ejemplo, comerciales concretos en distintos departamentos, o meses específicos dentro de un año.
# grouping by single column
	df.groupBy("department").sum(“salary”).show()

#grouping by multiple columns
	df.groupBy(["department", 2]).sum(“salary”).show()
Como habrás notado, el método groupBy funciona de forma muy similar a las sentencias GROUP BY de SQL. Más adelante veremos cómo usar también ese lenguaje en PySpark.
PySpark incluye un amplio abanico de métodos de agregación integrados para trabajar con datos agrupados. Si conoces SQL, te sonarán muchos de ellos como count(), sum(), avg(), etc. Puedes repasar en nuestra guía de funciones de agregación en SQL.
Repasemos las funciones integradas:
count(): cuenta el número de registros en la particiónsum(): resume el total de los valores numéricosavg(): calcula la media de los valores numéricosmin(): devuelve el valor más pequeño de la particiónmax(): devuelve el valor más grande de la particiónAdemás, puedes encadenar el método .alias() para renombrar columnas y hacerlas más claras. Lo veremos en un ejemplo a continuación.
En lugar de realizar cada agregación por separado, puedes hacer varias de una vez con el método agg(). Cada agregación creará una nueva columna en tu dataframe. También reduce la necesidad de múltiples llamadas a groupBy, lo que mejora el rendimiento. No es necesario agregar sobre la misma columna en agg(): puedes definir una columna distinta para cada función de agregación.
# After already starting your session
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()Salida:
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+La ventaja de PySpark es poder usar patrones de agregación más avanzados, como pivotar datos, realizar rollups y crear cubos de datos. También puedes crear grouping sets.
Igual que en una tabla dinámica de Excel, puedes pivotar tus datos por distintas columnas. En este caso, agrupamos por department y pivotamos sobre la columna employee para ver el salario total de cada persona.
Esto significa que cada fila muestra el departamento y cada columna serían los empleados de ese departamento. Imagina el potencial si tuviéramos datos por año y quisiéramos ver la evolución de cada departamento año a año.
df.groupBy("department").pivot("employee").sum("salary").show()Dos formas muy potentes de agregar datos son rollup() y cube(). Mientras que un groupby() normal muestra los resultados de las agregaciones existentes, rollup() y cube() generan estructuras jerárquicas. Es decir, agregan los datos a distintos niveles de granularidad.
Por ejemplo, rollup() agrega de izquierda a derecha, mostrando cada posible permutación si fuéramos paso a paso. Para cada departamento, mostramos cada persona de ese departamento y también el grupo final que agrega quienes no encajan.
Por su parte, cube() muestra todas las permutaciones posibles para todas las columnas agregadas: cada departamento por separado, cada empleado por separado y todas las combinaciones de ambos.
En resumen:
Puedes ver un ejemplo en el siguiente código y salida:
rollup() Código:
# using rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() Salida:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() Código:
#using cube
df.cube("department", "employee").sum("salary").show()
cube() Salida:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+Los grouping sets te permiten definir múltiples niveles de agregación. En este ejemplo, agrego a nivel de departamento y empleado, a nivel de departamento y a nivel total para obtener el salario global.
Verás que la sintaxis de groupingSets() es algo distinta. Primero defines la lista de conjuntos [(“department”, “employee”), (“department”, ), ()], donde el primero es departamento y empleado, el segundo solo departamentos y el último () significa total.
Luego defines las columnas de agregación dentro de los conjuntos. El resto se escribe como de costumbre usando .agg().
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()Salida:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+Por último, podemos crear funciones de agregación personalizadas usando User Defined Functions (UDFs) en PySpark. Hay dos formas: udf y pandas_udf. Ambas te permiten crear funciones a medida, cada una con sus pros y contras.
El udf estándar de Spark permite crear funciones nativas de Spark. Eso implica que la sintaxis y los tipos de datos deben ser compatibles de forma nativa. Aunque limita lo que puede hacerse en la UDF, te permite aprovechar al máximo la capacidad de cómputo distribuido de Spark y es mejor para conjuntos de datos grandes.
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
Por otro lado, pandas_udf te permite crear funciones personalizadas más “pythónicas”. Estás limitado solo por lo que es posible en Pandas y no únicamente en Spark.
Sin embargo, esto implica que no aprovechas el cómputo distribuido de Spark y dependes del cálculo local. Es mejor para conjuntos de datos pequeños o medianos.
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
En general, usa funciones personalizadas solo si no hay mejores formas de realizar la agregación. ¡No reinventes la rueda!
Además, si algo puede vectorizarse (como nuestras funciones de arriba), opta por una versión vectorizada de la función en lugar de una UDF de agregación. Para más información sobre groupBy(), lee este artículo que profundiza en el marco split-apply-combine con pandas.
En PySpark, puedes filtrar grupos en función de métricas agregadas tras agrupar usando el método filter(). En este método, proporcionas una condición en expresiones de Python o SQL.
Dicho esto, también puedes usar where() si lo prefieres, ya que es un alias de filter() y realiza la misma operación.
Puedes elegir filtrar antes o después de la agregación. Filtrar antes impactará la agregación al limitar qué datos se agregan y puede mejorar el rendimiento.
Por ejemplo, quizá solo queremos contar el número de empleados por encima de cierto salario para identificar empleados con “salario alto”.
#filter for high salaries
filter_df = df.filter(df.salary > 4000)

#aggregate and find the total of high salary employees
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
Sin embargo, filtrar después de la agregación no afectará a la agregación original. Quizá queremos contar a todos los empleados de un departamento y mostrar solo los departamentos por encima de cierto tamaño. Esto añade una capa extra de procesamiento, pero no debería aumentar mucho la carga computacional.
# creating a dataframe counting the number of employees
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# filtering for departments where there is more than 1 employee
agg_df.where("num_employees > 1").show()
Elige bien cuándo filtrar, porque afectará a la precisión y al resultado final. Filtrar antes puede reducir el total final, mientras que filtrar después puede dejar demasiados en la respuesta.
Aunque PySpark optimiza automáticamente la operación groupBy, hay estrategias que pueden mejorar todavía más la velocidad de procesamiento. Minimizar los shuffles de datos, mitigar el sesgo (skew) y optimizar la ejecución son claves para mejorar el rendimiento de groupBy.
groupBy provoca un shuffle, que redistribuye los datos entre particiones para agrupar claves similares. Los shuffles son intensivos en red y disco, así que minimizarlos u optimizarlos es crucial. Algunas técnicas clave:
repartition() con criterio: puedes indicar a PySpark por qué columna particionar para que busque los datos en menos sitios.Aquí tienes ejemplos de cómo mejorar la gestión del shuffle.
# reduce the number of shuffle partitions
spark.conf.set("spark.sql.shuffle.partitions", "64")  # Adjust based on cluster size

# make sure spark compresses the data
spark.conf.set("spark.shuffle.compress", "true") # compresses network transfer
spark.conf.set("spark.shuffle.spill.compress", "true") # compresses disk spillage

# repartitions the data prior to grouping to optimize aggregation
df.repartition("department").groupBy("department").sum("salary").show()El sesgo de datos ocurre cuando ciertas claves aparecen desproporcionadamente más que otras, generando cargas desiguales por partición y tareas lentas. Esto sobrecarga a algunos workers más que a otros. Podemos reducir el skew y distribuir el trabajo de forma más equilibrada mediante salting, minimizando joins sesgados y usando broadcast joins para dimensiones pequeñas.
# Salting example:

df = df.withColumn("salted_key", sf.rand()) #Create column of random
df = df.repartition(2, 'salted_key') # use this to repartition data
df.groupBy(sf.spark_partition_id()).count().show()Los planes lógico y físico de los jobs de PySpark pueden optimizarse con funciones integradas que mejoran el rendimiento de tus agregaciones groupBy.
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # you can cache your intermediate results

# use broadcasting (pseudocode here):
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
Para más detalles sobre cómo optimizar operaciones en PySpark, lee este artículo sobre joins en PySpark para entender mejor lo que ocurre “bajo el capó”.
Aunque la API de DataFrame es la interfaz recomendada para la mayoría de usuarios de PySpark por su mayor nivel de abstracción y eficiencia (gracias a Catalyst), entender la capa de RDD (Resilient Distributed Dataset) puede ser valioso, especialmente si quieres más control o migras código heredado de Spark. En general, la API de DataFrame o SQL te dará mejor rendimiento.
El RDD es el componente base de PySpark, sobre el que se construye todo (incluida la API de DataFrame). Suele trabajar en memoria y maneja mejor el streaming que la API de DataFrame. Sin embargo, los datos son inmutables y no se pueden cambiar una vez creado el RDD.
En esta sección comparamos groupBy en la API de DataFrame con sus equivalentes en la API de RDD, analizando rendimiento y casos de uso.
Primero, convirtamos el dataframe en un RDD.
# Convert DataFrame to RDD of (key, value)
rdd = df[['department','salary']].rdd
rdd.collect()
Ahora podemos ejecutar groupByKey() y reduceByKey() sobre el RDD. Empecemos por groupByKey().
El método groupByKey() baraja (shuffle) todos los valores con la misma clave al mismo executor y luego los agrupa. Por eso puede tardar mucho en mover los datos a la clave correcta y también provocar skew.
rdd.groupByKey().mapValues(list).collect()En su lugar, prueba reduceByKey(). Este método primero agrega en cada partición y luego mueve los datos por la red. Así minimiza la cantidad de datos barajados y funciona más rápido.
Por tanto, reduceByKey se prefiere ampliamente frente a groupByKey porque reduce significativamente las operaciones de shuffle.
Agrega en cada partición, combina los datos y luego vuelve a agregarlos. Es ideal para agregaciones que combinan claves, como sum() y max().
from operator import add

rdd.reduceByKey(add).collect()Aquí tienes una tabla que resume las ventajas de cada método de agregación.
|
Característica |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
Nivel de abstracción |
Alto |
Bajo |
Bajo |
|
Ejecución optimizada |
Sí (Catalyst & Tungsten) |
No |
No |
|
Minimización de shuffles |
Sí |
❌ (Shuffle completo) |
✅ (Con combinador) |
|
Eficiencia de memoria |
Alta |
Baja |
Media–Alta |
|
Flexibilidad |
Moderada |
Alta |
Media |
|
Rendimiento en big data |
Excelente |
Pobre |
Bueno |
|
Uso recomendado |
La mayoría de casos |
Raro/especializado |
Agregaciones a bajo nivel |
El curso Big Data Fundamentals with PySpark cubre la programación con RDD en detalle y describe cómo son la columna vertebral de PySpark.
Otra forma de realizar agregaciones en PySpark es usar la API de SQL para escribir sentencias en SQL. Es una gran opción si te sientes más cómodo escribiendo SQL.
El primer paso es crear una vista temporal mediante createOrReplaceTempView() del DataFrame. Luego puedes usar spark.sql() para escribir tu sentencia.
# Create a temporary view using the DataFrame
df.createOrReplaceTempView("employees")

# Write a SQL-like statement
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()Salida:
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
Como ves, es tan fácil como escribir una consulta SQL normal. La API de SQL suele usarse por familiaridad y por facilitar la escritura de las consultas. La API de DataFrame a menudo es mejor porque mantiene tipos de datos coherentes y suele optimizar más.
Además, accedes a métodos de DataFrame que no tendrías con la API de Spark SQL. Para más información sobre GROUP BY en SQL, puedes leer este artículo sobre GROUP BY y HAVING en SQL.
Hay muchísimos usos reales para agregar tus datos. De hecho, casi seguro tendrás que agregarlos de alguna manera para poder analizarlos y compartirlos.
A continuación, verás ejemplos de distintos casos de uso de agregaciones. Algunos pueden ser pseudocódigo o no encajar exactamente con nuestro dataset de prueba, pero sirven para inspirarte sobre cómo escribir estas agregaciones.
Un tema recurrente es usar groupBy como medio de análisis jerárquico. Imagina que tenemos una columna "revenue" y nos interesa cómo rinde cada departamento. Podemos agrupar por departamento y evaluar la contribución de ingresos de cada uno.
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()Las agregaciones te dan acceso a funciones de ventana. Estas funciones miran una ventana deslizante de datos, ya sea una serie de filas secuenciales o un periodo de tiempo.
Primero definimos una ventana con el objeto Window indicando qué queremos partitonBy y orderBy. Luego usamos este objeto en el método over() de nuestra función de agregación elegida. Por ejemplo, una media móvil sería sf.avg().over(window).show().
Imagina que queremos ver una media móvil de salarios por departamento. Agruparíamos por department y ordenaríamos por una columna nueva que llamaremos employeeId. Como los ID de empleado suelen ser secuenciales, podemos ver cómo ha cambiado el salario medio a lo largo del tiempo.
from pyspark.sql.window import Window

#Define the window we wish to partition and order by
windowSpec = Window.partitionBy("department").orderBy("employeeId")

#Perform the sf.avg function on the “salary” column over the windowSpec.
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
Esto es muy parecido a cómo haríamos funciones de ventana en SQL.
Quizá queremos entender varias métricas de usuario para nuestra compañía de medios. Queremos cosas como el tiempo total de visualización y vídeos únicos. Podemos groupBy() sobre una columna user_id y luego .agg() con funciones como sum() y countDistinct() para distintas métricas.
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), #sum minutes watched
    sf.countDistinct("video_id").alias("unique_views") #count unique videos watched
).show()Al agregar datos en PySpark, es fácil caer en errores que llevan a bajo rendimiento y ejecuciones largas. Seguir estas buenas prácticas te ayuda a garantizar rendimiento, corrección y escalabilidad.
Aquí tienes formas habituales de convertir consultas simples en programas eternos.
groupByKey() en RDD:groupByKey() en RDD, ya que hace que PySpark baraje datos entre particiones. Esto puede generar mucho tráfico de red y E/S de disco.reduceByKey() o mantente en la API de DataFrame.repartition().sum() en un groupBy y luego count() sobre el mismo conjunto agrupado en otra línea) generan planes ineficientes al impedir que PySpark optimice.persist() o cache() cuando reutilices datos agrupados.Aquí tienes ideas para optimizar tus agregaciones en PySpark y que todo fluya.
na.fill() o na.drop() antes de agregar.df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions según el volumen y prueba qué número encaja mejor con tus datos..explain() para entender la ejecución física.df.groupBy("department").sum("salary").explain(True)Salida:
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
Spark tiene muchas configuraciones que pueden ajustarse para cargas de trabajo de groupBy grandes. Consulta la tabla siguiente para ver algunas claves.
|
Configuración |
Descripción |
|
|
Controla el número de particiones para shuffles. Redúcelo para jobs pequeños, auméntalo para grandes. (Por defecto: 200) |
|
|
Activa el broadcast automático de tablas pequeñas. Pon -1 para desactivar o aumenta para joins más grandes. (Por defecto: 10MB) |
|
|
Controla la memoria disponible por executor. Súbela para agregaciones grandes. (Por defecto: 4g) |
|
|
Activa Adaptive Query Execution (AQE), que optimiza dinámicamente shuffles, skew y joins. (Por defecto: true) |
Para usuarios avanzados o quienes tratan con datasets muy grandes, entender cómo se comporta groupBy internamente es esencial. Veamos algunos matices de cómo funciona.
Todas las operaciones de DataFrame en PySpark, incluido groupBy, se evalúan de forma perezosa. Es decir, no se computa nada hasta que se dispara una acción (como show() o collect()).
Esto permite a Catalyst reordenar, combinar o eliminar operaciones para mejorar el rendimiento. Aprovecha esto encadenando múltiples agregaciones y métodos para que Spark cree un plan optimizado.
Cuando usas groupBy() devuelve un objeto GroupedData. Al realizar una función de agregación como sum() devuelve entonces un objeto tipo DataFrame. Si usas show() mostrará los resultados.
Recuerda que groupBy().agg() devuelve un nuevo DataFrame con columnas de nuevo nombre. Usa siempre alias con el método alias() para evitar colisiones y clarificar salidas. Si dejas columnas sin alias, puedes provocar colisiones de nombres o problemas en joins más adelante.
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)Algo a tener en cuenta en PySpark: la agregación devuelta no preserva el orden de las filas. Usa orderBy() para obtener salidas predecibles y orden consistente.
df.groupBy("department").sum("salary").orderBy("department").show()Hay cambios y limitaciones según la versión de PySpark. Catalyst se introdujo en la 1.3 y mejoró notablemente en la 2.0. Algunos métodos no llegaron hasta versiones posteriores, como groupingSets().
Aquí tienes una tabla con algunos de los cambios funcionales más importantes de PySpark. ¡Asegúrate de usar la versión adecuada de Spark y PySpark según las funciones que necesites!
|
Función |
Versión de Spark |
Descripción |
|
|
1.4+ |
Agregaciones jerárquicas útiles en analítica OLAP (3.4+ soporta Spark Connect) |
|
|
2.3+ |
UDF vectorizadas con Apache Arrow para ejecución más rápida (3.4+ soporta Spark Connect, 4.0+ soporta SCALAR) |
|
Adaptive Query Execution (AQE) |
3.0+ |
Ajusta dinámicamente joins, shuffles y gestión de skew en tiempo de ejecución |
|
Modo de compatibilidad ANSI SQL |
3.0+ |
Informes de error y comportamiento de expresiones más precisos |
|
|
4.0+ |
Permite múltiples agrupaciones en una sola agregación (por ejemplo, para subtotales) |
La función groupBy de PySpark es esencial para la agregación de datos en entornos distribuidos. Ya sea para resumir por región, calcular métricas medias o realizar analítica multinivel compleja, groupBy ofrece una API escalable y flexible para cargas de big data.
Recuerda estas buenas prácticas para minimizar tiempos y costes:
A medida que PySpark evolucione, veremos optimizaciones más inteligentes, soporte nativo para agregaciones complejas y mejor integración con Pandas y la sintaxis tipo SQL. Incluso podría integrar mejor modelos a gran escala. Si te interesa aprender más sobre PySpark, explora estos recursos de DataCamp:
Los mejores cursos de PySpark
Curso
Curso
Curso
Tutorial
Natassha Selvaraj
10 min
Tutorial
Eugenia Anello
6 min
Tutorial
Olivia Smith
8 min
Tutorial
Karlijn Willems
15 min
Tutorial
Satyam Tripathi
9 min
Tutorial
DataCamp Team
7 min