
Kurs
Grundlagen von PySpark
4 Std.
157.8K
In der Big-Data-Welt arbeiten wir selten mit Rohdaten. Um Daten greifbar zu machen, ist das Gruppieren und Aggregieren ein gängiger und wirkungsvoller Schritt. In verteilten Systemen wie Apache Spark und Python hilft uns PySparks groupBy-Funktion, verteilte Daten zusammenzuführen und zu verdichten. Sie spiegelt die Funktionalität der SQL-Klausel GROUP BY wider, ist aber speziell darauf ausgelegt, verteilte Datenverarbeitung über riesige Datensätze effizient zu handhaben.
Mit PySparks groupBy kannst du Daten anhand verschiedener Spalten partitionieren und anschließend in Kennzahlen wie Summe, Durchschnitt usw. aggregieren. Dafür folgt PySpark dem Split-Apply-Combine-Prinzip:
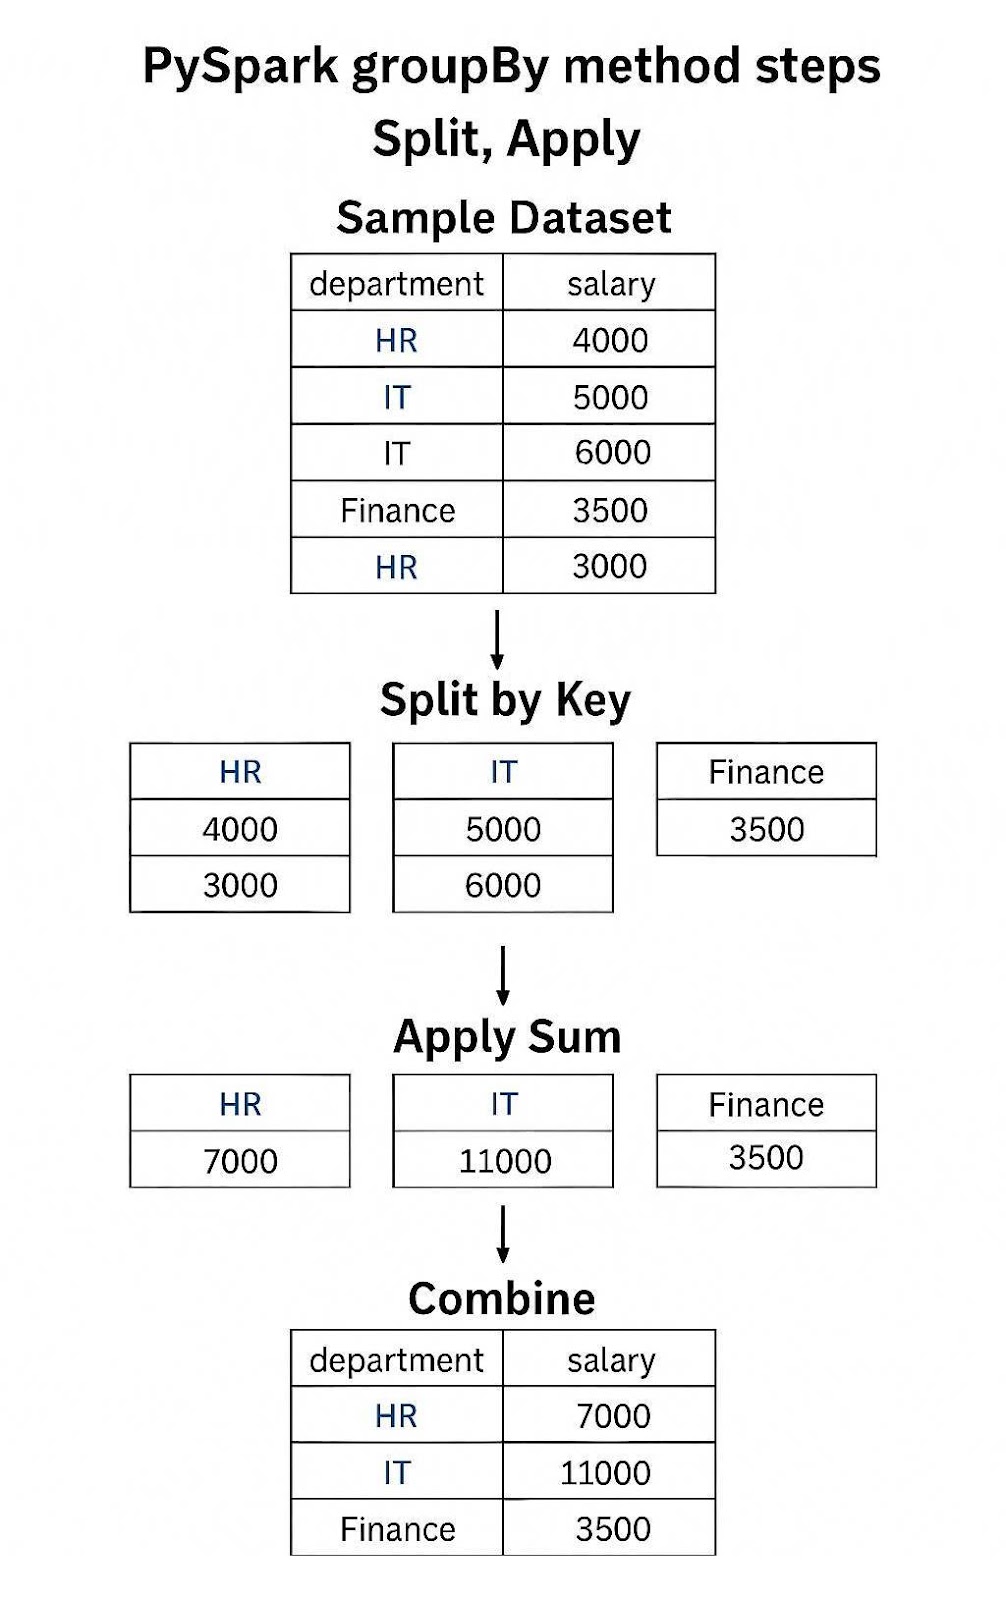
Beispiel: PySparks groupBy()-Methode mit Summe
PySpark setzt auf Lazy Evaluation. Das heißt, Operationen wie groupBy werden erst berechnet, wenn Aktionen (wie show() oder collect()) aufgerufen werden. Zuvor baut PySpark einen initialen DAG (Directed Acyclic Graph) auf, der für Performance optimiert wird. So kann Spark den Abfrageplan vor der Ausführung verbessern.
Falls du noch nicht mit PySpark gearbeitet hast, schau dir die Big Data Fundamentals with PySpark an – sehr empfehlenswert.
Zuerst brauchen wir ein PySpark DataFrame. Wenn du die PySpark-Befehle auffrischen willst, hilft dieses praktische PySpark DataFrame Cheatsheet.
Wir gehen einige Kernschritte und -befehle durch, um mit PySpark loszulegen. Stelle sicher, dass PySpark sowie Java und das Java JDK in deiner Python-Umgebung installiert sind. Wenn du Unterstützung brauchst, folge dieser Anleitung zum Einstieg in PySpark.
Schritt eins: PySpark starten!
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()Erstellen wir ein Beispiel-DataFrame, mit dem wir arbeiten können.
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()Ausgabe:
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
+----------+--------+------+PySpark groupBy ist eine Transformation, die Daten anhand einer oder mehrerer Spalten in Gruppen aufteilt, die dann unabhängig aggregiert oder transformiert werden können.
Die Nutzung von groupBy ist einfach: Rufe die Methode auf dem gewünschten DataFrame auf. Du kannst jede geeignete Spalte verwenden, die sich zum Partitionieren anbietet. Gleitkommazahlen solltest du beispielsweise meist vermeiden.
grouped = df.groupBy("department")Das erzeugt ein GroupedData-Objekt, noch kein DataFrame. Es teilt Spark jedoch mit, wie die Daten partitioniert werden sollen. Auf diesem GroupedData-Objekt kannst du Aggregationen wie .count() oder .sum() anwenden und so ein neues DataFrame erhalten.
grouped.count().show()Der einzige Parameter der Methode ist *cols. Er akzeptiert Spaltennamen, Spaltenausdrücke, Spaltenindizes (int) oder eine Liste von Spalten. Solange es eine sinnvolle Partitionierungsspalte ist, kannst du sie verwenden. Zurückgegeben wird immer ein GroupedData-Objekt.
# Gruppierung nach Spaltenname wie oben
	df.groupBy("department")

# Gruppierung per Spaltenausdruck
	df.groupBy(df.department)

# Gruppierung per Spaltenindex
	df.groupBy(1)

# Gruppierung nach Spaltenliste – Methoden lassen sich mischen!
df.groupBy(["department", 2])Wie gezeigt, kannst du nach einer oder mehreren Spalten gruppieren. Eine einzelne Spalte eignet sich, wenn dich eine Achse interessiert, z. B. Abteilungen oder Jahre. Mehrere Spalten liefern zusätzliche Detailebenen, etwa einzelne Verkäufer innerhalb von Abteilungen oder Monate innerhalb eines Jahres.
# Gruppierung nach einer Spalte
	df.groupBy("department").sum(“salary”).show()

# Gruppierung nach mehreren Spalten
	df.groupBy(["department", 2]).sum(“salary”).show()
Wie du sicher bemerkt hast, ähnelt groupBy stark SQLs GROUP BY. Später zeigen wir auch, wie du diese Sprache in PySpark verwendest.
PySpark unterstützt eine große Bandbreite an eingebauten Aggregationsmethoden für gruppierte Daten. Wenn du SQL kennst, kommen dir viele davon bekannt vor, etwa count(), sum(), avg() usw. Eine Auffrischung findest du in unserem Guide zu Aggregatfunktionen in SQL.
Die wichtigsten eingebauten Aggregationsfunktionen:
count(): Zählt die Anzahl der Zeilen in dieser Partition.sum(): Bildet die Summe numerischer Werte.avg(): Berechnet den Durchschnitt numerischer Werte.min(): Liefert den kleinsten Wert der Partition.max(): Liefert den größten Wert der Partition.Zusätzlich kannst du mit .alias() Spalten umbenennen, damit Ergebnisse leichter verständlich sind. Ein Beispiel folgt.
Statt jede Aggregation separat auszuführen, kannst du mit agg() mehrere Aggregationen gleichzeitig definieren. Jede Aggregation erzeugt eine neue Spalte im DataFrame. Das reduziert die Anzahl der groupBy-Aufrufe und verbessert die Performance. Du musst nicht auf derselben Spalte aggregieren: Für jede Funktion lässt sich eine andere Spalte angeben.
# Nachdem die Session bereits läuft
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()Ausgabe:
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+Ein großer Vorteil von PySpark sind erweiterte Muster wie Pivot, Rollup und Data Cubes. Du kannst auch Grouping Sets erstellen.
Ähnlich wie bei einer Pivot-Tabelle in Excel kannst du Daten über Spalten drehen. Hier gruppieren wir nach department und pivotieren über die Spalte employee, um die Gehaltssumme je Mitarbeiter zu sehen.
Das bedeutet: Jede Zeile zeigt die Abteilung, jede Spalte die Mitarbeitenden dieser Abteilung. Besonders stark wird das mit Jahresdaten, wenn du die Entwicklung je Abteilung Jahr für Jahr sehen willst.
df.groupBy("department").pivot("employee").sum("salary").show()Zwei sehr mächtige Arten zu aggregieren sind rollup() und cube(). Während ein einfaches groupBy() nur die existierenden Aggregationsebenen zeigt, sind rollup() und cube() hierarchische Strukturen, die feiner aggregieren.
Zum Beispiel aggregiert rollup() von links nach rechts und zeigt jede mögliche Zwischenstufe. Für jede Abteilung siehst du die einzelnen Personen sowie die Gesamtsumme.
cube() hingegen erzeugt alle möglichen Kombinationen der angegebenen Spalten: jede Abteilung separat, jede Person separat und jede Kombination daraus.
Kurz zusammengefasst:
Ein Beispiel siehst du unten in Code und Ausgabe:
rollup() Code:
# using rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() Ausgabe:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() Code:
#using cube
df.cube("department", "employee").sum("salary").show()
cube() Ausgabe:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+
Grouping Sets erlauben mehrere Aggregationsebenen in einem Schritt. Im Beispiel aggregiere ich auf Abteilungs- und Mitarbeitendenebene, nur auf Abteilungsebene sowie über alle Datensätze, um die Gesamtsumme zu erhalten.
Die Syntax für groupingSets() ist etwas anders. Zuerst definierst du die Liste der Sets [(“department”, “employee”), (“department”, ), ()], wobei das erste Set Abteilung+Mitarbeiter ist, das zweite nur Abteilung und das leere Set () für „alle“ steht.
Dann definierst du die Aggregationsspalten innerhalb der Sets. Der Rest läuft wie gewohnt mit .agg().
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()Ausgabe:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+Du kannst auch eigene Aggregationsfunktionen mit User Defined Functions (UDFs) in PySpark erstellen. Es gibt zwei Varianten: udf und pandas_udf. Beide ermöglichen eigene Funktionen – mit jeweiligen Vor- und Nachteilen.
Das klassische Spark-udf erzeugt Spark-native Funktionen. Syntax und Datentypen müssen nativ in Spark funktionieren. Das schränkt zwar ein, was in der UDF möglich ist, nutzt aber die verteilte Rechenleistung von Spark voll aus und ist für große Datensätze besser.
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
pandas_udf erlaubt dagegen pythonischere, Pandas-basierte Funktionen. Du bist also nicht nur auf Spark beschränkt.
Allerdings nutzt du dabei nicht die verteilte Rechenleistung von Spark, sondern rechnest lokal. Das passt besser für kleine bis mittlere Datensätze.
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
Eigene Funktionen solltest du nur einsetzen, wenn es keine bessere eingebaute Lösung gibt. Erfinde das Rad nicht neu!
Wenn sich etwas vektorisieren lässt (wie oben), nutze lieber eine vektorisierte Funktion statt einer aggregierenden UDF. Mehr zu groupBy() und dem Konzept findest du im Artikel zum Split-Apply-Combine-Framework mit pandas.
In PySpark kannst du Gruppen basierend auf Aggregatkennzahlen nach dem Gruppieren mit der Methode filter() filtern. Die Bedingung kannst du in Python- oder SQL-Ausdrücken angeben.
Du kannst auch where() verwenden – ein Alias für filter() mit identischer Wirkung.
Du kannst vor oder nach der Aggregation filtern. Vorheriges Filtern begrenzt die zu aggregierenden Daten und kann die Performance verbessern.
Vielleicht wollen wir z. B. nur Mitarbeitende über einem bestimmten Gehalt zählen, um „Hochlohn“-Mitarbeitende zu ermitteln.
# Filter für hohe Gehälter
filter_df = df.filter(df.salary > 4000)

# Aggregieren und die Anzahl der Hochlohn-Mitarbeitenden je Abteilung bestimmen
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
Ein Filtern nach der Aggregation beeinflusst die ursprüngliche Aggregation nicht. Vielleicht wollen wir alle Mitarbeitenden je Abteilung zählen, aber nur Abteilungen anzeigen, die größer als ein bestimmter Schwellenwert sind. Das fügt eine Verarbeitungsstufe hinzu, erhöht die Last aber meist nur geringfügig.
# DataFrame mit Anzahl Mitarbeitender erstellen
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# Filtern auf Abteilungen mit mehr als 1 Mitarbeitenden
agg_df.where("num_employees > 1").show()
Wähle den Zeitpunkt fürs Filtern mit Bedacht – er beeinflusst Genauigkeit und Ergebnis. Vorheriges Filtern kann Summen reduzieren, nachträgliches Filtern ggf. zu viele Gruppen im Resultat lassen.
Obwohl PySpark groupBy automatisch optimiert, gibt es Strategien, um die Verarbeitung weiter zu beschleunigen. Das Minimieren von Shuffles, der Umgang mit Daten-Skew und Ausführungsoptimierungen verbessern die groupBy-Performance spürbar.
groupBy löst einen Shuffle aus: Daten werden über Partitionen neu verteilt, damit gleiche Schlüssel zusammenkommen. Shuffles kosten Netzwerk- und Plattenressourcen, daher sollten sie minimiert oder optimiert werden. Zentrale Techniken:
repartition() gezielt einsetzen: Weise PySpark an, nach welcher Spalte partitioniert werden soll, damit weniger gesucht werden muss.spark.sql.shuffle.partitions anpassen: Standard sind 200 Shuffle-Partitionen. Für kleinere Datensätze reduzieren.Beispiele zur Verbesserung des Shuffle-Managements:
# Anzahl der Shuffle-Partitionen reduzieren
spark.conf.set("spark.sql.shuffle.partitions", "64")  # Je nach Clustergröße anpassen

# Sicherstellen, dass Spark Daten komprimiert
spark.conf.set("spark.shuffle.compress", "true") # komprimiert Netzwerktransfer
spark.conf.set("spark.shuffle.spill.compress", "true") # komprimiert Platten-Spills

# Vorab nach Abteilung repartitionieren, um Aggregation zu optimieren
df.repartition("department").groupBy("department").sum("salary").show()Daten-Skew entsteht, wenn bestimmte Schlüssel deutlich häufiger vorkommen als andere. Das führt zu ungleichmäßig ausgelasteten Partitionen und langsamen Tasks – einige Worker sind überlastet, andere Leerlauf. Gegenmaßnahmen sind Salting, das Vermeiden schiefer Joins und Broadcast-Joins für kleine Dimensionen.
# Beispiel für Salting:

df = df.withColumn("salted_key", sf.rand()) # Zufallsspalte erstellen
df = df.repartition(2, 'salted_key') # Daten nach salted_key repartitionieren
df.groupBy(sf.spark_partition_id()).count().show()Die logischen und physischen Ausführungspläne von PySpark-Jobs lassen sich mit Bordmitteln optimieren. So beschleunigst du groupBy-Aggregationen:
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # Zwischenergebnisse cachen

# Broadcasting verwenden (Pseudocode):
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
Mehr Details zur Optimierung findest du im Artikel zu PySpark Joins, der die internen Mechanismen erklärt.
Die DataFrame-API ist dank höherer Abstraktion und Effizienz (Catalyst Optimizer) für die meisten PySpark-Anwendungen zu bevorzugen. Ein Verständnis der Resilient Distributed Datasets (RDD) kann dennoch hilfreich sein – etwa für mehr Kontrolle oder bei der Migration von Legacy-Spark-Code. Im Allgemeinen liefern DataFrame- oder SQL-API bessere Performance.
Das RDD ist der Kernbaustein von PySpark, auf dem alles (auch die DataFrame-API) aufsetzt. Es arbeitet oft im Speicher und kann Streaming-Daten teils besser handhaben. Daten sind jedoch unveränderlich (immutable) und können nach Erstellung nicht verändert werden.
In diesem Abschnitt vergleichen wir groupBy in der DataFrame-API mit den Entsprechungen in der RDD-API – hinsichtlich Performance und Einsatzszenarien.
Zunächst machen wir aus dem DataFrame ein RDD.
# DataFrame zu einem RDD aus (key, value) konvertieren
rdd = df[['department','salary']].rdd
rdd.collect()
Jetzt können wir groupByKey() und reduceByKey() auf dem RDD ausführen. Starten wir mit groupByKey().
groupByKey() verschiebt alle Werte mit demselben Schlüssel auf denselben Executor und gruppiert sie dort. Das kann lange dauern, weil viel Datenverkehr entsteht – und zudem Skew verstärken.
rdd.groupByKey().mapValues(list).collect()Besser ist reduceByKey(). Diese Methode aggregiert zunächst innerhalb jeder Partition und verschiebt erst dann Daten über das Netzwerk. So wird weniger geshuffelt und es läuft schneller.
reduceByKey ist daher deutlich vorzuziehen gegenüber groupByKey, weil es Shuffle-Operationen stark reduziert.
Konkret wird erst in jeder Partition aggregiert, dann kombiniert und erneut aggregiert. Ideal für Aggregationen, die Schlüssel zusammenführen, z. B. sum() oder max().
from operator import add

rdd.reduceByKey(add).collect()Hier eine Zusammenfassung der Vorteile der jeweiligen Aggregationsansätze.
|
Merkmal |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
Abstraktionsebene |
Hoch |
Niedrig |
Niedrig |
|
Optimierte Ausführung |
Ja (Catalyst & Tungsten) |
Nein |
Nein |
|
Shuffle-Minimierung |
Ja |
❌ (Voller Shuffle) |
✅ (Mit Combiner) |
|
Speichereffizienz |
Hoch |
Niedrig |
Mittel–Hoch |
|
Flexibilität |
Mittel |
Hoch |
Mittel |
|
Performance bei Big Data |
Exzellent |
Schwach |
Gut |
|
Empfohlener Einsatz |
Meiste Fälle |
Selten/spezialisiert |
Individuelle, Low-Level-Aggregationen |
Die Big Data Fundamentals with PySpark behandeln RDD-Programmierung ausführlicher und zeigen, wie sie das Rückgrat von PySpark bilden.
Aggregationen lassen sich in PySpark auch über die SQL-API mit SQL-Statements schreiben – ideal, wenn dir SQL besonders liegt.
Zuerst erstellst du eine temporäre View mit createOrReplaceTempView() auf dem DataFrame. Dann schreibst du dein Statement mit spark.sql().
# Temporäre View aus dem DataFrame erstellen
df.createOrReplaceTempView("employees")

# SQL-ähnliches Statement schreiben
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()Ausgabe:
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
Wie du siehst, ist es so einfach wie eine normale SQL-Abfrage. Der Hauptgrund für die SQL-API ist die Vertrautheit und das leichtere Schreiben. Die DataFrame-API ist oft im Vorteil, da sie konsistente Datentypen bietet und in der Regel besser optimiert.
Mit der DataFrame-API erhältst du außerdem Zugriff auf Methoden, die in Spark SQL nicht verfügbar sind. Mehr zu SQLs GROUP BY findest du im Artikel GROUP BY und HAVING in SQL.
Es gibt zahlreiche reale Anwendungsfälle für Aggregationen. In der Praxis wirst du Daten fast immer irgendwie aggregieren müssen, um sie zu analysieren und zu teilen.
Unten findest du Beispiele verschiedener Use Cases. Teils ist es Pseudocode oder nicht exakt auf unseren Testdatensatz anwendbar – die Idee dahinter ist zu zeigen, wie du solche Aggregationen schreiben könntest.
Ein wiederkehrendes Muster ist die hierarchische Analyse mit groupBy. Stell dir eine Spalte „revenue“ vor und du möchtest die Abteilungsleistung betrachten. Wir gruppieren je Abteilung und bewerten den Umsatzbeitrag jeder Abteilung.
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()Aggregationen eröffnen den Zugang zu Fensterfunktionen. Diese betrachten ein gleitendes Fenster über Daten – als fortlaufende Zeilen oder Zeiträume.
Wir definieren zuerst ein Fenster mit dem Objekt Window und legen fest, nach was wir partitonBy und orderBy. Dieses Objekt übergeben wir dann per over() an unsere Aggregatfunktion. Ein gleitender Durchschnitt sähe etwa so aus: sf.avg().over(window).show().
Angenommen, wir wollen den gleitenden Gehaltsdurchschnitt je Abteilung sehen. Wir gruppieren nach department und sortieren nach einer neuen Spalte employeeId. Da Employee-IDs oft sequenziell sind, sehen wir so die Entwicklung des Durchschnitts über die Zeit.
from pyspark.sql.window import Window

# Fenster definieren: Partition und Sortierung
windowSpec = Window.partitionBy("department").orderBy("employeeId")

# Den Durchschnitt über das Fenster berechnen
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
Das ähnelt stark den Fensterfunktionen in SQL.
Vielleicht möchtest du mehrere Nutzungsmetriken für ein Medienunternehmen verstehen – etwa gesamte Watchtime und einzigartige Videos. Wir groupBy() die Spalte user_id und verwenden anschließend .agg() mit sum() und countDistinct() für unterschiedliche Kennzahlen.
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), # Summe der gesehenen Minuten
    sf.countDistinct("video_id").alias("unique_views") # Anzahl einzigartiger Videos
).show()Beim Aggregieren in PySpark tappt man leicht in Performance-Fallen mit langen Laufzeiten. Diese Best Practices sichern Performance, Korrektheit und Skalierbarkeit.
So werden aus einfachen Abfragen schnell Langläufer:
groupByKey() in RDDs überstrapazieren:groupByKey() in RDDs, da dabei Daten über Partitionen geshuffelt werden – hoher Netzwerk- und Platten-Overhead.reduceByKey() oder bleib bei der DataFrame-API.repartition() die Workloads gleichmäßiger zu verteilen.sum() in einem groupBy und count() später auf demselben Grouped-Datensatz – verhindern effiziente Pläne und schwächen PySparks Optimierung.persist() oder cache() einsetzen.So hältst du deine PySpark-Aggregationen auf Kurs:
na.fill() oder na.drop() verwenden.df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions je nach Datenvolumen feinjustieren..explain() Ausführungspläne beobachten.df.groupBy("department").sum("salary").explain(True)Ausgabe:
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
Spark bietet viele Konfigs, die sich für große groupBy-Workloads anpassen lassen. Hier einige wichtige:
|
Konfiguration |
Beschreibung |
|
|
Steuert die Anzahl der Partitionen für Shuffles. Für kleine Jobs reduzieren, für große erhöhen. (Standard: 200) |
|
|
Ermöglicht automatisches Broadcasten kleiner Tabellen. Auf -1 setzen, um zu deaktivieren, oder erhöhen für größere Joins. (Standard: 10MB) |
|
|
Steuert den verfügbaren Speicher pro Executor. Für große Aggregationen erhöhen. (Standard: 4g) |
|
|
Aktiviert Adaptive Query Execution (AQE), die Shuffles, Skew und Joins zur Laufzeit dynamisch optimiert. (Standard: true) |
Für fortgeschrittene Nutzer oder sehr große Datensätze ist es wichtig zu verstehen, wie groupBy unter der Haube funktioniert. Hier einige Feinheiten.
Alle DataFrame-Operationen in PySpark – inklusive groupBy – werden „lazy“ ausgewertet. Es passiert also nichts, bis eine Aktion (wie show() oder collect()) ausgelöst wird.
So kann der Catalyst Optimizer Operationen umordnen, kombinieren oder entfernen, um die Performance zu steigern. Nutze das aus und verknüpfe mehrere Aggregationen und Methoden, damit Spark einen optimalen Plan erstellen kann.
groupBy() liefert ein GroupedData-Objekt. Eine Aggregationsfunktion wie sum() erzeugt daraus dann ein DataFrame-ähnliches Objekt. Mit show() werden die Ergebnisse angezeigt.
Denk daran: groupBy().agg() gibt ein neues DataFrame mit neu benannten Spalten zurück. Nutze konsequent Aliasse per alias(), um Namenskonflikte zu vermeiden und die Ausgabe klarer zu machen. Ohne Aliasse drohen Kollisionen oder Probleme bei späteren Joins.
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)Beachte: Aggregationen in PySpark erhalten die Zeilenreihenfolge nicht. Verwende orderBy() für reproduzierbare Ausgaben und konsistentes Sorting.
df.groupBy("department").sum("salary").orderBy("department").show()Zwischen PySpark-Versionen gibt es Änderungen und Einschränkungen. Catalyst wurde in 1.3 eingeführt und in 2.0 deutlich verbessert. Einige Methoden kamen später hinzu, z. B. groupingSets().
Die folgende Übersicht zeigt größere Funktionsänderungen in PySpark. Achte darauf, die passende Spark-/PySpark-Version für deine benötigten Features zu nutzen!
|
Feature |
Spark-Version |
Beschreibung |
|
|
1.4+ |
Hierarchische Aggregationen für OLAP-Analysen (ab 3.4+ mit Spark Connect) |
|
|
2.3+ |
Vektorisierte UDFs mit Apache Arrow für schnellere Ausführung (ab 3.4+ Spark Connect, ab 4.0+ SCALAR) |
|
Adaptive Query Execution (AQE) |
3.0+ |
Passt Joins, Shuffles und Skew zur Laufzeit dynamisch an |
|
ANSI-SQL-Kompatibilitätsmodus |
3.0+ |
Präzisere Fehlermeldungen und Ausdrucksverhalten |
|
|
4.0+ |
Erlaubt mehrere Gruppierungen in einer Aggregation (z. B. für Subtotale) |
PySparks groupBy ist ein unverzichtbares Werkzeug zur Datenaggregation in verteilten Umgebungen. Ob zur Zusammenfassung nach Regionen, zur Berechnung von Durchschnittswerten oder für komplexe mehrstufige Analysen – groupBy bietet eine skalierbare und flexible API für Big-Data-Workloads.
Behalte dabei diese Best Practices im Blick, um Laufzeit und Kosten zu senken:
Mit der Weiterentwicklung von PySpark dürfen wir auf noch intelligentere Optimierungen, native Unterstützung komplexer Aggregationen und engere Verzahnung mit Pandas und SQL-Syntax hoffen. Auch für großskalige Modelle könnte die Integration weiter wachsen. Wenn du tiefer einsteigen willst, sieh dir diese Ressourcen von DataCamp an:
Top-PySpark-Kurse
Kurs
Kurs
Kurs