
Cours
Principes fondamentaux de PySpark
4 h
157.8K
Dans l’univers du big data, on consulte rarement des données brutes. Pour les rendre exploitables, le regroupement et l’agrégation sont des opérations courantes et puissantes. En environnement distribué comme Apache Spark et Python, la fonction groupBy de PySpark nous permet de regrouper et de synthétiser nos données distribuées. Elle reflète le fonctionnement de la clause GROUP BY en SQL, tout en étant conçue pour traiter efficacement des jeux de données massifs en mode distribué.
La méthode groupBy de PySpark permet de partitionner les données selon différentes colonnes, puis d’agréger ces groupes avec des mesures telles que sommes, moyennes, etc. Pour optimiser cela, PySpark suit le paradigme split-apply-combine :
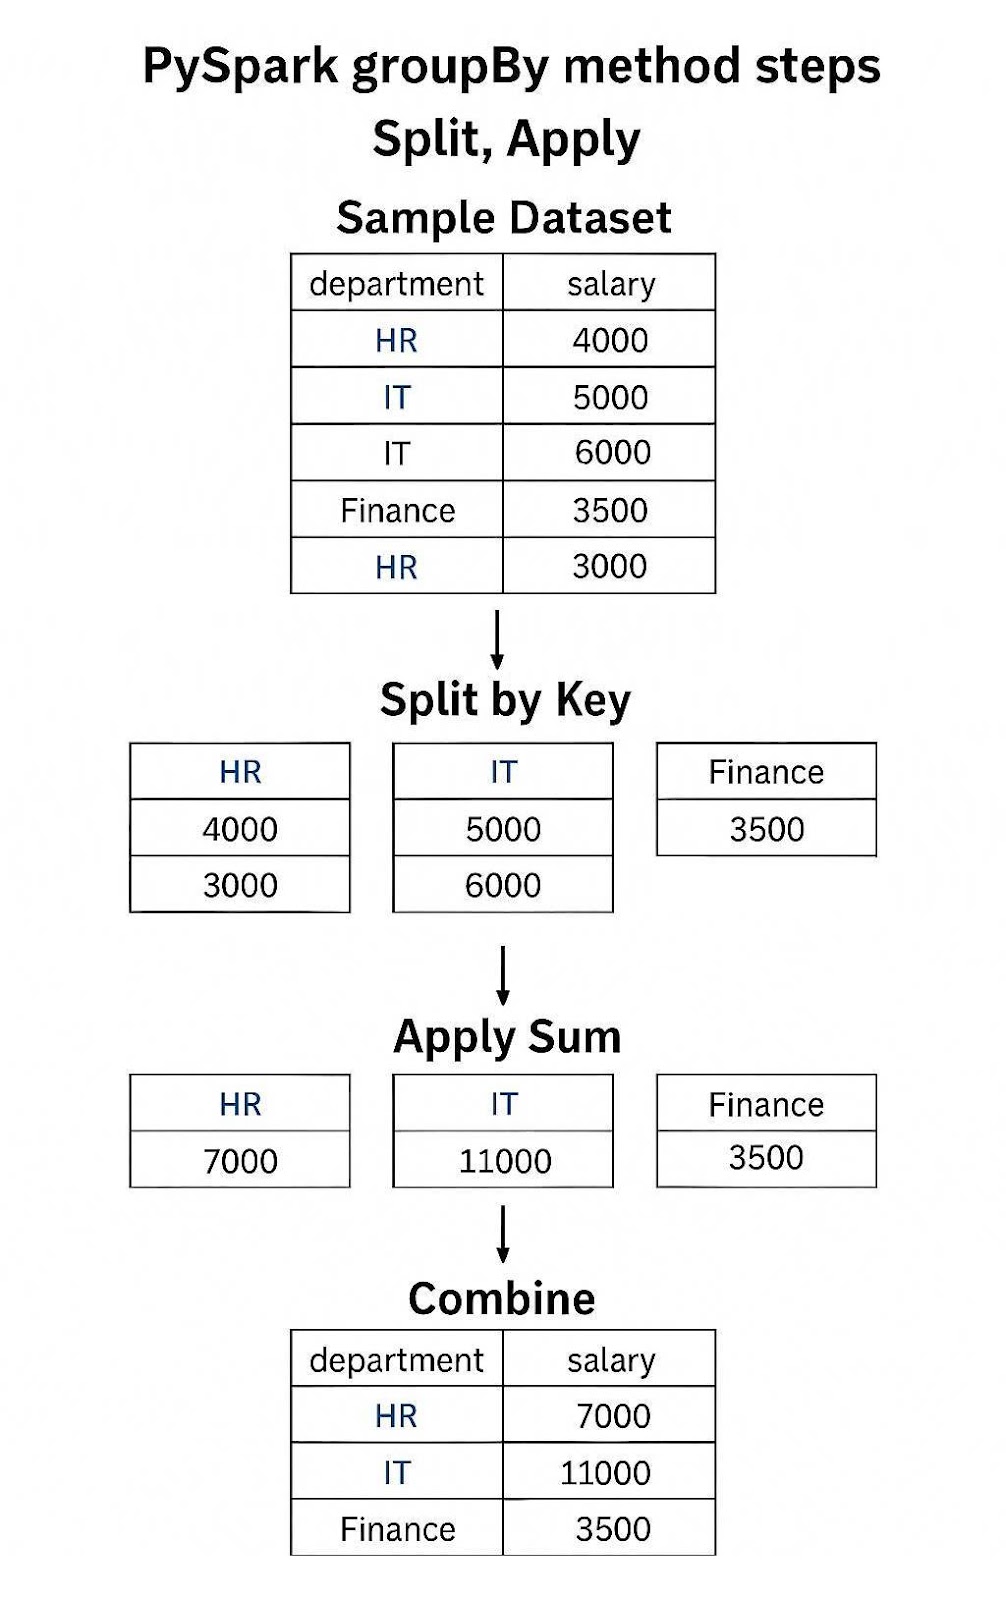
Exemple d’application de Sum avec groupBy() de PySpark
PySpark exploite l’évaluation paresseuse : les opérations comme groupBy ne sont réellement calculées que lorsqu’une action (comme show() ou collect()) est appelée. PySpark construit d’abord un DAG (graphe acyclique orienté) initial, ensuite optimisé pour les performances. Cela aide Spark à optimiser le plan d’exécution avant de lancer le calcul.
Si vous n’avez pas encore travaillé avec PySpark, nous vous recommandons vivement le cours Big Data Fundamentals with PySpark.
Avant tout, il nous faut un DataFrame PySpark. Besoin d’un rappel sur les commandes PySpark ? Consultez cet excellent aide-mémoire PySpark DataFrame.
Passons en revue quelques étapes et commandes clés pour bien démarrer avec PySpark. Avant de commencer, assurez-vous d’avoir installé PySpark dans votre environnement Python, ainsi que Java et le JDK Java. Si besoin, suivez ce guide pour démarrer avec PySpark.
Première étape : lancer PySpark !
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()Créons un DataFrame d’exemple sur lequel travailler.
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()
Résultat :
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
+----------+--------+------+La transformation groupBy de PySpark permet de scinder les données en groupes selon une ou plusieurs colonnes, puis d’appliquer des agrégations ou transformations indépendantes.
L’utilisation de groupBy est simple : appelez-la sur le DataFrame souhaité. Elle s’applique à tout type de colonne pertinent pour la partition. Par exemple, on évitera généralement les flottants.
grouped = df.groupBy("department")Cela crée un objet GroupedData, qui n’est pas un DataFrame en soi. Il indique à Spark comment commencer à partitionner les données. Une fois cet objet créé, vous pouvez appliquer des agrégations comme .count() ou .sum() pour obtenir un nouveau DataFrame.
grouped.count().show()Le seul paramètre de la méthode est *cols, qui accepte des noms de colonnes, des expressions de colonnes, des indices (int) ou une liste de colonnes. Tant que la colonne sert de clé de partition, vous pouvez l’utiliser. La méthode renvoie toujours un objet GroupedData.
# groupement par nom de colonne comme ci-dessus
	df.groupBy("department")

# groupement par expression de colonne
	df.groupBy(df.department)

# groupement par indice de colonne
	df.groupBy(1)

# groupement par liste de colonnes (vous pouvez combiner les méthodes)
df.groupBy(["department", 2])Comme montré ci-dessus, vous pouvez regrouper par une ou plusieurs colonnes. Une seule colonne convient lorsque vous vous intéressez à un seul axe (départements, années). Plusieurs colonnes apportent plus de granularité : commerciaux par département, mois au sein d’une année, etc.
# groupement par une seule colonne
	df.groupBy("department").sum(“salary”).show()

# groupement par plusieurs colonnes
	df.groupBy(["department", 2]).sum(“salary”).show()
Vous l’aurez noté, groupBy fonctionne de façon très similaire à GROUP BY en SQL. Nous verrons plus loin comment utiliser aussi ce langage dans PySpark.
PySpark propose un large éventail de méthodes d’agrégation intégrées pour traiter des données groupées. Si vous connaissez SQL, vous retrouverez des fonctions telles que count(), sum(), avg(), etc. Consultez notre guide des fonctions d’agrégation en SQL pour un rappel.
Passons en revue les principales fonctions :
count() : compte le nombre d’enregistrements dans la partitionsum() : calcule la somme des valeurs numériquesavg() : calcule la moyenne des valeurs numériquesmin() : renvoie la plus petite valeur de la partitionmax() : renvoie la plus grande valeur de la partitionEn complément, vous pouvez utiliser la méthode .alias() pour renommer les colonnes et rendre les résultats plus lisibles. Exemple ci-dessous.
Plutôt que d’exécuter chaque agrégation séparément, vous pouvez en effectuer plusieurs en une seule fois grâce à agg(). Chaque agrégation crée une nouvelle colonne dans votre DataFrame. Cela évite des appels multiples à groupBy et améliore les performances. Il n’est pas nécessaire d’agréger sur la même colonne : vous pouvez définir une colonne différente pour chaque fonction d’agrégation.
# Après avoir démarré votre session
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()
Résultat :
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+L’un des atouts de PySpark est la prise en charge de modèles d’agrégation avancés : pivot, rollup et data cubes. Vous pouvez aussi créer des grouping sets.
Comme dans un tableau croisé dynamique Excel, vous pouvez pivoter vos données sur différentes colonnes. Ici, on groupe par department et on pivote sur employee pour voir le salaire total de chaque employé.
Chaque ligne représente le département, et chaque colonne correspond à un employé du département. Imaginez la puissance de ce procédé avec des données annuelles pour comparer la performance d’un département d’une année sur l’autre.
df.groupBy("department").pivot("employee").sum("salary").show()Deux méthodes très puissantes pour agréger les données sont rollup() et cube(). Avec un groupBy() simple, vous n’obtenez que les agrégations existantes, tandis que rollup() et cube() créent des structures hiérarchiques, donc des niveaux supplémentaires d’agrégation.
Par exemple, rollup() agrège de gauche à droite, en affichant chaque permutation possible au fil des itérations. Pour chaque département, on voit chaque personne du service ainsi que le total du groupe.
De son côté, cube() affiche toutes les permutations possibles pour les colonnes agrégées : chaque département séparément, chaque employé séparément et toutes les combinaisons des deux.
En résumé :
Exemple de code et de sortie ci-dessous :
rollup() Code :
# using rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() Résultat :
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() Code :
#using cube
df.cube("department", "employee").sum("salary").show()
cube() Résultat :
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+Les grouping sets permettent de définir plusieurs niveaux d’agrégation. Dans cet exemple, j’agrège au niveau département+employé, département seul, et un total général pour le salaire.
Vous remarquerez une syntaxe un peu différente avec groupingSets(). On définit d’abord la liste des sets [(“department”, “employee”), (“department”, ), ()] : le premier correspond à département+employé, le second aux seuls départements, et le dernier () à « tous ».
On définit ensuite les colonnes d’agrégation dans ces sets. Le reste se fait comme d’habitude avec .agg().
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()Résultat :
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+Enfin, vous pouvez créer des fonctions d’agrégation personnalisées via les User Defined Functions (UDFs) en PySpark. Deux options existent : udf et pandas_udf. Toutes deux permettent de créer vos propres fonctions, chacune avec ses avantages et limites.
Le udf standard de Spark crée des fonctions natives Spark. Cela impose une syntaxe et des types de données compatibles Spark, ce qui peut restreindre certaines opérations, mais tire pleinement parti de la puissance de calcul distribuée de Spark — idéal pour les grands jeux de données.
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
À l’inverse, pandas_udf permet de créer des fonctions personnalisées plus « pythoniques ». Vous êtes alors limité par ce que Pandas permet, et non plus uniquement Spark.
En revanche, vous ne profitez pas de la distribution de calcul de Spark et vous vous appuyez sur des calculs locaux. C’est mieux adapté à des jeux de données petits à moyens.
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
Globalement, n’utilisez des fonctions personnalisées que si aucune autre solution ne permet l’agrégation souhaitée. Inutile de réinventer la roue !
Par ailleurs, si une opération peut être vectorisée (comme ci-dessus), privilégiez une version vectorisée plutôt qu’un UDF d’agrégation. Pour aller plus loin sur groupBy(), lisez cet article plus détaillé sur le cadre split-apply-combine avec pandas.
Avec PySpark, vous pouvez filtrer des groupes sur la base de mesures agrégées après le regroupement via filter(). Vous fournissez alors une condition en Python ou en expressions SQL.
À noter : vous pouvez aussi utiliser where(), alias de filter() réalisant la même opération.
Vous pouvez filtrer avant ou après l’agrégation. Le filtrage en amont limite les données agrégées et peut améliorer les performances.
Par exemple, peut-être souhaitez-vous uniquement compter les employés au-dessus d’un certain salaire pour identifier les employés « haut salaire ».
# filtrer les salaires élevés
filter_df = df.filter(df.salary > 4000)

# agréger et compter les employés à haut salaire
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
En revanche, filtrer après l’agrégation n’affecte pas l’agrégation initiale. Vous pouvez compter tous les employés d’un département puis n’afficher que les départements au-dessus d’une certaine taille. Cela ajoute une étape, sans pour autant alourdir fortement la charge.
# créer un dataframe comptant le nombre d’employés
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# filtrer les départements avec plus d’un employé
agg_df.where("num_employees > 1").show()
Choisissez le moment du filtrage avec discernement, car il impacte l’exactitude et le résultat final. Filtrer avant peut réduire le total final, tandis que filtrer après peut laisser trop d’éléments dans la réponse.
Même si PySpark optimise automatiquement groupBy, certaines stratégies peuvent encore accélérer le traitement. Minimiser le shuffle, atténuer le skew et optimiser l’exécution contribuent tous à améliorer les performances de groupBy.
groupBy provoque un shuffle, qui redistribue les données entre partitions pour regrouper des clés similaires. Les shuffles sollicitent fortement le réseau et le disque, il est donc crucial de les minimiser ou de les optimiser. Techniques clés :
repartition() à bon escient : indiquez à PySpark la colonne de partition pour réduire l’espace de rechercheExemples d’améliorations de la gestion des shuffles :
# réduire le nombre de partitions de shuffle
spark.conf.set("spark.sql.shuffle.partitions", "64")  # à ajuster selon la taille du cluster

# s’assurer que Spark compresse les données
spark.conf.set("spark.shuffle.compress", "true") # compression des transferts réseau
spark.conf.set("spark.shuffle.spill.compress", "true") # compression des débordements disque

# repartitionner avant le groupement pour optimiser l’agrégation
df.repartition("department").groupBy("department").sum("salary").show()Le skew survient quand certaines clés sont surreprésentées, entraînant des charges de partitions inégales et des tâches lentes. Certains workers sont davantage sollicités. On peut atténuer le skew via le salting, la réduction des jointures biaisées et les broadcast joins pour les petites dimensions.
# Exemple de salting :

df = df.withColumn("salted_key", sf.rand()) # Crée une colonne aléatoire
df = df.repartition(2, 'salted_key') # repartitionner via cette clé
df.groupBy(sf.spark_partition_id()).count().show()Les plans logique et physique des jobs PySpark peuvent être optimisés via des fonctionnalités intégrées. Elles améliorent les performances de vos agrégations groupBy.
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # vous pouvez mettre en cache des résultats intermédiaires

# utiliser le broadcast (pseudo-code) :
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
Pour plus de détails sur l’optimisation des opérations PySpark, lisez cet article sur les PySpark Joins afin de comprendre une partie des mécanismes internes.
L’API DataFrame est recommandée pour la plupart des utilisateurs PySpark en raison de son niveau d’abstraction et de son efficacité (grâce au Catalyst Optimizer). Comprendre la couche RDD (Resilient Distributed Dataset) reste utile, notamment pour davantage de contrôle ou lors de migrations d’ancien code Spark. En général, l’API DataFrame ou SQL offre de meilleures performances.
Le RDD est le cœur de PySpark, sur lequel tout (y compris l’API DataFrame) est construit. Il travaille majoritairement en mémoire et gère parfois mieux des flux que l’API DataFrame. Les données sont toutefois immuables : on ne peut pas modifier un RDD après sa création.
Cette section compare groupBy dans l’API DataFrame à ses équivalents RDD, en termes de performance et d’adéquation aux usages.
Commençons par convertir le DataFrame en RDD.
# Convertir le DataFrame en RDD de (clé, valeur)
rdd = df[['department','salary']].rdd
rdd.collect()
Nous pouvons maintenant utiliser groupByKey() et reduceByKey() sur le RDD. Commençons par groupByKey().
La méthode groupByKey() regroupe sur un même exécuteur toutes les valeurs partageant la même clé. Cela peut prendre du temps, car beaucoup de données doivent être déplacées, et cela peut accentuer le skew.
rdd.groupByKey().mapValues(list).collect()À la place, utilisons reduceByKey(). Cette méthode agrège d’abord au sein de chaque partition, puis déplace les résultats sur le réseau. Elle minimise le volume de données shuffle et fonctionne donc plus vite.
Ainsi, reduceByKey est fortement préférable à groupByKey car elle réduit significativement les opérations de shuffle.
Concrètement, on agrège dans chaque partition, on combine, puis on agrège globalement. C’est idéal pour des agrégations rassemblant les clés comme sum() et max().
from operator import add

rdd.reduceByKey(add).collect()Voici un tableau récapitulant les avantages de chaque méthode d’agrégation.
|
Caractéristique |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
Niveau d’abstraction |
Élevé |
Faible |
Faible |
|
Exécution optimisée |
Oui (Catalyst & Tungsten) |
Non |
Non |
|
Minimisation du shuffle |
Oui |
❌ (Shuffle complet) |
✅ (Avec combiner) |
|
Efficacité mémoire |
Élevée |
Faible |
Moyenne–élevée |
|
Flexibilité |
Modérée |
Élevée |
Moyenne |
|
Performance sur big data |
Excellente |
Faible |
Bonne |
|
Cas recommandé |
La plupart des cas |
Rares/spécifiques |
Agrégations bas niveau sur mesure |
Le cours Big Data Fundamentals with PySpark couvre en détail la programmation avec les RDDs et explique leur rôle fondamental dans PySpark.
Une autre manière d’agréger dans PySpark consiste à utiliser l’API SQL pour écrire des instructions en SQL. Idéal si vous êtes plus à l’aise avec ce langage.
Commencez par créer une vue temporaire via createOrReplaceTempView() sur le DataFrame. Vous pouvez ensuite écrire votre instruction avec spark.sql().
# Créer une vue temporaire à partir du DataFrame
df.createOrReplaceTempView("employees")

# Écrire une requête de type SQL
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()
Résultat :
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
Comme vous le voyez, c’est aussi simple qu’une requête SQL classique. L’API SQL est pertinente pour des raisons de familiarité et de facilité d’écriture. L’API DataFrame est souvent préférable : elle assure des types cohérents et fournit en général de meilleures optimisations.
Vous accédez à des méthodes DataFrame qui ne sont pas disponibles via Spark SQL. Pour en savoir plus sur GROUP BY en SQL, lisez cet article sur GROUP BY et HAVING en SQL.
Les cas d’usage de l’agrégation sont nombreux. En pratique, vous aurez presque toujours besoin d’agréger vos données pour les analyser et les partager.
Voici quelques exemples. Certains sont du pseudo-code ou ne s’appliquent pas exactement à notre jeu de test, mais illustrent la manière d’écrire ces agrégations.
Un thème récurrent est l’analyse hiérarchique avec groupBy. Imaginez une colonne « revenue » et l’envie d’évaluer la performance de chaque département. On groupe par département et on évalue sa contribution au revenu.
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()Les agrégations donnent accès aux fonctions de fenêtre. Elles examinent une fenêtre glissante de données, soit une suite de lignes, soit une période temporelle.
On définit d’abord une fenêtre avec l’objet Window pour préciser partitonBy et orderBy. On utilise ensuite cette fenêtre dans la méthode over() de la fonction d’agrégation choisie. Par exemple, une moyenne glissante ressemble à sf.avg().over(window).show().
Imaginons que l’on souhaite la moyenne glissante des salaires par département. On groupe par department et on ordonne par une nouvelle colonne employeeId. Les IDs étant souvent séquentiels, on observe l’évolution de la moyenne salariale dans le temps.
from pyspark.sql.window import Window

# Définir la fenêtre (partition et ordre)
windowSpec = Window.partitionBy("department").orderBy("employeeId")

# Appliquer sf.avg sur "salary" sur la fenêtre définie
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
C’est très proche des fonctions de fenêtre en SQL.
Supposons que nous voulions comprendre différents indicateurs utilisateur pour une entreprise média : temps de visionnage total et nombre de vidéos uniques. On peut groupBy() sur user_id puis utiliser .agg() avec sum() et countDistinct() pour différents métriques.
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), # somme des minutes regardées
    sf.countDistinct("video_id").alias("unique_views") # nombre de vidéos uniques
).show()En agrégeant des données dans PySpark, on tombe facilement dans des pièges menant à des performances médiocres et des temps d’exécution longs. Ces bonnes pratiques garantissent performance, justesse et scalabilité.
Voici des façons courantes de transformer une requête simple en programme interminable.
groupByKey() dans les RDD :groupByKey() sur RDD : il force PySpark à faire du shuffle entre partitions, avec un fort coût réseau et disque.reduceByKey() ou restez sur l’API DataFrame.repartition() pour mieux répartir la charge.sum() dans un groupBy puis count() sur la même base groupée dans une autre ligne) fragmente l’optimisation de PySpark.persist() ou cache() lors de réutilisations.Voici quelques leviers pour garder vos agrégations PySpark fluides !
na.fill() ou na.drop() avant l’agrégation.df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions selon le volume de données pour trouver le bon nombre de partitions..explain() pour comprendre l’exécution physique.df.groupBy("department").sum("salary").explain(True)Résultat :
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
Spark propose de nombreux paramètres à ajuster pour des charges groupBy importantes. Voir le tableau ci-dessous pour quelques clés.
|
Configuration |
Description |
|
|
Contrôle le nombre de partitions pour les shuffles. Réduisez pour de petits jobs, augmentez pour de gros volumes. (Par défaut : 200) |
|
|
Active la diffusion automatique des petites tables. Mettez à -1 pour désactiver ou augmentez pour supporter de plus grosses jointures. (Par défaut : 10 Mo) |
|
|
Mémoire disponible par exécuteur. Augmentez-la pour de grosses agrégations. (Par défaut : 4g) |
|
|
Active l’Adaptive Query Execution (AQE), qui optimise dynamiquement shuffles, skew et jointures. (Par défaut : true) |
Pour les utilisateurs avancés ou en contexte de très grands volumes, comprendre le fonctionnement interne de groupBy est essentiel. Voici quelques points clés.
Toutes les opérations DataFrame en PySpark, y compris groupBy, sont évaluées paresseusement. Aucune computation n’a lieu tant qu’une action (show(), collect(), etc.) n’est pas déclenchée.
Catalyst peut ainsi réorganiser, combiner ou supprimer des opérations pour améliorer les performances. Profitez-en et chaînez plusieurs agrégations et méthodes pour permettre la création d’un plan optimisé.
L’appel à groupBy() renvoie un objet GroupedData. Exécuter une fonction d’agrégation comme sum() renvoie ensuite un objet de type DataFrame. Avec show(), les résultats s’affichent.
N’oubliez pas que groupBy().agg() renvoie un nouveau DataFrame avec de nouvelles colonnes. Utilisez systématiquement des alias via alias() pour éviter les collisions de noms et clarifier les sorties. Sans alias, vous risquez des collisions de colonnes ou des problèmes de jointure plus tard.
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)Notez qu’en PySpark, l’ordre des lignes n’est pas garanti dans les résultats d’agrégation. Utilisez orderBy() pour des sorties prévisibles et un tri cohérent.
df.groupBy("department").sum("salary").orderBy("department").show()Certaines fonctionnalités et limitations varient selon la version de PySpark. Catalyst a été introduit en 1.3 puis fortement amélioré en 2.0. Des méthodes comme groupingSets() sont apparues dans des versions ultérieures.
Voici un tableau récapitulant quelques évolutions majeures. Assurez-vous d’utiliser la version de Spark et PySpark offrant les fonctionnalités dont vous avez besoin !
|
Fonctionnalité |
Version Spark |
Description |
|
|
1.4+ |
Agrégations hiérarchiques utiles pour l’analytique OLAP (3.4+ prend en charge Spark Connect) |
|
|
2.3+ |
UDF vectorisées via Apache Arrow pour une exécution plus rapide (3.4+ prend en charge Spark Connect, 4.0+ prend en charge SCALAR) |
|
Adaptive Query Execution (AQE) |
3.0+ |
Ajuste dynamiquement les jointures, shuffles et la gestion du skew à l’exécution |
|
Mode de compatibilité ANSI SQL |
3.0+ |
Des erreurs et des expressions plus conformes et précises |
|
|
4.0+ |
Permet plusieurs groupements en une seule agrégation (ex. : sous-totaux) |
La fonction groupBy de PySpark est un outil essentiel pour l’agrégation de données en environnement distribué. Qu’il s’agisse de synthétiser par région, de calculer des moyennes ou de conduire des analyses multi-niveaux complexes, groupBy offre une API scalable et flexible pour les charges big data.
Gardez à l’esprit ces bonnes pratiques pour réduire le temps d’exécution et les coûts :
À mesure que PySpark évolue, on peut s’attendre à des optimisations plus intelligentes, un support natif des agrégations complexes et une meilleure intégration avec Pandas et la syntaxe SQL. L’intégration avec des modèles plus larges pourrait aussi s’améliorer. Pour aller plus loin avec PySpark, explorez ces ressources DataCamp :
Meilleurs cours PySpark
Cours
Cours
Cours