Curso
Fundamentos do PySpark
4 h
157.8K
No universo de big data, raramente olhamos os dados em bruto. Para tornar as informações mais digeríveis, agrupar e agregar dados é uma operação comum e poderosa. Ao trabalhar com sistemas distribuídos como Apache Spark e Python, contar com a função groupBy do PySpark permite reunir e resumir dados distribuídos. Ela espelha a funcionalidade da cláusula GROUP BY do SQL, mas foi criada para lidar com processamento distribuído em conjuntos de dados massivos com eficiência.
O groupBy do PySpark permite particionar os dados com base em várias colunas, que depois podem ser agregadas em diferentes medidas, como somas, médias e assim por diante. Para fazer isso de forma eficiente, o PySpark segue o paradigma split-apply-combine:
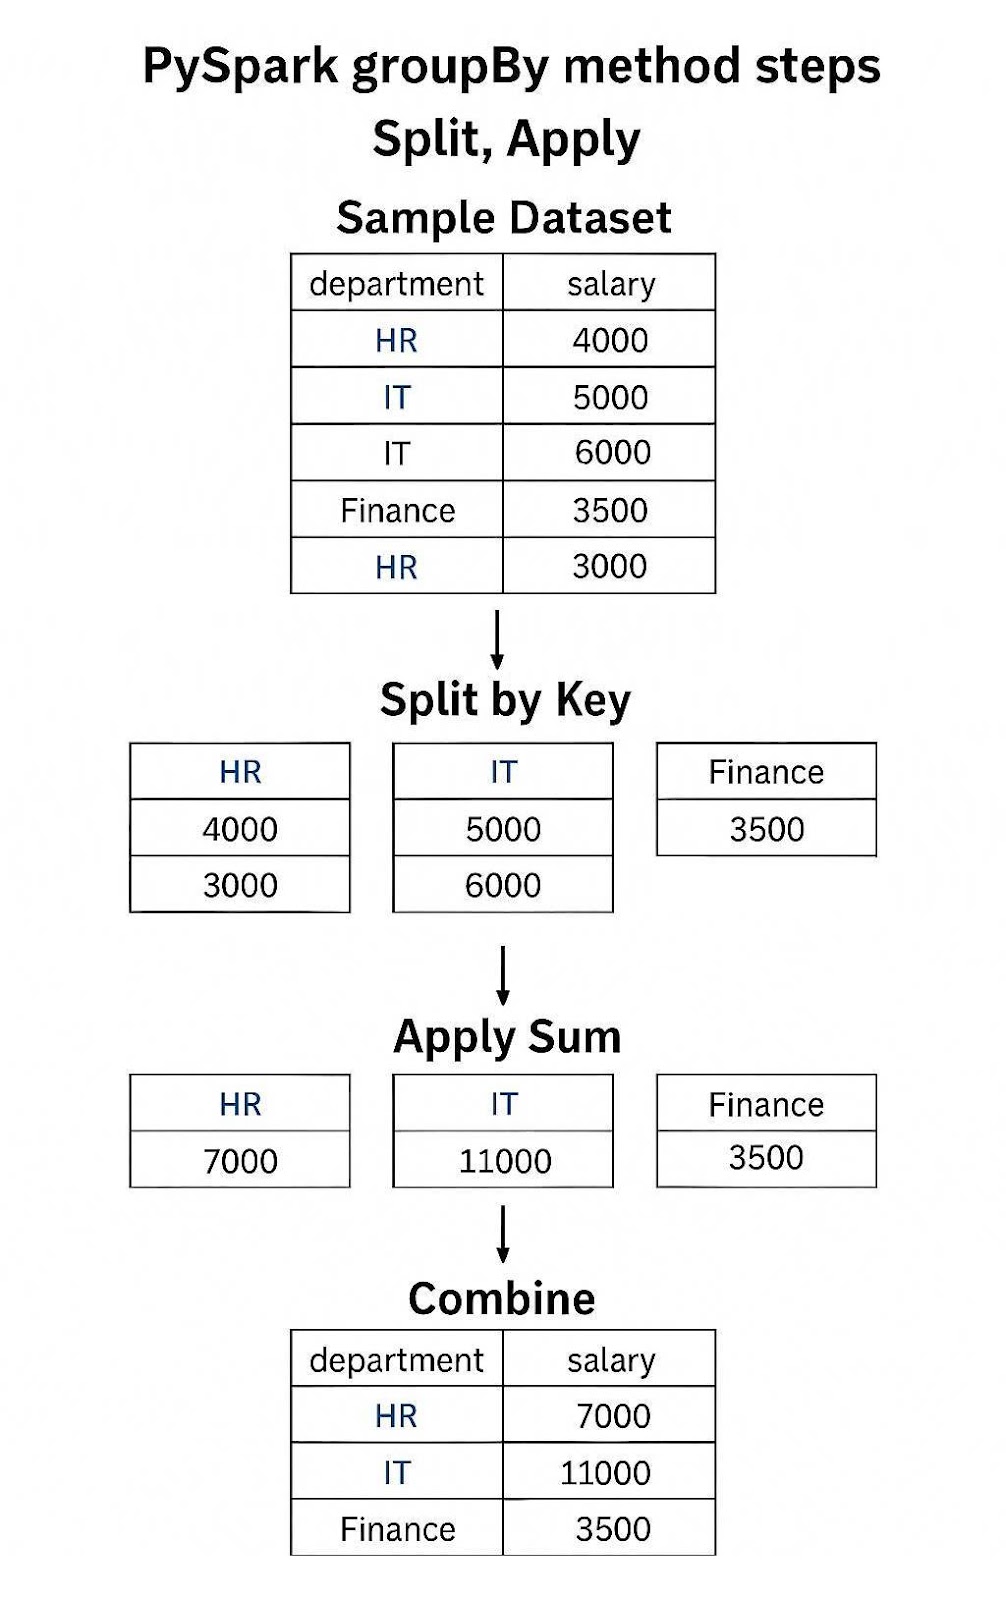
Exemplo do método groupBy() do PySpark aplicando soma
O PySpark usa avaliação preguiçosa (lazy evaluation), o que significa que operações como groupBy só são computadas quando ações (como show() ou collect()) são chamadas. Antes disso, o PySpark constrói um DAG (Directed Acyclic Graph) inicial que é refinado para performance. Isso ajuda o Spark a otimizar o plano de consulta antes da execução.
Se você ainda não teve oportunidade de trabalhar com PySpark, vale conferir os Fundamentos de Big Data com PySpark.
Primeiro de tudo, precisamos de um DataFrame do PySpark. Se quiser relembrar os principais comandos, dê uma olhada neste ótimo cheatsheet de DataFrame do PySpark.
Vamos passar por etapas e comandos essenciais para começar com o PySpark. Antes de iniciar, garanta que o PySpark esteja instalado no seu ambiente Python, assim como Java e o Java JDK. Se precisar de ajuda, siga este guia de como começar com PySpark.
O primeiro passo é colocar o PySpark para rodar!
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()Vamos construir um DataFrame de exemplo para trabalharmos.
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()Saída:
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
	+----------+--------+------+
O groupBy do PySpark é uma transformação usada para dividir os dados em grupos com base em uma ou mais colunas, que depois podem ser agregados ou transformados de forma independente.
Usar o método groupBy é simples: você o chama no dataframe de interesse. Dá para usá-lo em qualquer tipo de coluna, desde que faça sentido particionar por ela. Por exemplo, convém evitar floats.
grouped = df.groupBy("department")Isso cria um objeto GroupedData, que não é um DataFrame em si. Ele orienta o Spark sobre como começar a particionar os dados. A partir desse GroupedData, você aplica agregações como .count() ou .sum() para obter um novo DataFrame.
grouped.count().show()O único parâmetro do método é *cols, que aceita nomes de coluna, expressões de coluna, ordinais de coluna (int) ou uma lista de colunas. Se a coluna for algo pelo qual você deseja particionar, pode usá-la na operação. O retorno é sempre um objeto GroupedData.
# agrupando por nome de coluna, como acima
	df.groupBy("department")

# agrupando por expressão de coluna
	df.groupBy(df.department)

# agrupando por ordinal da coluna
	df.groupBy(1)

# agrupando por lista de colunas; você pode misturar os métodos!
df.groupBy(["department", 2])Como mostrado acima, você pode agrupar por uma ou várias colunas. Uma única coluna é ótima quando você se interessa por um único eixo, como departamentos ou anos. Já várias colunas servem para trazer mais camadas de detalhe, por exemplo, vendedores específicos em diferentes departamentos ou meses específicos dentro de um ano.
# agrupando por coluna única
	df.groupBy("department").sum(“salary”).show()

# agrupando por múltiplas colunas
	df.groupBy(["department", 2]).sum(“salary”).show()
Como você provavelmente notou, o método groupBy funciona de forma muito semelhante ao GROUP BY do SQL. Mais adiante, vamos mostrar como usar essa linguagem também no PySpark.
O PySpark oferece uma ampla variedade de métodos de agregação nativos para trabalhar com dados agrupados. Se você já conhece SQL, vai reconhecer muitos deles, como count(), sum(), avg() e por aí vai. Você pode revisar nosso guia de funções de agregação em SQL.
Vamos passar pelas funções de agregação nativas:
count(): conta o número de registros na partiçãosum(): soma os valores numéricosavg(): calcula a média dos valores numéricosmin(): retorna o menor valor da partiçãomax(): retorna o maior valor da partiçãoAlém das funções de agregação, você pode anexar o método .alias() para renomear colunas e deixá-las mais fáceis de entender. Vamos mostrar um exemplo abaixo.
Em vez de executar cada agregação separadamente, você pode fazer várias de uma vez usando o método agg(). Cada agregação cria uma nova coluna no seu dataframe. Isso também reduz a necessidade de várias chamadas a groupBy, o que melhora a performance. Não é preciso agregar na mesma coluna com agg(); você pode definir uma coluna diferente para cada função de agregação.
# Depois de iniciar a sessão
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()Saída:
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+Uma das grandes vantagens do PySpark é poder usar padrões de agregação mais avançados, como pivotar os dados, fazer rollup e criar cubos de dados. Você também pode criar grouping sets.
Assim como criar uma tabela dinâmica no Excel, você pode pivotar os dados em diferentes colunas. Neste caso, estamos agrupando por department e pivotando a coluna employee para ver o salário total de cada pessoa.
Isso significa que cada linha mostra o departamento e cada coluna representa os funcionários daquele departamento. Dá para ver como isso seria poderoso se tivéssemos dados por ano e quiséssemos comparar o desempenho de cada departamento ano a ano.
df.groupBy("department").pivot("employee").sum("salary").show()Duas formas bem poderosas de agregar dados são rollup() e cube(). Enquanto um groupby() simples mostra os resultados para as agregações existentes, rollup() e cube() são estruturas hierárquicas. Ou seja, agregam em níveis mais granulares.
Por exemplo, rollup() agrega da esquerda para a direita, mostrando cada permutação possível se fôssemos iterar passo a passo. Para cada departamento, mostramos cada pessoa do departamento e também o grupo final (agregado) daqueles que não estão especificados.
Já o cube() mostra todas as permutações possíveis para todas as colunas agregadas: cada departamento separadamente, cada funcionário separadamente e todas as combinações entre ambos.
Resumindo:
Veja um exemplo no código e na saída abaixo:
rollup() Código:
# usando rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() Saída:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() Código:
# usando cube
df.cube("department", "employee").sum("salary").show()
cube() Saída:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+
Grouping sets permitem definir múltiplos níveis de agregação. No exemplo, estou agregando no nível de departamento e funcionário, apenas por departamento e o total geral para obter o salário total.
Você vai notar que a sintaxe do método groupingSets() é um pouco diferente. Primeiro você define a lista de conjuntos [(“department”, “employee”), (“department”, ), ()], em que o primeiro é departamento e funcionário, o segundo apenas departamentos e o último () significa todos (total geral).
Depois você define as colunas de agregação dentro dos conjuntos. O restante é escrito normalmente usando .agg().
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()Saída:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+Por fim, podemos criar funções de agregação personalizadas usando User Defined Functions (UDFs) no PySpark. Existem duas formas: udf e pandas_udf. Ambas permitem criar funções customizadas, cada uma com seus prós e contras.
A udf padrão do Spark permite criar funções nativas do Spark. Isso significa que a sintaxe e os tipos de dados precisam funcionar nativamente no Spark. Embora isso limite um pouco o que pode ser feito na UDF, você aproveita ao máximo o poder computacional distribuído do Spark, sendo melhor para conjuntos de dados maiores.
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
Já a pandas_udf permite criar funções personalizadas mais "pythônicas". Você fica limitado apenas ao que é possível no Pandas, e não só no Spark.
Porém, isso significa que você não aproveita o poder computacional distribuído do Spark e passa a depender de computação local. É mais indicada para conjuntos de dados pequenos a médios.
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
No geral, use funções personalizadas apenas quando não houver uma forma melhor de realizar a agregação. Não reinvente a roda!
Além disso, se algo puder ser vetorizado (como as funções acima), prefira uma versão vetorizada em vez de uma UDF de agregação. Para saber mais sobre groupBy(), leia este artigo que aprofunda o framework split-apply-combine com pandas.
No PySpark, você pode filtrar grupos com base em métricas agregadas após o agrupamento usando o método filter(). Nele, você fornece uma condição em expressões Python ou SQL.
Aliás, você também pode usar where() se preferir, pois é apenas um alias de filter() e realiza a mesma operação.
Você pode escolher filtrar antes ou depois da agregação. Filtrar antes impacta a agregação ao limitar quais dados serão agregados e pode melhorar a performance.
Por exemplo, talvez a gente só queira contar o número de funcionários acima de um certo salário para encontrar o número de colaboradores com "salário alto".
# filtrar por salários altos
filter_df = df.filter(df.salary > 4000)

# agregar e encontrar o total de funcionários com salário alto
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
Já filtrar depois da agregação não impacta a agregação original. Talvez a gente queira contar todos os funcionários de um departamento e só visualizar departamentos acima de um certo tamanho. Isso adiciona uma camada extra de processamento, mas não deve aumentar muito a carga computacional.
# criando um dataframe com a contagem de funcionários
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# filtrando departamentos com mais de 1 funcionário
agg_df.where("num_employees > 1").show()
Escolha bem quando filtrar, pois isso impacta a precisão e o resultado final. Filtrar antes pode reduzir o total final, enquanto filtrar depois pode deixar muitos no resultado.
Embora o PySpark otimize automaticamente a operação groupBy, existem estratégias para aumentar ainda mais a velocidade de processamento. Coisas como minimizar shuffles de dados, mitigar skew e otimizar a execução contribuem para melhorar a performance do groupBy.
O groupBy causa um shuffle, que redistribui dados entre partições para agrupar chaves semelhantes. Shuffles consomem rede e disco, então minimizá-los ou otimizá-los é essencial. Algumas técnicas importantes:
repartition() com critério: você pode indicar por qual coluna os dados devem ser particionados, reduzindo o escopo de busca.Veja alguns exemplos de como melhorar o gerenciamento de shuffle.
# reduzir o número de partições de shuffle
spark.conf.set("spark.sql.shuffle.partitions", "64")  # Ajuste conforme o tamanho do cluster

# garantir que o spark comprima os dados
spark.conf.set("spark.shuffle.compress", "true") # comprime a transferência de rede
spark.conf.set("spark.shuffle.spill.compress", "true") # comprime o spill em disco

# reparticiona os dados antes do agrupamento para otimizar a agregação
df.repartition("department").groupBy("department").sum("salary").show()O skew acontece quando certas chaves aparecem muito mais do que outras, gerando cargas desiguais nas partições e tarefas lentas. Isso sobrecarrega alguns workers mais do que outros. Podemos minimizar o skew e distribuir o trabalho de forma mais uniforme com salting, evitando joins enviesados e usando broadcast joins para dimensões menores.
# Exemplo de salting:

df = df.withColumn("salted_key", sf.rand()) # cria coluna aleatória
df = df.repartition(2, 'salted_key') # usa para reparticionar os dados
df.groupBy(sf.spark_partition_id()).count().show()Os planos lógico e físico de execução dos jobs PySpark podem ser otimizados com recursos nativos. Eles melhoram a performance das suas agregações com groupBy.
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # você pode fazer cache de resultados intermediários

# use broadcasting (pseudocódigo aqui):
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
Para mais detalhes sobre como otimizar operações no PySpark, leia este artigo sobre joins no PySpark para entender a mecânica por trás.
Embora a API de DataFrame seja a interface recomendada para a maioria dos usuários de PySpark, graças à sua abstração de alto nível e eficiência (via Catalyst Optimizer), entender a camada de RDD (Resilient Distributed Dataset) pode ser valioso, especialmente para quem quer mais controle ou está migrando código legado do Spark. Em geral, porém, usar a API de DataFrame ou SQL tende a entregar melhor performance.
O RDD é o componente central do PySpark, sobre o qual tudo (incluindo a API de DataFrame) é construído. Ele costuma trabalhar em memória e lida melhor com dados de streaming do que a API de DataFrame. Entretanto, os dados são imutáveis, então não podem ser alterados após a criação do RDD.
Esta seção compara o groupBy na API de DataFrame com seus equivalentes na API de RDD, analisando performance e aderência ao caso de uso.
Primeiro, vamos transformar o dataframe em um RDD.
# Converter DataFrame para RDD de (chave, valor)
rdd = df[['department','salary']].rdd
rdd.collect()
Agora podemos executar operações como groupByKey() e reduceByKey() no RDD. Vamos ver o groupByKey() primeiro.
O método groupByKey() envia todos os valores com a mesma chave para o mesmo executor e depois os agrupa. Por isso, pode levar bastante tempo para redistribuir os dados para a chave correta. Isso também pode gerar skew.
rdd.groupByKey().mapValues(list).collect()Em vez disso, podemos usar o método reduceByKey(). Ele primeiro agrega em cada partição e depois envia os dados pela rede. Isso minimiza a quantidade de dados em shuffle e, como resultado, funciona mais rápido.
Portanto, reduceByKey é fortemente recomendado em vez de groupByKey porque reduz significativamente as operações de shuffle.
Na prática, ele agrega em cada partição, depois combina os dados e então agrega novamente. É ideal para agregações que unem chaves, como sum() e max().
from operator import add

rdd.reduceByKey(add).collect()Aqui vai uma tabela que resume as vantagens de cada método de agregação.
|
Recurso |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
Nível de abstração |
Alto |
Baixo |
Baixo |
|
Execução otimizada |
Sim (Catalyst & Tungsten) |
Não |
Não |
|
Minimização de shuffle |
Sim |
❌ (shuffle completo) |
✅ (com combiner) |
|
Eficiência de memória |
Alta |
Baixa |
Média–Alta |
|
Flexibilidade |
Moderada |
Alta |
Média |
|
Performance em Big Data |
Excelente |
Fraca |
Boa |
|
Uso recomendado |
Maioria dos casos |
Raro/especializado |
Agregações customizadas e de baixo nível |
O curso Fundamentos de Big Data com PySpark cobre programação com RDDs em mais detalhes e descreve como eles são a espinha dorsal do PySpark.
Outra maneira de fazer agregações no PySpark é usar a API SQL para escrever instruções em SQL. É uma ótima opção se você se sente mais confortável com SQL.
O primeiro passo é criar uma visão temporária com o método createOrReplaceTempView() do DataFrame. Depois, use spark.sql() para escrever sua consulta.
# Criar uma visão temporária a partir do DataFrame
df.createOrReplaceTempView("employees")

# Escrever uma instrução em SQL
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()Saída:
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
Como você vê, é tão fácil quanto escrever uma query SQL normal. Os principais motivos para usar a API SQL são familiaridade e facilidade para escrever consultas. A API de DataFrame costuma ser melhor por fornecer tipos de dados consistentes e, geralmente, otimizar mais.
Você também ganha acesso a métodos de DataFrame que não teria com a API Spark SQL. Para saber mais sobre o GROUP BY no SQL, leia este artigo sobre GROUP BY e HAVING em SQL.
Existem muitas aplicações práticas para agregar seus dados. Na verdade, é quase certo que você vai precisar agregar de alguma forma para analisar e compartilhar resultados.
Abaixo, trazemos alguns exemplos de diferentes casos de uso de agregações. Alguns podem ser pseudocódigo ou não se aplicar exatamente ao nosso dataset de teste; a ideia é inspirar como você pode escrever essas agregações.
Um tema recorrente que discutimos é o uso de groupBy como meio de análise hierárquica. Imagine que temos uma coluna "revenue" e queremos ver o desempenho de cada departamento. Podemos agrupar por departamento e avaliar a contribuição de receita de cada um.
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()Agregações dão acesso a funções de janela (window functions). Essas funções analisam uma janela deslizante de dados, seja por linhas sequenciais ou por períodos de tempo sequenciais.
Primeiro definimos uma janela usando o objeto Window para indicar o que queremos partitonBy e orderBy. Em seguida, usamos esse objeto no método over() da função de agregação escolhida. Por exemplo, uma média móvel ficaria sf.avg().over(window).show().
Imagine que queremos ver a média móvel de salários por departamento. Agruparíamos por department e ordenaríamos por uma nova coluna que podemos chamar de employeeId. Como IDs de funcionários costumam ser sequenciais, dá para ver como a média salarial mudou ao longo do tempo.
from pyspark.sql.window import Window

# Definir a janela que queremos particionar e ordenar
windowSpec = Window.partitionBy("department").orderBy("employeeId")

# Executar sf.avg na coluna “salary” sobre a windowSpec
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
Isso é bem parecido com como fazemos funções de janela em SQL.
Talvez queiramos entender várias métricas de usuário em uma empresa de mídia. Queremos, por exemplo, tempo total assistido e número de vídeos únicos. Podemos fazer groupBy() em uma coluna user_id e depois .agg() com funções como sum() e countDistinct() para diferentes métricas.
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), # soma de minutos assistidos
    sf.countDistinct("video_id").alias("unique_views") # contagem de vídeos únicos assistidos
).show()Ao agregar dados no PySpark, é fácil cair em armadilhas que levam a baixa performance e tempos longos de execução. Seguir estas boas práticas ajuda a garantir performance, correção e escalabilidade.
Aqui estão alguns jeitos comuns de transformar consultas simples em programas que demoram a rodar.
groupByKey() em RDDs:groupByKey() em RDDs, pois seu mecanismo faz o PySpark distribuir dados entre partições. Isso pode gerar grande overhead de rede e disco.reduceByKey() ou fique na API de DataFrame.repartition().sum() em um groupBy e depois count() no mesmo conjunto agrupado em outra linha — quebram a capacidade de otimização do PySpark e geram planos ineficientes.persist() ou cache() ao reutilizar dados agrupados.Aqui vão algumas formas de otimizar suas agregações no PySpark para manter tudo fluindo bem!
na.fill() ou na.drop() antes da agregação.df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions com base no volume de dados e teste o melhor número de partições..explain() para entender a execução física.df.groupBy("department").sum("salary").explain(True)Saída:
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
O Spark tem diversas configurações que podem ser ajustadas para workloads grandes de groupBy. Veja a tabela abaixo com algumas chaves importantes.
|
Configuração |
Descrição |
|
|
Controla o número de partições para shuffles. Reduza para jobs pequenos, aumente para grandes. (Padrão: 200) |
|
|
Habilita broadcast automático de tabelas pequenas. Defina -1 para desabilitar ou aumente para suportar joins maiores. (Padrão: 10MB) |
|
|
Controla a memória disponível por executor. Aumente para grandes agregações. (Padrão: 4g) |
|
|
Habilita o Adaptive Query Execution (AQE), que pode otimizar dinamicamente shuffles, skew e joins. (Padrão: true) |
Para usuários avançados ou quem lida com datasets muito grandes, entender como o groupBy se comporta por baixo dos panos é essencial. Vamos cobrir alguns pontos finos de como esse método funciona.
Todas as operações de DataFrame no PySpark, incluindo groupBy, são avaliadas de forma preguiçosa. Ou seja, nenhuma computação real acontece até que uma ação (como show() ou collect()) seja acionada.
Isso permite ao Catalyst reorganizar, combinar ou remover operações para melhorar a performance. Aproveite isso e encadeie múltiplas agregações e métodos para que o Spark crie um plano otimizado.
Ao usar groupBy(), é retornado um objeto GroupedData. Executar uma função de agregação, como sum(), retorna então um objeto tipo DataFrame. Usando show(), você verá os resultados.
Lembre que groupBy().agg() retorna um novo DataFrame com colunas recém-nomeadas. Sempre use aliases com o método alias() para evitar colisões de nomes e deixar as saídas mais claras. Se você não usar aliases, isso pode levar a colisões de nomes de coluna ou problemas em joins mais adiante.
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)Um ponto importante no PySpark: a agregação retornada não preserva a ordem das linhas. Use orderBy() para saídas previsíveis e ordenação consistente.
df.groupBy("department").sum("salary").orderBy("department").show()Existem mudanças e limitações específicas em cada versão do PySpark. O Catalyst foi introduzido na 1.3 e melhorado significativamente na 2.0. Alguns métodos só chegaram em versões posteriores, como groupingSets().
Aqui está uma tabela com algumas das maiores mudanças funcionais no PySpark. Garanta que você usa a versão certa do Spark e do PySpark para os recursos de que precisa!
|
Recurso |
Versão do Spark |
Descrição |
|
|
1.4+ |
Agregações hierárquicas úteis em analytics estilo OLAP (3.4+ suporta Spark Connect) |
|
|
2.3+ |
UDFs vetorizadas usando Apache Arrow para execução mais rápida (3.4+ suporta Spark Connect, 4.0+ suporta SCALAR) |
|
Adaptive Query Execution (AQE) |
3.0+ |
Ajusta dinamicamente joins, shuffles e tratamento de skew em tempo de execução |
|
Modo de compatibilidade ANSI SQL |
3.0+ |
Relatos de erro e comportamento de expressões mais precisos |
|
|
4.0+ |
Permite múltiplos agrupamentos em uma única agregação (por exemplo, subtotais) |
A função groupBy do PySpark é uma ferramenta essencial para agregação de dados em ambientes distribuídos. Seja para resumir dados por região, calcular métricas médias ou realizar análises complexas em múltiplos níveis, o groupBy oferece uma API escalável e flexível para workloads de big data.
Só não esqueça destas boas práticas para reduzir tempo de execução e custos:
Conforme o PySpark evolui, podemos esperar otimizações ainda mais inteligentes, suporte nativo a agregações complexas e melhor integração com Pandas e sintaxe ao estilo SQL. É possível que traga integração ainda melhor com modelos em larga escala. Se você quer se aprofundar em PySpark, confira estes recursos da DataCamp:
Principais cursos de PySpark
Curso
Curso
Curso
blog
Moez Ali
9 min
Tutorial
Natassha Selvaraj
10 min
Tutorial
Eugenia Anello
6 min
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
7 min
Tutorial
Kevin Babitz
8 min