
कोर्स
PySpark की नींव
4 घंटा
157.9K
बिग डेटा की दुनिया में हम शायद ही कभी कच्चे डेटा को देखते रह जाते हैं। डेटा को अधिक सुगम बनाने के लिए ग्रुपिंग और एग्रीगेशन एक सामान्य और शक्तिशाली ऑपरेशन है। जब आप Apache Spark और Python जैसे डिस्ट्रीब्यूटेड सिस्टम्स के साथ काम करते हैं, तो PySpark का groupBy फंक्शन हमें हमारे वितरित डेटा को इकट्ठा और संक्षेप करने देता है। यह SQL के GROUP BY क्लॉज़ की क्षमता को दर्शाता है, लेकिन इसे बड़े पैमाने पर डिस्ट्रीब्यूटेड डेटा प्रोसेसिंग को कुशलता से संभालने के लिए डिज़ाइन किया गया है।
PySpark का groupBy उपयोगकर्ताओं को विभिन्न कॉलम के आधार पर डेटा को विभाजित करने देता है, जिसे बाद में sums, averages आदि जैसे अलग-अलग मापों में एग्रीगेट किया जा सकता है। इसे कुशलता से करने के लिए, PySpark split-apply-combine पैरेडाइम का पालन करता है:
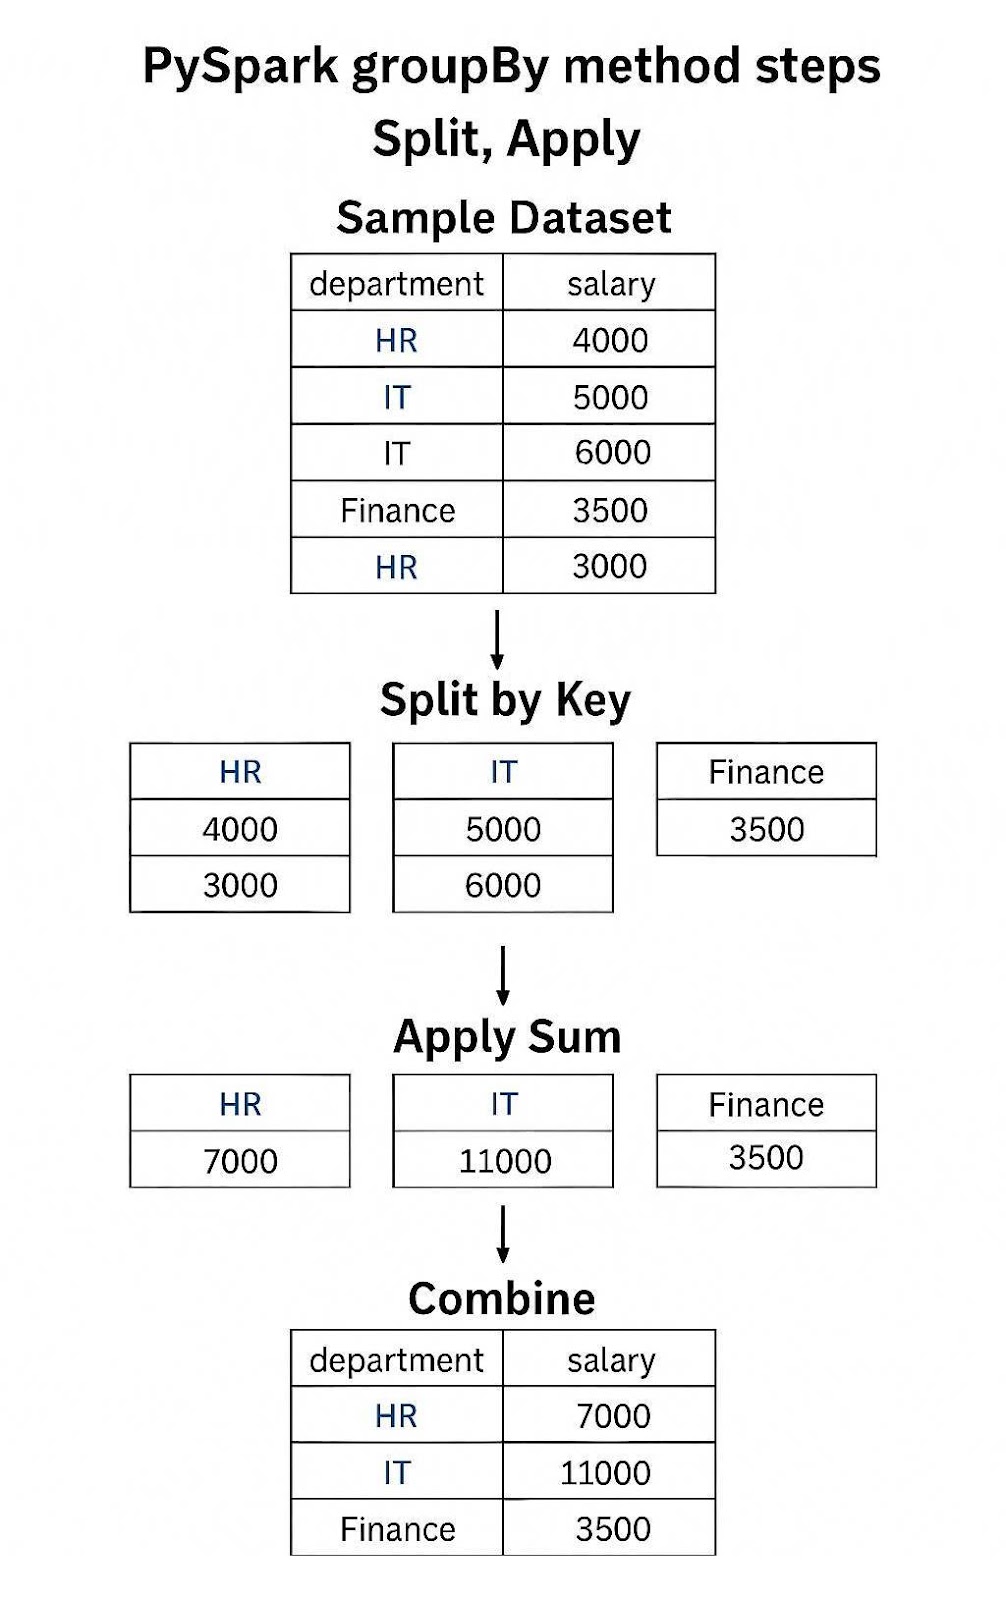
Sum लागू करते हुए PySpark के groupBy() मेथड का उदाहरण
PySpark लेज़ी इवैल्यूएशन का उपयोग करता है, यानी groupBy जैसे ऑपरेशन तब ही कंप्यूट होते हैं जब show() या collect() जैसी actions कॉल की जाती हैं। इसके बजाय, PySpark पहले एक प्रारंभिक DAG (Directed Acyclic Graph) बनाता है, जिसे प्रदर्शन के लिए परिष्कृत किया जाता है। यह Spark को निष्पादन से पहले क्वेरी प्लान को ऑप्टिमाइज़ करने में मदद करता है।
यदि आपने अभी तक PySpark के साथ काम नहीं किया है, तो मैं Big Data Fundamentals with PySpark देखने की अत्यधिक अनुशंसा करता/करती हूँ।
सबसे पहले, हमें एक PySpark DataFrame चाहिए। यदि आपको विभिन्न PySpark कमांड्स पर रीफ़्रेशर चाहिए, तो यह शानदार PySpark DataFrame Cheatsheet देखें।
हम कुछ प्रमुख चरणों और कमांड्स पर जाएँगे जो PySpark शुरू करने में मदद करेंगे। आरंभ करने से पहले सुनिश्चित करें कि आपके Python वातावरण में PySpark, Java और Java JDK इंस्टॉल हैं। यदि आपको सहायता चाहिए, तो getting started with PySpark पर इस गाइड का पालन करें।
पहला कदम है PySpark को चलाना!
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()आइए एक सैंपल DataFrame बनाते हैं जिस पर हम काम कर सकें।
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()आउटपुट:
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
	+----------+--------+------+
PySpark का groupBy एक ट्रांसफ़ॉर्मेशन है जो एक या अधिक कॉलम्स के आधार पर डेटा को समूहों में विभाजित करता है, जिन्हें बाद में स्वतंत्र रूप से एग्रीगेट या ट्रांसफ़ॉर्म किया जा सकता है।
groupBy मेथड का उपयोग करना आसान है; आप इसे अपने इच्छित DataFrame पर कॉल कर सकते हैं। आप इसे किसी भी कॉलम प्रकार पर इस्तेमाल कर सकते हैं, बशर्ते कि उस पर पार्टिशनिंग उपयुक्त हो। उदाहरण के लिए, फ्लोट्स से बचना चाहेंगे।
grouped = df.groupBy("department")यह एक GroupedData ऑब्जेक्ट बनाता है, जो स्वयं DataFrame नहीं है। यह Spark को बताता है कि वह डेटा को कैसे पार्टिशन करना शुरू करेगा। एक बार जब आपके पास यह GroupedData ऑब्जेक्ट हो, तो आप .count() या .sum() जैसे एग्रीगेशन लगाकर नया DataFrame प्राप्त कर सकते हैं।
grouped.count().show()इस मेथड का एकमात्र पैरामीटर *cols है, जो कॉलम नाम, कॉलम एक्सप्रेशन्स, कॉलम ऑर्डिनल (int), या कॉलम्स की सूची स्वीकार करता है। जब तक कॉलम वह है जिस पर आप पार्टिशन करना चाहते हैं, आप उसे ऑपरेशन में उपयोग कर सकते हैं। यह हमेशा एक GroupedData ऑब्जेक्ट लौटाता है।
# grouping by column name like above
	df.groupBy("department")

# grouping by column expression
	df.groupBy(df.department)

#grouping by column ordinal
	df.groupBy(1)

#grouping by list of columns, you can mix the methods!
df.groupBy(["department", 2])जैसा कि ऊपर दिखाया गया है, आप एकल या एकाधिक कॉलम्स पर ग्रुप कर सकते हैं। एकल कॉलम तब अच्छा है जब आप केवल एक ही अक्ष पर रुचि रखते हैं, जैसे विभाग या वर्ष। एकाधिक कॉलम तब उपयोगी हैं जब आप अधिक परतों में विवरण चाहते हैं, जैसे विभिन्न विभागों में विशिष्ट सेल्सपर्सन, या एक वर्ष के भीतर विशिष्ट महीने।
# grouping by single column
	df.groupBy("department").sum(“salary”).show()

#grouping by multiple columns
	df.groupBy(["department", 2]).sum(“salary”).show()
जैसा कि आपने देखा होगा, groupBy मेथड SQL के GROUP BY स्टेटमेंट्स के बहुत समान काम करता है। हम आगे चलकर PySpark में उसी भाषा का उपयोग करने का एक तरीका भी दिखाएँगे।
PySpark समूहित डेटा के साथ काम करने के लिए बिल्ट-इन एग्रीगेशन मेथड्स की एक विस्तृत श्रृंखला का समर्थन करता है। यदि आप SQL से परिचित हैं, तो आप इनमें से कई से परिचित होंगे, जैसे count(), sum(), avg() आदि। एक रीफ़्रेशर के लिए हमारा aggregate functions in SQL गाइड देखें।
आइए बिल्ट-इन एग्रीगेशन फंक्शंस पर जाएँ:
count(): इस पार्टिशन में रिकॉर्ड्स की संख्या गिनता हैsum(): संख्यात्मक मानों का कुल जोड़ता हैavg(): संख्यात्मक मानों का औसत निकालता हैmin(): पार्टिशन का सबसे छोटा मान लौटाता हैmax(): पार्टिशन का सबसे बड़ा मान लौटाता हैएग्रीगेशन फंक्शंस के अलावा, आप कॉलम्स का नाम अधिक समझने योग्य बनाने के लिए .alias() मेथड भी जोड़ सकते हैं। हम नीचे एक उदाहरण दिखाएँगे।
प्रत्येक एग्रीगेशन को अलग-अलग करने के बजाय, आप agg() मेथड का उपयोग करके एक साथ कई एग्रीगेशन कर सकते हैं। प्रत्येक एग्रीगेशन आपके DataFrame में एक नया कॉलम बनाएगा। यह कई groupBy कॉल्स की आवश्यकता को भी कम करता है, जिससे प्रदर्शन बेहतर होता है। agg() के साथ हमें एक ही कॉलम पर एग्रीगेट करने की आवश्यकता नहीं है—आप प्रत्येक एग्रीगेशन फंक्शन के लिए अलग कॉलम परिभाषित कर सकते हैं।
# After already starting your session
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()आउटपुट:
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+PySpark का लाभ यह है कि आप अधिक उन्नत एग्रीगेशन पैटर्न का उपयोग कर सकते हैं, जैसे अपने डेटा को पिवट करना, रोलअप करना और डेटा क्यूब बनाना। आप grouping sets भी बना सकते हैं।
Excel में पिवट टेबल बनाने की तरह, आप डेटा में अलग-अलग कॉलम्स पर अपने डेटा को पिवट कर सकते हैं। इस उदाहरण में, हम department द्वारा ग्रुप कर रहे हैं और प्रत्येक कर्मचारी के कुल वेतन को देखने के लिए employee कॉलम पर पिवट कर रहे हैं।
इसका मतलब है प्रत्येक पंक्ति विभाग दिखाएगी, और प्रत्येक कॉलम उस विभाग के कर्मचारी होंगे। आप देख सकते हैं कि यह कितना शक्तिशाली हो सकता है यदि हमारे पास वर्षों के अनुसार डेटा हो, और हम देखना चाहते हों कि प्रत्येक विभाग ने वर्ष-दर-वर्ष कैसा प्रदर्शन किया।
df.groupBy("department").pivot("employee").sum("salary").show()डेटा को एग्रीगेट करने के दो बहुत शक्तिशाली तरीके rollup() और cube() हैं। जहाँ साधारण groupby() केवल मौजूदा एग्रीगेशन्स के परिणाम दिखाता है, वहीं rollup() और cube() दोनों पदानुक्रमिक संरचनाएँ हैं। यानी ये अधिक सूक्ष्म स्तर पर डेटा एग्रीगेट करते हैं।
उदाहरण के लिए, rollup() बाएँ से दाएँ एग्रीगेट करता है, और यदि हम चरण-दर-चरण इटरेशन से गुजरें तो प्रत्येक संभावित क्रमचय दिखाता है। प्रत्येक विभाग के लिए, हम उस विभाग के प्रत्येक व्यक्ति को दिखाते हैं और साथ ही उन लोगों का अंतिम समूह भी जो नहीं हैं।
दूसरी ओर cube() सभी एग्रीगेटेड कॉलम्स के लिए सभी संभावित क्रमचयों को दिखाता है, इसलिए प्रत्येक विभाग अलग-अलग, प्रत्येक कर्मचारी अलग-अलग, और दोनों के हर संयोजन के लिए।
संक्षेप में:
आप नीचे कोड और आउटपुट में उदाहरण देख सकते हैं:
rollup() कोड:
# using rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() आउटपुट:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() कोड:
#using cube
df.cube("department", "employee").sum("salary").show()
cube() आउटपुट:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+Grouping sets आपको एग्रीगेशन के कई लेवल परिभाषित करने देते हैं। इस उदाहरण में, मैं विभाग और कर्मचारी स्तर पर, विभाग स्तर पर, और सभी स्तरों पर कुल वेतन प्राप्त करने के लिए एग्रीगेट कर रहा/रही हूँ।
आप देखेंगे कि groupingSets() मेथड का सिन्टैक्स थोड़ा अलग है। आप पहले सेट्स की सूची परिभाषित करते हैं [(“department”, “employee”), (“department”, ), ()] जहाँ पहला सेट विभाग और कर्मचारी है, दूसरा सेट केवल विभाग है, और अंतिम सेट () का अर्थ है सभी।
इसके बाद आप सेट्स के भीतर एग्रीगेशन के कॉलम परिभाषित करते हैं। बाकी हिस्सा सामान्य रूप से .agg() का उपयोग करके लिखा जाता है।
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()आउटपुट:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+अंत में, हम PySpark में User Defined Functions (UDFs) का उपयोग करके कस्टम एग्रीगेशन फंक्शंस बना सकते हैं। इसके दो तरीके हैं: udf और pandas_udf। दोनों आपको अपने कस्टम फंक्शंस बनाने देते हैं, जिनके अपने-अपने फायदे/नुकसान हैं।
स्टैंडर्ड Spark udf आपको Spark-नेटिव फंक्शंस बनाने देता है। यानी सिन्टैक्स और डेटा टाइप्स Spark में नेटिव तौर पर काम करने चाहिए। यह UDF में किए जा सकने वाले कुछ कार्यों को सीमित तो करता है, लेकिन यह Spark की डिस्ट्रीब्यूटेड कम्प्यूटेशनल शक्ति का पूरा लाभ लेने देता है और बड़े डेटासेट्स के लिए बेहतर है।
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
दूसरी ओर, pandas_udf आपको अधिक Pythonic कस्टम फंक्शंस बनाने देता है। अब आप केवल Pandas में संभव बातों तक ही बाध्य हैं, न कि सिर्फ Spark तक।
हालाँकि, इसका मतलब है कि आप Spark की डिस्ट्रीब्यूटेड कम्प्यूटेशनल शक्ति का उपयोग नहीं कर पाएँगे और स्थानीय कम्प्यूटेशन पर निर्भर रहेंगे। यह छोटे से मध्यम आकार के डेटासेट्स के लिए बेहतर है।
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
कुल मिलाकर, कस्टम फंक्शंस का उपयोग तभी करें जब एग्रीगेशन करने के बेहतर तरीके उपलब्ध न हों। पहिया दोबारा न बनाएँ!
साथ ही, यदि कुछ वेक्टराइज़ किया जा सकता है (जैसे ऊपर के फंक्शंस), तो एग्रीगेशन UDF की जगह फंक्शन का वेक्टराइज़्ड संस्करण उपयोग करें। groupBy() पर अधिक जानकारी के लिए, यह लेख पढ़ें जो pandas के साथ split-apply-combine फ्रेमवर्क में गहराई से जाता है।
PySpark में, आप filter() मेथड का उपयोग करके ग्रुपिंग के बाद एग्रीगेट मेट्रिक्स के आधार पर समूहों को फ़िल्टर कर सकते हैं। इस मेथड में, आप Python या SQL एक्सप्रेशन्स में से किसी में भी एक कंडीशन देते हैं।
इसी संदर्भ में, आप चाहें तो where() का भी उपयोग कर सकते हैं, क्योंकि यह बस filter() का एक एलियस है और वही ऑपरेशन करता है।
आप एग्रीगेशन से पहले या बाद में फ़िल्टर करना चुन सकते हैं। पहले फ़िल्टर करना इस बात को प्रभावित करेगा कि कौन सा डेटा एग्रीगेट होगा और प्रदर्शन में सुधार कर सकता है।
उदाहरण के लिए, मान लीजिए हम केवल एक निश्चित वेतन से ऊपर के कर्मचारियों की संख्या गिनना चाहते हैं ताकि “उच्च-वेतन” कर्मचारियों की संख्या पता चल सके।
#filter for high salaries
filter_df = df.filter(df.salary > 4000)

#aggregate and find the total of high salary employees
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
हालाँकि, एग्रीगेशन के बाद फ़िल्टर करना मूल एग्रीगेशन को प्रभावित नहीं करेगा। हो सकता है हम किसी विभाग में सभी कर्मचारियों की गिनती करना चाहें और केवल उन विभागों को देखना चाहें जिनका आकार एक सीमा से ऊपर हो। इससे प्रोसेसिंग की एक अतिरिक्त परत जुड़ जाएगी, लेकिन कम्प्यूटेशनल लोड बहुत अधिक नहीं बढ़ना चाहिए।
# creating a dataframe counting the number of employees
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# filtering for departments where there is more than 1 employee
agg_df.where("num_employees > 1").show()
बुद्धिमानी से तय करें कि कब फ़िल्टर करना है, क्योंकि यह सटीकता और अंतिम परिणाम को प्रभावित करेगा। पहले फ़िल्टर करना अंतिम योग को कम कर सकता है, जबकि बाद में फ़िल्टर करना अंतिम उत्तर में बहुत कुछ छोड़ सकता है।
हालाँकि PySpark स्वतः groupBy ऑपरेशन को ऑप्टिमाइज़ करता है, फिर भी कुछ रणनीतियाँ हैं जो प्रोसेसिंग स्पीड को और बेहतर कर सकती हैं। डेटा शफ़लिंग को कम करना, स्क्यू शमन, और निष्पादन अनुकूलन जैसी बातें groupBy प्रदर्शन सुधारने में भूमिका निभाती हैं।
groupBy एक शफ़ल करवाता है, जो समान कीज़ को साथ लाने के लिए डेटा को पार्टिशनों में फिर से वितरित करता है। शफ़ल नेटवर्क और डिस्क पर भारी होता है, इसलिए उन्हें कम या ऑप्टिमाइज़ करना महत्वपूर्ण है। यहाँ कुछ प्रमुख तकनीकें हैं:
repartition() का समझदारी से उपयोग करें; आप PySpark को बता सकते हैं कि किस कॉलम पर डेटा पार्टिशन होना चाहिए ताकि डेटा खोजने के लिए कम जगहों पर जाना पड़ेयहाँ कुछ उदाहरण हैं कि आप शफ़ल प्रबंधन को कैसे बेहतर कर सकते हैं।
# reduce the number of shuffle partitions
spark.conf.set("spark.sql.shuffle.partitions", "64")  # Adjust based on cluster size

# make sure spark compresses the data
spark.conf.set("spark.shuffle.compress", "true") # compresses network transfer
spark.conf.set("spark.shuffle.spill.compress", "true") # compresses disk spillage

# repartitions the data prior to grouping to optimize aggregation
df.repartition("department").groupBy("department").sum("salary").show()डेटा स्क्यू तब होता है जब कुछ कीज़ अन्य की तुलना में असमान रूप से अधिक दिखाई देती हैं, जिससे पार्टिशन लोड असमान हो जाते हैं और टास्क धीमे हो जाते हैं। इससे कुछ वर्कर्स पर अधिक दबाव पड़ता है। हम साल्टिंग, स्क्यूड जॉइन्स को कम करने, और छोटे डाइमेंशन्स के लिए ब्रॉडकास्ट जॉइन्स का उपयोग करके स्क्यू को कम कर सकते हैं और कार्य को अधिक समान रूप से वितरित कर सकते हैं।
# Salting example:

df = df.withColumn("salted_key", sf.rand()) #Create column of random
df = df.repartition(2, 'salted_key') # use this to repartition data
df.groupBy(sf.spark_partition_id()).count().show()PySpark जॉब्स की लॉजिकल और फिजिकल एक्ज़ीक्यूशन प्लान्स को बिल्ट-इन फीचर्स से ऑप्टिमाइज़ किया जा सकता है। ये आपके groupBy एग्रीगेशन्स के प्रदर्शन को बढ़ा सकते हैं।
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # you can cache your intermediate results

# use broadcasting (pseudocode here):
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
PySpark के ऑपरेशन्स को कैसे ऑप्टिमाइज़ कर सकते हैं, इस पर और विवरण के लिए, PySpark Joins पर यह लेख पढ़ें ताकि कुछ अंतर्निहित यांत्रिकी को समझ सकें।
हालाँकि DataFrame API उच्च-स्तरीय एब्स्ट्रैक्शन और प्रदर्शन दक्षता (Catalyst Optimizer की बदौलत) के कारण अधिकांश PySpark उपयोगकर्ताओं के लिए अनुशंसित इंटरफ़ेस है, फिर भी Resilient Distributed Dataset (RDD) लेयर को समझना मूल्यवान हो सकता है, खासकर उनके लिए जो अधिक नियंत्रण चाहते हैं या लेगेसी Spark कोड माइग्रेट कर रहे हैं। सामान्यतः, DataFrame या SQL API बेहतर प्रदर्शन देगा।
RDD PySpark का कोर कंपोनेंट है, जिस पर बाकी सब (DataFrame API सहित) बना है। यह प्रायः इन-मेमाेरी काम करता है और स्ट्रीमिंग डेटा को DataFrame API की तुलना में कुछ बेहतर संभालता है। हालाँकि, डेटा इम्यूटेबल होता है और RDD बन जाने के बाद बदला नहीं जा सकता।
यह अनुभाग DataFrame API में groupBy की तुलना RDD API में उसके समकक्षों से करता है, और प्रदर्शन व उपयोग-केस फिट दोनों का विश्लेषण करता है।
सबसे पहले, DataFrame को RDD में बनाते हैं।
# Convert DataFrame to RDD of (key, value)
rdd = df[['department','salary']].rdd
rdd.collect()
अब हम RDD पर groupByKey() और reduceByKey() जैसी चीजें कर सकते हैं। पहले groupByKey() को कवर करते हैं।
groupByKey() मेथड समान की वाले सभी मानों को उसी एक्ज़ीक्यूटर पर शफ़ल करता है और फिर उन्हें समूहित करता है। इस वजह से, डेटा को सही की तक शफ़ल होने में वास्तव में अधिक समय लग सकता है। यह डेटा स्क्यू का कारण भी बन सकता है।
rdd.groupByKey().mapValues(list).collect()इसके बजाय, हम reduceByKey() मेथड आज़मा सकते हैं। यह मेथड पहले प्रत्येक पार्टिशन पर एग्रीगेट करता है और फिर डेटा को नेटवर्क के पार ले जाता है। यह शफ़ल होने वाले डेटा की मात्रा को कम करता है और परिणामस्वरूप अधिक तेज़ी से काम करता है।
इसलिए, reduceByKey को groupByKey पर दृढ़ता से प्राथमिकता दी जाती है क्योंकि यह शफ़ल ऑपरेशन्स को काफी कम करता है।
तो, यह प्रत्येक पार्टिशन में एग्रीगेट करता है, फिर डेटा को जोड़ता है, और फिर साथ में एग्रीगेट करता है। यह उन एग्रीगेशन्स के लिए सबसे अच्छा है जो कीज़ को एक साथ लाते हैं, जैसे sum() और max()।
from operator import add

rdd.reduceByKey(add).collect()यहाँ प्रत्येक एग्रीगेशन मेथड के लाभों का एक सार-सारांश तालिका है।
|
फ़ीचर |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
एब्स्ट्रैक्शन लेवल |
उच्च |
निम्न |
निम्न |
|
ऑप्टिमाइज़्ड एक्ज़ीक्यूशन |
हाँ (Catalyst & Tungsten) |
नहीं |
नहीं |
|
शफ़ल न्यूनीकरण |
हाँ |
❌ (पूर्ण शफ़ल) |
✅ (कम्बाइनर के साथ) |
|
मेमोरी दक्षता |
उच्च |
निम्न |
मध्यम–उच्च |
|
लचीलापन |
मध्यम |
उच्च |
मध्यम |
|
बिग डेटा पर प्रदर्शन |
उत्कृष्ट |
खराब |
अच्छा |
|
अनुशंसित उपयोग |
अधिकांश मामलों में |
दुर्लभ/विशिष्ट |
कस्टम, लो-लेवल एग्रीगेशन |
Big Data Fundamentals with PySpark RDDs के साथ प्रोग्रामिंग को अधिक विस्तार से कवर करता है और बताता है कि वे PySpark की रीढ़ कैसे बनते हैं।
PySpark में एग्रीगेशन करने का एक और तरीका SQL API का उपयोग करके SQL स्टेटमेंट लिखना है। यदि आप SQL लिखने में अधिक सहज हैं, तो यह एक बढ़िया तरीका हो सकता है।
पहला कदम DataFrame की createOrReplaceTempView() मेथड का उपयोग करके एक अस्थायी व्यू बनाना है। फिर आप अपना स्टेटमेंट लिखने के लिए spark.sql() का उपयोग कर सकते हैं।
# Create a temporary view using the DataFrame
df.createOrReplaceTempView("employees")

# Write a SQL-like statement
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()आउटपुट:
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
जैसा कि आप देख सकते हैं, यह सामान्य SQL क्वेरी लिखने जितना आसान है। SQL API का उपयोग करने का मुख्य समय है परिचितता और अपनी क्वेरी लिखने में आसानी। DataFrame API अक्सर बेहतर हो सकता है क्योंकि यह सुसंगत डेटा टाइप प्रदान करेगा और आमतौर पर बेहतर ऑप्टिमाइज़ करता है।
आपको DataFrame मेथड्स का एक्सेस मिलता है जो Spark SQL API के साथ उपलब्ध नहीं होते। SQL के GROUP BY पर अधिक जानकारी के लिए, GROUP BY और HAVING in SQL पर यह लेख पढ़ें।
अपने डेटा को एग्रीगेट करने के ढेरों वास्तविक जीवन के अनुप्रयोग हैं। वास्तव में, किसी न किसी रूप में डेटा एग्रीगेट करना लगभग तय है ताकि उसका विश्लेषण और साझा किया जा सके।
नीचे, हम एग्रीगेशन्स के विभिन्न उपयोग मामलों के कुछ उदाहरण देंगे। इनमें से कुछ छद्म-कोड हो सकते हैं या हमारे टेस्ट डेटासेट पर ठीक-ठीक लागू न हों, बल्कि आपको यह विचार देने के लिए हैं कि आप इन्हें कैसे लिख सकते हैं।
एक सामान्य थीम जो हमने चर्चा की है वह है groupBy का उपयोग पदानुक्रमिक विश्लेषण के साधन के रूप में। मान लीजिए हमारे पास “revenue” नाम का कॉलम है और हम यह देखना चाहते हैं कि प्रत्येक विभाग ने कैसा प्रदर्शन किया। हम प्रत्येक विभाग पर ग्रुप कर सकते हैं और प्रत्येक विभाग के राजस्व योगदान का आकलन कर सकते हैं।
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()एग्रीगेशन्स आपको विंडो फंक्शंस तक पहुँच देते हैं। ये फंक्शंस डेटा की स्लाइडिंग विंडो को देखते हैं—या तो क्रमिक रूप से पंक्तियों की श्रृंखला या क्रमिक रूप से समय की अवधि।
हम पहले Window ऑब्जेक्ट का उपयोग करके एक विंडो परिभाषित करते हैं, जिसमें दिखता है कि हम किन पर partitonBy और orderBy करना चाहते हैं। फिर हम इस ऑब्जेक्ट को अपनी इच्छित एग्रीगेशन फंक्शन के over() मेथड में उपयोग करते हैं। उदाहरण के लिए, रोलिंग एवरेज sf.avg().over(window).show() जैसा दिखेगा।
मान लीजिए हम प्रत्येक विभाग के लिए वेतन का रोलिंग औसत देखना चाहते हैं। हम department के आधार पर ग्रुप करेंगे और एक नए कॉलम employeeId के आधार पर ऑर्डर करेंगे। चूँकि कर्मचारी IDs अक्सर क्रमिक होती हैं, हम देख सकते हैं कि समय के साथ औसत वेतन कैसे बदला है।
from pyspark.sql.window import Window

#Define the window we wish to partition and order by
windowSpec = Window.partitionBy("department").orderBy("employeeId")

#Perform the sf.avg function on the “salary” column over the windowSpec.
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
यह SQL में विंडो फंक्शंस करने के बहुत समान है।
मान लें कि हम अपनी मीडिया कंपनी के लिए अलग-अलग यूज़र मेट्रिक्स समझना चाहते हैं। हमें कुल वॉच टाइम और यूनिक वीडियोज़ जैसी चीज़ें चाहिए। हम user_id कॉलम पर groupBy() कर सकते हैं और फिर अलग-अलग मेट्रिक्स के लिए sum() और countDistinct() जैसे फंक्शंस के साथ .agg() का उपयोग कर सकते हैं।
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), #sum minutes watched
    sf.countDistinct("video_id").alias("unique_views") #count unique videos watched
).show()
PySpark में डेटा एग्रीगेट करते समय, कुछ pitfalls में फँसना आसान है जो खराब प्रदर्शन और लंबे रन टाइम्स का कारण बनते हैं। इन सर्वोत्तम प्रथाओं का पालन करने से प्रदर्शन, शुद्धता और स्केलेबिलिटी सुनिश्चित होती है।
यहाँ कुछ सामान्य तरीके दिए गए हैं जिनसे लोग अपनी सरल क्वेरीज़ को लंबे समय तक चलने वाले प्रोग्राम में बदल देते हैं।
groupByKey() का अत्यधिक उपयोग:groupByKey() से बचें, क्योंकि इसका मैकेनिज्म PySpark को पार्टिशनों में डेटा शफ़ल करवाता है। इससे बहुत अधिक नेटवर्क और डिस्क ओवरहेड हो सकता है।reduceByKey() का उपयोग करें या DataFrame API से चिपके रहें।repartition() मेथड के साथ पार्टिशन वर्कलोड को पुनर्वितरित करके इसे कम करने के लिए साल्टिंग या कस्टम पार्टिशनिंग का उपयोग करें।groupBy में sum() और उसी grouped dataset पर अलग लाइन में count()) PySpark की ऑप्टिमाइज़ करने की क्षमता को तोड़कर अक्षम प्लान्स का कारण बनते हैं।persist() या cache() का उपयोग करने पर विचार करें।यहाँ कुछ तरीके हैं जिनसे आप अपने PySpark एग्रीगेशन्स को ऑप्टिमाइज़ कर सकते हैं ताकि वे सुचारू रूप से चलें!
na.fill() या na.drop() का उपयोग करें।df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions को डेटा वॉल्यूम के आधार पर ट्यून करें और देखें कि आपके डेटा के लिए पार्टिशन्स की कौन-सी संख्या सबसे अच्छी काम करती है।.explain() के साथ क्वेरी प्लान्स मॉनिटर करें।df.groupBy("department").sum("salary").explain(True)आउटपुट:
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
Spark में कई कनफ़िगरेशन हैं जिन्हें बड़े groupBy वर्कलोड्स के लिए ट्यून किया जा सकता है। नीचे दी गई तालिका में कुछ प्रमुख कनफ़िगरेशन हैं।
|
कनफ़िगरेशन |
वर्णन |
|
|
शफ़ल्स के लिए पार्टिशन्स की संख्या नियंत्रित करता है। छोटे जॉब्स के लिए घटाएँ, बड़े के लिए बढ़ाएँ। (डिफ़ॉल्ट: 200) |
|
|
छोटी टेबल्स के स्वतः ब्रॉडकास्ट को सक्षम करता है। अक्षम करने के लिए -1 सेट करें या बड़े जॉइन्स के लिए बढ़ाएँ। (डिफ़ॉल्ट: 10MB) |
|
|
प्रति एक्ज़ीक्यूटर उपलब्ध मेमोरी नियंत्रित करता है। बड़े एग्रीगेशन्स के लिए इसे बढ़ाएँ। (डिफ़ॉल्ट: 4g) |
|
|
Adaptive Query Execution (AQE) सक्षम करता है, जो रनटाइम पर शफ़ल्स, स्क्यू और जॉइन्स को गतिशील रूप से ऑप्टिमाइज़ कर सकता है। (डिफ़ॉल्ट: true) |
उन्नत उपयोगकर्ताओं या बहुत बड़े डेटासेट्स से निपटने वालों के लिए, यह समझना आवश्यक है कि groupBy अंदर से कैसे व्यवहार करता है। आइए इस मेथड के कार्य करने के कुछ बारीक बिंदुओं को कवर करें।
PySpark में सभी DataFrame ऑपरेशन्स, groupBy सहित, लेज़ी इवैल्यूएट होते हैं। यानी तब तक कोई वास्तविक गणना नहीं होती जब तक कोई action (जैसे show() या collect()) ट्रिगर नहीं होती।
यह Catalyst ऑप्टिमाइज़र को प्रदर्शन सुधारने के लिए ऑपरेशन्स को पुनर्व्यवस्थित, संयोजित या हटाने देता है। इसका लाभ उठाएँ और कई एग्रीगेशन्स और मेथड्स को साथ में chain करें ताकि Spark एक ऑप्टिमाइज़्ड प्लान बना सके।
groupBy() का उपयोग करने पर यह एक GroupedData ऑब्जेक्ट लौटाता है। sum() जैसी एग्रीगेशन फंक्शन करने पर फिर एक DataFrame जैसा ऑब्जेक्ट लौटाया जाता है। show() का उपयोग करने पर यह परिणाम दिखा देगा।
याद रखें कि groupBy().agg() एक नया DataFrame लौटाता है जिसमें नए नाम वाले कॉलम होते हैं। नेमिंग कोलिज़न से बचने और आउटपुट को स्पष्ट बनाने के लिए हमेशा alias() मेथड के साथ एलियस का उपयोग करें। यदि आप कॉलम्स को एलियसिंग के बिना छोड़ते हैं, तो यह कॉलम नाम टकराव या आगे चलकर जॉइन्स में समस्याओं का कारण बन सकता है।
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)PySpark के बारे में ध्यान देने योग्य बात यह है कि लौटाया गया एग्रीगेशन पंक्ति क्रम को संरक्षित नहीं करता। पूर्वानुमेय आउटपुट और सुसंगत सॉर्टिंग के लिए orderBy() का उपयोग करें।
df.groupBy("department").sum("salary").orderBy("department").show()PySpark के प्रत्येक संस्करण में कुछ संस्करण-विशिष्ट परिवर्तन और सीमाएँ हैं। Catalyst 1.3 में पेश किया गया था और 2.0 में काफी बेहतर हुआ। कुछ मेथड्स बाद के संस्करणों तक पेश नहीं हुए, जैसे groupingSets()।
यहाँ एक चार्ट है जो PySpark के कुछ बड़े फ़ंक्शनल बदलावों को कवर करता है। सुनिश्चित करें कि जिन फ़ीचर्स की आपको आवश्यकता है, उनके लिए आप सही Spark और PySpark संस्करण का उपयोग करें!
|
फ़ीचर |
Spark संस्करण |
वर्णन |
|
|
1.4+ |
OLAP-शैली एनालिटिक्स में उपयोगी पदानुक्रमिक एग्रीगेशन्स (3.4+ Spark Connect को सपोर्ट करता है) |
|
|
2.3+ |
Apache Arrow का उपयोग करके वेक्टराइज़्ड UDFs तेज़ निष्पादन के लिए, (3.4+ Spark Connect सपोर्ट, 4.0+ SCALAR सपोर्ट) |
|
Adaptive Query Execution (AQE) |
3.0+ |
रनटाइम पर जॉइन्स, शफ़ल्स और स्क्यू हैंडलिंग को गतिशील रूप से समायोजित करता है |
|
ANSI SQL कम्पैटिबिलिटी मोड |
3.0+ |
अधिक सटीक त्रुटि रिपोर्टिंग और एक्सप्रेशन व्यवहार |
|
|
4.0+ |
एक एग्रीगेशन में एकाधिक ग्रुपिंग्स की अनुमति देता है (उदा., सबटोटलिंग के लिए) |
डिस्ट्रीब्यूटेड परिवेश में डेटा एग्रीगेशन के लिए PySpark का groupBy फंक्शन आवश्यक उपकरण है। चाहे क्षेत्रवार डेटा का संक्षेप करना हो, औसत मीट्रिक्स निकालना हो, या जटिल मल्टी-लेवल एनालिटिक्स करना हो, groupBy बड़े डेटा वर्कलोड्स को संभालने के लिए एक स्केलेबल और लचीला API प्रदान करता है।
बस रनटाइम और लागत कम करने के लिए इन सर्वोत्तम प्रथाओं को ध्यान में रखें:
जैसे-जैसे PySpark विकसित होता जाएगा, हम और भी बुद्धिमान ऑप्टिमाइज़ेशन, जटिल एग्रीगेशन्स के लिए नेटिव सपोर्ट, और Pandas तथा SQL-शैली के सिन्टैक्स के साथ बेहतर एकीकरण की अपेक्षा कर सकते हैं। यह बड़े पैमाने के मॉडलों के लिए और बेहतर इंटीग्रेशन भी दे सकता है। यदि आप PySpark के बारे में और सीखने में रुचि रखते हैं, तो DataCamp के ये विस्तृत संसाधन देखें:
शीर्ष PySpark कोर्स
कोर्स
कोर्स
कोर्स