
Khóa học
Nền tảng về PySpark
4 giờ
157.9K
Trong thế giới dữ liệu lớn, hiếm khi chúng ta nhìn thẳng vào dữ liệu thô. Để dữ liệu dễ tiêu hóa hơn, nhóm (group) và tổng hợp (aggregate) là thao tác phổ biến và mạnh mẽ. Khi làm việc với các hệ thống phân tán như Apache Spark và Python, việc có hàm groupBy của PySpark cho phép chúng ta gom và tóm tắt dữ liệu phân tán. Nó phản chiếu chức năng của mệnh đề GROUP BY của SQL, nhưng được thiết kế để xử lý tính toán dữ liệu phân tán trên các tập dữ liệu khổng lồ một cách hiệu quả.
Hàm groupBy của PySpark cho phép người dùng phân vùng dữ liệu dựa trên nhiều cột, sau đó có thể tổng hợp thành các thước đo khác nhau như tổng, trung bình, v.v. Để làm điều này hiệu quả, PySpark tuân theo mô hình split-apply-combine (tách - áp dụng - kết hợp):
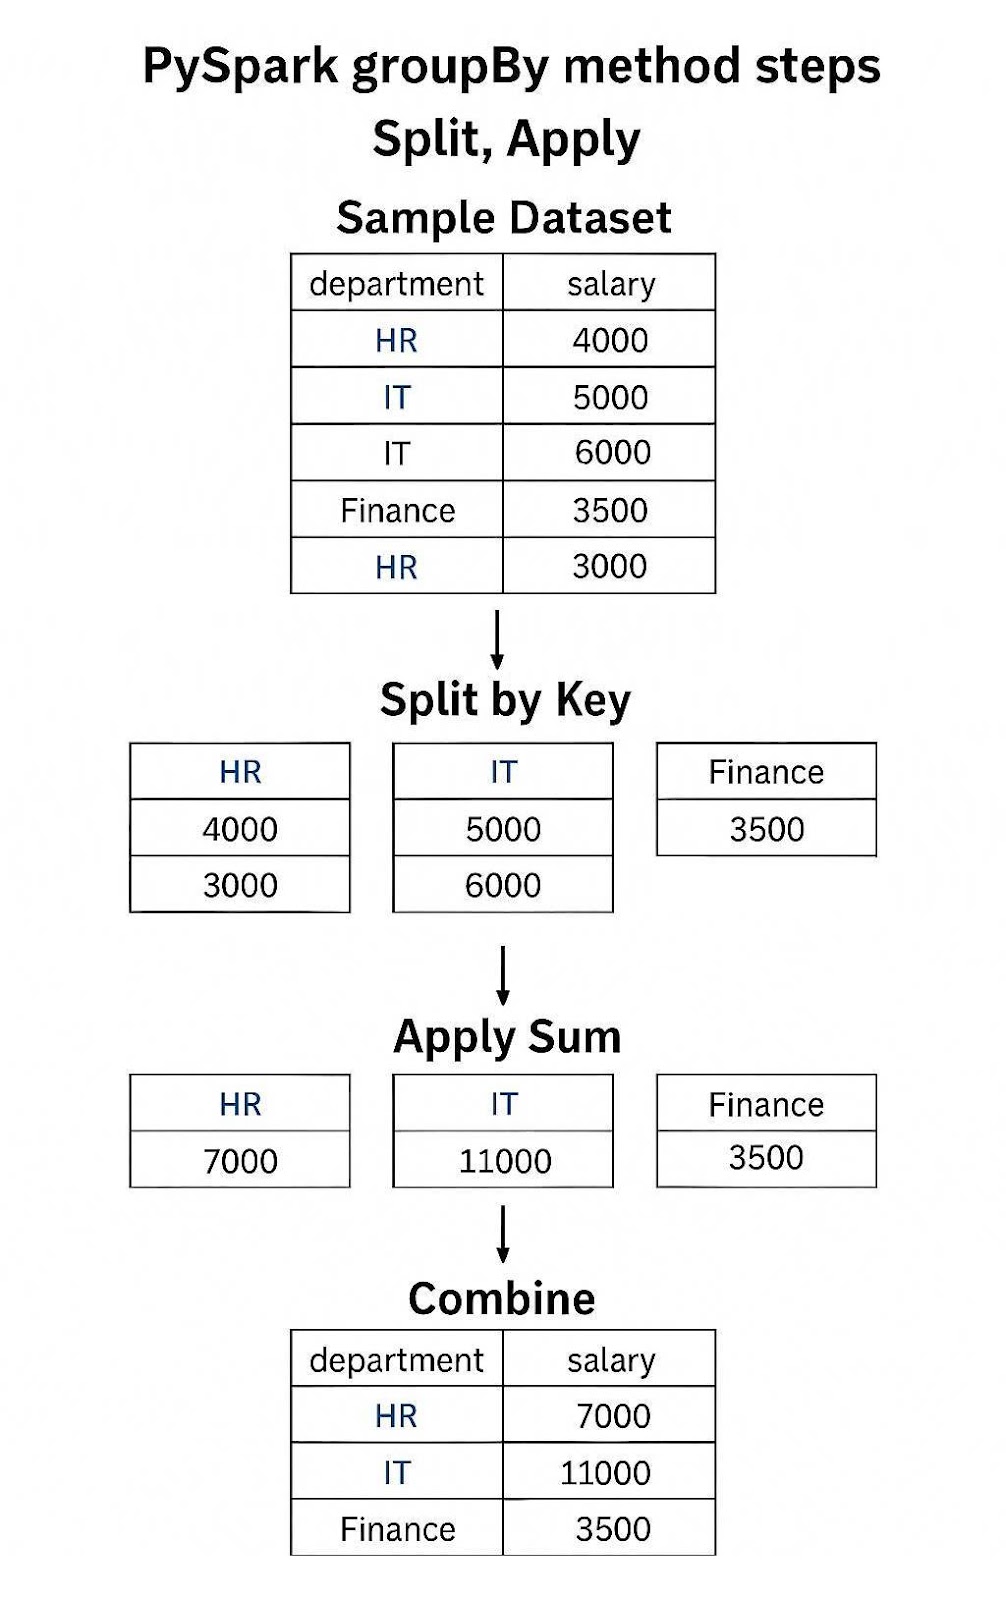
Ví dụ phương thức groupBy() của PySpark áp dụng phép Sum
PySpark sử dụng cơ chế đánh giá lười (lazy evaluation), nghĩa là các thao tác như groupBy chỉ được tính toán khi các hành động (như show() hoặc collect()) được gọi. Thay vào đó, PySpark trước tiên xây dựng một DAG (Đồ thị có hướng không chu trình) ban đầu được tinh chỉnh để đạt hiệu năng. Điều này giúp Spark tối ưu kế hoạch truy vấn trước khi thực thi.
Nếu bạn chưa có cơ hội làm việc với PySpark, tôi rất khuyến nghị xem qua Những điều cơ bản về Big Data với PySpark.
Trước hết, chúng ta cần có một PySpark DataFrame. Nếu bạn cần ôn lại các lệnh PySpark khác nhau, hãy xem Cheat Sheet PySpark DataFrame tuyệt vời này.
Chúng ta sẽ điểm qua một số bước và lệnh chính giúp bạn bắt đầu với PySpark. Trước khi bắt đầu, hãy đảm bảo bạn đã cài PySpark trong môi trường Python của mình, cũng như Java và Java JDK. Nếu cần trợ giúp, hãy làm theo hướng dẫn bắt đầu với PySpark.
Bước một là chạy được PySpark của bạn!
from pyspark.sql import SparkSession

# Start a SparkSession
spark = SparkSession.builder \
    .appName("GroupByExample") \
.getOrCreate()Hãy xây dựng một DataFrame mẫu để chúng ta thực hành.
from pyspark.sql import Row

data = [
    Row(department="Sales", employee="Alice", salary=5000),
    Row(department="Sales", employee="Bob", salary=4800),
    Row(department="HR", employee="Carol", salary=4000),
    Row(department="HR", employee="David", salary=3900),
    Row(department="IT", employee="Eve", salary=6000)
]

df = spark.createDataFrame(data)
df.show()
Đầu ra:
	+----------+--------+------+
	|department|employee|salary|
	+----------+--------+------+
	|     Sales|   Alice|  5000|
	|     Sales|     Bob|  4800|
	|        HR|   Carol|  4000|
	|        HR|   David|  3900|
	|        IT|     Eve|  6000|
	+----------+--------+------+
PySpark groupBy là một phép biến đổi dùng để tách dữ liệu thành các nhóm dựa trên một hoặc nhiều cột, sau đó có thể được tổng hợp hoặc biến đổi độc lập.
Việc dùng phương thức groupBy rất đơn giản; bạn có thể gọi nó trên dataframe quan tâm. Bạn có thể dùng nó trên bất kỳ kiểu cột nào miễn là phù hợp để phân vùng. Chẳng hạn, bạn có thể muốn tránh dùng số thực (float).
grouped = df.groupBy("department")Điều này tạo ra một đối tượng GroupedData, bản thân nó không phải là DataFrame. Nó cho Spark biết cách bắt đầu phân vùng dữ liệu. Khi có đối tượng GroupedData, bạn có thể áp dụng các phép tổng hợp .count() hoặc .sum() để thu được một DataFrame mới.
grouped.count().show()Tham số duy nhất của phương thức là *cols chấp nhận tên cột, biểu thức cột, chỉ số cột (int), hoặc danh sách cột. Miễn là cột là thứ bạn muốn dùng để phân vùng, bạn có thể sử dụng trong phép toán. Phương thức luôn trả về một đối tượng GroupedData.
# grouping by column name like above
	df.groupBy("department")

# grouping by column expression
	df.groupBy(df.department)

#grouping by column ordinal
	df.groupBy(1)

#grouping by list of columns, you can mix the methods!
df.groupBy(["department", 2])Như đã minh họa ở trên, bạn có thể nhóm theo một hoặc nhiều cột. Một cột rất phù hợp khi bạn chỉ quan tâm đến một trục, như phòng ban hoặc năm. Nhiều cột rất hữu ích nếu bạn muốn có thêm các lớp chi tiết, chẳng hạn các nhân viên cụ thể trong các phòng ban khác nhau, hoặc các tháng cụ thể trong một năm.
# grouping by single column
	df.groupBy("department").sum(“salary”).show()

#grouping by multiple columns
	df.groupBy(["department", 2]).sum(“salary”).show()
Có lẽ bạn đã nhận ra, phương thức groupBy hoạt động rất tương tự các câu lệnh GROUP BY trong SQL. Chúng tôi cũng sẽ chỉ ra một cách dùng ngôn ngữ đó trong PySpark ở phần sau.
PySpark hỗ trợ nhiều phương thức tổng hợp dựng sẵn để làm việc với dữ liệu đã nhóm. Nếu bạn quen với SQL, bạn sẽ thấy nhiều hàm quen thuộc như count(), sum(), avg(), v.v. Bạn có thể xem lại trong hướng dẫn hàm tổng hợp trong SQL.
Hãy điểm qua các hàm tổng hợp dựng sẵn:
count(): đếm số bản ghi trong phân vùngsum(): tính tổng các giá trị sốavg(): tính trung bình các giá trị sốmin(): trả về giá trị nhỏ nhất của phân vùngmax(): trả về giá trị lớn nhất của phân vùngNgoài các hàm tổng hợp, bạn có thể gắn phương thức .alias() để đổi tên cột cho dễ hiểu hơn. Chúng tôi sẽ minh họa ở dưới.
Thay vì thực hiện từng phép tổng hợp độc lập, bạn có thể làm nhiều phép tổng hợp cùng lúc bằng phương thức agg(). Mỗi phép tổng hợp sẽ tạo một cột mới trong dataframe. Nó cũng giảm nhu cầu phải gọi groupBy nhiều lần, giúp cải thiện hiệu năng. Chúng ta không cần tổng hợp trên cùng một cột với agg(); bạn có thể chỉ định cột khác nhau cho từng hàm tổng hợp.
# After already starting your session
from pyspark.sql import functions as sf

df.groupBy("department").agg(
    sf.count("employee").alias("employee_count"),
    sf.avg("salary").alias("avg_salary"),
    sf.max("salary").alias("max_salary")
).show()
Đầu ra:
+----------+--------------+----------+----------+
|department|employee_count|avg_salary|max_salary|
+----------+--------------+----------+----------+
|     Sales|             2|    4900.0|      5000|
|        HR|             2|    3950.0|      4000|
|        IT|             1|    6000.0|      6000|
+----------+--------------+----------+----------+Lợi thế của PySpark là khả năng dùng các mẫu tổng hợp nâng cao như pivot dữ liệu, rollup và tạo data cube. Bạn cũng có thể tạo grouping sets.
Giống như tạo pivot table trong Excel, bạn có thể xoay (pivot) dữ liệu theo các cột khác nhau. Ở đây, chúng ta nhóm theo department và pivot theo cột employee để xem tổng lương của từng nhân viên.
Điều này có nghĩa mỗi hàng hiển thị phòng ban, và mỗi cột là nhân viên của phòng đó. Bạn có thể thấy cách này mạnh mẽ nếu có dữ liệu theo năm và muốn xem từng phòng ban qua từng năm.
df.groupBy("department").pivot("employee").sum("salary").show()Hai cách tổng hợp rất mạnh là rollup() và cube(). Trong khi groupby() thông thường chỉ hiển thị các kết quả tổng hợp tồn tại, thì rollup() và cube() đều là cấu trúc phân cấp, nghĩa là chúng tổng hợp dữ liệu ở mức chi tiết hơn.
Ví dụ, rollup() tổng hợp từ trái sang phải, hiển thị mọi hoán vị có thể nếu chúng ta đi qua từng bước lặp. Với mỗi phòng ban, chúng ta hiển thị từng người trong phòng và cả nhóm cuối cùng của những người không xác định.
Ngược lại, cube() hiển thị mọi hoán vị có thể cho tất cả các cột được tổng hợp, tức là cho từng phòng ban riêng lẻ, từng nhân viên riêng lẻ và mọi kết hợp của cả hai.
Tóm lại:
Bạn có thể xem ví dụ trong mã và đầu ra dưới đây:
rollup() Mã:
# using rollup
df.rollup("department", “employee”).sum("salary").show()
rollup() Đầu ra:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
+----------+--------+-----------+
cube() Mã:
#using cube
df.cube("department", "employee").sum("salary").show()
cube() Đầu ra:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|   Alice|       5000|
|      NULL|    NULL|      23700|
|     Sales|   Alice|       5000|
|     Sales|    NULL|       9800|
|     Sales|     Bob|       4800|
|      NULL|     Bob|       4800|
|      NULL|   Carol|       4000|
|        HR|   Carol|       4000|
|        HR|    NULL|       7900|
|        HR|   David|       3900|
|      NULL|   David|       3900|
|        IT|     Eve|       6000|
|        IT|    NULL|       6000|
|      NULL|     Eve|       6000|
+----------+--------+-----------+
Grouping sets cho phép bạn định nghĩa nhiều mức tổng hợp. Trong ví dụ này, tôi đang tổng hợp ở mức phòng ban và nhân viên, mức phòng ban, và mức tổng để lấy tổng lương.
Bạn sẽ thấy cú pháp của phương thức groupingSets() hơi khác. Trước tiên bạn định nghĩa danh sách các tập [(“department”, “employee”), (“department”, ), ()] trong đó tập đầu là phòng ban và nhân viên, tập thứ hai chỉ là phòng ban, và tập cuối cùng () nghĩa là tất cả.
Sau đó bạn định nghĩa các cột cần tổng hợp trong các tập. Phần còn lại viết bình thường với .agg().
df.groupingSets([("department", "employee"), ("department",), ()], "department","employee").agg(sf.sum("salary")).sort("department","employee").show()Đầu ra:
+----------+--------+-----------+
|department|employee|sum(salary)|
+----------+--------+-----------+
|      NULL|    NULL|      23700|
|        HR|    NULL|       7900|
|        HR|   Carol|       4000|
|        HR|   David|       3900|
|        IT|    NULL|       6000|
|        IT|     Eve|       6000|
|     Sales|    NULL|       9800|
|     Sales|   Alice|       5000|
|     Sales|     Bob|       4800|
+----------+--------+-----------+Cuối cùng, chúng ta có thể tạo các hàm tổng hợp tùy chỉnh bằng User Defined Functions (UDFs) trong PySpark. Có hai cách: udf và pandas_udf. Cả hai cho phép bạn tạo hàm tùy chỉnh của riêng mình với ưu/nhược điểm riêng.
Hàm udf chuẩn của Spark cho phép bạn tạo hàm gốc Spark. Nghĩa là cú pháp và kiểu dữ liệu phải hoạt động nguyên bản trong Spark. Dù điều này giới hạn phần nào những gì có thể làm trong UDF, nó cho phép bạn tận dụng tối đa sức mạnh tính toán phân tán của Spark và phù hợp hơn với tập dữ liệu lớn.
from pyspark.sql.functions import udf
from pyspark.sql.types import IntegerType

@udf(returnType=IntegerType())
def bonus(salary):
    return int(salary * 0.1)

df.withColumn("bonus", bonus(df.salary)).show()
Mặt khác, pandas_udf cho phép bạn tạo các hàm tùy chỉnh theo phong cách Pythonic hơn. Bạn giờ chỉ bị ràng buộc bởi những gì khả thi trong Pandas chứ không chỉ Spark.
Tuy nhiên, điều đó có nghĩa bạn không thể dùng sức mạnh tính toán phân tán của Spark và phải dựa vào tính toán cục bộ. Cách này phù hợp hơn với các tập dữ liệu nhỏ đến trung bình.
import pandas as pd
from pyspark.sql.functions import pandas_udf

@pandas_udf("double")
def salary_bonus(s: pd.Series) -> pd.Series:
    return s * 0.1

df.withColumn("bonus", salary_bonus(df.salary)).show()
Tổng thể, bạn chỉ nên dùng hàm tùy chỉnh khi và chỉ khi không có cách tốt hơn để thực hiện phép tổng hợp. Đừng phát minh lại bánh xe!
Ngoài ra, nếu thứ gì có thể vector hóa (như các hàm ở trên), hãy ưu tiên dùng phiên bản vector hóa thay vì một UDF tổng hợp. Để biết thêm về groupBy(), hãy đọc bài viết đi sâu hơn vào khung split-apply-combine với pandas.
Trong PySpark, bạn có thể lọc các nhóm dựa trên các chỉ số tổng hợp sau khi nhóm bằng phương thức filter(). Trong phương thức này, bạn cung cấp điều kiện dưới dạng biểu thức Python hoặc SQL.
Nhân tiện, bạn cũng có thể dùng where() nếu thích, vì nó chỉ là bí danh của filter() và thực hiện cùng một thao tác.
Bạn có thể chọn lọc trước hoặc sau khi tổng hợp. Lọc trước sẽ ảnh hưởng đến tổng hợp bằng cách giới hạn dữ liệu được tổng hợp và có thể cải thiện hiệu năng.
Ví dụ, có thể chúng ta chỉ muốn đếm số nhân viên có mức lương trên một ngưỡng nhất định để tìm số nhân viên “lương cao”.
#filter for high salaries
filter_df = df.filter(df.salary > 4000)

#aggregate and find the total of high salary employees
agg_filter_df = filter_df.groupBy("department").agg(sf.count("*").alias("high_salary_emp"))
agg_filter_df.show()
Tuy nhiên, lọc sau khi tổng hợp sẽ không ảnh hưởng tới phép tổng hợp ban đầu. Có thể chúng ta muốn đếm tất cả nhân viên trong một phòng ban và chỉ muốn xem các phòng có quy mô trên một ngưỡng. Điều này sẽ thêm một lớp xử lý nữa, nhưng không làm tăng quá nhiều tải tính toán.
# creating a dataframe counting the number of employees
agg_df = df.groupBy("department").agg(sf.count("*").alias("num_employees"))

# filtering for departments where there is more than 1 employee
agg_df.where("num_employees > 1").show()
Hãy cân nhắc thời điểm lọc một cách khôn ngoan, vì nó sẽ ảnh hưởng đến độ chính xác và kết quả cuối. Lọc trước có thể làm giảm tổng cuối cùng, trong khi lọc sau có thể để lại quá nhiều trong đáp án cuối.
Mặc dù PySpark tự động tối ưu thao tác groupBy, vẫn có những chiến lược giúp tăng tốc xử lý hơn nữa. Những điều như giảm tối đa shuffle dữ liệu, giảm lệch (skew) và tối ưu thực thi đều góp phần cải thiện hiệu năng groupBy.
groupBy gây ra shuffle, tức phân phối lại dữ liệu qua các phân vùng để gom các khóa giống nhau. Shuffle tốn tài nguyên mạng và đĩa, nên giảm thiểu hoặc tối ưu chúng là rất quan trọng. Dưới đây là vài kỹ thuật tối ưu chủ chốt:
repartition() một cách hợp lý, bạn có thể chỉ định PySpark phân vùng dữ liệu theo cột nào để nó tìm kiếm dữ liệu ở ít nơi hơnDưới đây là vài ví dụ cách bạn có thể cải thiện quản lý shuffle.
# reduce the number of shuffle partitions
spark.conf.set("spark.sql.shuffle.partitions", "64")  # Adjust based on cluster size

# make sure spark compresses the data
spark.conf.set("spark.shuffle.compress", "true") # compresses network transfer
spark.conf.set("spark.shuffle.spill.compress", "true") # compresses disk spillage

# repartitions the data prior to grouping to optimize aggregation
df.repartition("department").groupBy("department").sum("salary").show()Lệch dữ liệu xảy ra khi một số khóa xuất hiện nhiều hơn hẳn các khóa khác, dẫn đến tải phân vùng không đều và tác vụ chậm. Điều này khiến một số worker chịu tải nhiều hơn. Chúng ta có thể giảm skew và phân phối tải đều hơn bằng cách “salting”, giảm thiểu các phép join lệch và broadcast join cho các chiều nhỏ.
# Salting example:

df = df.withColumn("salted_key", sf.rand()) #Create column of random
df = df.repartition(2, 'salted_key') # use this to repartition data
df.groupBy(sf.spark_partition_id()).count().show()Kế hoạch thực thi logic và vật lý của các job PySpark có thể được tối ưu bằng các tính năng dựng sẵn. Những điều này có thể cải thiện hiệu năng các phép tổng hợp groupBy.
grouped_df = df.groupBy("department").sum("salary").cache()
grouped_df.show() # you can cache your intermediate results

# use broadcasting (pseudocode here):
from pyspark.sql.functions import broadcast
df.join(broadcast(smaller_df), "department").show()
Để biết thêm chi tiết về cách tối ưu hoạt động của PySpark, hãy đọc bài viết về PySpark Joins để hiểu một số cơ chế bên dưới.
Mặc dù DataFrame API là giao diện được khuyến nghị cho hầu hết người dùng PySpark nhờ mức trừu tượng cao và hiệu năng tốt (nhờ Catalyst Optimizer), việc hiểu lớp Resilient Distributed Dataset (RDD) vẫn hữu ích, đặc biệt với những người muốn kiểm soát nhiều hơn hoặc đang chuyển mã Spark cũ. Tuy nhiên, nói chung, dùng DataFrame hoặc SQL API sẽ cho hiệu năng tốt hơn.
RDD là thành phần lõi của PySpark, trên đó mọi thứ (bao gồm DataFrame API) được xây dựng. Nó có xu hướng làm việc trong bộ nhớ và xử lý dữ liệu streaming có phần tốt hơn DataFrame API. Tuy nhiên, dữ liệu là bất biến nên không thể thay đổi sau khi RDD được tạo.
Phần này so sánh groupBy trong DataFrame API với các tương đương trong RDD API, phân tích cả hiệu năng và mức độ phù hợp theo tình huống.
Trước hết, hãy chuyển dataframe thành RDD.
# Convert DataFrame to RDD of (key, value)
rdd = df[['department','salary']].rdd
rdd.collect()
Giờ chúng ta có thể thực hiện các thao tác như groupByKey() và reduceByKey() trên RDD. Hãy nói về groupByKey() trước.
Phương thức groupByKey() shuffle tất cả giá trị có cùng khóa về cùng một executor rồi nhóm lại. Vì vậy, nó có thể mất nhiều thời gian để shuffle dữ liệu tới đúng khóa. Điều này cũng có thể dẫn đến lệch dữ liệu.
rdd.groupByKey().mapValues(list).collect()Thay vào đó, chúng ta có thể thử phương thức reduceByKey() sau. Phương thức này đầu tiên tổng hợp trên mỗi phân vùng rồi mới chuyển dữ liệu qua mạng. Điều này giảm thiểu lượng dữ liệu cần shuffle và do đó chạy nhanh hơn.
Vì vậy, reduceByKey được ưu tiên mạnh mẽ so với groupByKey vì nó giảm đáng kể các thao tác shuffle.
Nói cách khác, nó tổng hợp trong mỗi phân vùng, rồi kết hợp dữ liệu, rồi tổng hợp lại. Cách này tốt cho các phép tổng hợp gom các khóa lại với nhau như sum() và max().
from operator import add

rdd.reduceByKey(add).collect()Dưới đây là bảng tóm tắt lợi ích của từng phương thức tổng hợp.
|
Tính năng |
DataFrame groupBy |
RDD groupByKey() |
RDD reduceByKey() |
|
Mức trừu tượng |
Cao |
Thấp |
Thấp |
|
Thực thi được tối ưu |
Có (Catalyst & Tungsten) |
Không |
Không |
|
Giảm thiểu shuffle |
Có |
❌ (Shuffle toàn phần) |
✅ (Có combiner) |
|
Hiệu quả bộ nhớ |
Cao |
Thấp |
Trung bình–Cao |
|
Tính linh hoạt |
Vừa |
Cao |
Trung bình |
|
Hiệu năng trên Big Data |
Xuất sắc |
Kém |
Tốt |
|
Khuyến nghị sử dụng |
Hầu hết trường hợp |
Hiếm/đặc thù |
Tổng hợp mức thấp, tùy chỉnh |
Big Data Fundamentals with PySpark trình bày chi tiết hơn về lập trình với RDD và mô tả cách chúng tạo nền tảng cho PySpark.
Một cách khác để thực hiện tổng hợp trong PySpark là dùng SQL API để viết các câu lệnh SQL. Đây có thể là cách tuyệt vời nếu bạn quen viết SQL hơn.
Bước đầu tiên là tạo một temporary view bằng phương thức createOrReplaceTempView() của DataFrame. Sau đó bạn có thể dùng spark.sql() để viết câu lệnh.
# Create a temporary view using the DataFrame
df.createOrReplaceTempView("employees")

# Write a SQL-like statement
spark.sql("""
    SELECT department, AVG(salary) AS avg_salary
    FROM employees
    GROUP BY department
""").show()
Đầu ra:
+----------+----------+
|department|avg_salary|
+----------+----------+
|     Sales|    4900.0|
|        HR|    3950.0|
|        IT|    6000.0|
+----------+----------+
Như bạn thấy, nó dễ như viết một truy vấn SQL bình thường. Thời điểm chính để dùng SQL API là vì sự quen thuộc và dễ viết truy vấn. DataFrame API thường tốt hơn vì cung cấp kiểu dữ liệu nhất quán và thường tối ưu tốt hơn.
Bạn có thể truy cập các phương thức DataFrame mà bạn sẽ không có với Spark SQL API. Để biết thêm về GROUP BY trong SQL, bạn có thể đọc bài viết về GROUP BY và HAVING trong SQL.
Có rất nhiều ứng dụng thực tế cho việc tổng hợp dữ liệu. Thực tế, bạn gần như chắc chắn sẽ phải tổng hợp dữ liệu theo cách nào đó để có thể phân tích và chia sẻ.
Bên dưới, chúng tôi sẽ đưa ra một số ví dụ về các trường hợp sử dụng khác nhau cho tổng hợp. Một số có thể là giả mã hoặc không áp dụng đúng cho tập dữ liệu thử nghiệm của chúng ta, nhưng nhằm gợi ý cách bạn có thể viết các phép tổng hợp này.
Một chủ đề quen thuộc chúng ta đã bàn là ý tưởng dùng groupBy như một phương tiện phân tích phân cấp. Hãy hình dung chúng ta có cột “revenue” và quan tâm mỗi phòng ban hoạt động ra sao. Ta có thể nhóm theo từng phòng và đánh giá mức đóng góp doanh thu của từng phòng.
CopyEdit
df.groupBy("department").agg(sum("revenue").alias("total_revenue")).show()Tổng hợp cho phép bạn sử dụng các hàm cửa sổ (window). Các hàm này nhìn vào một cửa sổ trượt của dữ liệu, hoặc là một chuỗi hàng tuần tự, hoặc là một khoảng thời gian tuần tự.
Trước tiên ta định nghĩa một cửa sổ bằng đối tượng Window để chỉ ra ta muốn partitonBy và orderBy theo gì. Sau đó dùng đối tượng này trong phương thức over() của hàm tổng hợp lựa chọn. Ví dụ, trung bình trượt sẽ trông như sf.avg().over(window).show().
Hãy tưởng tượng chúng ta muốn xem trung bình trượt của lương cho mỗi phòng ban. Ta sẽ nhóm theo department và sắp xếp theo một cột mới gọi là employeeId. Vì ID nhân viên thường tuần tự, ta có thể thấy mức lương trung bình thay đổi theo thời gian.
from pyspark.sql.window import Window

#Define the window we wish to partition and order by
windowSpec = Window.partitionBy("department").orderBy("employeeId")

#Perform the sf.avg function on the “salary” column over the windowSpec.
df.withColumn("rolling_avg", sf.avg("salary").over(windowSpec)).show()
Điều này rất giống với cách chúng ta làm hàm cửa sổ trong SQL.
Giả sử chúng ta muốn hiểu nhiều chỉ số người dùng khác nhau cho công ty media của mình. Chúng ta muốn những thứ như tổng thời gian xem và số video duy nhất. Ta có thể groupBy() theo cột user_id rồi .agg() với các hàm khác nhau như sum() và countDistinct() cho các chỉ số khác nhau.
df.groupBy("user_id").agg(
    sf.sum("watch_time").alias("total_watch"), #sum minutes watched
    sf.countDistinct("video_id").alias("unique_views") #count unique videos watched
).show()Khi tổng hợp dữ liệu trong PySpark, rất dễ rơi vào một số bẫy dẫn đến hiệu năng kém và thời gian chạy dài. Làm theo các thực hành tốt này giúp đảm bảo hiệu năng, tính đúng đắn và khả năng mở rộng.
Dưới đây là vài cách thường biến các truy vấn đơn giản thành chương trình chạy dài.
groupByKey() trong RDD:groupByKey() trong RDD, vì cơ chế của nó khiến PySpark shuffle dữ liệu qua các phân vùng. Điều này dẫn đến chi phí mạng và đĩa lớn.reduceByKey() hoặc bám vào DataFrame API.repartition().sum() trong một groupBy rồi count() trên cùng tập đã nhóm ở dòng khác sẽ tạo kế hoạch kém hiệu quả do phá vỡ khả năng tối ưu của PySpark.persist() hoặc cache() khi tái sử dụng dữ liệu đã nhóm.Dưới đây là vài cách bạn có thể tối ưu các phép tổng hợp PySpark để vận hành trơn tru!
na.fill() hoặc na.drop() trước khi tổng hợp.df.na.fill({"salary": 0}).groupBy("department").sum("salary").show()spark.sql.shuffle.partitions dựa trên khối lượng dữ liệu và xem số phân vùng nào phù hợp nhất..explain() để hiểu thực thi vật lý.df.groupBy("department").sum("salary").explain(True)Đầu ra:
	== Parsed Logical Plan ==
	'Aggregate ['department], ['department, unresolvedalias('sum(salary#600L))]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Analyzed Logical Plan ==
	department: string, sum(salary): bigint
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- LogicalRDD [department#598, employee#599, salary#600L], false

	== Optimized Logical Plan ==
	Aggregate [department#598], [department#598, sum(salary#600L) AS sum(salary)#679L]
	+- Project [department#598, salary#600L]
	   +- LogicalRDD [department#598, employee#599, salary#600L], false

	== Physical Plan ==
	AdaptiveSparkPlan isFinalPlan=false
	+- HashAggregate(keys=[department#598], functions=[sum(salary#600L)], output=[department#598, sum(salary)#679L])
	   +- Exchange hashpartitioning(department#598, 200), ENSURE_REQUIREMENTS, [plan_id=1841]
	      +- HashAggregate(keys=[department#598], functions=[partial_sum(salary#600L)], output=[department#598, sum#681L])
	         +- Project [department#598, salary#600L]
	            +- Scan ExistingRDD[department#598,employee#599,salary#600L]
Spark có nhiều cấu hình có thể tinh chỉnh cho khối lượng công việc groupBy lớn. Tham khảo bảng dưới cho một số cấu hình chính.
|
Cấu hình |
Mô tả |
|
|
Kiểm soát số phân vùng cho shuffle. Giảm cho job nhỏ, tăng cho job lớn. (Mặc định: 200) |
|
|
Bật broadcast tự động cho bảng nhỏ. Đặt -1 để tắt hoặc tăng để hỗ trợ join lớn hơn. (Mặc định: 10MB) |
|
|
Kiểm soát bộ nhớ khả dụng cho mỗi executor. Tăng giá trị này cho các phép tổng hợp lớn. (Mặc định: 4g) |
|
|
Bật Adaptive Query Execution (AQE), có thể tối ưu động shuffle, skew và join khi chạy. (Mặc định: true) |
Với người dùng nâng cao hoặc làm việc với tập dữ liệu rất lớn, hiểu cách groupBy vận hành bên dưới là điều thiết yếu. Hãy điểm qua một số điểm tinh tế về cách phương thức này hoạt động.
Tất cả các thao tác DataFrame trong PySpark, bao gồm groupBy, đều được đánh giá lười. Tức là sẽ không có tính toán nào diễn ra cho đến khi một action (như show() hoặc collect()) được kích hoạt.
Điều này cho phép Catalyst optimizer sắp xếp lại, kết hợp hoặc loại bỏ các thao tác để cải thiện hiệu năng. Hãy tận dụng điều này và xâu chuỗi nhiều phép tổng hợp và phương thức với nhau để Spark có thể tạo một kế hoạch tối ưu.
Khi dùng groupBy() nó trả về một đối tượng GroupedData. Thực hiện một hàm tổng hợp như sum() sau đó sẽ trả về một đối tượng giống DataFrame. Nếu dùng show() nó sẽ hiển thị kết quả.
Hãy nhớ rằng groupBy().agg() trả về một DataFrame mới với các cột được đặt tên mới. Luôn dùng bí danh với phương thức alias() để tránh xung đột tên và làm rõ đầu ra. Nếu bạn bỏ qua alias, có thể dẫn đến va chạm tên cột hoặc lỗi khi join về sau.
from pyspark.sql import functions as F

df.groupBy("department") \

  .agg(

      sum("salary").alias("total_salary"),

      count("*").alias("employee_count")

)Một điều cần lưu ý về PySpark là kết quả tổng hợp trả về không giữ thứ tự hàng. Hãy dùng orderBy() để có đầu ra dự đoán được và sắp xếp hàng nhất quán.
df.groupBy("department").sum("salary").orderBy("department").show()Có một số thay đổi và giới hạn theo phiên bản trong mỗi bản PySpark. Catalyst được giới thiệu từ 1.3 và cải thiện đáng kể ở 2.0. Một số phương thức chỉ xuất hiện ở các phiên bản sau, như groupingSets().
Dưới đây là bảng tóm các thay đổi chức năng lớn của PySpark. Hãy chắc chắn bạn dùng đúng phiên bản Spark và PySpark cho các tính năng mình cần!
|
Tính năng |
Phiên bản Spark |
Mô tả |
|
|
1.4+ |
Tổng hợp phân cấp hữu ích cho phân tích kiểu OLAP (3.4+ hỗ trợ Spark Connect) |
|
|
2.3+ |
UDF vector hóa dùng Apache Arrow để thực thi nhanh hơn (3.4+ hỗ trợ Spark Connect, 4.0+ hỗ trợ SCALAR) |
|
Adaptive Query Execution (AQE) |
3.0+ |
Điều chỉnh động join, shuffle và xử lý lệch trong thời gian chạy |
|
Chế độ tương thích ANSI SQL |
3.0+ |
Báo lỗi và hành vi biểu thức chính xác hơn |
|
|
4.0+ |
Cho phép nhiều nhóm trong một phép tổng hợp (ví dụ, để tính subtotal) |
Hàm groupBy của PySpark là công cụ thiết yếu để tổng hợp dữ liệu trong môi trường phân tán. Dù là tóm tắt theo vùng, tính trung bình các chỉ số, hay thực hiện phân tích đa cấp độ phức tạp, groupBy cung cấp API có khả năng mở rộng và linh hoạt để xử lý khối lượng công việc dữ liệu lớn.
Chỉ cần ghi nhớ các thực hành tốt sau để giảm thời gian chạy và chi phí:
Khi PySpark tiếp tục phát triển, chúng ta có thể kỳ vọng có nhiều tối ưu thông minh hơn, hỗ trợ nguyên bản cho các tổng hợp phức tạp, và tích hợp tốt hơn với Pandas và cú pháp kiểu SQL. Thậm chí có thể tích hợp tốt hơn cho các mô hình quy mô lớn. Nếu bạn quan tâm tìm hiểu thêm về PySpark, hãy xem các tài nguyên chi tiết từ DataCamp sau:
Các khóa học PySpark hàng đầu
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
