
{count, plural, one {Program} other {Program}}
Deret Waktu dalam Python
{hours} jam
Melatih model machine learning deret waktu bukanlah hal yang sederhana; ini cukup berbeda dari masalah klasifikasi atau regresi tradisional. Anda perlu membuat window dan lag untuk menghasilkan fitur baru dari data yang ada, dan bahkan setelah itu, model Anda mungkin tidak berkinerja baik. Bukan hanya model regresi linear yang kesulitan, bahkan model deep learning seperti LSTM dan GRU pun bisa berkinerja buruk saat meramalkan pasar saham.
Apakah kita memerlukan model seperti GPT-4o untuk deret waktu yang bekerja baik di semua jenis dataset? Tentu saja. TimeGPT adalah model fondasi mutakhir yang mampu melakukan peramalan bahkan pada dataset yang belum pernah dilihat.
Dalam tutorial ini, kita akan membahas arsitektur TimeGPT, bagaimana model ini dilatih, dan tolok ukurnya. Selain itu, kita akan mempelajari cara menggunakan API Nixtla untuk mengakses model TimeGPT guna peramalan, deteksi anomali, visualisasi deret waktu, dan evaluasi model.
Gambar oleh Penulis | Canva
TimeGPT-1 adalah model deret waktu berbasis Transformer dengan mekanisme self-attention yang dapat Anda akses menggunakan API Nixtla. Ini adalah model fondasi pertama untuk dataset deret waktu yang cukup akurat pada data yang belum pernah dilihat. Yang perlu Anda lakukan hanyalah melakukan fine-tuning pada dataset Anda, dan dalam beberapa detik, model ini akan memberikan kinerja mutakhir.
Arsitektur TimeGPT terdiri dari struktur encoder-decoder dengan beberapa lapisan, masing-masing dilengkapi dengan koneksi residual dan normalisasi lapisan. Lapisan keluarannya bersifat linear dan memetakan output decoder ke dimensi jendela peramalan.
Model ini dilatih pada kumpulan data deret waktu terbesar yang tersedia untuk publik, sehingga dapat meramalkan dataset yang belum pernah dilihat tanpa perlu pelatihan ulang. Untuk menghasilkan ramalan, TimeGPT mengambil jendela nilai sebelumnya dan menambahkan positional encoder lokal untuk memperkaya masukan.
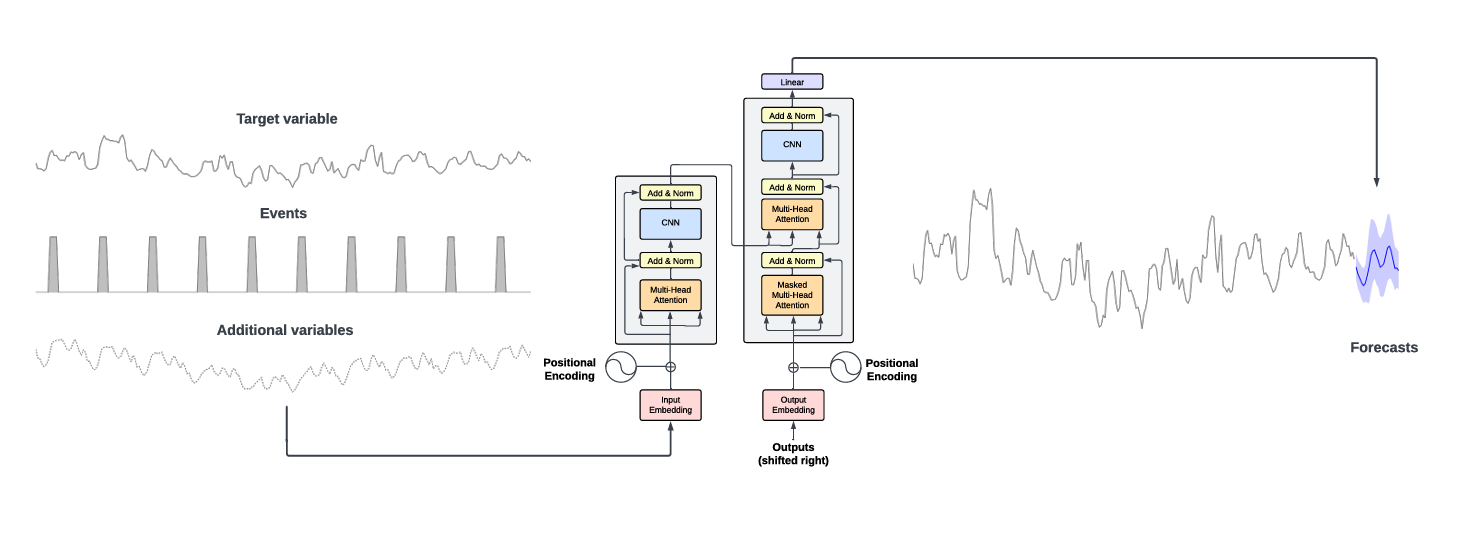
Sumber: 2310.03589 (arxiv.org) | TimeGPT mengambil nilai historis dari nilai target dan variabel eksogen tambahan sebagai masukan untuk menghasilkan ramalan.
Model TimeGPT melampaui metode statistik, machine learning, dan deep learning yang sudah mapan, menunjukkan kinerja inferensi zero-shot, efisiensi, dan kesederhanaan yang unggul. Seperti ditunjukkan pada tolok ukur di bawah ini, TimeGPT unggul di berbagai metrik machine learning bahkan tanpa rekayasa fitur apa pun.
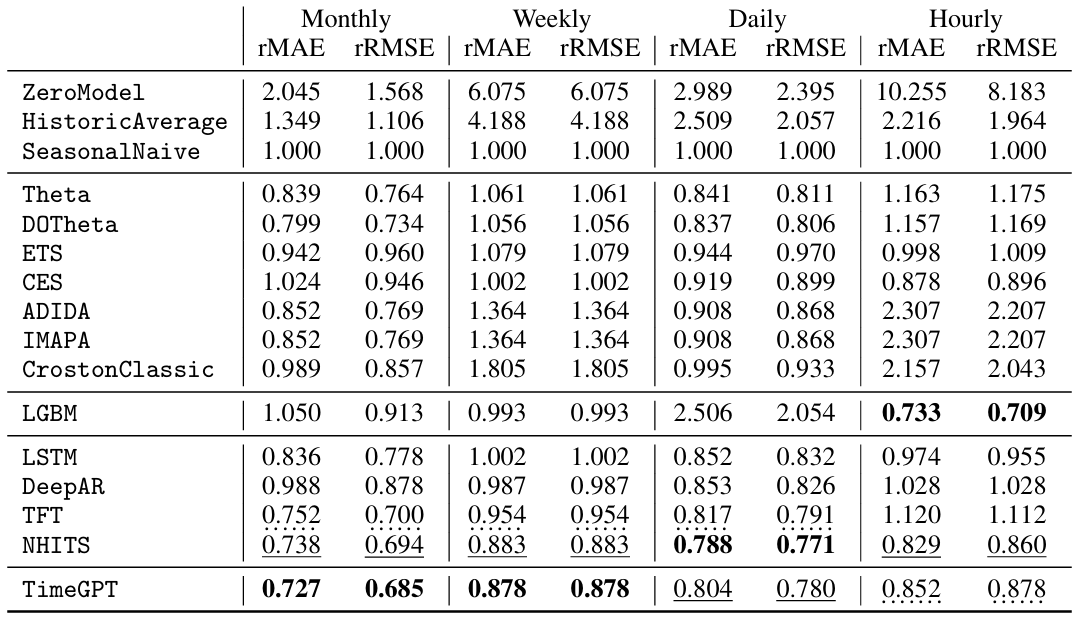
Sumber: 2310.03589 (arxiv.org) | Model tolok ukur diukur dengan rMAE dan rRMSE, skor lebih rendah lebih baik.
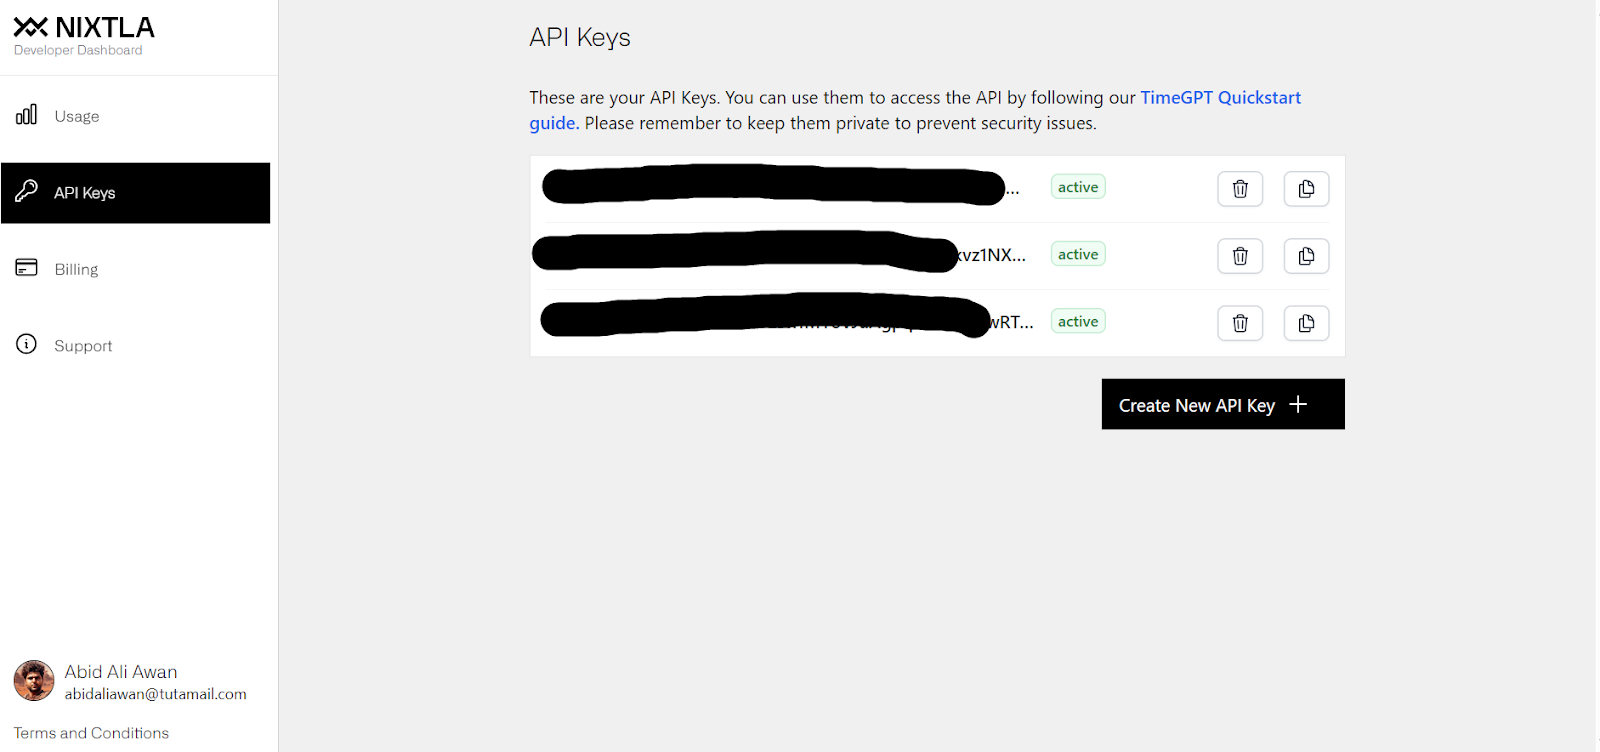
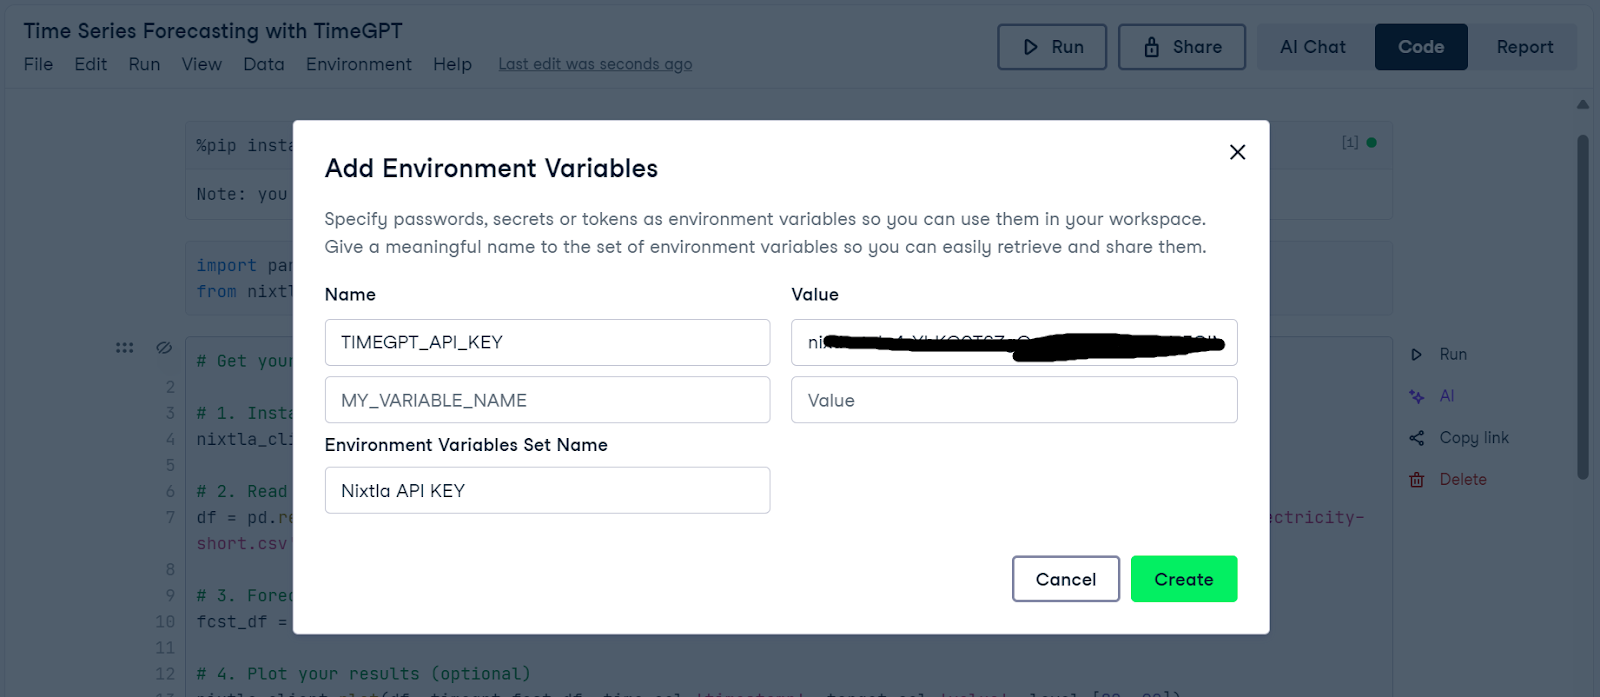
Model TimeGPT bukan open source, dan Anda hanya dapat mengaksesnya melalui API Nixtla. Bagian ini akan memandu Anda menyiapkan API Nixtla untuk mengakses model TimeGPT dan meramalkan data saham Amazon.
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
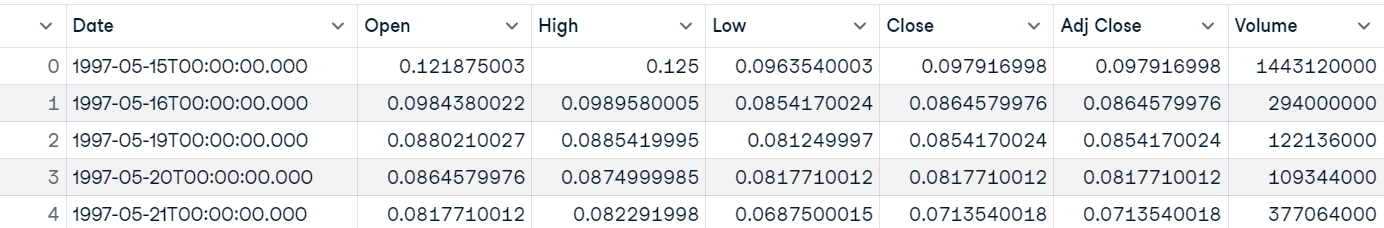
amazon_stock_data.head()Kita memiliki data harga saham Amazon mulai dari 1997 hingga saat ini.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')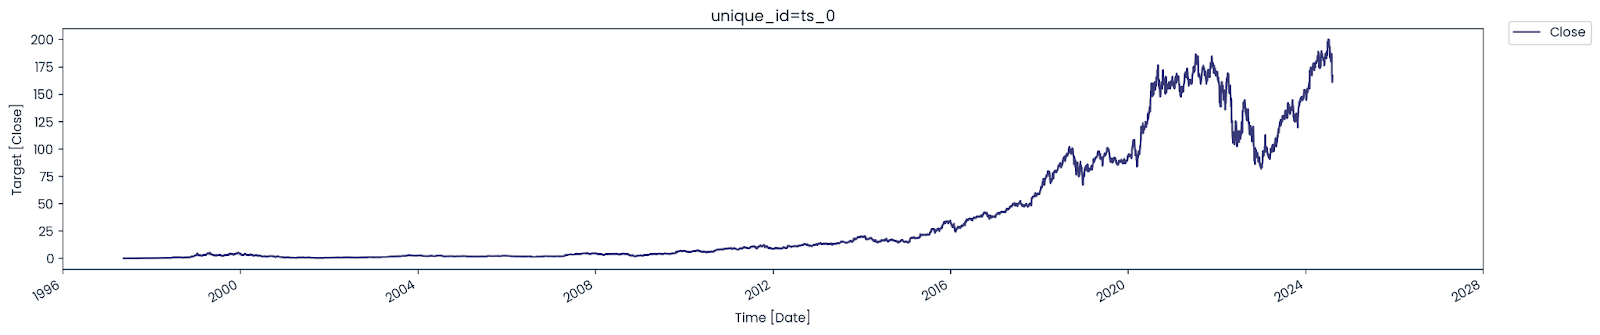
Pelajari cara membuat plot garis deret waktu menggunakan Matplotlib dengan mengikuti tutorial Matplotlib Time Series Line Plot ini.
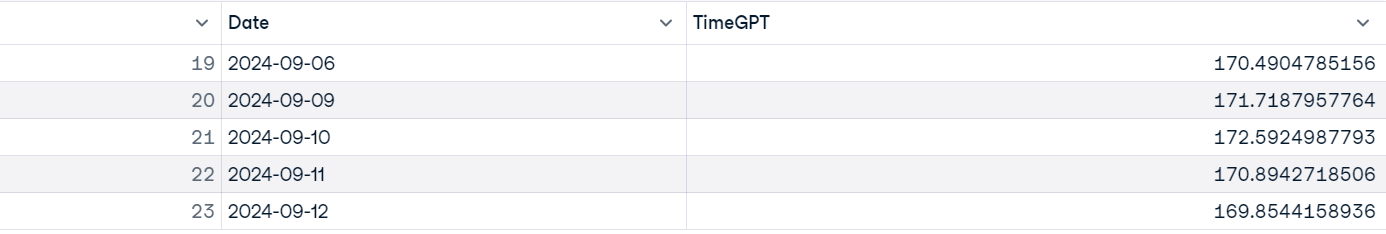
.forecast dengan data saham, nama model, horizon ramalan (setara dengan 24 hari), frekuensi, kolom waktu, dan kolom target. Karena bursa saham tutup pada akhir pekan, kita memilih frekuensi "business day(B)".model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
model.tail()
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
Seperti yang terlihat, dalam beberapa detik, model TimeGPT secara akurat memprediksi harga penutupan Amazon ke masa depan.
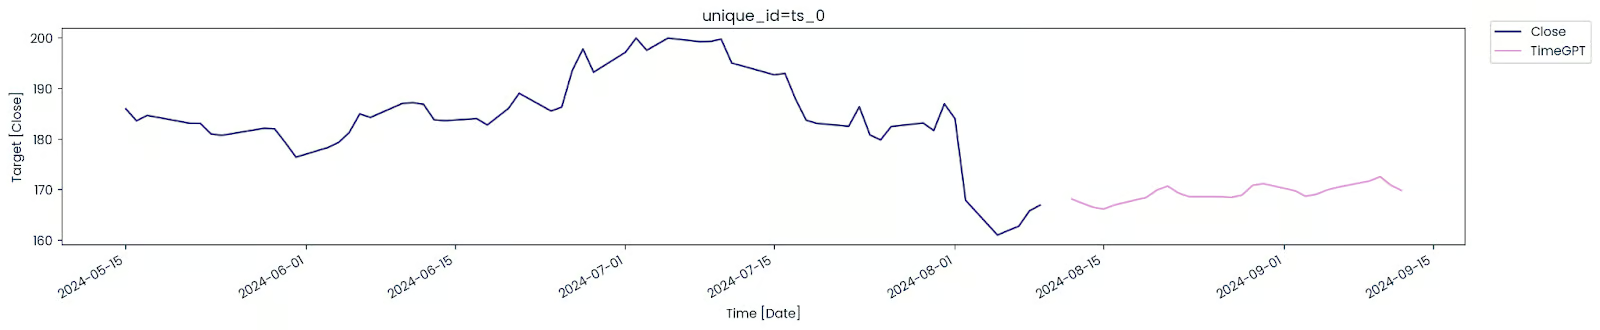
Ini adalah contoh tingkat pemula. Pada sesi berikutnya, kita akan mengerjakan dataset yang lebih kompleks dan mengeksplorasi berbagai fitur API Nixtla.
Pada bagian ini, kita akan menggunakan dataset yang lebih kompleks tentang Permintaan Listrik Australia dan menggunakan model TimeGPT untuk meramalkan banyak nilai sekaligus.
Dataset ini terdiri dari 5 deret waktu yang merepresentasikan permintaan listrik per setengah jam dari 5 negara bagian di Australia: Victoria, New South Wales, Queensland, Tasmania, dan Australia Selatan.
Kita juga akan mempelajari cara melakukan fine-tuning pada model dan menggunakan berbagai hiperparameter untuk meningkatkan kinerja. Terakhir, kita akan melakukan cross-validation dan membandingkan kinerja model dengan model tradisional untuk penilaian yang menyeluruh.
Tidak ada cara sederhana untuk memuat file .tsf di pustaka pandas. Kita harus membuat fungsi kustom sendiri untuk memuat dan memproses data lalu mengonversinya menjadi dataframe Pandas.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

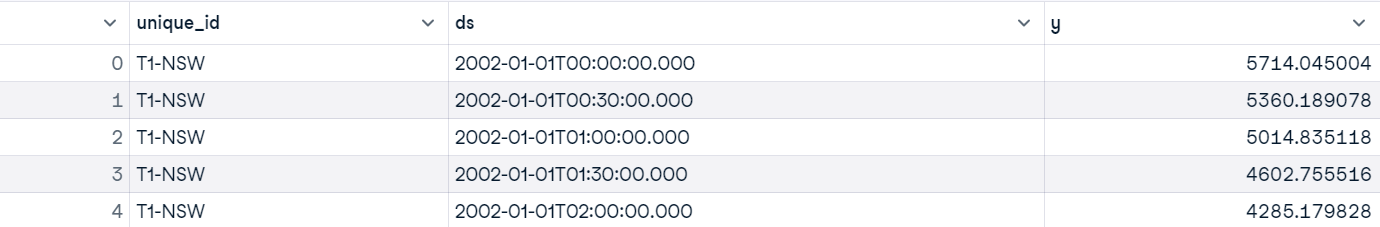
demand_df.head()
Dataset kita memiliki tiga kolom:
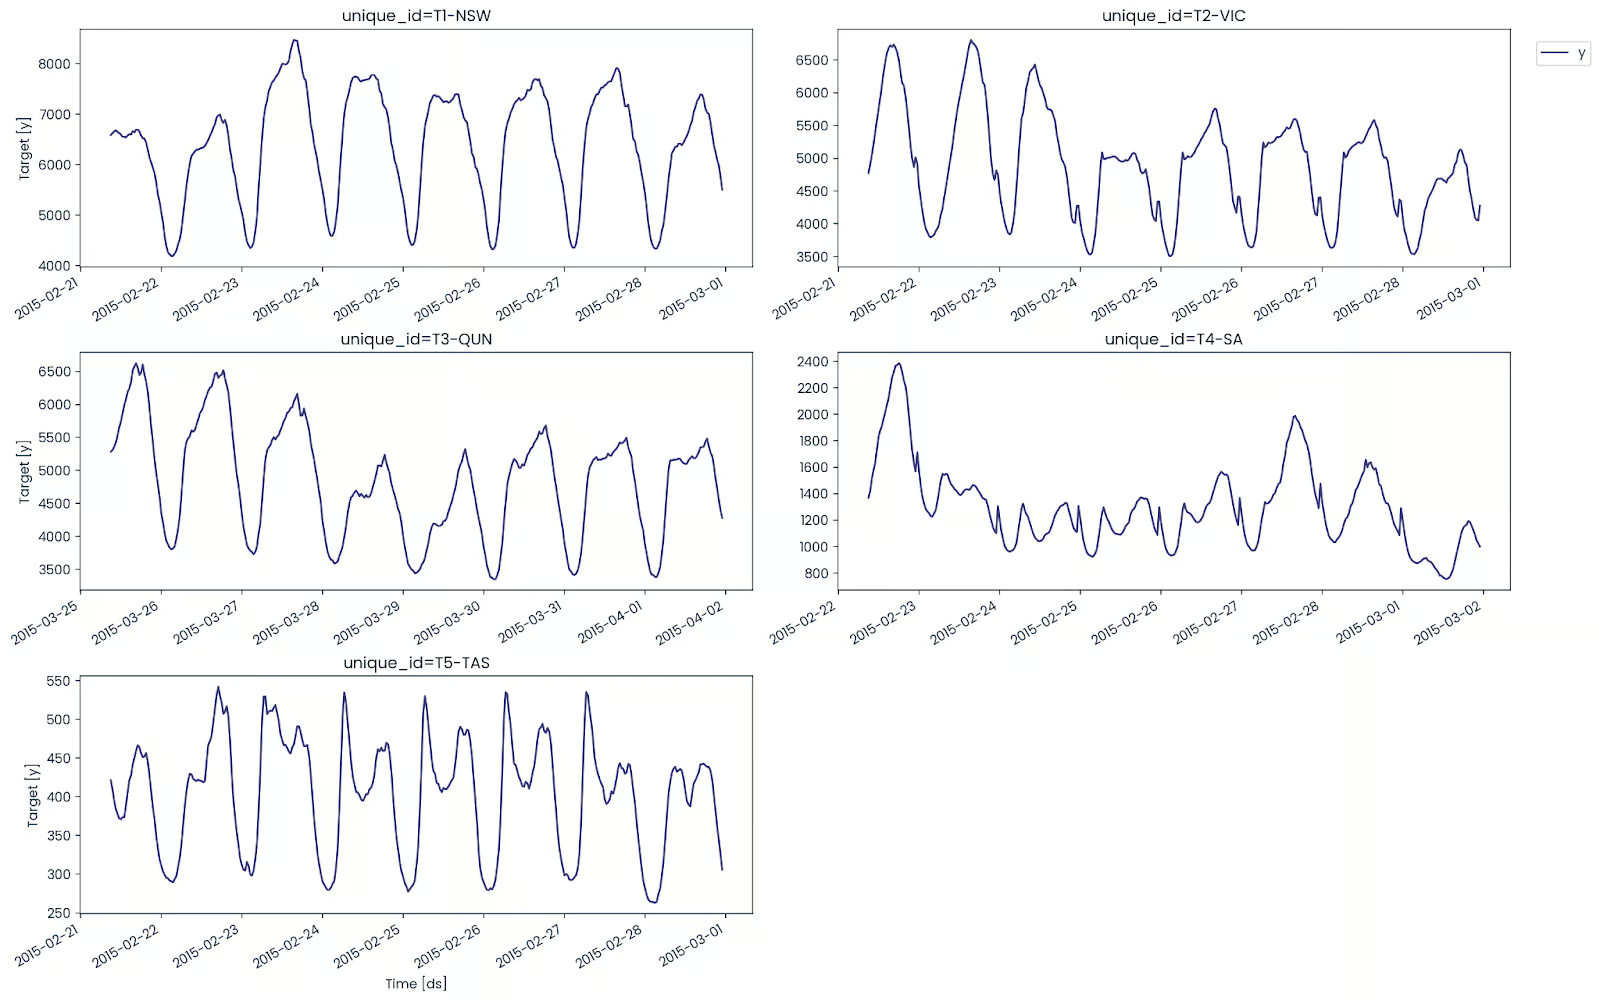
Fungsi plot sangat bagus karena secara otomatis mengenali kolom unique_id dan membuat lima visualisasi deret waktu yang berbeda.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
Visualisasi di bawah ini menunjukkan konsumsi daya dari 5 negara bagian, dan semuanya memiliki pola yang berbeda.
Pelajari analisis deret waktu dengan mengikuti sesi live code-along di DataCamp, di mana Anda akan menyelami dataset deret waktu finansial menggunakan Python.
Pada sesi ini, kita akan mengeksplorasi berbagai saham, memvisualisasikan kinerjanya, dan membuat ramalan menggunakan model yang berbeda.
Sebelum melakukan peramalan, kita akan mengidentifikasi berbagai anomali dalam dataset untuk memahami masalah dengan lebih baik.
Fungsi .detect_anomalies menerima dataset, kolom waktu dan target, serta frekuensi.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
Kita telah menampilkan semua kejadian di mana anomali terdeteksi.
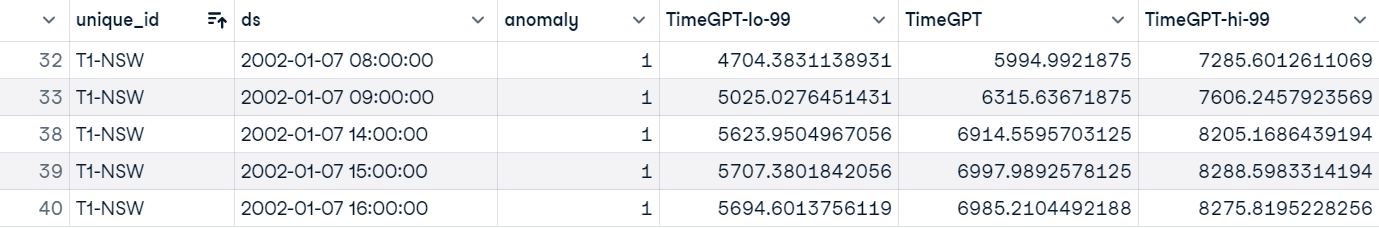
Jumlah total anomali di semua 5 dataset deret waktu adalah 17.316, yang tergolong banyak.
anomalies_df.anomaly.value_counts()
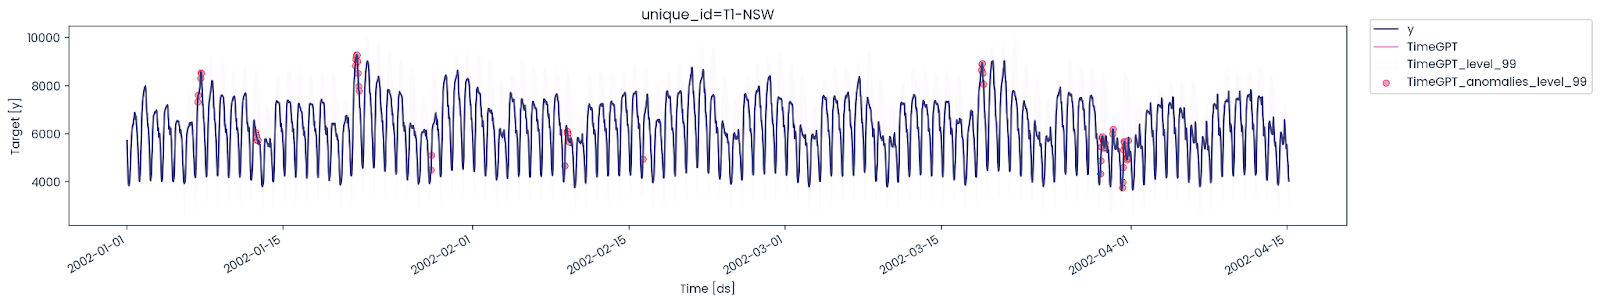
Sekarang, kita akan memplot anomali pada dataset aktual untuk melihat di mana dan seberapa sering anomali terjadi dari hari ke hari. Untuk menyederhanakan visualisasi, kita hanya akan menampilkan 5.000 sampel dari New South Wales.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
Anomali secara harian tidak umum, tetapi ada hari-hari ketika beberapa anomali terjadi dalam satu hari.
Sekarang kita akan meramalkan permintaan listrik New South Wales. Untuk itu, kita akan memfilter hanya nilai untuk "T1-NSW".
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()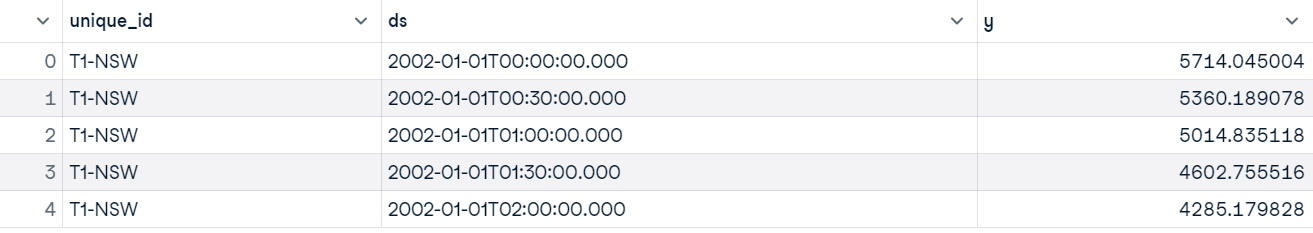
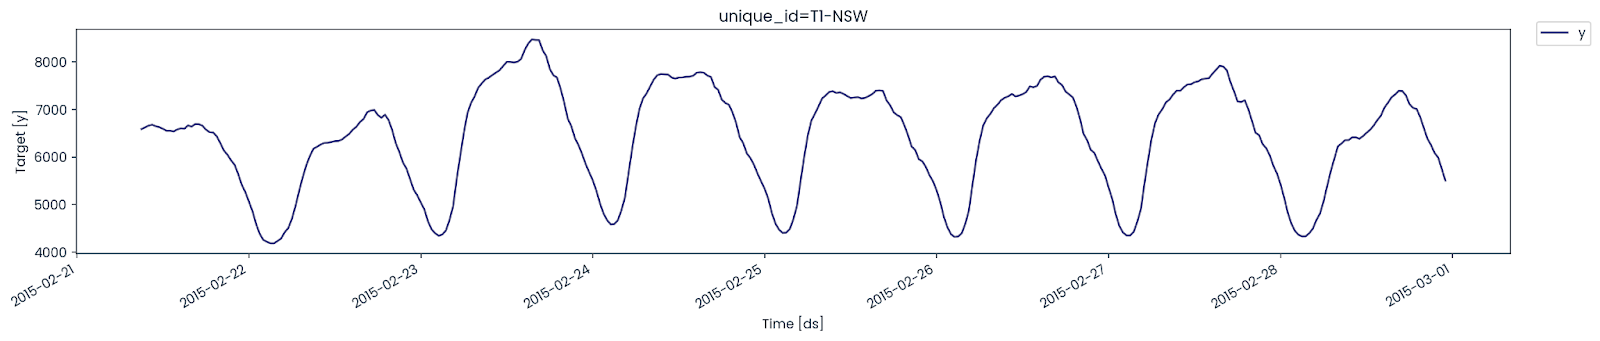
Plot 365 nilai terbaru untuk memahami pola konsumsi listrik.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
Sekarang kita akan mengevaluasi kinerja model. Untuk itu, kita perlu membagi dataset menjadi set pelatihan dan pengujian.
Set pelatihan terdiri dari 144 nilai, yang setara dengan 3 hari, dan set pengujian terdiri dari 1200 nilai, yang setara dengan 25 hari.
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Untuk peramalan, kita akan memilih model yang lebih baik dan menyetel berbagai argumen untuk meningkatkan kinerja model, khususnya:
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
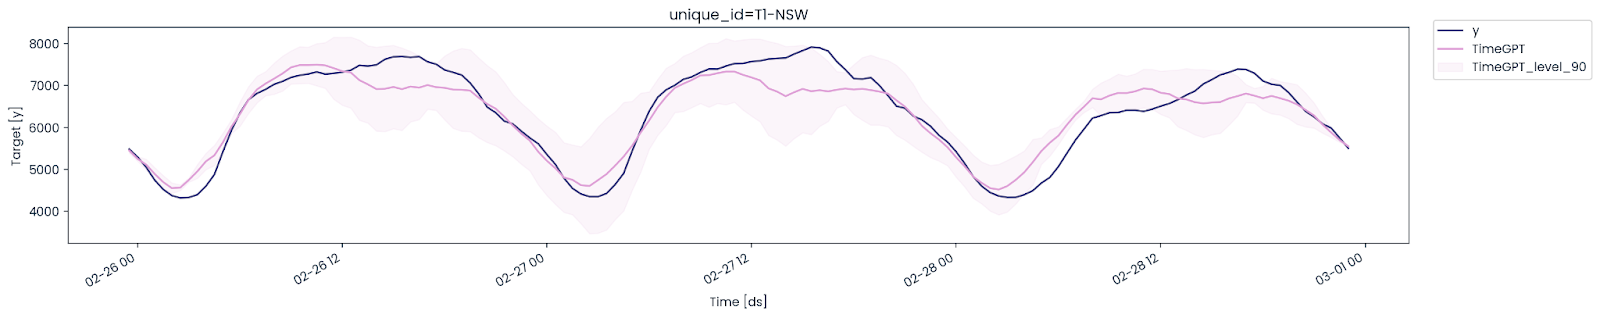
Plot data aktual, ramalan, dan interval kepercayaan 90 persen untuk menilai kinerja model.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Dalam beberapa detik, kita mendapatkan hasil yang cukup akurat. Itulah kekuatan model pra-latih.
Sekarang kita akan mengevaluasi kinerja model menggunakan pustaka UtilsForecast, yang merupakan bagian dari proyek open-source Nixtla. Untuk melakukannya, kita akan menggabungkan dataset pengujian dan ramalan, lalu memberikannya ke fungsi evaluate. Fungsi ini menerima dataset, metrik, model, kolom target, dan ID unik untuk menghitung metrik model dan menampilkannya sebagai data frame pandas.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
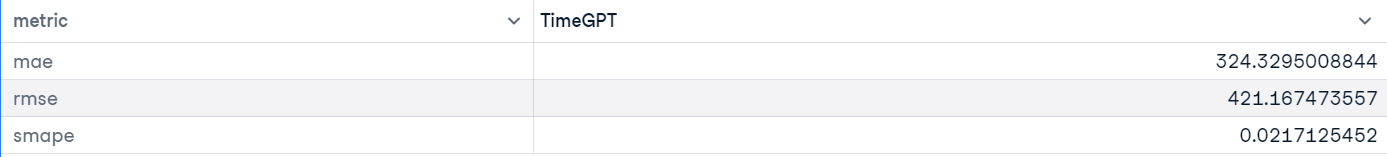
average_metrics
Kita mendapatkan hasil yang cukup baik.
API Nixtla juga memungkinkan Anda meramalkan banyak seri sekaligus. Kita akan menggunakan seluruh dataset alih-alih memfilter berdasarkan ID unik.
Untuk membagi dataset menjadi set pelatihan dan pengujian, kita menggunakan fungsi groupby untuk membagi 144 nilai untuk setiap ID unik. Jika tidak, kita hanya akan memiliki 144 nilai untuk beberapa ID unik yang dipilih secara acak.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
Fungsi forecast sama seperti pada bagian sebelumnya, hanya saja kali ini kita juga menyertakan kolom ID.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
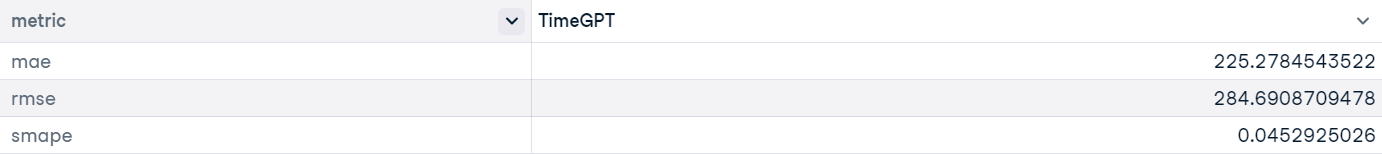
Plot grafik deret waktu untuk nilai aktual, ramalan, dan level kepercayaan 90 dari semua 5 Unique ID.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Seperti terlihat, model TimeGPT berkinerja baik bahkan pada banyak deret waktu, kecuali untuk Australia Selatan. Model tidak dapat meramalkan tren penurunan permintaan listrik.
Kita perlu menggabungkan dataframe pengujian dan ramalan untuk mengevaluasi model menggunakan metrik MAE, RMSE, dan SMAPE.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
Gunakan fungsi evaluate untuk menghasilkan laporan kinerja model sebagai dataframe pandas. Laporan ini akan berisi metrik model untuk setiap ID unik. Untuk menghitung kinerja keseluruhan model, kita harus merata-ratakan nilainya dan menampilkan hasil akhirnya.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

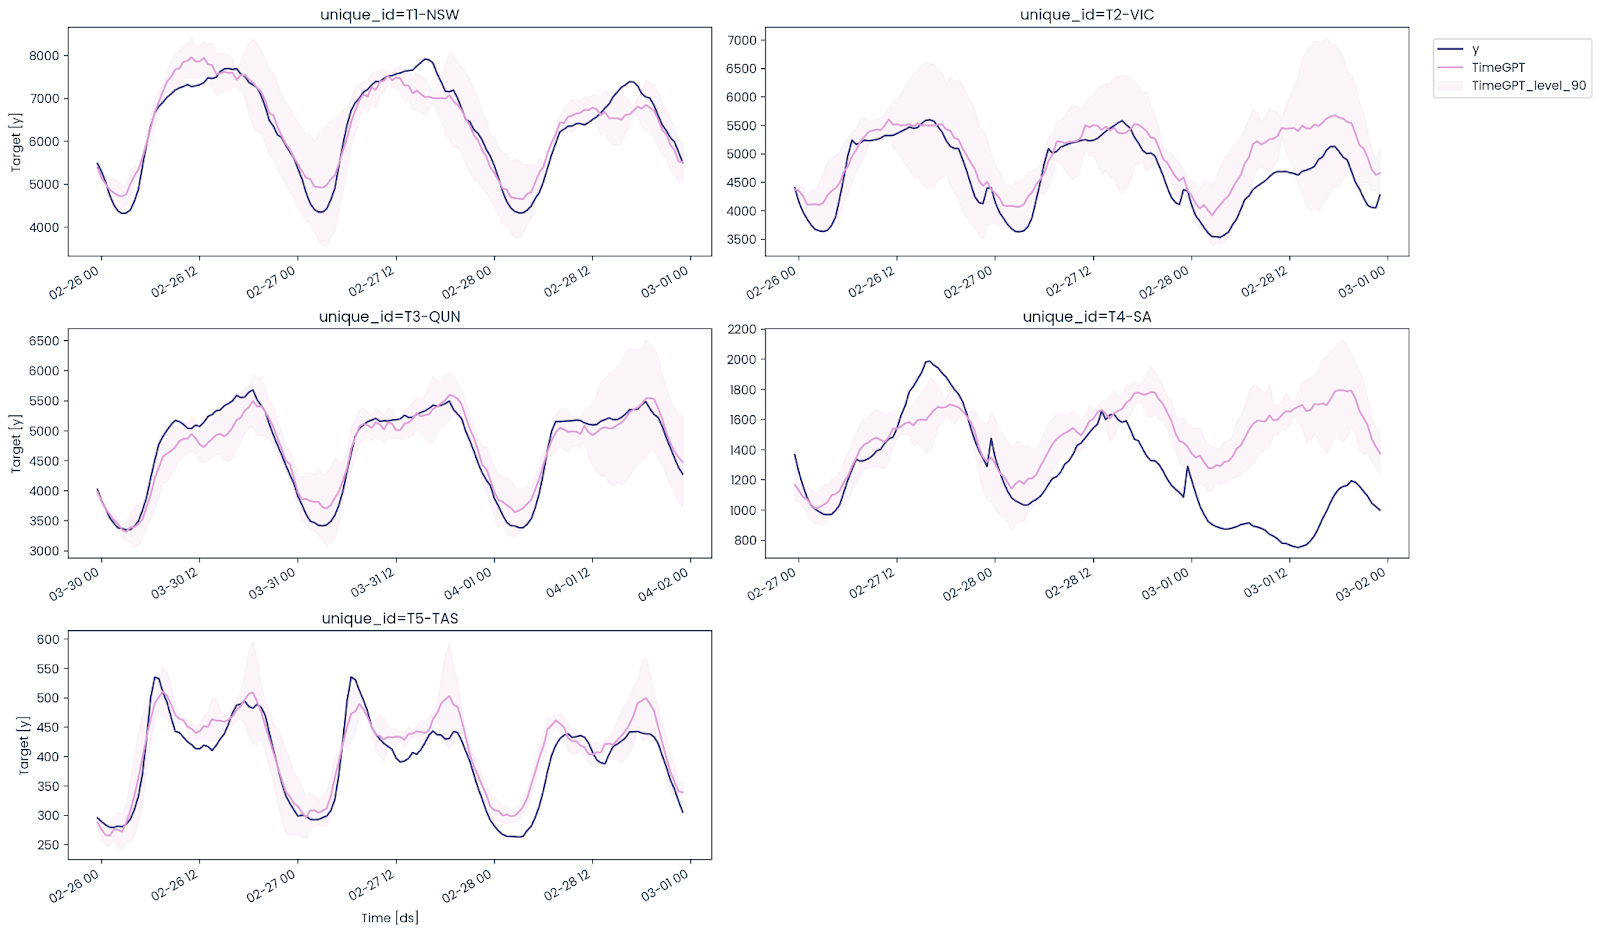
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Kinerja model secara keseluruhan meningkat saat di-fine-tune pada banyak deret waktu dibandingkan satu deret saja.
Klien Nixtla juga memungkinkan Anda melakukan cross-validation untuk mengevaluasi kinerja model pada berbagai jendela dataset.
Kita akan menggunakan fungsi .cross_validation dan memberikannya dataset yang telah difilter yang hanya berisi nilai New South Wales. Cross-validation akan memiliki 5 jendela, masing-masing sepanjang 7 jam.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
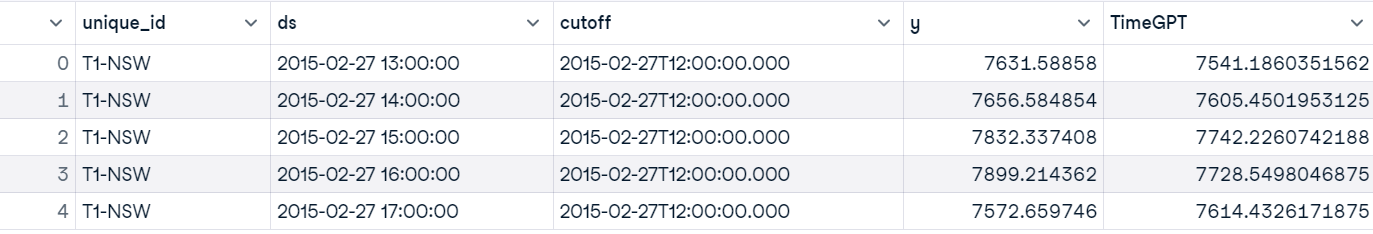
timegpt_cv_df.head()
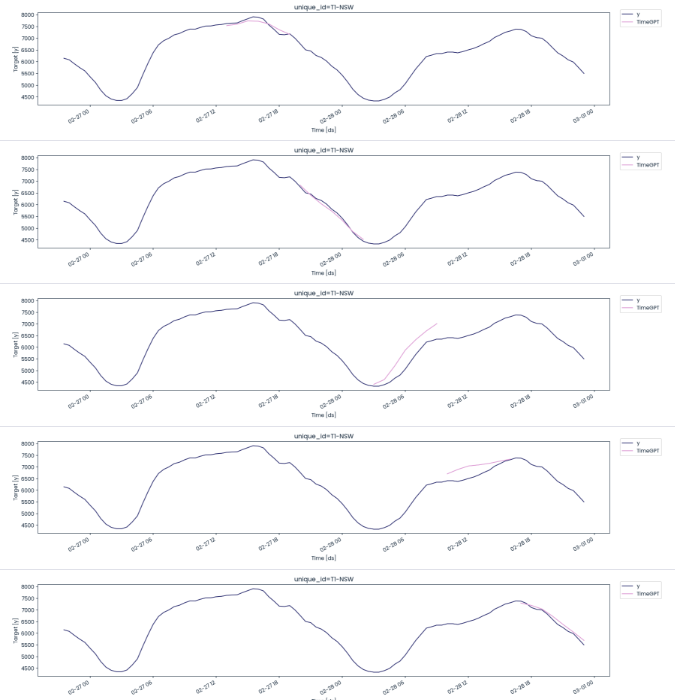
Seperti terlihat, kita mendapatkan nilai ramalan berdasarkan lima jendela berdurasi 7 jam.
Kita akan menggunakan tanggal dan waktu cutoff untuk membuat 5 jendela, masing-masing menampilkan nilai prediksi dan aktual.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
Selain pada pembagian ke-3 dan ke-4, model berkinerja cukup baik.
Sekarang mari bandingkan kinerja model TimeGPT dan Light Gradient-Boosting Machine (LGBM) untuk menentukan dengan jelas mana yang unggul pada dataset yang sama. Kita telah melakukan cross-validation pada dataframe New South Wales; langkah berikutnya adalah menggunakan fungsi evaluate untuk menghasilkan laporan evaluasi model.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation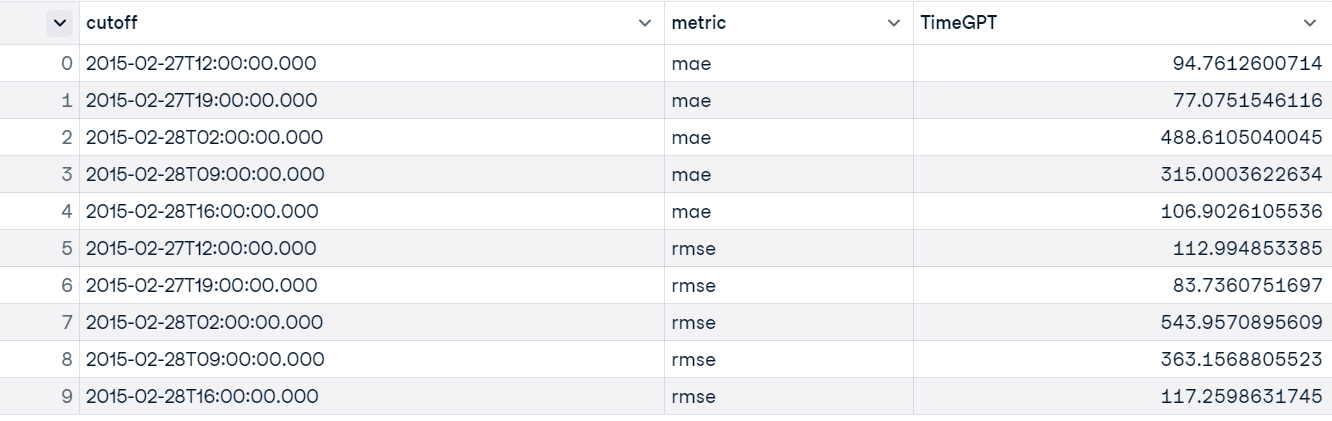
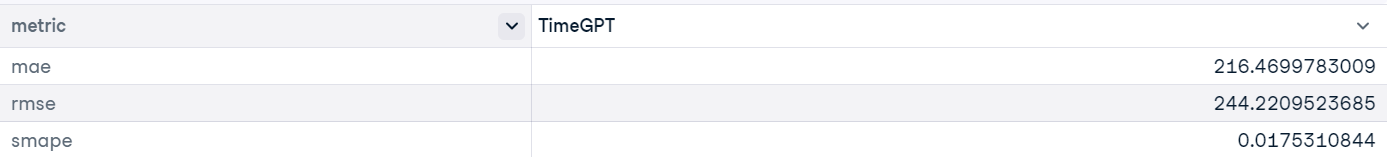
Kita perlu menghitung rata-rata MAE, RMSE, dan SMAPE untuk semua 5 jendela guna memperoleh hasil keseluruhan model.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Hasilnya cukup baik, bahkan pada himpunan nilai yang kecil.
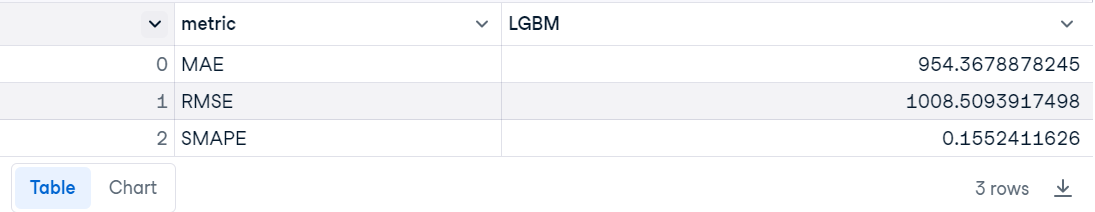
Untuk mengevaluasi model LGBM, kita perlu mengikuti langkah-langkah berikut:
Catatan: Untuk menggunakan model statistik dan machine learning dalam peramalan deret waktu, penting untuk mempelajari teknik rekayasa fitur dasar dan algoritma. Untuk panduan komprehensif tentang topik ini, lihat tutorial berikut: Tutorial Peramalan Deret Waktu di DataCamp.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
metrics_df
TimeGPT hampir 5 kali lebih baik daripada LGBM.
Jika Anda mengalami masalah saat menjalankan kode di atas atau menyiapkan TimeGPT, silakan cek ruang kerja DataLab: Time Series Forecasting with TimeGPT.
Ekosistem TimeGPT dan Nixtla ideal bagi perusahaan yang baru memulai, karena menghilangkan kebutuhan untuk merekrut insinyur machine learning untuk melatih model dan insinyur MLOps untuk menerapkan serta memeliharanya. Jika Anda adalah startup, Anda dapat menghemat biaya secara signifikan sambil tetap mengakses model berkinerja tinggi.
Mirip dengan GPT-3, TimeGPT merepresentasikan awal dari model-model mutakhir untuk deret waktu, dan seiring peningkatan model-model ini, banyak perusahaan kemungkinan akan mengadopsi API Nixtla untuk integrasi yang mudah dan kinerja yang lebih baik.
Dalam tutorial ini, kita telah mengeksplorasi TimeGPT, model fondasi pertama untuk deret waktu. Selain itu, kita telah mempelajari cara menggunakan Python API untuk mengakses model TimeGPT untuk tugas-tugas seperti peramalan, visualisasi deret waktu, evaluasi model, cross-validation, dan deteksi anomali.
Pelajari cara meramalkan masa depan menggunakan model kelas ARIMA dan menghasilkan prediksi serta wawasan menggunakan model machine learning dengan Time Series with Python skill track. Jika Anda lebih menyukai bahasa R, pertimbangkan Time Series with R skill track untuk memahami peramalan deret waktu secara komprehensif.
Kursus Teratas di DataCamp
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt



