
Lernpfad
Zeitreihen mit Python
20 Std.
Ein Zeitreihenmodell für Machine Learning zu trainieren, ist alles andere als trivial und unterscheidet sich deutlich von klassischen Klassifikations- oder Regressionsaufgaben. Du musst Fenster und Lags erstellen, um aus vorhandenen Daten neue Features zu generieren – und selbst dann liefert das Modell oft keine guten Ergebnisse. Nicht nur lineare Regressionsmodelle tun sich schwer; auch Deep-Learning-Modelle wie LSTM und GRU können bei Börsenprognosen schwächeln.
Brauchen wir also ein Modell à la GPT-4o für Zeitreihen, das über alle Datensätze hinweg stark performt? Auf jeden Fall. TimeGPT ist ein hochmodernes Grundlagemodell, das auch auf unbekannten Datensätzen präzise Prognosen liefert.
In diesem Tutorial schauen wir uns die Architektur von TimeGPT, sein Training und Benchmarks an. Außerdem lernst du, wie du über die Nixtla API auf TimeGPT zugreifst – für Forecasting, Anomalieerkennung, Zeitreihenvisualisierung und Modellevaluation.
Bild: Autor | Canva
TimeGPT-1 ist ein Transformer-basiertes Zeitreihenmodell mit Self-Attention-Mechanismen, auf das du über die Nixtla API zugreifst. Es ist das erste Grundlagemodell für Zeitreihendaten, das auch auf unbekannten Daten recht präzise ist. Alles, was du tun musst: Es kurz auf deinem Datensatz feinabstimmen – und nach wenigen Sekunden liefert es State-of-the-Art-Ergebnisse.
Die TimeGPT-Architektur besteht aus einer Encoder-Decoder-Struktur mit mehreren Schichten, jeweils mit Residualverbindungen und Layer-Normalisierung. Die Ausgabeschicht ist linear und mappt die Decoder-Ausgabe auf die Dimension des Forecast-Fensters.
Trainiert wurde es auf der größten Sammlung frei verfügbarer Zeitreihendaten. Dadurch kann es unbekannte Datensätze ohne erneutes Training vorhersagen. Für eine Prognose nimmt TimeGPT ein Fenster vergangener Werte und ergänzt es um einen lokalen Positionsencoder, um die Eingabe zu veredeln.
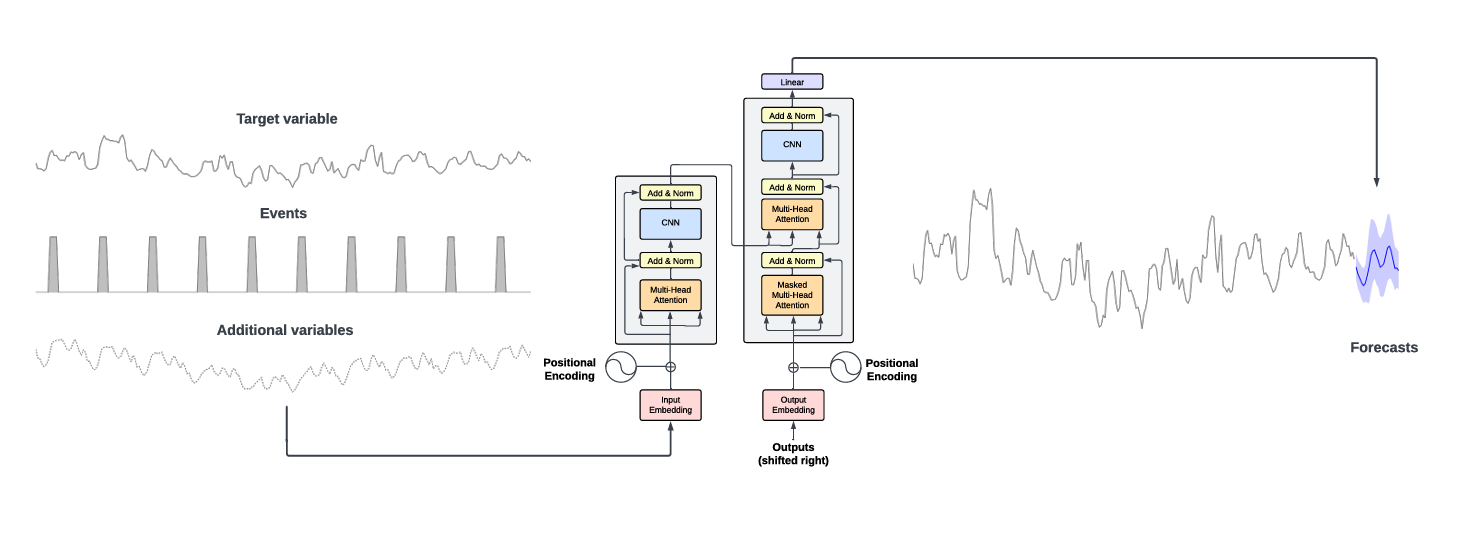
Quelle: 2310.03589 (arxiv.org) | TimeGPT nutzt historische Zielwerte und zusätzliche exogene Variablen als Eingaben, um Prognosen zu erzeugen.
TimeGPT übertrifft etablierte statistische, ML- und Deep-Learning-Methoden und überzeugt mit starker Zero-Shot-Inferenz, Effizienz und einfacher Nutzung. Wie der Benchmark unten zeigt, glänzt TimeGPT über verschiedene Metriken hinweg – ganz ohne Feature Engineering.
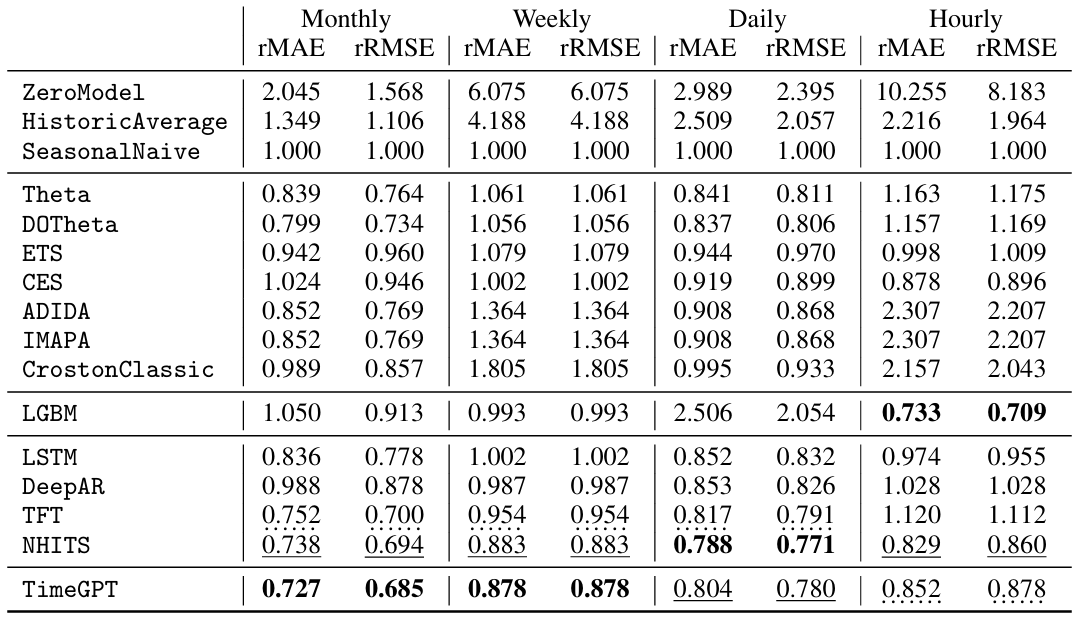
Quelle: 2310.03589 (arxiv.org) | Benchmark-Modelle gemessen mit rMAE und rRMSE, niedrigere Werte sind besser.
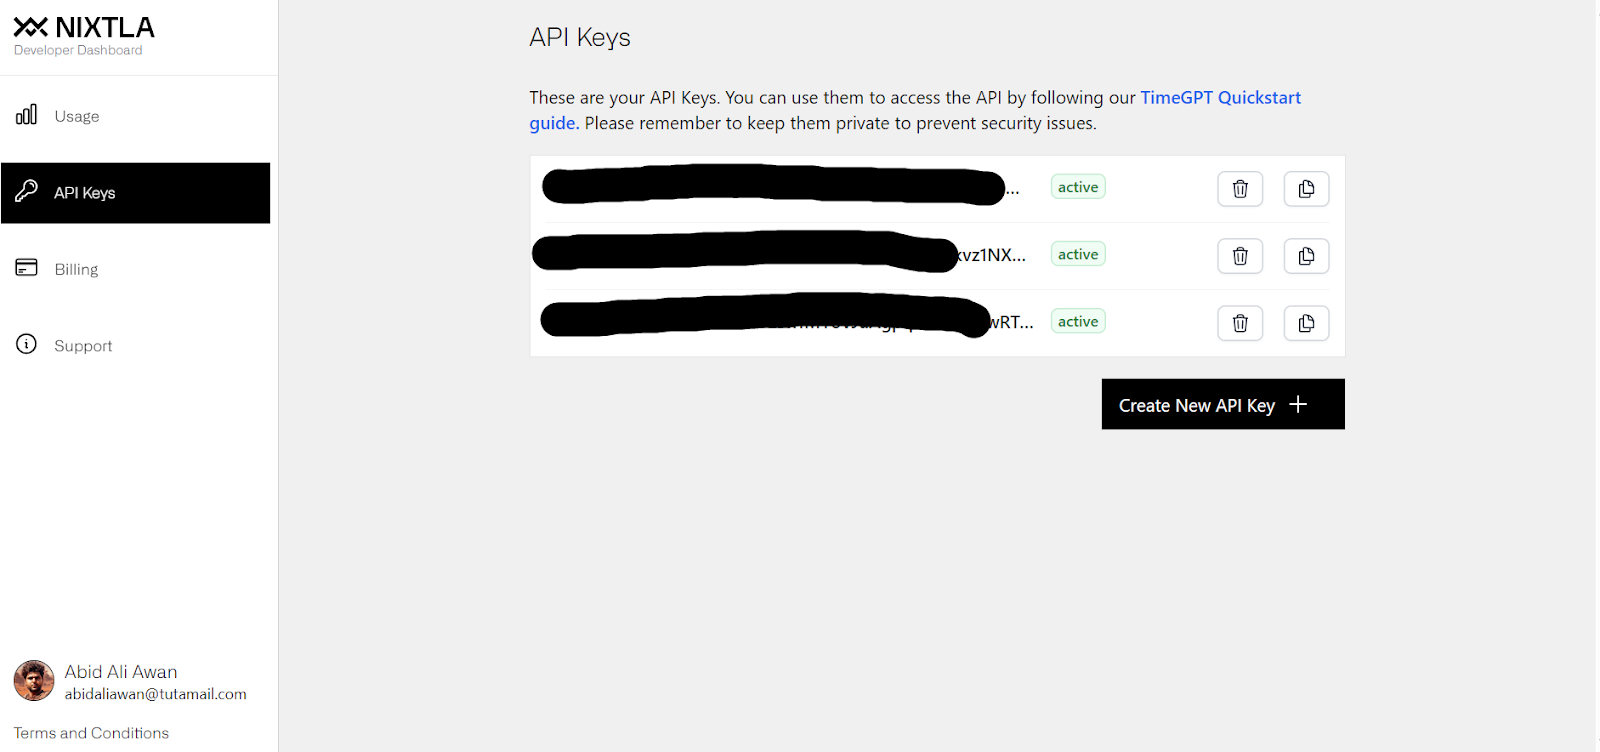
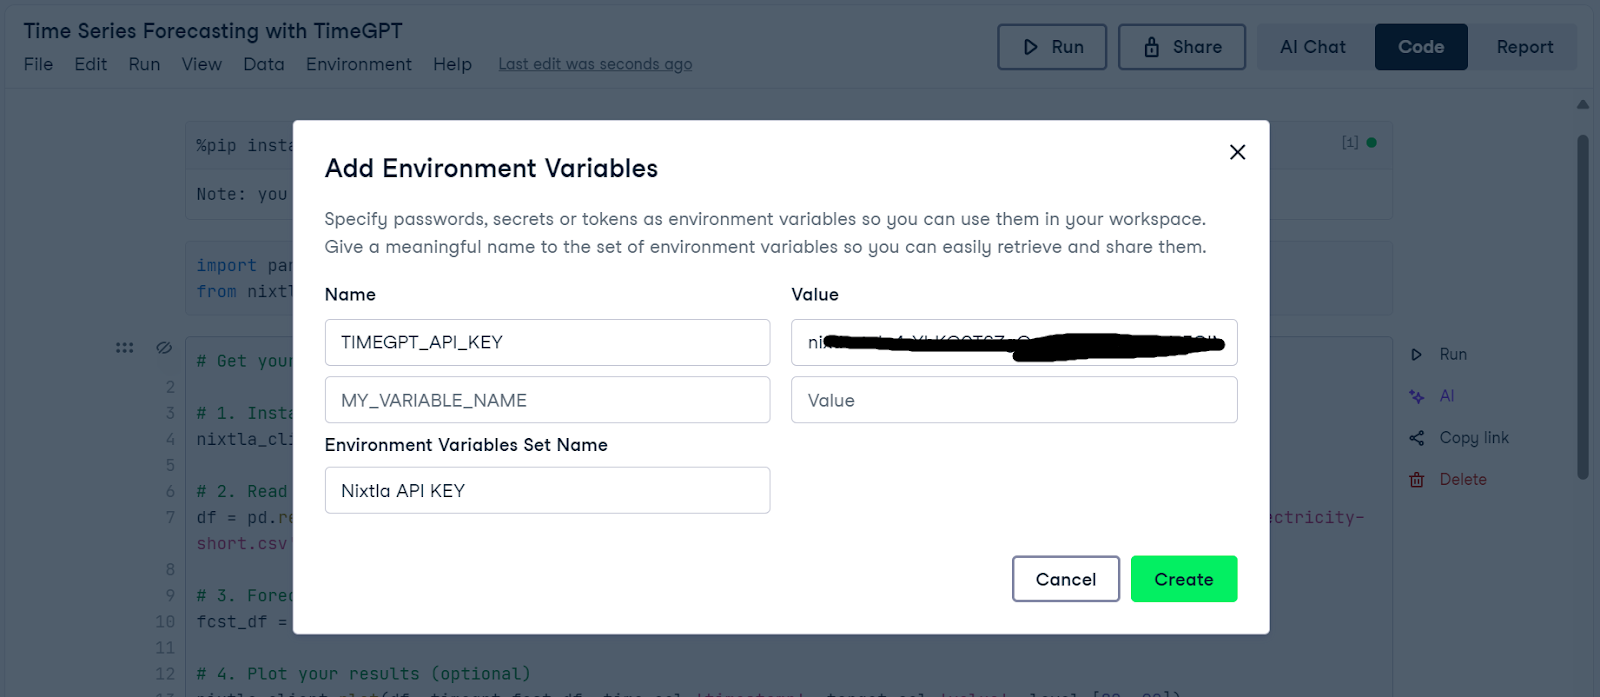
TimeGPT ist nicht Open Source und ausschließlich über die Nixtla API zugänglich. In diesem Abschnitt richten wir die Nixtla API ein, um auf TimeGPT zuzugreifen und Börsendaten von Amazon zu prognostizieren.
%%capture
%pip install nixtla>=0.5.1
%pip install yfinanceimport pandas as pd
import yfinance as yf
from nixtla import NixtlaClient
import os
timegpt_api_key = os.environ["TIMEGPT_API_KEY"]
# Setup NixtlaClient
nixtla_client = NixtlaClient(api_key = timegpt_api_key)
# Downloading Amazon stock price data
ticker = 'AMZN'
amazon_stock_data = yf.download(ticker)
amazon_stock_data = amazon_stock_data.reset_index()
# Displaying the dataset
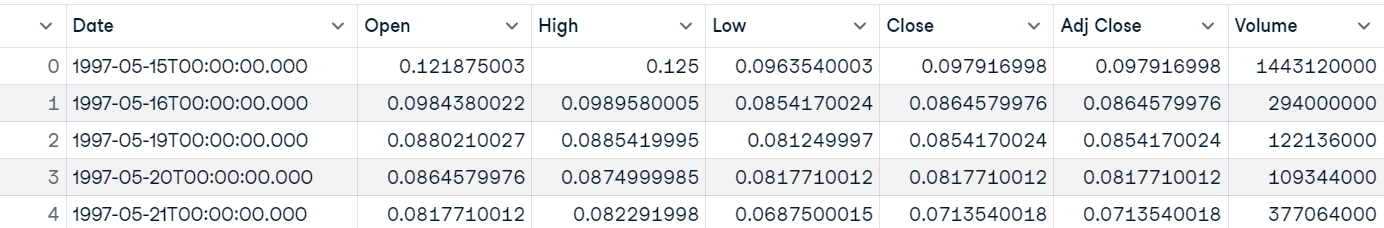
amazon_stock_data.head()Wir haben Amazon-Kursdaten ab 1997 bis heute.
nixtla_client.plot(amazon_stock_data, time_col='Date', target_col='Close')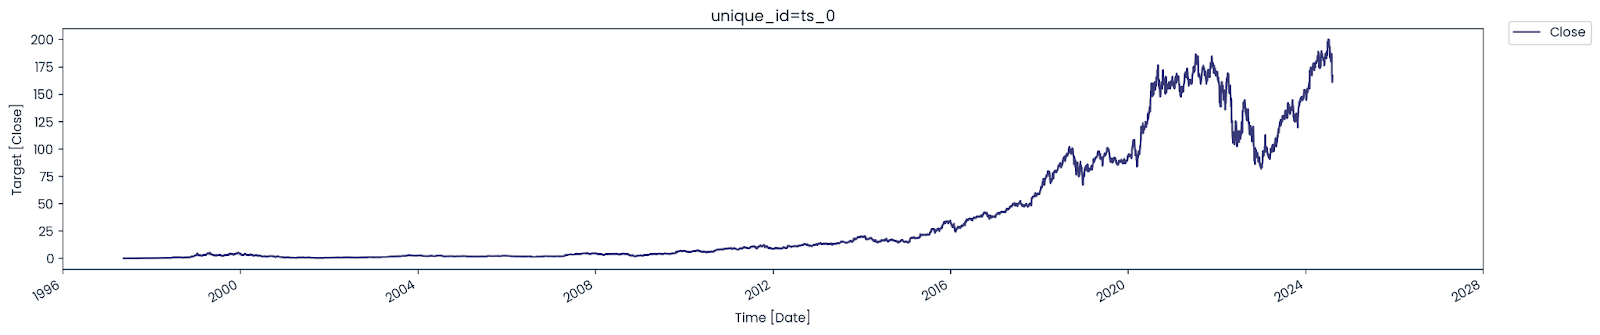
Lerne in diesem Matplotlib-Tutorial zu Zeitreihen-Liniendiagrammen, wie du Zeitreihendiagramme erstellst.
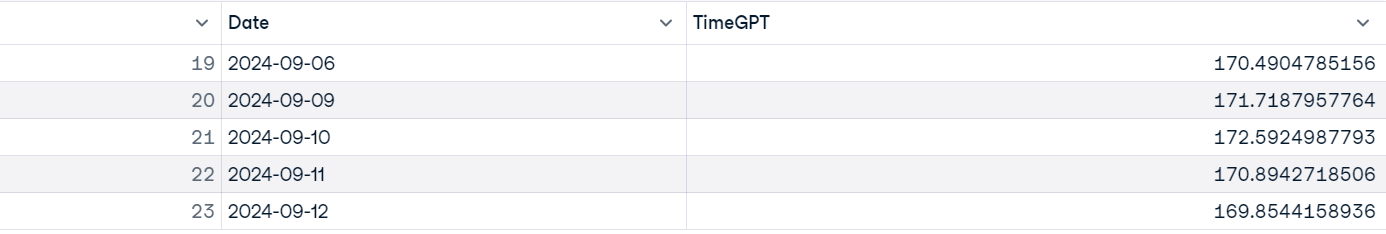
.forecast die Kursdaten, den Modellnamen, den Prognosehorizont (hier 24 Tage), die Frequenz sowie Zeit- und Zielspalten. Da die Börse am Wochenende geschlossen ist, wählen wir die Frequenz "Business Day (B)".model = nixtla_client.forecast(
df=amazon_stock_data,
model="timegpt-1",
h=24,
freq="B",
time_col="Date",
target_col="Close",
)
model.tail()
nixtla_client.plot(
    amazon_stock_data,
    model,
    time_col="Date",
    target_col="Close",
    max_insample_length=60,
)
Wie zu sehen ist, hat TimeGPT innerhalb weniger Sekunden die Schlusskurse von Amazon sehr treffend in die Zukunft projiziert.
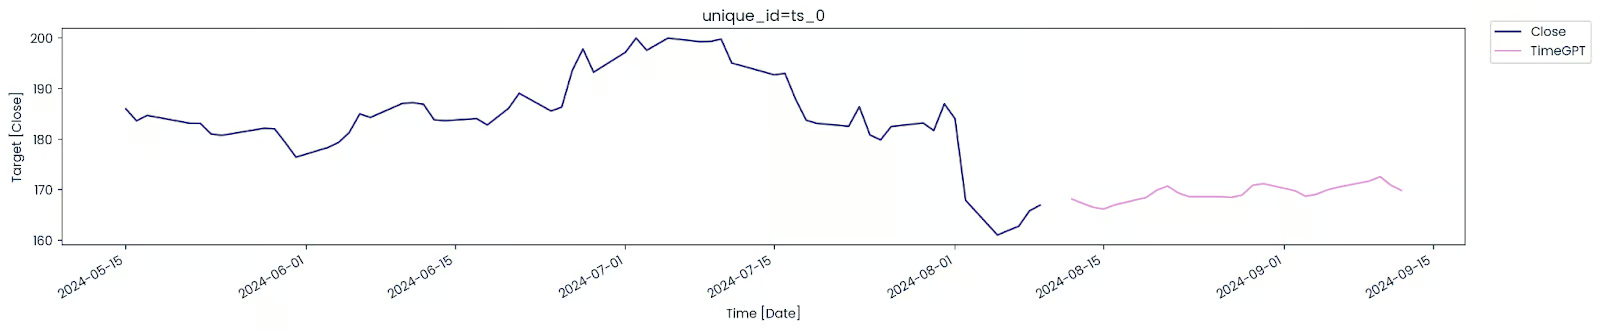
Das war ein Einstiegsbeispiel. Im nächsten Abschnitt arbeiten wir mit komplexeren Datensätzen und entdecken weitere Funktionen der Nixtla API.
Hier verwenden wir einen komplexeren Datensatz zur Stromnachfrage in Australien und lassen TimeGPT mehrere Reihen gleichzeitig vorhersagen.
Der Datensatz umfasst 5 Zeitreihen mit halbstündlicher Stromnachfrage der Bundesstaaten Victoria, New South Wales, Queensland, Tasmanien und South Australia.
Außerdem lernst du, das Modell zu feinabstimmen und mit Hyperparametern die Performance zu steigern. Abschließend führen wir Cross-Validation durch und vergleichen die Ergebnisse mit traditionellen Modellen – für eine fundierte Bewertung.
Es gibt keinen einfachen Weg, .tsf-Dateien in pandas zu laden. Wir schreiben daher eine kleine Hilfsfunktion, die die Daten einliest, aufbereitet und in ein pandas-DataFrame konvertiert.
import pandas as pd


def read_tsf_from_file(file_path):
    data = []
    start_date = pd.to_datetime("2002-01-01 00:00:00")

    # Open and read the file from the directory

    with open(file_path, "r") as file:
        for line in file:
            if line.startswith("T"):
                parts = line.strip().split(":")
                unique_id = parts[0] + "-" + parts[1]
                values = list(map(float, parts[3].split(",")[:-1]))

                # Generate datetime index at half-hour intervals

                periods = len(values)
                date_range = pd.date_range(
                    start=start_date, periods=periods, freq="30min"
                )

                # Append to data list

                for dt, value in zip(date_range, values):
                    data.append([unique_id, dt, value])
    # Convert the list of data into a DataFrame

    return pd.DataFrame(data, columns=["unique_id", "ds", "y"])


# Example usage

file_path = "australian_electricity_demand_dataset.tsf"
demand_df = read_tsf_from_file(file_path)

# Display the dataframe

demand_df.head()
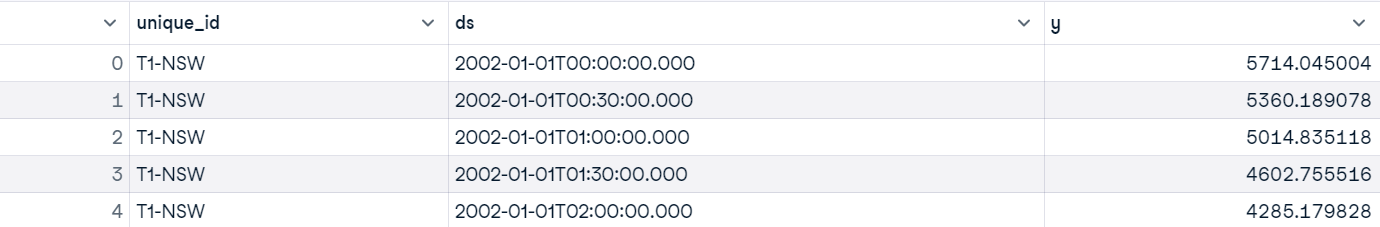
Unser DataFrame hat drei Spalten:
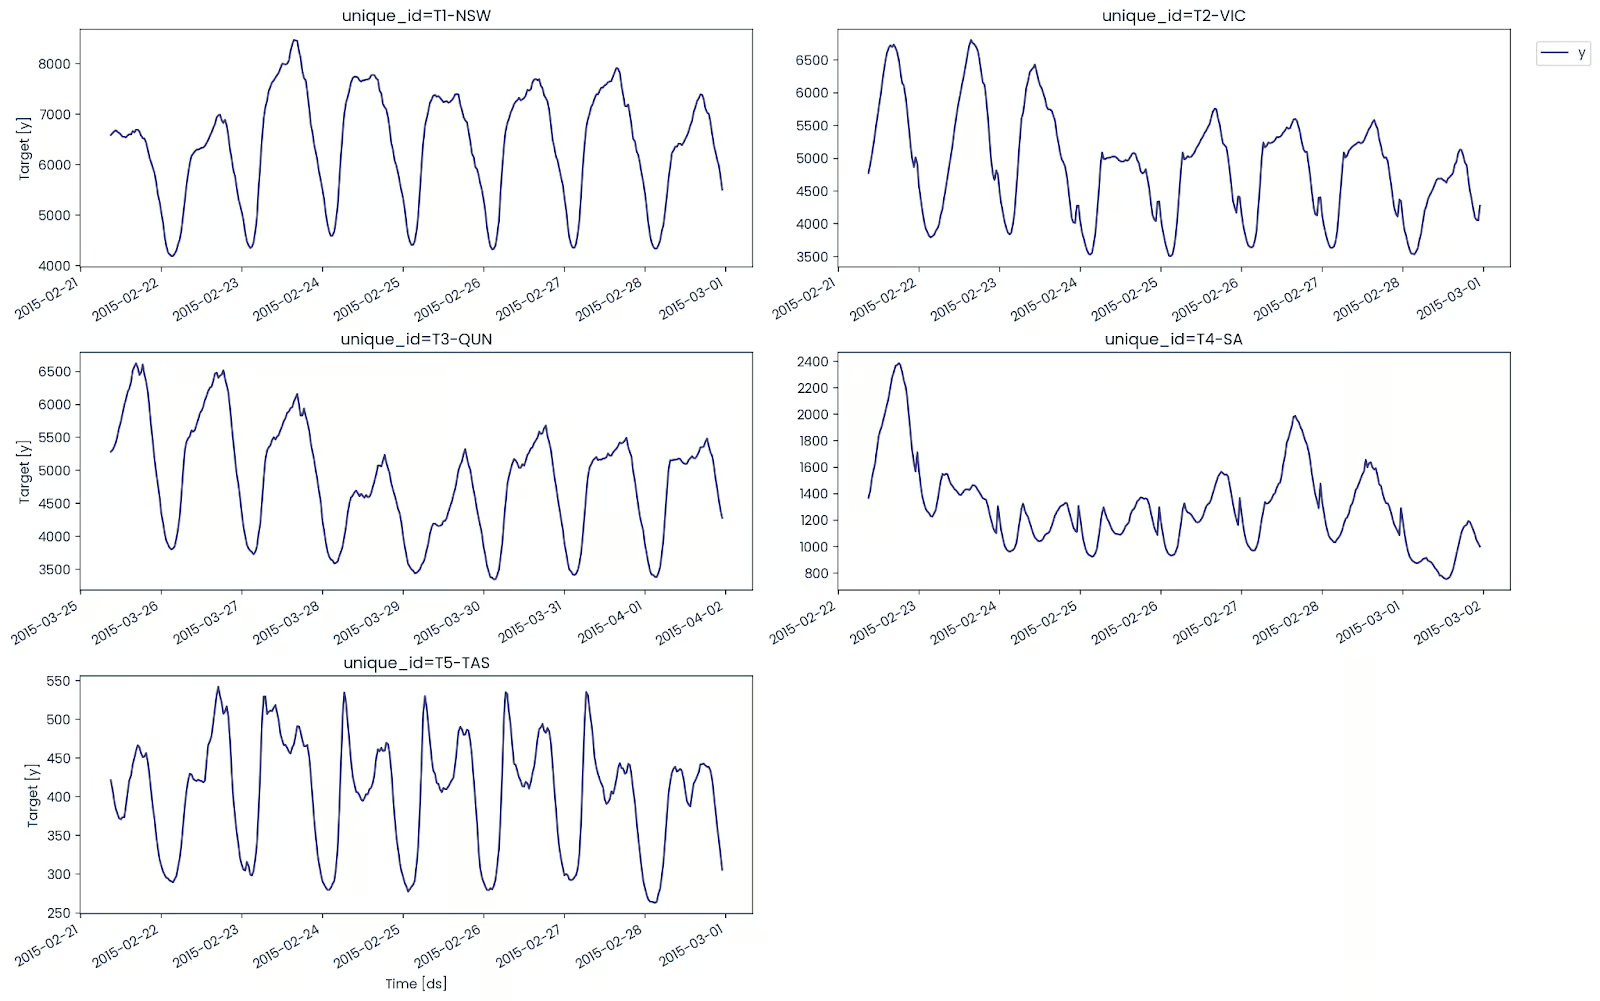
Die Plot-Funktion erkennt automatisch die Spalte unique_id und erzeugt fünf separate Zeitreihendiagramme.
nixtla_client.plot(
    demand_df,
    max_insample_length=365,
)
Die Visualisierung unten zeigt den Stromverbrauch der 5 Bundesstaaten – jeweils mit eigenen Mustern.
Lerne Zeitreihenanalyse in der Live-Code-Session auf DataCamp – mit Finanzzeitreihen in Python.
Wir untersuchen verschiedene Aktien, visualisieren ihre Entwicklung und erstellen Prognosen mit unterschiedlichen Modellen.
Bevor wir prognostizieren, identifizieren wir Anomalien im Datensatz, um das Problem besser zu verstehen.
Die Funktion .detect_anomalies erwartet Datensatz, Zeit- und Zielspalten sowie die Frequenz.
# Detect anomalies
anomalies_df = nixtla_client.detect_anomalies(
    demand_df,
    time_col='ds',
    target_col='y',
    freq='H',
)
anomalies_df[anomalies_df["anomaly"]==1].head()
Hier siehst du Beispiele, bei denen Anomalien erkannt wurden.
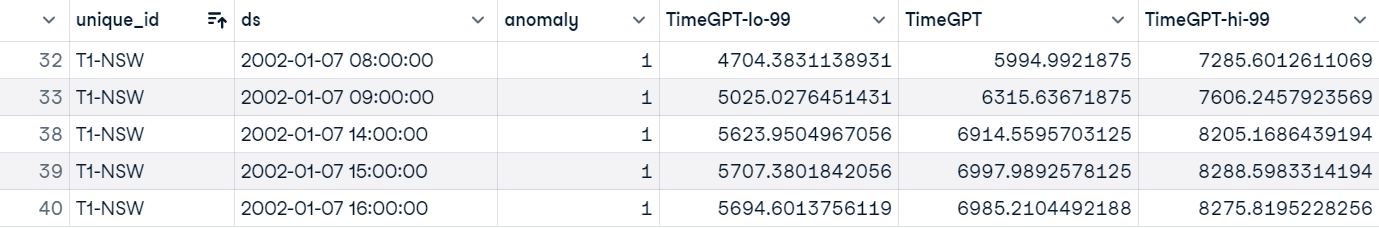
In Summe gibt es in allen 5 Reihen 17.316 Anomalien – das ist eine Menge.
anomalies_df.anomaly.value_counts()
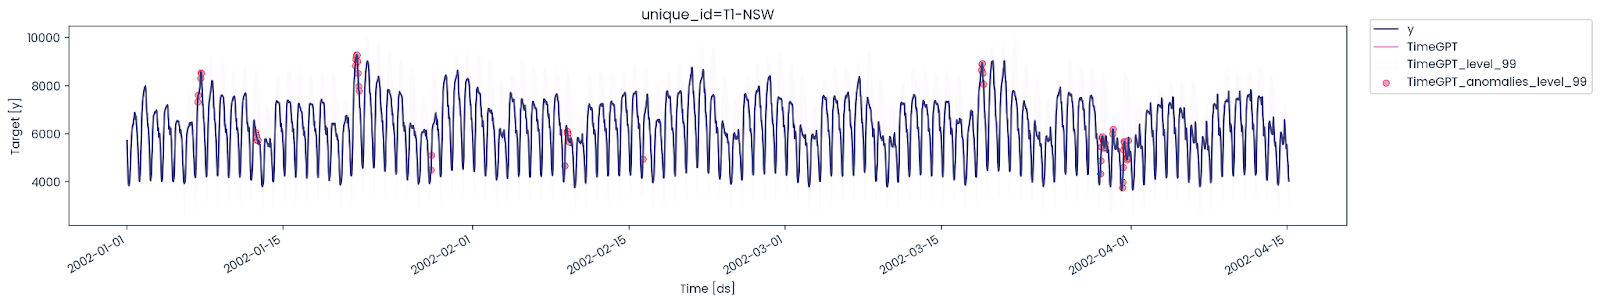
Jetzt plotten wir die Anomalien im Kontext der Originaldaten – wann und wie häufig sie auftreten. Zur Vereinfachung zeigen wir 5.000 Stichproben aus New South Wales.
# Plot anomalies
nixtla_client.plot(
    demand_df[demand_df["unique_id"]=="T1-NSW"][0:5000],
    anomalies_df[anomalies_df["unique_id"]=="T1-NSW"][0:5000],
    time_col='ds',
    target_col='y',

)
Tagesweise sind Anomalien selten, es gibt aber Tage mit mehreren Auffälligkeiten.
Als Nächstes prognostizieren wir die Nachfrage in New South Wales. Dazu filtern wir die Werte für "T1-NSW" heraus.
T1_df = demand_df[demand_df["unique_id"]=="T1-NSW"]
T1_df.head()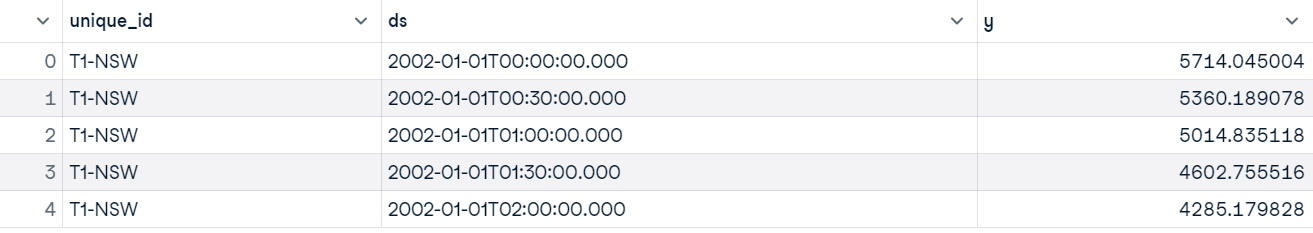
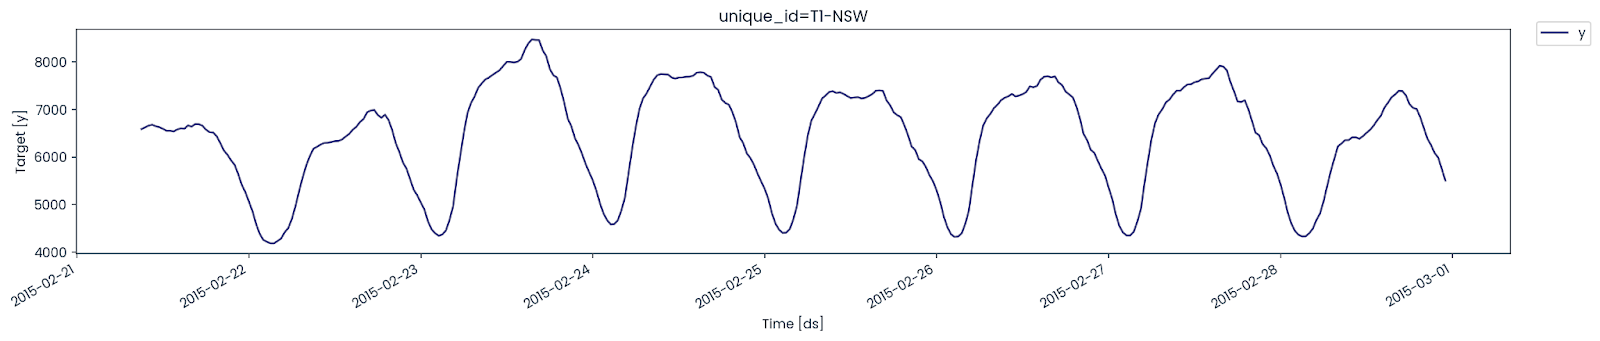
Plotte die letzten 365 Werte, um das Verbrauchsmuster zu verstehen.
nixtla_client.plot(
    T1_df,
    max_insample_length=365,
)
Jetzt bewerten wir die Modellgüte. Dafür teilen wir in Train- und Testdaten.
Das Testset umfasst 144 Werte (3 Tage), das Trainingsset 1.200 Werte (25 Tage).
test_df = T1_df.tail(144) # 3 days = (144 * 0.5h *  1 day/24h)
train_df = T1_df.iloc[-1344:-144] # 25 days = (1200 *0.5h * 1 day/24h)
Für die Prognose wählen wir ein passendes Modell und setzen Parameter zur Performance-Steigerung:
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],  # Generate a 90% confidence interval
    finetune_steps=60,  # Specify the number of steps for fine-tuning
    finetune_loss="mae",  # Use the MAE as the loss function for fine-tuning
    model="timegpt-1-long-horizon",  # Use the model for long-horizon forecasting
    time_col="ds",
    target_col="y",
)
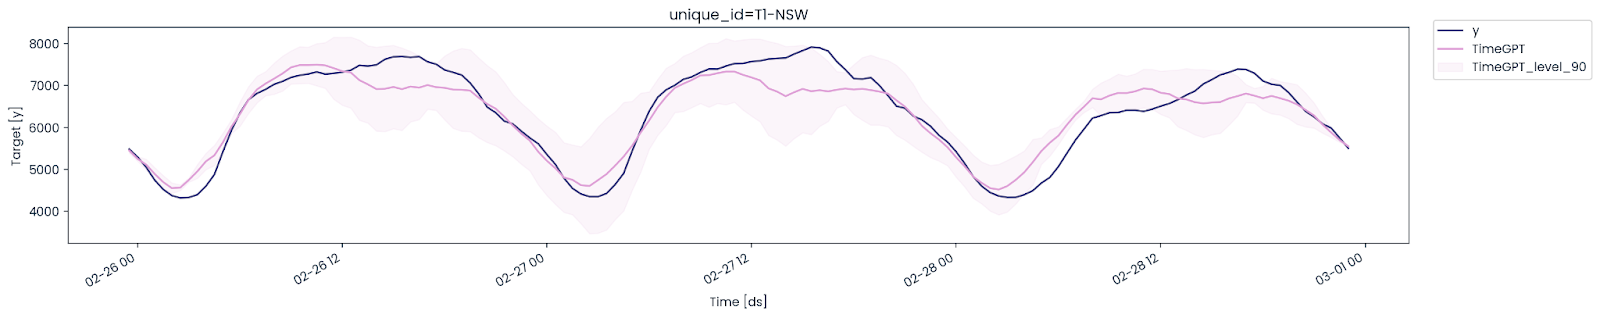
Plotte Istwerte, Prognose und 90-%-Intervall zur Beurteilung der Leistung.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Nach wenigen Sekunden erhalten wir sehr ordentliche Ergebnisse. Das ist die Stärke vortrainierter Modelle.
Zur Auswertung nutzen wir die Bibliothek UtilsForecast (Teil des Open-Source-Projekts von Nixtla). Wir mergen Test- und Prognosedaten und übergeben sie an evaluate. Die Funktion erhält Datensatz, Metriken, Modelle, Zielspalte und eine eindeutige ID, berechnet die Kennzahlen und zeigt sie als pandas-DataFrame an.
from utilsforecast.losses import mae, rmse, smape
from utilsforecast.evaluation import evaluate

predict_df["ds"] = pd.to_datetime(predict_df["ds"])
test_df = pd.merge(test_df, predict_df, "left", ["ds", "unique_id"])
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col="unique_id",
)

average_metrics = evaluation.groupby("metric")["TimeGPT"].mean()
average_metrics
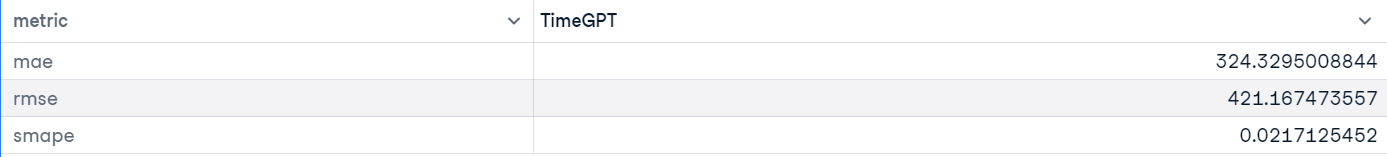
Die Resultate sind insgesamt gut.
Mit der Nixtla API kannst du auch mehrere Reihen gleichzeitig prognostizieren. Wir nutzen den gesamten Datensatz statt nach einer unique_id zu filtern.
Für die Aufteilung in Train und Test verwenden wir groupby, um für jede ID die letzten 144 Werte als Test zu wählen. Sonst würden wir nur für eine zufällige ID 144 Werte erhalten.
values for some randomly chosen unique ID.
test_df = demand_df.groupby("unique_id").tail(144)  # 3 days
train_df = (
    demand_df.groupby("unique_id")
    .apply(lambda group: group.iloc[-1344:-144])
    .reset_index(drop=True)
)  # 25 days
Der Aufruf von forecast ist identisch, nur dass wir diesmal die ID-Spalte mitgeben.
predict_df = nixtla_client.forecast(
    df=train_df,
    h=144,
    level=[90],
    finetune_steps=60,
    finetune_loss='mae',
    model='timegpt-1-long-horizon',
    time_col='ds',
    target_col='y',
    id_col='unique_id'
)
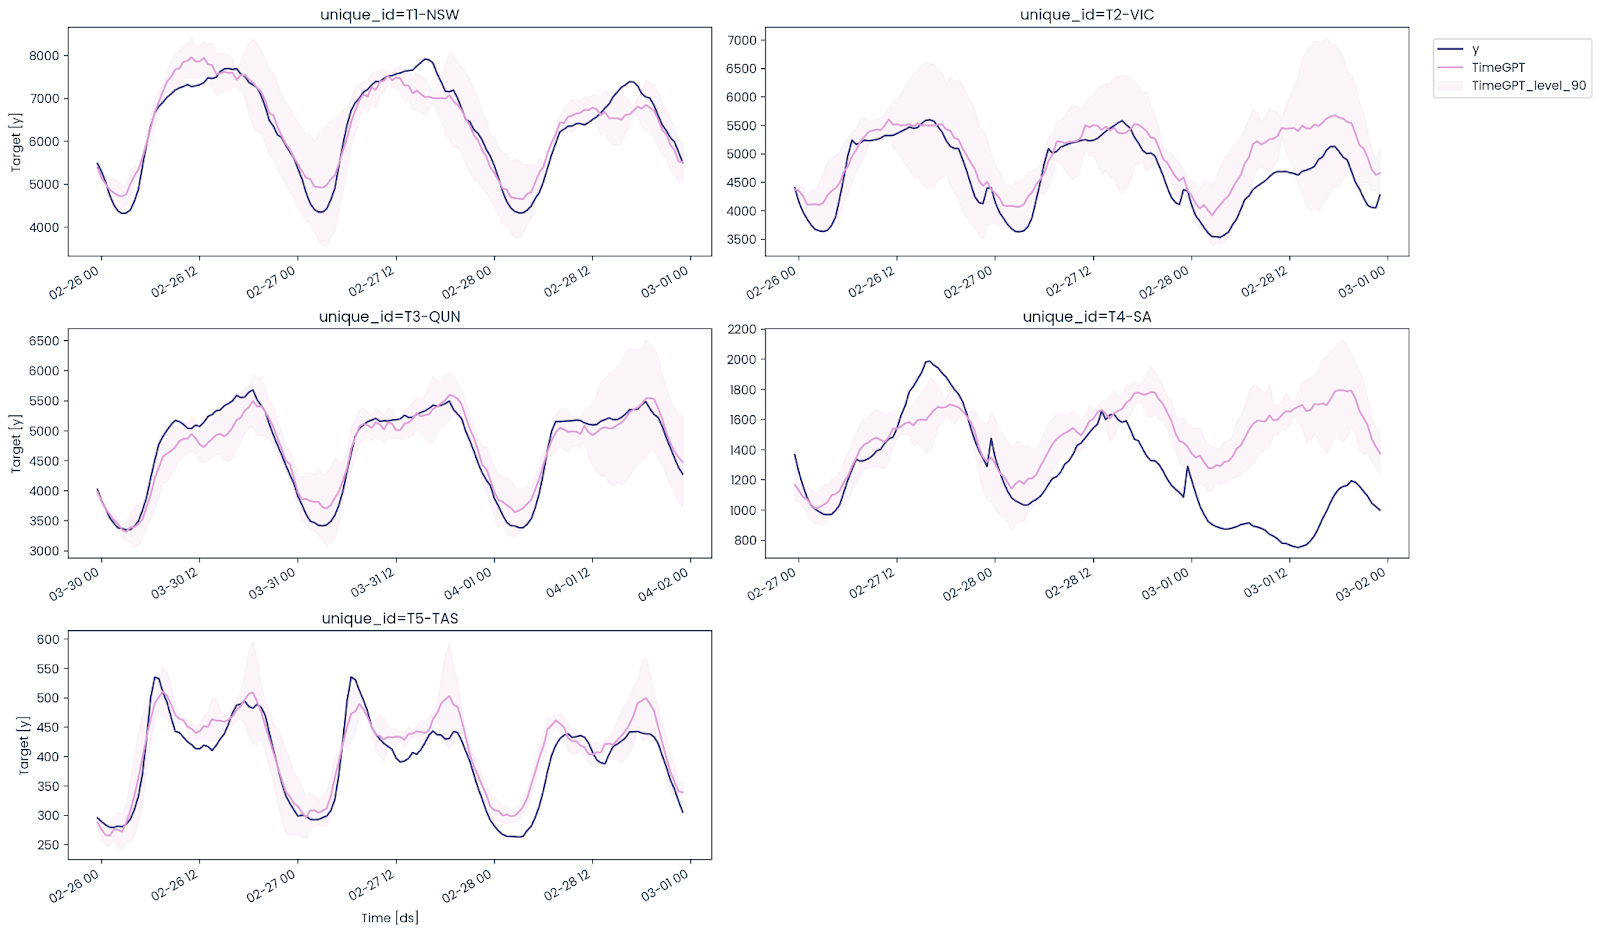
Plotte Istwerte, Prognosen und das 90-%-Intervall für alle 5 unique_id.
nixtla_client.plot(
    test_df, predict_df, models=["TimeGPT"], level=[90], time_col="ds", target_col="y"
)
Wie zu sehen ist, performt TimeGPT auch über mehrere Reihen hinweg gut – mit Ausnahme von South Australia, wo der Abwärtstrend nicht getroffen wurde.
Zur Evaluation mergen wir Test- und Prognosedaten und berechnen MAE, RMSE und SMAPE.
predict_df['ds'] = pd.to_datetime(predict_df['ds'])
test_df = pd.merge(test_df, predict_df, 'left', ['ds','unique_id'])
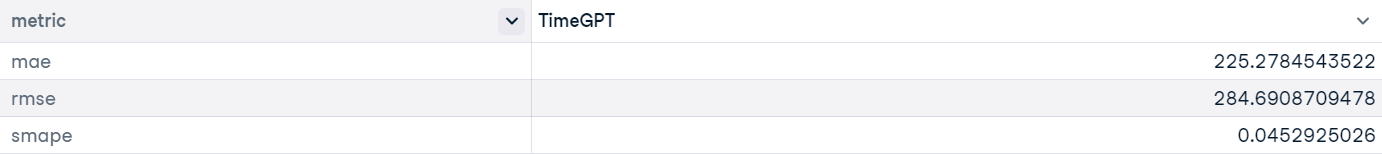
Mit evaluate erzeugen wir einen Performance-Report als pandas-DataFrame – mit Metriken je unique_id. Für die Gesamtleistung mitteln wir die Werte.
evaluation = evaluate(
    test_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "unique_id"
)

average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Die Gesamtperformance verbessert sich, wenn auf mehreren Reihen statt nur einer feinabgestimmt wird.
Der Nixtla-Client unterstützt außerdem Cross-Validation, um die Modellleistung über verschiedene Fenster des Datensatzes zu prüfen.
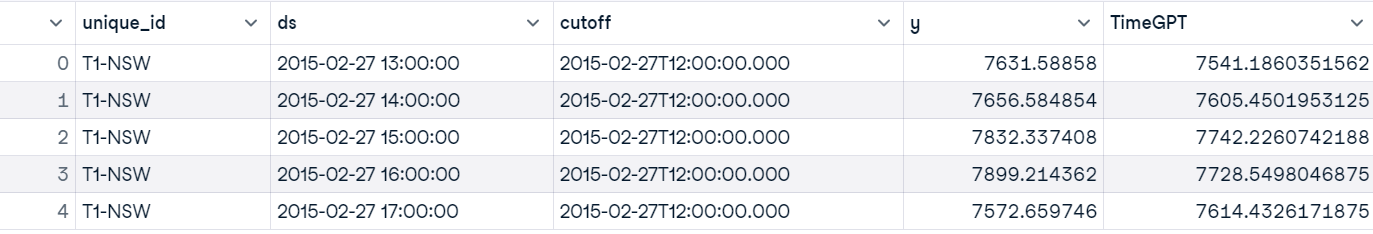
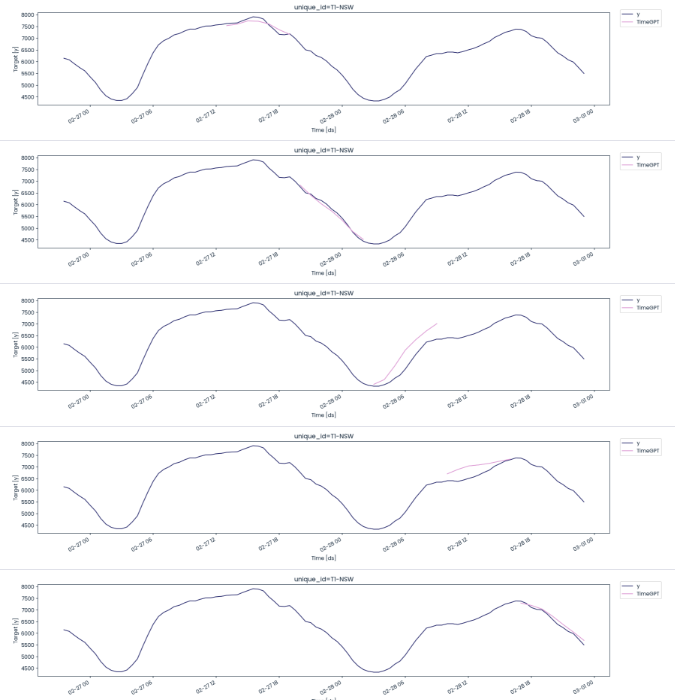
Wir verwenden .cross_validation und übergeben den gefilterten Datensatz für New South Wales. Es werden 5 Fenster à 7 Stunden erzeugt.
timegpt_cv_df = nixtla_client.cross_validation(
    T1_df,
    h=7,
    n_windows=5,
    time_col='ds',
    target_col='y',
    freq='H',
)
timegpt_cv_df.head()
Wie zu sehen, erhalten wir Prognosen für fünf 7-Stunden-Fenster.
Wir nutzen Cutoff-Datum/-Uhrzeit, um 5 Fenster mit Prognosen und Istwerten zu visualisieren.
cutoffs = timegpt_cv_df['cutoff'].unique()
for cutoff in cutoffs:
    fig = nixtla_client.plot(
        T1_df.tail(100),
        timegpt_cv_df.query('cutoff == @cutoff').drop(columns=['cutoff', 'y']),
        time_col='ds',
        target_col='y'
    )
    display(fig)
Abgesehen vom 3. und 4. Split schneidet das Modell sehr gut ab.
Vergleichen wir nun TimeGPT mit Light Gradient-Boosting Machine (LGBM), um klar zu sehen, welches Modell auf demselben Datensatz vorne liegt. Die Cross-Validation auf dem New-South-Wales-DataFrame ist bereits erfolgt; als Nächstes erzeugen wir mit evaluate den Report.
evaluation = evaluate(
    timegpt_cv_df,
    metrics=[mae, rmse, smape],
    models=["TimeGPT"],
    target_col="y",
    id_col = "cutoff"
)
evaluation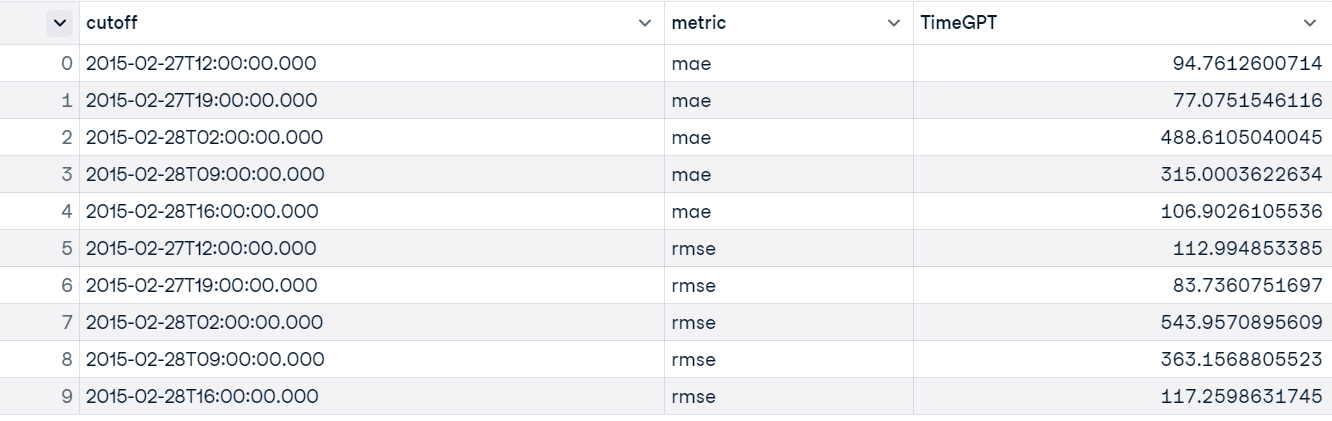
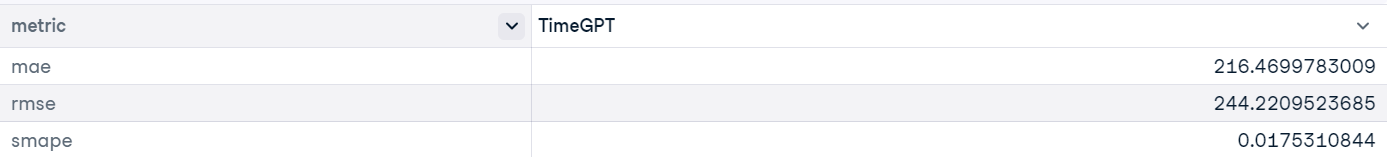
Für das Gesamtbild mitteln wir MAE, RMSE und SMAPE über alle 5 Fenster.
average_metrics = evaluation.groupby('metric')["TimeGPT"].mean()
average_metrics
Die Werte sind auch bei kleinem Sample erfreulich gut.
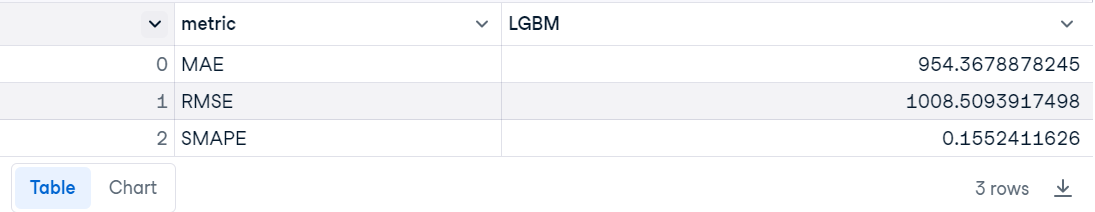
Für die Bewertung des LGBM-Modells gehen wir wie folgt vor:
Hinweis: Für Zeitreihenprognosen mit Statistik- und ML-Modellen brauchst du grundlegende Feature-Engineering-Techniken und Algorithmen. Eine kompakte Einführung findest du in diesem Tutorial: Time Series Forecasting Tutorial auf DataCamp.
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import TimeSeriesSplit
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Function to calculate SMAPE
def smape(y_true, y_pred):
    return np.mean(2 * np.abs(y_pred - y_true) / (np.abs(y_true) + np.abs(y_pred)))

# Assuming 'ds' is the date/time column and 'y' is the target variable
T1_df['ds'] = pd.to_datetime(T1_df['ds'])

# Filter the DataFrame to include only the specified datetime range
start_date = '2015-02-27T13:00:00'
end_date = '2015-02-28T23:00:00'
T1_df = T1_df[(T1_df['ds'] >= start_date) & (T1_df['ds'] <= end_date)]

# Convert 'ds' to a numerical value (e.g., timestamp)
T1_df['ds_num'] = T1_df['ds'].apply(lambda x: x.timestamp())

# Create lag and window features
for lag in range(1, 4):
    T1_df[f'lag_{lag}'] = T1_df['y'].shift(lag)

T1_df['rolling_mean'] = T1_df['y'].rolling(window=3).mean()
T1_df['rolling_std'] = T1_df['y'].rolling(window=3).std()

# Drop NaN values resulting from lag and rolling operations
T1_df.dropna(inplace=True)

# Select features for the model
X = T1_df[['ds_num', 'lag_1', 'lag_2', 'lag_3', 'rolling_mean', 'rolling_std']]
y = T1_df['y']

# Time series split
tscv = TimeSeriesSplit(n_splits=5)
mae_scores = []
rmse_scores = []
smape_scores = []

for train_index, test_index in tscv.split(X):
    X_train, X_test = X.iloc[train_index], X.iloc[test_index]
    y_train, y_test = y.iloc[train_index], y.iloc[test_index]

    # Initialize and train the LGBM model
    model = lgb.LGBMRegressor(force_row_wise=True, verbosity=-1)
    model.fit(X_train, y_train)

    # Make predictions
    y_pred = model.predict(X_test)

    # Evaluate the model
    mae = mean_absolute_error(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))
    smape_value = smape(y_test, y_pred)

    mae_scores.append(mae)
    rmse_scores.append(rmse)
    smape_scores.append(smape_value)

# Convert the metrics into a DataFrame
mae_avg = np.mean(mae_scores)
rmse_avg = np.mean(rmse_scores)
smape_avg = np.mean(smape_scores)

metrics_df = pd.DataFrame({
    'metric': ['MAE', 'RMSE', 'SMAPE'],
    'LGBM': [mae_avg, rmse_avg, smape_avg]
})

# Display the DataFrame
metrics_df
TimeGPT ist fast fünfmal besser als LGBM.
Wenn du Probleme beim Ausführen des Codes hast oder TimeGPT einrichten willst, wirf einen Blick in den DataLab-Workspace: Time Series Forecasting with TimeGPT.
Das TimeGPT- und Nixtla-Ökosystem ist ideal für Unternehmen, die gerade starten: Du musst keine ML-Engineers zum Trainieren und keine MLOps-Engineers zum Deployen und Betreiben einstellen. Besonders für Startups lassen sich so erhebliche Kosten sparen – bei gleichzeitig starker Modellleistung.
Ähnlich wie GPT-3 markiert TimeGPT den Startschuss für State-of-the-Art-Modelle in der Zeitreihenwelt. Mit der Weiterentwicklung dieser Modelle werden viele Unternehmen die Nixtla API für einfache Integration und bessere Performance übernehmen.
In diesem Tutorial haben wir TimeGPT – das erste Grundlagemodell für Zeitreihen – erkundet. Außerdem hast du gelernt, wie du über die Python-API auf TimeGPT zugreifst: für Forecasting, Visualisierung, Evaluation, Cross-Validation und Anomalieerkennung.
Lerne, mit ARIMA-Klassen in die Zukunft zu blicken und mithilfe von Machine-Learning-Modellen Vorhersagen und Insights zu generieren – im Lernpfad Time Series with Python. Wenn du lieber mit R arbeitest, schau dir den Lernpfad Time Series with R an, um Zeitreihenprognosen umfassend zu verstehen.
Top-DataCamp-Kurse
Lernpfad
Lernpfad
Lernpfad